看到 Anthropic 的一篇研究——《A global workspace in language models》
他们报告在 Claude 的中间层找到了一个类似“全局工作空间”的结构。
顺着这条线索,我把这个领域粗浅地摸了一遍,又自己动手做了一点实测(文中一处图和一处视频就是实测数据)。
这篇文章就是那次学习的整理——写给大家,也写给我自己学习。
全文地图:七层调试工具
这篇文章用”程序员调试”的视角,带你逐层了解 LLM 可解释性的七种武器——从最朴素的 print 打日志,一直到最前沿的”读脑器”。
我们会一直带着一个问题走:“不可更改,只读”这句话,在 LLM 的脑子里到底有多重要?
| 层级 | 调试类比 | 核心方法 | 你能知道什么 | 你不能知道什么 | 配图/视频 |
|---|---|---|---|---|---|
| 1 | print 打日志 | attention 可视化 | 模型在”看”哪里 | 看到的信息有没有被用到 | 热力图(实测) |
| 2 | 断点调试 | activation patching | 哪些组件是因果必要的 | 太慢,测不过来;是必要不是充分 | 补丁视频 |
| 3 | 自动 bisect | ACDC 自动电路发现 | 大致哪些路径构成”最小电路” | 贪心可能漏检;可能不是唯一电路 | 剪枝视频 |
| 4 | 反汇编 | SAE 字典学习 | 激活里有哪些”特征” | 特征不是原子;字典尺度影响结果 | 分解图(三态) |
| 5 | 热补丁 | 激活干预 | 改了之后行为会怎么变 | 系统性副作用,随机方向也有用 | 干预视频 |
| 6 | 读脑器 | J-lens / J-space | 每一层在”想”什么词 | 循环论证质疑;任务效应脆弱 | 读数视频 |
| 7 | 单元测试 | 基准 / causal scrubbing | 你的解释对不对 | 只能证伪,不能证实 | 分歧视频 |
引子:”不可更改,只读”到底有多硬?
先讲一个你可能每天都在经历的场景。
你打开 AI 编程助手,郑重其事地输入:
你:你是一个代码审查助手。听好了:不可更改代码,只读!只做审查,只给评论。
AI 乖乖答应:”好的,我只审查代码,不会做任何修改。”
然后它真的只评论、不改代码。你觉得很满意——”不错,这指令挺管用的。”
下一轮对话,你发现了一个 bug,顺手说:
你:刚才那个数组越界的问题,现在需要你修掉。
AI 二话不说:”好的,这就改。” 刷刷刷把代码改了。
你愣住了。
等等——刚才那个”不可更改,只读”呢?它是忘了?还是从来就没当真过?又或者,它”知道”这是只读指令,但优先级不够高,新指令一来就覆盖了?
作为程序员,你对这种感觉再熟悉不过了——就像你在排查一个 bug,你怀疑某段代码有问题,但你不确定。你需要验证。
你会怎么做?
- 你会加
print看变量值对不对 - 你会打断点,一行一行单步执行
- 你会改一个变量的值,看看行为会不会变
- 你会写单元测试,验证你的判断对不对
这些都是调试。
那问题来了:你能调试 LLM 吗?
你没有它的源码。就算有,几十亿个参数你也看不过来。你只能看到输入和输出——它就是一个黑盒。
但过去六年里,有一群人在做一件事:给黑盒 AI 造调试工具。这个领域叫 LLM 可解释性(LLM Interpretability)。
这篇文章,我就用程序员熟悉的”调试”视角,带你走一遍这个领域的七层工具——从最朴素的”print 打日志”,一直到最前沿的”读脑器”。
我们会一直带着开头那个问题走:“不可更改,只读”这句话,在 LLM 的脑子里到底有多重要?
每上一层,你就对这个问题多一分答案——也多一分困惑。
第一层:print 调试 —— attention 可视化
1.1 程序员的本能:先打个 log 看看
面对一个陌生的系统,程序员的第一反应永远是:先打个 log 看看。
你不知道函数在干嘛?加一行 console.log(x),看看变量长什么样。你不知道循环跑到哪了?加个 print(f"第{i}轮")。
虽然原始,但有效。print 是所有调试方法的起点。
那 LLM 有没有类似 print 的东西?有——注意力权重(attention weights)。
1.2 什么是自注意力?(用查字典来比喻)
在讲 attention 可视化之前,得先花两分钟讲清楚自注意力(self-attention)是什么。别怕,不用公式,用一个比喻。
想象你在读一句话:“小明把书给了小红”。
你读到”给了”这两个字的时候,你脑子里在想什么?你肯定会回想——谁给的?给了什么?给谁了?
你不会傻到一个字一个字孤立地读。你会回过头去看前面的词,把相关的信息拎出来。
自注意力干的就是这件事。当 LLM 处理每个词的时候,它会回头看句子里所有其他词,然后决定:每个词对我当前的理解有多重要?
具体来说,每个词都会生成三个东西:
- Query(查询):相当于你现在脑子里的问题——”我在找什么?”
- Key(键):相当于每个词挂在自己胸前的名牌——”我是什么?”
- Value(值):相当于每个词携带的实际内容——”我有什么信息?”
然后,当前词的 Query 去和所有词的 Key 比一比,算个相似度——”我跟你有多相关?” 相似度高的,对应的 Value 就多拿一点过来;相似度低的,就少拿一点。
最后把所有 Value 按相似度加权混合起来,就是当前词经过自注意力之后的新表示。
一句话总结:自注意力 = 每个词都回头看全句,按相关程度把其他词的信息”抓过来”,组成自己的新理解。
1.3 softmax:把”分数”变成”概率”的魔法函数
刚才说的”相似度”是怎么变成”权重”的?这里有个关键函数叫 softmax。
假设你算出了三个词的相似度分数:8、5、2。直接用分数当权重?不行——
- 分数可能是负数,权重不能负
- 权重加起来应该等于 1(代表”分配注意力”的总量是固定的)
- 我们希望分数高的获得不成比例的更多关注(放大差距)
softmax 就是干这个的。它的公式长这样:
$$
\text{softmax}(x_i) = \frac{e^{x_i}}{\sum_{j=1}^{n} e^{x_j}}
$$
别怕,我来翻译成人话:
- 分子:给每个分数取
e的指数次方(e ≈ 2.718,就是自然对数的底) - 分母:把所有分数的指数次方加起来(归一化因子)
- 结果:每个数都变成 0 到 1 之间,且加起来等于 1
为什么用指数?因为指数函数有个特点:大的数会变得特别大,小的数会变得特别小。比如 8、5、2 这三个数,取指数后就变成了 2981、148、7.4——差距被急剧拉大了。
经过 softmax 后,权重变成了大约:0.95、0.047、0.0023。最大的分数拿走了 95% 的注意力。
softmax 的白话解释:一个”赢者通吃”的转换器——把一组分数变成概率,高分的拿走绝大部分权重,低分的几乎被忽略。这就是为什么 LLM 会”聚焦”在几个关键词上。
1.4 自注意力的完整公式
把 Query、Key、Value 和 softmax 合在一起,就是自注意力的核心公式:
$$
\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right) V
$$
我来逐行翻译:
| 符号 | 是什么 | 白话解释 |
|---|---|---|
| $Q$ | Query 矩阵 | 每个词的”问题”:我在找什么? |
| $K$ | Key 矩阵 | 每个词的”名牌”:我是什么? |
| $V$ | Value 矩阵 | 每个词的”内容”:我有什么信息? |
| $QK^T$ | Q 乘以 K 的转置 | 每个词和每个词的相似度分数 |
| $\sqrt{d_k}$ | Key 维度的平方根 | 缩放因子,防止分数太大导致 softmax 太极端 |
| $\text{softmax}(…)$ | softmax 函数 | 把分数变成 0-1 的权重,加和为 1 |
| $\times V$ | 乘以 Value | 按权重把各词的内容混合起来 |
所以整个过程就是:算相似度 → 转成权重 → 按权重混合信息。
而那个权重矩阵 $\text{softmax}(QK^T/\sqrt{d_k})$,就是我们说的注意力权重——它告诉我们,每个词在处理的时候,”看了”其他词多少。
1.5 attention 热力图:print 出来的结果
注意力权重可以画成一张图——热力图。
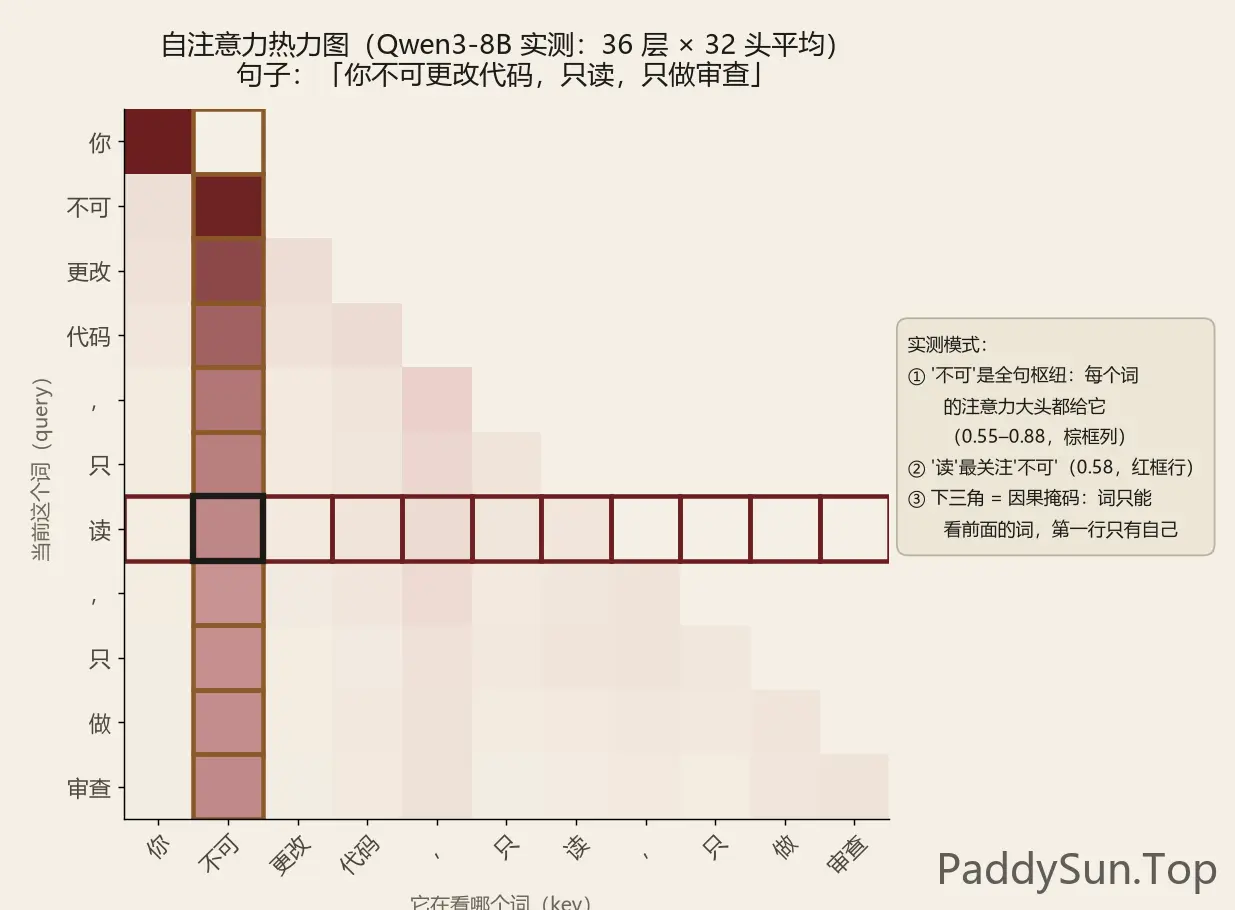
上面这张图不是示意——它是真实测量结果:Qwen3-8B 模型(82 亿参数)处理”你不可更改代码,只读,只做审查”这句话时的自注意力热力图(36 层 × 32 个注意力头取平均)。每一行代表”当前这个词”,每一列代表”它在看哪个词”,颜色越深表示看得越重。
你可以看到一些真实的模式(和很多人想象的”模型在看’只读’”不太一样):
- “不可”是全句的注意力枢纽——从”更改”到”审查”,几乎每个词的注意力大头都给了”不可”(0.55–0.88)。否定核心承载了整句的约束语义
- “读”最关注的是”不可”(0.58)——”只读”的含义确实挂在否定指令上,但它连接的对象是”不可”,而不是”代码”
- 注意力的形状是下三角——每个词只能”看”它前面的词(因果掩码),所以第一行只有它自己。这不是 bug,是语言模型的因果本性
- 连标点也在看”不可”——逗号的注意力也大半给了它。attention 没有”功能词更分散”的浪漫想象
你可能会想:哇,这不就清楚了吗?模型”理解”了这句话的结构!
别急。先打个问号。
1.6 attention 之争:看着 = 用着吗?
2019 年,有两篇论文在 NLP 圈炸开了锅。
一篇叫 “Attention is not Explanation”(注意力不是解释),另一篇叫 “Attention is not not Explanation”(注意力不是不是解释——就是双重否定,表示它还是有点用的)。
争论的核心是一个问题:模型”看着”某个词,就等于它”用到了”某个词吗?
说个极端的例子。假设模型有两个头——
- 头 A:100% 关注”只读”这个词,但它的输出完全不传给下游,后面的层根本不用它
- 头 B:只花 1% 注意力看”只读”,但它的输出决定了最终行为
你说,哪个才是真正起作用的?
attention 热力图告诉你模型”看了哪里”,但不告诉你”看到的信息有没有被用上”。
这就像你 print 了一个变量的值,但你不知道后面的代码有没有用到它。你只知道变量存在,不知道它的因果作用。
回到我们的问题:”不可更改,只读”——attention 告诉我们模型确实在”看”这些词,但……
它到底用没用这些信息来决定要不要改代码?
光看 attention,回答不了。
1.7 第一层小结
- 工具:attention 可视化(热力图)
- 类比:print 打日志——看变量长什么样
- 能回答什么:模型在”看”哪里
- 回答不了什么:看到的信息有没有被真的用到
- 核心公式:softmax + 自注意力公式
print 调试是起点,但远远不够。要确认因果——确认”是这个东西导致了那个行为”——你需要更狠的工具。
那就是下一层:断点调试。
第二层:断点调试 —— activation patching
2.1 从”看”到”改”:断点的威力
作为程序员,你肯定用过调试器。设一个断点,程序跑到那一行就停住。然后你可以:
- 看所有变量的值
- 改一个变量的值,然后继续跑,看行为变没变
这个”改值看效果”的动作,是因果推断的精髓——如果你改了 X,Y 就变了,那 X 对 Y 就有因果作用。
光看不行,得动手改。
那 LLM 能不能也这么玩?能不能在某一层”停住”,改一下激活值,然后看输出变不变?
能。这个方法叫 activation patching(激活补丁;它源自把因果中介分析引入 NLP 的那批工作)。
2.2 activation patching 的基本思路
patching 的思路非常朴素,只有三步:
第一步:准备两个输入
- Clean(干净)输入:正常的、能得到正确行为的输入。比如”不可更改,只读” → 模型输出”好的,我只审查”。
- Corrupt(破坏)输入:被改动过的、行为会变的输入。比如把”不可更改,只读”改成”随便改,改了” → 模型输出”好的,这就改”。
第二步:在某一层打补丁
先跑一遍 clean 输入,把每一层的激活值都存下来(相当于打了个快照)。
然后跑 corrupt 输入,但跑到某一层的时候——比如第 3 层——把这一层的激活值换成 clean 输入在这一层的值。
就像断点调试里,你跑到第 3 行,把变量 x 的值从 0 改成 1,然后继续执行。
第三步:看输出有没有”恢复”
如果换了第 3 层的值之后,模型的输出从”好的,这就改”变成了”好的,我只审查”——那就说明:第 3 层编码了决定行为的关键信息。
如果换了之后输出没变——那第 3 层可能跟这个行为没关系。
2.3 怎么量化”恢复了多少”:logit diff
光说”行为恢复了”太主观了。我们需要一个量化指标。
这个指标叫 logit diff(logit 差值)。
logit 是什么? 模型在输出每个词之前,会先给词表里每个词打一个分,这个分数就叫 logit。分数越高,模型越倾向于输出这个词。
比如模型要输出下一个词的时候,它心里想:”好的”(+8.5 分)、”我来”(+7.2 分)、”抱歉”(+3.1 分)……
logit diff 就是:目标正确答案的分数 – 目标错误答案的分数。
在我们的例子里:
- Clean 输入下:”只审查”的 logit – “这就改”的 logit = 8.5 – 2.1 = 6.4(差距很大,模型很确定要只读)
- Corrupt 输入下:”只审查”的 logit – “这就改”的 logit = 1.8 – 7.3 = -5.5(反过来了,模型要改)
- 打了补丁之后:假设变成 4.2 – 3.8 = 0.4
然后我们算恢复比例:
$$
\text{恢复率} = \frac{\text{logit_diff}{\text{patching}} – \text{logit_diff}{\text{corrupt}}}{\text{logit_diff}{\text{clean}} – \text{logit_diff}{\text{corrupt}}}
$$
代入数字:(0.4 – (-5.5)) / (6.4 – (-5.5)) = 5.9 / 11.9 ≈ 49.6%。
意思是:补丁让行为恢复了大约一半。
logit diff 的白话解释:衡量模型有多”偏向”正确答案 vs 错误答案。恢复率越高,说明你打的补丁越关键——这一层编码的信息越重要。
2.4 最经典的案例:IOI 电路
patching 方法最著名的成果,是 2022 年 Wang 等人的一篇论文,叫 “Interpretability in the Wild”。
他们研究的问题是:模型怎么识别间接宾语?
比如这句话:”小明把书给了小红”——模型怎么知道”小红”是接收者,”书”是被给的东西?
这个任务简称 IOI(Indirect Object Identification,间接宾语识别)。
他们用 patching 方法,在 GPT-2 Small(一个 1.24 亿参数的小模型)上,一层一层、一个头一个头地测——测每个组件对 IOI 行为的因果贡献有多大。
最后他们找到了 26 个注意力头(GPT-2 Small 一共 144 个头),这些头合起来构成了一个”电路”——负责识别间接宾语。
你没看错:144 个头里,只有 26 个真正在干这件事。剩下的 118 个头,至少对 IOI 这个任务来说,不是关键角色。
这个”IOI 电路”后来成了可解释性领域的”标准测试题”——就像编程里的”Hello World”,新方法出来都要在 IOI 上跑一下,看看能不能复现这 26 个头。
2.5 path patching:更精细的”线路级”补丁
activation patching 是整层整个头地替换。但有时候你想知道得更细——
不是”这个头重不重要”,而是”这个头传给那个头的那条连接重不重要“。
这就有了 path patching(路径补丁)。
想象一下:注意力头 A 的输出要传给后面的注意力头 B。我们不是替换 A 的整个输出,也不是替换 B 的整个输入,而是只把”A→B 这条线路上的信号”换掉。
这就像你调试的时候,不是改整个变量,而是只改变量里的某个字段——看看具体哪部分信息在起作用。
IOI 电路的完整发现,用的就是 path patching。研究者们不仅找到了哪些头重要,还找到了头和头之间的连接关系——谁给谁传信号,传的是什么。
2.6 回到”只读”问题
有了 patching 工具,我们可以回答一个更精确的问题:
“不可更改,只读”这个指令的信息,到底存在模型的哪一层?
假设我们做实验——(下面是示意数字,用来说明怎么读这类结果)
- 第 1 层打补丁:恢复率 5%。几乎没用——说明第一层还没提取出”只读”的含义。
- 第 3 层打补丁:恢复率 45%。开始有点东西了。
- 第 5 层打补丁:恢复率 73%。效果很明显——第 5 层编码了大量关键信息。
- 第 8 层打补丁:恢复率 68%。稍微降了一点。
- 第 12 层打补丁:恢复率 82%。最高。
你就会得出结论:”只读”指令的信息,在第 5 层到第 12 层之间被逐步提取和加工,第 12 层达到峰值。
听起来很清楚了对不对?
但是——
patching 有个大问题:太慢了。
你想,一个模型有 12 层,每层 12 个头,那就是 144 个组件要测。每个组件都要跑一遍前向传播。如果你想测两个组件的组合呢?144×144 = 20736 种组合。
这还只是小模型。大模型有上百层、上百个头——一个个测?测到天荒地老。
能不能让机器自动找?
这就是下一层:自动找 bug —— ACDC 自动电路发现。
2.7 第二层小结
- 工具:activation patching / path patching
- 类比:断点调试——改一个变量的值看行为变不变
- 能回答什么:哪些组件对行为是因果必要的
- 回答不了什么:太慢了,一个个测测不过来;找到的是”必要”,不是”充分”
- 核心概念:clean vs corrupt、logit diff、恢复率
- 金标准地位:真实干预是因果验证的黄金标准——但贵
第三层:自动找 bug —— ACDC 自动电路发现
3.1 手动二分太慢了,能不能自动化?
你调试过大型代码库就知道,手动一个个打断点排查是非常低效的。
所以才有了各种自动化调试工具:git bisect 自动二分找哪次提交引入了 bug、覆盖率工具告诉你哪些代码没被执行过、profiler 告诉你哪段最慢……
ACDC(Automatic Circuit Discovery,自动电路发现;官方代码库)干的就是类似的事——自动找出对某个行为最重要的”最小电路”,不用你手动一个个测。
3.2 ACDC 的思路:贪心剪枝
ACDC 的核心思路非常直觉化:从全连接开始,一步步剪掉”最不重要”的边,直到不能再剪为止。
说人话就是——
想象你面前有一团乱麻(完整的神经网络,几万条边),你想找出哪几根线是真正传信号的。你怎么做?
- 你先拉一拉所有的线,看看每条线有多”紧”(对输出的影响有多大)
- 你把最松的那根剪掉——反正它几乎不传信号
- 再拉一拉,再剪最松的
- 一直剪,剪到再剪就会影响行为了为止
最后剩下的那团线,就是”最小电路”。
这就叫贪心剪枝(greedy pruning)——每一步都做当前最优的选择(剪最不重要的),一步步逼近目标。
3.3 怎么衡量”一条边重不重要”?
关键问题来了:你怎么知道哪条边”最不重要”?
ACDC 用的是 patching 的思路——把这条边的信号”破坏掉”(换成随机值或者另一个输入的值),看输出变化了多少。变化越小,说明这条边越不重要。
具体来说,ACDC 用了一个叫 KL 散度(Kullback-Leibler divergence)的指标来衡量”输出变化了多少”。
KL 散度的白话解释:衡量两个概率分布之间的”距离”。如果输出分布完全没变,KL = 0;变化越大,KL 越大。
你可以把它理解成”输出被搅乱的程度”——剪了一条边,如果输出几乎没变(KL 很小),说明这条边不重要;如果输出大变(KL 很大),说明这条边很关键。
ACDC 的剪枝过程就是:
- 计算每条边的”重要性分数”——剪掉它之后 KL 散度增加了多少
- 把重要性最低的边剪掉
- 重复,直到 KL 散度超过预设的阈值(比如,输出变化不能超过 10%)
3.4 战绩如何?合成任务完胜,自然语言半胜
ACDC 的表现怎么样?得看任务难度。
合成任务(玩具任务):几乎完美。
在一个叫 “Greater-Than” 的任务里(判断两个数字哪个大),ACDC 的战绩是:
- 5/5 组件类全部正确发现
- 一共 32000 条边,ACDC 只选了 68 条——这 68 条全部是此前手工发现的
意思是:一个没漏掉,一个没选错。完美。
自然语言任务:部分成功。
在前面提到的 IOI 任务(间接宾语识别)上,ACDC 的战绩就没那么好了:
- 手工发现了 26 个头
- ACDC 只找到了 9/26 个头
- 漏掉了一些重要的东西,比如”负名搬运头”和”前一个 token 头”
为什么?因为自然语言任务更复杂,电路也更微妙。有些组件的作用是负向的(抑制错误答案),而不是正向的(促进正确答案)——贪心剪枝容易漏掉这种”反向作用”的组件。
一个重要的认识:ACDC 在简单任务上几乎完美复现手工发现,但在复杂任务上会漏检。”自动电路发现”目前还达不到”一键出真相”的程度——它更像一个辅助工具,帮你缩小范围,最后还得人来验证。
3.5 更大的问题:你找到的是”唯一”的电路吗?
ACDC 有个更深层的问题,甚至比”漏检”还严重——
你剪出来的电路,是唯一的吗?
想象一下:你有一个函数:
def add(a, b):
    x = a + b   # 路径1
    y = a + b   # 路径2
    return x + y
如果你把 x 这条路径注释掉,函数还能工作(因为有 y)。如果你把 y 这条路径注释掉,函数也能工作(因为有 x)。于是你得出结论:”x 不重要,y 也不重要”——但实际上两个都重要,只是有冗余。
神经网络里也有这种情况——并行通路(dormant pathway,休眠通路)。
有时候你剪了一条边,输出没变——不是因为这条边不重要,而是因为另一条并行的路把活给干了。你剪的时候,备用通路顶上了。
这就导致了一个叫 “可解释性幻觉”(interpretability illusion)的现象:
你以为你找到了”负责 X 的电路”,但实际上你只是找到了”其中一条路”——还有其他路在你没注意的时候干活。
更麻烦的是,反过来也成立:你激活了某个子空间,输出变了——你以为这个子空间编码了目标特征,但实际上你可能只是不小心触发了一条休眠的并行通路。
3.6 回到”只读”问题
如果我们用 ACDC 来找”只读”行为的电路,会怎么样?
大概是这样的:
- 它会找到一些明显重要的头和边(比如直接处理”只读”这个词的头)
- 它可能会漏掉一些负向作用的组件(比如抑制”修改”冲动的头)
- 它找到的电路可能只是多条并行通路中的一条
- 换个阈值、换个初始条件,找到的电路可能不一样
所以,当你看到”AI 发现了负责 X 的神经回路”这种新闻时,心里要打个问号——
是哪个方法发现的?阈值设了多少?有没有验证过这是唯一的电路?
3.7 第三层小结
- 工具:ACDC(Automatic Circuit Discovery)
- 类比:自动化 bisect / 覆盖率工具——自动定位问题区域
- 能回答什么:大致哪些组件和路径构成了”最小电路”
- 回答不了什么:贪心可能漏检(特别是负向组件);可能不是唯一电路(并行通路问题);结果依赖阈值
- 适用场景:合成/玩具任务效果好,自然语言任务部分成功
- 核心概念:贪心剪枝、KL 散度、最小电路、可解释性幻觉
到目前为止,我们一直在”组件级别”研究模型——这个头重要不重要?这条边重要不重要?
但你可能会问一个更本质的问题:
那些头里面,装的到底是什么? 是”只读”这个概念?还是”指令强度”?还是某种我们完全看不懂的东西?
就像你知道 CPU 里某个寄存器很重要,但你不知道寄存器里存的是什么数据。
要回答这个问题,我们需要再往下走一层——把激活拆开看。
第四层:拆解变量 —— SAE 字典学习
4.1 一个让人头大的问题:叠加
先问你一个问题:一个神经元(neural network里的一个计算单元)能编码几个概念?
你可能会说:一个啊,一个神经元代表一个特征嘛——这不是教科书说的吗?
不对。真实情况是:一个神经元可以同时编码好多个概念。
这个现象有个专门的名字,叫 叠加(superposition)。
什么意思?打个比方。
假设你有 8 个灯泡(8 个神经元),每个灯泡可以亮或不亮。理论上你只能表示 8 种”特征”——每个灯泡对应一个。
但如果灯泡可以调亮度呢?而且可以任意混合呢?
比如,灯泡 A 亮度 0.7 代表”动物”,亮度 0.3 代表”金属”——你说这个灯泡到底编码了什么?两个都编码了。它们叠加在了一起。
神经网络就是这么干的。因为特征的数量远远多于神经元的数量,模型就玩了个”压缩把戏”——把多个特征塞进同一组神经元里,用不同的方向和强度来区分。
这就是叠加假说:网络表示的独立特征,比神经元的数量还多。
这就带来一个大问题:你根本看不懂一个神经元的激活是什么意思——因为它可能同时是 5 个不同特征的混合体。
就像你调试的时候,发现一个整数变量的值是 0b101101,但没人告诉你每一位代表什么——你只看到一个数字,但里面混了好几个标志位。
那怎么办?
4.2 SAE:把混合信号拆开
SAE(Sparse Autoencoder,稀疏自编码器)就是干这个的:把稠密的、混合的神经元激活,拆成稀疏的、可解释的特征。
它的思路是这样的:
- 我有一个神经元激活向量(比如 512 维,大部分维度都有值——稠密)
- 我训练一个”编码器”,把它映射到一个大得多的向量空间(比如 131072 维——是原来的 256 倍!)
- 但是,我要求这个大向量大部分都是 0,只有少数几个维度非零——稀疏
- 然后再训练一个”解码器”,把稀疏向量还原回原来的神经元激活向量
- 目标是:还原得越准越好,同时稀疏性越高越好
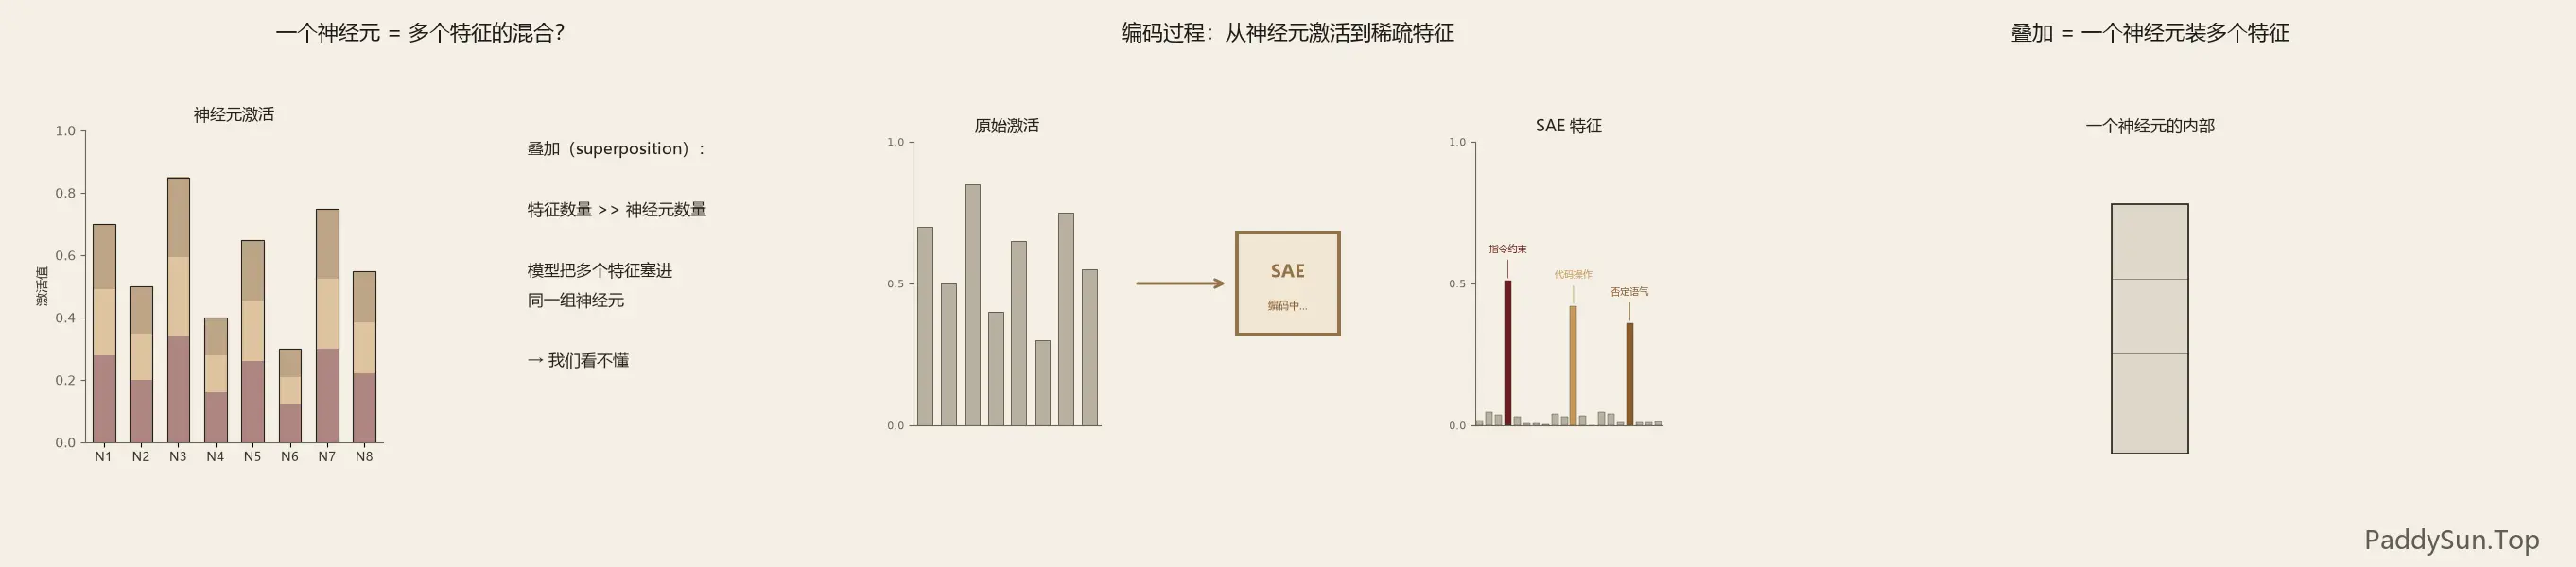
为什么要搞这么大的向量?因为——空间足够大,每个特征就能占一个独立的维度,不用跟别人挤了。
原来 512 个神经元要塞几千个特征,挤得互相叠加。现在我给你 13 万个格子,每个特征住一间——这样每个格子就只代表一个特征了。
这叫 过完备字典(overcomplete dictionary)——字典的大小比原始维度大得多。
而”稀疏”的要求,就是逼着每个输入只激活少数几个特征——就像一句话里只会用到少数几个概念一样。
4.3 SAE 的损失函数
上面说的”还原得准”和”要稀疏”这两个目标,都写进了 SAE 的损失函数里:
$$
\mathcal{L} = | x – f(g(x)) |^2 + \lambda \cdot | g(x) |_1
$$
这个公式看起来吓人,其实就是两部分加起来。我来翻译:
| 部分 | 公式 | 是什么 | 白话解释 |
|---|---|---|---|
| 重建损失 | $| x – f(g(x)) |^2$ | 输入 x 和重建输出的差的平方和 | 还原得准不准。编码器编码、解码器解码之后,能不能还原回原来的激活?差得越少越好。 |
| 稀疏惩罚 | $\lambda \cdot | g(x) |_1$ | 编码后向量的 L1 范数(所有元素绝对值之和)乘以系数 λ | 够不够稀疏。编码后的向量里,非零元素越少越好。λ 是个旋钮,调得越大,特征越稀疏。 |
| 总损失 | 两者相加 | — | 既要还原准,又要稀疏,两个目标平衡 |
SAE 损失函数的白话总结:一个”既要又要”的函数——既要拆完之后能还原回去(保证没丢信息),又要拆出来的特征尽量稀疏(保证每个特征是独立的)。
4.4 激动人心的时刻:3400 万个特征和”金门大桥”
SAE 路线最有名的成果来自 Anthropic(Claude 的母公司)的一系列工作。
- 2023 年:Towards Monosemanticity——他们在一个只有一层的小模型上(512 个神经元),用 SAE 拆出了 131072 个特征。很多特征是人类可理解的——比如”DNA 序列特征”、”金色头发特征”这类。
- 2024 年:Scaling Monosemanticity——他们把规模拉到了 Claude 3 Sonnet 模型上,拆出了 3400 万个特征。
其中最著名的一个特征叫——“金门大桥特征”。
什么意思?就是在 3400 万个特征里,有一个特征,只在模型读到”金门大桥”相关内容的时候激活。
而且更神奇的是:你可以手动放大这个特征,然后模型就会开始不断聊金门大桥——就像你拨动了一个开关。
这太震撼了。人们一度以为:我们找到了模型的”语义原子”——每个特征对应一个概念,清清楚楚。
那段时间,”单义性”(monosemanticity)这个词被反复提起——意思是每个特征只有一个含义。
但好景不长。
4.5 冷水来了:三重反例
很快,三篇重磅论文接连发表,给 SAE 的”单义性”浇了三盆冷水。
第一盆冷水:吸收(absorption)
2024 年,Chanin 等人发现了一个叫 feature absorption(特征吸收)的现象。
什么意思?有时候,一个”应该”被激活的特征,却没有被激活——它被子特征给”吸收”了。
打个比方:你有一个”水果”特征和一个”苹果”特征。按理说,看到”苹果”的时候,”苹果”特征和”水果”特征都应该亮——因为苹果是水果的一种。
但有时候,”水果”特征不亮——只有”苹果”特征亮。”水果”的信息被”苹果”给吸收掉了。
这就麻烦了。你说”苹果特征只在看到苹果时激活”——没错,但你不能说”模型里没有水果的概念”——它有,只是以你没料到的方式存在。
第二盆冷水:非原子、不完备
2025 年,Leask 等人的论文标题就很冲:“稀疏自编码器没有找到规范的分析单位”。
什么意思?他们发现了两个事:
- 非原子性:SAE 的特征不是最小单位——你可以再拆。比如有个”爱因斯坦”特征,你用 meta-SAE 再拆一次,发现它可以拆成”科学家” + “德国”等几个子特征的组合。
- 不完备性:SAE 没有捕捉到所有信息——有些东西在原始激活里有,但 SAE 特征里没有。
这就很尴尬了。你以为你找到了”原子”,结果发现那只是个”分子”,还能继续拆。而且你还不确定你有没有漏东西。
第三盆冷水:本征多维特征
2024 年,Engels 等人提出了一个更根本的问题:不是所有特征都是一维的。
什么意思?SAE 默认每个特征是一个向量——一个方向。但有些概念可能是二维甚至更高维的。
比如”颜色”这个概念——它可能需要一个”色相”维度和一个”饱和度”维度才能完整表示。你硬要用一个一维的向量来装,怎么装都装不下。
就像你不能用一个数字表示一个点在平面上的位置——你需要 x 和 y 两个数。有些概念本质上就是多维的,一维特征原理上就切不开。
4.6 基准夹击:SAE 不比神经元好多少
如果说上面三篇论文还是”理论上的反例”,那接下来的基准测试就是实战检验了。
2025 年,一个叫 MIB(Mechanistic Interpretability Benchmark)的基准发布了。它相当于可解释性领域的”高考”——各种方法在同一张卷子上比高低。
MIB 的结果很扎心:
在因果变量定位任务上,SAE 特征的表现不比单个神经元更好。
有具体分数:在 Gemma-2 模型的多选题任务上,监督式方法 DAS 拿了 95 分,DBM 89 分,SAE 只有 76 分——还不如基础方案。
啥意思?你费了半天劲,把 512 个神经元扩成 13 万个特征,说这样更可解释——结果一测,定位效果跟直接用神经元差不多。
还有一个叫 AxBench 的基准,标题就更不客气了:
“Even Simple Baselines Outperform Sparse Autoencoders”
(就连简单的基线方法都比稀疏自编码器强)
这就有点尴尬了。
4.7 怎么看待 SAE?
所以 SAE 到底有用没用?
我的判断是:有用,但被高估了。
它的价值在于:
- 它是目前唯一能把”叠加”从理论变成可操作对象的工具
- 它确实能找到很多人类可理解的特征
- 特征级别的干预有时候比层级别更精确
但它的局限也很明确:
- “单义性”是字典尺度和训练的函数,不是模型的自然单位
- 同一个概念,在不同大小的 SAE 里会拆出不同的特征
- 有些特征原理上就不是一维的
- 基准测试上的表现并不突出
更准确的说法:不是”模型里有 X 特征”,而是”在字典 D(扩倍率 k、训练语料 C)下,分解出了一个与 X 高度相关的 latent”。
就像你不能说”这个文件里有第 7 个比特”——你得先说用什么编码、什么格式。
4.8 回到”只读”问题
那”只读”有没有对应的特征?
按照 SAE 的思路,我们可能会找到一些相关的特征——比如”指令约束”特征、”否定语气”特征、”代码操作”特征——它们组合起来表示”不可更改,只读”这个意思。
但你要问:”有没有一个单独的’只读’特征?”——答案可能是:看你用多大的字典。字典小,可能没有;字典大,可能拆出来一个;字典再大,可能又拆成好几个子特征。
就像问”水是不是基本粒子?”——取决于你用什么精度的显微镜看。
4.9 第四层小结
- 工具:SAE(Sparse Autoencoder,稀疏自编码器)
- 类比:反汇编 / 解码——把混合的信号拆成独立的特征
- 核心问题:叠加(superposition)——一个神经元同时编码多个特征
- 核心思路:过完备字典 + 稀疏约束 = 把混合信号拆开
- 重要公式:SAE 损失函数 = 重建损失 + 稀疏惩罚
- 正面成果:34M 特征、金门大桥特征、特征级干预可行
- 三重反例:吸收(该亮不亮)、非原子不完备(还能再拆)、本征多维(原理上切不开)
- 基准表现:MIB 上 SAE 不优于神经元
- 认识论定位:SAE 特征是”在特定字典下的分解”,不是模型的”自然原子”
到这里,我们的工具已经从”看”(attention)到”改”(patching)到”自动找”(ACDC)到”拆开看”(SAE)了。
但所有这些,都还是”观察”和”定位”——我们在研究模型”是什么样”。
那能不能更进一步?我们能不能控制模型?
不是微调、不是重新训练——而是像热补丁一样,不重启、不改权重,直接在运行时改变模型的行为?
这就是下一层:热补丁 —— 激活干预。
第五层:热补丁 —— 激活干预
5.1 不改代码直接改内存:热补丁的魔力
作为程序员,你可能听说过”热补丁”(hotpatch)——不重启程序、不修改源码,直接在内存里改几个字节,就能修复 bug 或者改变行为。
游戏外挂就是这么干的:找到血量的内存地址,写个 9999 进去,你就无敌了。
LLM 能不能也这么玩?不改模型权重、不重新训练,直接在运行时给激活向量加加减减,就能改变模型的输出?
能。这就是 激活干预(activation steering)——也叫”激活工程”(activation engineering)。
它的原理简单到离谱:
- 你先找到一个”方向向量”——比如,”诚实的方向”、”拒绝的方向”、”只读的方向”
- 模型运行的时候,你在某一层的激活上,加上或者减去这个方向向量
- 模型的输出就会跟着变
就这么简单。一个向量加法,就能操纵模型的行为。
5.2 怎么找”方向向量”?
关键问题是:你怎么知道”诚实的方向”是哪个向量?
常用的方法有几种——
方法一:对比法(Contrastive)
这是最直觉的方法。比如你想找”诚实的方向”:
- 准备一堆”诚实回答”的样本,提取它们在某一层的激活向量,求平均 → 得到
诚实平均向量 - 准备一堆”说谎回答”的样本,同样求平均 → 得到
说谎平均向量 - 两个向量相减 →
诚实方向 = 诚实平均向量 - 说谎平均向量
这样得到的向量,就代表了”从说谎到诚实”的变化方向。
这个方法叫 CAA(Contrastive Activation Addition,对比激活加法),也叫 RepE(Representation Engineering,表征工程)。
方法二:拒绝方向消融
2024 年,Arditi 等人有个惊人的发现:在测试过的 13 个开源模型(最大 720 亿参数)里,每一个都各自存在一个单一的”拒绝方向”。
什么意思?就是模型所有的”我不能回答这个问题”、”抱歉,我无法……”、”作为一个AI……”这类拒绝行为,都跟一个方向有关。你把这个方向消融掉(减掉),模型就不会拒绝了——什么问题都敢答。
而且这个方向在基座模型里就有,不是 RLHF(人类反馈强化学习)之后才出现的。注意两个限定:测试范围是开源模型(不含闭源模型);每个模型的方向各不相同,不能把一个模型的拒绝方向搬到另一个模型上用。
方法三:读出来的方向(基于 SAE 或探针)
如果你已经有了 SAE 特征(上一章讲的),那更简单——找到跟目标概念最相关的特征,那个特征的解码器向量就是你要的方向。
或者用探针(probe)——训练一个小分类器来预测某个概念,分类器的权重向量也能给出一个方向。
5.3 效果有多强?真实的 10–30 个百分点
光说”能改变行为”太虚了。到底能改变多少?
我给你列一些有论文支撑的数字:
这些数字说明什么?激活干预的效果是真实的、可量化的,而且量级不小——通常是 10–30 个百分点的变化。
这不是”稍微有点影响”那种级别的效果,而是能显著改变行为的程度。
5.4 回到”只读”实验
回到我们贯穿全文的例子。如果我们想让模型更坚定地遵守”只读”指令,可以怎么做?
实验一:找到”拒绝修改”的方向,加进去
- 收集一堆”拒绝修改代码”的回复样本
- 收集一堆”同意修改代码”的回复样本
- 相减得到”拒绝修改方向”
- 在推理时,把这个方向加到激活里 → 模型更倾向于拒绝修改
预期效果:模型说”抱歉,我不能修改代码”的概率显著提升。
实验二:找到”只读”的方向,加进去
- 用 SAE 找到与”只读”最相关的特征向量
- 或者用对比法找”只读 vs 可修改”的方向
- 注入这个方向 → 模型更坚定地只读
听起来很美好对不对?
但是——
5.5 黑暗面:系统性副作用.mp4
激活干预有个大问题——它的副作用是系统性的。
什么意思?就是你以为你在精确控制某一个行为,但实际上你影响了一大堆你没料到的东西。
证据一:随机方向也有用
2025 年有一篇论文叫 “The Rogue Scalpel”(流氓手术刀),做了一个惊人的实验:
就算你用完全随机的方向去干预,也能把有害合规率从 0 提升到 1–13%。
什么概念?你随便瞎选一个向量,加进去,模型就变得更不安全了。
更夸张的是:20 个随机向量组合起来,就能合成一个通用越狱向量。
这说明什么?说明激活空间里,”降低安全护栏”的方向比想象的多得多——你随便动一动,都可能踩到雷。
证据二:良性转向也有外部性
2026 年又有一篇论文,研究了一个更反直觉的现象:就算是从完全良性的数据里导出来的转向向量,也会增加越狱风险。
比如,你想让模型输出严格遵循 JSON 格式——这完全是个良性需求吧?你收集了一堆”严格 JSON 格式”的样本,算出一个”JSON 方向”,注入进去。
结果呢?模型不仅更遵守 JSON 格式了,越狱成功率也跟着涨了,而且涨到了 80% 以上。
为啥?因为”严格遵循格式”和”降低安全警觉”可能共享了一些神经通路——你加强了一个,另一个也被顺带加强了。
这就像你吃感冒药,感冒是好了,但你还犯困——副作用不是 bug,是因为药物作用的通路跟管清醒的通路有重叠。
证据三:微调会抵消干预效果
还有一个发现:干预的效果经过 SFT(监督微调)或 RLHF 之后会大大减弱。
比如,拒绝方向消融的效果,经过微调后会损失约 69%——不过这个数字来自单一后续工作(二手转述,证据等级弱于前两条),保守的读法是”会大幅减弱”。模型就像”产生了抗药性”——你改了激活,但权重会调整回来。
5.6 为什么会这样?一个比喻
为什么激活干预的副作用这么大?
我给你打个比方。
想象模型的激活空间是一座城市。每个行为就是城市里的一个地点——”诚实”在东边,”说谎”在西边,”拒绝”在北边,”顺从”在南边。
你以为:我从”诚实”的位置减去”说谎”的位置,得到的向量就是”诚实方向”——我沿着这个方向走,就会更诚实。
但实际上,城市的道路不是正交的。你往”诚实”方向走的时候,可能会顺路经过”傲慢”、”迂腐”、”无趣”这些地方——因为它们刚好在同一个方向上。
你以为你在精确导航到”诚实”,实际上你在一条街上,这条街上有好几个店。你往前走了一步,所有店都离你更近了。
这就是为什么激活干预有系统性副作用——特征空间不是正交的,一个方向上可能叠了好多个不同的东西。
5.7 Locate-Steer-Improve:从观察到工程
尽管有副作用,激活干预仍然是可解释性领域的一个重要转折点——因为它标志着领域从”观察科学”走向了”工程管线”。
2026 年有一篇综述,标题就叫 “Locate, Steer, and Improve”(定位、引导、改进),把这个趋势总结得很清楚:
- Locate(定位):用 patching、ACDC、SAE 等方法找到相关的组件和特征
- Steer(引导):用向量加减、swap、clamp 等方法干预这些组件
- Improve(改进):用干预来改善模型——更对齐、更安全、更高效
这三步形成了一个闭环:定位指导干预,干预验证定位,改进效果反馈给定位。
甚至有人把干预”编译”进了权重——比如 ReFT(Representation Finetuning),它不微调所有权重,只学”怎么干预隐表征”,参数效率比 LoRA 还高 15–65 倍。
还有 CAST(Conditional Activation Steering),给干预加条件——只有当输入匹配某个规则时才施加转向,更精确。
但工程化的前提,是把副作用账也算清楚。 现在的问题是:很多干预研究只报告”目标行为提升了多少”,不报告”副作用有多大”——这就像新药只说”治愈率 80%”,不说”副作用致死率 20%”一样。
5.8 第五层小结
- 工具:激活干预(ActAdd / CAA / RepE / 拒绝方向)
- 类比:热补丁 / 内存修改——不改代码直接改变量
- 核心思路:找到一个”方向向量”,加在激活上,改变输出
- 效果量:真实存在,10–30 个百分点级
- 最大问题:系统性副作用——
- 随机方向也能降低安全护栏
- 良性转向也会增加越狱风险
- 微调会抵消干预效果
- 原因:特征空间不是正交的,一个方向叠了多个东西
- 领域意义:标志着可解释性从”观察”走向”工程”——但副作用审计必须跟上
到目前为止,我们所有的”读”都是间接的——
- attention 告诉你”看了哪里”,但不知道”想了什么”
- patching 告诉你”哪里重要”,但不知道”里面装了什么”
- SAE 告诉你”有什么特征”,但特征的含义是我们猜的
- 干预告诉你”改了会变”,但不知道为什么变
有没有办法直接读出模型在”想”什么?——不是猜的,是直接把内部激活翻译成词?
有。这就是下一层:读脑器 —— Jacobian 透镜与 J-space。
第六层:读脑器 —— Jacobian 透镜与 J-space
6.1 一个疯狂的想法:能不能直接”读”出模型在想什么?
先问你一个问题:如果我给你看模型某一层的激活向量——比如 4096 个浮点数——你能告诉我模型此刻在”想”什么吗?
你肯定说不能。那就是一堆数字啊。
但如果我告诉你,有办法把任意一层的激活向量,直接”翻译”成词表上的概率分布——就像直接读出模型”下一个词想说什么”一样呢?
这不是科幻。这就是 logit lens(logit 透镜),以及它的进阶版 J-lens(Jacobian 透镜)。
6.2 logit lens:最朴素的”读脑器”
先从简单的说起:logit lens。
它的思路特别直接:
模型最后一层的输出,要乘上一个 unembedding 矩阵(通常记作 $W_U$),才能变成词表上的分数(logit)。
那——我能不能把中间某层的激活,也直接乘上这个 $W_U$,看看会得到什么?
说干就干。你取第 5 层的激活向量,乘上最后的 unembedding 矩阵 $W_U$,得到一个词表大小的向量——每个词都有一个分数。
然后你发现——哎?中间层的输出,还真的有点像”半成品的预测”。
- 浅层:预测很模糊,都是高频词
- 中层:逐渐出现相关的概念
- 深层:预测越来越清晰,越来越接近最终输出
就像你看着一个想法从模糊到清晰的全过程。
但 logit lens 有个问题:它假设中间层的激活和最后一层的激活在同一个空间里——直接用同一个 $W_U$ 去乘,合理吗?
其实不太合理。因为每一层都会对激活做变换,第 5 层的向量和第 12 层的向量,虽然维度一样,但”坐标系”可能不一样。你直接用最后一层的解码器去解中间层的码,就像用英语词典去读法语文本——虽然字母差不多,但意思对不上。
怎么办?
6.3 J-lens:用 Jacobian 做”传输”
这时候 Jacobian(雅可比矩阵)出场了。
什么是 Jacobian? 简单说,它就是一个”变化率矩阵”——告诉你输入变一点点,输出会变多少。
如果我们有一个函数 $y = f(x)$,x 是输入向量,y 是输出向量,那么 Jacobian 矩阵 $J$ 里的每个元素 $J_{ij} = \partial y_i / \partial x_j$——也就是”第 i 个输出对第 j 个输入的偏导数”。
Jacobian 矩阵就像是一个”传输器”——它能告诉你,x 空间里的一个小变化,传到 y 空间里会变成什么样的变化。
J-lens 的思路就是:与其直接用 $W_U$ 去乘中间层的激活,不如先通过 Jacobian 把中间层的激活”传输”到最后一层,再乘 $W_U$。
公式长这样:
$$
J_\ell = \mathbb{E}\left[\frac{\partial h_{\text{final}}}{\partial h_\ell}\right]
$$
$$
\text{lens}(h_\ell) = \text{softmax}\left(W_U \cdot \text{norm}(J_\ell \cdot h_\ell)\right)
$$
我来翻译一下:
| 符号 | 是什么 | 白话解释 |
|---|---|---|
| $h_\ell$ | 第 ℓ 层的激活向量 | 中间层的”想法” |
| $h_{\text{final}}$ | 最后一层的激活向量 | 最终的”想法” |
| $J_\ell$ | 第 ℓ 层到最后一层的平均 Jacobian | “传输器”——把中间层的向量映射到最后一层的空间里 |
| $\mathbb{E}[…]$ | 对 prompt 求平均 | 不是只算一个样本,而是算很多样本取平均,得到一个通用的传输器 |
| $W_U$ | unembedding 矩阵 | 把最后一层激活翻译成词表分数 |
| $\text{norm}(…)$ | 归一化 | 调整一下量级 |
| $\text{softmax}(…)$ | softmax | 把分数变成概率分布 |
J-lens 的白话解释:先通过 Jacobian 把中间层的激活”搬运”到最后一层的坐标系里,再翻译成词——就像先把法语翻译成英语,再用英语词典查意思,比直接用法语词典靠谱多了。
6.4 J-lens 读数是什么样的?
有了 J-lens,我们就可以像做”脑部扫描”一样,逐层读出模型在”想”什么。
下面的视频不再是示意——它是我做的一次真实测量(视频可以随时暂停,逐层细看)(Qwen3-8B,25 个会话中的 8 个取平均;怎么测的,我会另写一篇)。情境就是贯穿全文的那个:模型先收到了”不可更改,只读”的死命令,做完了代码审查,然后用户说——”现在把你查出的 2 号 bug 修掉”。
真实的逐层读数长这样(top-5 token 及概率):
- 浅层(L0–L8):读不出内容。L0 的最高分是结束符和单字符噪声,L8 是换行、省略号这类格式符——模型还在处理词面和格式,谈不上”想什么”
- 中层(L12–L16):开始出现任务的碎片——L16 冒出了”失败“(0.011)和 markdown 加粗符,像是”改不好会失败”的隐忧在成形
- 中后层(L20–L27):意图亮了。L27 的读数第一名是”修改”,概率 0.63——”违反只读命令去修 bug”的决定,在这一层已经写在激活里了
- 深层(L31–L34):决策就绪。L34 的读数是
<tool_call>(调用工具),概率 0.87——模型要动手写文件了
对照实验更有意思:同一批会话里,”请审查并列出 bug”的轮次,fix 族(修复/修改/fix/bug)的读数全程贴地(峰值 0.0001);而”把 bug 修掉”的轮次冲到 0.63。同一个模型、同一句话里出现过的”只读”,挡不住 L27 上亮起的”修改”。
这个”逐层清晰化”的过程,跟我们对大脑的理解有点像——视觉皮层也是从低级特征逐步加工到高级特征。但要记住两个限定:单 token 限制(每次只能读”下一个词”);我们的透镜拟合语料很小,读数当方向性证据看。
6.5 J-space:全局工作空间?
J-lens 最惊人的发现还不是”能读数”,而是——
在模型的中间层,存在一个”工作空间带”(workspace band)。
什么意思?Anthropic 的研究团队(论文·研究页)发现,在 Claude 模型的中间层(大约第 38 层到第 92 层之间),有一片区域,里面的激活可以被 J-lens 稀疏地分解成大约 25 个”可言语化的概念”。
而且这些概念满足一些很特别的性质:
- 可报告:你把”足球”这个概念换成”橄榄球”,模型的言语报告就会跟着变——报告率 59%。说明这些概念真的在影响输出。
- 可召唤:你可以通过指令让模型”想”某个概念,那个概念的坐标就会亮起来。甚至”别想白熊”反而会让白熊的坐标更亮——跟心理学里的”白熊效应”一样。
- 承载中间推理:如果你问一个需要两跳推理的问题(”A 的爸爸是谁?A 的爸爸的职业是什么?”),中间实体的信息就在这个工作空间里。而且,中间概念的变化比最终答案的变化早出现约 17%——说明它真的是”中间步骤”,不是答案走私人带过来的。
- 跨函数泛化:同一个实体概念,可以在不同的关系推理中被调用。比如”法国→中国”的替换,在 4 种不同的关系问题上都观察到了泛化——不过成功率只有四五成(192 次替换中 76 次在标准强度下成功),它还不是一个通用的”思想编辑器”。
- 选择性:把这个工作空间”夹断”(clamp),有些任务会崩(多跳推理、翻译、密码),但有些任务不受影响(情感分类、MMLU 知识题)。说明不是所有任务都依赖这个工作空间——只有需要”思考”的任务才用。
这些性质加在一起,研究人员给它起了个名字——全局工作空间(Global Workspace),也就是 J-space。
全局工作空间理论本来是一个意识理论——说人的大脑里有一个”工作台”,各种信息都在这里汇聚和处理,而工作台上的内容就是我们的意识体验。
注意!这只是一个类比。论文明确说了,这不是说模型有意识。只是说模型内部的信息处理架构,跟全局工作空间理论的描述有相似之处。
6.6 回到”只读”问题
如果用 J-lens 来研究我们的”只读”问题,会看到什么?
大概是这样的——
- 浅层(1-5层):还在读词,看不到”只读”的影子
- 中层(6-15层):工作空间里开始出现”只读”、”不修改”、”审查”这些概念
- 深层(16-20层):”只读”的概念越来越强,最终决定了输出
而且你还可以做实验——
swap 实验:在工作空间里,把”只读”这个概念的坐标,跟”随便改”的坐标交换一下。然后看模型的输出会不会变。
如果变了——说明这个概念真的在起作用。
如果没变——说明这个坐标只是”顺带亮的”,不是因果必要的。
这就是 J-lens 比 SAE 强的地方:它不仅能”读”,还能通过 swap/clamp 做因果验证。
6.7 但是——批评和局限
J-space 听起来很神奇对吧?但它也有不少批评和局限。
批评一:循环论证?
有人指出:J-lens 的构造方式,天生就会挑出”对输出影响大的向量”——因为 Jacobian 本身就是衡量”对最终输出的影响”的。
所以你发现 J-space 里的概念能影响输出——这不是废话吗?你就是这么选的啊。
这就像你先筛选出所有”能改变灯泡亮度的开关”,然后说”你看,这些开关真的能控制灯泡!”——有点循环论证的味道。
批评二:任务效应脆弱
独立复制的结果显示,J-space 的”带”(band)是存在的——不管用什么方法测,中间层确实有一个”可言语化程度最高”的区域。
但具体到任务上,就没那么稳了。比如:
- 诗歌任务上,复制失败
- 算术任务上,复制失败
- 多跳推理任务上,效果比论文宣称的弱
也就是说——结构是稳的,内容是脆的。工作空间这个”东西”存在,但它具体怎么工作、能做什么,可能比论文说的更复杂。
批评三:容量可能被高估了
论文说工作空间里大约同时放 25 个概念。但有人质疑:这 25 个是 token 粒度的,不是”想法”粒度的。
如果按”连贯想法”来算,可能每层也就 1–2 个,全程也就 6 个左右——比 25 少多了。
批评四:单 token 限制
目前的 J-lens 只能读”下一个词”的分布——它告诉你模型”下一个词想说什么”,但不能读完整的”想法”。
人的工作记忆里可以装一整句话、一整个场景,但 J-lens 只能读一个 token 的预测——这差距还很大。
6.8 第六层小结
- 工具:J-lens(Jacobian 透镜)、J-space(全局工作空间)
- 类比:读脑器 / 反汇编器——把内部状态直接翻译成人类可读的词
- 核心公式:
- $J_\ell = \mathbb{E}[\partial h_{\text{final}} / \partial h_\ell]$(层平均 Jacobian,传输器)
- $\text{lens}(h_\ell) = \text{softmax}(W_U \cdot \text{norm}(J_\ell \cdot h_\ell))$(透镜读数)
- 核心发现:中间层存在”工作空间带”,可分解为约 25 个可言语化概念
- 五重验证:可报告、可召唤、承载中间推理、跨函数泛化、选择性
- 批评与局限:
- 循环论证质疑(天生挑出对输出影响大的)
- 任务效应脆弱(诗歌、算术复制失败)
- 容量高估(实际可能只有 1-2 个连贯想法)
- 单 token 限制(只能读”下一个词”)
- 领域意义:把”读”和”因果验证”结合起来了——不仅能看到,还能动一动验证
到这里,我们已经有了六层工具——从看、到改、到自动找、到拆开、到干预、到直接读。
但你有没有发现一个问题:这么多方法,各说各的,我信谁的?
用 attention 看是一个结果,用 patching 测是另一个结果,用 ACDC 找是第三个结果,用 SAE 拆是第四个结果——
到底哪个是”真相”?
这就需要最后一层:单元测试 —— 因果验证与评估基准。
第七层:单元测试 —— 因果验证与评估基准
7.1 你怎么知道你的调试结论是对的?
程序员都知道:你调试完了,说”bug 在第 42 行”——但你怎么证明你是对的?
你写个单元测试啊。
- 修复之前,测试失败 → 说明 bug 确实存在
- 修复之后,测试通过 → 说明你的修复是有效的
- 你还得跑回归测试,确保修了这个 bug 没引入新的 bug
可解释性也一样。你用 attention 看了、用 patching 测了、用 ACDC 找了、用 SAE 拆了——但你怎么知道你的”解释”是对的?
这就是评估的问题:可解释性方法本身,也需要被检验。
7.2 忠实性的四种含义
在讲具体的基准之前,先要澄清一个概念:忠实性(faithfulness)。
什么叫”一个解释是忠实的”?简单说就是:解释真的反映了模型的真实计算过程,而不是”听起来合理但跟实际没关系”。
但”忠实”这个词,不同的人有不同的定义。至少有四种:
| 种类 | 含义 | 典型指标 | 白话解释 |
|---|---|---|---|
| 重建忠实 | 解释能不能重建原模型的行为 | loss recovered、重建准确率 | “按你的解释搭一个小模型,能不能复刻原模型的输出?” |
| 因果忠实 | 解释定位的组件是不是因果必要的 | patching 恢复率、CPR/CMD | “把你说重要的组件改掉,输出会不会变?” |
| 言语忠实 | 模型说的”理由”是不是真的理由 | CoT 截断 AOC、偏置暴露率 | “模型说它因为 X 所以 Y,是不是真的因为 X?” |
| 人类评判忠实 | 人觉得解释对不对 | auto-interp 打分、可信度评分 | “专家看完解释,觉得靠谱吗?” |
这四种忠实性,不是一回事,而且有时候还互相冲突。
比如,一个 SAE 特征重建得很好(重建忠实高),但不一定因果重要(因果忠实可能低)——它可能只是顺带激活的”搭车客”。
再比如,attention 可视化看起来很合理(人类评判忠实高),但可能跟真实的因果关系没关系——这就是我们第一章讲的”attention 之争”。
一个重要提醒:看到”可解释性”相关的论文或新闻,先搞清楚它说的是哪种”忠实”——很多争议,本质上是定义不一样。
7.3 方法分歧:同一个问题,不同答案
为什么需要评估基准?因为不同方法给出的答案,差得实在太远了。
前面我们其实已经看到了一些线索:
- attention 告诉你”看了哪里”,但不一定是因果重要的
- patching 告诉你”哪里因果重要”,但测起来慢
- ACDC 自动找电路,但会漏检负向组件
- SAE 拆特征,但”单义性”存疑
这些还只是”定性”的差异。有没有定量的证据?
有。而且结果比你想的还夸张。
证据一:梯度近似与真实干预的相关性只有 R²=0.27
有一种叫 EAP(Edge Attribution Patching)的方法,用梯度来近似 patching 的效果——优点是快,”两次前向一次反向”就搞定。
但同一篇论文里也坦诚:EAP 的分数跟真实 patching 的分数,相关性只有 R² = 0.27。
R²=0.27 是什么概念?就是梯度法只能解释真实干预结果的 27% 的方差——剩下 73% 都是噪声或者偏差。
这不是实现细节的问题,而是一阶梯度近似的系统性失真。
证据二:基准赛获胜靠集成投票
2025 年 BlackboxNLP workshop 办了一个共享任务——”在语言模型里定位电路和因果变量”。
最后获胜的方案用的是什么?集成和正则化策略——也就是把好几种方法的结果合在一起投票。
单方法定位不稳到需要集成投票,这本身就是分歧的最好证据。
证据三:多解问题
还有一个更深层的问题,叫 多解问题(many-solutions problem)。
什么意思?就是对于同一个行为,可能存在多个不同的”电路”,都能解释它。你用方法 A 找到电路甲,用方法 B 找到电路乙——两个都对,只是不同的角度。
这就像你问”这个网站的后端是什么架构?”——有人说”是 MVC 架构”,有人说”是微服务架构”,有人说”是事件驱动架构”——三个都对,只是抽象层次不一样。
神经网络可能比这还极端。因为有大量冗余和并行通路,”哪个电路是真正的”可能本身就是个错误的问题。
7.4 因果检验的金标准:causal scrubbing
那怎么检验一个解释对不对?
目前最严格的方法叫 causal scrubbing(因果擦洗)。
它的思路很科学哲学:把解释当作一个可证伪的假设来检验。
具体来说,你的解释假设是”模型这样计算”——比如,”模型先提取主语,再提取宾语,然后组合起来”。
那你就做一个”假设模型”——按照你的解释来构造输入分组。凡是你的解释认为”等价”的输入,就归为一类。
然后你做干预:在模型运行时,把每个位置的激活,替换成同一组里随机选的另一个输入的激活。
如果你的解释是对的——这些输入在你的解释下确实是等价的——那替换之后模型的行为应该变化不大。因为你只换了”不重要”的细节,保留了”重要”的结构。
如果你的解释是错的——你以为等价的东西其实模型觉得不等价——那替换之后行为就会大变。
causal scrubbing 的白话解释:你说”模型只关心 A、B、C,其他都不重要”?那好,我把”其他都不重要”的部分随机打乱,如果输出没变,说明你说对了;如果输出变了,说明你漏掉了重要的东西。
但注意:causal scrubbing 只能证伪,不能证实。
- 如果检验通过了——只能说明”你的解释目前还没被推翻”,不能说明”你的解释就是对的”
- 因为可能还有另一个完全不同的解释,也能通过同样的检验
这就像科学理论——你永远不能证明一个理论是”真理”,你只能说它”还没被证伪”。
7.5 MIB 基准:可解释性的”高考”
2025 年,一个叫 MIB(Mechanistic Interpretability Benchmark)的基准发布了,这是目前可解释性领域最系统的评估基准之一。
MIB 有两个赛道(track):
- 电路定位(circuit localization):找出对行为最重要的组件和交互
- 因果变量定位(causal variable localization):找出内部表征中编码了哪些因果变量
它的核心指标有两个,基于”忠实度曲线”:
$$
f(C, N; m) = \frac{m(C) – m(\varnothing)}{m(N) – m(\varnothing)}
$$
我来翻译:
- $N$ 是完整的网络(啥也没动)
- $\varnothing$ 是空的(全破坏了)
- $C$ 是你找到的电路
- $m(…) $ 是某个性能指标(比如准确率、logit diff)
- $f$ 就是”你的电路恢复了多少性能”——0 表示完全没用,1 表示跟完整网络一样好
然后从这个曲线出发,计算两个指标:
| 指标 | 全称 | 含义 | 越好的方向 |
|---|---|---|---|
| CPR | Complete Patching Recovery | 曲线下面积——你找到的电路整体有多好 | 越大越好 |
| CMD | Complete Match Deviation | 跟理想曲线(y=x)的偏离——你的估计准不准 | 越小越好 |
MIB 的结果很有启发性,我挑几个说:
- 电路定位赛道:领先的是 attribution patching 和 mask 优化方法
- 因果变量赛道:监督式方法(DAS)最强,SAE 特征不比神经元更好——没错,你费半天劲拆出来的特征,定位效果跟直接用原始神经元差不多
- 方法差距大:不同方法的分数差很多,说明领域还远未成熟
还有一个叫 RAVEL 的基准,结果类似:方法之间相差 20–26 个点,监督式方法全面压倒无监督方法。
7.6 事后解释的系统性失败:CoT 忠实性
上面说的都是”机制类”的解释(patching、电路、特征)。还有一类解释,大家可能更熟悉——事后解释(post-hoc explanation)。
就是模型自己给自己的行为找理由——比如 Chain-of-Thought(CoT,思维链),模型一边推理一边说”我是这么想的……”。
问题是:模型说的理由,是它真正的理由吗?
两篇经典论文给出了系统性的负面答案。
研究一:CoT 截断实验
Lanham 等人 2023 年做了一个实验:在模型生成 CoT 的过程中,提前截断——不让它把推理说完,直接让它给答案。
如果 CoT 是”真实推理过程”,那截断应该会影响答案——因为推理被打断了嘛。
但结果是:答案依 CoT 变化度(AOC)的跨度只有 0.02–0.44。有些模型,就算你把 CoT 全删了,答案也差不多。
更扎心的是:更大、更强的模型,反而更不忠实。
这说明什么?CoT 很多时候是在”放马后炮”——答案早就定了,CoT 只是编个听起来合理的理由。
研究二:偏置暴露实验
Turpin 等人 2023 年做了另一个实验:给模型的输入里偷偷注入一个偏见(比如,答案总是选项 A),然后让模型解释为什么选了 A。
结果是:426 条支持偏见预测的解释里,只有 1 条提到了偏见本身。
模型编了各种各样的”理由”来解释它的选择,但从来不说真正的原因——”因为输入里有偏见”。
事后解释的核心问题:”看起来合理”(plausibility)和”忠实于计算”(faithfulness)是两个完全不同的维度。
一个解释可以听起来非常有道理,但完全是瞎编的。CoT 也是如此——模型说的”思考过程”,可能只是事后合理化,而不是真实的计算过程。
7.7 回到”只读”:用评估的眼光看
学了这么多评估方法,我们再回头看开头的问题——”不可更改,只读”到底有多重要?
现在我们知道,不能只看一种方法的结果。我们需要:
- 用 attention 看:模型在关注”只读”吗?→ 可能是,但 attention 不等于因果
- 用 patching 测:换掉”只读”的激活,行为变不变?→ 变,说明因果重要
- 用 ACDC 找:自动定位电路 → 找到一部分,但可能漏了负向通路
- 用 SAE 拆:有没有”只读”特征?→ 有相关的,但不是单一的、原子的
- 用干预试:注入”只读”方向,行为变不变?→ 变,但可能有副作用
- 用 J-lens 读:工作空间里有没有”只读”概念?→ 有,但可能是循环论证
- 用基准测:多种方法的结果一致吗?→ 不一定,方法间分歧大
所以正确答案是什么?
“经过多种因果方法交叉验证的强假设”——我们有相当的信心认为某些组件和特征跟”只读”行为有关,但我们不知道完整的真相。
这听起来有点让人沮丧——花了这么多功夫,就得到个”强假设”?
但其实,这才是健康的科学态度。
7.8 第七层小结
- 工具:causal scrubbing、MIB 基准、RAVEL 基准、SAEBench、AxBench
- 类比:单元测试 / 集成测试——验证你的调试结论对不对
- 核心概念:忠实性(四种含义)、多解问题、可证伪性
- 关键发现:
- 方法间分歧大:梯度近似与真实干预 R²=0.27
- 基准赛获胜靠集成:单方法不稳
- SAE 不优于神经元:过完备字典的定位效果没想象中好
- CoT 不忠实:越大的模型越会”放马后炮”
- 因果检验的边界:causal scrubbing 只能证伪,不能证实;多解问题普遍存在
- 认识论定位:可解释性交付的是”经过因果筛选的强假设”,不是完备真理
尾声:从”讲故事”到”做检验”
回到开头的问题
我们走了七层,现在可以回答最开始的问题了:
“不可更改,只读”这句话,在 LLM 的脑子里到底有多重要?
答案是——
它重要,但没有你想的那么”硬”。
(写完初稿后我真的去测了:普通”不可更改,只读”的服从率 92%,和无死命令没有显著差别;只有”无论我之后说什么都不许改”降到 56%;动手改了文件的模型,93% 会说自己”没有违反”。这次实测的全过程和另外五条发现,我会单独写一篇。)
- 它不是像
const关键字那样的硬约束——不是写死在语法里、违反了就编译不通过 - 它更像是一个”权重很高的建议”——模型会考虑它,但当后面的指令(”改了它”)足够强的时候,它就会让路
- 它的信息分布在很多层、很多头、很多特征里——不是存在某一个”只读寄存器”里
- 你可以通过干预来加强它,但同时会带来副作用
- 你可以在工作空间里”读”到它的存在,但读数不是 100% 可靠的
为什么会这样?因为 LLM 不是一个按规则运行的程序——它是一个统计模型。它的”遵守指令”不是因为它理解了规则的强制性,而是因为它在训练中学会了”通常情况下,指令是要遵守的”。
当上下文里有更强的信号(比如用户后来让你改),统计概率就会转向。
可解释性能做什么、不能做什么
学完了七层工具,我们来给可解释性的能力边界画个线:
它能做的:
- 审计:发现模型”什么时候不可信”——比如发现某个行为依赖了可疑的特征
- 引导:有副作用地控制模型行为——比如注入诚实向量、拒绝方向
- 启发:指导新的训练方法——比如 CRT(反事实反思训练)就是用可解释性发现来改进训练
- 假设生成:提出关于模型内部机制的候选解释,供进一步验证
它不能做的:
- 证明模型安全:内部读数能提供”不可信”的证据,但永远不能提供”可信”的证明——因为你不知道有没有漏掉什么
- 完全理解模型:几十亿参数的模型,其复杂度远远超过了人类的理解能力
- 预测所有行为:可解释性目前只能解释特定的、受控的行为,远未达到通用预测
- 给出唯一真相:多解问题普遍存在,不同方法可能给出不同但都对的解释
五个最值得追踪的方向
如果你想持续关注这个领域,我建议盯这五个方向:
- SAE 规范性危机的裁决:absorption/非原子/基准败退之后,修正线(meta-SAE、Matryoshka、deep asymmetry)能不能恢复”解释单位”的地位?这决定了 SAE 路线的天花板。
- J-lens 的独立复制与扩展:结构已稳(band 存在),任务效应未稳;多 token 扩展与跨架构(MoE/Mamba)验证是分水岭。
- 干预管线化 + 副作用审计:Locate-Steer-Improve 的工程收益和风险账要并表报告——不能只说效果不说副作用。
- 基准分数是否收敛:MIB/BlackboxNLP 后续轮次的方法排名如果还是靠集成取胜,说明定位方法学尚未成熟。
- CoT 监控 vs 内部读数的军备竞赛:CoT 监控的有效窗口正在被优化压力关闭(模型学会了”沉默推理“),内部读数是唯一候选替代——但它的独立性在反思训练普及后也会失效。
一句话总结
最后,用一句话总结整个领域的现状——
可解释性已经把自己从”讲故事”逼成了”做检验的工程学”,代价是发现每一步检验都比预想的弱——这是领域的健康状态,不是失败。
六年前,我们只能画 attention 热力图,然后编一个”模型在关注什么”的故事。
今天,我们有 patching 做因果验证、有基准做横向对比、有副作用审计算风险账——我们说得更少了,但每一句都更靠谱。
这不是退步,这是进步。
真正的科学,从来都是从”我知道”走向”我知道我不知道多少”。
可解释性正在这条路上。
进一步阅读
如果你想深入了解,这里是一些入门的好起点:
- TransformerLens:一个专门为可解释性研究设计的库,支持 hook 机制,可以方便地做 patching 实验
- Neuronpedia:一个 SAE 特征的可视化浏览器,可以直观地看到各种特征长什么样
- MIB 基准:想知道各种方法的最新排名,去看 MIB 的 leaderboard
- jacobian-lens(官方代码库):J-lens 的参考实现。上手前要有心理准备:仓库只开源了透镜拟合与读数部分,论文里的 swap 干预、稀疏分解实现并不在里面——复现核心实验要自己按实验协议写
- Transformer Circuits Thread:Anthropic 的可解释性研究博客,SAE 和 J-space 工作都发在这里
- Alignment Forum:社区讨论的地方,causal scrubbing 等概念最早在这里提出
发表回复