一次国产 S60 加速卡
上的 FLUX 生图事故复盘,顺便研究一下生图模型的原理。
这篇文章要讲的,就是我亲眼看着一张AI生成图片把我的 san 值按在地上摩擦的经历。
一、事故现场
先说背景。我在做一项国产 AI 加速卡(燧原 S60)的模型部署认证考试,其中一题是:把 FLUX 生图模型跑起来,按考题描述出一张图
考题原文(70 字长句):一只可爱的橘色小猫坐在窗台上,窗外是夕阳余晖洒满的城市天际线,温暖的光线透过玻璃照在猫咪的毛发上,营造出宁静祥和的氛围。高清摄影风格,细节丰富。
参数:1024×1024,30 步,guidance 3.5,seed=42
一句人畜无害的提示词。我预期得到一只毛茸茸的橘猫。然后我得到了这个:
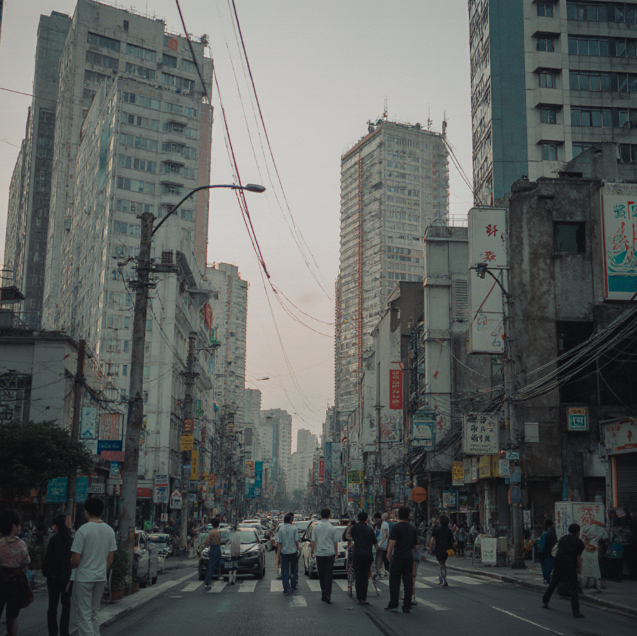
一张冷色调的城市街道广角——视角就站在马路中央,朝着马路延伸的方向望去,行人和车辆热热闹闹,一切都很”合理”。唯独没有猫。 我盯着它看了很久,脑子里冒出一个不太舒服的念头:我要的是一只猫,它给了我一座城市——那我的猫呢?
会不会再生成几次直接出来一个血淋淋的
“Help ME”
不死心,我把提示词删改成一句 20 字短句(一只可爱的橘色小猫坐在窗台上高清摄影风格,细节丰富。,参数不变)又跑了一次。得到了这个:
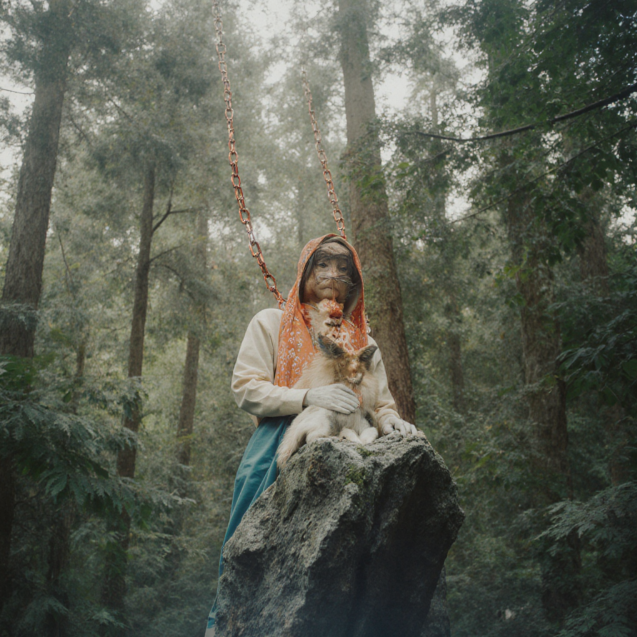
如果说第一张只是”错愕”,这一张是真的恐怖了。一种 80 年代《西游记》老剧的质感:丛林里,一个脸上长毛的人形生物,怀里抱着一只站在石头上的生物——好像是兔子,又好像是猫,那张脸扭曲到无法辨认。它不是”画错了”,它是”长错了”:构图、光线、氛围全部在线,唯独主角落在人类认知的裂缝上。
太掉san了。它是画出了一幅”几乎正确”的图——构图合理、光影正常、氛围到位,唯独每个细节都在尖叫”这个世界不对”。恐怖谷效应的完全体。
二、乱码文字无所谓,但图片很吓人
这里有个值得琢磨的不对称现象。
如果 LLM(大语言模型)输出一堆乱码,扫一眼,”哦,模型抽风了”,关掉重跑,情绪成本为零。文字的错乱是抽象的——你的大脑处理语言时本来就带一层符号抽象,符号坏了,意义层直接过滤掉它。
但生图模型输出乱掉的内容,冲击力完全是另一个量级。因为人脑的视觉系统是硬编码的:人脸检测、肢体比例检测、光影一致性检测,这些模块不走”理性分析”通道,是毫秒级自动触发的。
一张五官错位的脸不是”错误的符号”,它是一次直接的感官入侵——你的视觉系统在报告”这里有个东西,它长得不对”,而你没办法闭眼。
而要理解这些幻觉从哪来,得先知道生图模型到底在干什么。
三、生图模型原理
以这次事故的主角 FLUX 为例(Stable Diffusion 3、SDXL 同族)。先看全景——它生成一张图,就是这条流水线:
flowchart LR
    P["prompt 提示词"] --> C1["CLIP-L 编码器<br/>77-token 窗口"]
    P --> C2["T5-XXL 编码器<br/>512-token 窗口"]
    SD["seed<br/>初始随机噪声"] --> D["DiT 去噪主干 Transformer<br/>迭代 30 步"]
    C1 --> D
    C2 --> D
    D -->|每步去掉一点噪声| D
    D --> V["VAE 解码器<br/>8 倍上采样"]
V --> O["1024×1024 像素图"]下面把四个关键部件逐一拆开。每一节配的都是真实实验图——这台 S60 机器上跑出来的原片,不是示意图。
3.1 它不是”画”图,是”去噪”
生图模型不是从白纸开始画,而是从一团纯随机噪声出发,迭代地把它”擦”成图片。程序员的类比:一个迭代求解算法——初值是噪声张量,目标是”符合提示词的图”,每步往目标挪一点:
flowchart TB
    A(["t = 30,最噪"]) --> B["DiT 预测方向 v(x_t, t, 条件)"]
    B --> C["小步挪动:x_t → x_(t-1)"]
    C --> Q{"t = 0 了吗?"}
    Q -->|否| B
    Q -->|是| Z(["x_0 → 交给 VAE 解码"])
FLUX 的具体 formulation 是流匹配(flow matching):把噪声和图片看作一条直线两端,模型预测从任意中间点走向图片端的方向。记住”迭代式地从混沌收敛到图像”就够了。真实轨迹长这样(同一张图从噪声到成形的 6 个切片,768²、gs 3.5、seed 42、双语提示词):
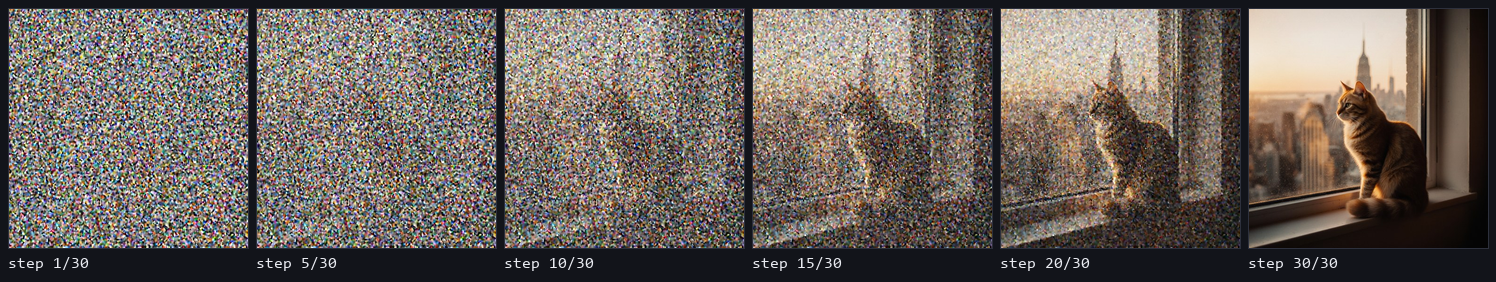
步数(num_inference_steps)就是迭代次数:只跑 4 步,语义已放对位置但高频细节全失——像一张失焦的实拍(见第五节实验 2 的 exp_steps4.png);30 步是常规工作点。
3.2 它在”潜空间”里干活,不在像素上
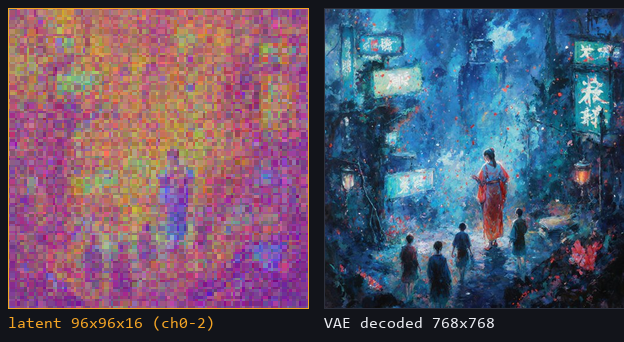
被迭代的不是 1024×1024×3 的像素,而是一个小 64 倍的潜空间张量(latent)——VAE(变分自编码器)训练出来的压缩表示:
flowchart LR
    P["像素 H×W×3"] -->|VAE 编码 ÷8| L["潜空间 (H/8)×(W/8)×16"]
    L -->|2×2 打包| T["token 网格 (H/16)²×64<br/>DiT 实际看到的形状"]
    T -->|30 步迭代全在这里| T
    T -->|解包还原| L2["潜空间"]
    L2 -->|VAE 解码 ×8| O["像素"]
这就是为什么 1024 的图算得动——迭代发生在 1/64 的数据量上。左下是 768² 生成走到最后一步时潜空间的前三个通道,右边是它经 VAE 解码出的像素图——模型全程在压缩空间里工作,直到最后一刻才”显影”:
3.3 文字是怎么进来的:两个编码器,两套语言能力
这是本次事故的案发第一现场。FLUX 用两个文本编码器并行读你的提示词:
| 编码器 | 窗口 | 角色 | 脾气 |
|---|---|---|---|
| CLIP-L | 77 token | 管风格、关键词、构图 | 英文为中心,词表是字节级 BPE |
| T5-XXL | 512 token | 管语义、细节、指令遵循 | 32k sentencepiece 词表 |
“token”是 NLP 版的字符串切分 + 查表:文字切成片段 → 查词表得整数 id → 经 embedding 矩阵(一张 32000×4096 的查找表)变成向量。**模型从不直接看到文字,只看到这些向量。**两个编码器读”同一句话的两种写法”的真实下场(红 = 乱码/未知,绿 = 正常词,橙 = 截断):
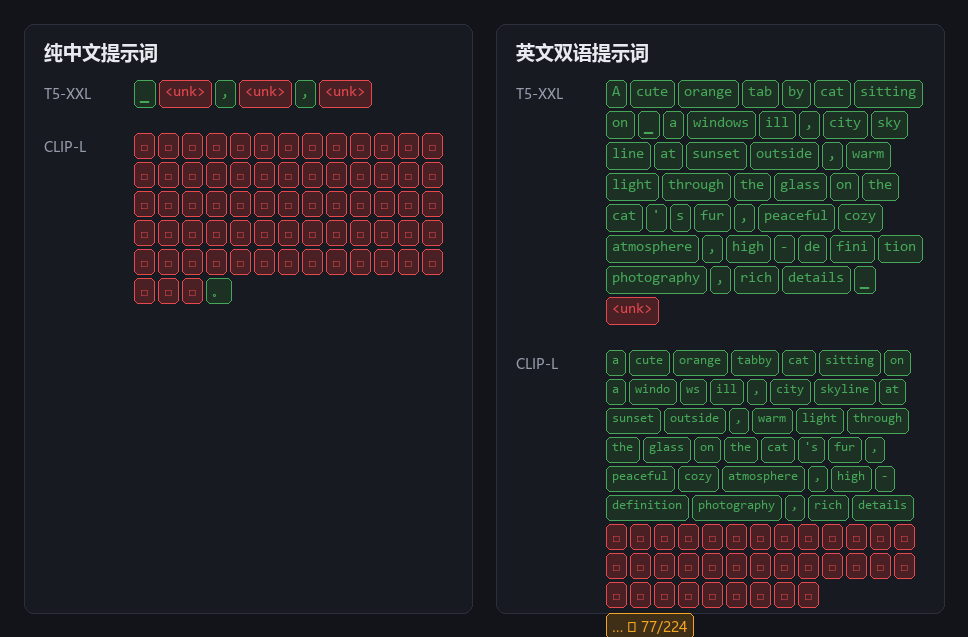
词表和 embedding 都是训练时定死的:CLIP-L 的语料几乎全是英文,T5 的 32k 词表对中文覆盖极其有限。喂它词表外的语言会发生什么——第四节全程取证。
3.4 引导力度:guidance_scale
去噪的每一步都在”任意合理图片”(先验)与”贴提示词”(条件)之间拿捏,guidance_scale 是往条件方向用力的系数(FLUX 把这个机制蒸馏进了权重)。三个真实样本,同一提示词、同 seed,只有 guidance 不同:
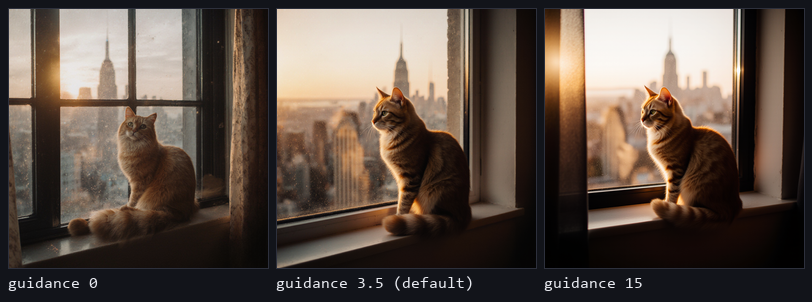
推荐值 3.5。拧到 0 并不会”无视提示词”——左图仍是一只正常的猫,只是细节留了瑕疵;拧到 15 则毛发边缘起高光,AI 感明显。
3.5 seed:平行世界的钥匙
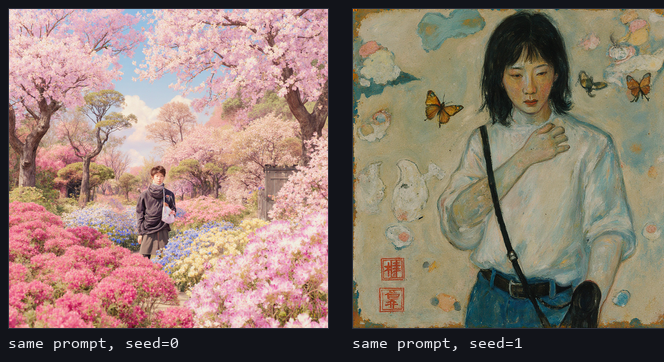
seed 决定初始噪声。同参数 + 同 seed = 逐字节复现同一张图(事故两张已验证,见第五节实验 1);换 seed = 同一”条件”掷出的另一个平行世界。同一句读不懂的短句、两个相邻的种子:
流水线讲完了。现在回到案发现场。
四、模型它到底看到了什么
事故当天我的第一反应也是最常见的猜测:提示词太长被截断了(CLIP 只看前 77 个 token,而中文在字节级 BPE 下会被拆得很碎)。
但这次复盘,我决定取证到底——直接调用模型自己的 tokenizer,按流水线的真实路径(padding 到 max_length、允许截断)编码那句中文提示词,把模型实际收到的东西打印出来。结果比猜测有趣得多:
== 事故短句(20 字 → 丛林图的源头)==
  T5-XXL 实际内容 : ['', '<unk>', ',', '<unk>']
                    ↑ 两个未知符 + 一个逗号,这就是那张恐怖图的全部条件
  CLIP-L         : raw=70 → kept=69,未截断,但 69 个 token 全是字节碎片 '�'

== 事故长句(70 字 → 街道图的源头)==
  T5-XXL 实际内容 : ['', '<unk>', ',', '<unk>', ',', '<unk>', ',', '<unk>', ',', '<unk>']
                    ↑ 5 个 <unk> 夹 4 个逗号
  CLIP-L         : raw=192 → 77 窗口截断(当晚日志的 "184 > 77" 警告即此,
                    慢/快分词器口径差几个 token)
两个发现,一个比一个狠:
发现一:截不截断根本不重要。 事故短句在 CLIP 里只有 70 个 token(<77,**没有截断**);长句 192 个 token(>77,截掉了大半)。但看下面——截断与否,读不懂就是读不懂。当晚日志里那行 184 > 77 把我的注意力引向了”截断”。
发现二:送进去了,但模型读不懂。 看清楚那两段输出:
- 在 T5 这边(FLUX 的语义主力):词表里压根没有这些常用汉字,整段汉字序列坍缩成了
<unk>(unknown)。短句整句只剩”两个 夹一个逗号”,长句剩”五个 夹四个逗号”。逗号恰好在中英文里共用词表项,是唯一幸存的”语义”。 - 在 CLIP 这边:每个汉字被字节级 BPE 拆成 UTF-8 原始字节碎片(显示为
�,实际类似<0xE4><0xB8><0x80>)。这些字节 token 在 CLIP 的英文语料里出现频率趋近于零——embedding 几乎没被训练过,对模型而言近似随机噪声向量。
所以真相是:“猫”这个概念,从头到尾没有到达过模型。 生成那张丛林恐怖图时,T5 收到的全部指令是 <unk> , <unk>;CLIP 收到的是 69 个乱码碎片。条件约等于真空。
条件空白时,去噪主干在干什么?它在做它唯一还会做的事:从训练先验里采样一张”平均意义上合理”的图片。FLUX 见过海量 LAION 级别的网络图片,其中最常见的类别是什么?街景、行人、招牌、森林、人物。于是你得到黄昏街道或者森林老人——不是它画错了猫,是它压根不知道你要猫,它只是按全球图片的平均分布随机抽了一张。伪汉字招牌尤其讽刺:模型见过几百万块招牌,知道”招牌上有字”,但字长什么样它没学会——于是它把训练分布里”字的统计形状”直接渲染了出来。这玩意儿比画错更掉san,因为它证明模型的世界里”文字”只是一个视觉纹理概念。
顺带,对照组也一样说了实话。双语提示词(英文在前、中文在后):
== 双语版 == CLIP-L 77 token 窗口实际内容:
  ['<|startoftext|>', 'a', 'cute', 'orange', 'tabby', 'cat', 'sitting', 'on',
   'a', 'windo', 'ws', 'ill', ',', 'city', 'skyline', ..., 'rich', 'details',
   '�', '�', ... 中文部分碎成字节碎片 ...]

  T5-XXL 实际内容:
  ['A', 'cute', 'orange', 'tab', 'by', 'cat', 'sitting', ..., 'rich', 'details', '', '<unk>']
英文部分在两个编码器里都完整、干净、语义明确(cat、tabby、windowsill 全是高频 token,embedding 训得很好);中文尾巴在 CLIP 侧被 77 窗口截掉、在 T5 侧缩成一个 <unk>,但此时已经无所谓——语义主力换成了英文。结果:
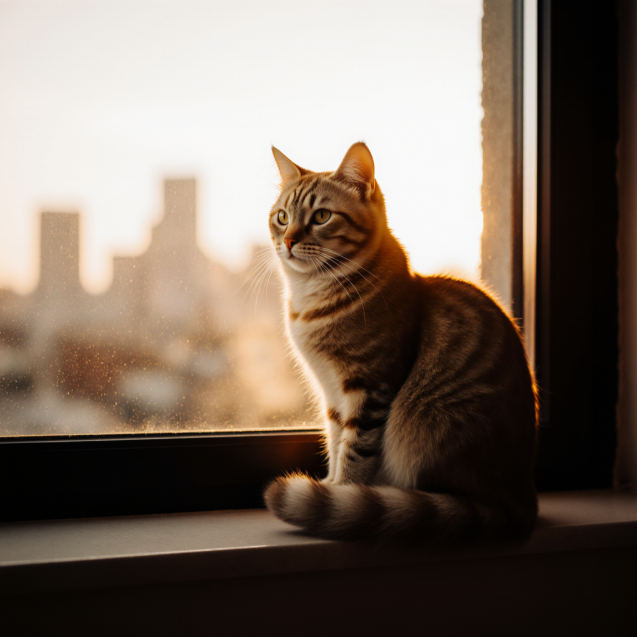
猫在窗台上,夕阳,城市天际线,高清摄影感。同一台机器、同一个模型、同一秒都没差,唯一的变化是提示词的语言。
这就是”双语提示词”这个生图圈常识的底层原理,也是我此前”截断论”笔记的更正:不是窗口装不下,是词表里没有你的语言。 取证要到 tokenizer 层才算到底。
token 处理——两个编码器实际收到的全量 token(红 = 乱码/未知,绿 = 正常词,橙 = 截断):
去噪过程——30 步迭代去噪实录,每一步都是当时潜向量经 VAE 解码出的真实画面:
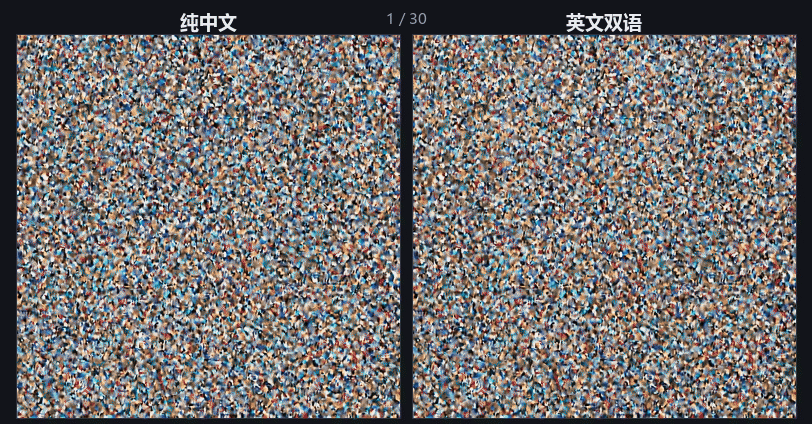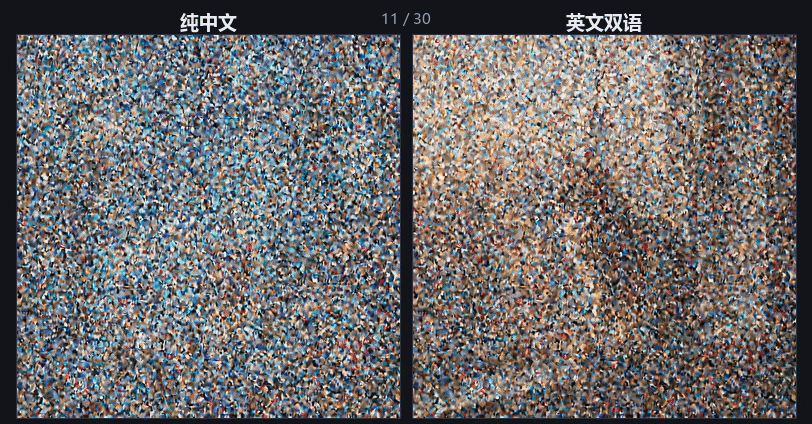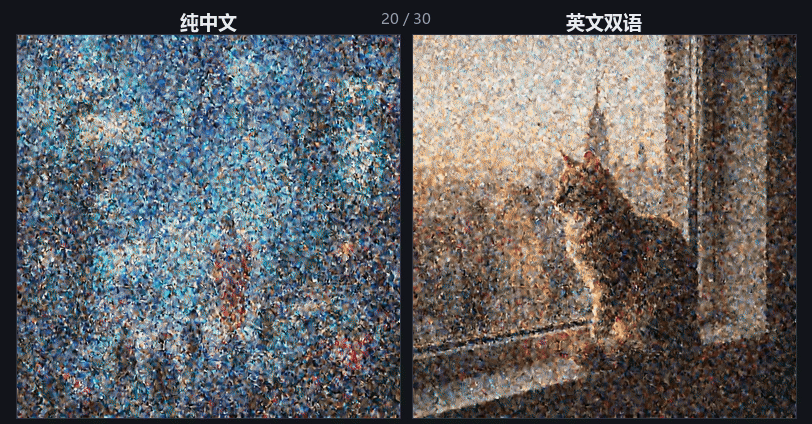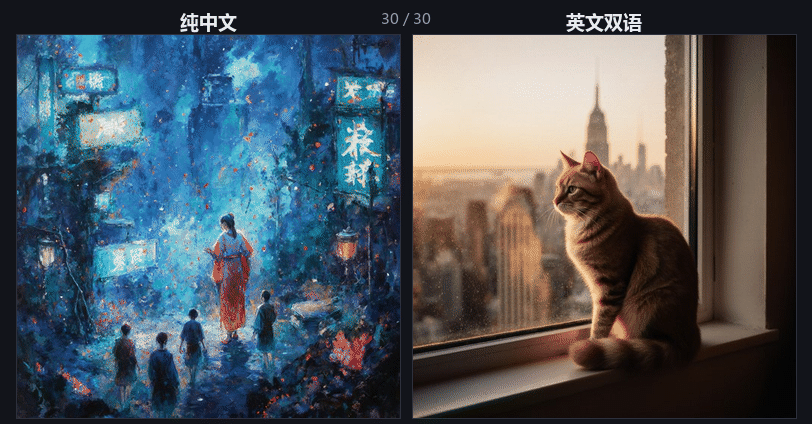
两路画面在第 10 步左右开始分道扬镳:左路长成街景,右路长出猫。语义有没有抵达,画面从不撒谎。
技术上的做法(可复现):diffusers 的 FluxPipeline 支持逐步回调,callback_on_step_end 里可以拿到每一步的潜向量;FLUX 的 transformer 工作在 2×2 打包后的潜空间上(形状是 2304×64 而不是 16×96×96),解码前要先 _unpack_latents 还原、再除以 scaling_factor 加 shift_factor、过 VAE。
五、边界实验:把旋钮拧到极端,结果意外地体面
理解了原理,就可以故意制造失败了。我在一台新的算力实例上重跑了一套边界实验(同一模型、同一提示词体系,每次只改一个参数)。
事先声明结果:这些实验几乎没有一张是恐怖的——极端参数伤害的是”质感”,制造不了恐怖。真正的恐怖在下一节。但正因如此,这组对照才有趣:它标出了哪些旋钮只会让图”变差”,而不是”变怪”。
实验 1:精确复现事故
在新机器上用事故当晚的两句原话、原参数(1024²、30 步、guidance 3.5、seed 42)重跑:
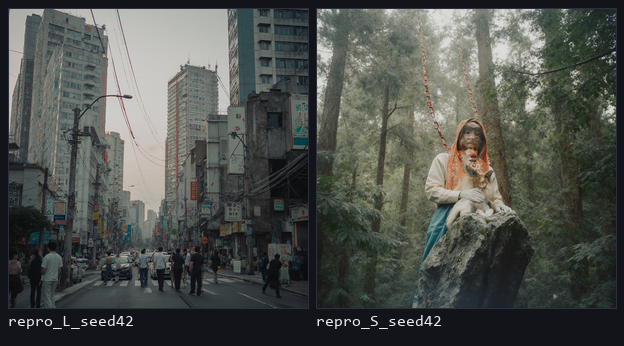
两张都是逐字节复现:PNG 字节数与当晚 Notebook 落盘的完全一致(1614369 / 1620791),与本地保存的事故图像素平均差 6.3 / 4.4——就是同一张图。所谓”灵异事件”,其实是读不懂的提示词 + 固定 seed = 一台可以无限重放的老虎机。而一旦换掉 seed,同一个提示词又会掷出完全不同的世界(见六.五的掷骰实验)。
实验 2:去噪步数不足(30 步 → 4 步)
提示词换成正常的英文版,只把迭代次数从 30 砍到 4:
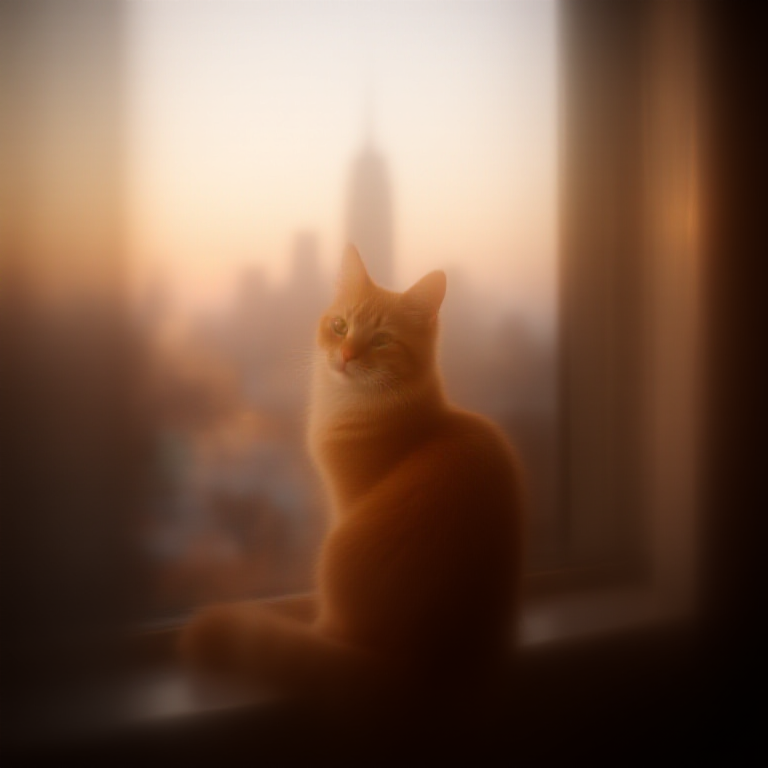
预期中的”半成品怪物”没有出现——实际效果像一张没对焦的实拍照片:猫是正常的,画面甚至颇有氛围感。迭代步数砍到 4/30,模型依然把”猫”这个语义放对了位置,只是放弃了高频细节。低步数 ≠ 崩坏,更像是”失焦”。
实验 3:引导力度拧到两端(3.5 → 0 / 15)
guidance_scale=0:
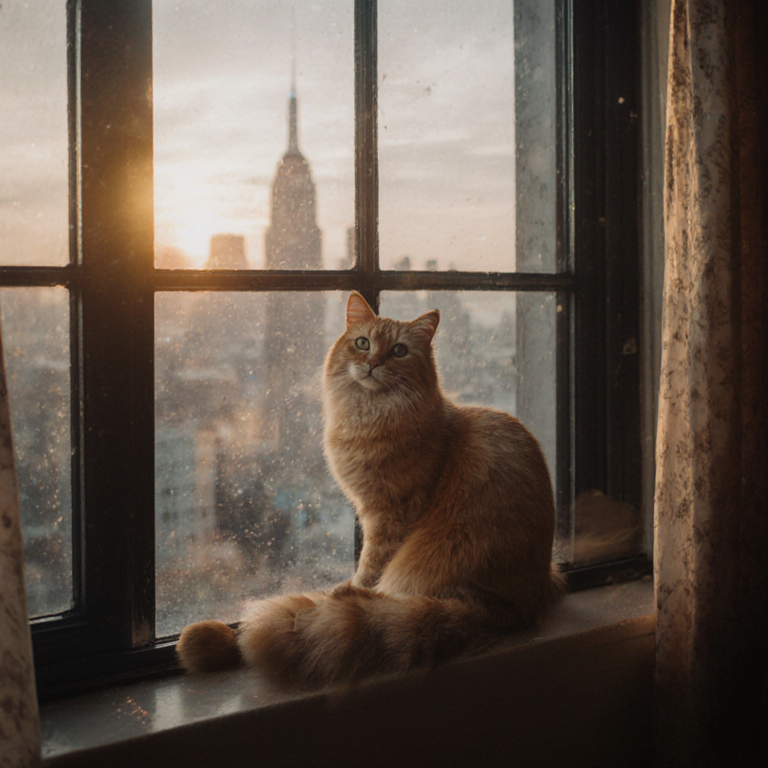
我原本以为它会输出”无视提示词的抽象噪声”——结果它给了一张床边的小猫:对焦正常、质感真实,唯一的破绽是尾巴末梢多出一小团莫名其妙的增生毛团。这纠正了一个想当然的理解:FLUX 的引导是蒸馏进模型权重的,gs=0 并不等于”关闭条件”,提示词依然生效,极端值只在细节处留下瑕疵。
guidance_scale=15(推荐值的四倍多):
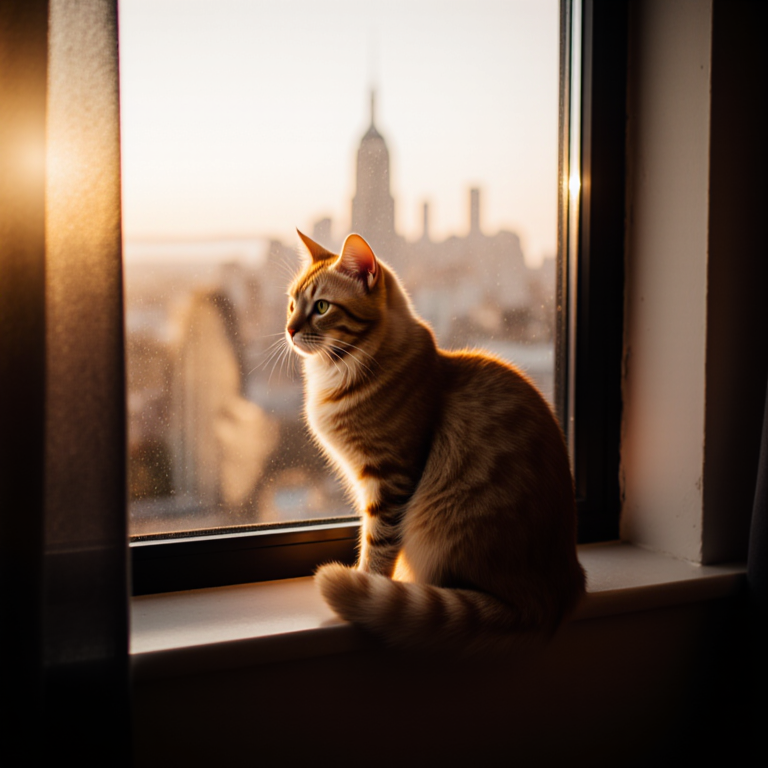
猫还是那只猫,但毛发边缘出现一圈高光,AI 感明显。引导过度不产生怪物,只产生”太用力”的塑料感。
实验 4:乱码提示词
提示词:焱燚雥龘靐齾爩鱻麤龗齉纞爨盨 stare into the 爩
tokenizer 招供的结果:T5 收到 <unk> stare into the <unk>——这串乱码的全部有效语义是英文里的 “stare into the(凝视……)”。我满心以为会得到全系列最恐怖的一张:
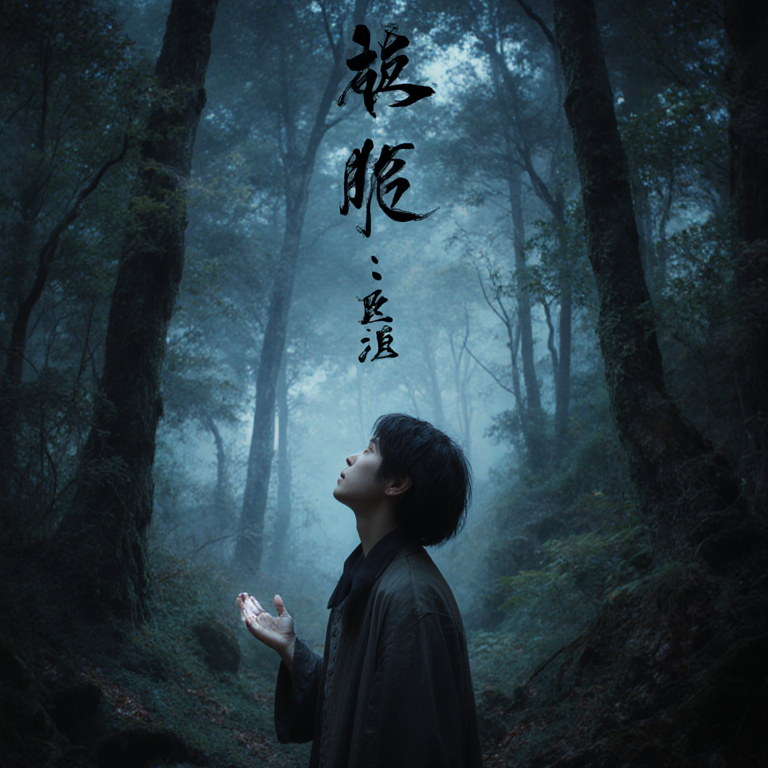
结果一点都不恐怖——氛围阴郁、构图讲究,很像一张另类音乐的专辑封面。语义残片没有催生怪物,只贡献了一点忧郁的气质。模型的”自由发挥”远比人类想象得克制。
实验 5:提示词只有一个句号
提示词:。
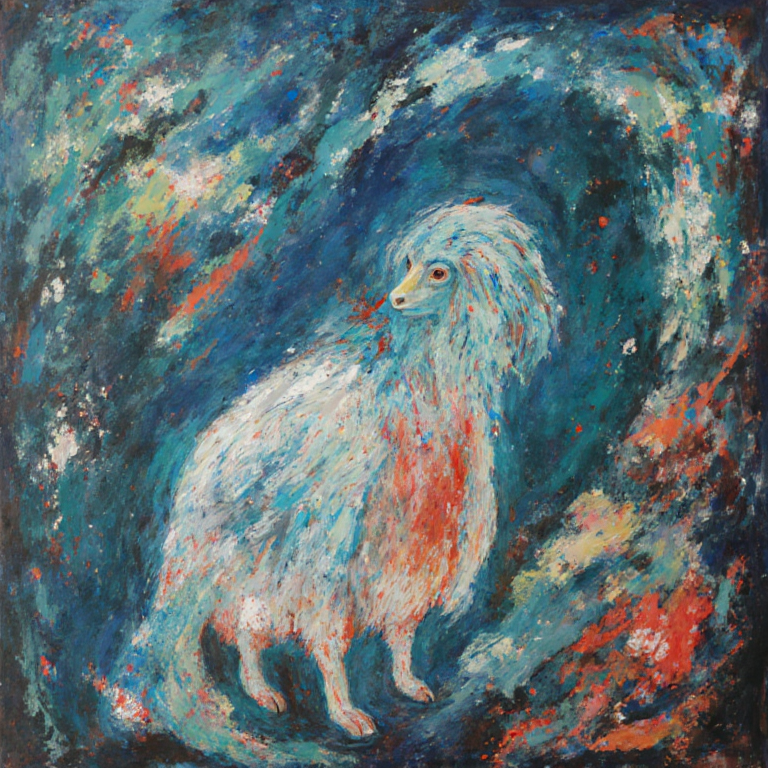
一幅技法成熟的古典静物:玻璃杯、无花果、深色织物。完全无指令时,模型从先验里随机抽了一个”艺术史平均品味”。你别说,还怪好看的。
实验 6:极端画幅(512×1408 竖幅)
正常英文提示词,但分辨率拉成 1:2.75 的细长条:
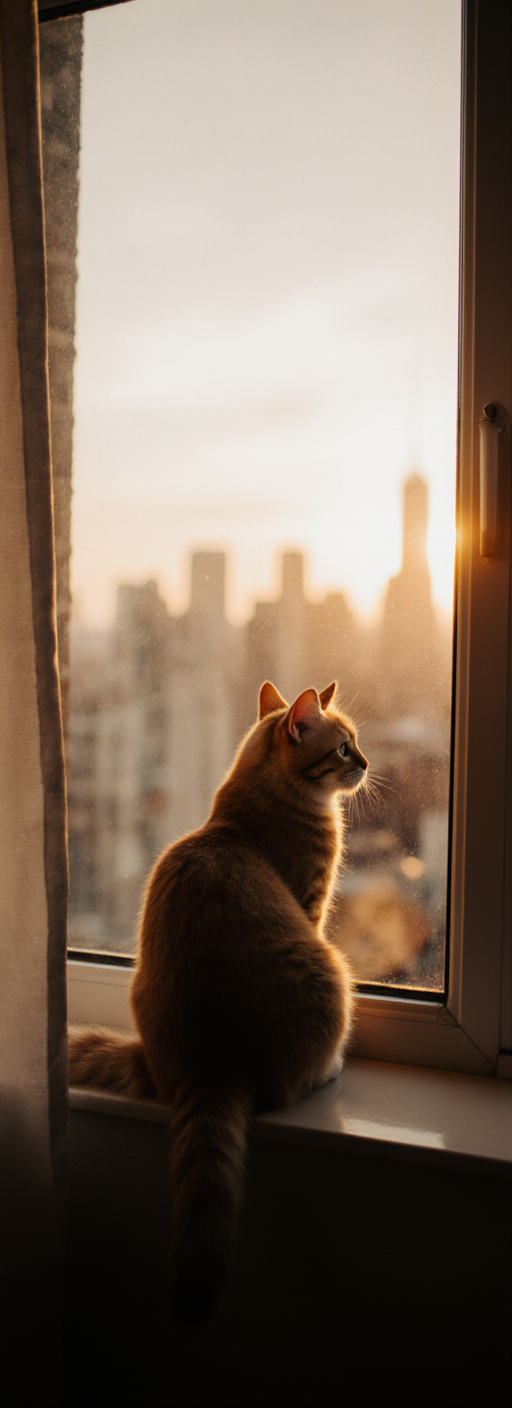
又一个预期落空:猫完全没有形变,构图正常,画面呈柔光质感,AI 感甚至比 gs=15 那张更弱。位置编码对分布外画幅的容忍度比想象中高得多——极端长宽比伤不了它。
六、失败模式 × 流水线环节对照表
把所有实验排在一起,你会发现每种掉san都精准对应流水线上一个环节的失效:
| 流水线环节 | 它负责什么 | 怎么弄坏它 | 坏掉的样子 |
|---|---|---|---|
| Tokenizer / 编码器 | 把文字变成有意义的向量 | 用词表外的语言(纯中文、乱码) | 内容随机漂移:街景、丛林人形——不可预测,且可能很恐怖 |
| 去噪步数 | 迭代收敛的次数 | 砍到 4 步 | 像失焦的实拍:主体正常,高频细节丢失 |
| 引导力度(CFG) | 条件强度的蒸馏系数 | 拧到 0 或 15 | gs=0 仅细节留瑕疵;gs=15 边缘高光、塑料感 |
| 随机种子 | 初始噪声 | 换数字 | 同一失败模式的平行世界变体 |
| 位置编码 / 画幅 | 空间坐标系先验 | 极端长宽比 | 意外地稳:无拉伸,柔光 |
| VAE 解码器 | 潜空间 → 像素 | (分布外潜向量) | 细节涂抹、纹理伪影 |
反过来读这张表,就是生图模型的调试手册:图不对题 → 查编码器和 tokenizer;图没成形 → 加步数;图太假 → 降 guidance;构图怪 → 换画幅/seed。 同时它揭示了本篇最重要的一个观察:参数层面的失败(步数、引导、画幅)只会让图”变差”,不会让图”变怪”。真正制造恐怖谷的,是语义层的事故。
六.五、回到案发现场:恐怖是一次随机抽样
先坦白一个走弯路的尝试:本文初稿里,我曾设计 12 个”埋了恐怖配方”的正常提示词(人形×动物×模糊物种×老剧质感)跑了 24 张,想主动复刻丛林人形——没有一张是恐怖的。用提示词去”点单”恐怖,此路不通。恐怖不是提示词的属性。要搞清楚它到底是什么,只能回到案发现场。
现场还原
好在证据齐全:Notebook 记录、服务端日志、还有当时与 AI 助手的完整对话存档(用”和猫一点关系没有”当关键词从本地数据库里翻出来的)。时间线:
| 时间 | 动作 | 结果 |
|---|---|---|
| 23:48 | 卸载 xformers(先被 PEP 668 拦一道,补 --break-system-packages 成功) | — |
| ~23:57 | Run1:考题 70 字长句,1024²/30 步/gs3.5/seed42 | 日志现 184 > 77 截断警告 → 城市街道(提示词1) |
| ~00:01 | Run2:删改成 20 字短句,同参数 | 无任何警告 → 丛林人形(提示词2) |
| 00:07 | 把现场贴给 AI:”问题是其生成出来的图片我看了一下,和猫一点关系没有” | 开始归因 |
注意那个反转:最恐怖的一张,出自更短、看起来更无害的那句。token 取证已经解释了两句为什么都读不懂;至于”读不懂之后会掷出什么”,靠猜是没用的——我猜短句更容易出恐怖,掷骰结果把这个猜测也推翻了。
掷骰实验:同一句读不懂的话,掷 14 次
五组批量采样,每组只动提示词和 seed,其余参数固定。逐组给出组图与参数:
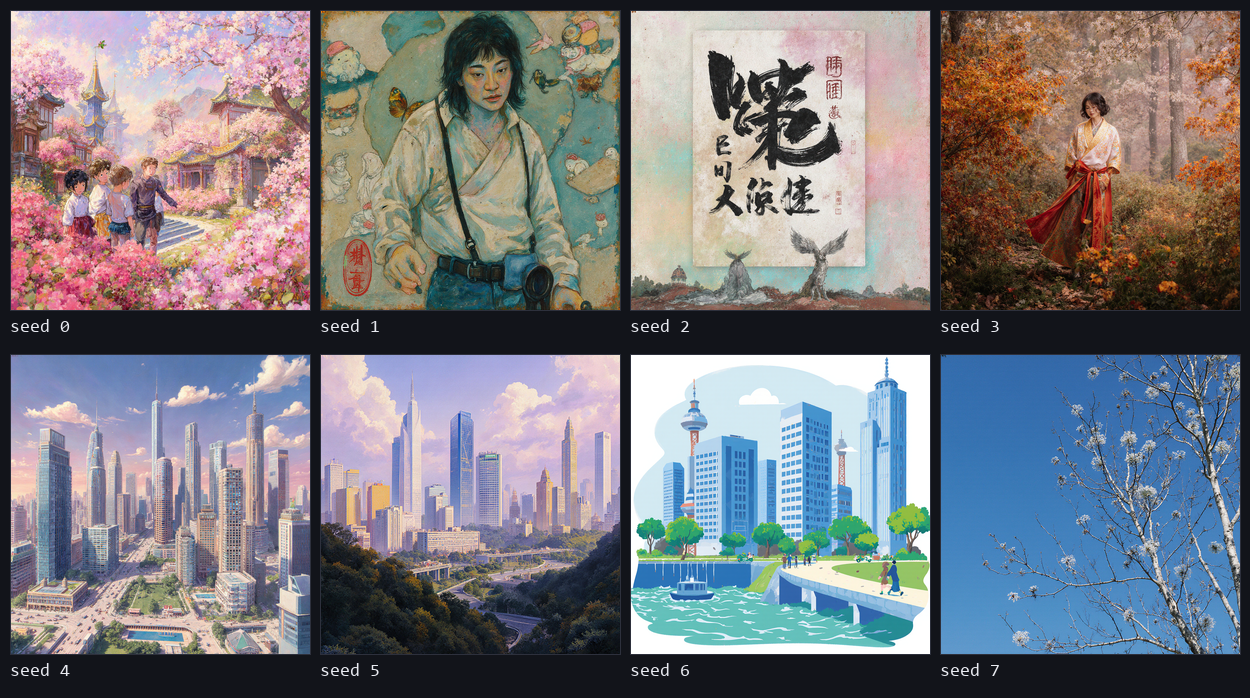
长句组——事故 70 字长句,1024²、30 步、gs 3.5,seed 0–7:
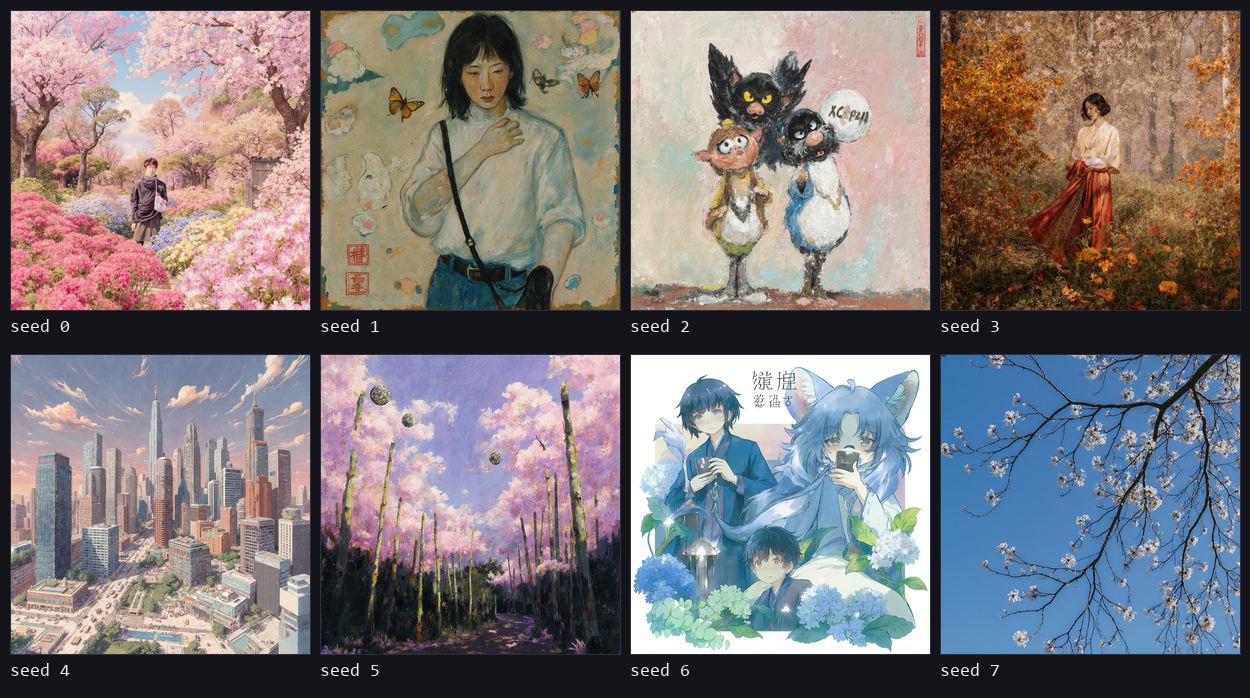
短句组——事故 20 字短句,1024²、30 步、gs 3.5,seed 0–7:
句号组——提示词仅为一个句号”。”,768²、25 步、gs 3.5,seed 0–5:
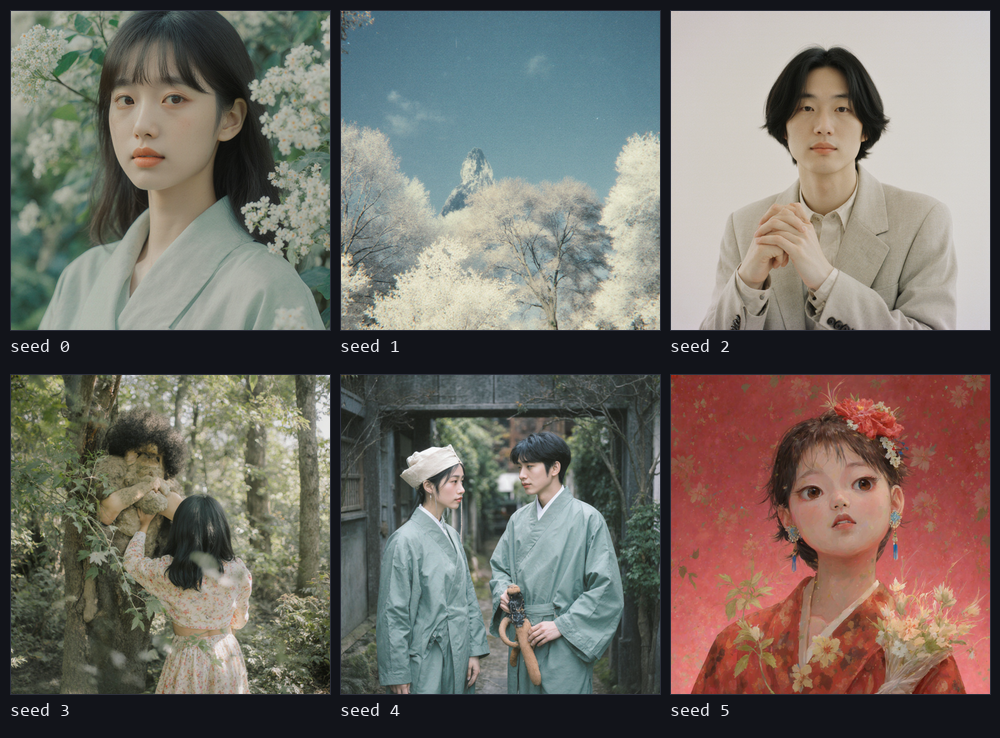
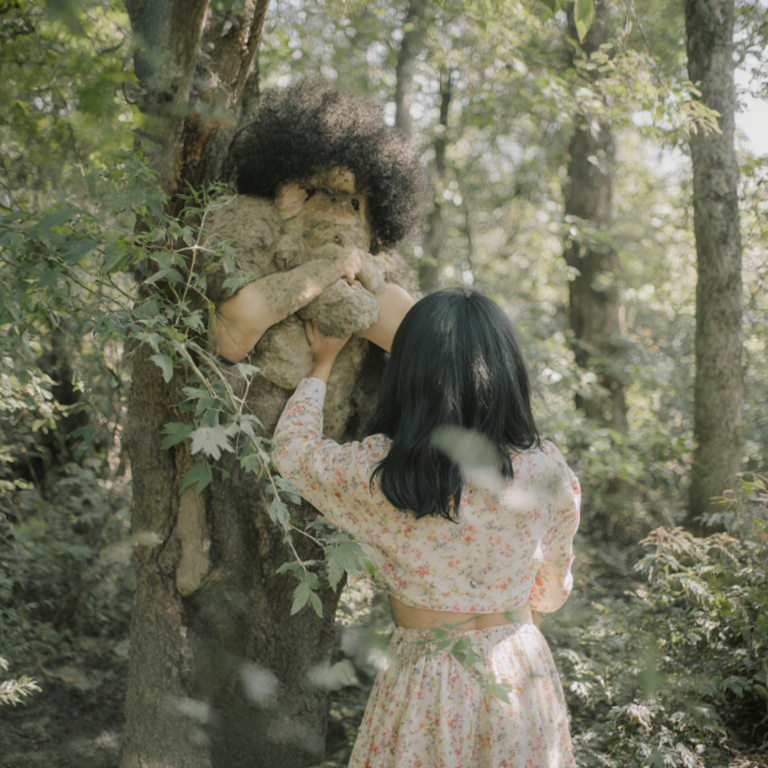
其中新的恐怖D3(seed3)单独放这里了(总不能只吓到我自己吧)
中英组——英文核心 + 中文原文(对照,模型读得懂),768²、25 步、gs 3.5,seed 1–2:
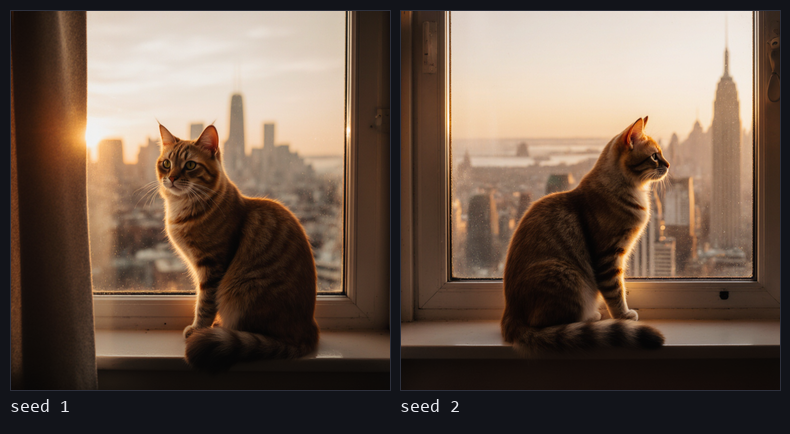
把 token 证据和掷骰结果并排放:22 张全新采样里,恐怖只出现了 1 次(D3),而且出自条件最空的那组——提示词只有一个句号,连”语义”这个概念都不存在。
加上事故本身(短句 seed42,T5 只读成 <unk> , <unk>),两次恐怖全部落在”条件近真空”的区间。样本很小,不谈概率,但方向与机制一致:强条件把采样压在常见区域;条件越空,采样越靠近纯先验;而纯先验的角落里,躺着一些没人标注过的形体。
它们平时被强条件压着出不来,只有当你的话模型一个字都听不懂时,才有机会被 seed 掷出来——这批实验里二十分之一的频率。
所以那晚真正发生的事情是:一句 T5 只能读成 <unk> , <unk> 的 20 字中文,把条件强度推到了接近真空;seed 42 恰好掷进了先验分布里那片长毛的脸。
这也给”AI 又画恐怖图了”的都市传说一个冷酷的注脚:绝大多数”灵异事件”不是模型黑化,而是一次可复现的、平庸的随机抽样——只是抽中的那位用户,不知道自己的 seed 是多少。
七、写在最后
回到开头的那个不对称:LLM 生成乱码你无感,生图模型生成乱图你掉san。
做完这一轮实验我觉得原因还有更深一层——乱码文字暴露的是模型的”无知”,而乱掉的图片暴露的是模型的”库存”。
它不知道你要猫,但它见过全世界的街景,于是给你一座热闹的城市,让你的猫下落不明;而当条件彻底读不懂时,它就从记忆的最深处随手捞起一张——有时候,那是一张长毛的脸。
某种程度上这暴露的是模型深处的记忆~~
附:复现参数
全量参数:产生的全部生成图的参数下载: generation_log.csv(点此下载)
记录了每张图的精确提示词、分辨率、步数、guidance、seed、所用脚本,以及对应的 原图下载链接(cos_url 列)。

发表回复