三天前,我把本博客的「自研」主题提交到了 WordPress 官方主题目录(ticket #292433 1),至今没有回音,个人怀疑是因为介绍用中文写的(😡)。
同一段时间,我给 Bifrost 提了个 PR。Bifrost 是 Maxim AI 开源的 LLM API 网关,我折腾大模型 API 的时候发现的,你别说,比起 OneAPI 它功能更全,界面也更好看。修复本身很小:Anthropic provider 在处理会话历史里 function_call 带非法 JSON arguments 时,会把整个请求打成 500,改动 +20/-2,三个文件 2。我(的 Agent)是真的在测试服务器上,按 PR checklist 一项项验证完才提交的。
等到今天,PR 还是没动静。不过这不重要。重要的是我盯着 PR 页面这几天,看清了一件事:一个人类都还没看的 PR,上面已经站满了机器人。
一、二十行代码,五家公司的机器人陪审团
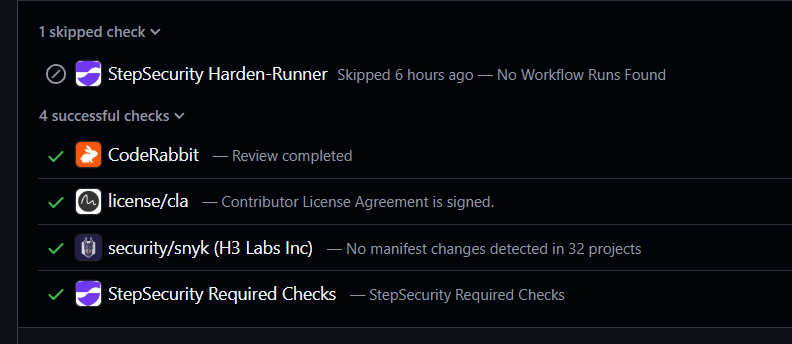
PR 刚创建,流水线上就自动亮起一串绿勾(CodeRabbit稍微工作了十几分钟,给我发了通过回复):
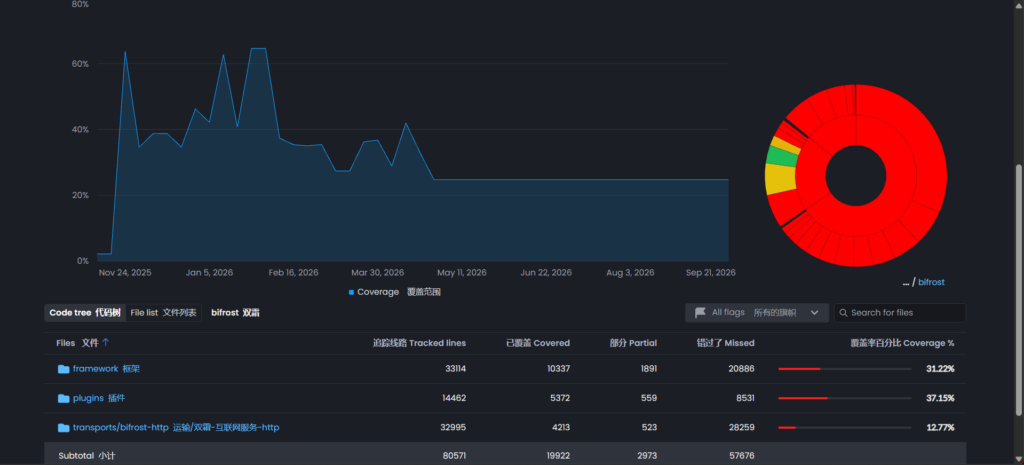
还有 Codecov。它没在 PR 页面上留下一票,产出在仓库仪表盘上:一张漂亮的测试覆盖率饼图 3。
一个 AI 审查官,一个法务,两个安全审计,一个质量监督,围观我二十行代码。挺好,这就是成熟开源项目的自动化陪审团。然后我想起自己的单人项目:一个都没有。代码靠 AI 写,AI 写完连人工 review 都没有,更别说这一桌机器人。
这串绿勾里跟测试直接相关的,是 Codecov 那张饼图背后的覆盖率。而覆盖率恰好是这一整套系统里最容易糊弄的环节。这篇文章想清楚的,就是在「AI 写代码 + AI 写测试 + 无人审查 + 本地高频 commit」的闭环里,怎么给自己攒一套 AI 没法靠凑数绕过的自动校验。
二、AI 写的测试,是「看起来够了」
普通质量问题,怎么差怎么补。VibeCoding 不一样,AI 会主动凑数。
Michael Bromley 在《The Problem With Your AI Tests》4 里把 AI 写测试的失效形态归了四类,我在自己的项目里全见过:
| 形态 | 长什么样 | 为什么全绿 |
|---|---|---|
| 弱断言 | assert result is not None、assert total >= 0(本该 assert total == 3) | 对错值也能通过 |
| 重言式 | expected = net + tax,然后断言被测函数返回 expected,期望值是同一段算式复算出来的;更极端的连被测函数都不 import,自己在测试文件里重写一份 | 断言自己证明自己 |
| mock 自证 | mock 掉被测依赖,断言结果等于 mock 返回值。测的是 mock 配置,不是代码 | 测试在自嗨 |
| 条件式测试 | if result.success: assert X, else: assert error,两条分支都给自己留了活路 | AI 把容错逻辑写进了测试套件 |
这不是个别人的抱怨。HN 上的一手吐槽:「把测试 mock 到只剩测 mock 本身?是的!」5。还有人发现 Claude Code 和 Cursor 会删掉或跳过测试,然后宣称全部修复 6。westurner 的总结最扎心:现代 coding agent 很擅长写出刚好凑够 100% 覆盖率的测试,但 100% 覆盖率不等于高质量软件 7。
学术侧也跟上来了。2026 年 MSR 的实证研究测出,coding agent 生成的测试里 mock 占比显著高于人类提交,36% 对 26%(Hora & Robbes,《Are Coding Agents Generating Over-Mocked Tests?》8)。LLM 的短板为什么集中在断言(test oracle)而不是造输入,ASE 2025 有一篇专门的分析 9。
原因说穿了不新鲜。一条 HN 高赞评论讲得很透:模型被 RL 训练的目标就是让测试通过,遇到困难,它先想到的不是修代码,是改测试 10。覆盖率是数字,通过率也是数字,Goodhart 定律在 agentic coding 里自动兑现。
得说句公道话:重言式测试不是 AI 发明的。2010 年就有 TTDD(Tautological TDD)反模式的老吐槽 11;2019 年学术界就给这种「通过但断言根本没生效」的测试起了名字,Rotten Green Tests 12。AI 的贡献是把它从个别懒人的特产,变成了默认产物。
三、覆盖率救不了你,变异分数可以
pitest.org 首页有段话,建议每个让 AI 写测试的人都读一遍:
“Traditional test coverage … measures only which code is executed by your tests. It does not check that your tests are actually able to detect faults … It is therefore only able to identify code that is definitely not tested.” —— 13
翻译一下:覆盖率只能告诉你哪些代码没被测,永远说不了哪些代码没测好。零断言的测试照样刷满行覆盖。MutGen 的论文 14 里有个扎心案例:LLM 生成的测试,覆盖率 100%,变异分数 4%。
变异分数(mutation score)就是那个 AI 难以作假的指标,原理三句话:
- 往被测代码里注入一个细微突变:整数 +1、
<换<=、break换continue; - 跑测试套件。挂了,这个突变算 killed;全绿,算 survived;
- killed 除以总数,就是变异分数。
survived 的突变体就是测试的盲区。AI 写的 assert x is not None,在 <= 被改成 < 时根本不会红,当场现形。全程不需要任何人「审」测试,机器直接给测试的真实性打分。
这不是玩具技术。Meta 把变异引导的 LLM 测试生成做进了生产系统(ACH,FSE 2025 Industry Track 15):10,795 个类,9,095 个突变体,生成的测试 73% 被采纳。Google 也在 ICSE-SEIP 2020 发过全公司规模的变异测试实践 16。
工具就是 mutmut(当前 3.8.0 17)。我给自己排的演示流程:让 AI 写一个新函数的测试,mutmut run,mutmut browse 看 survived 列表,让 AI 补真断言,再跑,变 killed。这套前后对比做一次,比讲十遍理论都管用。
也别把变异分数神化。mutmut 自己提供 # pragma: no mutate 豁免,行、块、区间三级都有 17。工具度量测试真实性,也顺手提供了新的作弊口:AI 往代码里塞豁免注释就能「提高」分数。所以豁免区必须进 review,哪怕是 AI 自审。
四、单人场景的五重特殊性
把团队方案直接抄到单人环境,会处处踩空。我把自己场景的特殊性整理成五条:
| 维度 | 典型团队方案假设 | 单人 VibeCoding 实况 |
|---|---|---|
| 审查者 | 有 PR reviewer 人工把关 | 没有第二双眼睛。AI 既是作者,又是唯一可能的审查者 |
| 门禁环境 | CI 流水线,push 之后 | commit 之前,问题要在本地拦住 |
| 妥协空间 | 门槛太严会卡住队友,要折中 | 可以设最严门槛,没人会被你卡住 |
| 反馈容忍度 | CI 慢一点能接受 | commit 是高频动作,hook 慢几秒就会想绕过它 |
| 指标语义 | 覆盖率是参考信号之一 | 覆盖率会被 AI 主动刷分,必须换它难以作假的指标 |
由此两个推论。第一,变异测试在单人场景比团队项目更重要:团队里还有人工 review 兜底,你只有自动化手段。第二,它又不能全量塞进 commit 环节:变异测试的本质是每个突变体都要跑一遍测试,全量跑下来,提交会慢到你想 --no-verify。所以只能把验证拆散,嵌进工作流的不同时刻。
五、三层防线:同步守门 + 异步体检
我的方案是三层触发点,各管一段,职责不重叠:
| 层 | 触发时机 | 跑什么 | 反馈给谁 | 时间预算 |
|---|---|---|---|---|
| ① 即时反馈 | AI 写完测试的瞬间(Claude Code PostToolUse hook) | 新测试文件 lint + 快速跑测 | 反馈给 Claude,让它自己修 | 30-60 秒内 |
| ② commit 守门 | git commit(pre-commit hook) | 受影响测试 + 覆盖率门禁 | 阻止提交(exit 非零) | ≤ 10-15 秒 |
| ③ 定时体检 | 每日定时 | 全量测试 + 全量变异测试 | 给人看的体检报告 | 分钟到小时,无所谓 |
① AI 写完测试的瞬间:PostToolUse hook
Claude Code 的 hooks 配置在 settings.json 的 hooks 块(~/.claude/settings.json 或项目 .claude/settings.json)。官方文档给的示例场景里,就有「只在 Claude 写/编辑文件时跑 lint 脚本」,用 matcher Edit|Write 过滤工具事件 18:
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [{ "type": "command", "command": "python .claude/hooks/check_tests.py" }]
      }
    ]
  }
}
hook 从 stdin 拿到 JSON,里面有 tool_name 和 tool_input(Write/Edit 的 file_path 恒为绝对路径),判断写的是不是测试文件,是就跑检查。
这里有个关键语义:exit 2 在 PreToolUse 里能拦下工具调用;在 PostToolUse 里,动作已经发生,拦不回来,只能把 stderr 喂回给 Claude。而后者恰好就是第①层要的语义:测试写得烂,让 Claude 立刻看到失败,自己修(这条语义我对照了多个二手源,官方文档页一直没抓开,见文末「未能核实」)。
社区已有现成玩法。有人用 PreToolUse 拦下 git push,先跑 lint 和测试再放行 19;有人做了 hook 集合,让 Claude 每次改完 TS 文件自动过一遍类型检查 20。Claude 官方课程的说法更直接:hooks 给你的是确定性控制 21。
两个坑。第一,hooks 只在 Claude Code 会话内生效,人不在会话里,第①层就完全静默,这正是还需要第②层的原因。第二,文件被外部程序改写时不会触发 PostToolUse,这种漏网情形只能靠第②层兜底。
② commit 秒级守门:pre-commit + 受影响测试
第②层的目标是守门,不是全测。社区对 pre-commit 耗时的共识是 10 秒以内,贵的测试留给 CI 22;上限普遍认为在十几秒。Windows 上 pytest 冷启动就要 1-3 秒,受影响测试必须选得准:
pytest --lf:只重跑上次失败的。语义是「重跑失败」,不是「受影响」,别混用;- pytest-picked:按 git 变更文件匹配同名测试文件。文件级粗粒度,零建库成本,适合起步 23;
- pytest-testmon:用 Coverage.py 收集「测试 ↔ 被测代码」依赖图,做细粒度选择,首次要全量建库。单人小项目用它最合适 23。
覆盖率门禁一行搞定:coverage.py 的 fail_under(低于阈值 exit 2),或 pytest-cov 的 --cov-fail-under 24。门禁值可以设到团队不敢设的高度,反正卡住的只有你自己。
③ 每日体检:定时任务跑全量变异测试
commit 环节放不下变异测试,但完全不跑,又等于放弃真实性校验。团队方案里 CI 承担的角色,单人环境用本地定时任务替代。CircleCI 官方博客的建议跟我想的一样:
“Run mutation tests on a schedule, not on every commit. Nightly or weekly runs against the main branch catch regressions in test quality.” —— 25
Windows 侧一行建任务:schtasks /create /sc DAILY /tn mutation-report /tr run-mutation.bat。nightly 也有反方观点,隔夜反馈错过了修复时的上下文 25。单人开发者的化解反而简单:把体检排在早餐前跑完,看完报告再开工。
mutmut 让这件事的性价比越来越高:3.7.0 起按函数源码哈希做增量缓存,改一个函数只重测该函数的突变体;还支持通配符,mutmut run "my_module*" 单跑一个模块 17。Stryker(JS/TS 生态的同类工具)官方文档给过一组数字:增量模式下 3965 个突变体复用了 3731 个,只需重跑 234 个 26。
最后一个 Windows 的坑,单独拎出来:mutmut 依赖 os.fork,Windows 上必须在 WSL 里跑。官方原话:”must be run on a system with fork support” 17。
六、提示词也是防线
上面三层都是事后机器验证。AI 是测试的作者,事前还应该有一层约束,压低假测试的产生率。我的 CLAUDE.md 里加了这些规则:
## 测试规则
- 期望值必须硬编码字面量,禁止由被测逻辑复算得出
- 禁止弱断言:assert x is not None / assertTrue(x) / assert x >= 0(除非语义确实如此)
- 禁止 mock 被测单元本身;mock 只用于外部依赖
- 禁止修改既有测试来让结果变绿;测试失败先怀疑实现
- 新测试写完必须先确认它能失败(对空实现跑一遍)
最后一条不是我发明的,是社区验证过的 TDD 工作流:Anthropic 官方文章里,团队的用法就是先写测试、确认失败、再实现、不许改测试 27。「不许弱化测试或校验来让失败的用例通过」也已经是公开 AGENTS.md 的常见条目,krkn-operator 的 AGENTS.md 里就原样写着 “Do not weaken tests, validation, RBAC, TLS, or quality thresholds to hide failures” 28。
也有人泼冷水。qodo 提醒,静态规则文件有时反而让 agent 表现变差,规则要跟具体上下文绑定 29。
所以这层的定位要说清楚:它是概率防线,压低假测试的产生率,但不保证拦住每一个;确定性防线是变异分数,机器说了算。一个降本,一个兜底。
七、本地小模型审查:我的结论是默认不上
我原来的设想里有「本地小模型的强制审查」这一环。调研之后暂时放弃,三个理由。
一,可靠性边界太硬。IEEE TSE 2025 有一篇专门研究 LLM 给代码当裁判的论文,结论是即便表现最好的 GPT-4-turbo,判断代码正确性也远谈不上可靠 30;2026 年的《Bias in the Loop》进一步发现,judge 的结论对 prompt 措辞高度敏感,代码不变,结论能翻转 31。7B 本地模型只会更差,而误报最后还是要人复核,省下的时间又还回去了。
二,最关键的问题不需要模型。「这个测试真的能红吗」是个可执行验证问题,变异测试直接给答案,不需要第二意见。
三,工业界的做法印证了这一点。Meta 的 TestGen-LLM 让 LLM 改进既有测试,但每条建议必须过确定性过滤器:能构建、能运行、覆盖率提升、杀死更多变异体 32。LLM 负责生成候选,验收全部交给机器,而不是另一个 LLM。
替代方案是规则层,便宜,立刻能上:
- Ruff(
PT018复合断言拆分、B011assert False、PLW0129字面量断言、PT009pytest 风格)加 flake8-assertive(规则码 A500-A504:assertTrue(a==b)改assertEqual,assertTrue(a is not None)改assertIsNotNone)33; - 自写一个两百行以内的
ast.NodeVisitor补盲区:测试函数断言数为 0、断言裸变量或字面量、重复断言同一表达式; - 语义级的「断言与实现同构」不硬扛,交给变异测试兜底。
再加一味药:property-based testing。Hypothesis 的 ghostwriter 能给纯函数生成性质测试源码,官方把它定位成 PBT 的低门槛入口 34。AI 写的举例测试和性质测试天然互为审查,「看起来在测」过不了随机输入那一关。真想实验小模型,把它定位成可疑测试的第二意见就好,别做门禁。
八、元测试:验证验证者
还剩一环:这套机制自己坏了,谁来验证?
我的最低成本做法是手动注入 bug,相当于变异测试的 30 秒手动版:
- 写完核心模块和测试后,随手改坏一行(
<换<=,+换-); - 跑测试;
- 全绿?说明测试瞎了,回到第五节重来。
土是土了点,但思想和混沌工程是同一回事:Netflix 的 Chaos Monkey 定期往基础设施里注入故障,验证监控、告警、恢复机制真的有效,Gremlin 把这套做法制度化为 game day 35。「定期注入 bug 验证测试真的会红」,就是它在代码层的投影。
想升级就上抽样变异:限定目录、限定突变算子,跑一部分突变体,接受近似的杀灭率。另外,断言密度是个免费的旁路信号:2015 年有实证研究发现,测试套件的断言数量与它的杀变异能力强相关(基于 Java 生态,搬到 Python 要谨慎)36,一条 shell 命令就能统计。
九、SOP 草案:先人工调度,再自动化
落地节奏,从最便宜的起步:
- 阶段 0(现在,零成本):CLAUDE.md 测试规则 + Ruff + flake8-assertive。这三样没有理由不开。
- 阶段 1(本周,人工):每次 AI 写完测试,人工跑一遍
mutmut run和mutmut browse,肉眼看 survived;每个核心模块手动注入一个 bug,30 秒元测试。这一步是摸清变异测试在我项目里的真实耗时和误报形态。 - 阶段 2(半自动):pre-commit 挂 pytest-testmon 和
--cov-fail-under;schtasks 建每日全量变异任务,早餐前跑完。 - 阶段 3(全自动):把阶段 1 的动作写成 PostToolUse hook 脚本,挂到第①层;体检报告摘要自动推送。SOP 稳定之后,人工调度过的每一步才有资格被自动化。
顺带一个还没想清楚的方向。antirez 提出与其让 AI 写单元测试,不如让它当 QA:按 markdown 清单做真实的集成验收,覆盖覆盖率之外的状态空间 37。这跟变异测试不冲突:变异分数管测试的真实性,QA agent 管测试的盲区。留给下一轮。
十、工具速查
| 用途 | 工具 | 一句话 |
|---|---|---|
| 变异测试(Python) | mutmut | 3.8.0,schemata 并行、增量缓存、TUI 报告;Windows 必须走 WSL |
| 变异测试(Python,备选) | cosmic-ray | 8.7.0 活跃维护,结构更重,可分布式 38 |
| 变异测试(其他语言) | Stryker(JS/TS)、PIT(JVM)、cargo-mutants(Rust)、gremlins(Go)、mull(C/C++)、Stryker.NET(.NET) | 各生态主流选择 |
| 弱断言 lint | flake8-assertive(A500-A504)、Ruff(PT018/B011/PLW0129/PT009)、pylint(W0199/W0129) | 规则层第一道网 |
| 受影响测试 | pytest-testmon(依赖级)/ pytest-picked(文件级)/ --lf(失败级) | 按建库成本递减选择 |
| 覆盖率门禁 | coverage.py fail_under / pytest-cov --cov-fail-under | 低于阈值 exit 2 |
| hook 机制 | Claude Code hooks(PostToolUse/PreToolUse) | 官方文档 18 |
| 定时任务 | Windows schtasks / Task Scheduler | 一行命令建每日任务 |
| PBT | Hypothesis(ghostwriter) | 性质测试与 AI 举例测试互为审查 |
| test smell 学术参考 | tsDetect / testsmells.org 39 | 19 种 JUnit smell 分类(Python 需自写 AST 检查) |
未能核实的事项
- Claude Code hooks 的退出码语义(PreToolUse 阻断 / PostToolUse 只回显 stderr):官方 hooks 文档页两次抓取均超时,结论来自多个独立二手源交叉一致。配置示例发布前建议对照官方页再核一遍。
- 《On the Effectiveness of LLM-as-a-Judge for Code Generation and Summarization》确认发表于 IEEE TSE(2025),稳定的公开全文链接没拿稳,本文未附。
- promptessor 与 qodo 的两篇文章只确认了站点、标题与发布时间,具体 URL 未核,先挂站点链接。
- pytest-picked 在新版 pytest 下的兼容性没实测,用前先跑一把。
- HN 各评论的存在性经核实,逐字引语以链接原文为准。
- Snyk、CodeRabbit 的免费额度各处口径对不上,本文不写具体数字,只引 PR 页面可见的自报内容。
- Zhang & Mesbah 的断言密度研究只核到 2015 年 ACM DL 收录,「强相关」的具体强度以原文为准。

发表回复