过去两天我做了一次对照实验:同一个开发任务、同一个模型、同一份代码起点,起两个并行的 AI 编码会话——一个启用 AOCI-Code,一个不启用。结果是:两边花的 token 几乎一样(input 相差 0.7%),但真实工具错误率从 8.0% 降到 3.2%。
这篇文章记录这个实验,以及它背后的两个问题:怎么让 AI 代理”入职”你的项目,以及当它干得比你审得快的时候该怎么办。
问题一:AI 代理也需要入职
一个人类开发者加入新项目,第一周通常不写代码:先读文档(如果文档做得好的话),再读和自己需求相关的代码,然后才敢动手。没人觉得这是浪费。
但我们用 AI agent 时常常忘了这条常识,期待它进来就直接干活。这不符合科学——模型没有读过你的仓库,它凭什么领悟这个项目是干嘛的?
当然 agent 有真实优势:它读代码比人快得多,知识面也比人广(我是靠 AI 才第一次知道有 tac 这个命令的——cat 反着拼)。但它有两个硬约束:
- 上下文窗口有限。 它不可能把整个仓库塞进一次会话。
- 每次会话结束它就”离职”了。 下一次会话顶上来的是另一个同样聪明、但对你这个项目一无所知的新人。
所以局面是这样的:你雇了一个执行能力超强的天才,但他只在你的项目里待两周,走后顶替他的天才同样对你一无所知。你留不住他。你能做的只有两件事:把每次的入职成本降到最低,并且让上一任积累的理解能传递给下一任。
这不是提示词工程问题,是一个基础设施问题。AOCI 是对这个判断的一次认真回答。
AOCI 是什么
AOCI(AI-Oriented Cognition Infrastructure,面向 AI 的认知基础设施)的核心是一个朴素的想法:既然每个 agent 都要重新上岗,那就把上岗文档做成一份机器可治理的资产。
它的参考实现 AOCI-Code 是一个 Go 单二进制,既提供 CLI,也提供 9 个工具的 MCP server。MCP(Model Context Protocol)是模型调用外部工具的标准协议——Claude Code、Codex 这类编码代理都通过它接入外部工具。这份”上岗文档”就是仓库里一份 Git 版本化的纯文本索引:每个受管文件一行,用四个字段描述(合称 FRAS):
- F(Function):这个文件负责什么;
- R(Relations):改它之前,你还必须看哪些文件;
- A(API):它对外暴露什么接口、命令、格式;
- S(Non-obvious constraints):有什么从代码里看不出来的坑。
AOCI 自己仓库里的一个真实条目长这样:
atomic.go[CG9L]: F:Provides durable replace CAS, create CAS, atomic writes,
and no-clobber recovery moves | R:code:internal/fs/atomic_exchange_linux.go,...
| A:AtomicWrite,AtomicWriteCAS,... | S:Native publication never degrades to an
overwriting rename; ...
索引由 agent 写、agent 读,但治理是机器的:每个字段的长度上限写在二进制里而不是文本里,项目自己改配置也放宽不了;S 字段有准入门槛(必须”从代码推不出来、且能防止出错”才准写入)。这些设计让索引不会退化成一份没人维护的过期文档。
我最欣赏的一个细节是:AOCI 不信任”我读过了”这句话。 agent 通过 aoci_overview 读完整个索引后,必须提交一个 attestation(送达证明):回答 10 道针对索引内容的挑战题,序号正确率至少 80%、对象身份最多错一次。答旧版本的问题无效。这就把”他入职了”从一个口头声明变成了一个可验证的事实——防的是 agent 最常见的失效模式:自称读过,实际没读。
类似的做法已经有一些
给 agent 补项目认知不是新需求,这条路上已经有几个成型的方案,和 AOCI 的取舍各不相同:
- AGENTS.md:仓库级 agent 指令的事实标准,官方称有 6 万多个开源项目在用。它是纯 Markdown、人写一次、零校验的静态文件。AOCI 没有替代它,而是把一段托管块写进 AGENTS.md,在它上面叠加机读索引和治理——静态指令之上的一层”活文档”。
- Aider 的 repo map:机器生成的代码地图——用 tree-sitter 抽取定义与引用,图排序算法(源码里是 PageRank)按重要性排序,再按 token 预算截断,每次请求即时重建。它和 AOCI 是两个方向:repo map 永远新鲜、但永远浅,内容是签名和结构这类”结构事实”,原理上抽不出”这个文件为什么这样设计、什么不能改”(FRAS 里 S 字段的内容);AOCI 建起来贵,但建一次、之后只需廉价校验。
- MCP 协议 本身:它只管工具的传输与发现,不管工具返回的知识有没有被真的读进去、有没有过期。AOCI 的送达证明和漂移检测,补的正是协议之上的这一层。
- Claude Code 的 hooks:宿主在生命周期事件上做确定性拦截和注入的机制。AOCI 的宿主集成完全构建在这类机制上——比如”上下文压缩后强制重载索引”就是挂在 SessionStart 钩子上实现的。
一句话概括它们的分工:MCP 管连接,AGENTS.md 管静态指令,repo map 管结构地图,AOCI 管认知的持久化和保鲜。
实测中它被这样使用
在我两天的多批次开发里,四个启用了 AOCI 的会话呈现出完全一致的三段式用法:
flowchart LR
    A["开工<br>aoci_overview 装载索引<br>约 7 分钟"] --> B["编码中段<br>AOCI 调用 ≈ 0"]
    B --> C["收尾<br>aoci_maintain 漂移检测<br>aoci_update_entry 批量记账<br>约 90 秒/条"]
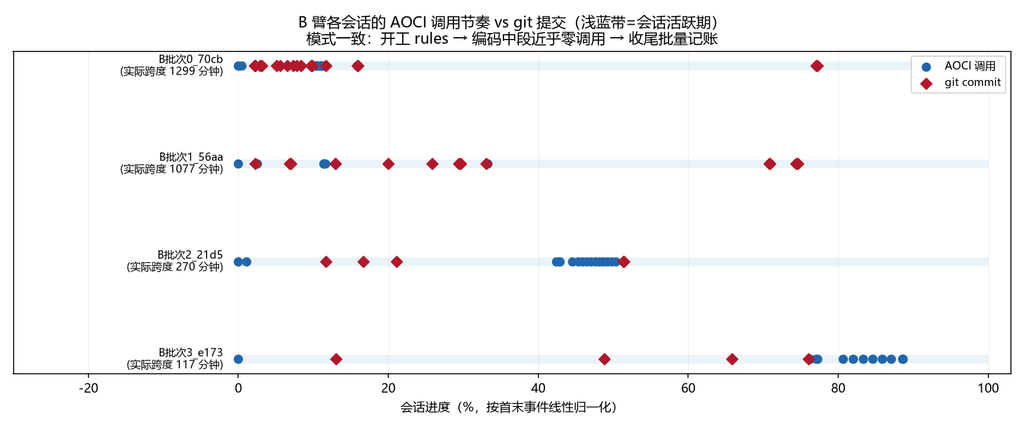
三个阶段的分工很清楚:开工时一次性装载认知,让 agent 知道系统全貌;编码中段它凭装载的认知干活,不去骚扰索引;收尾时把本次改动批量记回索引、跑一遍漂移检测(对比每个文件的 SHA-256 哈希,找出”记录和代码不一致”的地方)并逐条修复。装载和记账大约占每个会话 20%–30% 的首尾开销——这是这个工具的固定成本,后面会看到它换来了什么。
但这个节奏不是 agent 自然形成的,恰恰相反:AOCI 很容易被忘记用。 编码一旦进入状态,agent 中间一两个小时完全不会主动想起索引——B 臂批次 0 的 125 分钟编码段里,AOCI 调用是 0 次。如果没有外部的强制,中段的零调用意味着收尾记账也大概率不会发生,索引会无声地过期。AOCI 用提示词契约对抗这一点:AGENTS.md 托管块里写死”受管对象变更后,收尾必须调用一次维护”,连”每次编辑后逐文件维护”这种看似更勤快的做法都被明确禁止——高频骚扰只会让 agent 学会忽略。下图是四个 B 臂会话的实际调用节奏,蓝点(AOCI 调用)全部压在首尾,红点(git 提交)集中在中段,右侧那串密集的蓝点就是约 90 秒一条的收尾批量记账:
对照实验
实验对象是我手头一个正在开发的多批次项目(下文称”这个项目”)。设计:
- 同一份任务书、同一起点(基线提交)、同一个模型(GLM-5.3-Flash),两臂并行执行;
- A 臂:不启用 AOCI,由另一位提交者执行;
- B 臂:启用 AOCI,由我执行;
- 对比第一批次(批次 0)的编码段,这是两边任务完全重合的窗口。
先解释下文用到的几个统计口径,它们都来自对两臂全部执行轨迹的逐事件统计,不依赖任何主观判断:
| 口径 | 定义 |
|---|---|
| 真实工具错误率 | 工具调用返回错误标记(is_error)的次数 ÷ 全部工具调用次数。这是工具真实报错,不经任何模型评价 |
| 重读率 | Read 调用中,目标文件在近期已经读过的比例——衡量 agent 的”回看”习惯 |
| 冗余率 | 与此前调用重复(同工具、近似参数)的调用比例 |
| input tokens | 模型输入侧累计 token(token 是 LLM 的计量单位,约等于半个到一个单词),是成本的近似 |
结果:同成本,质量不同
批次 0 的核心数字:
| 指标 | A 臂(无 AOCI) | B 臂(AOCI) |
|---|---|---|
| input tokens | 50.80M | 51.18M(+0.7%) |
| 真实工具错误率 | 8.0%(28/350) | 3.2%(10/316) |
| 错误构成 | Bash 19 / Edit 8 / Write 1 | Edit 9 / Write 1 / Bash 0 |
| git 产出 | +857 行 / 7 commits | +1007 行 / 6 commits |
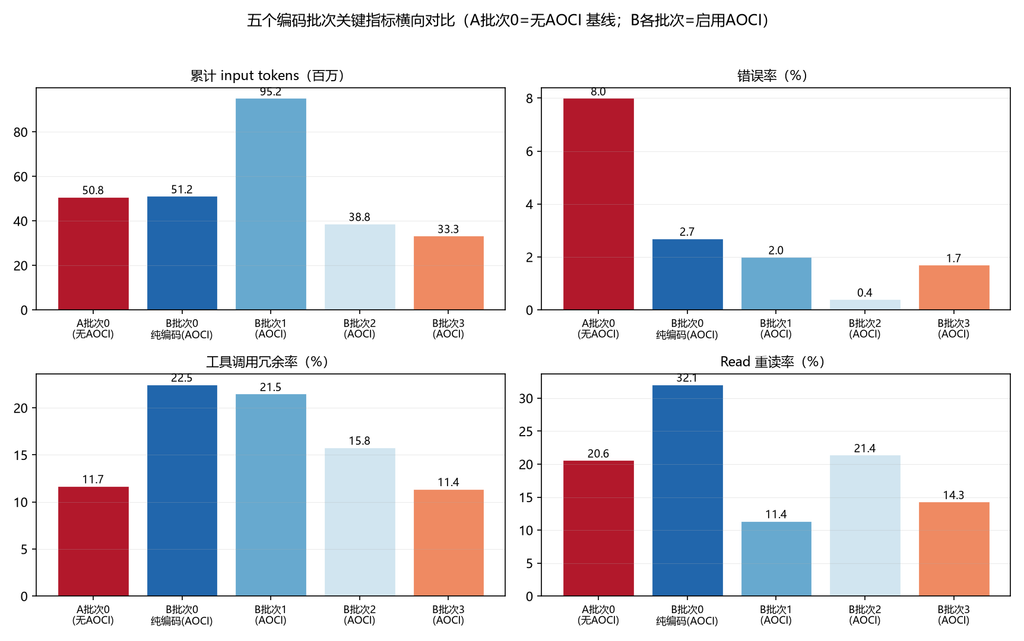
成本几乎持平,产出相当,错误率差 2.5 倍。而且 B 臂用同样的预算额外完成了对 A 臂代码的跨线审查(抓出 3 处真实缺陷,其中 1 处是安全漏洞)和合并执行。
错误的性质不一样
比数量更重要的是性质。看 A 臂的一个真实片段:
[THINK]  用 sed 给 check.ps1 做批量替换,保持 ASCII。
[ACTION] Bash: sed -i 's/^py -m pip/\$Py -m pip/; s/^py -m pytest/\$Py -m pytest/...'
[OBS]    10:$Py = Join-Path $root ".venvScriptspython.exe"   ← 反斜杠被吃掉了
[THINK]  sed mangled backslashes. Fix with Edit tool directly.
[ACTION] Read + Edit 修复
agent 用 sed -i 批量改写一个 Windows PowerShell 脚本,反斜杠在 sed 的替换语法里被转义吞噬,一条命令把门禁脚本改坏,然后花了额外的 Read + Edit 修复。这不是孤立事件:A 臂 28 个错误里有 19 个 Bash 错误,其中大部分集中在开工后前 35 分钟——环境试错、git 报 fatal、脚本被改坏。此时上下文才爬到 5–10 万 token,错误不是因为上下文过载,而是因为开工时对环境没有认知。
B 臂的 10 个错误则全部是 Edit/Write 纪律错误——没先 Read 就 Edit、字符串没匹配上——被编码代理的”先读后写”保护当场拦截,单次代价是 1 次 grep + 1 次 Read,几 K token 就恢复了。
一句话概括:A 臂的错误是已执行的破坏,B 臂的错误是被拦截的意图。 这也解释了图里另一个反直觉的数据:B 臂的重读率(30.0%)和冗余率(23.1%)反而比 A 臂高(20.6% / 11.7%)——低错误率不是靠”更少试探”换来的,而是靠”试探更安全”。多看一眼是廉价的,盲改是昂贵的。
成本花在哪了
B 臂的固定开销有两块:一次性建索引(104 个条目,12.8M tokens),以及每会话首尾的装载与记账(约 20%–30%)。下图是批次 0 两臂的逐轮上下文占用曲线,能直接看到成本的形态:蓝线(B 臂)整体比红线(A 臂)高出约 2–4 万 token——这就是索引装载的常驻开销,一次性抬升后不变;但两条线的斜率几乎一致,也就是说编码本身的节奏和消耗没有因为 AOCI 改变,多出来的只是首尾那笔”入职费”。之后三个批次的会话直接复用了这份索引,索引被反复摊薄。
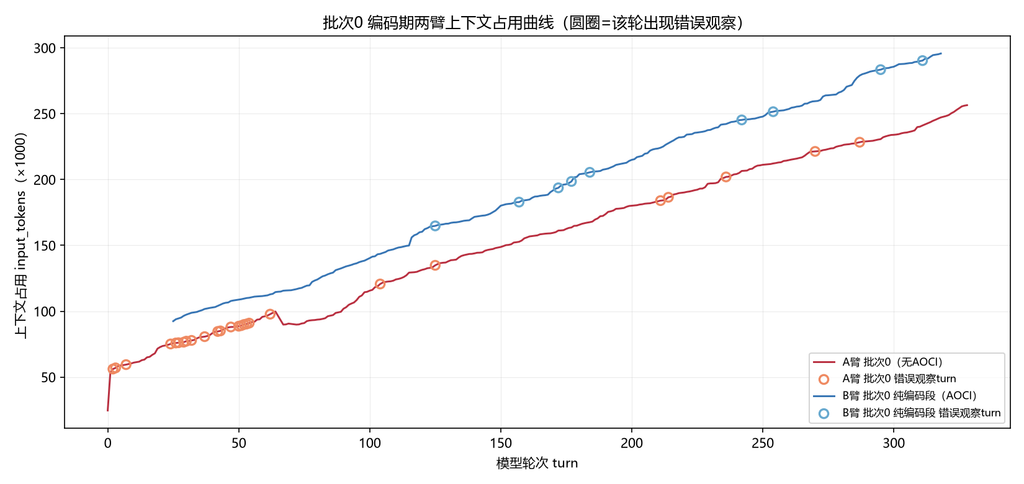
顺带一提,图里红圈(A 臂的错误轮次)密集压在前 60 轮的低上下文区——错误不是上下文过载的产物,而是开工期环境认知不足的产物,和上一节的结论对上了。
四个 B 臂会话的错误率全部落在 0.4%–3.2%,没有出现 A 臂 8.0% 这种离群值。
一场对称的事故
实验里最有意思的巧合:两臂独立踩中了同一个坑。这个项目在验证测试质量时会用自动化脚本临时改写源码生成缺陷变体,两臂都在这个环节出了事故——A 臂的脚本中断后把被改写的文件残留在工作区,靠人工恢复收尾;B 臂的变体泄漏进了一次提交,但 B 臂的处置是:回滚污染提交、给审计脚本加”写回前校验”的永久防御、再把这个教训写进项目台账收口。
同一个事故,两种终态。AOCI 的收尾记账机制要求”改动必须与索引对齐后才能收口”,事故必须以修复加固化的方式终结——它把一次事故变成了永久性防御,而不是一次人工恢复。
问题二:他干得比我审得快
还有一件更尴尬的事我必须承认。实验期间 agent 会反复提醒我:某个索引条目过期了、某个文件该补录了——而我经常正在忙别的,就是不理他。他会不会在心里偷偷骂我?
玩笑归玩笑,这里的结构性变化是真的:当 agent 的执行速度超过人类的审核速度,瓶颈就转移了。 过去是人写代码、人审核;现在是 agent 写代码,人成了瓶颈,而人在瓶颈期的第一反应往往是”先不看,反正测试是绿的”。
问题恰恰藏在”反正测试是绿的”里。轨迹分析发现了一批工具不报错、但逻辑错了的缺陷:某个校验函数没注册进框架,测试照样全绿(假绿);模板渲染把占位符原样输出到了页面上;一个被临时改写过的源文件混进了提交。这些在 is_error 口径里一个都看不到——工具没有报错,因为从工具的视角一切正常。
这类问题推动我做了第二件事:用我正在开发的一个 Agent 执行轨迹分析工具,把两臂共 5,427 个模型调用事件(包括每一次思考、工具调用和返回结果)全量导出、逐条扫描。这篇文章里的所有数字——错误风暴集中在前 35 分钟、B 臂错误全是纪律型、首尾记账节奏——没有一个能从最终的 git diff 里看出来。产物只告诉你他交付了什么,轨迹才告诉你他是怎么干的。
这两个工具合起来,回答的其实是同一个问题的两半:AOCI 管他知道什么(入职认知),轨迹审计管他做过什么(过程监督)。模型在变强,但这两件事不会因为模型变强而消失。
边界与建议
如实声明这次实验的局限:两臂由不同的人执行,个人风格差异无法剥离;B 臂后三个批次没有 A 臂对照;我只验证了批次 0 这个任务完全重合的窗口,这也是全文最强的一组证据——它是同任务、同日的直接对比,但不是随机对照试验。
AOCI 自己的不足,两天用下来我看到五个:
- 机器校验的是形式,不是内容。 漂移检测、送达证明全部通过,只说明索引和代码是同步的、agent 真的读过——不说明 agent 写的条目内容是对的。README 的 FAQ 也如实承认了这一点。S 字段里写错的”坑”,比没有这条记录更危险。
- 它只治理自家的九个工具。 “agent 忘记调用某个 MCP 工具”这个一般性问题,它没有解——所有机制都围绕自家索引展开。不过它的思路(收尾契约、hook 注入、响应内嵌下一步指令)可以平移到任何 MCP 工具上。
- 索引是全量装载,没有相关性排序。 不管当前任务是什么,开工都是整读索引。repo map 那种按当前任务文件加权的个性化排序(PageRank 的个性化向量),是它可以借鉴的方向。
- 多人协作和多项目场景没有给出现成答案。 索引是 Git 版本化的,理论上团队共享一份、随代码一起合并。但这次实验里两个并行会话的协调成本已经显现——互相确认、重复装载占了批次 1 成本膨胀的相当一部分,这只是同一个人的两个会话;换成两个人各自带着 agent 改同一份索引,合并冲突怎么办、每人负责的条目域怎么划,工具层面没有机制,只能靠团队自觉约定。多项目场景同理:索引按仓库组织,仓库之间的依赖关系(改了这个仓库的接口,那个仓库的索引条目就过期了)完全在治理范围之外。
- 索引是 AI 写的,这笔账不止是成本。 建索引花了 12.8M tokens,这是一次性投入,摊得掉;更麻烦的是它对文档的依赖是不稳定的——条目内容是从”当时的代码 + 当时的需求和设计”里提炼的。代码变了有 SHA-256 基线盯着,会报 Stale;但需求变了、设计推翻重来了,没有任何机制会发现。索引里的”为什么”可能基于一个已经被否决的设计方案,而漂移检测依然全绿。
实用结论:
- 值不值取决于任务形态。 多批次、长周期、频繁合流的项目,索引成本会被反复摊薄,收益明显;单会话、改几个文件的小任务,建索引不划算。
- 成本前提是缓存。 B 臂实测 input 缓存命中率 96% 以上,装载索引的开销靠缓存压平;如果你的推理后端缓存命中率低,首尾装载会明显变贵。
- 错误率要分开看性质。 “先读后写”这类纪律错误是廉价的,真正要防的是已执行的破坏和假绿——前者靠认知装载,后者只有审计轨迹才能发现。
- 收尾记账要赶在收口提交之前。 这次实验里部分记账发生在最后一次 commit 之后,最后的漂移修复没有经过提交验证——下次我会把
aoci_maintain排在 commit 前面。
参考链接
- AOCI-Code:https://github.com/aoci-spec/aoci-code
- AGENTS.md:https://agents.md
- Aider repo map 文档:https://aider.chat/docs/repomap.html
- Model Context Protocol:https://modelcontextprotocol.io
- Claude Code hooks 文档:https://code.claude.com/docs/en/hooks
发表回复