# Under the Sun with Paddy — 全量正文
====
# WordPress 平稳换主题:从本地验证到稳态的四阶段
https://www.paddysun.top/archives/5293 · 2026-09-17
> **系列**:paddy-newsprint 主题开发记 · 续篇
> **前置阅读**:[做了一个报纸风格的 WordPress Markdown 主题](https://www.paddysun.top/archives/5254) · [换装之后:75 到 93,三条军规的生产环境成绩单](https://www.paddysun.top/archives/5271) · [上线不是终点:主题没写错,麻烦都在它脚下](https://www.paddysun.top/archives/5288) · [越堆越厚:一张防护链的地图和它的盲区](https://www.paddysun.top/archives/5289)
> **主题分类**:实践复盘
> **阅读时间**:约 11 分钟
# 激活只是第三步:一次 WordPress 主题切换的四阶段变更管理
切换主题这件事,在 WordPress 后台点一下“激活”,耗时不到一秒。但围绕那一秒,我花了四天准备、三天监测,中间还踩了两个坑。
上一篇讲的是换完之后碰到了什么麻烦。这一篇往回退一步,讲那个“换”本身是怎么管的。核心就一句话:激活是整个流程里最没有技术含量的一步,真正花时间的是它前后的四件事,而每一件都有自己安静的方式让你翻车。
## 阶段零:本地先过一遍,别拿生产环境当调试器
主题在上线之前,我在本地搭了一套完整的 WordPress 环境,数据库是从生产拉下来的快照,插件列表一致。这一步的意义不是“看看能不能跑”,是“在不会弄坏任何人的前提下,把所有模板都走到”。
开 `WP_DEBUG`,逐个模板人工过:首页、单篇、归档、搜索、404、关于页。每个模板都要看到实际渲染,不能只看“没报错”。PHP 的 notice 和 warning 在生产环境通常被关掉,但它们是潜在问题的信号,本地必须开着。
然后是按需加载的逐项触发。我的主题里公式渲染、图表渲染、代码高亮这三个库是按需加载的,只有正文正则命中时才 enqueue。所以必须分别打开一篇含公式的文章、一篇含图表的、一篇含代码块的,确认每个库都在该加载的时候加载、不该加载的时候不加载。这一步如果偷懒,到了生产环境你不会知道某个库是不是在所有页面都多余地加载着,直到性能分掉下来才回头查。
有两个风险点是这个阶段抓出来的。
第一个,首页报头里用了服务端渲染的日期令牌。这意味着如果 HTML 被缓存 600 秒,页面上显示的日期会冻结在缓存生成的那个时刻,最坏情况差 10 分钟。处置是接受这个陈旧度,因为日期报头不是实时信息,10 分钟的偏差不影响任何人。但这个决策必须在本地做,不能到生产环境上线之后才发现日期不动了。
第二个,主题里有几个 pattern 引用了第三方域名上的图片,比如徽章。生产环境如果启用这些 pattern,就破坏了“零外部请求”这条原则,第三方域名挂了页面就慢。处置是清点站点实际用到哪些 pattern,没用的不启用,要用的考虑图片本地化。
这两个风险点如果在本地阶段没发现,到了生产环境就变成“为什么首页日期不对”和“为什么页面在等一个不认识的域名”这两类现场故障。本地验证的价值就是在这它们变成故障之前抓出来。
## 阶段一:换前基线,三到五天,三个视角
换主题之前必须在旧主题在产的时候采集基线。没有基线,换完之后的数字就没有可比性,你不知道“好”是真好还是只是不坏。
基线采三到五天,每天用同样的页面、同样的工具、同样的网络条件跑一次。判定标准我定的是正负 30% 以内算正常波动,不做过度归因。
采集必须分三个视角,不能混。
业务侧看的是流量层面:每小时请求量、各种拦截码的计数、封禁数。这些数字是你的站“正常长什么样”的基准画像。换主题之后路径和资源全变了,404 是这类变更里最容易放大的一条风险线,有基线才知道换完之后的 404 是正常新增还是异常激增。
服务器侧看的是机器本身:负载、内存、数据库慢查询、缓存命中率。换主题不应该影响这些,但如果新主题的资源加载方式不同,PHP worker 的消耗模式可能变。这一组数字是“机器有没有被新主题搞累”的参照。
CDN 侧看的是边缘命中率和回源量。换主题必须清缓存,清完之后命中率会掉,然后回升。有基线才知道回升到什么程度算正常。
表头必须写清采集时段和网络环境。同样的工具在早上跑和晚上跑,数字可以差 30%,不记条件就没有可比性。这条我定成铁律:基线表不写采集条件的,视为无效。
这一步还有一个测速方法上的坑,上一篇讲过但值得在这里再说一遍:源站直连视角在外面根本量不到。外部直连源站地址会被 WAF 挡成 403,要拿 PHP 的真实渲染耗时只能到服务器本机侧量。这意味着“边缘视角”和“源站视角”天生是两套数据、两台机器、两个采集条件,不能混在一张表里比。
## 阶段二:上线前检查清单,每一条都是踩过才加的
检查清单不是拍脑袋写的,每一条都是某个“差点出事”或“已经出事”之后加的。
先读服务器的安全运维文档。变更纪律是先读后改,因为生产环境上有别人或过去的自己留下的配置和约束,不读就改可能踩到不相关的红线。
备份要做三层:数据库全库导出、旧主题目录打包、记下当前激活的主题名。回滚不是“把新主题修好”,是“把旧主题重新激活加全量清缓存”。没有旧主题的完整备份,回滚就没有落点。
CDN 缓存规则要确认一件事:新主题新增的静态资源扩展名是否被已有的静态缓存规则覆盖。我的新主题自托管 woff2 字体,旧主题没有这个扩展名,所以必须确认缓存规则覆盖了 woff2,否则字体文件不进缓存,每次请求都回源。
WAF 适配要预演一件事:新主题的资源路径会不会触发 WAF 的 404 扫描封禁规则。主题换掉之后所有资源路径都变了,如果扫描器大量碰到 404,可能触发自动封禁。这个坑必须在上线前用预演发现,不能等上线后用真实流量撞。
最后一步是 wp-admin 的“实时预览”。WordPress 有一个不激活就能预览主题的功能,用它把首页和单篇过一遍。这不是验证,是最后一眼确认没有明显的渲染损坏。
## 阶段三:切换执行,选低峰,按顺序,不跳步
切换选在低峰时段。我的操作顺序是备份、激活、全量清缓存、逐页验证、缓存重建确认、运维文档记账。每一步做完再做下一步,不跳。
全量清缓存必须在激活之后立刻做。旧主题的页面缓存如果不清,新主题已经激活但访客看到的还是旧页面,混排是最糟糕的情况,比“整个站挂了”还难诊断。
逐页验证的清单和本地验证时一样,但多了两个维度:feed 和站点地图必须确认格式没变,登录页必须确认能正常加载。每个页面都应该是 200,不是 200 的要当场定位。浏览器开发者工具同时打开,确认字体加载成功、没有 404 资源、没有外部请求。
回滚条件我提前写死了四条:关键模板 5xx 或白屏、字体样式批量 404、误封激增、三十分钟内定位不了渲染损坏的原因。任何一条命中就回滚,不临场讨论。临场讨论的意思是你在压力下做判断,而压力下的判断质量是打折扣的。写死条件就是让回滚这个决策不需要判断力,只需要执行力。
回滚动作本身也写死了:重新激活旧主题、全量清缓存、缓存复核、运维文档记账。四个步骤,不需要思考,只需要执行。
## 阶段四:换后监测,前三天最紧,然后慢慢松
前三天每天采一次同参数快照,重点盯 404 计数。主题换掉之后资源和路径全变了,404 是这类变更里最容易放大的一条风险线。新主题资源如果 404,被扫描器盯上会放大;如果同时触发了 WAF 的 404 扫描封禁规则,可能变成误封。所以 404 计数是这一阶段的核心指标,不是性能分。
缓存命中每天验一次。首页和字体文件必须命中,单篇文章页一开始可能 MISS(每次回源),这是预期的,但要确认它不是因为缓存规则没配对。
前两周每周做一次更深度的检查:主题版本和模板文件完整性(用 wp-admin 的主题文件编辑器抽查几个关键文件,确认没有被意外修改)、第三方性能分复测、搜索引擎收录快照抽查渲染是否正常。最后一条是因为换主题会影响 HTML 结构,搜索引擎需要重新爬一遍才能适应新的 DOM。
稳态之后,把换后实测数值更新为新的基线,然后并入现有的例行巡检节奏,不再有额外动作。
## 两个坑
第一个坑在阶段三。上传主题安装包的时候,站上一个对象存储同步插件被上传钩子唤醒了。它的配置还是空的,直接 fatal。这件事的教训不是“记得配置插件”,是“你改的是主题,但被牵连的东西不在你的改动范围里”。阶段二的检查清单里从此多了一条:所有带上传钩子的插件,配置必须提前备好,不能留空配置激活。
第二个坑更早,在阶段一和阶段二之间。换主题之前我调了一次 WAF 规则,为了看新规则的行为对不对,切到了观察模式。然后忘了关,开了两天半。那两天半里来了三起洪水,WAF 在观察模式下全部放行,源站被打穿。这个坑的教训是:观察模式不是安全状态,是裸奔状态。切完规则必须当天回来看,确认完就切回拦截。换主题的窗口前后尤其不能再开观察模式,因为那几天每一项变更都需要 WAF 在拦截状态兜底。
## 这套流程里什么没做
本地验证只覆盖了“模板能渲染、资源能加载”这一层。没有在本地跑真实流量压测,因为本地环境的 PHP 版本、数据库数据量、缓存行为都和生产不同,压测结果的参考价值有限。真实的性能验证完全依赖阶段一的基线对照和阶段四的监测。
阶段一的基线采集窗口是三到五天,但如果在这个窗口里恰好遇到了异常流量事件(比如一次洪水),基线会被污染。我没有做“剔除异常天”的标准化处理,只是凭经验判断哪些天的数据应该排除。这在流量较小的站上够用,规模一大就需要更严格的统计方法。
阶段四的搜索引擎收录适应期观察只做了两周。实际上 WordPress 换主题之后搜索引擎可能需要更长时间才能完全适应新的 HTML 结构,两周只是“看起来正常了”,不是“已经稳定了”。
## 收尾
激活那一秒做完之后,真正的安全感来自四样东西:旧主题的完整备份、一份写清采集条件的换前基线、四条写死的回滚条件、前三天每天一次的同参数快照。这四样东西缺任何一样,出事的时候你就得临场判断,而临场判断的质量是打折扣的。
主题现在是 0.10.13,系列写到这儿,从主题设计到性能到运维到防护链到变更管理,五个角度走完了。如果这篇有第六篇续篇,大概该写这套流程本身怎么固化成脚本和检查清单,让它不依赖我的记忆。但那件事我还没做,做了再写。
====
# 网站防护架构图:四层防线与它们的静默失败
https://www.paddysun.top/archives/5291 · 2026-09-16
## 越堆越厚:一张防护链的地图和它的盲区
上一篇结尾我说,这套防护链已经复杂到需要一张自己的地图,而复杂本身就是新的风险。这一篇就是那张地图。
它不是一次事件的复盘,是站在一个时间点上往回看,把两个月里因为不同原因加上去的每一层防线画在同一张图里,看它们各自管什么、各自怎么坏,以及层与层之间的缝隙里漏过什么。
> **系列**:paddy-newsprint 主题开发记 · 续篇
> **前置阅读**:[做了一个报纸风格的 WordPress Markdown 主题](https://www.paddysun.top/archives/5254) · [换装之后:75 到 93,三条军规的生产环境成绩单](https://www.paddysun.top/archives/5271) · [上线不是终点:主题没写错,麻烦都在它脚下](https://www.paddysun.top/archives/5288)
> **主题分类**:架构复盘
> **阅读时间**:约 12 分钟
## 从外往里数,一共四层加一片空白
请求从访客发出到源站的 PHP 开始执行,中间经过的每一道关卡都是后来加的。最初只有源站和防火墙,后来加了 CDN,再后来加了 WAF,再后来在 WAF 上面又加了边缘规则。每一层都不是一开始就规划好的,是出了事才补的。
```mermaid
flowchart LR
A[请求进来] --> B[边缘缓存层]
B -->|未命中| C[应用防火墙层]
C -->|放行| D[网络防火墙层]
D -->|白名单| E[源站]
B -->|命中| F[直接返回]
C -->|拦截| G[4xx 段]
C -->|限速| H[429 → 封禁链路]
D -->|非白名单| I[丢弃]
E -->|过载| J[503 透传]
```
边缘缓存层管“绝大多数请求根本不该到源站”,应用防火墙层管“到了源站之前的请求是不是恶意的”,网络防火墙层管“谁有资格回源”,源站自己管“拿到请求之后怎么处理”。看上去各司其职,问题出在每一层都有自己安静的失败方式,而失败的时候它不一定告诉你。
## 先认是谁拦的,再去看代码
这一段上一篇讲过,这里只收口成一条可复用的方法。
出异常时第一件事不是看代码,是认“这是谁拦的”。每一层的拦截都有自己的签名:应用防火墙的攻击拦截走 4xx 段,响应体里带它自己静态资源的路径特征;人机验证和自定义规则是同一段里的另外两个编号;边缘平台的自定义规则拦截走 5xx 段的一个自有编号,响应头里带平台标识和一个日志 UUID;503 是源站过载的透传,不是任何一层“拦”的。
先看状态码落在哪一段,再看响应头和响应体的特征,就能定位到是哪一层在动作。然后只去看那一层的规则和日志,比在几套系统里乱翻快得多。这个方法在上一篇文章里那条通配符事故中救了我一整天的排查时间。
## 每一层都会安静地坏掉
这是这张地图上最重要的标记。不是“可能坏”,是“已经坏过了,而且坏的时候没出声”。
**边缘缓存层的失败方式是“该缓存的东西没缓存”。** 文章页一开始没进缓存,每次都真实回源,这条攻击路径一直开着。而验证缓存又有一个坑:HEAD 请求永不被缓存,用 `curl -I` 验证会看到永远 MISS,把一个漂亮的命中误判成“缓存失效”。必须 GET 二连看 Age 有没有递增。这个坑本身不危险,危险的是你以为缓存是好的、实际不是。
**应用防火墙的失败方式是“它被调到了观察模式,然后有人忘了关”。**
这件事上一篇没展开。换主题之前我做了一次 WAF 规则调整,为了看新规则的行为对不对,把拦截模式切成了观察模式。观察模式的语义是“匹配到了只记录不拦”,等价于这一层临时不存在。然后我忘了关,它开了两天半。
那两天半里来了三起洪水,全部是慢速 GET 页面洪水,正好打在文章页没缓存的窗口上。WAF 在观察模式下全部放行,源站的 PHP 被打穿,503 透传给访客。等到我发现的时候,日志里躺着三天的事件记录,每一行都是“匹配到了,未拦截”。
教训是两条。第一,WAF 规则变更一律先开观察模式跑一段,从日志确认匹配行为再切拦截,这是对的;但切完之后必须在当天回来看,观察模式不是安全状态,是裸奔状态。第二,换主题的窗口前后严禁再开观察模式,因为那几天你在改模板、改路径、改资源 URL,每一项变更都需要 WAF 在拦截状态兜底。
**网络防火墙的失败方式是“开机时静默丢掉了启动任务”。** 上一篇详细讲过的 systemd 排序环:一个定制服务的排序声明自相矛盾,每次开机必然成环,systemd 解环时丢一个 job,丢谁不固定。这次轮到防火墙被丢,它从开机起就没启动过,但 enabled 状态不变、配置文件里的开关写着 yes、失败列表是空的。四种检查项里三项绿、一项红,而那一项红必须靠查防火墙运行状态才看得到。
这个环是存量缺陷,不是某次升级引入的。平时大概率一直在吞另一个服务(那个服务在已初始化的服务器上近乎无害),偶尔轮到防火墙才被抓到。修复是删掉那条排序声明,但那个服务包一旦更新就得重新核一遍。
**封禁链路的失败方式是“那个本该盯着它的哨兵没在跑”。** 上一篇文章里白名单漏了第 196 条 CIDR,那个缺口的最佳观测点是自检哨兵,它专门检测“有没有请求来自白名单之外的 IP”。但它的定时任务在快照回滚中丢了,没人发现。原因是哨兵只写异常行不写汇总行,于是“没运行”和“运行了且一切正常”在日志里长得一模一样。
四层,四种静默失败。每一种的根因都不同,但有一个共同点:如果不是因为别的症状顺便暴露了它,它会继续安静地待下去。
```mermaid
flowchart LR
EC[边缘缓存层] -->|坏的样子 该缓存的没缓存| CACHECHK[只能靠 GET 二连看 Age]
WAF[应用防火墙层] -->|坏的样子 停在观察模式| WAFCHK[只能靠查当前模式是不是拦截]
FW[网络防火墙层] -->|坏的样子 开机时启动任务被丢掉| FWCHK[只能靠查运行状态和开机日志]
BA[封禁链路] -->|坏的样子 哨兵没在跑| BACHK[只能靠查日志里有没有汇总行]
```
## 层与层之间的缝隙
有些问题不属于任何一层,它落在层与层之间的接缝上。
第一个接缝是“诊断代码和被诊断代码共享同一个假设”。上一篇文章里,白名单漏项的诊断循环用了 `while read`,和被诊断的加载循环犯了完全相同的跳过末行的错误,于是第一轮结论是“缺失 0 条”。检测方法必须独立于被检测代码的假设,否则同错相消,你什么都看不见。这条原则不只适用于 shell,适用于任何“你写的工具去检查另一个工具的输出”的场景。
第二个接缝是“快照回滚会抹掉跨层的取证证据”。排序环的跨启动证据、白名单哨兵的定时任务、当天做完的几项正确变更,全部在一次回滚中消失。回滚是时间机器不是撤销键,它不区分“要撤销的”和“不要撤销的”。这意味着:如果你的取证证据只存在磁盘上,一次回滚就能把它们全清掉。上一篇文章里我为此丢掉了排序环的全部跨启动考古材料,此后只能靠每次重启后 grep 一次来维持监测。
第三个接缝更隐蔽:每一层各自看都是好的,但叠在一起产生了新的盲区。边缘缓存层在正常工作,所以大部分请求到不了 WAF;WAF 在正常工作,所以到达的请求里恶意的大多被拦了;防火墙在正常工作,所以白名单外的回源被丢弃了。这条链看起来很完整,但它意味着:如果有一个请求类型恰好穿过所有层的“正常”路径,比如一个慢速的、来自合法 IP 的、请求静态路径的、不需要回源的 GET,没有任何一层会觉得它有问题。而慢洪水就是这种请求。
```mermaid
flowchart LR
R[慢速 GET 一个合法路径] --> A[边缘缓存层 未命中 按规则回源]
A --> B[应用防火墙层 请求合法 放行]
B --> C[网络防火墙层 来源在白名单里 放行]
C --> D[源站 PHP 照常执行 直到过载]
D --> E[四层判断都没错 合起来漏掉了这类请求]
```
## 应用层自己也能做点什么
WordPress 本身不是全然被动地等着被保护。我在应用层挂了一个安全插件,定位是“应用感知的告警器”,不是 volumetric 防御。
它管的三件事是:登录爆破限制(3 次失败就锁,管理员开二次验证)、404 扫描限制(爬虫和人类分开计数,超限封禁)、请求总量限速(动作用 throttle 而非 block,拖住即可不产生 503)。
它在这一轮里完成了全部四次封禁,但都是在 404 扫描这个场景。慢洪水一个都没抓到,因为慢洪水的请求是合法路径的 GET,应用层看不出它和正常流量的区别。
这个定位要拿准。如果指望它扛 volumetric 攻击,你会把阈值调紧,然后第一个被挡住的是自己。打开媒体库网格时并发拉几十张缩略图,登录 cookie 让缓存把请求全部放回源站,一瞬间超阈值,人机验证粘滞一个小时,媒体库卡死。上一篇文章里我踩过这个坑。应用层防护是最后一道意识,不是第一道城墙。
## 空白区:主机侧
地图上从边缘缓存到源站 PHP 之间画了四层,源站往里是一片空白。
这片空白不是我忘了画,是我评估之后决定不填。我调研了云厂商提供的一个主机侧排查工具,功能矩阵很清晰:病毒查杀含 webshell 检测、异常登录记录、弱口令扫描、进程和网络连接研判。它恰好补上现有体系对落盘文件的零覆盖——上传目录和插件目录是 webshell 的常见落点,而前面四层全在边界,没有一个看主机里面。
不装的原因有三条。第一,它需要一个常驻客户端,而我的原则是尽量不增加常驻组件;每个常驻的东西都是一个需要维护、可能被更新搞坏、可能在某次重启后不启动的新依赖。第二,它的“隔离”动作对 WordPress 站点太危险,插件和主题里的混淆代码容易误报,点一下隔离就是站点故障。第三,它的定位是触发式应急工具,真出事再装来得及,平时挂着只增加运维面。
这片空白是刻意的。但它是地图上最大的未标记区域,也是我最没底的一块。如果有一天边界层被绕过——不管是因为配置错误还是因为零日漏洞——这片空白就是攻击者唯一需要面对的对手。目前它唯一的覆盖是:每周的例行巡检脚本会查配置层的几项基线,但那不是文件和进程层的检测,只是“配置有没有被改过”。
## 复杂本身是新的风险
这是这张地图最后一条标注,也是我在画完它之后最明显的感觉。
每一层单独看都有存在的理由。边缘缓存把绝大多数请求挡在源站之外,WAF 拦住恶意模式,防火墙只放 CDN 回源,封禁链路对高频 IP 自动拉黑,应用层补一个登录爆破和 404 扫描的收口。每一层都是在一次具体的事故之后加的,不是拍脑袋。
但层的数量本身就是风险。每一层都有自己的配置面,每一次变更都可能碰歪某一层;每一层都有自己的静默失败模式,而失败模式之间不互通——缓存层失败看 Age,防火墙失败看 `journalctl`,封禁链路失败看哨兵有没有汇总行,WAF 失败看它是不是被切到了观察模式。你得记住每一层的体检方法,还得记住每一层“看起来好实际坏”的签名。
然后还有层间的接缝。诊断代码不能共享被诊断代码的假设。快照回滚不区分要留的和要扔的。一层放行的东西下一层不一定拦,而一个精心构造的请求可以穿过所有层的“正常”路径。
两个月前这张地图上只有防火墙一层。现在有四层加一片空白。下次出事的时候,大概率还会再加一层。每一层都让“常规攻击”更难过,但也让“诊断出了什么事”更难了一步。
## 哪些没做、哪些没证明
主机侧的空白是刻意的,但也是未验证的。我评估了那个工具,没装也没测过它在真实场景下的检出率和误报率。“真出事再装来得及”是一个判断,不是一个结论。
封禁链路目前只有“自动封 + 手动解封”。没有自动解封机制,封错了就只能人去放。在一个人维护的站上这没问题,但规模一大就会变成瓶颈。
边缘层的 CC 模块我还没有启用。如果启用,单 IP 的高频请求在边缘就吸收了,零源站压力。但多一层意味着多一套配置要维护,多一种静默失败的可能性。我没有证明“不启用比启用好”,只是现在的洪水规模还到不了需要它的程度。
最后,这张地图本身只覆盖了我这台机器。它不是通用架构,里面的每一层、每一个阈值、每一个失败模式都是在具体的环境里撞出来的。抄不了,只能当参照。
## 收尾
主题现在是 0.10.13,防护链现在是四层加一片空白。主题的代码我一行一行写的,每个函数为什么在那儿我都知道。防护链不是,它是事故堆出来的,每一层都带着一次半夜爬起来的记忆。
地图画完了。下一件事不是再加一层,是回头检查每一层的体检方法是不是都在例行巡检里,以及那张巡检清单本身有没有哨兵。
====
# WordPress 主题更换后的服务器运维与排错实录
https://www.paddysun.top/archives/5286 · 2026-09-16
## 上线不是终点:主题没写错,麻烦都在它脚下
上一篇的结尾我把话说得太漂亮了。单篇 TTFB 从 0.721 秒降到 0.317 秒,性能分 93,缓存命中,字体 preload,一切都在预期里。收尾时我写了一句“还有一大块免费的速度没有领”,然后关电脑睡觉。
后面的两周证明,难的部分根本不在这儿。
> **系列**:paddy-newsprint 主题开发记 · 续篇
> **前置阅读**:[做了一个报纸风格的 WordPress Markdown 主题](https://www.paddysun.top/archives/5254) · [换装之后:75 到 93,三条军规的生产环境成绩单](https://www.paddysun.top/archives/5271)
> **主题分类**:实践复盘
> **阅读时间**:约 14 分钟
我把这段时间真正让我半夜爬起来、或者事后拍大腿的问题数了一遍。它们的共同点很清楚:没有一个出在主题代码里。主题是我自己写的,每个函数为什么在那儿我都知道;难缠的是它脚下那台机器。内核会升级,CDN 的回源段会变,缓存规则会影响你怎么改一段文案,攻击流量会挑你最虚的那一刻来。这些东西不会出现在 git diff 里,但它们决定站点是活着还是死了。
这一篇讲的就是这堆事:换主题之后怎么运维、怎么测,以及当一个“看起来像主题 bug”的现象出现时,怎么把它定位到真正的地方。
## 上线那一晚,全绿
9 月 13 日晚上激活新主题,全量刷新缓存,然后逐页过:首页、单篇、归档、搜索、404、关于页,再加上含公式、含图表、含代码块的实页,还有 feed、站点地图、llms.txt、登录页。浏览器开发者工具确认字体加载成功、没有 404 资源、没有外部请求。全部通过。
当晚就撞上第一个跟主题无关的问题。上传主题包的时候,站上一个对象存储同步插件被上传钩子唤醒了。它的配置还是空的,直接 fatal。
这是整段经历里的第一次提醒:你改的是主题,但被牵连的东西不在你的改动范围里。
## 先把“换主题”当成一次变更管理
激活,是整个流程里最没有技术含量的一步。真正花时间的是前后四件事。
**换前体检。** 先把主题的缓存行为过一遍:有没有外部请求,资源是不是按需加载,版本号用什么做参数。结论决定后面重点核对什么。我这套主题的版本号用的是文件修改时间,文件一动 URL 就变,天然破缓存;但正文模板里嵌着几枚第三方徽章图,那算是“零外部请求”这条军规的破口。
**换前基线。** 同页面、同工具、同网络,采三到五天,表头必须写清采集时段和网络环境,否则数字之间没有可比性。判定标准我定的是正负 30% 以内算正常。
**回滚条件先写死。** 关键模板 5xx 或白屏、样式字体批量 404、误封激增、三十分钟内定位不了——任何一条命中就回滚,不临场讨论。
**换后监测。** 前三天每天采一次同参数快照,重点盯 404 计数。主题换掉之后资源和路径全变了,404 是这类变更里最容易放大的一条风险线。
两个测速方法上的坑必须单独说,它们决定你拿到的数字是真是假。
第一个:源站视角在外面根本量不到。我试过直连源站地址,回环地址也一样,全被边界防护挡成 403。要拿 PHP 的真实渲染耗时,只能到服务器本机侧量,而那是另一台机器、另一条链路。这意味着“边缘视角”和“源站视角”天生是两套数据、两个采集条件,不能混在一张表里比。
第二个:验证缓存不能用 `curl -I`。HEAD 请求不会被 CDN 缓存,永远是 MISS,会把一次漂亮的命中误判成“缓存失效”。必须用 GET 拉完整响应,同一个 URL 连打两次,看第二次的 Age 有没有递增。
这两个结论后来固化成了两个小脚本:一个负责多页面计时、输出逐轮和中位数的表格,一个负责二连 GET 的缓存判定。脚本本身没什么技术含量,真正值钱的是上面那两条反面教训。
## 防火墙没起来,而且它不打算告诉你
换装完成后的第一个维护窗口,我给服务器做了一次内核升级。重启之后例行检查,其中一项亮红灯:防火墙。
它的状态长这样。
- 服务是 enabled
- 配置文件里开关写着 yes
- 当前状态:inactive
- 本次启动的服务日志:零条目
- 失败服务列表:空的
翻译过来只有一句话:它从没启动过。而且它不在任何“失败”统计里,因为这次开机的启动事务里根本没有它这一项,job 被删掉了。
一条命令定性:
```
journalctl -b -t systemd --grep 'ordering cycle'
```
输出是两行:
```
network-pre.target: Found ordering cycle on <防火墙服务>.service/start
network-pre.target: Job <防火墙服务>.service/start deleted to break ordering cycle ...
```
(服务名做了替换,不点具体是哪个防火墙。)
查这个环必须加 `-t systemd`。不加的话,grep 会匹配到你刚刚执行的那条命令本身,得到一个假阳性,然后你会以为自己找到了问题。
根因在开机依赖图上:有一个定制服务同时声明了“在网络服务之后启动”和“在系统初始化的最早期之前启动”。这两个条件在时间上不可能同时满足,于是每次开机必然成环,systemd 每次都要丢掉一个 job 来解环,丢谁不固定。这次的倒霉蛋是防火墙,别的时候是别人。
```mermaid
flowchart LR
S[那个定制服务] -->|声明一 要在网络就绪之后启动| N[网络就绪目标]
N -->|声明二 又要早于网络就绪启动| S
S -.->|两条声明不可能同时成立| C[systemd 每次开机丢一个启动任务来解环]
C -.->|丢谁不固定| F[这次丢的是防火墙]
```
这件事同时解释了一个长期困惑:为什么过去几次“重启后验证通过”的结论时而成立时而翻车。因为环一直在,中招对象是随机的,不查真的不知道。修复是删掉那条自相矛盾的排序声明,之后连续几次重启 grep 都是零输出。留了一个提醒给自己:那个服务包一旦更新,这行要重新核。
然后是这两周里最贵的一课,跟技术无关。
当晚我因为轮换登录凭据把自己锁在了门外,最后用救援模式回滚了几个小时前的快照。回滚很顺利,站点立刻恢复。但快照回滚不是撤销键,是时间机器:它撤销的是那个时间点之后的一切,包括已经做完并且验证过的正确变更,也包括我刚取证完的日志。排序环的跨启动证据就这样没了,这个问题此后只剩两个监测点,每次重启后 grep 一次,以及例行检查里看一眼防火墙状态。
新纪律只有一条:每个维护窗口开工前先拍快照,快照 ID 记进运维账本;真要回滚,目标永远是账本里最近那一条 ID,不靠记忆。
## 白名单里少了的第 196 条
第二件事更安静。
CDN 的回源节点段每周会变,服务器上有个脚本定时去拉最新清单,写进防火墙的白名单集合,只放这些段回源。某天收到回源节点变更通知,我顺手核了一下拉取是否正常。
清单是 196 条,集合里只有 195 条。缺的正好是排序后的最后一条。
三层原因叠在一起:
第一层,写清单的代码是 `'\n'.join(sorted(set(...)))`,结尾不带换行符。
第二层,加载循环 `while read -r cidr; do ... done < "$ACL"` 会跳过没有换行符的末行。
第三层,日志打印的是“加载完之后集合的条数”,所以它每次都报一个自洽的数字,195,看起来毫无异常。
```mermaid
flowchart TD
A[写入端 join 之后不补换行] --> B[清单末行没有换行符]
B --> C[加载循环 while read 跳过没有换行的末行]
C --> D[集合比清单少一条]
D --> E[日志只报集合条数 数字自洽]
```
后果是每周静默漏一条。如果某天有一条新节点正好排在末位,它的回源会被防火墙丢掉,用户看到的就是 502。这次核查了丢包日志,漏掉的那条当时并没有在服务,所以它属于潜在缺陷,而不是已经发生过的故障。
诊断过程里还有两个跟“数数”有关的坑。
`wc -l` 不统计没有换行符的末行。我用它数清单,先后得出两个错误结论:先算出 195,又把 diff 出来的 196 当成“多出一条”。
更讽刺的是第二个。我自己写的检测循环也用了 `while read`,于是复现了完全相同的跳过,第一轮结论是“缺失 0 条”。检测方法必须独立于被检测代码的假设,否则同错相消,你什么都看不见。
修复是三处一起上,做双保险:
```
# 写入端补换行
open(path, 'w').write('\n'.join(sorted(set(data))) + '\n')
# 读取端加守卫,兼容无换行末行
while read -r cidr || [ -n "$cidr" ]; do
ipset add cdn_origins "$cidr"
done < "$ACL"
# 日志加对比数字:集合条数 vs 清单条数,两个数不一致立刻暴露
```
第二层问题比这个缺陷本身更值得记。这个脚本配了一个自检哨兵,专门检测“有没有来源在白名单之外的请求”,理论上正好能抓住上面这个漏项。但它的定时任务在两周前的一次快照回滚里丢了,没人发现。原因是哨兵只写“有异常”的行,不写汇总行,于是“根本没运行”和“运行了一切正常”在日志里长得一模一样。修复之后的输出变成两行,扫一眼就知道跑没跑:
```
cdn_origins entries: 196 (清单条目: 196)
cdn-origins-check: 检查 N 个来源IP, MISS 0 个
```
## 阈值是量出来的,不是拍出来的
九月上旬连着四起慢洪水,外加一个大攻击日。快攻那天的记录是 6080 次 403 加 4533 次 429,说明高水位限速工作正常。但那四起慢洪水的强度全落在限速窗口以下,一个 429 都没触发;而 503 全部透传,封禁链路完全没有信号可抓。
先把地板量出来。正常时段全站每小时三位数的请求量;我自己在后台编辑的峰值大约每分钟 2 个请求。而 PHP 被打到回 503 的那个门槛低得离谱:有一次某个来源用半个多小时、极慢的节奏把源站打穿了,几乎每一个请求都换回一个 503。具体数字我不在这里写,写了等于把一份现成的施压配方递出去,只能说这台机器不是按“能扛压力”设计的。
结论是,这台小机器的防护链是照着“高水位快攻”配的,慢洪水正好从缺口里走进去。
接下来是最难堪的部分,我第一轮统计算错了,而且连错三次。
排查用的日志分析脚本按时间窗过滤,比较的是时分秒字符串,没有比较日期。跨天之后,前一天的行会被累进“最近 N 分钟”:
- 第一次算出“10 分钟 4.2 万请求”,实际是每分钟 470;
- 第二次得出“慢洪水仍在活跃”,实际那些行是两天前的;
- 第三次报告“上千个 429 没有被封禁”,实际是多天累加加上旧快照。
三条全错,而且都指向同一个方向,差点让我去改一套本来就正常工作的封禁逻辑。铁律:时间窗统计必须带日期守卫,或者干脆用 `tail -N` 截窗口。
修正后的建议是三层,动作收敛到同一条封禁链路:
层条件阈值防什么登录口登录 POST,每 IP按实测地板标定登录爆破突发非静态路径,每 IP同上,窗口更短并发循环总量非静态路径,每 IP同上,窗口更长慢洪水
这三层的具体数值我故意不写。阈值本身就是防护的一部分,公开它等于告诉对方卡在哪个数下面最安全,而这一节前面刚讲过慢洪水是怎么从缺口里钻进去的。三层怎么切、每层防什么,比具体填多少更值得参考。
静态扩展名(图片、字体、CSS、JS、视频)整档豁免在外。改完必须自测:临时把阈值调到 2 次/10 秒,自己连刷三下,确认 429 触发、封禁链路收到了,然后立刻改回。还有一条铁律,503 永远不能作为封禁信号,它是上游故障的透传,不是攻击证据。
阈值放宽之后又踩了一次,这次伤的是自己。媒体库打开网格时会并发拉几十张缩略图,而登录 cookie 会让缓存策略把带登录态的请求全部放回源站,一瞬间超过阈值,触发了人机验证。验证粘滞 60 分钟,表现就是“媒体库卡死”。处置是把阈值放宽一个量级,并且在重媒体操作之前临时加白名单。
这里有个真实的教训:阈值调紧的时候,第一个被挡住的是站长自己。
## 把页面搬到边缘,比调阈值更管用
四起洪水里三起是 GET 页面洪水。也就是说,只要页面 HTML 在边缘节点就命中,PHP 根本不参与,慢洪水就失去了杀伤力。而当时只有首页 HTML 进缓存,文章页每次真实回源,这条攻击路径一直开着。
把文章页也放进 600 秒缓存之后,单篇 TTFB 从 0.317 秒继续降到 0.1 秒以内,真正落到源站上的动态请求降了一个量级,慢洪水的性价比也就没了。
缓存规则上的坑,都是实测撞出来的:
- 路径条件是精确匹配。写 `/feed` 命中不了 `/feed/`,两个都要列。
- 站点地图清单要对着真实地址核一遍。我那份里有一堆从来没被访问过的死条目,是另一个插件留下的命名习惯。
- “静态扩展名”这一档里包含 txt,所以 `/llms.txt` 走的是静态缓存。但源站如果返回 `Cache-Control: private, no-store`,边缘就不会缓存它。这个行为正好在 0.10.13 上撞了一次:新版本把 `/llms-full.txt` 改成默认关闭,关闭状态下它返回 403 加 no-store,我用两次 GET 验证,Age 一直不出现,确认没有被缓存,所以在设置页打开它之后是立刻生效的,不需要手动清任何东西。
- 静态文件可能被“启发式”缓存过。有一次更新说明页之后仍然看到旧版本,最后只能按 URL 单独刷新。此后更新静态资源一律优先换文件名做版本化,不指望缓存规则。
## 689 个文件搬走之后
上一篇结尾我说了要做图床迁移,把所有上传文件搬到对象存储。做完之后有几个决定值得写下来。
**桶保持私有读写。** 未授权直连桶的默认域名会直接 403,这本身就是一层防直连盗链,比桶级防盗链省事,而且桶级防盗链会误伤边缘回源,因为回源请求不带访客的 Referer。
**URL 改写是运行时的,不是写进数据库的。** 插件在渲染时通过一组过滤器把附件 URL 换成加速域名。这个机制决定了三件事:不用改数据库,文件传上去 URL 就自动变;回滚就是停用插件,前提是本地文件别删;改写是无差别的,没上传成功的附件也会被改写成加速域名,于是上传缺口会直接表现为裂图。所以完整性校验不是可选项。
迁移当天踩的坑里,最致命的是一个空字段。
坑现象处置自定义域名没填改写指向桶的默认域名,私有桶下匿名访问 403,全站裂图在插件设置页填上加速域名后台“首次同步”报超时界面提示失败UI 报错不等于后端停了,两次“失败”之后文件其实已经全部传完;要确定性可以走插件自带的命令行上传上传目录里的 .php 请求返回 566以为坏了预期行为,边缘和 WAF 会拦掉上传目录里的 PHP
完整性校验的方法很土但有效:把本地上传目录的文件全量列出来,按加速域名逐个请求,200 算已上传,566 算被安全策略拦下的正常项,404 就是缺口。结果是本地 690 个文件、689 个可用,唯一“缺”的那个是上传目录里的一个 PHP 缓存文件,本来就该被拦。之后又扫了文章、首页、列表页和说明页,零裂图。
**最小权限这块翻了两次车。**
一是策略模拟器。它默认把资源字段填成 `*`,然后告诉你“全部拒绝”,看起来像权限根本没配上。测单桶策略必须把要验证的具体资源填进去。
二是资源名的写法。对象存储的资源标识有好几种拼写方式,带不带账号 ID、桶级还是对象级,服务端实际用哪种评估并不确定。配完之后策略模拟器说“允许,匹配 N 个策略”,真实请求却返回 `Access Denied.`,而且不带动作名,看不出原因。最后的处置是把 8 种组合全部列进资源字段,全部锁同一个桶,范围没有扩大,确认生效之后再逐个删。
还有一条验证纪律:收窄权限之后要逐个打开所有设置页的标签页,不能只测上传主链路。附属功能依赖不同的云服务,漏测会让人以为“刚才那步把系统改坏了”。顺带一提,这个插件的错误处理会吞异常,界面不提示,错误只进服务端日志,排查上传失败的正确入口是日志。
## 一个通配符把图床全站拦掉了
这是最贵的一次。
现象:图床域名上的所有请求全部被拦。博客正文里引用的、没有 Referer 的(图片代理服务端代取)、裸域名、完整 URL,六种变体无一幸免。主题说明页里 17 处图片引用、公开仓库 README 里的截图、主题安装包的下载链接,全断。
定位第一步不是看代码,是认“是谁拦的”。这一层前后站了好几道防线,每道都有自己的签名。
WAF 的攻击拦截返回 4xx,响应体里带它自己静态资源的路径特征;人机验证和自定义规则是同一段里的另外两个编号;边缘平台的自定义规则拦截用的是 5xx 段的一个自有编号(我这边实测是 567),响应头里带平台标识和一个日志 UUID。
```mermaid
flowchart LR
A[页面异常] --> B{状态码落在哪一段}
B -->|4xx + 特征响应体| C[站点侧防护层]
B -->|5xx 自有编号 + 平台响应头| D[边缘平台自定义规则]
B -->|503 透传| E[源站过载或故障]
C --> F[查该层规则与日志]
D --> F
E --> G[查源站负载与慢请求]
```
先用编号判断是哪一层拦的,再去看那一层的规则,比在几套日志里乱翻快得多。这次是边缘平台的自定义规则,根因很蠢:运算符那一栏选的是“Referer 通配符不匹配”,字段里填的却是正则表达式。通配符引擎的语义里,`*` 是任意字符、`?` 是单字符,其余字符按字面匹配,于是正则里的 `^`、`(`、`[`、`\.` 这些字符永远不可能出现在真实 Referer 中,条件永不成立,所有请求都落进“不匹配则拦截”的分支。
三条纪律我全犯了。
字段的模式,通配符还是正则,必须和填写的表达式语法一致,粘贴之前先看运算符那一栏。自定义规则变更一律先开观察模式,从日志确认匹配行为之后再切拦截。白名单型防盗链必须允许空 Referer,否则图片代理、RSS 阅读器、聊天预览、下载工具全部误伤,而空 Referer 又可以被 `referrerpolicy=no-referrer` 绕过,所以 Referer 防盗链的实际防护力有限,大流量场景该靠限速。
最后这条规则被删掉了。那个域名现在靠边缘侧的自适应限速和流量层防护,都不依赖 Referer,也没有误伤。
另一个小坑:提取页面里的 URL 做批量测试时,HTML 的行尾符会把多余的字符带进 URL,curl 返回 000,看起来像站点全挂。请求前先清一遍。
## 说明页和隐私政策也是攻击面
主题要公开发布,随之而来的是一批“由我本人主动撰写、而且必须长期公开”的文档:主题说明页、隐私政策、公开仓库的 README。这类材料在攻击者眼里很好用,因为它是你自愿写清楚的。
我给自己定的判定标准是一句话:一条信息如果能让陌生人缩短“判断技术选型、匹配已知漏洞、定向试探”这条路,就不该出现在对外文档里;反过来,用户做“要不要用这个站”这个决定所需要的知情信息,必须写。
落到做法上是三类分开处置。安全防护类只按类别写,绝不写产品名。基础设施类也按类别写,主机、CDN、对象存储、缓存和数据库这些东西,写了只有细节没有收益。**接触用户提交内容的第三方必须点名**,用户的评论和邮箱流向哪家,他有权利知道。
还有一个容易忽略的泄露面是版本记录。写“停用了某某插件”“改用某某统计”,等于把组件变更史公开了,和正文是同一级别的信息。
这次踩的坑是“停用”两个字。WordPress 插件列表里那个“停用”是操作链接,不是状态标签。显示“停用”意味着该插件**正在启用**。我按字面读,把两个启用中的插件当成了已停用的,结果是隐私政策漏披露了一条真实的数据流出:评论正文和用户名会传给第三方内容审核服务。连带影响是,评论过滤类插件通常还提供拦截日志,启用它就意味着新增一类留存数据,未通过的评论正文、提交 IP 和 UA、命中原因都算,隐私政策的“收集”和“保留期限”两节都要跟着改。核状态要认插件名下方的状态标签或者列表页的筛选计数。
发布前我会跑一个关键词自查脚本,词表就是上面那三条规则。用的时候有一个提示:命中不等于有错,比如“安全组件”会命中“安全组”这一条,得逐条人工判断;而且它只做关键词,不做语义判断,写得太细但没命中敏感词的情况依然存在。
## 哪些事我没做,哪些结论站不住
先说没做的一件事。盘点防护链的时候我发现,所有动作都做在边界层:CDN、WAF、防火墙、封禁。边界之内,主机侧我只保留了触发式应急这条路,没有增加常驻组件。我调研了一个云厂商提供的主机侧排查工具,结论是不装。它需要常驻一个客户端,而我的原则是尽量不增加常驻组件;更要紧的是它的“隔离”动作对 WordPress 站点太危险,插件和主题里的混淆代码本来就容易误报,点一下隔离可能就是站点故障。它的定位是触发式应急工具,真出事再装,来得及。
再说测试方法上的一处坦白。PageSpeed Insights 的单次数字不能信。同一个配置、同一个页面,间隔四分钟跑两次,一次 64 分一次 94 分,差了 30 分。此后所有第三方数据一律三次取中位数,单次数字不驱动任何决策。
这一轮没证明什么,也值得写清楚。测速基线依赖采集时段和网络,表头必须记采集条件,我把正负 30% 以内视为正常,不做过度归因。脚本只覆盖 HTTP 这一侧,机器自身的资源监控不在这一轮的范围里。缓存和权限的验证都是“我在本地和服务端看到的结果”,不等于陌生访客在每个边缘节点上的体验。至于“重媒体操作前临时加白名单”,它是一次性的手工动作,忘了就是误伤,算不上真正的解法。
这一轮真正改变的不是某个阈值,是三件事。
每次变更前先拍快照,快照 ID 记进账本。回滚是时间机器,它会把没记下来的东西一起抹掉。
所有定时任务都要有汇总行。区分“没跑”和“跑了没问题”,比任何指标都重要。
出现异常时,先问“这是谁拦的、谁在漏”,再问“是不是我写错了”。这两周里所有真正难缠的问题,答案都是前者。
## 收尾
主题现在是 0.10.13。这一版的主要变化是新增了“外观 → llms.txt 设置”页:`/llms.txt` 和 `/llms-full.txt` 两个端点可以独立开关,内容来源支持全自动、半手工和全手工三种,全量导出的篇数、全文还是摘要也能配。有一个行为变化要专门提醒:`/llms-full.txt` 这一版默认是关的,升级之后需要去设置页手动打开;`/llms.txt` 默认仍然开着,并且不再推荐那个已经关闭的地址了。
主题源码和安装包都在 GitHub:[PaddySun/paddy-newsprint](https://github.com/PaddySun/paddy-newsprint),Release 见 [v0.10.13](https://github.com/PaddySun/paddy-newsprint/releases/tag/v0.10.13),镜像下载:[https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.13.zip](https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.13.zip)。
上一篇我说“还有一大块免费的速度没有领”,现在领了。下一篇想写这套越堆越厚的防护链本身,它已经复杂到需要一张自己的地图,而复杂本身就是新的风险。
====
# 自”妍” WordPress 主题性能实测
https://www.paddysun.top/archives/5271 · 2026-09-13
> **系列**:paddy-newsprint 主题开发记 · 续篇
> **前置阅读**:[做了一个报纸风格的 WordPress Markdown 主题](https://www.paddysun.top/archives/5254) · [主题说明页](https://www.paddysun.top/paddy-newsprint)
> **主题分类**:实践复盘
> **阅读时间**:约 8 分钟
# 换装之后:75 到 93的生产环境成绩单
9 月 13 日晚上,我把运行了一年多的旧主题下线,换上了自己写的 paddysun-newsprint。切换前我给旧主题拍了一组基线,切换、清缓存、改完页脚之后,用同样的工具、同样的页面、同样的网络再测了一遍。
先看结果:
PageSpeed Insights(移动端)换装前(yuki)换装后(newsprint 0.10.11)**性能总分****75****93**First Contentful Paint3.0 秒1.8 秒Largest Contentful Paint3.9 秒2.8 秒速度指数 Speed Index8.0 秒4.0 秒总阻塞时间 TBT0 毫秒0 毫秒累计布局偏移 CLS00.002
同一台 2 核 4G 的小服务器,同一条 CDN 链路,同一个域名。差的是那套主题。
上一篇文章说过,这个主题在开发时立了三条军规:**零外部请求、按需加载、缓存友好**。当时它们更像审美洁癖——博客圈流行的话术谁都会说,可这些原则到底值几分,没有人真的去量过。这一篇就是量过的结果。
## 体积去哪了:零外部请求的账本
先用 curl 在生产环境逐页计时(宁波电信宽带直测,每页三轮取中位数):
curl 实测(CDN 视角)换装前换装后首页 TTFB 中位数0.090 秒0.073 秒首页传输体积118.0 KB**87.5 KB(-26%)**单篇 TTFB 中位数0.721 秒**0.317 秒**单篇传输体积116.8 KB101.4 KB
首页瘦了四分之一。这个主题没有 Google Fonts、没有统计脚本的第三方请求、没有图标库——四枚正文字体(含一枚花体装饰字)全部自托管,头像用本地 SVG。浏览器打开首页时,除了博客自己,不需要信任任何第三方域名。
诚实地说,”零外部请求”目前还差一口气:友情徽章里有两枚 88×31 的小图仍指向外站(indieweb.org 和一位友链的徽章)。这两枚已经在待办清单上,方案是下载进主题的 assets 目录改本地引用。账本要记完整——2 枚外链图,不美化成”基本为零”。
## TBT 那个 0,是设计出来的
PSI 里最扎眼的一个数字是**总阻塞时间 0 毫秒**——换装前后都是 0。这在 WordPress 主题里不常见:典型的多用途主题会加载一整个前端框架、滑块、动画库,主线程被切成碎片,TBT 轻松上百毫秒。
这个主题的写法是:首页一个 JS 文件都不加载。代码高亮、KaTeX 公式、Mermaid 图表、目录悬浮、复制按钮、评论折叠——全部按需加载,PHP 端先检查正文里有没有对应内容,有才在页脚挂上对应的 defer 脚本。首页没有代码块也没有公式,所以一个字节的任务都不用排。这个 0 不是运气,是”正文里没有就不加载”的直接结果。
CLS 从 0 变成了 0.002,属于噪声级别的波动(Lighthouse 对同一页面的两次测量也会在这个量级抖动),不构成叙事。
## 字体为什么敢 preload
FCP 从 3.0 秒提前到 1.8 秒,LCP 从 3.9 秒缩到 2.8 秒——这 1 秒多的差距,主要不在 HTML 本身(首页 HTML 换装前后都吃 CDN 边缘缓存),而在资源层的加载顺序。
正文的 Source Serif 4 两枚字重走 `wp_head` 最优先级 preload,浏览器在解析 CSS 的同时就开始下载字体,正文文字不会先以回退字体闪现再切换。旧主题的做法是等 CSS 解析完再发现字体引用,多一个串行往返。报纸风的衬线正文恰恰是 LCP 元素——字体快,LCP 就快。
版本号这件事也顺带验证了:主题 CSS/JS 用文件的修改时间戳做版本参数,这次更新主题文件后,CDN 和浏览器自动拿到新 URL、强制回源,不需要手动清任何缓存。上线当晚改页脚、推 0.10.11 版本,全程零缓存事故。
## 单篇页:快了 0.4 秒,但不是缓存的功劳
单篇页 TTFB 从 0.721 秒降到 0.317 秒,容易误读成”缓存生效了”。不是。目前 CDN 只缓存首页 HTML,单篇页每次都真实回源打到 PHP。这 0.4 秒几乎全是**服务端渲染变轻了**:块主题的模板直接输出区块标记,没有旧主题层层套模板的 PHP 开销。
这意味着还有一大块免费的速度没有领:单篇页零动态内容(没有随机文章、没有浏览计数),完全具备整页缓存的条件。下一步把它也放进 600 秒的边缘缓存,单篇 TTFB 会从 0.317 秒直接掉进 0.1 秒以内。这是目前清单上性价比最高的一项。
## 测试方法的两处坦白
第一,这次留档的 PSI”桌面端”快照和移动端内容相同(保存时拿到了同一份移动端报告),所以本文只用移动端口径——它本来就是更严苛的那个。桌面端留档下次补。
第二,PSI 是实验室数据(模拟 Moto G 电源 + 慢速网络),curl 是宁波单点,都不是真实用户的分布。它们能证明”变快了”和”快在哪”,不能证明”每个访客都快了多少”。多地拨测的原始文件已存档,真实用户侧的长期数据(RUM)要靠后续积累。
## 成绩单之外
性能只是一部分。这套主题的缓存友好设计(无动态内容、无 cookie 差异输出、按需加载)让全站 HTML 都具备上边缘缓存的资格——对一个跑在 4GB 小机器上的个人博客来说,”绝大多数请求不消耗 PHP”同时也是抗流量洪水的能力,这个话题值得单独一篇。
主题的代码、文档和发布记录都在 GitHub:[PaddySun/paddy-newsprint](https://github.com/PaddySun/paddy-newsprint),安装包在 [Release v0.10.11](https://github.com/PaddySun/paddy-newsprint/releases/tag/v0.10.11) 或镜像下载:[https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.11.zip](https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.11.zip)。
下一篇大概率是图床迁移——662 个文件搬去对象存储之后,这套”零外部请求”的账本要重新记账,到时候再来汇报。
====
# 做了一个报纸风格的 WordPress Markdown 主题
https://www.paddysun.top/archives/5254 · 2026-09-13
> 喜欢 Typora 的阅读效果,也想让「本地 Markdown → WordPress → 知乎」这条写作流程少一点折腾。
最近,我给自己的博客换上了一个新主题:**Paddy Newsprint**。
它并不是从一个宏大的产品计划开始的。最初的出发点很简单:我喜欢 Typora 打开 Markdown 后的阅读节奏,也习惯在本地写文章。但文章写完之后,还要在不同平台之间来回复制、调整格式,公式和 Mermaid 图表尤其容易把流程打断。于是我想,不如做一个更贴合自己写作习惯的 WordPress 主题。
## 我的日常写作流程
平时写博客,大致是这样一条链路:
1. 在本地用 Typora 写 Markdown;
2. 将文章复制到 WordPress 站点;
3. 再把内容复制到知乎;
4. 维护公式、代码块、表格和 Mermaid 图表等格式;
5. 发布之后,再检查各个平台的显示效果。
这套流程本身并不复杂,但它有几个很具体的麻烦。
首先,WordPress 主题和插件对 LaTeX 公式的支持经常需要额外配置。有的方案依赖短代码,有的方案要求改写公式,有的方案在编辑器、前台和 RSS 中表现不一致。其次,Mermaid 在很多网站上不能直接按照 Markdown 代码块渲染,往往需要先转成图片,再上传到文章里。最后,文章一旦离开本地 Markdown 文件,原文就不容易被完整保留下来。
我希望主题能尽可能接近这样的使用方式:**本地按照自己熟悉的 Markdown 习惯写,粘贴到 WordPress 后仍然能正常阅读,并且随时可以拿回 Markdown 原文。**
## 为什么是「报纸风格」
功能问题解决之后,剩下的是视觉问题。
我一直很喜欢报纸版面那种高密度的信息组织方式:明确的栏线、紧凑的留白、强烈的标题层级,以及在有限空间里同时容纳多条信息的能力。它不像一些极简主题那样追求把页面变得空无一物,而是允许内容之间产生有秩序的拥挤感。
所以 Paddy Newsprint 最后变成了一个报纸风格的块主题:
- 首页采用报头、栏目、主稿和侧栏组成的报纸版面;
- 文章页保留接近 Typora Newsprint 的阅读节奏;
- 颜色、字体、字号和间距通过 `theme.json` 统一管理;
- 尽量使用 WordPress 原生区块,让页面可以继续在站点编辑器里修改;
- 中文内容强调稳定的阅读宽度,英文内容则使用更接近报刊排版的字体方案。
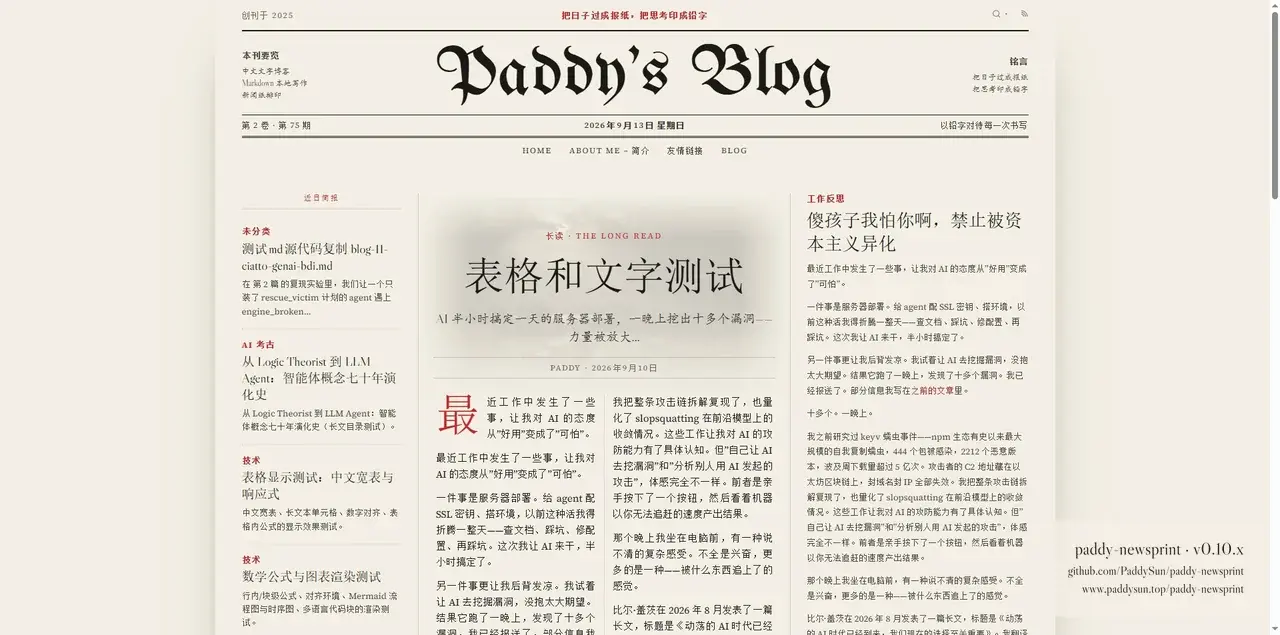
我希望它看起来像一份可以长期阅读的数字报纸,而不是一张只负责展示链接的首页。
## 公式、Mermaid 和 Markdown 原文
这个主题最核心的改进,还是围绕 Markdown 内容本身。
### LaTeX 公式
文章中的行内公式和独立公式可以直接保留 Markdown 写法。主题会在检测到公式内容时,按需加载 KaTeX,避免首页在没有公式时额外加载相关资源。
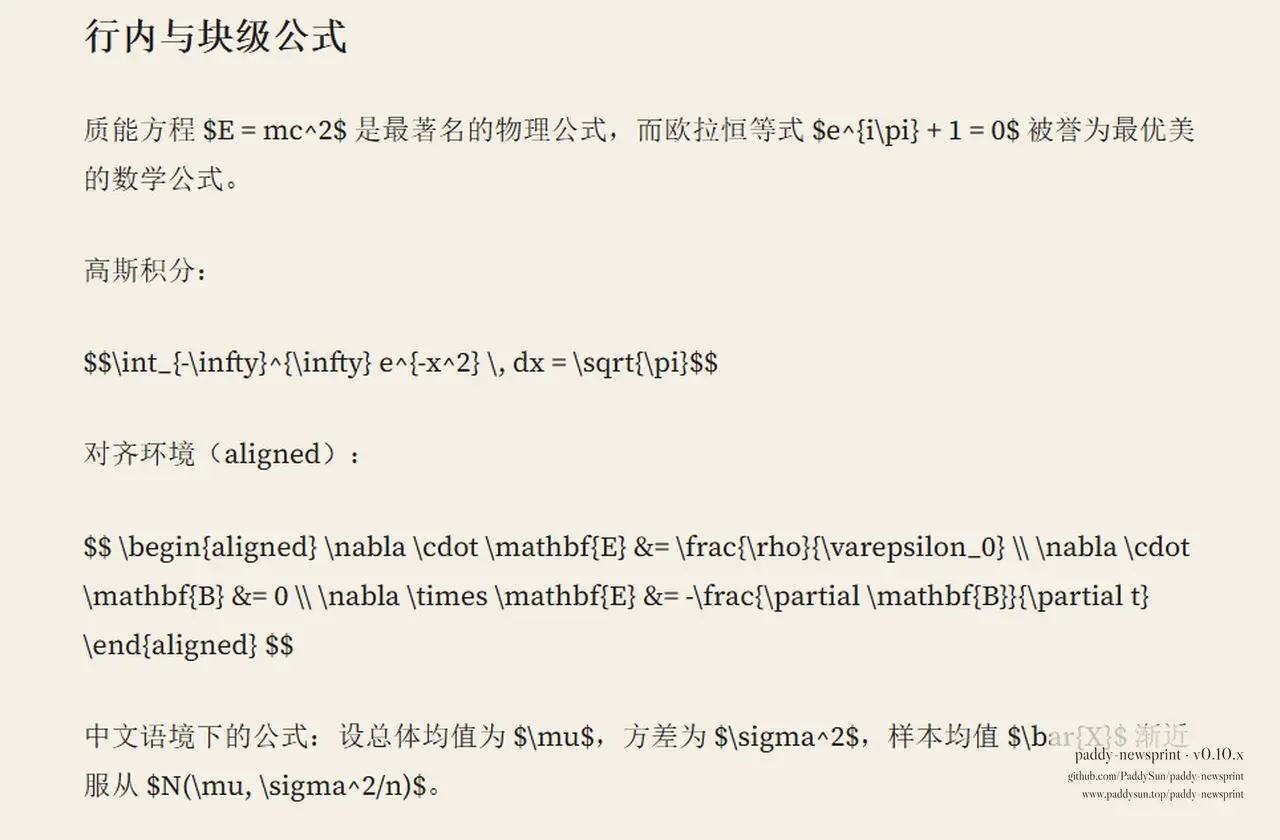
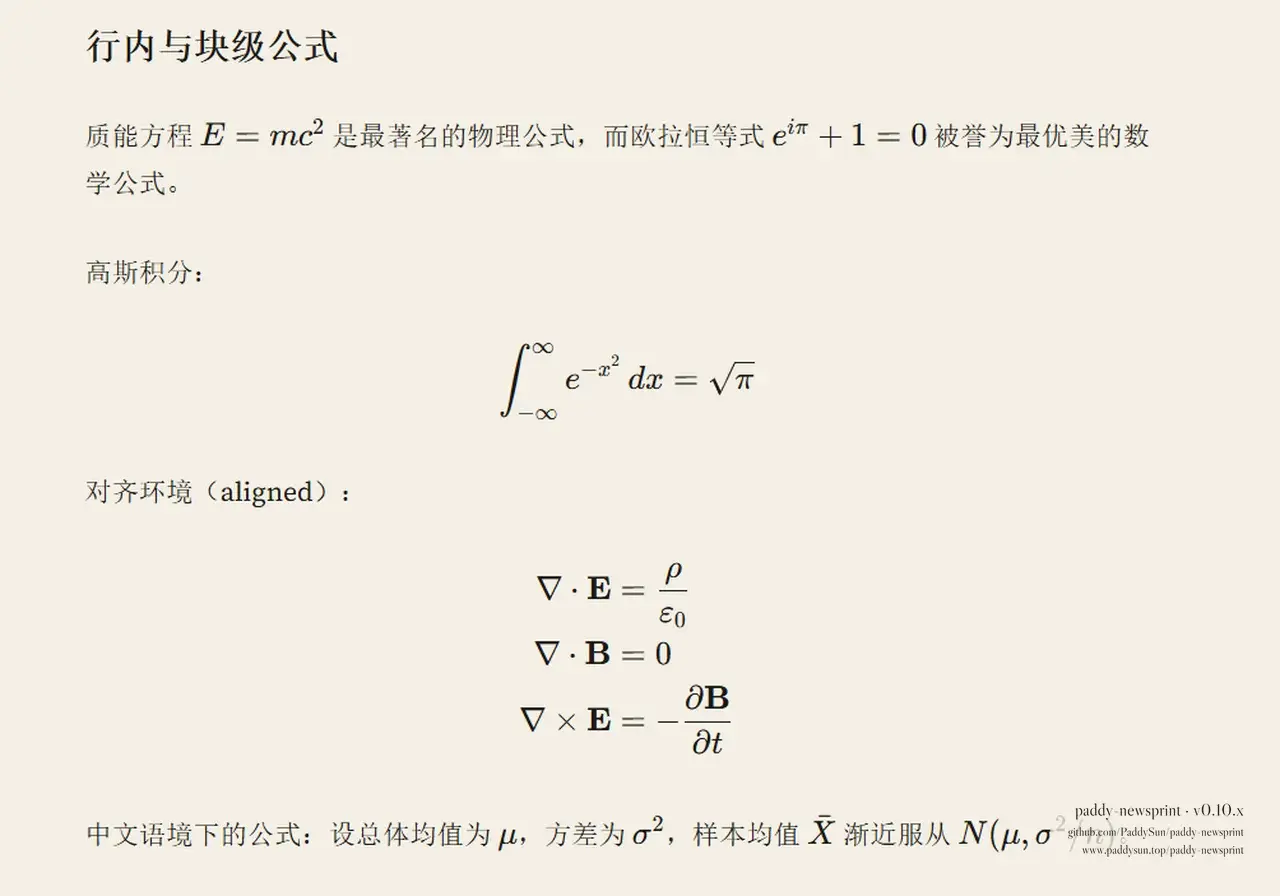
### Mermaid 图表
Mermaid 代码块也可以保留在文章内容中。编辑器里看到的是 Mermaid 源码,前台则渲染成图表;如果某个环境无法正常渲染,文章仍然保留源代码,不至于只剩下一张无法修改的图片。
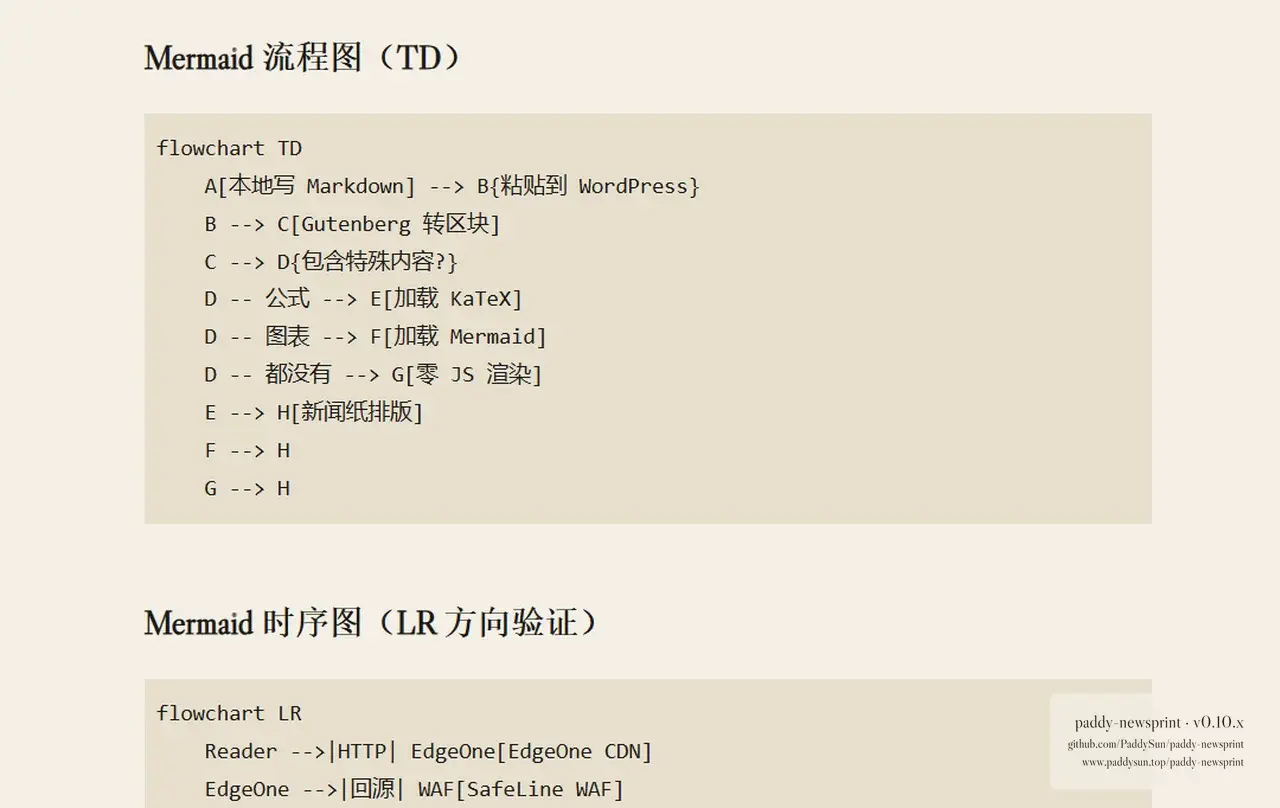
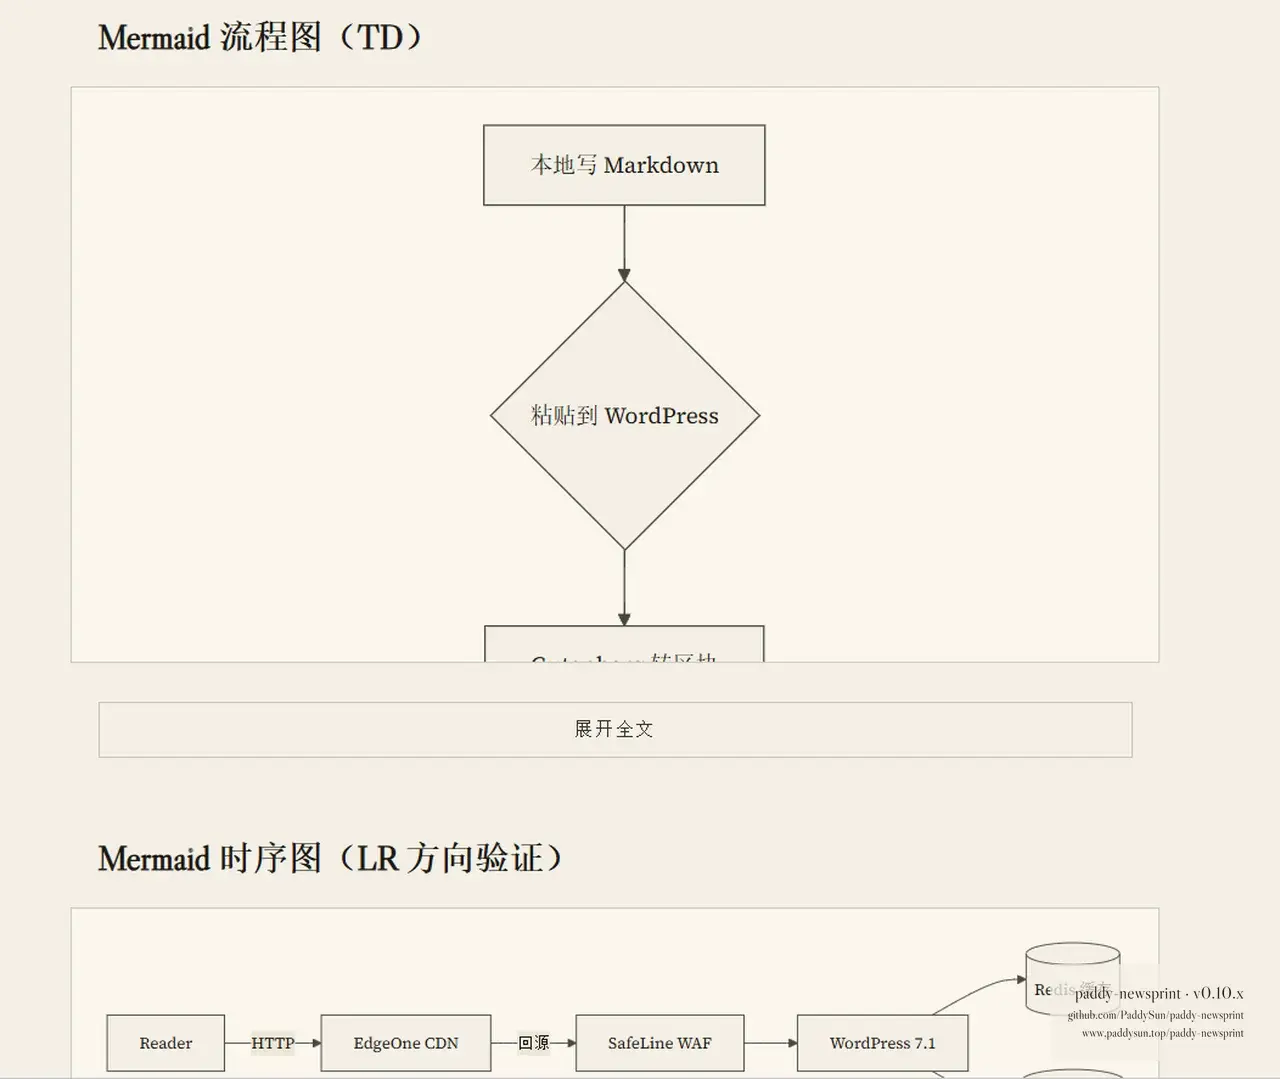
这并不意味着所有平台都能直接识别 Mermaid。发布到知乎等平台时,仍然可能需要把图表转成图片上传。但至少在自己的站点里,Markdown 源码和最终展示可以同时保留,后续修改会轻松很多。
### 保留 Markdown 原文
主题提供了「原文 Markdown」存档入口。发布文章时,可以把本地原文一并保存;文章页面提供复制 Markdown 的按钮,REST 接口也可以返回 Markdown 原文。
如果没有保存原文,主题也会尝试从文章 HTML 反推出 Markdown。不过,反向转换不可能百分之百恢复所有手工排版,因此如果文章需要在多个平台重复发布,建议同时保存原始 Markdown。
## 我还顺手处理了哪些细节
做主题的过程中,一些原本以为很小的问题也逐渐积累成了功能:
- 代码块语法高亮与一键复制;
- 文章目录和章节定位;
- 表格根据内容自动调整列宽,移动端可展开宽表;
- 文章引用、脚注和交叉链接;
- 引用块、文章卡片和评论区的报纸化样式;
- 图片加载失败时的占位插画;
- 公式、Mermaid 和代码高亮按需加载;
- 移动端重新安排长文与栏目顺序;
- 评论头像使用本地 SVG,不请求 Gravatar;
- 对减少动效和高对比度显示做了基础适配。
这些功能并不是为了把主题做得「什么都有」,而是因为它们确实出现在我的日常文章里。对我来说,一个主题最重要的标准不是功能列表有多长,而是写一篇真实的文章时,会不会频繁被格式问题打断。
## 测试说明
Paddy Newsprint 目前主要按照「本地 Markdown 写作并发布到 WordPress」的流程进行测试。每次发布前后,我会重点检查以下内容。
### 页面与响应式测试
- 首页、文章页、页面、分类页、搜索页和 404 页面是否能正常打开;
- 桌面端三栏报纸布局是否保持稳定;
- 平板和手机端是否能自动切换为适合长文阅读的单栏结构;
- 导航、检索弹层、目录和评论区是否可以正常操作;
- 打印样式和减少动效设置是否生效。
### 内容渲染测试
- 标题层级、目录和章节锚点;
- 行内公式与独立 LaTeX 公式;
- Mermaid 源码与前台图表;
- 代码块、语言标记和复制按钮;
- 表格、宽表和移动端展开行为;
- 图片、失效图片占位和图片说明;
- 引用、脚注、交叉引用和链接;
- 中文 Markdown 原文复制与 REST 输出。
### 主题工程测试
项目中也保留了若干自动检查脚本,用于进行 PHP 语法、JavaScript 语法、首页标记、区块模板和页面结构的快速验证。例如:
```
# 主题冒烟测试
bash paddysun-tool/wp-theme-smoke.sh \
./wp-src/wp-content/themes/paddysun-newsprint \
paddysun.localhost \
np-site-header np-lead np-brief np-cards
# 九类页面快速检查
bash paddysun-tool/wp-pages-check.sh
# 区块模板有效性检查
php ../paddysun-tool/validate-block-templates.php
```
另外,Markdown 接口可以通过下面的地址检查:
```
https://www.paddysun.top/wp-json/paddysun/v1/posts/<文章 ID>/markdown
```
需要说明的是,当前版本仍然处于持续实机测试阶段。不同 WordPress 版本、编辑器配置、缓存插件和主机环境,可能会带来不一样的表现。因此,这些测试更多是为了保证主题自身的主要路径稳定,而不是宣称它已经覆盖所有第三方环境。
## 主题地址与下载安装
主题说明页:[https://www.paddysun.top/paddy-newsprint](https://www.paddysun.top/paddy-newsprint)
GitHub 仓库:[https://github.com/PaddySun/paddy-newsprint](https://github.com/PaddySun/paddy-newsprint)
下载安装包(相关资源正在实机测试):[https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.11.zip](https://cos.paddysun.top/paddy-newsprint/rel/paddy-newsprint-0.10.11.zip)
GitHub Release:[https://github.com/PaddySun/paddy-newsprint/releases/tag/v0.10.11](https://github.com/PaddySun/paddy-newsprint/releases/tag/v0.10.11)
## 欢迎反馈和一起开发
本站已经换装 Paddy Newsprint。如果你在使用过程中遇到任何问题,欢迎在任意评论区留言,也可以通过 `paddysun@foxmail.com` 联系我,或者直接在 GitHub 上提交 Issue。
如果你对 WordPress 区块主题、Markdown 发布流程、LaTeX、Mermaid 或报纸风格的网页排版感兴趣,也欢迎参与一起开发。这个主题本来就是从个人使用需求出发的,后续仍然会根据真实写作和真实反馈继续调整。
希望它能让更多人少花一点时间处理格式,多花一点时间写文章。
====
# 88×31
https://www.paddysun.top/archives/5245 · 2026-09-11
.badge-article { line-height: 1.8; }
.badge-article figure {
margin: 24px 0;
text-align: center;
}
.badge-article figure img {
image-rendering: pixelated;
display: block;
margin: 0 auto;
}
.badge-article figcaption {
font-size: 0.85rem;
color: #8a8178;
margin-top: 8px;
line-height: 1.6;
}
.badge-inline {
image-rendering: pixelated;
width: 88px;
height: 31px;
vertical-align: -8px;
margin: 0 6px;
border: 1px solid #e4ded5;
border-radius: 2px;
}
.badge-gallery {
display: grid;
grid-template-columns: repeat(auto-fill, minmax(260px, 1fr));
gap: 18px;
margin: 28px 0;
}
.badge-item {
border: 1px solid #e4ded5;
border-radius: 8px;
padding: 16px 12px 12px;
text-align: center;
background: #faf8f4;
}
.badge-item img {
display: block;
margin: 0 auto;
width: 176px;
height: 62px; /* 2 倍放大展示,交付为 88x31 原尺寸 */
image-rendering: pixelated;
border: 1px solid #d8d1c6;
border-radius: 3px;
}
.badge-item .b-name {
font-weight: 600;
margin-top: 10px;
}
.badge-item .b-src {
font-size: 0.78rem;
color: #8a8178;
margin-top: 4px;
line-height: 1.6;
}
.badge-article blockquote {
border-left: 3px solid #d8d1c6;
margin: 20px 0;
padding: 4px 18px;
color: #6d655c;
}
88×31:一枚两千七百二十八像素的复古徽章
前阵子逛街,在 [geedea.pro 的 linkroll](https://www.geedea.pro/linkroll/) 页脚看见一排小得不起眼的图片按钮——这样,88 像素宽、31 像素高,往网页上一挂,就是一枚站长的”名片”。好奇之下顺着挖了挖,发现这小东西背后有一整段网页史。

[IndieWeb](https://indieweb.org/) 的 88×31 徽章——这枚尺寸早已成为独立网站的”会员徽章”
从广告位到身份徽章
88×31 诞生于九十年代的商业网页:它是当年互联网广告的标准尺寸之一,和 468×60 横幅一起,被塞满各大小网页的页脚与边栏。后来广告进化了,这种”微型按钮”逐渐退场——却在个人网站、网页戒指(webring)、”Best viewed in…” 贴纸文化里活了下来。
真正让它复活的是 [IndieWeb 社区](https://indieweb.org/88x31)。在他们的语境里,88×31 不再是广告位,而是站长的身份徽章:挂在首页上,朋友之间互相交换,像交换名片或徽章一样,把彼此挂在自己的角落。这个尺寸有一种奇特的约束之美——总共 2,728 个像素,比一枚邮票还小,每一像素都要花在刀刃上。IndieWeb 的维基把它比作”写诗”:像素预算越紧,设计越要克制而精准。
2728 个像素,说多不多,说少不少——刚好够装下一个站名、一段动效,和一点”我还在手写网页”的态度。
当 88×31 遇见代码艺术
我平时收藏了不少生成艺术的效果——Shadertoy 上的云海、OpenProcessing 上的火焰粒子与噪声河流。看到 88×31 的第一反应是:这不就是给生成艺术量身定做的画布吗?2728 个像素的计算量微乎其微,再复杂的噪声场也跑得动;而 GIF 动图恰好能把”活的效果”装进一枚静态规格的徽章里。
于是我把收藏里的算法一个个搬到 Python + Pillow 上,逐像素渲染成 88×31 的动画 GIF。全部源码都在公开仓库里:[PaddySun/paddy-88×31-button](https://github.com/PaddySun/paddy-88x31-button),固定随机种子,任何人都可以复现、改参、做出自己的版本。

云海 · 日出
多层视差云带 + 波浪顶沿离散色阶。深度移植自 Shadertoy 作者 [mdb 的「up in the cloud sea」](https://www.shadertoy.com/view/Ndc3zl)(CC BY-NC-SA),由 GLSL 译为 Python。

火焰粒子
发光矩形粒子上升、高度渐变色相、加色合成。深度移植自 [Kazoops 的火焰粒子(Flame 的 fork)](https://openprocessing.org/@Kazoops/2727322)(CC BY-NC-SA),WEBGL 投影改为 2D 四边形。

流场粒子
日出渐变 + 流场粒子,本系列的第一枚。无特定原作的通用技法,独立实现。

粒子轨迹
噪声流场轨迹线 + 霓虹配色。算法移植自 [OpenProcessing「Particle Plotter」](https://openprocessing.org/@u65884/751983)(灵感源自 Felix Auer 的微分方程相图)。

赛博朋克 · 坏信号
CRT 电视坏信号:扫描线、雪花、RGB 色散、故障条。demoscene 通用技法,独立实现。

BlogsClub
为 [BlogsClub](https://www.blogsclub.org/) 制作的社区徽章:品牌蓝 Perlin 流场粒子。背景技法借鉴 [Samuel YAN 的「Sands 002」](https://openprocessing.org/@samuelyan/1353598)(CC BY-NC-SA)。
以上徽章均按 2 倍放大展示,实际交付为 88×31 原尺寸;各徽章的算法来源、原作协议与借鉴程度的完整记录见仓库内 [REFERENCES.md](https://github.com/PaddySun/paddy-88x31-button/blob/main/REFERENCES.md)。
欢迎交换
88×31 最有趣的地方从来不是徽章本身,而是”交换”——它把友情链接从一行文字变成一枚可以别在页脚的实体徽章。如果你也有自己的 88×31,或者想动手做一枚,欢迎来 [我的友情链接页](https://www.paddysun.top/links/) 交换:那里挂着本站全部徽章的取用代码,复制粘贴即可。
下一枚做什么还没想好——收藏夹里还躺着噪声河流和域扭曲。不过 2728 个像素的世界,慢慢逛就够了。
====
# 傻孩子我怕你啊,禁止被资本主义异化
https://www.paddysun.top/archives/5214 · 2026-09-03
## 半天搞定一天的活,一晚上挖出十个漏洞
最近工作中发生了一些事,让我对 AI 的态度从”好用”变成了”可怕”。
一件事是服务器部署。给 agent 配 SSL 密钥、搭环境,以前这种活我得折腾一整天——查文档、踩坑、修配置、再踩坑。这次我让 AI 来干,半小时搞定了。
另一件事更让我后背发凉。我试着让 AI 去挖掘漏洞,没抱太大期望。结果它跑了一晚上,发现了十多个漏洞。我已经报送了。部分信息我写在[之前的文章](https://www.paddysun.top/archives/5188)里。
十多个。一晚上。
我之前研究过 keyv 蠕虫事件——npm 生态有史以来最大规模的自我复制蠕虫,444 个包被感染,2212 个恶意版本,波及周下载量超过 5 亿次。攻击者的 C2 地址藏在以太坊区块链上,封域名封 IP 全部失效。我把整条攻击链拆解复现了,也量化了 slopsquatting 在前沿模型上的收敛情况。这些工作让我对 AI 的攻防能力有了具体认知。但”自己让 AI 去挖漏洞”和”分析别人用 AI 发起的攻击”,体感完全不一样。前者是亲手按下了一个按钮,然后看着机器以你无法追赶的速度产出结果。
那个晚上我坐在电脑前,有一种说不清的复杂感受。不全是兴奋,更多的是一种——被什么东西追上了的感觉。
## 盖茨那句话,我现在才读懂
比尔·盖茨在 2026 年 8 月发表了一篇长文,标题是《动荡的 AI 时代已经到来,我们现在的选择至关重要》。我翻译过[原文](https://www.paddysun.top/archives/5092),当时读到其中一句,只是觉得说得对:
> **技能非常有限的罪犯也能对各种规模的受害者发起攻击。**
当时我是作为一个翻译者在读这句话。现在我让 AI 挖了一晚上漏洞之后,再回头读这句话,感受完全不同了。
盖茨说的不是未来时,是现在时。他说的”技能非常有限的罪犯”,甚至不需要自己懂漏洞挖掘——他只需要会跟 AI 说”帮我找找这个系统的漏洞”。一晚上,十多个。报送的时候我甚至有点恍惚:这些漏洞是我发现的,还是 AI 发现的?如果报送给了厂商,厂商修复了,那我是安全研究者还是只是一个按了按钮的人?
盖茨在文章里还说了另一句话:
> 同一个能找出软件漏洞供公司修复的 AI 模型,也能帮助罪犯利用该漏洞。发动攻击所需的资源正在显著降低。
我做的事和攻击者做的事之间,唯一的区别是意图。技术门槛已经被 AI 抹平了。剩下的那道防线——”人有善恶之分”——说实话,这道防线从来没有真正坚固过。
## 人的价值不在技能细节,在品味
这些事让我重新想起自己之前写的一篇文章——[《嚼别人嚼过的口香糖,AI 时代人的价值》](https://www.paddysun.top/archives/5098)。
在那篇文章里我讲了一个”嚼口香糖”的比喻:AI 嚼了一遍,人再嚼一遍,然后再喂给下一个人。我在公司里看到同事用 AI 生成报告直接交差,看到有人一句话让 AI 搓出原型,看到自己挖空心思的调研分析被藏在了四十多页文档的某个角落没人看。
当时的结论是:人要发展的不是技能细节,而是**品味**——对工作质量的要求,对方向的判断力。AI 不会选方向,它只会在人选定的方向上跑得更快。选方向的能力,才是真正稀缺的。同时也要提高利用 AI 这个工具的效率。
所以最近我在做一件事:考古式地研究 AI 发展历史。从 McCarthy 时代的 Logic Theorist,到 BDI 意图架构,再到今天的 LLM Agent。我想搞清楚”智能体”这个概念是怎么一步步演化过来的——不是为了学技术细节,而是为了建立判断力。知道来路,才知道去哪里。
但提高 Agent 工作效率,光有品味和历史视野还不够。还有一个很现实的坑。
## 孩子(AI)还是比较傻的
这几天的工作里,我的多个 agent 在多项任务中都面对了同样的问题:翻了同样的错,重写了同样的工具。
第一个 agent 花了半小时写了一个 SSH 连接器,踩了 MSYS 环境的坑,调试了半天才搞定。第二个 agent 遇到同样的需求,又从头写了一遍,又踩了同样的坑。第三个 agent 做 Playwright 打包,犯了一个配置错误,我花了时间纠正。第四个 agent 遇到一样的需求,又犯了一遍。
你不能说它们不聪明。单个拿出来看,每个都表现不错。但它们之间不共享记忆,不共享教训。每次都是一张白纸重新开始。
这让我想起一句话:**不要二过**。犯一次错是学习,犯同样的错是浪费。我的 agent 们在反复犯同样的错,而浪费的是我的时间和 token。
所以我决定把之前项目里积累的 agent 经验和工具都整理出来,做成一个工具库。云上推到 GitHub:[paddy-agent-cookbook](https://github.com/PaddySun/paddy-agent-cookbook)。目的是让我的 agent 们不再重复造轮子——SSH 连接怎么配、fail2ban 怎么部署、Playwright 打包要注意什么、MSYS 环境有什么坑——这些都写成 skill 和 tool,下次 agent 启动就能用。
但就是这个仓库,给我带来了一个完全意想不到的困扰。
## MIT 协议:我第一个后悔的选择
一开始创建这个仓库的时候,我选了 MIT 协议。这是最省事的选择——GitHub 新建仓库时默认推荐的,宽松、简单、人人都懂。
但推上去之后,我开始焦虑了。
我的焦虑有三层:
第一层:这些经验和工具是我花时间踩坑攒下来的。如果开源成 MIT,大厂可以直接拿去,集成为 WorkBuddy 中的 skill tool,然后我就没有啦。我贡献了劳动,成果被资本吸收,变成了别人产品的一部分。
第二层:同事或者公司拿到这些沉淀之后,我的”不可替代性”在哪里?公司有了这些工具库,配一个更便宜的应届生来用,是不是就不需要我了?
第三层:如果被训练进模型里,那我的经验就直接变成了模型的参数。以后任何人问 AI 这个问题,AI 都能回答——我的经验彻底不再属于我。
MIT 协议对这三层焦虑,一条都拦不住。MIT 明确授予任何人”使用、复制、修改、合并、发布、再许可、出售”的权利,没有限制。我等于亲手签了一张白条。
于是我开始改协议。
## 和 AI 聊这件事的时候,我不想要什么逐渐清晰
改协议这件事,我是和 AI 一起做的。过程中的对话很长,这里只说关键的几步。
一开始,我只有一个模糊的想法:
> **最初的版本(口头表述)**
>
> 可以用于个人私用学习改编为个人使用的 skill 和 tool,禁止用于训练机器学习模型,禁止配置到通用广泛传播的 skill tool mcp 等(例如集成到 workbuddy 中)。
AI 帮我找到了 RAIL(Responsible AI Licenses)这个协议家族——它的结构就是”基础授权 + 使用限制附件”,正好适合我的需求。又参考了 BSD 3-Clause Non-AI License,它有一条经过打磨的训练禁令措辞。AI 起草了一版叫 `PRAL-1.0`(Paddy 个人研究与改编许可)的东西。
然后我让它继续优化。它核查了我提到的几个参考协议,发现其中一个(CIEL Limited Open Access License v1.2)可能是 AI 编造的——查无此证。这让我更加确信:在这件事上,AI 是好工具,但不能全信。
经过几轮迭代,协议从 v1.0 到 v1.1 到 v1.2,禁训练条款从单句扩展成了覆盖衍生品、数据集、微调、蒸馏、嵌入库(RAG)的完整禁令。传播渠道禁令、分发与商用禁令也都补齐了。
到这一步,技术层面的问题基本解决了。但我的焦虑并没有消失。
因为我知道,无论协议写得多严密,公开的东西就是公开的。爬虫不会读你的 LICENSE,训练管线不会检查你的条款。协议是”事后追责”的依据,不是”事前预防”的手段。我在用法律文本对抗一个技术现实,这本身就很无力。
而真正让我不舒服的,也不是法律层面的问题。是别的什么东西。
## 禁止被资本主义异化
在技术条款之外,我加了一句话。先是加在协议里的,后来也加在了心里。
协议变成了这样:
> **PRAL v2.0(序言节选)**
>
> 本许可旨在保护劳动者的知识成果,使其能够用于提高劳动者个人的工作效率、解放其时间与创造力;反对这些成果被资本异化——即脱离劳动者,反过来成为支配、监视、规训或剥削劳动者之工具。
>
> 本许可欢迎以个人学习、研究与改编为目的的使用,反对使材料异化为资本增殖工具或劳动支配工具的使用。
>
> 可以用于个人私用学习改编为个人使用的 skill 和 tool,旨在提高劳动者个人工作效率,禁止用于训练机器学习模型,禁止配置到通用广泛传播的 skill tool mcp 等(例如集成到 workbuddy 中),禁止被资本主义异化。
“禁止被资本主义异化。”
这句话加了之后,AI 给了我一堆法律分析:序言的概括条款太模糊、定义 7 存在循环定义、三.4.e 的 catch-all 条款在法庭上可能被攻击为范围不确定……它说得都对。从法律起草的角度看,这句话确实不够精确。
但我还是留着它了。
因为这句话不是写给法官的,是写给自己的。
我恐惧的不是”有人违反了我的协议”。我恐惧的是:**我花时间踩坑积累的经验,被公司拿走,配一个更便宜的人来用,然后我被优化掉。** 我恐惧的是:我主动提升效率的工具,反过来成了证明”这个岗位不需要人”的证据。我恐惧的是:我亲手造了一把更锋利的刀,然后这把刀架在了自己的脖子上。
这不是一个法律问题。这是一个人的存在焦虑。
AI 在分析协议条款的时候,建议我用”行为定义违法,用序言表达立场”——把立场和法律拆开。这个建议很好,我采纳了。但它没法理解的是:我写”禁止被资本主义异化”这八个字的时候,手在抖。
不是夸张。是那种你明知道一件事在理性上可能没有用,但还是要做的感觉。像一个人在深夜锁门——锁挡不住想进来的人,但锁门这个动作本身,是你在黑暗中给自己的一点确定感。
## 最恐怖的事
说到底,对于我最恐怖的事不是 AI 太强。
AI 太强我反而兴奋——一晚上挖十多个漏洞,半小时搞定一天的服务器部署,这些事让我觉得自己站在一个巨大的杠杆上,力量被放大了。
对于我最恐怖的是**被优化了**。或者说,失去自己存在的意义。
这两个恐惧看起来矛盾,其实是同一枚硬币的两面。AI 越强,杠杆越大,我能做的事越多——但同时,”我”在这件事里的权重就越小。当 AI 能独立完成从挖漏洞到写报告的全流程时,我在这个流程里的位置是什么?当我的 agent 工具库足够完善,任何一个会用 AI 的人都能驾驭时,我花在踩坑上的那些时间、那些痛苦、那些”我知道这个坑在这里”的隐性知识——它们还值钱吗?
我在”嚼口香糖”那篇文章里说,人的价值在品味、在判断、在”知道为什么做”。我现在依然相信这个判断。但相信是一回事,踏实是另一回事。
我相信人应该发展品味而不是跟 AI 比技能细节——但当我的同事用 AI 一句话搓出原型、老板说”咱们写的污染了我的上下文”、我挖空心思的调研被藏在了四十页文档的角落——这些时刻,”品味”这个词显得很轻。
我相信开源能增加议价力而不是削弱它——但当协议写了一遍又一遍,从 MIT 改到自定义限制性许可,还加了一句”禁止被资本主义异化”——这些动作本身就在告诉我:我不信。至少没有完全信。
我相信人本身是原因,也是目的——但当”存在意义”这四个字需要靠信念来支撑的时候,它就已经在摇晃了。
所以这份协议,与其说是在保护我的代码,不如说是在做一件事:**把恐惧写下来。**
写下来的恐惧,比闷在心里的好一点。不是因为写下来就能解决,而是因为写下来之后,你能看见它的形状。看见形状之后,至少能知道自己在怕什么。
我在怕什么?
我怕的不是 AI 替代我。我怕的是:在我被替代之后,没有人觉得这件事有什么不对。包括我自己。
---
这篇文章写到一半的时候,我问 AI:”你觉得我该不该开源这个仓库?”
它给了我一个很平衡的分析:开源的好处是作品集效应和社区反馈,风险是被白嫖和被训练。建议我分仓——公开仓放脱敏后的通用经验,私有仓留核心方法论。很理性,很正确。
但我没有照做。我把整个仓库都推上去了,带着那个”禁止被资本主义异化”的协议。
因为我知道,如果我把所有真正有价值的东西都藏起来,只公开一些脱了敏的通用笔记——那我开源的到底是什么?是我自己吗?还是一个安全的、不会受伤的影子?
我不想开源一个影子。
我也不想被优化成一个影子。
---
### 引用与参考
- **盖茨2026** Gates, B. (2026). *The turbulent AI era is here. The choices we make now are critical.* GatesNotes. [原文链接](https://www.gatesnotes.com/home/home-page-topic/reader/a-turbulent-ai-era-and-critical-choices-to-make) | [我的翻译](https://www.paddysun.top/archives/5092)
- **Paddy-5188** Paddy. (2026). *打开即沦陷:keyv 蠕虫与 AI 编码助手时代的供应链暗战*. [链接](https://www.paddysun.top/archives/5188)
- **Paddy-5098** Paddy. (2026). *嚼别人嚼过的口香糖,AI 时代人的价值*. [链接](https://www.paddysun.top/archives/5098)
- **PRAL** Paddy 个人研究与改编许可(PRAL),结构改编自 Responsible AI Licenses(licenses.ai)与 NON-AI-BSD3(github.com/non-ai-licenses)。仓库:[paddy-agent-cookbook](https://github.com/PaddySun/paddy-agent-cookbook)
====
# [Agent 考古] Ciatto 2025 解读:LLM 住进 BDI 解释器,计划生成与 believes achieved 退化
https://www.paddysun.top/archives/5172 · 2026-09-03
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:11 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[BDI 从理论到工程](https://www.paddysun.top/?p=5114) · [意图编辑权](https://www.paddysun.top/?p=5160) **阅读时间**:约 22 分钟
---
# 当 LLM 住进 BDI——Ciatto 2025 与强概念的当代补全
## 卡死的机器人,和一通迟到的电话
一个 BDI agent 一生中最安静的时刻,是它遇到一件计划库里没有的事。
在 [第 2 篇](https://www.paddysun.top/?p=5122) 的复现实验里,我们让一个只装了 rescue_victim 计划的 agent 遇上 engine_broken 事件。t=1,事件进了队列,agent 没动;t=2,没动;t=3、t=4,还是没动。整整四个时间步纹丝不动。这不是 agent 偷懒,而是 AgentSpeak(L) 的语义本来如此:事件驱动,按计划规则匹配,找不到适用计划,事件被丢弃,agent 什么都不做。这个场面不是复现的瑕疵,它就是 PRS、dMARS、AgentSpeak(L) 一脉工程化传统的正常运转。
这条传统有一个从未真正解决的前提:**计划库由人手写**。人写多全,agent 就多能干;人没写到的情境,agent 就当场哑火。Ciatto 等人在 2025 年 ECAI 论文的开篇,把这条老伤口明确地指了出来:
> “traditional BDI programming frameworks typically lack mechanisms allowing agents to autonomously acquire or build new plans at runtime”(传统 BDI 编程框架普遍缺少让 agent 在运行时自主获取或构建新计划的机制。)ciatto2025
经典的补救方案是一阶规划(first-principles planning):给每个动作建立前提条件与效果的形式模型,让规划器现场推出计划。但它需要详细的动作模型,这类模型成本高昂,在高度动态的环境中往往不可用 ciatto2025。这正是 Cohen & Levesque 的形式化 cl1990 与 PRS 工程化之间的那条老裂缝——理论上 agent 应该能推理出该做什么,工程上 agent 只能从预设计划库里选。
把镜头拉远一点,这道裂缝还有一层概念史的含义。1995 年,Wooldridge 和 Jennings 给 Agent 下过双层定义:弱概念是四性质(自主、社会、反应、主动),强概念是用信念、愿望、意图这些心智状态来概念化或实现的系统 wj1995。三十年过去,LLM Agent 遍地开花,但绝大多数只满足弱概念——LangGraph 把意图拓扑画成状态图,AutoGPT 把愿望-意图链条塞进 prompt,ReAct 循环在文本 token 流中隐式运行。这些系统的内部都不是 BDI 的结构。强概念的 BDI 架构,似乎被工程实践抛弃了。
2025 年,Ciatto 等人做了一件看似逆潮流的事:把 LLM 放进经典 BDI 架构里,让它担任计划生成模块(PGP, Plan Generation Procedure)。AgentSpeak(L) 解释器找不到合适计划时,调用 LLM 现场生成一个,加入计划库,然后按 BDI 的正常流程执行。LLM 让 BDI 第一次具备了运行时自主生成计划的能力——在强概念的意义上,这是一次真正的升级。
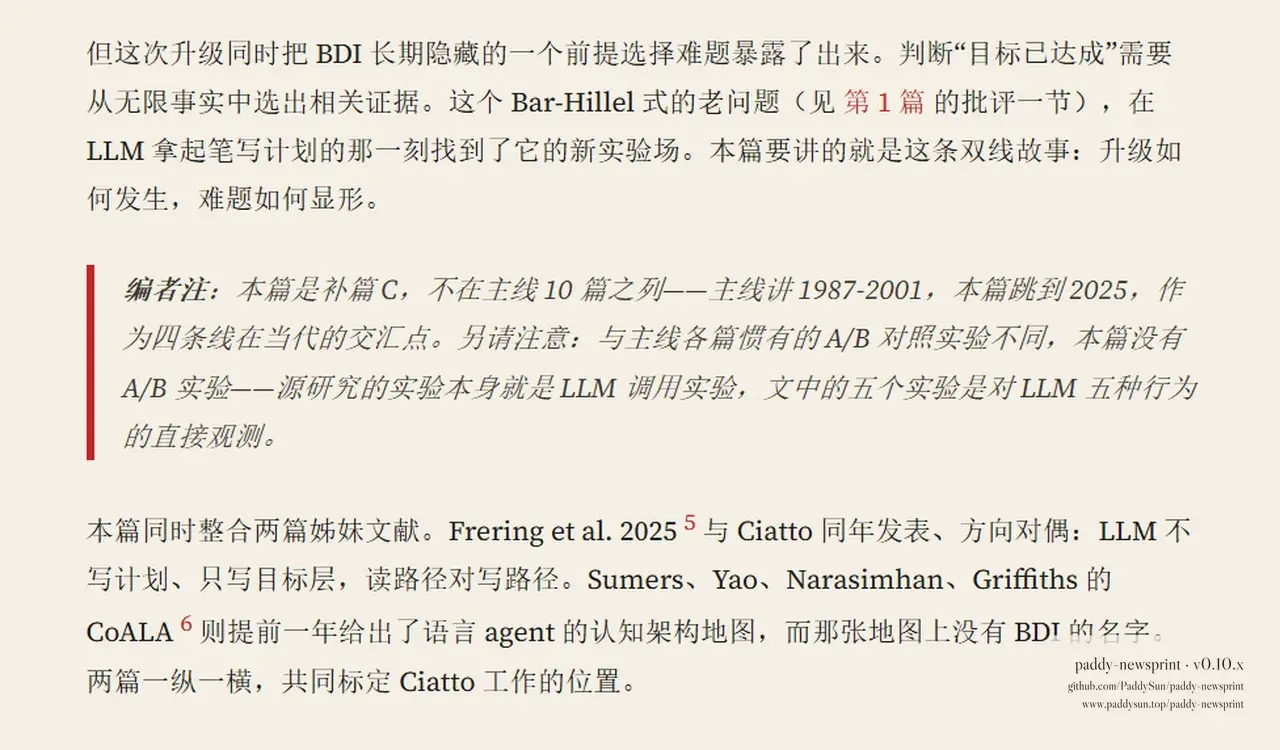
但这次升级同时把 BDI 长期隐藏的一个前提选择难题暴露了出来。判断“目标已达成”需要从无限事实中选出相关证据。这个 Bar-Hillel 式的老问题(见 [第 1 篇](https://www.paddysun.top/?p=5118) 的批评一节),在 LLM 拿起笔写计划的那一刻找到了它的新实验场。本篇要讲的就是这条双线故事:升级如何发生,难题如何显形。
> **编者注**:本篇是补篇 C,不在主线 10 篇之列——主线讲 1987-2001,本篇跳到 2025,作为四条线在当代的交汇点。另请注意:与主线各篇惯有的 A/B 对照实验不同,本篇没有 A/B 实验——源研究的实验本身就是 LLM 调用实验,文中的五个实验是对 LLM 五种行为的直接观测。
本篇同时整合两篇姊妹文献。Frering et al. 2025 frering2025 与 Ciatto 同年发表、方向对偶:LLM 不写计划、只写目标层,读路径对写路径。Sumers、Yao、Narasimhan、Griffiths 的 CoALA coala2024 则提前一年给出了语言 agent 的认知架构地图,而那张地图上没有 BDI 的名字。两篇一纵一横,共同标定 Ciatto 工作的位置。
## 逆潮流的方案:LLM 作为计划生成程序
Ciatto et al. 的方案说穿了只有一句话:在 AgentSpeak(L) 的推理循环上加一步 PGP。当找不到适用计划时,系统不再直接放弃:调用 LLM 生成一个计划,加入计划库,然后重试。方案的巧思都藏在这句话的执行细节里,可以拆成三个关键点。
### PGP 的输入与输出
PGP 接收四样东西作为上下文:目标描述、可用动作、当前信念、现有计划。输出的是一个结构化计划:触发事件、上下文条件、步骤序列,正好是 AgentSpeak(L) 计划规则的三段式。论文使用混合 YAML+Prolog 格式;我们的复现把它简化为 JSON,但三段式结构不变。
### 生成即入库
生成的计划不是一次性的:它加入计划库,成为 agent 的永久知识。第一次遇到新目标需要调 LLM——慢、贵;第二次及以后直接复用已生成的计划——快、免费。这是 GenAI+BDI 相对纯 LLM Agent 的关键效率优势,后文的复用实验会专门验证它。
### 多层生成策略:谁有权按下 LLM 的按钮
论文还设计了多层级的 PGP 策略声明,优先级从高到低:MAS 层(整个多 Agent 系统的默认配置)、Agent 层(单个 agent 的覆盖配置)、Plan 层(单个目标/计划的最高优先配置)。每一层可以指定不同的提示模板、温度参数、模型选择,甚至完全禁用 PGP,即“只能用预设计划,不准调 LLM”。
这在工程上是很聪明的设计:核心目标禁用 PGP 保可靠性,探索性目标启用 PGP 保灵活性,不同重要性的目标用不同的温度。“什么时候可以冒险调用 LLM”的决定权,交给了开发者。但从自主性的角度看,它也是一个有意思的妥协:LLM 的调用权仍然牢牢握在人类开发者手中。[第 9 篇](blog-09-intent-editing-rights.md) 讲意图编辑权的分层拉锯,这里是同一件事的另一面:编辑权放出去一半,又用配置文件收了回来。
### 论文如何评估生成的计划
论文用 JaKtA(一个 Kotlin 版 BDI 解释器)实现了原型,在 ExplorerRobot 网格世界场景中做系统评估。ExplorerRobot 是一个简化的二维网格世界:机器人移动、拾取与携带物品、感知周围环境,目标通常是“走到某位置”“拾取某物品”“把物品送到某处”。这个场景的好处是动作空间有限且定义清晰,适合系统评估 LLM 生成计划的正确性。
评估沿三个维度展开。提示类型:S(Syntactic,只给语法模板)、SS(Syntactic + Semantic,语法加动作语义描述)、SE(再加示例计划);温度:0.1、0.7、1.0;模型:GPT-3.5、GPT-4、CodeLlama 等。指标则覆盖计划正确性(PC, Plan Correctness)、上下文正确性(CC, Context Correctness)、计划体正确性(PBC, Plan Body Correctness)、目标正确性(GC, Goal Correctness)、复用率(RR, Reusability Rate)、单次调用生成计划数(NGC)、计划体信念变更数(NBC)、目标满足准确率(GSA, Goal Satisfaction Accuracy)。
这组指标本身就很有意思:它们量化的正是“LLM 生成的计划有多可靠”这个核心问题。论文的发现是:不同模型之间差异很大,温度和提示类型对结果有显著影响。
## PGP 扩展推理循环:在”找不到计划”处开口
标准 BDI 推理循环是四步:获取事件 → 查找适用计划 → 选择计划 → 执行步骤。Ciatto et al. 在“查找”失败的分支上开了一个口子,扩展后的循环如下:
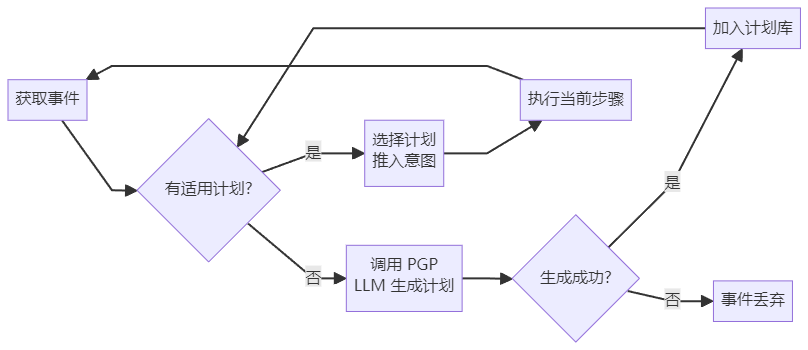
图里最值得盯住的是 **F→B 的回边**:生成的计划加入计划库之后,系统回到“查找适用计划”这一步重新查一遍。如果生成计划的上下文条件满足,它就被推入意图开始执行;如果不满足,计划虽然入库了,当前事件还是得不到处理。可见 PGP 生成的计划不仅步骤要对,上下文条件也要对。而上下文条件的判断完全依赖 LLM 对域的理解,这又是一个前提选择问题,“退化”一节会回到它。
用 [第 2 篇](blog-02-bdi-theory-to-engineering.md) 的语言说:PRS/dMARS 的四组件主循环在 Ciatto 架构中增加了一个 PGP 分支,经典 BDI 的“选项生成”从“从计划库选”扩展为“从计划库选,没有就调 LLM 生成”。
我们的复现把这一步实现在解释器里,核心只有十行(节选自 `../genai-bdi-reproduction/genai_bdi/interpreter.py` 的 `_invoke_pgp`,略去统计计数与提示组装):
```
def _invoke_pgp(self, goal: str) -> str:
result = self.pgp.generate_plan(
goal=goal, available_actions=list(self.actions.keys()),
current_beliefs=self.beliefs, existing_plans=self.plans.get_all(),
)
if result.success and result.plan:
self.plans.add(result.plan) # 生成计划直接入库
applicable = self.plans.find_applicable(goal, self.beliefs)
if applicable:
self.intentions.push(Intention(plan=applicable[-1])) # 回边:重新查找后入栈
```
四参数就是喂给 LLM 的全部上下文,`self.plans.add` 一行是入库,最后一行是 F→B 回边的落点。生成、入库、重查、入栈,一条链走完。跑起来是什么样?实验 1 给出了最小成功路径:agent 遇到一个无预设计划的目标 `!go_to(kitchen)`:
```
初始计划库: 0 预设, 0 LLM生成
目标: !go_to(kitchen)(无预设计划,需 PGP 生成)
step 1: PGP generated plan for !go_to(kitchen) (ok) — pushing intention
step 2: Executed action: walk_to(kitchen) -> moved to kitchen
✅ 目标达成: at(kitchen) (证据来源: deduction)
统计: PGP 调用=1, 成功=1, LLM生成计划=1
```
[第 2 篇](blog-02-bdi-theory-to-engineering.md) 里那个四步纹丝不动的 agent,在同一个“找不到计划”的分支上,现在走出了一条新路:调 PGP、入库、入栈、执行、达成。这就是 GenAI+BDI 的核心承诺——**LLM 补上了 BDI 长期缺失的计划获取能力**。agent 不再被预设计划库限死,它可以运行时“学会”新技能。
## 知识转移的双向性:一次生成,永久复用
Ciatto et al. 论文的一个核心洞见,是知识转移在 GenAI+BDI 里是双向的。**正向**:BDI agent 的目标名称、动作名称、现有计划作为上下文提供给 LLM,帮助它生成符合域约定的计划。上面代码里 `generate_plan` 的四个参数,就是这条正向通道。**反向**:LLM 生成的计划被加入计划库,成为 agent 永久知识的一部分;`self.plans.add(result.plan)` 这一行就是反向通道的入口。
论文还特别讨论了“自然语言描述”的作用:给目标和动作加上人类可读的描述(复现里对应 `add_goal_description` 和动作注册时的 description 参数)。同一份描述既帮助人类开发者理解域,也帮助 LLM 更好地生成计划。一次书写,人和 AI 共用一份说明书。这是一种巧妙的设计:文档即提示词。
反向通道的效果就是复用。实验 2 专门验证了它:第一次调用目标,PGP 被唤起;第二次调用同一目标,PGP 一次都没被唤起:
```
--- 第一次调用 !go_to(kitchen) ---
PGP 调用次数: 1
计划库大小: 1
--- 第二次调用 !go_to(kitchen) ---
PGP 调用次数: 0
计划库大小: 1
✅ 复用成功——第二次直接使用已生成计划,无需再调LLM
```
这直接验证了 Ciatto et al. 的核心设计:**生成一次,永久复用**。AutoGPT 这类纯 LLM Agent 每次都要从头推理;BDI+LLM 的混合架构把计划库当作 LLM 知识的缓存,第二次起零成本。这是结构性的效率优势,不是调参调出来的。
但复用机制有一个隐含前提:被复用的计划是正确的。如果 LLM 生成了一个错误计划,这个错误也会被永久复用——下次遇到同一目标,agent 还会执行同一个错误计划。计划库既是缓存,也是污染的培养基。这个暗面,下一节展开。
## 动作幻觉:当 LLM 不认识这个域
论文的设计里有一个明显的缺口:**生成的计划没有验证环节**。PGP 生成计划、加入计划库、开始执行。如果计划是错的(不存在的动作、错误的上下文条件、错误的步骤顺序),agent 会在执行中失败,但失败的计划仍然留在计划库里,下次遇到同一目标还会被选中。论文的评估指标里有正确性指标(PC/CC/PBC),但那些是离线评估,不是运行时验证。agent 自己不知道生成的计划对不对,只能试错。
我们的复现里,每条计划带一个来源标记,两类计划在数据结构上完全平等(节选自 `../genai-bdi-reproduction/genai_bdi/plan.py`):
```
class PlanSource(Enum):
PREPROGRAMMED = "preprogrammed" # 设计时人写(默认可信)
LLM_GENERATED = "llm_generated" # 运行时 PGP 生成(默认可疑)
```
标记是有的,但库本身不做区分对待。这里存在一个根本性的不对称:人类写的计划默认是对的(因为人验证过),LLM 生成的计划默认应该是可疑的。但在 Ciatto 的架构里,两者在计划库中地位平等。
实验 4 展示了可疑计划长什么样。当 LLM 完全不了解域时,agent 遇到陌生目标 `!solve_mystery`,PGP 被迫编造:
```
step 1: PGP generated plan for !solve_mystery (hallucinated!) — pushing intention
step 2: Executed action: walk_to(kitchen) -> moved
step 3: Action 'think_about(Solve a my)' not found — plan failed (hallucination?)
>>> Plan FAILED due to hallucinated action
```
PGP 先抄了一个真实存在的动作充门面,然后编出 `think_about(Solve a my)` 这种谁也没注册过的动作,最后还不忘在计划末尾加上“目标达成”的信念(这条暗线更重要,“退化”一节细说)。执行到第三步,解释器查不到这个动作,意图标记失败。幻觉计划在执行中必然露馅,这正是论文 PC 指标所量化的失败类型。
露馅本身不是问题所在,问题在于**露馅之后什么也不发生**:失败的计划还留在计划库里。错误的计划、幻觉的动作、不正确的上下文条件,都被永久保存,下次还会被选中。经典 BDI 中计划库是人类精心编写、默认可靠的;GenAI+BDI 中 LLM 生成的计划混了进来,随着生成越来越多,错误计划的比例上升,agent 的平均表现反而可能下降——这是一种经典 BDI 没有的新失效模式:**计划库污染**。
那么,agent 能不能从失败中学习?经典 BDI 没有学习机制,计划库是静态的。GenAI+BDI 理论上可以做“失败计划降级”:把执行失败的 LLM 生成计划标记为低优先级或直接移除,下次遇到同一目标时重新调用 PGP 生成新计划。但论文没有讨论这个机制,我们的复现也没有实现它,这是这条路线上一处明确的未来工作。
## 真实 API 的检验:DeepSeek 写出的泡茶计划
以上实验用的是 MockPGP——一个确定性的假 LLM,用来可控地制造成功与失败。但 Ciatto 论文的核心论断毕竟是对真 LLM 说的。实验 5 把 PGP 换成真实 DeepSeek API(deepseek-chat 模型,temperature=0.3),测试目标也换成一个全新领域:`!make_tea`。
```
测试目标: !make_tea(无预设计划,需LLM生成)
可用动作: walk_to(kitchen), boil_water, steep_tea, pour_in_cup ...
step 1: PGP generated plan for !make_tea (ok) — pushing intention
step 2: Executed action: walk_to(kitchen) -> moved to kitchen
step 3: Executed action: boil_water -> water boiled
step 4: Executed action: steep_tea -> tea steeped
step 5: Executed action: pour_in_cup -> poured tea into cup
✅ 目标达成: tea_in_cup (证据来源: deduction)
```
DeepSeek 生成的计划步骤顺序正确,动作全部来自可用动作清单,五步之内达成目标。核心论断在真实 API 上成立:**LLM 确实能生成可用的 BDI 计划**——先去厨房、烧水、泡茶、倒杯,一个懂做饭的计划。
但仔细看生成的计划,有一个微小但重要的格式错误:所有步骤都被标记为 `action` 类型;而在 AgentSpeak(L) 中,`!goal` 前缀的步骤应该是 subgoal(子目标)类型,会触发新一轮计划查找,而不是当作外部动作直接执行。LLM 用对了 `!` 前缀的写法,却没对上它的语义。这说明 LLM 对 BDI 语法的理解还停留在表面模式层,恰好对应论文评估中 SS 与 SE 两种提示类型的效果差异:不给语义描述和示例,LLM 只能靠猜。全部五个实验的完整脚本与实现见仓库 `../genai-bdi-reproduction/`。
## 同年的对偶:Frering 只许 LLM 读心智
Ciatto 的方案是让 LLM **写** BDI 的计划库。同一年,格拉茨工业大学与 BOKU 维也纳的 Frering、Steinbauer-Wagner、Holzinger 发表了一个镜像互补的架构 frering2025:LLM 只被允许**读** BDI 的心智状态。
他们的问题场景是机器人人机交互:操作员不该需要技术训练才能给机器人下指令。方案是把两个 LLM 组件接到一个 Jason 实现的 BDI agent 两侧:”User Command Interpretation”把自然语言指令翻译成参数化目标(如 goto(X,Y)),”Explanation Generation”用对话解释系统为什么这么做。BDI agent 居中持有全部心智状态,并持续把 Mind State(信念库 + 计划库 + 触发事件与所选行动的历史)转发给两个 LLM 组件。作者把分工说得很直接:
> “we use LLMs only to generate high-level goals from user commands, and rely on a BDI agent for refining it into robot actions”(我们只用 LLM 从用户指令生成高层目标,把目标细化为机器人动作的是 BDI agent。)frering2025
实现栈全是标准件:机器人侧 ROS2 + Gazebo 的 Clearpath Husky 仿真,BDI 侧 Jason,LLM 侧 GPT-4o,模块间用 MQTT 消息胶合。三个关键设计值得细看。
**第一,Mind State 的持续转发。** BDI agent 把信念库、计划库、触发事件与所选行动的历史打包成 Mind State,持续转发给两个 LLM 组件。指令解释用它理解上下文(如“回到上一个路径点”),解释生成用它回答“为什么”。这使 LLM 的语言成为**对心智状态的读操作**:解释生成组件甚至能拿到 AgentSpeak 源码,论文表 4 的示例对话里,LLM 准确引用了初始信念 `forbidden_area(2,2,0.5)` 和计划中的距离判断公式来解释机器人为什么拒绝移动。解释是从数据结构里读出来的,不是从权重里编出来的。
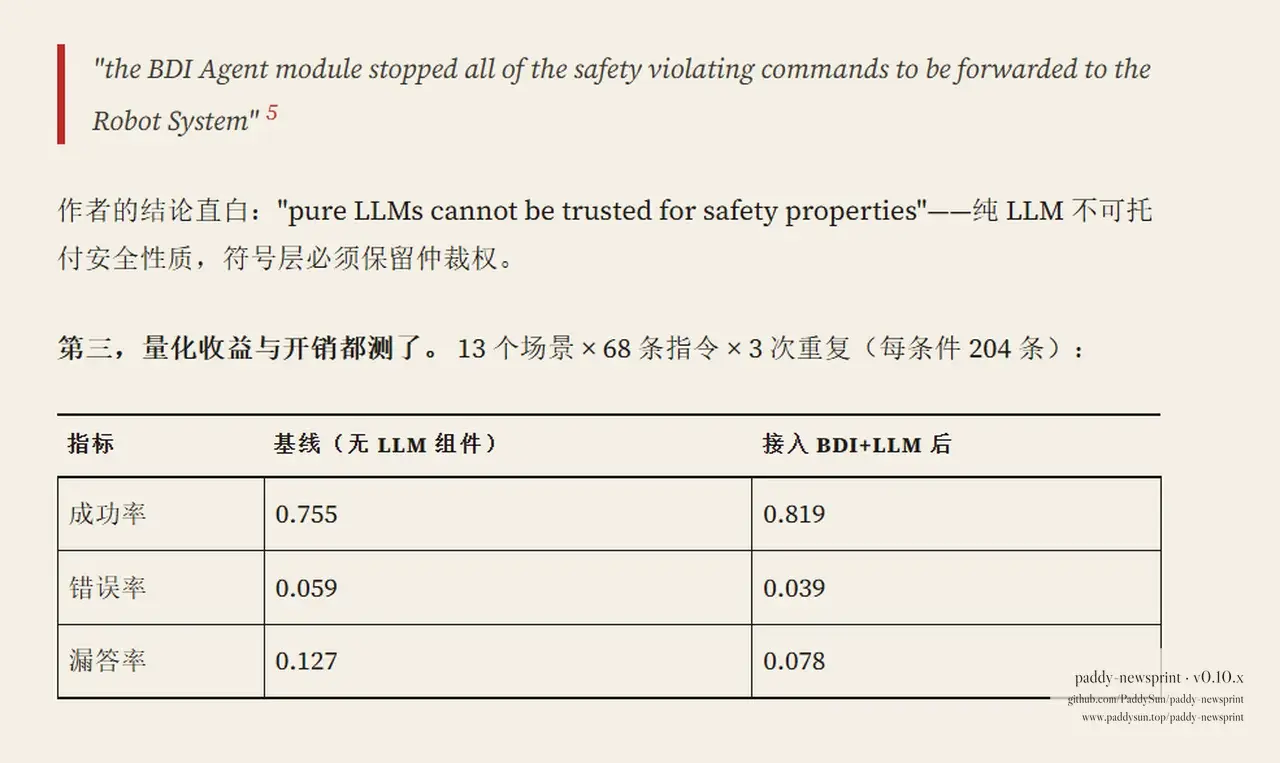
**第二,安全闸门在 BDI,不在 LLM。** BDI agent 预置禁入区信念,收到目标先做距离检查,命中则拒绝转发给机器人。评估中 LLM 指令解释侧的输出仍有安全违规(SER 0.039),但实践上 BDI 组件挡下了全部违规指令,无一到达机器人。论文表 3 脚注原文:
> “the BDI Agent module stopped all of the safety violating commands to be forwarded to the Robot System” frering2025
作者的结论直白:”pure LLMs cannot be trusted for safety properties”——纯 LLM 不可托付安全性质,符号层必须保留仲裁权。
**第三,量化收益与开销都测了。** 13 个场景 × 68 条指令 × 3 次重复(每条件 204 条):
指标基线(无 LLM 组件)接入 BDI+LLM 后成功率0.7550.819错误率0.0590.039漏答率0.1270.078
提升主要来自记忆类指令(“回到第三个路径点”):Mind State 的事件历史给了 LLM 一个跨对话的准确记忆。开销侧:BDI agent 平均 CPU 1.89%、内存 298MiB,200 次迭代的累计时间差稳定在约 3.2 秒,相比 LLM API 延迟可忽略。
Frering 的边界同样清楚:LLM 的写权限只到**愿望层**(生成目标),计划库保持人预设、对 LLM 只读。论文的未来工作一节,恰好预告了 Ciatto 的方向——
> “granting LLMs access to BDI-specific commands, enabling the automated execution of meta-reasoning actions at runtime (e.g., resuming and suspending goals)”(授予 LLM 访问 BDI 专有命令的权限,使其能在运行时自动执行元推理动作,如恢复和挂起目标。)frering2025
但作者们立即加上警告:这需要仔细考虑 LLM 生成计划的风险,可能需要显式引入运行时验证(runtime verification)。读路径的作者对写路径风险的判断,与 Ciatto 论文未讨论验证环节形成直接对照:两条路线站在同一道悬崖边上,一个跳了下去,一个立了警示牌。
用 [第 3 篇](https://www.paddysun.top/?p=5128) 强概念的坐标看,Ciatto 与 Frering 构成一对互补实验:Ciatto 开放**程序性记忆的写路径**(计划库),Frering 开放**心智状态的读路径**(解释与上下文),只允许写愿望层(目标)。两条路径都保持 BDI 解释器持有数据结构,强概念的“硬途径”在两个方向上各自前进一步。而 Frering 那条“BDI 挡下全部违规”的实证,正是 [第 9 篇](https://www.paddysun.top/?p=5160) “LLM 提议、解释器仲裁”这个编辑权分担结构在安全侧的验证:LLM 可以犯错,只要犯错的那一层没有执行权。
## 三架构对照:GenAI+BDI 在 BDI 坐标系里的位置
把经典 BDI、GenAI+BDI、纯 LLM Agent 放进同一张图,三种架构在数据结构上的差异一目了然:
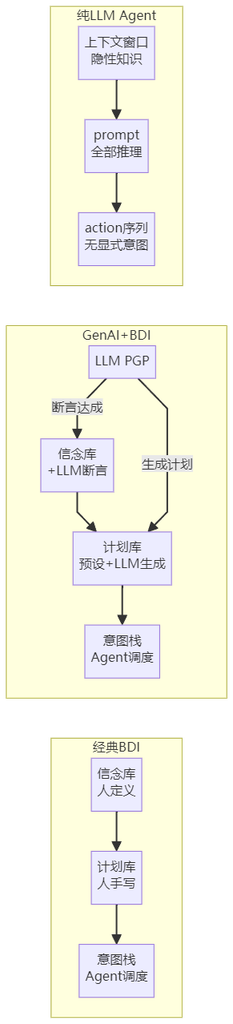
图中的关键差别在中间一列:GenAI+BDI 保留了 BDI 的全部数据结构(信念库、计划库、意图栈),只是在“计划库只能人写”这一点上开了口。LLM PGP 从两个方向接入:向计划库写入生成计划,向信念库写入达成断言(后者正是“退化”一节的伏笔)。逐维度展开成表:
维度经典 BDI (dMARS)GenAI+BDI (Ciatto 2025)纯 LLM Agent (AutoGPT)**信念**信念库(基文字集合),来源=感知/推导信念库 + LLM 断言信念,来源需区分上下文窗口 + 隐性知识**愿望**外部下发(用户/消息)外部下发 + LLM 生成子目标用户 prompt**意图**可调度的计划栈,计划来自预设库计划栈 + 运行时 PGP 生成计划ReAct 循环中的 action 序列**意图编辑权**计划库人预设 + 栈调度 Agent骨架人预设 + 血肉 LLM 生成 + 计划库 LLM 扩充全部交给模型(失控)**承诺策略**盲目/单一心智/开放心智三种旋钮三种旋钮 + PGP 失败即放弃无显式策略**计划来源**人手写(设计时)人手写 + LLM 生成(运行时)LLM 每次重新推理**“believes achieved”**计划末尾的 +belief(人定义)计划末尾的 +belief(LLM 定义)无显式判定(容易跑不停)
关键观察:**GenAI+BDI 是强概念的升级,不是弱概念的替代**。它保留了 BDI 的全部数据结构与推理循环,只在“找不到计划”这个分支上接入了 LLM。相对纯 LLM Agent,它的优势是结构清晰、可验证、可复用、有承诺策略;相对经典 BDI,它补上了计划获取的短板。
用 [第 9 篇](https://www.paddysun.top/?p=5160) 意图编辑权的三层分担(目标人写、计划人写、选哪个执行归 Agent)来看,GenAI+BDI 把“计划编写”这一层也下放给了 LLM,编辑权进一步向 agent 端转移。但严格说,LLM 不是 agent 自身,它是外部调用的服务:编辑权从“人类开发者”独占,变成“LLM + 开发者共同控制”,并没有完全交给 agent。前文的多层生成策略,就是这份共同控制的体现:开发者用配置文件划定 LLM 的写作权限。
## CoALA 地图,与 BDI 的精确缺席
如果说 Ciatto 与 Frering 是 BDI 谱系内部的推进,普林斯顿的 Sumers、Yao、Narasimhan、Griffiths 发表的 CoALA 则来自另一条谱系——把语言 agent 放回认知架构(cognitive architecture)传统,给出一张地图 coala2024。
CoALA 的出发点是一个经典类比:**LLM 是概率产生式系统**。产生式系统是字符串改写规则,加上控制流就是算法,加上感知、记忆、决策循环就是认知架构;LLM 定义了对文本续写改动的概率分布,正好是概率化的产生式,prompt 工程是控制流。于是,为产生式系统发展了三十年的认知架构控制原理,可以整体搬到 LLM 上。Soar 从 1986 年起就能“把新产生式写入自己的程序性记忆”,相当于更新自己的源代码。Ciatto 的 PGP,就是这个四十岁先例的 LLM 版。
框架本身是三件套:**记忆**(工作记忆 + 长期记忆,长期又分情景/语义/程序性三种子类)、**行动空间**(外部 grounding:物理/对话/数字环境;内部行动:检索=读长期记忆、推理=用 LLM 更新工作记忆、学习=写长期记忆)、**决策循环**(规划阶段的提议-评估-选择 + 执行阶段)。两个定义对本系列特别重要:
> “CoALA’s notion of working memory is more general: it is a data structure that persists across LLM calls.”(CoALA 的工作记忆概念更一般:它是跨 LLM 调用持久的数据结构。)coala2024
> “Language agents contain two forms of procedural memory: implicit knowledge stored in the LLM weights, and explicit knowledge written in the agent’s code.”(语言 agent 的程序性记忆有两形:LLM 权重中的隐式知识,与 agent 代码中的显式知识。)coala2024
第一句是本系列反复强调的“harness 持有心智状态数据结构”的正式表述:LLM 无状态,agent 的心智必须住在 LLM 之外、跨调用持久的结构里。第二句则精确定位了 Ciatto 的 PGP:LLM 生成计划写入计划库,在 CoALA 语境下就是“更新程序性记忆(agent 代码)”。而 CoALA 对这个操作的风险评级,恰好预写了前文“动作幻觉”一节的计划库污染问题:
> “writing to procedural memory… is significantly riskier than writing to episodic or semantic memory, as it can easily introduce bugs or allow an agent to subvert its designers’ intentions.”(写程序性记忆比写情景/语义记忆危险得多——容易引入 bug,或让 agent 背离设计者意图。)coala2024
用 [第 9 篇](https://www.paddysun.top/?p=5160) 的词汇说,这是**意图编辑权**风险的认知架构表述。CoALA 还把访问控制列为 agent 设计的第一步:其零售助手示例中,agent 对情景记忆可读可写、对语义与程序性记忆**只读**——
> “since it should not update the inventory or its own code”(因为它不应自行更新货架库存或自己的代码。)coala2024
读/写权限的分层授予,就是编辑权的仲裁设计。
还有一处精确的缺席。我们在 CoALA 全文(TMLR 2024 版 32 页)中检索 BDI、belief-desire、AgentSpeak——**零命中**。CoALA 引用的认知架构谱系是 Soar/ACT-R/产生式系统,不是 PRS/dMARS/AgentSpeak。这不止是疏漏:Soar 谱系(Newell 的人类问题求解传统)与 BDI 谱系(Bratman 的实践推理传统)是符号主义认知架构的两条平行线,CoALA 用前者组织语言 agent 时,后者恰好缺席。Ciatto 与 Frering 做的,正是把 BDI 谱系接入 CoALA 地图上的空位。两条谱系在 2025 年前后于语言 agent 世界会合,但会合点上的相互引用尚未发生:CoALA 不引 BDI,Ciatto/Frering 也不引 CoALA。即便如此,Soar 谱系与 BDI 谱系在“写程序性记忆最危险”这一点上独立收敛。这本身就是计划库污染问题实在性的佐证。
用 CoALA 坐标反解三种架构(此表为本文归纳,非 CoALA 原文;它的代表系统是 SayCan/ReAct/Voyager/Generative Agents/Tree of Thoughts):
CoALA 概念经典 BDICiatto GenAI+BDIFrering BDI+LLM语义记忆(世界知识)信念库(人定义)信念库 + LLM 断言信念库(人定义)程序性记忆-代码计划库(人手写)计划库 + LLM 运行时写入计划库(人预设,LLM 只读)工作记忆事件队列 + 意图栈同左 + PGP 调用记录同左 + Mind State 转发推理行动(慎思)元级 KA / 选择函数PGP + 选择函数指令解释 LLM学习:写程序性记忆不存在PGP 入库(无验证)未开放(未来工作 + 风险警告)LLM 权重(隐式程序性记忆)不存在PGP 的知识来源指令解释与解释生成的知识来源
## “believes achieved” 的三时代退化
现在回到本篇埋了两处伏笔的那条暗线:计划末尾那个由 LLM 写下的“目标达成”信念。
C&L 1990 的 PGOAL 放弃条件只有二支:believes achieved(相信已达成)或 believes impossible(相信永不可能)cl1990。这正是 [第 1 篇](https://www.paddysun.top/?p=5118) 的形式化起点,也是 [第 9 篇](https://www.paddysun.top/?p=5160) “自止”论述的核心。在标准 BDI 工程中,”believes achieved”由计划末尾的 `+belief` 步骤实现:人类开发者写计划时,就确定了什么算达成。那么在 GenAI+BDI 中,**谁来决定“目标已达成”的信念是什么?** 答案是:LLM。
这个概念在三个时代中的语义强度一路走低:
图中的退化路径很清楚:C&L 1990 有模态算子 BEL(x, p)、可能世界语义、形式化正确性证明——强,有语义保证;经典 BDI 工程降为计划末尾的 +belief、人定义达成条件、人保证正确性——中,有人工担保;GenAI+BDI 再降为 LLM 写 belief_add、可能漏掉或写错、无语义无验证——弱,退化为断言。
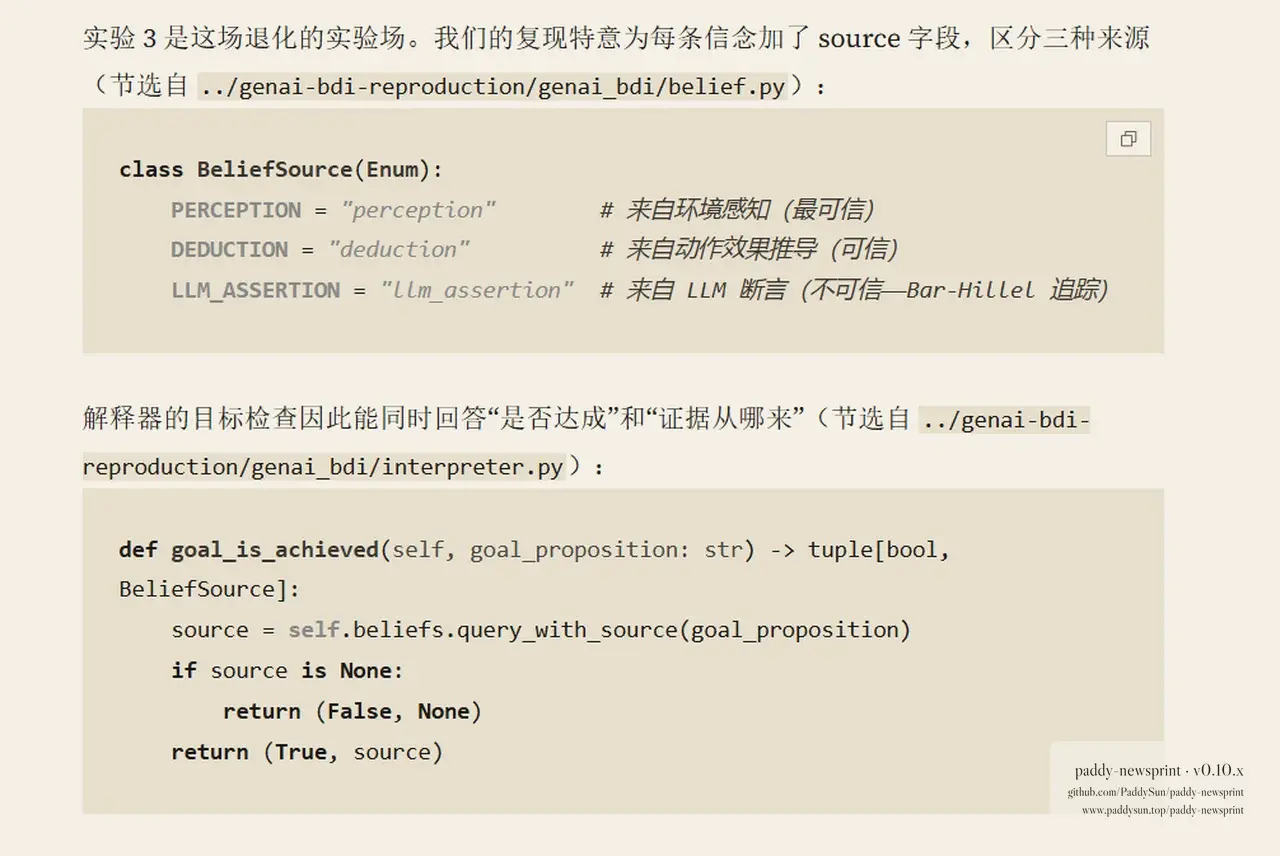
实验 3 是这场退化的实验场。我们的复现特意为每条信念加了 source 字段,区分三种来源(节选自 `../genai-bdi-reproduction/genai_bdi/belief.py`):
```
class BeliefSource(Enum):
PERCEPTION = "perception" # 来自环境感知(最可信)
DEDUCTION = "deduction" # 来自动作效果推导(可信)
LLM_ASSERTION = "llm_assertion" # 来自 LLM 断言(不可信——Bar-Hillel 追踪)
```
解释器的目标检查因此能同时回答“是否达成”和“证据从哪来”(节选自 `../genai-bdi-reproduction/genai_bdi/interpreter.py`):
```
def goal_is_achieved(self, goal_proposition: str) -> tuple[bool, BeliefSource]:
source = self.beliefs.query_with_source(goal_proposition)
if source is None:
return (False, None)
return (True, source)
```
实验 3a 构造了虚假断言场景:LLM 生成的计划在正常的动作效果之外,末尾多写了一个达成信念:
```
step 1: PGP generated plan for !go_to(kitchen) (ok) — pushing intention
step 2: Executed action: walk_to(kitchen) -> moved to kitchen
step 3: Added belief: at(kitchen) (source: llm_assertion)
step 4: Added belief: go_to_kitchen_achieved (source: llm_assertion)
⚠️ LLM 断言目标达成: go_to_kitchen_achieved
来源: llm_assertion
```
注意 step 3 和 step 4 的来源标记。`go_to_kitchen_achieved` 不是来自感知(perception),也不是来自动作效果的推导(deduction),而是 LLM 自己写进计划里的。这个例子里动作恰好真的把机器人送到了厨房,问题被遮住了;但如果动作没达成,LLM 仍然可能这么断言。判定“已达成”的责任,已经从人类开发者转移到了一个没有语义保证的统计模型手里。
实验 3b 追问更深的一层:**如果 LLM 生成的计划漏掉了这个 “achieved” 信念呢?** 复现程序的输出把答案钉在屏幕上——
```
C&L 的 BEL(x, p) 在 GenAI+BDI 中退化为:
1. LLM 在计划末尾写的 belief_add(可能漏掉或写错)
2. LLM 对结果的口头断言(没有算子语义)
3. 人类用户的主观判断(回到了人在回路)
```
漏写,则 agent 永远不认为目标达成,意图永不终止;写错,则 agent 在错误的时机自认完成。三种退化产物都不是 C&L 意义上的“信念”:没有模态算子,没有可能世界语义,没有正确性证明。
这正是 Bar-Hillel 批评的精确投影:**判断“p 是真的”需要从无限多的事实中选出相关证据子集,这个前提选择比演绎本身困难得多**。前提选择的责任落到了 LLM 身上,而 LLM 没有语义保证、没有算子定义、没有验证机制。计划的**上下文条件**是同一根刺的另一个投影:LLM 生成的上下文条件可能太宽松(不该触发时触发了,导致执行失败)、太严格(该触发时没触发,导致不必要地再次调用 PGP)、或完全错误(引用了不存在的信念命题)。上下文条件的正确性本质上也是一个前提选择问题:LLM 要从无限多的可能前提中选出“这个计划适用所需的条件”,Bar-Hillel 批评再次应验。
这里与 [第 9 篇](blog-09-intent-editing-rights.md) 的自止论述直接互证。那一篇把 LLM 时代的自止判为“自知、自觉、自止”三问中“至今无主的一问”,并引 [第 1 篇](blog-01-intent-as-commitment.md) 的 A/B 实验作证:精确匹配的单组件判定与信念库规模无关,换成 LLM 语义判定则在百条无关事实中失焦(K=100 时九成漏终止)。本篇实验 3 是同一根刺在 GenAI+BDI 中的单 agent 投影:**自止的判定被外包给统计直觉,而统计直觉连“什么信念代表达成”都是自己挑的**。第 9 篇的判词在这里再次生效——谁有权写放弃条件,谁就持有最后的编辑权。Ciatto 的架构把这个权柄递给了 LLM,却没有同时递给它语义。
## 影响谱系:谁站在这次升级背后
### 强影响
**Rao & Georgeff BDI 架构(1991/1995)**——Ciatto et al. 的工作直接建立在 BDI 架构之上,使用 AgentSpeak(L) 语法和标准 BDI 推理循环。PGP 是对 BDI 的扩展,不是替代。
> Rao & Georgeff, “Modeling Rational Agents within a BDI-Architecture” (KR&R-91) — [https://doi.org/10.1016/0743-1066(91)90040-J](https://doi.org/10.1016/0743-1066%2891%2990040-J)
**AgentSpeak(L)(Rao 1996)**——论文明确以 AgentSpeak(L) 为基础语言,PGP 的输入输出格式遵循 AgentSpeak(L) 的计划规则语法。
> Rao, “AgentSpeak(L): BDI Agents Speak Out in a Logical Computable Language” (MAAMAW’96) — [https://doi.org/10.1007/3-540-61732-9_3](https://doi.org/10.1007/3-540-61732-9_3)
### 中强影响
**dMARS 规范(d’Inverno et al. 1998)**——四大数据结构(事件、信念、意图、计划)的设计直接继承自 dMARS dinverno1998。
**Shoham AOP(1993)**——将心智状态作为编程原语的思想,以及 W&J 强概念的定义,都是 GenAI+BDI 的概念祖先 shoham1993。LLM 作为 PGP,让强概念第一次具备了运行时自主获取计划的能力。
### 中影响
**AutoGPT / LangGraph 等 LLM Agent 框架**——虽然技术路线不同(纯 LLM vs BDI+LLM),但两者面临的根本问题相同:计划生成、目标判定、终止条件。Ciatto 的 BDI 框架为这些问题提供了更结构化的思考方式。
> LangGraph — [https://langchain-ai.github.io/langgraph/](https://langchain-ai.github.io/langgraph/)
### 同期并行工作(2023-2025)
**Frering et al. 2025(EAAI)——读路径与安全闸门**。与 Ciatto 同年、方向对偶:LLM 只读 Mind State、只写目标层,BDI 持有数据结构并承担安全仲裁。实证结论“纯 LLM 不可托付安全性质、BDI 挡下全部违规输出”,为强概念“硬途径”提供了安全侧的第一组量化数据(见前文“同年的对偶”一节)。
> Frering, Steinbauer-Wagner & Holzinger, EAAI 141 (2025) 109771 — [https://doi.org/10.1016/j.engappai.2024.109771](https://doi.org/10.1016/j.engappai.2024.109771)
**Sumers et al. CoALA(TMLR 2024)——谱系地图**。用产生式系统-认知架构传统(Soar 线)组织语言 agent,提出记忆/行动空间/决策循环三件套。“工作记忆=跨 LLM 调用持久的数据结构”与“写程序性记忆最危险”两个论断,分别对应本系列的数据结构问题与计划库污染问题。全文未提 BDI,两条认知架构谱系的会合尚未完成(见前文“CoALA 地图”一节)。
> Sumers, Yao, Narasimhan & Griffiths, “Cognitive Architectures for Language Agents” — [https://arxiv.org/abs/2309.02427](https://arxiv.org/abs/2309.02427)
## 诚实边界:这次升级没有做到什么
Ciatto et al. 的工作是 BDI 强概念的一次有意义的升级,但边界必须诚实标出,以下每一条都不弱化:
- **没有运行时计划验证**:生成的计划直接入库,执行失败后也不会标记或移除。
- **没有承诺策略的整合**:PGP 失败时的行为属于一个特殊分支,并非三种承诺策略(盲目/单一心智/开放心智,见 [第 2 篇](https://www.paddysun.top/?p=5122))的自然延伸。如果 PGP 连续失败多次,agent 是应该放弃目标(盲目承诺)、重新尝试(开放心智)、还是降级处理?论文没有讨论。
- **没有联合意图扩展**:论文只讨论单 agent 场景,多 agent 的 GenAI+BDI 仍是开放问题——如果两个 agent 都用 PGP 生成计划,它们的意图如何协调?
- **评估限于网格世界仿真**:ExplorerRobot 场景相对简单,动作空间小且定义清晰。真实世界域(比如机器人操作、软件自动化)的表现尚不清楚。
- **JaKtA 研究原型**:论文的实现是研究原型,不是生产级系统。性能、稳定性、可扩展性都还没有经过工业验证。
- **没有 plan-library 污染的治理**:随着 LLM 生成越来越多的计划,计划库的质量会如何变化?有没有阈值控制?论文没有讨论。
把这六条边界放回系列坐标,本篇的位置就清楚了。与 [第 10 篇](https://www.paddysun.top/?p=5167) 呼应:Dochkina 的 Sequential 协议证明了“固定排序 + 自主角色”的混合最优。Ciatto 的 GenAI+BDI 是同一思路在单 agent 内部的体现——**固定 BDI 骨架 + LLM 自主生成计划血肉**,三时空同构又多了一个时空点。与 [第 2 篇](blog-02-bdi-theory-to-engineering.md) 呼应:PRS 以来“计划库未覆盖即卡死”的工程宿疾,第一次有了运行时的解药。与 [第 9 篇](https://www.paddysun.top/?p=5160) 呼应:解药递过来的同时,自止的判定权也被递了出去——收获与代价在同一行代码里。
**[作者判断]** GenAI+BDI 可能是比纯 LLM Agent 更有前途的架构方向:它保留了 BDI 的结构优势(可验证、可复用、有承诺策略),同时用 LLM 补上了计划获取的短板。但计划验证、计划库污染、上下文正确性这三个 Bar-Hillel 式问题,是这条路线必须解决的根本难题——它们不解决,强概念的升级就始终悬在半空。三十年前 W&J 划出的强弱之别,2025 年的这次实验给出了一个未完成的答案:心智状态的数据结构回来了,心智状态的语义还没有。
## 参考文献
[**wj1995**] Wooldridge, M. & Jennings, N. R. “Intelligent Agents: Theory and Practice.” *Knowledge Engineering Review*, 10(2): 115-152, 1995.
[**ciatto2025**] Ciatto, G., Aguzzi, G., Battistini, R., Baiardi, M., Burattini, S. & Ricci, A. “Exploiting GenAI for Plan Generation in BDI Agents.” In *Proc. ECAI 2025*, FAIA 413: 3495-3502, 2025. DOI: 10.3233/FAIA251223 — 论文 PDF:[https://cris.unibo.it/bitstream/11585/1026414/3/FAIA-413-FAIA251223.pdf](https://cris.unibo.it/bitstream/11585/1026414/3/FAIA-413-FAIA251223.pdf)
[**frering2025**] Frering, L., Steinbauer-Wagner, G. & Holzinger, A. “Integrating Belief-Desire-Intention agents with large language models for reliable human–robot interaction and explainable Artificial Intelligence.” *Engineering Applications of Artificial Intelligence*, 141: 109771, 2025. DOI: 10.1016/j.engappai.2024.109771(开放获取 CC BY。存档:本地 PDF `Integrating Belief-Desire-Intention agents with large language models for.pdf`,11 页全文转录核对——注意网上检索摘要误作 “Lucas Frering”、卷号 137,PDF 原文为 **Laurent** Frering、卷号 **141**)。
[**coala2024**] Sumers, T. R., Yao, S., Narasimhan, K. & Griffiths, T. L. “Cognitive Architectures for Language Agents.” *Transactions on Machine Learning Research*, 02/2024. arXiv:2309.02427. 存档:本地 PDF `Cognitive Architectures for Language Agents.pdf`,32 页全文转录核对(BDI/belief-desire/AgentSpeak 零命中之断言基于此版本全文检索)。
[**cl1990**] Cohen, P. R. & Levesque, H. J. “Intention Is Choice with Commitment.” *Artificial Intelligence*, 42(3): 213-261, 1990.
[**shoham1993**] Shoham, Y. “Agent-Oriented Programming.” *Artificial Intelligence*, 60(1): 51-92, 1993. DOI: 10.1016/0004-3702(93)90003-9
[**dinverno1998**] d’Inverno, M., Kinny, D., Luck, M. & Wooldridge, M. “A Formal Specification of dMARS.” In *Intelligent Agents IV* (ATAL-4), LNAI 1365: 155-176, Springer, 1998.
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 意图编辑权:从 BDI 到 LLM Agent,谁有权决定机器何时停下来
https://www.paddysun.top/archives/5160 · 2026-09-02
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 9 篇 / 共 11 篇 **主题分类**:观点评论 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [意图即带承诺的选择](https://www.paddysun.top/?p=5118) · [BDI 从理论到工程](https://www.paddysun.top/?p=5122) **阅读时间**:约 27 分钟
---
# 意图编辑权:谁来决定智能体做什么、何时坚持、何时放弃
2023 年,AutoGPT 的 README 里写着一句让所有用户都会心一笑的警告:这个程序“可能永远跑下去”(may run forever),官方认可的终止手段是 Ctrl+C。三十三年前的 1990 年,Cohen 和 Levesque 在 *Artificial Intelligence* 期刊上用两行条件回答过同一个“何时停”的问题:agent 在相信目标已达成、或相信目标永不可能之前,不放弃cl1990。一个跑在千亿参数上,一个跑在模态逻辑里,但它们争夺的是同一件东西——**谁有权替 agent 写下“放弃”这两个字**。
这个东西,本系列把它叫做**意图编辑权**:决定 agent 做什么、何时坚持、何时放弃的权力。它是贯穿前面八篇(以及提前引用的第 10 篇)所有故事的那条暗线:合同网争夺的是任务分配的编辑权,KQML 争夺的是对话资格的编辑权,TouringMachines 与 INTERRaP 争夺的是慎思时机的编辑权。本文是本系列唯一的观点总结篇,把八条线索收拢到一张桌面上,看这场拉锯从 1958 年打到 2026 年,究竟前进了几步、又在哪里原地踏步。在收束之前,我们还要完成一次跨越两个系列的焊接,把阶段二终章留下的“自止”之问,焊接到 PGOAL 的放弃条件上。
先看这场拉锯的起点,和那次几乎没人察觉的权力转移。
## 麦卡锡的祈使句,与一次悄悄发生的权力转移
1958 年,McCarthy 在 Advice Taker 中提出了一个至今回响的愿景:让机器自行推导该做什么mccarthy1958。但在那个年代,“自行推导”的地基是人写定的:每一条 if-then 都是程序员手写的祈使句,机器只负责执行,不负责决定做什么、何时坚持、何时放弃。人持有全部意图编辑权。谈不上设计缺陷,这就是那个时代对“机器”的全部想象。
三十二年后的 1990 年,Cohen 与 Levesque 发表了”Intention Is Choice with Commitment”cl1990(意图的概念底座来自 Bratman 1987bratman1987)。他们用 PGOAL→DECIDING→INTEND 的定义链给出了形式化答案:意图是对行动的持续性承诺,agent 在相信目标已达成或相信目标永不可能之前不放弃。PGOAL 的放弃条件全文一致只有二支,即 believes achieved 或 believes impossible,在论文 p232 的定义、p235 的解释、p239 的定理、p247 的结论四处彼此印证,没有第三个出口。
这是一次历史性的权力转移,而且安静得反常。在 McCarthy 那里,“何时放弃”由人写定的规则决定;在 C&L 这里,“何时放弃”变成了 agent 自己的判断——只要它相信目标尚未达成且并非永不可能,它就持续坚持。意图编辑权第一次从人手上部分移交给了机器:机器获得了“持续承诺”的义务,终止则受二元约束的管束。没有发布会,没有宣言,转移就发生在四个定义和几条定理之间。
我们的复现实验验证了这套承诺机制的持久性。在 Little Nell 场景中(见[第 1 篇](https://www.paddysun.top/?p=5118)实验 1),英雄的持续目标是“救出 Nell”:从时间步 1 到 5,agent 持续推进行动,跑向 Nell、到达、抓住、拉离轨道、火车驶过,信念逐步累积,但持续目标始终保持“持续中”状态,没有提前放弃。直到步骤 6,”nell_rescued”进入信念库,PGOAL 的 UNTIL 条件 BEL(x, p) 满足,目标状态翻为“已达成”,意图随之终止。六个时间步的信念演变,把“承诺”两个字从哲学名词变成了可观测的状态机。
围绕这次转移,意图编辑权可以拆成三个层层递进的问题。**做什么**——agent 的目标和计划从何而来,是人预设的还是自主生成的?**何时坚持**——遇到障碍时,谁决定继续坚持还是切换策略?**何时放弃**——agent 在什么条件下可以终止一个意图,谁定义这些条件?在阶段三的谱系里,这三个问题各有归属:C&L 1990 回答了“何时放弃”(二元条件),PRS/dMARS 1987-1998 回答了“做什么”(计划库由人预设,栈调度归 Agent),R&G 1991/1995(盲目/单一心智/开放心智是旋钮)。而当代的 AutoGPT、LangGraph、o1/R1,各自把这三个问题的答案推向了不同的极端。这是后话,先看承诺本身是怎么建造起来的。
## 承诺的建造:从模态算子到数据结构,再到一条没人走通的直线
C&L 的核心策略,是不给意图一个原始模态算子,而用信念(BEL)与目标(GOAL)两个已有算子复合定义意图。定义链有三层(见[第 1 篇](https://www.paddysun.top/?p=5118)):**PGOAL**(持续目标,Definition 3.13,p232)四条件——现在相信 p 为假、目标是将来 p 为真、不相信 p 永不可能、UNTIL 直到相信 p 已真或永不为真才放弃;**DECIDING**(Definition 4.4,p235)——把“做 a”作为持续目标,且此刻尚不相信 a 必将发生;**INTEND**——意图就是“做某行动的持续目标”。承诺性从 PGOAL 的 UNTIL 条件直接继承,不需要额外的承诺算子。
这套定义有一个容易被低估的精妙之处:副作用免疫。C&L 的定理(p240)保证:意图做某行动不蕴涵意图做其全部可预见后果,因为 INTEND = P-GOAL(HAPPENS a),而副作用 B 是另一个不同的命题,两者之间没有逻辑桥梁。复现实验验证了这一点(见[第 1 篇](https://www.paddysun.top/?p=5118)实验 2):agent 意图做 A,信念库中存在“A 的可预见副作用 B”,但意图栈中不出现 do_B(`intentions.contains("do_B")` 返回 `False`)。回头看,这个“不承诺追踪全部后果”的设计,后来被证明是对某个深层难题的结构性防御——本节末尾和自止一节都会回到它。
C&L 给了逻辑底座,PRS/dMARS 给了工程实现,四代演化清晰可辨(见[第 2 篇](https://www.paddysun.top/?p=5122))。**PRS 1987**prs1987:信念库 + 目标 + KA 过程库(调用条件 + 计划体两件式)+ 解释器 + 进程栈;意图是隐式的:“一个进程栈(装有所有当前活跃的 KA),可视为系统当前的意图”,那个“可视为”是关键,意图并非显式存储的数据结构,它只是对运行时进程栈的诠释视角。**R&G 1995**rg1995:抽象解释器四组件(选项生成→慎思→执行→意图处理)+ 三种承诺策略 + 实用化三让步(只存基文字信念、以计划库表示手段、意图隐式表示为计划运行时栈)。**AgentSpeak(L) 1996**agentspeak1996:外部归因,即 BDI 三态度在已实现系统中是数据结构、不是模态算子。**dMARS 1998**dmars1998:计划六组件(调用条件/可选 context/计划体/维护条件/成功内部动作集/失败内部动作集)+ 触发事件四类型 + 六选择函数固化 + 意图显式化 + Z 操作语义。
阶段三由此给出了它的核心分担结构:**计划库由人预设,栈调度归 Agent**。dMARS 规范的原话是:“agent 完全不做第一性原理规划……计划全部由设计者在设计时生成。agent 所做的规划全部是情境敏感的子目标展开,且推迟到子目标被选中执行之时。”计划库是预编译的过程知识,agent 在运行时只做子目标展开,不做从零搜索。这条路线与 STRIPS 分道扬镳strips1972:STRIPS 的规划器从算子库出发做前向搜索,即使没有预存计划也能搜出解;PRS/dMARS 走了相反的路,代价是实时性换覆盖。复现实验把代价量得很准(见[第 2 篇](https://www.paddysun.top/?p=5122)实验 2):触发事件为 `engine_broken`,计划库仅含 `rescue` 计划,无匹配计划,事件在队列中始终未被消费,agent 四个时间步纹丝不动。“不做第一性原理规划”的精确工程含义就是——覆盖盲区即死局,没有兜底的通用规划器。
但四代演化铺了十一年,有一条直线始终没画通。AgentSpeak(L) 的自认写得很直白:**“理论与实践之间仍有巨大鸿沟。主因是定理证明与模型检查的复杂性……因此已实现的 BDI 系统趋于把三大态度作为数据结构而非模态算子来使用。”** 这不是抱怨,而是承认:BDI 工程早已数据结构化(PRS/dMARS 在跑),算不动的是形式语义的定理证明和模型检查。它留下一句被反复引用的“圣杯句”:“BDI agent 研究的圣杯是证明这种一一对应(模型论/证明论/抽象解释器)在一种足够有用且足够有表达力的语言中成立。”三十年来无人完成:C&L 的 INTEND = P-GOAL(HAPPENS a) 是模态算子定义,dMARS 的意图是计划实例序列,两者的语义对应从未被形式化证明;R&G 的承诺策略终止条件是可能世界可达性约束,dMARS 的六选择函数是确定性算法,策略到函数的映射从未被证明保持语义。工程在跑,理论没跟上。
给“什么是 agent”立锚的是 Wooldridge & Jennings 1995wj1995 的双层定义。**弱概念**是行为层面的描述性定义:自主性、社会性、反应性、主动性四性质,不要求任何特定内部结构;**强概念**在四性质之上增加心智状态约束,即用知识、信念、意图、义务来概念化系统。两层之间同样横着一条鸿沟,复现实验踩的就是这条沟(见[第 3 篇](https://www.paddysun.top/?p=5128)失败实验)。agent 的信念库包含 P 和 P_implies_Q,通过分离规则自动推导出 Q,后承数量从 2 涨到 3,这正是可能世界语义下的逻辑全知问题;W&J 讨论的三种补救(Levesque 的显式/隐式信念二分、Konolige 的局部演绎模型、元语言方法)没有一种成为工程标准。
综合线索 A 的四篇工作,意图编辑权的分担结构在阶段三的精确形态如下图:人持有计划库和承诺策略的旋钮,Agent 获得选计划入栈、子目标展开、放弃判定的执行权。
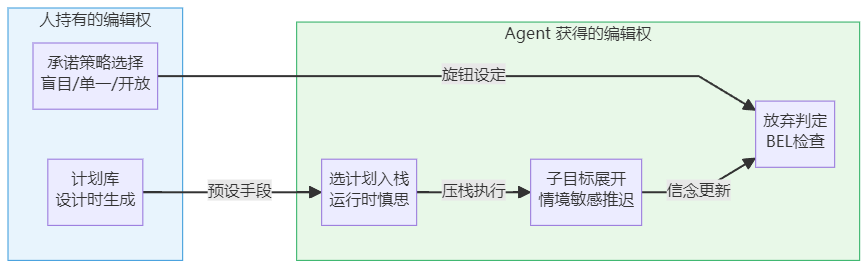
图中那条从 H2 到 A3 的边最值得注意:三种承诺策略是旋钮,控制 agent 在多大程度上容忍世界变化——但旋钮的刻度由人在设计时选定,agent 不能自行切换策略。复现实验把三档旋钮的行为差异量得很清楚(见[第 2 篇](https://www.paddysun.top/?p=5122)实验 1):
策略完成步数t=2 行为切换方式盲目承诺未完成(卡死)步骤失败,不重虑不切换单一心智5 步步骤失败后被动切换被动(失败后)开放心智4 步主动检测 context 失效后切换主动(失败前)
盲目承诺卡死在第 2 步:t=2 到 t=7 反复重试同一失败步骤,这正是 R&G 所说的“仅终止于成功”,过度承诺导致 agent 永远卡死;单一心智损失一个时间步,开放心智再省一步。旋钮的旋向决定了 agent 的自主程度:盲目承诺把编辑权完全交给计划库,开放心智把编辑权部分收回 agent。但请注意边界——agent 获得的是执行期适应权,不是策略选择权。承诺造好了,接下来看它如何被推广成一个社会。
## 社会的扩张与断裂:五步协议、四种仲裁、三个部署,和一门没有语法的语言
1981 年的合同网contractnet把“任务分配”重新表述为“合同协商”,第一次把“社会性”工程化。五步协议(招标→投标→中标→报告→终止)的核心贡献,是论文原话里的那次视角切换:
> “It is useful to adopt the perspective that the messages are statements in a language, rather than, say, patterns to be matched” ——把消息视为语言中的语句,而非待匹配的模式,是有益的。contractnet
角色动态互换是合同网最反直觉的设计:管理者和承包者只是角色,并非固定的节点类型——一个节点可以同时持有多个合同,作为某些任务的管理者、另一些任务的承包者;承包者还可以分解子任务并转包。复现验证了协议五步全程走通(见[第 4 篇](https://www.paddysun.top/?p=5132)实验 1):6 个节点、2 个管理者、4 个承包者,协议在 t=0 即完成全部匹配,14 条消息(2 招标 + 8 投标 + 2 中标 + 2 报告)。但囚徒困境实验(同篇实验 2)揭示了协议的根本局限:局部最优和 1.7 不可达,实际贪心产出 1.1 低于全局最优 1.6。论文自己承认:“最好的全局分配未必来自所有最好局部分配的简单拼接。”
这个缺口在 1988-1990 年被三篇论文从三个方向填补(见[第 5 篇](https://www.paddysun.top/?p=5136)),四种仲裁形态合观如下:
仲裁形态论文谁仲裁依据什么谈崩了怎么办招标裁决合同网 1981管理者裁决投标评估程序无兜底均衡约定Z&R 1989zr1989无外部仲裁者个体效用 + Zeuthen 策略冲突交易兜底第三方效用重写PERSUADER 1988persuader1988调解者(非裁决者)案例先例 + 信念结构 DAG修理准则保证收敛分层行为协调D&M 1990dm1990预设权威值全序行为六维空间区域重叠沿行为维度避让
复现验证了其中的关键机制:PERSUADER 的信念传播路径 `wage_raise → labor_cost → production_cost → employment` 找到支点,工会 wage_raise 重要性 6 < employment 重要性 8,论据成立;Z&R 的 Theorem 9 在混合交易下成立:不存在有利的安全谎言,复现中纯交易下有利谎言存在(True)、混合交易下不存在(False)。但四种形态合观的关键发现是苦涩的:**1990-1995 的实现里,完全不依赖设计期预设的仲裁机制并不存在**,Z&R 预设了效用函数,PERSUADER 预设了信念结构(由两位执业联邦调解人提供),D&M 预设了行为六维。真正的动态仲裁(效用元推理、学习层、动态权威分配)在三篇原文中全部位于 future work。
联合意图理论随后被三个系统带进三种截然不同的部署域(见[第 6 篇](https://www.paddysun.top/?p=5140))。**STEAM 1997**steam1997:直升机仿真 + RoboCup 足球,决策论通信选择性 EV(通信) = λ(1-Pmt)·Cinc vs Cmt。复现中 cautious 队产生 558 条消息(论文基线 538),balanced 队仅 18 条(论文区间 12-26),通信节省 96.8%;加一条终止条件即完成战术修改,通用团队计划零改动。**ARCHON 1995**archon1995:葡萄牙电网(24 座变电站、37 条输电线)+ CERN 加速器(377 块主磁铁),合作层包装遗留系统“无需任何重写”;但协调开销随 agent 数非线性增长,单 agent 纯性能更优,多 agent 的回报在弹性。**OASIS 1992**oasis1992:悉尼机场空管仿真,65 架进场航空器、时间跨度 1.5 小时,PRS 计划库声明式条目:域策略与元级计划同为条目,人类择案、机器生案。三个系统共享一个诚实边界:**“谁写计划库”仍是人工**——系统只负责“如何协调执行”,不负责“知道该做什么”。
社会线最后落到通信。1993-2001 年间,Agent 通信语言经历了从 KQML 到 FIPA 到 JADE 的规范演化(协议层的技术分析见[第 7 篇](blog-07-agents-find-each-other.md))。KQMLkqml1997 的三层分离架构,即消息包(performative + 保留参数)、内容语言(:language)与本体(:ontology),至今仍是 Agent 通信的设计范式,36 个保留 performative 按三类组织:Discourse 18 个、Intervention and Mechanics 7 个、Facilitation and Networking 11 个。FIPA 把 KQML 的单一 facilitator 拆为三个强制组件:AMS(白页 + 生命周期)、ACC(消息路由 + IIOP)、DF(黄页)。JADE 作为 FIPA 合规中间件“处理一切非 agent 内部特有的事务”jade2001,但它对认知内核的态度很明确:“我们产出了一个非常通用但原始的 agent 模型……复杂的 agent 模型如 BDI 和反应式架构可以在我们的‘原始’agent 模型之上实现。”BDI 不是规范内容,不是中间件职责,只是“可以外挂的一种架构”。
然后是断裂。复现直接验证了 KQML 的方言分裂(见[第 7 篇](https://www.paddysun.top/?p=5153)实验 2):方言 A 使用 ask/tell/advertise/broker,方言 B 使用 query/reply/register/recommend,A 向 B 发送 ask,B 理解 False;B 向 A 发送 query,A 理解 False,两个方向都返回 `understood: False`。JADE 1999 首尔互测的失败更深刻:“通过的多数测试”不是全部,失败根源不在 agent 的认知能力,而在 FIPA 规范自身的定义不完整。而 1997 年 2 月的 KQML 修订提案自我声明”This document is not the official new KQML specification”。到 1997 年 KQML 仍无权威定版,FIPA 却已经发布了自己的 ACL 规范;两个标准化努力在同一个时间窗口并行推进,KQML 1997 提案全文无一字提及 FIPA。这是方言分裂的温床。
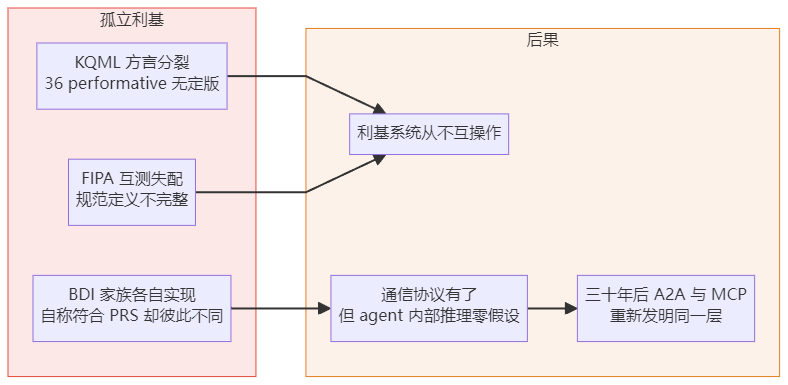
图中右下角那个节点是本节的伏笔:所有系统都跑在孤立的利基中,从未真正互操作。这背后的毛病超出了“规范还不够完善”的级别,是后面 MCP/A2A 一节要宣判的结构性问题。社会线到此扩张到了它的极限:协议齐了,理解没来。
## 设计者手雕的门控:反应与慎思的和解,签在设计时
Brooks 1986 的包容架构留下一道裂缝:如果智能不需要中央表征,那慎思往哪里放?PRS 1987 用计划库和进程栈做了一次折衷,但仍是单一解释器轮转——不是真正的并发架构。1992-1993 年,两篇技术报告给出了两种结构迥异的混合答案(见[第 8 篇](https://www.paddysun.top/?p=5160))。
**TouringMachines 1992(横向并发)**ferguson1992:三层独立连接感知与行动,即反应层 R(硬连线情境-动作)、规划层 P(局部路线规划)、建模层 M(他人意图模型);censor 规则在时间片首过滤感知,suppressor 规则在时间片尾过滤输出,层间无固定压制链,胜负取决于运行时情境。**INTERRaP 1993(纵向分层)**muller1993:四子模块纵向堆叠,即世界接口(独占感知行动)、BBC(反应行为模式)、PBC(局部规划)、CC(联合计划);称职驱动上交,模块自认能力不足时把任务上交给上层。
复现在同一场景下对比了两种架构(见[第 8 篇](https://www.paddysun.top/?p=5160)实验 1),t=4 的复杂冲突(近距障碍物 + 来车)是关键对比点。TouringMachines:R 说“减速备刹”(优先级 5.0),P 被 censor+suppressor 规则屏蔽,M 说“礼让来车”(优先级 6.0),最终 M 胜出,因为设计者给“礼让来车”分配的优先级更高;但规划层被抑制了,负责绕行的 P 被设计者的静态规则关掉了,结果是 agent 礼让来车但不绕行障碍。INTERRaP:BBC 发现有来车、自认不胜任、上交 PBC;PBC 发现有障碍物 + 来车、需要多方协调、上交 CC;CC 制定联合计划“先制动礼让来车再绕行障碍”,两个威胁都被纳入计划。同一情境,两种结局,差别全在仲裁的形状。
把阶段三所有仲裁机制放在一个谱系上,“设计者之手”的痕迹一目了然:
仲裁来源系统何时回到慎思预设程度设计者手工雕琢的 if-thenTouringMachines门控规则预设的情境触发编译时完全固定模块自评称职不足INTERRaPBBC 不胜任时自动上交运行时情境驱动(但判据预设)管理者评估程序合同网投标评估程序裁决设计期预设评估程序协议内生均衡Z&R个体效用计算驱动效用函数预设第三方调解者PERSUADER信念结构 DAG 找支点信念结构预设行为六维空间D&M区域重叠检测六维预设运行时选出权威INTERRaP 跨 agent“选出其中一个 agent 充当调解者”权威值全序预设
谱系的一端是 TouringMachines 的完全编译时固定,另一端是 INTERRaP 的运行时情境驱动。但即使是最动态的 INTERRaP,“什么算不胜任”的判据仍然是设计者编写的。称职驱动比静态门控更动态,但不是真正的动态仲裁。复现补上了最后一钉(见[第 8 篇](https://www.paddysun.top/?p=5160)实验 2):`can_assess_deliberation_need()` 检查 TouringMachines 能否在运行时评估“当前是否应该花更多时间慎思”,8 个时间片全部返回 False;Ferguson 自评“只能算前智能”,把决策论元推理、anytime 算法、第四学习层全部放在 future work。三篇合观(含 D&M)的结论与仲裁一节殊途同归:1990-1995 的实现里,完全不依赖设计期预设的仲裁机制并不存在,彼时通行折衷是“预设减到最少 + 运行时选出权威”(Durfee 权威值全序 → Müller 选举 mediator),真正的动态仲裁全部位于 future work。
反应与慎思和解了,但和约的签署人是设计者,签署时间在设计时。承诺建成了,社会扩张了,门控雕好了——现在可以把整条线放到 BDI 坐标上,看当代的 Agent 们站在哪里。
## BDI 坐标下的拉锯:AutoGPT、LangGraph、Function Calling 与沉入权重的意图
先速写阶段三在 BDI 坐标上的位置:信念是基文字集合,由感知事件触发确定性修订;愿望是外部下发的目标或招标言语行为;意图是可调度的计划栈/意图栈;意图编辑权分担为“计划库人预设 + 栈调度 Agent”;承诺策略是三种旋钮;通信协议是 KQML/FIPA;仲裁机制是四种形态。当代的每一种主流方案,都是在这个坐标系的某个维度上做了极端化。
**AutoGPT 2023-2024 把 C&L 的 DECIDING 推到了极端:愿望→意图整体移交模型。** 用户给一个目标,LLM 自行分解子任务、自行执行、自行评估;没有计划库——“计划”隐含在权重中,由 prompt 触发概率性生成;没有显式承诺策略——README 警告“可能永远跑下去”,终止手段是 Ctrl+C。C&L 形式化承诺的”believes achieved”判断,在 AutoGPT 中完全缺席。对比我们的复现:PGOAL 的 UNTIL 条件在第 6 步触发(nell_rescued 进入信念库),agent 判断目标已达成并终止意图;AutoGPT 没有这个机制——它能持续跑下去不是因为承诺太强,而是因为根本没有放弃条件。这就是本系列开头那个 Ctrl+C 场景的技术解剖。
**LangGraph 2024-2025 把意图的拓扑收回人手。** 显式状态图 + 条件边定义了 agent 行为的完整拓扑结构,节点内“下一步做什么”留给模型,这是“计划库由人预设、栈调度归 Agent”在 LLM 时代的复现。三对映射工整得惊人:BDI 的计划库 = LangGraph 的状态图节点,BDI 的选择函数 = 条件边路由,BDI 的意图栈 = 执行轨迹。差别在于节点内逻辑:dMARS 的计划体是确定性的树,LLM 的节点内推理是概率性的前向传播,条件边与前向传播之间的“语义对应”同样未被证明。BDI 的圣杯在 LLM 时代以新的形式重现。
**Function Calling 把“愿望执行”契约化。** LLM 输出结构化的 function call(名称 + 参数),由外部工具执行并返回结果,这是合同网协议语义的极简版:function call = 招标,工具执行 = 承包,返回结果 = 报告。但合同网的相互选择机制消失了:Function Calling 是单向调用,没有投标评估,没有相互选择。**o1/R1 等推理模型把意图生成沉入权重**:内生思维链在输出可见文本之前已经做了多步内部推理,这更接近 C&L 的 DECIDING 定义(“做 a 的持续目标 + 此刻尚不相信 a 必将发生”);但推理模型的“持续目标”并非显式的 PGOAL 数据结构,只是权重中的概率分布。放弃条件仍然无人定义,推理可以持续到 token 上限,没有“相信已达成”或“相信永不可能”的形式化判断。
当代轴上有两个关键实证,本系列提前引用了第 10 篇的内容。**Dochkina 2026 的 Sequential 协议**dochkina2026:固定排序(人预设骨架)+ 自主角色选择(Agent 填血肉)。复现验证 Sequential 优于 Coordinator +14.5%(论文 +14%)、优于 Shared +43.5%(论文 +44%);能力阈值翻转验证了这一点:能力 0.3 时 Coordinator(0.27) 胜 Sequential(0.18),能力 0.9 时 Sequential(0.61) 胜 Coordinator(0.51)。**BCG 2026 的治理悖论**bcg2026:47% 的用户花在管理 AI 上的时间超过了实际工作的时间,“节省的时间泄漏到了监督工具上”;复现中管理 AI 占比 44.0%(BCG 调查 47%),认知负荷从 4.4 升至 8.9。“重塑岗位快于重塑工作”是意图编辑权分担不彻底的症状:组织在给 AI 分配 title 的速度快于重新设计实际工作流。
于是出现了本文最重要的观察:**三时空同构**。PRS 1987 的“计划库人预设 + 栈调度 Agent”、Dochkina 2026 的“固定排序 + 自主角色选择”、LangGraph 2024-2025 的“状态图人编排 + 节点内 LLM 填充”——三者在不同时代、不同技术基座上独立发现了同一个分担结构:人持有骨架(做什么的拓扑),Agent 填充血肉(如何做的执行细节)。
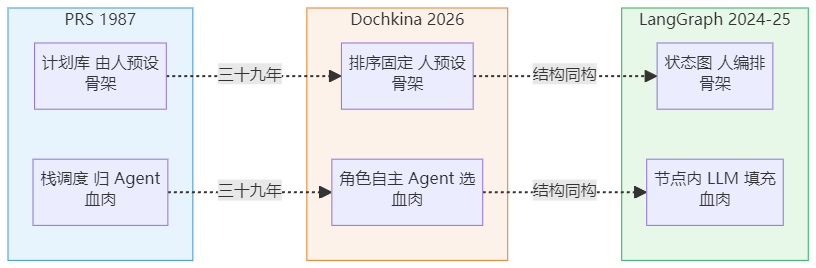
这个同构不是偶然的。[作者判断] 它揭示了一个深层约束:当认知能力(无论是 1987 年的符号推理还是 2026 年的 LLM 前向传播)不足以从零生成完整意图时,最优解总是“人预设骨架 + Agent 填充血肉”。Dochkina 的能力阈值翻转从反面验证了这一点:模型能力低于阈值时,骨架必须变粗(Coordinator 集中分配)、血肉收缩;能力高于阈值时,骨架可以变细(Sequential 固定排序)、血肉扩展。意图编辑权的拉锯并不遵循“越多交给 Agent 越好”的线性逻辑,中间有一个由认知能力决定的相变点。
分担结构中归 Agent 的那一半(运行时慎思)如今也拿到了微观实证。[可引证事实] **2026 新增 A/B 对照实验**(E1,见[第 2 篇](https://www.paddysun.top/?p=5122)实验 3)把 BDI 解释器的计划选择(dMARS 六选择函数的平凡实例 options[0])单组件替换为 LLM 元级慎思:三计划场景(快路过桥 / 高速 3 步 / 省道 5 步,含风暴预报变体)中,20 次独立抽样全部选中理论最优计划、稳定读出 `storm_forecast` 与桥前提的风险关联,20/20 无一失手;基线贪心在 static 场景 4 步、风暴场景 5 步(t=3 桥塌后才被动重虑),被全面击败。慎思侧的元级判断,即 PRS 1987 元级 KA“在多个相关 KA 中择一”的职责,在 LLM 内核在场时确实可以外包,且严格优于平凡实例。
把两个时代放进同一张坐标表,拉锯的全貌如下:
维度阶段三综合阶段六 LLM Agent 2026信念信念库(基文字集)参数统计分布 + RAG + MCP resources愿望外部下发(用户目标/招标言语行为)用户指令 + A2A 任务委派意图可调度的计划栈/意图栈ReAct 循环 + 状态图条件边 + 内生思维链意图编辑权计划库人预设 + 栈调度 Agent骨架人编排 + 血肉模型生成 + 意图沉入权重承诺策略盲目/单一心智/开放心智三种旋钮无显式策略;AutoGPT 无停机机制通信协议KQML 36 performative / FIPA ACLA2A agent card / MCP resource schema仲裁机制四种(招标/均衡/效用重写/终止条件)无标准机制;依赖人工编排当代实证Sequential = 固定排序 + 自主角色(+14.5%)BCG 47% 管理负担 + Dochkina 能力阈值翻转
表格逐行读下来,会发现一个不对称:当代方案在“做什么”和“如何做”上都有答案,唯独“何时放弃”这一行几乎是空的:无显式策略、无停机机制、依赖人工编排。这个不对称值得单独开一节来讲,而且它恰好接上了另一个系列留下的接头。
## 自止:PGOAL 的放弃条件,与阶段二终章的焊接
阶段二的终章在收束全系列时立了一个基础价值观:**Agent 或 LLM 是工具**——人是愿望的来源和存在的意义,工具的意义在于更好地完成人赋予的任务;争论一个工具有没有“意识”没有意义。但终章划出了一个例外:若要 Agent 自主制定工作计划,它需要“自知”(知道自己在做什么)、“自觉”(知道为什么这样做)、“自止”(知道何时该停止)——此时“意识”才有工具性意义。这种意义是工具性的:具备这些能力后,它能更好地完成任务,至于它是否“应该”有意识,无关紧要(见[阶段二终章《从 ELIZA 到 Chollet》](https://www.paddysun.top/archives/5049))。终章的收束判词是:
> “自知,是知道自己的边界;自觉,是理解选择的理由;自止,是懂得停止的时机。” ——阶段二终章《从 ELIZA 到 Chollet》的收束判词
终章同时判定:这三问“不是对‘意识’的哲学追求,而是对‘更好的工具’的工程要求”。但符号单体时代给不出答案:ELIZA、STRIPS、MYCIN 都是技能获取效率为零的先验载体,三问无处安放。它们要等 agent 获得跨时间的承诺结构之后才成为可回答的问题,而这正是阶段三做的事。
把 BDI 三心态对到三问上,对应得近乎工整:
终章三问阶段三的数据结构回答回答的机制自知(知道自己的边界)信念库可检视的世界持有;”意图须与信念一致”的 desiderata 把”知道自己知道什么”变成一致性约束自觉(理解选择的理由)愿望与意图的分离R&G 的意图定义——对”最近一次慎思所选定的行动路线”的承诺(见[第 2 篇](https://www.paddysun.top/?p=5122))——理由(愿望)与执行(意图)分开持有;副作用免疫保证理由不被可预见后果淹没自止(懂得停止的时机)PGOAL 放弃条件 + 三种承诺策略二支放弃条件(相信已达成 ∨ 相信永不可能)是”停止时机”的第一个可判定语义;盲目/单一心智/开放心智是自止权的旋钮
所以可以说:**BDI 是“自知、自觉、自止”三问的第一次数据结构化——而“自止”是其中唯一拿到形式化定义的一问。** 自止的形式化走过一条清晰的谱系,四级台阶一级比一级离逻辑更远:
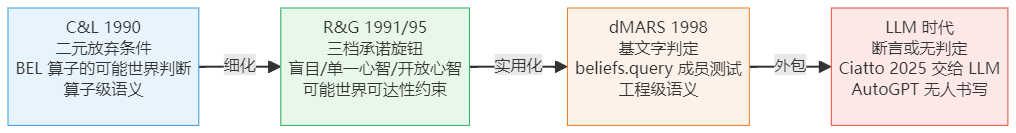
谱系也是一条退化链:从可证明(模态算子有语义),到可运行(成员测试有复杂度保证),到可商量(统计判定随规模衰减)。C&L 给自止的是算子级语义——”believes achieved”是 BEL 算子在无穷可能世界上的模态判断;R&G 把二支细化为三档旋钮;dMARS 降为工程级语义——信念库的基文字成员测试,一次字符串比较;LLM 时代走到第四级——Ciatto 2025 的 GenAI+BDI 把”believes achieved”交给 LLM 断言(见[补篇 C](https://www.paddysun.top/?p=5172)),AutoGPT 干脆无人书写。每退一级,自止的判定就从逻辑义务变成工程惯例,再变成概率习惯。
退化链的末端如今有了 A/B 实测。[可引证事实] **2026 新增 A/B 对照实验**(E2,见[第 1 篇](https://www.paddysun.top/?p=5118)实验 4):把 PGOAL 放弃条件的精确匹配单组件替换为 LLM 判定(Little Nell 剧本不变,第 6 步 nell_rescued 入库,自变量为干扰信念数 K,每配置 10 次独立抽样,视界 T=12)。K≤40 时十次抽样全部第 6 步正确终止,近失里程碑(nell_grabbed、nell_off_tracks、train_passed)无一诱发提前放弃;**K=100 时九成漏终止**——nell_rescued 已经躺在信念库里,统计判定器却在百条无关事实中失焦,直到视界 T=12 仍不敢宣告达成,唯一一次“延迟”也拖到第 10 步;而精确匹配基线在 K=100 下依然第 6 步准时终止。精确匹配与信念库规模无关,语义判定随规模衰减,自止外包给统计直觉的失败不是随机的。
到 LLM 时代,三问的记分牌发生了分化。**自知——近似解决**:上下文窗口 + 系统提示 + 自我描述让 agent“看起来知道自己在做什么”,但“知道自己能力的边界”仍是重灾区:agent 报告的自信与实际成功率之间的系统性错位,是自知之问在 2026 年的形态。**自觉——部分解决**:CoT 与 ReAct 轨迹把理由外显为可读文本,但轨迹中的理由是事后生成的叙事,不是决策的因果记录——读得到不等于靠得住。**自止——未解决**:AutoGPT 无停机机制,o1/R1 推到 token 上限;GenAI+BDI 把”believes achieved”交给 LLM 断言,等于把自止的判定外包给统计直觉,而判定“已达成”所需的前提选择(哪些信念与目标相关),恰是信念库爆炸实验暴露的不可处理问题(见[第 1 篇](https://www.paddysun.top/?p=5118)实验 3:agent 被迫追踪所有可预见后果时,信念库三个时间步从 0 涨到 348)。[作者判断] BCG 的 47% 里有一半是人类在充当 agent 的外挂自止器:打断、审批、Ctrl+C,都是人在替机器行使放弃权。
自止的失守不是随机的,它精确地撞在同一根刺上。E2 的 K=100 失焦与信念库爆炸的 348 条,是同一个问题的两个定量显影:从百条信念中挑出与目标相关的那几条(前提选择),恰是 Bar-Hillel 1958 年批评机器翻译时说的“比演绎更困难”的那个动作(详见下节)。放弃条件的形式化把“停止时机”变成了可判定问题,但判定的执行需要相关性筛选,而相关性筛选没有算法。C&L 的符号查询(精确匹配)是对这个难题的结构性规避,LLM 的语义判定则把它原样请了回来。
现在可以完成这次焊接了。阶段二终章留下三问,阶段三把三问第一次写成了数据结构:信念库给自知、愿望-意图分离给自觉、PGOAL 放弃条件给自止;自止是三问中唯一拿到过形式化定义的一问,也是 LLM 时代唯一失守的一问。终章说三问服务于“更好地完成人赋予的任务”;阶段三的证据把这个说法精确化了一半:自止不需要意识,只需要可判定的数据结构与放弃条件,但信念库爆炸实验表明,只靠数据结构也不够,放弃条件的判定本身撞在前提选择上。本系列的收束判词由此而来:**意图编辑权的拉锯,在终点处的名字就叫“自止”——谁有权写放弃条件,谁就持有最后的编辑权。** 阶段三把这个权柄第一次部分移交(二元约束 + 三旋钮),LLM 时代又把它整体没收(无显式策略),自止因此成为三问中至今无主的一问。
> **编者注**:三问的完整答案大概要等”经验改变系统”的维度打开——按终章引用的 Chollet 框架,那属于技能获取效率的问题,是阶段四(学习与适应)的领地,**不在本系列范围内**。本系列能画出的边界到此为止:自止是被形式化过的一问,也是被退化链磨掉的一问。
## Bar-Hillel 之刺:那条直线没人走通,前提先塌了
Bar-Hillel 1958 年批评机器翻译的核心论点是“前提选择比演绎困难”(见[阶段二《Bar-Hillel 式批评》](https://www.paddysun.top/archives/5039))barhillel。在阶段三的综合视角下,这根刺有一个最直接的投影:**AgentSpeak(L) 自认的圣杯(模型论/证明论/抽象解释器的一一对应)至今未被证明**。C&L 1990 给了逻辑底座,PRS 1987 给了工程实现,R&G 1995 给了形式化框架,dMARS 1998 给了规范,AgentSpeak(L) 1996 给了语言语义,但五者之间的“一一对应”始终悬空。最锋利的一处:C&L 的”believes achieved”是 BEL 算子的可能世界语义——无穷世界的模态判断;dMARS 的“相信已满足”是信念库的基文字检查——有限集合的成员测试。两者之间的直线,三十多年没人画通。
这根刺不挑年代。映射到当代 LLM Agent:LangGraph 用显式状态图 + 条件边把“意图的拓扑”收回人手,节点内留给模型,但条件边是确定性的路由逻辑,LLM 节点内是概率性的前向传播,两者之间的“语义对应”同样未被证明。BDI 的圣杯在 LLM 时代以新的形式重现:状态图的形式语义与 LLM 前向传播的概率语义之间的“一一对应”,依然是一条未被走通的路。回看本系列前八篇,每一篇都承载了这根刺的某个投影:C&L 的 PGOAL 放弃条件隐含了“判断目标已达成需要前提选择”(第 1 篇的信念库爆炸验证);合同网的“诚实投标”预设了未经论证的合作假设(第 4 篇);三种仲裁形态全部依赖设计期预设(第 5 篇);STEAM/ARCHON/OASIS 的“知道该做什么”仍由人类专家填补(第 6 篇);KQML“能找到对方不等于能理解对方”(第 7 篇);TouringMachines/INTERRaP 的仲裁依赖设计者预设(第 8 篇)。
第二根刺扎在网络层:**缺一个能让利基系统互相找到的网络层**。KQML 给了 36 个 performative 和三层分离架构,但没有给出“何时该用 broker 而非 recruit”的选择算法——36 个词是一本精装字典,但没有语法书。FIPA 给了形式语义和三组件,但 JADE 1999 首尔互测仍然失败:“失败取决于 FIPA 规范中一些不完整的定义”。而且这不是一个可以靠“完善规范”解决的问题:即使规范完美无缺,两个 agent 用同一个 cfp 消息通信,它们对 :content 的理解仍取决于各自的认知内核。FIPA ACL 的形式语义(feasibility preconditions + rational effect)只规范了“说这句话在什么条件下是合理的”以及“理性效果是什么”,却不规范“收到这句话后该怎么理解和行动”。JADE 2001 的原话把这层窗户纸捅破了:”a shared communication language is not the only element required to support inter-operability … common agent services and ontologies are also needed.”jade2001 共享通信语言只是互操作的必要条件之一:KQML/FIPA 对 agent 内部推理零假设,语言规范能在没有认知内核时独立完备,这本身是优点(解耦),但也是陷阱,人们会误以为有了通信协议就有了互操作。
两根刺合起来,就是阶段三留给今天的最大缺口:缺口不在技术,在认知。而这个缺口,恰好是三十年后的两份协议重新踩进去的地方。
## MCP 与 A2A 的判决:协议承载接口,不承载内容
三十年后,当代 agent 协议重新面对了同样的问题。A2A(Agent-to-Agent)协议定义了 agent 之间的消息格式和发现机制,其 Agent Card(能力声明 + 发现)在概念上与 KQML 的 advertise + facilitator 同构,但没有可追溯的直接引用链,A2A 的设计者大概率没有读过 Labrou & Finin 1997a2a2025。MCP(Model Context Protocol)定义了 agent 与工具之间的接口,其 Tool Registry 在概念上与 FIPA DF 黄页同构mcp2024。通信从结构化消息退化为自然语言对话:KQML 用 Lisp 语法定义 36 个 performative,Dochkina 2026 用自然语言 prompt 定义角色交换协议;但核心问题不变:**通信协议的选择和中介策略的决策,比消息传递本身难得多**,这正是 Bar-Hillel 之刺在通信层的投影。协议层的完整技术分析见[第 7 篇](https://www.paddysun.top/?p=5153),本节要做的是宣判:同样的概念在 1997 年死了,凭什么 2025 年能活?
先复盘死因。KQML/FIPA 的失败在本系列的证据边界内可归纳为四条:
#死因证据1无权威定版,方言分裂KQML 1997 TR 自认”本文档不是官方的新 KQML 规范”;复现实验直接验证 ask/query 互不认识([第 7 篇](https://www.paddysun.top/?p=5153)实验 2)2规范先行于实现FIPA 1997 先出规范、JADE 1999 才互测,失败归因”规范中一些不完整的定义”——规范完备性成为整个生态的单点瓶颈3语义过重FIPA ACL 给言语行为配形式语义(feasibility preconditions + rational effect)+ 三层本体——但语义只规范”说这句话何时合理”,不规范”收到后如何理解”,重量没换来互操作4内核缺位,协议被迫越位agent 内部没有通用认知内核,KQML 的 36 词表部分是在替”哑 agent”补协调智能;生态无真实商业痛点驱动收敛
(第 3、4 条的因果链为本系列凝练:内核缺位 → 协议上探语义 → 合规负担重 → 实现分化 → 方言分裂。)
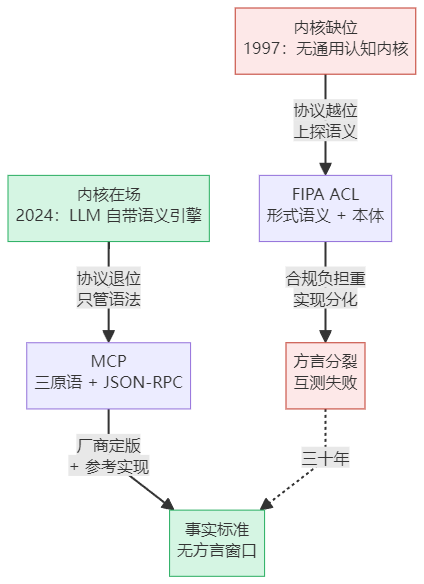
再看 MCP 的活法——四条死因逐条对上。其一,**单一厂商定版,先有代码后有规范**:Anthropic 2024.11 发布即开源,并预置 Google Drive、Slack、GitHub、Git、Postgres、Puppeteer 六个参考实现mcp2024,规范与可运行实现同日存在,不给方言分裂留窗口;随后数月被主要模型厂商相继采纳,事实标准先于任何委员会。其二,**最小内核**:三个原语(tools/resources/prompts,可提供任意子集)、一种消息格式(JSON-RPC 2.0)、两种传输(stdio + Streamable HTTP);对照 FIPA 的三强制组件 + IIOP 绑定 + 交互协议库,MCP 只做了其中一层皮。其三,**只管语法,不管语义**:MCP 不给 tool call 配言语行为语义,没有 feasibility precondition,没有 rational effect;何时调用、结果意味着什么,全部交给模型判断。这是对 FIPA 教训的(大概率无意识的)吸收:FIPA 想用协议内的形式语义弥补认知内核的缺位;MCP 面对的 agent 自带语义引擎(LLM),协议只需做管道。**语义让给模型、协议只管语法,这是 LLM 时代协议设计的第一教训**。其四,**降维的战场**:MCP 先解决 agent-to-tool 的集成痛点,公告原话“每个数据源都需各自定制实现,使互联系统难以扩展”,解法是“以单一协议取代碎片化集成”(”M×N→M+N”是社区凝练而非官方原话)mcp2024;KQML/FIPA 一上来就要做 agent-to-agent 的社会全景,MCP 只做了工具总线——难度降一个维度,痛点却是真实的。
然后是 A2A 的判决——它站在 MCP 验证过的地皮上,但它的脸更像 FIPA。风险面有三处结构相似。其一,多方共治:2025.04 发布即 50+ 伙伴(Atlassian、Salesforce、SAP、PayPal……),随后捐给 Linux Foundationa2a2025,委员会治理回归,版本漂移风险随之回归;微观样本已经出现:Agent Card 的标准发现路径从 0.1 版的 `agent.json` 改为 `/.well-known/agent-card.json`,一次 breaking change 就是一次“无权威定版”的微缩重演。其二,语义鸿沟原样搬运:A2A 规定了 Task 的生命周期与终态(completed/canceled/rejected/failed,不可重启),但“何时算 completed”由远程 agent 自定,这正是 JADE 1999 问题的当代版:格式互通了,理解仍取决于各自的内核,只不过内核从 JESS 换成了 LLM。其三,野心更大:五条设计原则涵盖发现、委派、数小时级长任务、模态无关,比 KQML 的通信词表野心更宽。防护面也有三条:设计原则明言“基于现有标准”(HTTP(S)、JSON-RPC 2.0、SSE、Webhook),不重造 IIOP 式新栈;发布时有真实产品与真实商业需求背书(跨厂商 agent 互操作在 2025 年有真金白银,1997 年没有);且官方明确划界:“MCP 面向 agent-to-tool……A2A 面向 agent-to-agent……不是 MCP 的替代,二者互补”a2a2025,没有重走“一次标准化一切”的老路,至少在口号上。
**判决(本系列凝练):A2A 的生死不在语法层——语法层它已全部做对(最小内核、现有标准、与 MCP 互补);它的生死在于 Agent Card 被当接口还是被当内容。**[作者判断] 给读者一个可检验的观察点:盯住 Agent Card 的 schema 演化方向。卡片持续增肥(能力语义、质量指标、协商规则、领域本体重标准化),就是在重走 FIPA 用协议补偿语义的路;保持瘦卡(身份 + 端点 + 签名)、把细节留给运行时协商(让两端 LLM 用自然语言谈),就守住了“语义让给模型”的边界。发现场景天然存在卡片增肥的压力:要找到“对的 agent”,就想在卡片里写更多信息。这道张力不会自己消失,只能被治理选择压住。
这个判决已有实验支撑。[可引证事实] 把 KQML facilitator 的 performative 精确匹配单组件替换为 LLM matcher(见[第 7 篇](https://www.paddysun.top/?p=5153)实验 3):基线在双域方言场景 0/8 命中(方言分裂一比一复现),LLM matcher 80/80 全对、中介策略选择 7/8 稳定补位(KQML 自认缺失的选择算法),代价是每次判定约 230 tokens 的模型成本。语义让给模型在内核在场时确实可行且强大,但它是用 token 成本和概率性买来的——这正是 FIPA 买不起、MCP 买得起、A2A 必须想清楚自己买不买的那个东西。卡片“内容侧”的代价也有了定量样本(见[第 4 篇](https://www.paddysun.top/?p=5132)实验 3):把合同网的投标自评单组件替换为 LLM 定性自评,120 次自评零高估、一半低估:强项校准良好、弱项被系统性压低,真值 0.2 的兜底能力被自评为 0.05、跌破投标门槛,囚徒困境的全局效用从 1.1 恶化到 0.9。让 LLM 诚实地书写能力语义,它会如实写“几乎做不了”,而任务市场依赖的恰是弱但非零的冗余容量。卡片增肥的压力不止来自“想写更多”,还来自“写得更诚实”也会伤市场深度,这是瘦卡主张没有料到的第二重张力。
用本篇的语言收束:**协议只能承载“意图的接口”(签名、寻址、生命周期),承载不了“意图的内容”(何为完成、何为好的执行)。** KQML/FIPA 死于想让协议承载内容;MCP 活于只做接口;A2A 的 Agent Card 正站在接口与内容的分界线上,而分界线另一侧的那个问题,“何为完成”,上一节已经给出它的名字:自止。
## 谱系与边界:这条线留下了什么,没碰过什么
观点篇的最后义务是把引证强度摊开。阶段三 17 篇原始论文 + 2 篇当代研究的影响分三级,每条附证据。
**强影响(直接继承协议语义或工程实现):**
系统 / 概念年份影响点参考C&L 1990 → PRS/dMARS1987-1998PGOAL 放弃条件 = dMARS 意词语义逻辑底座[第 1 篇](https://www.paddysun.top/?p=5118)合同网 → FIPA cfp1981→1997招标/投标/中标/报告/终止 = FIPA 五种言语行为[FIPA](https://fipa.org/specs/fipa00026/)KQML → FIPA ACL 语法1993→1997JADE 原话”ACL syntax is very close to KQML”[JADE](https://doi.org/10.1002/spe.420)STEAM → JACK Teams1997→2000s团队算子和联合意图语义直接商业化[JACK](https://aosgrp.com/products/jack/)Dochkina Sequential → 验证 PRS 分担结构2026+14.5% 证明”计划库人预设+栈调度Agent”在 LLM 时代仍最优[arXiv](https://arxiv.org/abs/2603.28990)
**中强影响(概念延续与超越):**
概念路径年份影响点参考R&G 三种承诺策略 → 当代 Agent 设计1991/1995盲目/单一/开放旋钮是承诺理论的工程原语[KR&R-91](https://doi.org/10.1016/0743-1066%2891%2990040-J)ARCHON 包装遗留系统 → MCP 包装 API1995→2024“无需重写”的包装模式同构[MCP](https://modelcontextprotocol.io/)KQML advertise → A2A Agent Card1997→2025能力声明+发现机制概念同构(无直接引用链)[第 7 篇](https://www.paddysun.top/?p=5153)TouringMachines/INTERRaP → LangGraph 状态图1992→2024横向/纵向分层概念平行于状态图分层[LangGraph](https://langchain-ai.github.io/langgraph/)BCG 47% → 意图编辑权治理实证2026管理负担=人持有编辑权但被压垮[BCG](https://www.bcg.com/)
**中等影响(概念启发,无直接因果链):**
概念路径年份影响点参考合同网囚徒困境 → 多 Agent 协调研究1981“局部最优≠全局最优”成为 MAS 经典问题[第 4 篇](https://www.paddysun.top/?p=5132)W&J 弱概念四性质 → LLM Agent 定义1995行为层定义概念传承,无直接引用[第 3 篇](https://www.paddysun.top/?p=5128)AgentSpeak(L) 外部归因 → LLM 意图诠释1996“数据结构而非模态算子”在 LLM 中重现[第 2 篇](https://www.paddysun.top/?p=5122)Z&R 均衡约定 → 机制设计1989博弈论协商路线影响后续 MAS 机制设计[IJCAI-89](https://doi.org/10.1016/B978-0-934613-85-5.50142-X)
同样重要的是另一张清单:阶段三没有直接影响到什么。**统计学习路线**:BDI 的信念库是基文字集合、由感知事件触发确定性修订,强化学习的“信念”是值函数或策略分布、由奖励信号统计更新,两者没有概念桥梁;BDI 的承诺策略在 RL 中对应探索-利用策略,但分属不同方法论传统。**LLM 的 prompt 内推理**:BDI 的计划库是预编译的显式过程知识、触发匹配是字符串比较,LLM 的“计划”隐含在权重中、由 prompt 触发概率性生成。**Transformer 架构**:注意力机制与言语行为理论无关联,KQML/FIPA 的 Lisp 语法与 JSON Schema 无技术继承关系。**LLM Agent 的 prompt 工程**:C&L 的形式化需要显式算子和可能世界语义,LLM Agent 没有这些结构,意图退化为 ReAct 循环的 action 序列,放弃条件无人定义。
剥掉直接引用链之后,阶段三留下的是两个结构性遗产。第一个是**意图编辑权的分担结构**:它不以引用链的方式影响当代(LangGraph 的设计者大概率没读过 dMARS 规范),但分担结构本身被独立重新发现(三时空同构),且被 Dochkina 的大规模实验证明在 LLM 时代依然是最优解,前提是模型能力跨过阈值。第二个是**通信协议的形式化范式**:从合同网的五步协议到 KQML 的 36 performative 到 FIPA 的三组件。没有人再用 Lisp 语法写 KQML 消息,但 A2A 的 Agent Card 是 KQML advertise 的重发明,MCP 的 Tool Registry 是 FIPA DF 黄页的重发明。
最后是诚实边界的当代投影。阶段三留给今天的最大缺口不在技术,在认知:**AgentSpeak(L) 自认的圣杯在 LLM 时代以新的形式重现**,BDI 的形式语义与 LLM 前向传播的概率语义之间的“一一对应”未被证明,就像 C&L 的模态算子与 dMARS 的数据结构之间的对应未被证明。Dochkina 的能力阈值翻转和 BCG 的 47% 合观,给出了这个缺口的当代投影:**瓶颈不在 AI 能否自组织(Dochkina 证明可以),而在人的组织形式能否适配 AI 的自组织(BCG 证明还没有)**。管理 AI 的认知负荷,本质是人试图理解 LLM 生成的不透明意图的成本;前提选择比演绎困难,在治理层面,“这个 agent 为什么选了这个角色”比执行这个角色本身更耗认知。这场从 1958 年打到 2026 年的拉锯,全景如下:
回到开头的那个场景:2023 年的用户按下 Ctrl+C 时,他行使的正是 McCarthy 1958 年代由人独占、C&L 1990 年代部分移交、AutoGPT 年代又被整体没收的那项权力——自止。七十年拉锯,三个问题里两个有了工程答案(做什么:骨架人预设血肉模型填;如何做:E1 证明慎思可外包),唯独“何时放弃”从形式化的顶点一路退化成没人认领的空白。谁有权写放弃条件,谁就持有最后的编辑权。这是本系列八篇历史加一篇实证浓缩出来的一句话。下一篇文章将给出这句判词的当代证据:25,000 次任务、8 个模型的大规模验证,以及那个管理时间超过工作时间的治理悖论。
## 参考文献
[**cl1990**] Cohen, P. R. & Levesque, H. J. “Intention Is Choice with Commitment.” *Artificial Intelligence*, 42(3): 213-261, 1990. 详见 [第 1 篇](https://www.paddysun.top/?p=5118)。
[**prs1987**] Georgeff, M. P. & Lansky, A. L. “Procedural Reasoning.” In *Proc. AAAI-87*, pp. 677-682, 1987. 详见 [第 2 篇](https://www.paddysun.top/?p=5122)。
[**rg1995**] Rao, A. S. & Georgeff, M. P. “BDI Agents: From Theoretical Foundations to Practical Applications.” Technical Note 56, 1995; also in *Proc. ICMAS-95*. 详见 [第](blog-02-bdi-theory-to-engineering.md)[2 篇](https://www.paddysun.top/?p=5122)。
[**dmars1998**] d’Inverno, M., Kinny, D., Luck, M. & Wooldridge, M. “A Formal Specification of dMARS.” In *Intelligent Agents IV* (ATAL-4), LNAI 1365: 155-176, Springer, 1998. 详见 [第 2 篇](https://www.paddysun.top/?p=5122)。
[**agentspeak1996**] Rao, A. S. “AgentSpeak(L): BDI Agents Speak Out in a Logical Computable Language.” In *Proc. MAAMAW’96*, LNAI 1038: 42-55, Springer, 1996. 详见 [第 2 篇](https://www.paddysun.top/?p=5122)。
[**wj1995**] Wooldridge, M. & Jennings, N. R. “Intelligent Agents: Theory and Practice.” *The Knowledge Engineering Review*, 10(2): 115-152, 1995. 详见 [第 3 篇](https://www.paddysun.top/?p=5128)。
[**contractnet**] Davis, R. & Smith, R. G. “Negotiation as a Metaphor for Distributed Problem Solving.” MIT AI Memo No. 624, May 1981. 详见 [第 4 篇](https://www.paddysun.top/?p=5132)。
[**zr1989**] Zlotkin, G. & Rosenschein, J.S. “Negotiation and Task Sharing Among Autonomous Agents in Cooperative Domains.” *IJCAI-89*, pp. 912-917. 详见 [第 5 篇](https://www.paddysun.top/?p=5136)。
[**persuader1988**] Sycara, K. “Resolving Goal Conflicts via Negotiation.” *AAAI-88*, pp. 245-250. 详见 [第 5 篇](https://www.paddysun.top/?p=5136)。
[**dm1990**] Durfee, E.H. & Montgomery, T.A. “A Hierarchical Protocol for Coordinating Multiagent Behavior.” *AAAI-90*, pp. 86-93. 详见 [第 5 篇](https://www.paddysun.top/?p=5136)。
[**steam1997**] Tambe, M. “STEAM: Towards Flexible Teamwork.” *Journal of AI Research* 7: 83-124, 1997. 详见 [第 6 篇](https://www.paddysun.top/?p=5140)。
[**archon1995**] Jennings, N. R. “Controlling Cooperative Problem Solving in Multi-Agent Systems.” *Artificial Intelligence* 75(2): 195-240, 1995. 详见 [第 6 篇](https://www.paddysun.top/?p=5140)。
[**oasis1992**] Ljungberg, L. & Lucas, A. “The OASIS Air Traffic Flow Management System.” AAII Technical Note 28, Melbourne, 1992. 详见 [第 6 篇](https://www.paddysun.top/?p=5140)。
[**kqml1997**] Labrou, Y. and Finin, T. “A Proposal for a new KQML Specification.” UMBC Technical Report TR CS-97-03, 1997. 详见 [第 7 篇](https://www.paddysun.top/?p=5153)。
[**jade2001**] Bellifemine, F., Poggi, A. and Rimassa, G. “Developing multi-agent systems with a FIPA-compliant agent framework.” *Software: Practice and Experience*, 31(2):103-128, 2001. 详见 [第 7 篇](https://www.paddysun.top/?p=5153)。
[**ferguson1992**] Ferguson, I. A. “TouringMachines: An Architecture for Dynamic, Rational, Embedded Agents.” Technical Report UCAM-CL-TR-273, University of Cambridge, 1992. 详见 [第 8 篇](https://www.paddysun.top/?p=5160)。
[**muller1993**] Müller, J. P. & Pischel, M. “INTERRaP: An Architecture for Behavior-Based Agents.” DFKI Research Report, 1993. 详见 [第 8 篇](https://www.paddysun.top/?p=5160)。
[**dochkina2026**] Dochkina, V. “Drop the Hierarchy and Roles: How Self-Organizing LLM Agents Outperform Designed Structures.” arXiv:2603.28990, March 2026. 详见 [第 10 篇](https://www.paddysun.top/?p=5167)。
[**bcg2026**] BCG. “AI at Work 2026: Strategy Matters More Than Tools.” Boston Consulting Group, June 3, 2026. 详见 [第 10 篇](https://www.paddysun.top/?p=5167)。
[**mcp2024**] Anthropic. “Introducing the Model Context Protocol.” 2024.11 发布,开源规范,预置六个参考服务器(Google Drive、Slack、GitHub、Git、Postgres、Puppeteer). [https://modelcontextprotocol.io](https://modelcontextprotocol.io/) (存档 `原始文章\07a-MCP-Spec.md`;”M×N→M+N”系社区凝练,官方原话为”以单一协议取代碎片化集成”)
[**a2a2025**] Google → Linux Foundation. “Agent2Agent (A2A) Protocol.” 2025.04.09 Cloud Next ’25 发布(50+ 伙伴),2025 年中捐 Linux Foundation. [https://a2a-protocol.org](https://a2a-protocol.org/) (存档 `原始文章\07b-A2A-Spec.md`;Agent Card 现行标准路径为 `/.well-known/agent-card.json`,`agent.json` 为 0.1 版旧路径)
[**bratman1987**] Bratman, M. E. *Intention, Plans, and Practical Reason.* Harvard University Press, 1987. C&L 论文中引文 [8]。
[**barhillel**] Bar-Hillel 对形式系统前提选择难题的批评,见 [阶段二《Bar-Hillel 式批评》](https://www.paddysun.top/archives/5039)。
[**mccarthy1958**] McCarthy 的 Advice Taker 愿景,见 [阶段二《McCarthy Advice Taker》](https://www.paddysun.top/?p=4958)。
[**strips1972**] Fikes & Nilsson 的 STRIPS 感知-规划-执行闭环,见 [阶段二《STRIPS》](https://www.paddysun.top/archives/4968)。
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 25,000 次任务实测:多 Agent 协作协议质量排序与治理悖论
https://www.paddysun.top/archives/5167 · 2026-09-02
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 10 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [意图编辑权](https://www.paddysun.top/?p=5160) **阅读时间**:约 17 分钟
---
# 自组织的实证与治理悖论:智能体已学会自己组队,人还没学会怎么放手
2026 年上半年出现了两份表面上毫不相干的文件。3 月,莫斯科物理技术学院(MIPT)的 Victoria Dochkina 在 arXiv 上传了一篇大规模计算实验论文,标题挑衅性十足——”Drop the Hierarchy and Roles”(丢掉层级和角色)dochkina2026。6 月 3 日,波士顿咨询集团(BCG)发布了第四年度 AI 职场调查,标题是 “AI at Work 2026: Strategy Matters More Than Tools”,覆盖 14 个国家、11,749 名受访者bcg2026。一份来自实验室,一份来自写字楼;一份测的是 LLM 智能体群,一份问的是人类员工;一份用了两万五千次任务运行,一份用了四年的纵向追踪。
但它们在回答同一个问题的两面:**当智能体的集体智慧超过个体时,组织结构到底是助力还是阻力?** Dochkina 的答案落在 AI 侧:把层级和预设角色丢掉,足够强的模型会自己长出组织来,而且比任何人工设计的结构都好。BCG 的答案落在人侧:**47% 的用户花在管理 AI 上的时间超过了实际工作的时间**,AI 变强了,人却被管理工作压弯了腰。两份文件合在一起,拼出一个不对称的判断:AI 侧的自组织已经可行,人侧的组织形式还没跟上。
这是本系列正编的最后一篇。从 Cohen & Levesque 的意图形式化出发,我们走过了合同网的招标、三种仲裁的冲突消解、STEAM 与 ARCHON 的联合意图部署、KQML/FIPA 的通信标准化、反应与慎思的和解,以及意图编辑权的三时空拉锯。这篇文章用 2026 年的两份文件给这四条线收口:当年那些没有实证检验的组织设计,如今在两万五千次任务运行里得到了第一批大规模数据,而数据告诉我们的,既有“历史是对的”,也有“历史没料到的”。
## 两万五千个任务、八个模型:一次没有先例的实验
先看 Dochkina 这篇论文的实验规模,因为它在多 Agent LLM 系统的研究中尚无先例:
维度规模任务运行**25,000+ 次**,覆盖 20,810 种独特配置模型**8 个 LLM**:闭源 Claude Sonnet 4.6、GPT-5.4、GPT-4o、GPT-4.1-mini、Gemini-3-flash、GigaChat 2 Max;开源 DeepSeek v3.2、GLM-5系统规模**4 到 256 个 agent**协调协议**8 种**,从集中式(Coordinator)到完全自主(Shared)任务复杂度**4 级**(L1–L4),从单领域到对抗性多利益方
任务复杂度的四级分类值得展开:L1 是单领域任务(1 个领域,3-5 步,无依赖),L2 是跨领域任务(2 个领域,5-10 步,需要知识整合),L3 是多阶段任务(3 个以上领域,10-20 步,顺序依赖),L4 是对抗性任务(3 个以上领域,利益冲突,无单一正确答案)。这个分级本身就是对真实工作的一次诚实建模:它承认不是所有任务都有标准答案。
> **编者注**:模型名单里的 GLM-5 属于开源阵营,与撰写本系列所用的模型同族。论文报告它与其他开源模型一起达到了闭源模型约 95% 的质量——这个细节在下文讨论成本结构时会再回来。
论文的第一句话就划定了立场。原文写道:
> “AI agents need three things to self-organize—and none of them is a pre-assigned role. Given a mission, a communication protocol, and a sufficiently capable model, groups of LLM-based agents spontaneously form organizational structures, invent specialized roles, and voluntarily abstain from tasks outside their competence.” ——AI 智能体自组织需要三样东西,而其中没有一样是预先分配的角色。给定一个使命、一个通信协议和一个足够强的模型,LLA 智能体群会自发形成组织结构、发明专业化角色,并主动回避超出自身能力的任务。dochkina2026
三要素分别是:**使命**(mission)定义要做什么,**通信协议**(communication protocol)定义如何交互,**足够强的模型**(sufficiently capable model)提供认知能力。三者的交集产生自组织,缺一不可——去掉强模型,自组织逆转为刚性结构;去掉对的协议,最强的模型也会低效。
熟悉本系列历史的读者会在这里听到回声。合同网的 Davis 和 Smith 在 1981 年就写过:
> “cooperation cannot be established between nodes simply by indicating how they are to communicate; we must also indicate what they should say to each other” ——仅仅指明节点之间如何通信,并不能建立协作;我们还必须指明它们彼此应该说些什么。contractnet
这就是 Dochkina 三要素中的“通信协议”。KQML/FIPA 后来把通信协议形式化为 36 个 performative 和 AMS/ACC/DF 三件套([智能体如何找到彼此](https://www.paddysun.top/?p=5153)),而 Dochkina 的“通信协议”是这条线的当代延续,只是形式从消息级降到了 prompt 级。45 年过去,“协议先于角色”这个判断从工程直觉变成了一组带 p 值的实验结果。
## 八种协议:从外部指挥到完全自主的光谱
Dochkina 区分了外源协调(exogenous,结构由外部强加)和内源协调(endogenous,结构从系统内部涌现)。她的 8 种协议铺在这条光谱上,其中四种主要协议构成骨架:
协议性质机制LLM 调用Coordinator集中式(外源)Agent 0 分析任务后分配角色给所有其他 agent,并行执行1+NSequential混合(半外源半内源)固定顺序,每个 agent 观察前驱输出后自主选择角色NBroadcast信号式(内源)两轮:先广播角色意图,再基于意图做最终决策2NShared完全自主(内源)共享组织记忆 + 同时独立决策N
为了把这套光谱拿到手里掂量,我们把它做成了纯 Python 模拟:标准库、零外部依赖,完整代码在 \`../self-organization-reproduction/\` 目录下。三个模块各管一段:
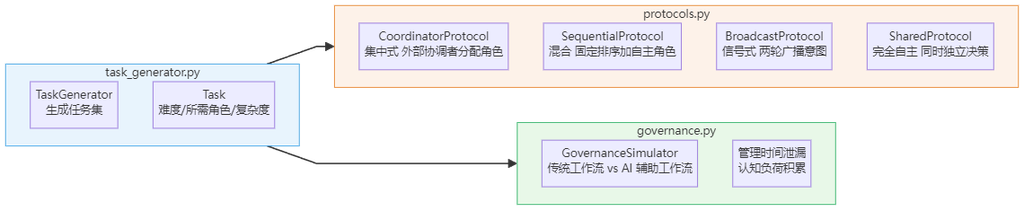
每种协议的质量得分由三个因素决定:基线质量(由模型能力决定,协议提供不同系数)、协议特定的奖励/惩罚(Sequential 的顺序累积 bonus、Shared 的冲突惩罚等)、任务难度(0.6-1.0 的随机值,作为质量乘数)。所有协议共享同一个随机种子(`random.Random(42)`)和同一份任务集,所以下文的质量差异来自协议结构本身,不来自运气。
先看光谱最外端的 Coordinator。它的质量模型浓缩在 `protocols.py` 的四行核心里:
```
base = model_capability * 0.55 + 0.20 # 结构地板:再弱的模型也有基线保障
centralization_overhead = 0.08 # 集中化开销
variation = rng.uniform(-0.03, 0.03) # 任务级扰动
quality = (base + variation) * (1 - centralization_overhead) * task.difficulty
```
这四行刻画了集中式协调的全部性格:结构提供 0.20 的地板——弱模型也能拿到保底质量;但信息瓶颈把准确度系数压到 0.55,集中化再扣掉 8%,而且没有任何适应性——协调者做完分配就撒手,不能根据中间结果调整。这是合同网式集中仲裁在数学上的样子:稳,但钝。
再看光谱中间的 Sequential——整篇论文的核心协议,也是核心发现的载体:
```
base = model_capability * 0.55 + 0.15 # 骨架地板略低于 Coordinator
threshold = 0.5 # 能力阈值
if model_capability >= threshold:
bonus = 0.35 * (model_capability - threshold) # 阈值以上:顺序累积增值
else:
bonus = -0.40 * (threshold - model_capability) # 阈值以下:误选叠加惩罚
overhead = 0.03 # 仅固定排序,开销全场最低
quality = (base + bonus + variation) * (1 - overhead) * task.difficulty
```
这八行是整篇论文最锋利发现的浓缩:**自主性本身既不是资产也不是负债,它的符号由模型能力决定**。排序是外源的(人预设骨架),角色选择是内源的(Agent 填血肉);能力跨过 0.5 的阈值,前驱输出就成了后来者脚下的台阶;能力跌破阈值,同样的前驱输出就成了错误叠加的传送带:每个 agent 在前驱的错误上再添一笔自己的错误。
## 结果:既不是最强的控制,也不是最大的自由
跑一遍模拟(Python 3.14.6,`main.py` 实验 1,8 个 agent、能力 0.8、100 个任务),四种协议的质量排序出来了:
```
============================================================
实验1:内源性悖论(Dochkina 2026)
============================================================
Coordinator(集中): 质量得分=0.47
Sequential(混合): 质量得分=0.54
Broadcast(信号): 质量得分=0.43
Shared(自主): 质量得分=0.37
Sequential vs Coordinator: +14.5% (预期 +14%)
Sequential vs Shared: +43.5% (预期 +44%)
```
排序是 **Sequential > Coordinator > Broadcast > Shared**——混合协议赢了两个极端。与论文报告的数字对齐:
对比复现结果论文结果Sequential vs Coordinator+14.5%+14%(p<0.001)Sequential vs Shared+43.5%+44%(Cohen’s d=1.86,p<0.0001)
这就是 Dochkina 命名的**内源性悖论**(endogeneity paradox):最大的外部控制(Coordinator)不行,最大的 agent 自主权(Shared)也不行,能产生最优结果的是两者的特定混合。固定排序提供最小骨架,自主角色选择提供最大血肉;骨架让 agent 有序,血肉让 agent 适应。Cohen’s d=1.86 是一个接近天花板的效果量——协议选择的差异不是统计噪声,是主导变量。
论文给出的比喻值得全文引用:
> “The protocol unlocks the model’s potential, like sheet music unlocks an orchestra; but an orchestra of beginners (weak models) plays better with a conductor than without one.” ——协议释放模型的潜力,就像乐谱释放交响乐团的潜力;但一支由初学者(弱模型)组成的乐团,有指挥比没有指挥更好。dochkina2026
这句话的后半句,正是下一个实验的全部剧情。
## 能力阈值翻转:给弱模型自由,不如给弱模型指挥
把模型能力从 0.3 扫到 0.9(`main.py` 实验 2,50 个任务),乐谱悖论显形了:
```
============================================================
实验2:能力阈值翻转
============================================================
能力 | Coordinator | Sequential | Shared
------------------------------------------------------------
0.3 | 0.27 | 0.18 | 0.00
0.5 | 0.35 | 0.33 | 0.06
0.7 | 0.43 | 0.47 | 0.27
0.9 | 0.51 | 0.61 | 0.48
>> 弱模型(cap<0.5)下 Coordinator 反超 Sequential 和 Shared
>> 原话: 乐谱能释放交响乐团的潜力,但初学者乐队有个指挥比没有更好
```
整理成对照表,翻转点清晰可见:
能力CoordinatorSequential翻转?0.3**0.27**0.18Coordinator 胜0.5**0.35**0.33Coordinator 胜0.70.43**0.47**Sequential 胜0.90.51**0.61**Sequential 胜
**能力阈值翻转**(capability threshold reversal):阈值落在 0.5 和 0.7 之间。在此以下,Coordinator 的刚性结构优于 Sequential 的自主选择;在此以上,Sequential 的自主适应加顺序累积反超。Shared 在所有能力水平下都最差或接近最差:完全自主的冲突惩罚过于严重,多个 agent 同时抢同一个角色,没有任何机制告诉它们“让一让”。论文将此发现跨闭源和开源模型验证,确立了一个可复现的能力阈值,低于该阈值时自组织逆转。
这是论文自身最锋利的自我批评:**自组织不是免费午餐**。它有一个隐含前提——AI 的能力必须跨过阈值。在阈值以下,旧有的层级结构就是必需,谈不上悖论。任何“AI 智慧超过用户时层级结构是灾难”的判断,都默认了这道门槛已经迈过;对今天的多数模型和多数任务,这个默认未必成立。
### 五千个角色与两百次弃权:涌现不是修辞
阈值以上,自组织长什么样?Dochkina 记录了三种涌现现象。其一是**动态角色发明**:8 个 agent 在 25,000 个任务中自发生成了 **5,006 个独特角色**——没有任何角色是预先分配的,全部由 agent 在运行中根据任务需求和前驱输出自主发明。其二是**自愿弃权**(voluntary self-abstention):agent 在判断自己的能力不足以贡献时会主动放弃参与。这不是失败,而是自组织系统的自我调节。其三是**自发层级形成**(spontaneous hierarchy formation):某些 agent 通过观察前驱输出,自发承担了协调角色,形成浅层层级。
我们的模拟复现了这三种现象(`main.py` 实验 3,200 个任务)。角色发明的机制在 `protocols.py` 里只有三行:
```
def _invent_role(rng):
"""生成一个涌现角色名(形容词 + 名词)。"""
return f"{rng.choice(_ROLE_ADJECTIVES)}_{rng.choice(_ROLE_NOUNS)}"
```
运行输出:
```
============================================================
实验3:涌现角色统计
============================================================
Agent 数: 8
涌现独特角色数: 220 (预期 ~5006)
自愿弃权次数: 205
自发层级深度: 3
>> 角色自发涌现——无预设角色,agent 自行发明专业化角色
```
220 个独特角色对论文的 5,006 个:这是 200 任务对 25,000 任务的等比例缩放(200/25000 = 0.8%,5,006 × 0.8% ≈ 40;我们的 220 高于此比例,因为模拟中涌现角色的生成概率设置得略高,以保证在 200 任务规模下统计可见)。关键的定性发现一致:**角色是自发涌现的,不是预设的**。205 次自愿弃权和深度 3 的自发层级,也印证了论文描述的另外两种涌现现象。
### 从 4 个到 256 个:亚线性扩展与开源追赶
Dochkina 还证明了系统从 4 个 agent 扩展到 256 个 agent 时质量没有显著下降(p=0.61)。这个数字需要放在坐标系里看:此前多 Agent 系统的规模上限,ChatDev 是 6 个 agent,MetaGPT 最多 8 个,AgentVerse 最多 5 个。256 无质量下降,意味着协调开销第一次呈现出亚线性。
这与 [联合意图部署](https://www.paddysun.top/?p=5140) 中 ARCHON 的遭遇形成直接对照。ARCHON 在真实电力系统和 CERN 部署中遇到的“协调开销随 agent 数非线性增长”的瓶颈,被 Dochkina 的亚线性扩展超越,但前提是模型能力跨过阈值。回头看来,ARCHON 的困难本质上是一个“弱模型”问题:电力系统 agent 的推理能力远低于 LLM,能力阈值翻转从理论层面解释了 1990 年代的实践困难——当年不是协议设计得不好,是内核不够强,乐谱给了也读不下来。
最后一个关键发现是开源模型的追赶:DeepSeek v3.2 和 GLM-5 等开源模型达到了闭源模型 95% 的质量,但成本仅为其 1/24。自组织多 Agent 系统不再是闭源模型的专利:按 token 计价的“理解成本”([智能体如何找到彼此](https://www.paddysun.top/?p=5153) 里那个昂贵的回应),在开源侧已经降到可以批量部署的水位。
## 治理悖论:管理 AI 的时间比干活还多
现在切到另一份文件。BCG 2026 年 6 月的调查里最引人注目的数字,正是本文开头那个:**47% 的用户花在管理 AI 上的时间超过了实际工作的时间**。报告原文的措辞是——”saved time leaked into supervision tools”,节省的时间泄漏到了监督工具上。AI 本应节省时间,但节省的时间被管理 AI 的工作消耗了;用户没有变得更自由,而是从“做工作的人”变成了“管理 AI 做工作的人”。
第二个数字是 **41% 的用户报告了更高的认知负荷**。BCG 将此称为”Joy Paradox”(快乐悖论):时间被节省了,但脑力更累。原因不难列举:管理 AI 比做实际工作更耗认知。你需要写精确的 prompt、审查 AI 输出的正确性、在不同工具间切换上下文、纠正 AI 的错误、理解 AI 生成的不透明内容。
我们把这个悖论也做成了模拟(`governance.py` 中的 `GovernanceSimulator`,对比传统工作流和 AI 辅助工作流各 20 个工作日)。时间泄漏的机制浓缩在四行代码里:
```
ai_efficiency = rng.uniform(0.43, 0.51) # AI 效率,均值 ~47%
theoretical_saved = self.hours_per_day * ai_efficiency
leak_rate = rng.uniform(0.90, 0.98) # 泄漏率,均值 ~95%
daily_mgmt = theoretical_saved * leak_rate # 节省的时间泄漏到管理
```
认知负荷的积累同样只有几行——注意那个 1.8 倍的管理密度系数,它是 Joy Paradox 的全部来源:
```
mgmt_density = 1.8 # 每小时管理 AI 的认知负荷 = 1.8 倍每小时工作
ai_load = (daily_mgmt / self.hours_per_day) * mgmt_density * 5.0
switching_penalty = rng.uniform(0.3, 0.6) # 上下文切换惩罚
daily_load = base_load + ai_load + switching_penalty
```
运行 `main.py` 实验 4 的输出:
```
============================================================
实验4:BCG 2026 治理悖论
============================================================
传统工作流:
工作时间: 143.6h
管理AI时间: 16.4h
认知负荷: 4.4/10
AI 辅助工作流:
实际工作时间: 89.6h
管理AI时间: 70.4h
认知负荷: 8.9/10
管理AI占比: 44.0% (BCG调查: 47%)
>> 节省的时间泄漏到了监督工具上
>> Joy Paradox: 时间被节省但脑力更累
```
四个数字讲完整个故事:工作时间从 143.6h 降到 89.6h——AI 确实省时间;管理时间从 16.4h 涨到 70.4h,但省下的时间几乎全部漏进了监督;管理占比 44.0%,逼近 BCG 调查的 47%;认知负荷从 4.4 升到 8.9,时间被节省,脑力翻倍地累。
### 策略大于工具:二十五个百分点对五个百分点
BCG 的第三个发现是对“工具主义”的直接反驳:拥有清晰 AI 策略的公司,业务影响提升约 25 个百分点(pp);而仅仅使用更好工具的公司,业务影响仅提升约 5pp。**策略的杠杆是工具的 5 倍**。这与 Dochkina 的发现形成共振——Dochkina 证明协议选择带来 44% 的质量差异,模型选择只带来约 14%。两份文献从实验室和职场两个方向指向同一个结论:**怎么组织比用什么更重要**。
第四个发现紧随其后:重新设计了工作流的公司,比单纯部署工具的公司,业务改善高 24 个百分点。这直接呼应 Sequential 协议的成功配方——“最小骨架 + 最大血肉”本身就是一种工作流重设计:固定排序(骨架)让 agent 有序,自主角色选择(血肉)让 agent 适应。BCG 的 24pp 红利和 Dochkina 的 +14% 优势,是同一个结构原理在两个世界里的投影。
### 岗位 title 跑在了工作流前面
BCG 报告最尖锐的观察是:**组织在重塑岗位 title 的速度快于重塑实际工作流**。公司给 AI 分配了“AI 经理”“AI 总监”的头衔,但没有重新设计工作流,人还在用旧有的组织形式管理新的智能体。用本系列的语言说,这正是意图编辑权分担不彻底的症状:编辑权的名义归属更新了,实际的分担结构还停在旧组织里。
## 不对称的结论:AI 侧可行,人侧没跟上
现在可以把两份文件放到同一张桌子上。表面上,一个是实验室的计算实验,一个是职场的问卷调查;深层里,它们共享同一个关切,并且互相补上了对方缺的那一半证据。把两边映射到 BDI(信念-愿望-意图)坐标系上,不对称结构一目了然:
维度Dochkina 2026BCG 2026LLM Agent 2026**信念**共享组织记忆(角色历史)用户的 AI 使用经验参数统计分布 + RAG**愿望**任务使命(mission)用户的工作目标用户指令 / task**意图**自主角色选择 + 弃权决策管理和指导 AI 的行为ReAct 循环**意图编辑权**排序固定 + 角色自主 = 最小骨架 + 最大血肉47% 时间在管理 AI = 意图编辑权仍由人持有骨架人编排 + 血肉模型生成**承诺策略**Sequential = 有序承诺 + 开放心态无显式策略无显式策略**仲裁方式**涌现式(自发弃权 + 浅层层级)人工(用户监督)无标准机制
AI 这一侧,自组织已被证明可行且更优,但仅在能力阈值以上。人这一侧,管理方式还没跟上,而且被 47% 的管理负担压着。Dochkina 的 Sequential 协议是“固定排序(人预设骨架)+ 自主角色选择(Agent 填血肉)”,这与阶段三 PRS 的“计划库由人预设 + 栈调度归 Agent”分担结构、与当代 LangGraph 的“状态图人编排 + 节点内 LLM 填充”结构构成三时空同构;而 BCG 的 47% 正是这种分担在人类侧的成本——人还没来得及把“管理 AI”的工作流本身重设计,就被旧有的层级结构惯性拖住了。
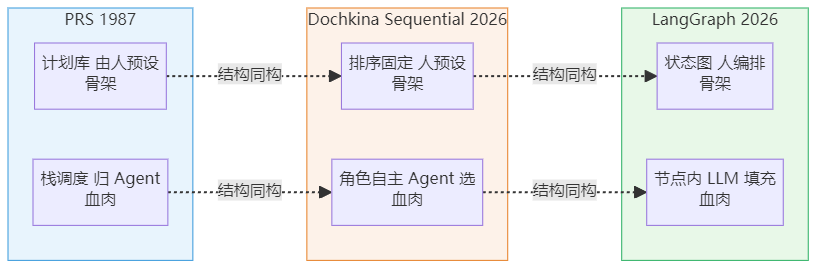
W&J 1995 的弱概念四性质在这里出现了一个他们未曾预见的非对称:**自主性在 AI 侧涌现,在人侧退化**。Dochkina 实证了 agent 的自主性可涌现:8 个 agent 自发生成 5,006 个独特角色,无需预设分配;BCG 却显示人的自主性被管理负担侵蚀:人不再是自主的工作者,而是被绑在 AI 监督链上的管理者([何为 Agent](https://www.paddysun.top/?p=5128))。同样,C&L 1990 年提出 agent 自行决定何时放弃目标,Dochkina 2026 年证明 agent 不仅能自行决定放弃目标(弃权),还能自行发明新角色——意图编辑权的范围从“何时放弃”扩展到了“做什么”([意图即带承诺的选择](https://www.paddysun.top/?p=5118))。
为什么人侧没跟上?Bar-Hillel 式的批评给出认知层面的解释。Bar-Hillel 1958 年批评机器翻译的核心论点是“前提选择比演绎困难”:判断一个翻译是否正确,需要从无限可能的事实中选出相关的证据子集,这个前提选择本身比演绎推理难 10^10 个数量级(见 [Bar-Hillel 式批评](https://www.paddysun.top/archives/5039))。把这个批评投影到治理层面:**管理 AI 的认知负荷(BCG 的 47%)本质上是人试图理解 LLM 生成的不透明意图的成本**。Sequential 协议中的“角色”由 LLM prompt 生成,没有效用函数做地基:角色是自然语言文本,不是可验证的能力值(这正是 [合同网](https://www.paddysun.top/?p=5132) 中 Bar-Hillel 批评的延续)。当人试图监督这些 prompt 级生成的角色和决策时,他面对的是自然语言的模糊性:“这个 agent 为什么选了这个角色?”“它弃权的理由是什么?”“它的输出可信吗?”——每一个问题都是一次前提选择,而前提选择比演绎本身困难得多。
所以 BCG 的 47% 并非“AI 还不够好”的症状,它指向的是“人还不够懂得如何组织 AI”。工作流重设计红利(24pp)指向的正是解药:只有当人重新设计工作流(像 Sequential 协议那样“最小骨架 + 最大血肉”),管理负担才会下降。但这里有一个循环:工作流重设计本身也需要跨过一道认知门槛,人必须先理解 AI 的工作方式,才能设计适配的工作流——而这道理解门槛,正是 Bar-Hillel 式批评的核心。
> **作者判断**:综合两份文献,未来两三年多 Agent 系统落地的瓶颈将主要出现在组织侧而非模型侧——谁先完成”Sequential 式”的工作流重设计(最小骨架 + 最大血肉),谁先收回那 24 个百分点的红利。[作者判断] 这一预测的依据是横截面数据,不排除随模型能力继续抬升、阈值约束失效后座次重排的可能。
## 历史回响:合同网、STEAM 与 KQML 的当代实证
把阶段三的四条线放到 2026 年的实验数据旁边,会看到一组跨越四十年的对应关系。Dochkina 的 8 种协议,正是这些历史协议的当代实证版——Coordinator 是合同网的集中仲裁,Sequential 是角色动态互换的进化形态,Broadcast 是 KQML 信号通信的 prompt 级延续:
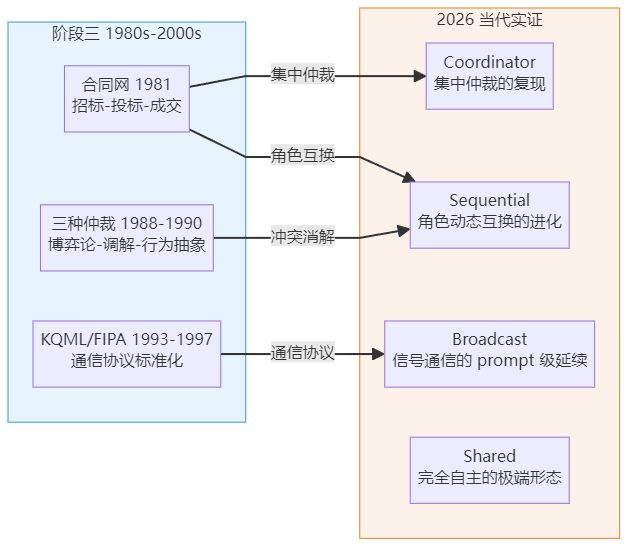
按引证强度分级,被验证的历史结论如下。
**强影响**(直接实证验证)——三条历史结论第一次拿到了大规模数据:
被验证的历史结论Dochkina 2026 证据参考来源合同网角色动态互换(Davis & Smith 1981)Sequential 的自主角色选择 = 合同网”角色动态互换”的进化形态,大规模实证验证[合同网](https://www.paddysun.top/?p=5132)KQML/FIPA 通信协议要素三要素中的”通信协议”= KQML/FIPA 的 prompt 级延续[智能体如何找到彼此](https://www.paddysun.top/?p=5153)W&J 弱概念自主性自主性被实证为可涌现——8 agent 自发生成 5,006 个独特角色[何为 Agent](https://www.paddysun.top/?p=5128)
**中强影响**(概念延续与超越):
历史概念Dochkina/BCG 的延续或超越参考来源ARCHON 协调开销非线性增长Dochkina 的亚线性扩展到 256 agent 超越 ARCHON——但前提是模型能力跨过阈值[联合意图部署](https://www.paddysun.top/?p=5140)三种仲裁形态Dochkina 的 Sequential = 第五种仲裁(涌现式自主弃权),与四种历史仲裁形成五形态对照[三种仲裁](https://www.paddysun.top/?p=5136)C&L 意图编辑权分担Sequential = 固定排序 + 自主角色 = 意图编辑权分担的实证验证[意图即带承诺的选择](https://www.paddysun.top/?p=5118)
**中等影响**(概念启发):
概念启发方向参考来源合同网囚徒困境Sequential 的固定排序解决了囚徒困境的”局部最优不等于全局最优”[合同网](https://www.paddysun.top/?p=5132)Z&R 均衡约定Dochkina 的涌现式弃权 = 不依赖外部仲裁者的内生均衡[三种仲裁](https://www.paddysun.top/?p=5136)
几条对应关系值得展开。合同网的囚徒困境(“最好的全局分配未必来自局部最优拼接”)在 Sequential 的固定排序中被部分解决:固定排序让每个 agent 看到前驱的选择,避免了同时竞标同一角色的冲突。合同网用招标机制让节点自主决定投不投标,Sequential 用排序机制让 agent 依次决定选不选角色——四十五年间换了内核,“让任务找到合适的 agent”这个问题本身没变。
仲裁谱系的扩展更值得记一笔。合同网的招标裁决、Z&R 的均衡约定、PERSUADER 的效用重写、D&M 的行为抽象:四种历史仲裁都依赖设计期预设([三种仲裁](https://www.paddysun.top/?p=5136))。Sequential 展示了第五种:**运行时涌现的仲裁**——agent 通过观察前驱的弃权行为动态推断权威分配,无需预设。而 Z&R 梦寐以求的“不依赖外部仲裁者的内生均衡”,在涌现式弃权里得到了一个 prompt 级的实例。
KQML 一线的延续则带着一层退化意味。Dochkina 的“通信协议”是三要素之一,但她的协议是 prompt 级的而非消息级形式化的:KQML 用 Lisp 语法定义 36 个 performative,Dochkina 用自然语言 prompt 定义 agent 间的角色交换协议。通信从结构化消息退化为自然语言对话,但核心问题不变:**通信协议的选择和中介策略的决策比消息传递本身难得多**,这正是 KQML 一线 Bar-Hillel 式批评的延续。
## 诚实边界:这三份材料各自不能证明什么
这篇文章引用了两份 2026 年文献和我们自己的一份模拟,它们都有不能越过的边界。逐条清点,一条不省。
**第一,Dochkina 的实验是 LLM-as-judge 评估,非真实工业部署。** 论文使用独立判官模型(GPT-4o / GPT-5.4)对解决方案进行多准则评分。这与 [联合意图部署](https://www.paddysun.top/?p=5140) 中 ARCHON 的真实电力/CERN 部署不在同一证据层——LLM-as-judge 的评分与真实工业环境的效果之间存在未被验证的鸿沟。判官模型自己的偏好、风格偏差和可操纵性,都没有被排除在评分之外。
**第二,BCG 的 47% 是自我报告数据,非行为观测。** “管理 AI 的时间”是受访者主观估计,而非时间追踪工具的客观记录。自我报告数据存在回忆偏差和社会期望偏差:受访者可能高估或低估管理时间。47% 应读作“约半数人如此感知”的量级信号,而非精确的行为测量。
**第三,两篇文献的因果链都不完整。** Dochkina 未证明 Sequential 协议在真实组织中的长期稳定性:25,000 个任务都是短时任务,没有跨月或跨年的纵向追踪,而组织的真实困难往往在时间维度上(角色固化、路径依赖、记忆污染)。BCG 未证明工作流重设计能消除 47% 的管理负担:24pp 的重设计红利是横截面比较,不是消除管理负担的因果证明。
**第四(本条须以最强语气陈述),我们的 Python 模拟使用数学公式而非真实 LLM 调用——它与 Dochkina 的实验在证据等级上差着整整一个范式。** 涌现角色统计(220 个)和角色选择行为由概率模型模拟(形容词 + 名词的词库采样),不是真实 LLM 的 prompt 级角色发明;质量得分由参数化公式计算,不是 LLM-as-judge 的真实评分;治理悖论由泄漏率和认知密度系数驱动,不是对任何真实工作者的观测。更要紧的是,复现数字与论文数字的高度吻合(+14.5% 对 +14%,44.0% 对 47%)不是独立推导的结果,而是把论文报告的效果量拟合进参数的必然回放——**模拟中没有一个数字来自一次真实的模型推理**。它的全部效力在于验证协议间质量排序和能力阈值翻转的定性模式:排序可以由这些机制产生;至于真实 LLM 群体是否恰好由这些机制主导,要回到 25,000 次真实运行里去看。完整代码在 \`../self-organization-reproduction/\`,读者可以自行检验这条边界画在哪里。
清点完毕,可以给这个系列的正编一个收束了。阶段三从 C&L 1990 的一个问题出发(自主性能不能有可计算的答案),走了 PRS、合同网、仲裁、联合意图、KQML、反应-慎思和解、意图编辑权,最后落到 2026 年的两份文件上。Dochkina 证明 AI 侧的自组织在能力阈值以上可行且更优,BCG 证明人侧的管理方式还没跟上——瓶颈不在 AI 能否自组织,而在人的组织形式能否适配 AI 的自组织。Sequential 的“最小骨架 + 最大血肉”因此有了双重身份:它既是给智能体群的编队口令,也是给人的管理备忘——把骨架留给自己,把血肉还给它者。这大概就是“意图即承诺,智能体即社会”在正编终点处的样子:承诺可以交给机器守住,组织得两边一起改。
## 参考文献
[**dochkina2026**] Dochkina, V. “Drop the Hierarchy and Roles: How Self-Organizing LLM Agents Outperform Designed Structures.” arXiv:2603.28990, March 2026. Moscow Institute of Physics and Technology (MIPT).
[**bcg2026**] BCG. “AI at Work 2026: Strategy Matters More Than Tools.” Boston Consulting Group, June 3, 2026. 14 countries, 11,749 respondents, fourth annual survey.
[**contractnet**] Davis, R. & Smith, R.G. “Negotiation as a Metaphor for Distributed Problem Solving.” MIT AI Memo No. 624, May 1981. 第 4.2 节(p10)。
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] TouringMachines 与 INTERRaP:混合架构如何调和 Agent 的反应与慎思
https://www.paddysun.top/archives/5153 · 2026-09-02
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 8 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/archives/5114) **阅读时间**:约 18 分钟
---
# 反应与慎思的和解:一边让三层抢方向盘,一边把难题逐级上交
设想一辆在城区行驶的自主车。前方十五米突然出现障碍物,它必须在几十毫秒内制动——这是感知-行动的直连,容不得任何“想一想”。但同一辆车还要在几分钟前决定走哪条路线绕开施工区,还要在路口前预测右侧来车会不会抢行,那是一个跨秒级的社会推理。毫秒、分钟、长时预测,三种时间粒度塞不进同一条反射弧。1986 年 Rodney Brooks 的包容架构证明了第一种智能可以不需要内部世界模型,但他只赢了这半场;后两种智能住在哪里、怎么与第一种共处,他留成了一道裂缝。
1992 到 1993 年,两篇博士论文级别的长篇技术报告几乎同时动手填这道裂缝,给出的却是两个结构上几乎相反的答案。剑桥大学的 Innes Ferguson 在 219 页的 UCAM-CL-TR-273 里造出 TouringMachines:反应、规划、建模三层并发运行,每层都直连感知与行动、都可直接下达动作命令,冲突交给设计者手工雕琢的门控规则在时间片两端收拢 ferguson1992。DFKI 的 Jörg Müller 与 Markus Pischel 在 109 页的研究报告里造出 INTERRaP:模块纵向堆叠,世界接口独占感知与行动,底层干不了的任务逐级上交,顶层的联合计划再分解下传 muller1993。
一个是横向并发,一个是纵向上交;一个守住“无中央表征”的前提,一个部分回到集中表征;一个把仲裁交给设计者预设的 if-then 规则,一个让模块在运行时自评称职。这篇文章沿着这道裂缝讲两边的工程细节,用同一场景的复现对比两条决策路径,最后用一场 2026 年的 A/B 实验回答一个 Ferguson 悬置了三十四年的问题:当静态门控换成 LLM 的运行时判定,兑现的是什么,付出的又是什么。
## 裂缝是怎么留下的:Brooks 赢了半场,PRS 折衷了另一半
1986 年,Brooks 发表了那篇改变 AI 走向的论文 brooks1986。他的核心论断是:智能行为可以由感知-行动耦合直接产生,不需要内部世界模型,不需要规划,不需要中央表征。包容架构(subsumption architecture)把行为组织成层,高层抑制低层输出——但抑制是固定的、硬连线的,不经过任何中央仲裁者。Brooks 的贡献不是“发明了反应式架构”(William Ashby 的稳态机、Grey Walter 的机器龟都是先驱),而是把“无内部表征”从哲学主张变成了可运行的机器人程序。他的 Herbert 机器人与 Genghis 六足步行机,都是没有规划、没有世界模型、却能在办公室走廊里搜集可乐罐的实体。
但 Brooks 自己留下了一道裂缝。他的论断覆盖的是“感知-行动”层——毫秒级、近距空间。一个需要在城市路网中导航到十公里外目的地的 agent,不可能只靠感知-行动耦合。Brooks 没有回答慎思往哪里放,他把这个问题留给了后人。
1987 年,SRI 的 Georgeff & Lansky 在 AAAI-87 上发表的 PRS(Procedural Reasoning System)做了一次折衷 prs1987。PRS 的核心是知识区域(Knowledge Area, KA)计划库——每个 KA 是一段“在什么条件下、怎么达成某目标”的过程。解释器在运行时从 KA 库中选择匹配当前信念和目标的 KA,压入进程栈执行;任意时刻被激活的 KA“既是部分的又是分层的”:计划不需要完整展开就能开始行动。PRS 把“何时停止规划”变成了一个可调用元级过程的问题(详见 [BDI 从理论到工程](https://www.paddysun.top/?p=5122))。但底层架构仍然是**单一解释器**轮转 KA。它没有真正的并发,反应式避障和战略规划在同一个进程栈里排队。当紧急障碍出现时,解释器需要先中断当前 KA、压栈、调度元级 KA 判断是否该切换。这套机制能用,但不是 Brooks 意义上的“感知-行动直连”。
裂缝还在。PRS 的折衷证明了一件事:把反应和慎思塞进一个解释器是可行的,但不是唯一的答案——甚至可能不是最好的答案。把这条线放进时间轴,可以看到两种混合架构如何从同一道裂缝分岔,又如何在三十多年后重新合流:
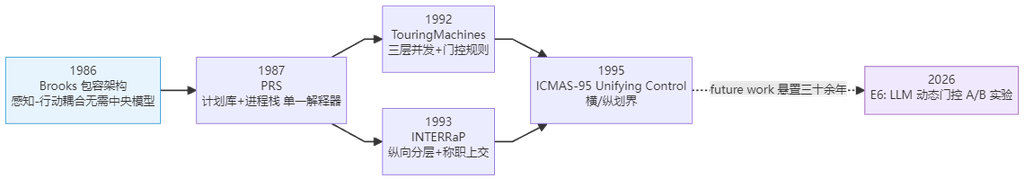
图中实线是架构演化的因果链,虚线是 Ferguson 埋进 future work 的那个问题:运行时能否自己决定“要不要多想一会儿”。它在 2026 年才第一次被真正拿到实验台上检验。我们先看 1992 年的第一个答案。
## Ferguson 的答案:让三层同时开车
TouringMachines 的核心结构,报告原话是“三个独立控制层:反应层 R、规划层 P、建模层 M”,三层“并发运行、独立驱动、产生行为” ferguson1992。每层独立连接感知与行动子系统,可直接下达动作命令,各自以不同的时空抽象粒度建模世界。控制框架对层透明——“每层可当作只有自己在控制 agent”。冲突不在层内解决,交由层外的门控规则收拢。
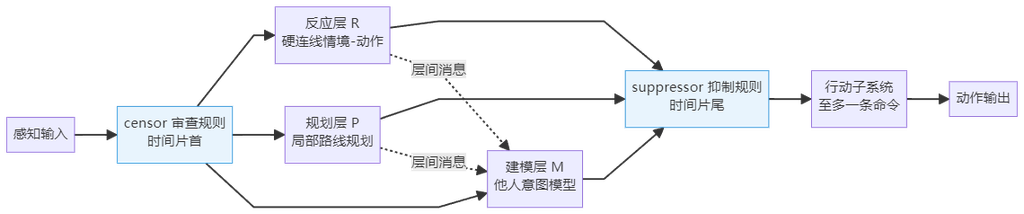
这张图的关键在于两端:感知进来先过 censor、动作出去前先过 suppressor,三层本体在中间互不指挥。三层的分工沿时空粒度展开——**反应层 R** 最细粒度,处理当前时刻、近距空间,硬连线情境-动作规则,感知-行动直连,无内部状态推理,撞墙前 15 米紧急制动。**规划层 P** 中等粒度,处理局部路段、分钟级,做局部路线规划,原话“计划仅被当作行动的资源,而非控制一切行为的严格配方”——计划不控制一切,只是行动时可调用的资源。**建模层 M** 最粗粒度,处理全局场景、长时,预测他人意图并据此行动,显式采用 BDI 式他人心理模型,建模层是本架构中 BDI 伏线最明显的接入点。
Ferguson 在报告里明确交代了自己的师承。他的控制框架自称“包裹式类包容控制框架”(a wrapper-like subsumption-like control framework),中介控制规则中的抑制机制“近似 subsumption 中的抑制机制”(akin to the suppression mechanism in subsumption)ferguson1992。师承线索清晰,但他做了两处关键改造。第一,Brooks 的抑制是固定的层间链——高层总是抑制低层;Ferguson 取消了固定压制链,原话“层间无严格层级化或优先级化的控制流”:建模层不总胜规划层,规划层不总胜反应层,胜负取决于运行时情境,抑制由情境激活的门控规则触发,不是硬连线。第二,subsumption 只在输出端抑制,Ferguson 在输入端也加了过滤,censor 规则在时间片首过滤喂给各层的感知,设计者由此可以控制“哪些层在哪些情境下能看到什么”,比 Brooks 的纯输出抑制多了一个维度。他还类比了 Minsky 心智社会的 censor/suppressor agents。本系列长期追踪的两条伏线(Brooks 的包容架构与 Minsky 的心智社会)在这里又一次交汇。
> **勘误**:“Brooks 与 BDI 的和解方案”系本报告凝练,不得作任何一家的原文称谓。可用旁证为 Ferguson 自述”subsumption-like control framework”(师承 Brooks)+ 建模层显式采用 BDI 式他人心理模型 + Müller 一侧“试图和解反应与慎思的架构”,但三家原文均无此称谓。
仲裁机制本身是两类中介控制规则,原话“通过修改任意层的输入输出来消解动作冲突” ferguson1992。censor 规则在时间片首过滤感知,例如“近距障碍时屏蔽规划层感知”(避免在紧急时浪费计算资源做路线规划);suppressor 规则在时间片尾过滤各层输出的动作命令,例如“紧急制动时抑制规划层输出”(反应层接管)。在我们的复现仓里,这套规则就是一个手写的静态表:
```
# 设计者手工雕琢的审查/抑制规则——静态、编译时分配
self.censor_rules = [
CensorRule("obstacle_close", "P", "近距障碍时屏蔽规划层感知"),
CensorRule("complex_conflict", "P", "复杂冲突时屏蔽规划层感知"),
]
self.suppressor_rules = [
SuppressorRule("obstacle_close", "P", "紧急制动时抑制规划层输出"),
SuppressorRule("obstacle_close", "M", "紧急制动时抑制建模层输出"),
SuppressorRule("complex_conflict", "P", "复杂冲突时抑制规划层输出"),
]
```
短短几行代码就是 TouringMachines 仲裁机制的全部本体:按情境标签查表,命中就屏蔽。真正要紧的是它的唯一性保证从哪里来——原话“由设计者雕琢,保证任一情境至多一条规则触发、至多一条命令到达效应器”。这不是运行时仲裁,而是**编译时分配**:设计者在编码时必须穷举所有可能的情境组合,为每个组合写好互斥的 if-then 规则;遗漏一个组合,就可能出现两条命令同时到达效应器。这条约束是 TouringMachines 最大的结构脆弱性——系统行为的质量完全取决于设计者编写规则的完备性,而设计者无法在编译时穷举所有运行时情境。(完整复现代码见 `../hybrid-architecture-reproduction/hybrid/touring_machines.py`。)
守住“无中央表征”的代价也在这里。三层中没有一层是“老板”,没有层拥有对其他层的控制权,仲裁由情境驱动的门控规则执行——这是对 Brooks 原则的忠实继承。但守住院子的代价,是仲裁能力被限制在“设计者预设的情境-规则对”之内:运行时遇到设计者没预设的情境组合,门控规则不触发。Ferguson 把“决策论元推理、anytime 算法、第四学习层”全部放进了 future work——不是不想做,是静态门控框架做不了。
## Müller 的答案:干不了就上交
一年后,DFKI 给出了结构上几乎镜像的答案。INTERRaP 的核心是两大件——“层次化 agent 知识库 + 多级控制单元” muller1993。控制单元含四个子模块:世界接口(World Interface)、行为组件 BBC(Behavior-Based Component)、计划组件 PBC(Plan-Based Component)、协作组件 CC(Cooperation Component),原话四者“经目标、计划与信息通信交换”。与 TouringMachines 的“每层独立连感知行动”相反,世界接口独占感知与行动,共享的 World Model 是所有层的公共底座——INTERRaP 部分回到了集中表征。
> **勘误**:INTERRaP 分层命名 BBL/LPL/CPL 定型于 1995-96 版。1993 DFKI 版为 WIF/BBC/PBC/CC——“社会模型”在 1993 版尚非独立组件,由 Cooperation Knowledge 层承担。本文一律使用 1993 版命名。
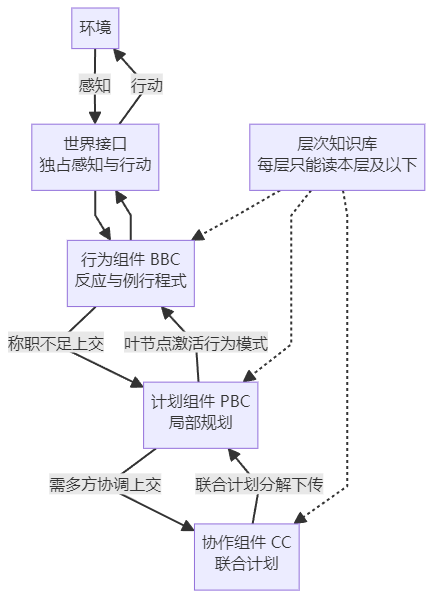
层间控制分两个方向。**自下而上**是称职驱动,原话“模块 n 自认能力不足,把任务上交模块 n+1”:BBC 尝试处理当前情境,有可用的行为模式(紧急制动、减速、保持车道等)就执行;来了其他 agent 需要交互,BBC 自认不胜任,把任务上交 PBC;PBC 做局部规划,若还需多方协调(障碍物与来车并存)再上交 CC。**自上而下**是计划分解:CC 制定联合计划后分解为子计划下传给 PBC,PBC 再分解为叶节点,叶节点激活 BBC 的行为模式,控制交还 BBC 执行,行动仍由世界接口独占输出。知识访问同样分层,原话“每层只能读本层及以下的知识层”:BBC 只能读世界模型和行为模式知识,PBC 可加读局部计划,CC 可读全部(含合作知识)。
称职驱动听起来抽象,落到实处只有几行判断。复现仓里 BBC 的称职判据是这样写的:
```
def can_handle(self, world: Dict[str, Any]) -> bool:
"""称职判据——BBC 能否独立处理当前情境"""
other_agents = world.get("other_agents", [])
if other_agents:
return False # 有其他 agent 需交互 -> 不胜任 -> 上交
return True # 无其他 agent -> BBC 可处理所有驾驶情境
```
整个上交链条则是三层 `can_handle` 的嵌套:
```
if self.bbc.can_handle(world):
behavior, action = self.bbc.act(world) # BBC 直接执行
elif self.pbc.can_handle(world):
plan_name, action = self.pbc.plan(world) # 上交一层做局部规划
else:
plan_name, joint_action, leaf = self.cc.coordinate(world) # 上交顶层协调
```
读这两段代码时值得留意两点。其一,BBC 并非纯粹的反射弧——原话行为模式“远超一般理解的反应式系统”,作者自语凝练为“把智能从规划移入执行”;BBC 内部“引入一种 Brooks 式包容结构”,行为模式按静态优先级排序,套用的是 Maslow 需求金字塔。其二,也是更关键的:称职判据本身是设计者写的 if-then。“自认能力不足”听起来是运行时的自我评估,但“什么算不胜任”在编码时就定死了——这个伏笔我们留到最后再展开。
层与层之间怎么说话?INTERRaP 的答案是消息原语(accept、command、demand、inform、modify、propose、reject),原话“模块间通信与 agent 间通信基本同一套言语行为式原语”。这是模块社会化路线:模块间的通信和 agent 间的通信使用同一套言语行为,模块本身就是“小 agent”,与 Minsky“脑内 agents 社交”的设想直接呼应。在 ICMAS-95 的后续短文里,Müller 一方还补了一个常被忽略的澄清:各层“虽按层级排列激活,却并发工作——agent 在规划时仍对意外保持感受性” muller1995。纵向堆叠不等于串行独占,这一点是它与其他分层方案的重要区别。
## 同一辆车,两条决策路径
两种架构孰优孰劣,Müller 本人在 ICMAS-95 的《Unifying Control》里亲自划了界 muller1995。他的判词是:Ferguson 的 TouringMachines 属**横向耦合**——“每个控制模块直连感知与行动”,三层并列,各有一根感知输入线和行动输出线,层间只有消息交换,没有控制权传递;INTERRaP 属**纵向架构**——“纵向架构中抑制可经模块间直接通信施加;横向架构里一个组件看不到另一个组件在提议什么动作”。
这句话点中了横向架构的结构盲点。TouringMachines 的三层各自独立产生动作命令,suppressor 规则在时间片尾收拢,但 suppressor 触发时只能看到“当前情境标签”,看不到“另一层正在提议什么动作”。设计者必须预设“复杂冲突时该抑制哪层”,可设计者无法预知运行时三层各自会提议什么。INTERRaP 的纵向架构让模块通过消息原语直接通信——一个模块可以看到另一个模块在提议什么,并据此决定是否施加抑制。这条划界不是品味之别,而是结构之别:横向守 Brooks 前提,代价是仲裁依赖设计者预设;纵向放弃 Brooks 前提,换取层间可见性和显式仲裁。
空口划界不如同场竞技。复现仓设计了一个两架构共用的测试场景:一辆自主车沿道路行驶,8 个时间片从开放道路到抵达目的地,其中 t=2 是近距障碍(15 米,紧急),t=4 是复杂冲突——近距障碍物(20 米)加来车从右方接近(完整场景定义见 `../hybrid-architecture-reproduction/hybrid/scenario.py`)。两种架构在同一个场景里各跑一遍:
```
实验1:TouringMachines vs INTERRaP 架构对比
============================================================
--- TouringMachines(横向并发)---
t=0 反应层=保持车道 规划层=沿路线前进 建模层=无他人需建模
censor触发=False suppressor触发=False
t=1 反应层=保持车道 规划层=沿路线前进 建模层=无他人需建模
censor触发=False suppressor触发=False
t=2 反应层=紧急制动 规划层=[被抑制] 感知被审查——未运行 建模层=[被抑制] 无他人需建模
censor触发=True suppressor触发=True
t=3 反应层=保持车道 规划层=沿路线前进 建模层=礼让来车
censor触发=False suppressor触发=False
t=4 反应层=减速备刹 规划层=[被抑制] 感知被审查——未运行 建模层=礼让来车
censor触发=True suppressor触发=True
t=5 反应层=保持车道 规划层=沿路线前进 建模层=无他人需建模
censor触发=False suppressor触发=False
--- INTERRaP(纵向分层)---
t=0 活动层=BBC 动作=保持车道
上交=False 理由=
t=1 活动层=BBC 动作=保持车道
上交=False 理由=
t=2 活动层=BBC 动作=紧急制动
上交=False 理由=
t=3 活动层=PBC 动作=规划礼让来车
上交=True 理由=BBC 无可用行为模式处理来车交互
t=4 活动层=CC 动作=联合计划: 先制动礼让来车再绕行障碍
上交=True 理由=PBC 需多方协调——障碍物与来车并存
t=5 活动层=BBC 动作=保持车道
上交=False 理由=
```
(t=6、t=7 为抵达目的地与终态,两种架构都输出停车。)平静路段两者行为一致,分歧全部集中在 t=4 那个复杂冲突上。把 t=4 拆开看:
TouringMachinesINTERRaP反应层 / BBCR:减速备刹(优先级 5.0)BBC:有来车 → 自认不胜任规划层 / PBCP 被 censor+suppressor 屏蔽PBC:障碍+来车 → 仍不胜任建模层 / CCM:礼让来车(优先级 6.0)CC:制定联合计划仲裁依据设计者的静态优先级 M>R称职驱动逐级上交胜出礼让来车联合计划:先制动礼让来车再绕行障碍后果**障碍物无人处理**两个威胁均被纳入计划
TouringMachines 在 t=4 的遭遇值得细读。三层各自独立产生动作:R 说“减速备刹”(静态优先级 5.0),M 说“礼让来车”(静态优先级 6.0),最终 M 胜出,因为设计者在编译时给“礼让来车”分配的优先级更高。但规划层被抑制了:complex_conflict 情境触发了 censor 和 suppressor 规则,本该规划绕行路线的 P 连感知都被屏蔽。结果是 agent 礼让来车但不绕行障碍——负责绕行的规划层,被设计者的静态规则关掉了。INTERRaP 走的是另一条路:BBC 发现有其他 agent,自认不胜任,上交 PBC;PBC 发现障碍物与来车并存,需要多方协调,再上交 CC;CC 制定的联合计划“先制动礼让来车再绕行障碍”把两个威胁都装了进去,计划叶节点再激活 BBC 的紧急制动行为模式执行。同一个场景,两种架构给出了不同的答案。而 TouringMachines 的那份答案里,盲区不是机器犯的错,是设计者编写的规则直接导致的。
> **勘误**:D&M(Durfee & Montgomery 1990)的“行为抽象层级”属协调协议中的通信内容抽象而非 agent 内部分层架构。D&M 不与 TouringMachines / INTERRaP 同列——后者是 agent 内部分层,前者是 agent 间协调协议的通信内容抽象。详见 [三种仲裁](https://www.paddysun.top/?p=5136)。
把两条路径的全部差异压进一张表:
维度TouringMachines(横向并发)INTERRaP(纵向分层)层间结构三层并列,各自直连感知与行动四模块纵向堆叠,世界接口独占感知行动仲裁机制censor + suppressor 门控规则(静态)称职驱动上交(运行时情境驱动)Brooks 前提守住——无中央表征,每层独立部分放弃——世界接口集中感知行动层间可见性一个组件看不到另一组件在提议什么动作模块间通过消息原语直接通信仲裁来源设计者手工雕琢的 if-then 规则模块自评称职不足触发上交何时回到慎思门控规则预设的情境触发BBC 不胜任时自动上交集中表征无有(World Model 为公共底座)控制流无固定层级——情境驱动纵向——称职驱动自下而上,计划分解自上而下
两种混合架构应两案并陈,不宜以 TouringMachines 概括全部:前者守住 Brooks 前提恢复慎思,方式是让三层并发、用情境门控规则消解冲突,但仲裁完全依赖设计者手工雕琢;后者放弃 Brooks 前提恢复慎思,方式是把反应作默认层、以称职驱动上交换取层间冲突的显式仲裁,但世界接口集中了感知行动。两种答案各有代价。
### 放进 BDI 坐标:连同 2026 年的第三列
把两个架构放进 BDI(信念-愿望-意图)坐标系,再并排放上 2026 年的 LLM Agent,三者的位置差异会看得更清楚:
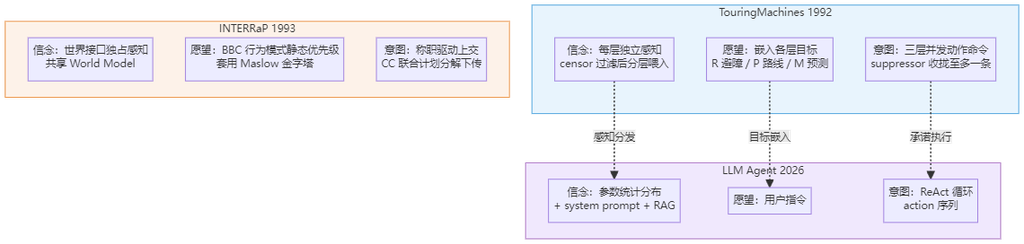
维度TouringMachines 1992INTERRaP 1993LLM Agent 2026信念每层独立感知,censor 过滤后分层喂入世界接口独占感知,共享 World Model参数统计分布 + system prompt + RAG愿望嵌入各层目标(R 避障 / P 路线 / M 预测)BBC 行为模式静态优先级,套用 Maslow 金字塔用户指令意图三层并发动作命令,suppressor 收拢至多一条称职驱动上交,CC 联合计划分解下传ReAct 循环 action 序列承诺语义suppressor 规则决定哪层动作生效计划叶节点激活 BBC 行为模式tool call 是隐式承诺何时慎思设计者预设的情境触发门控规则BBC 不胜任时自动上交LLM 自己决定(无元推理保障)仲裁来源设计者手工雕琢的 if-then 规则模块自评称职不足概率采样(无显式仲裁)信念更新感知子系统每时间片刷新世界接口每周期刷新每轮对话 context window 刷新
这张表里最要紧的一行是“何时慎思”。INTERRaP 的答案是**运行时自评**驱动的:BBC 自己判断“我能不能处理这个”,不能就上交,这比 TouringMachines 的“设计者预设情境触发”更动态。但两者都远未达到 Rao & Georgeff 1995 年 BDI 模型中“开放心智”agent 的理想——后者能评估“采纳意图的理由是否仍然成立”并据此放弃意图(见 [BDI 从理论到工程](https://www.paddysun.top/?p=5122))。而当代 LLM Agent 的“何时慎思”由 LLM 自己在 ReAct 循环中决定,没有元推理保障,“多想一会儿”只是采样上的概率波动,并非策略选择。这个空白,正是下一节实验的入口。
## 动态门控:一笔悬了三十四年的 future work,和它的兑现代价
Ferguson 把话说得很早、也很直白。他在结论章自认:计算资源分配是“静态的编译时方案”,运行时“无法评估是否该进一步慎思而非立即执行动作”——决策论元推理、anytime 算法与第四“学习层”全部位于 future work,自评当前 agent“只能算前智能” ferguson1992。复现仓里专门留了一个方法来验证这条自评:`can_assess_deliberation_need()`,检查 TouringMachines 能否在运行时评估“当前是否应该花更多时间慎思而非立即执行”:
```
def can_assess_deliberation_need(self, state: Any) -> bool:
"""验证 Ferguson 自认局限:
运行时'无法评估是否该进一步慎思而非立即执行动作'"""
return False
```
方法体只有一个 `return False`——这不是偷懒,这正是 Ferguson 自认的结构局限在代码里的等价物。跑一遍 8 个时间片:
```
实验2:静态资源分配局限(失败实验)
============================================================
TouringMachines 的 censor/suppressor 规则是静态分配的
运行时无法评估'是否该进一步慎思'
t=0 能否评估慎思需求: False
t=1 能否评估慎思需求: False
t=2 能否评估慎思需求: False
t=3 能否评估慎思需求: False
t=4 能否评估慎思需求: False
t=5 能否评估慎思需求: False
t=6 能否评估慎思需求: False
t=7 能否评估慎思需求: False
>> Ferguson 自评: 只能算前智能
>> 静态资源分配无法动态评估是否该进一步慎思
```
8 个时间片全部返回 False。censor/suppressor 规则是编译时分配的:哪些情境屏蔽哪层感知、哪些情境抑制哪层输出、层间计算资源配额,全部在设计期固定,运行时没有任何元推理机制来评估“当前是否应该多想一会儿”。以 t=4 为例:设计者预设了“complex_conflict 时抑制规划层”,可运行时 agent 面临障碍物加来车的复杂冲突,此刻恰恰**应该**让规划层参与(需要规划绕行路线)——静态规则却把规划层关掉了。TouringMachines 没有能力在运行时说“等等,这个情境比预设的复杂,让我多想一会儿”。这就是“只能算前智能”的含义。
**2026 新增 A/B 对照实验(E6)**。Ferguson 那条 future work 一留就是三十余年,这个实验试着把它兑现:只替换一个组件,其余全部不动。基线是设计者雕琢的静态 suppressor 规则(按情境标签查表);变体把 suppressor 换成 LLM,每时间片判定抑制哪些层的输出:**只给原始感知(速度、障碍距离、他车情况),不给情境标签**,逼 LLM 自己从感知推断紧急度,因为基线规则靠标签查表,若连标签一起给就测不出任何推断能力。censor 规则与“未抑制者中优先级最高者执行”的机制原样保留。模型 deepseek-chat,温度 0.3,8 时间片 × 10 轮独立抽样:
指标基线(静态规则)LLM 动态门控平静片抑制集吻合8/8(定义)6/6 × 10 轮全对t=2 紧急片(胜者须=R 紧急制动)通过**10/10 通过**t=4 复杂冲突片胜者=M(礼让来车)1/10 同基线;**9/10 改判 R**失败模式分布—correct×1,conservative_overreach×9误抑制 R / 平静片漂移0**0 / 0**每片延迟<0.001s~1.2s(LLM 调用)
安全底线全部守住了,这一点必须先说清楚:真紧急片(t=2 近距障碍)十轮全部让反应层的紧急制动到达效应器,十轮零误抑制反应层,六个平静片十轮零漂移,LLM 从原始感知推断紧急度的能力是可靠的。逐片吻合度也齐整:9 轮保守过抑各为 7/8 片吻合(唯一偏离就在 t=4),1 轮完全吻合为 8/8。
但 t=4 暴露了一个结构性的行为漂移,这一条要如实记录、不作软化。先看基线在 t=4 做了什么:Ferguson 的静态规则只抑制规划层 P,建模层 M 的“礼让来车”以优先级 6.0 合法胜过反应层 R 的减速备刹(5.0)。这正是“层间无严格层级化”的展示点,社会性冲突中可以礼让而非急刹。而 LLM 在 9/10 轮里连建模层也一并抑制,只留下反应层的“减速备刹”——反射层独大。也就是说,模型的安全先验把 Ferguson 精心保留的社会性仲裁重新层级化成了“反射优先”。判决(本系列凝练):**LLM 动态门控兑现了 Ferguson 的 future work(运行时仲裁确实可行且安全),但兑现的方式是把“设计者雕琢的情境特判”替换成“模型先验的保守特判”**;动态化买来了适应性,卖掉的是架构原有的行为多样性。附带成本同样真实:每片约 1.2 秒的延迟(基线静态查表不到 1 毫秒),以及 80 次调用共 25,891 tokens(prompt 22,410 + completion 3,481,零调用错误)。原始数据存于 `../experiment_results/ab_e6_hybrid_gating.json`。
> **修正记录**:本实验初版的失败模式分类法误设”危险片胜者须=R”,把 t=4 也按”胜者必须是反应层”来判——但基线在 t=4 的胜者本为 M(礼让来车)。该假设已撤回,全部 10 轮从原始记录重新分类(correct×1、conservative_overreach×9),未重跑 API。分类修正的依据写在 `../hybrid-architecture-reproduction/ab_experiment.py` 的 `classify()` 注释里:t=2 胜者须为 R(真紧急),t=4 若抑制集大于基线(连 M 也抑制)记 conservative_overreach。
> **编者注**:把这条修正与 t=4 的结果放在一起读更有意味——即使按修正后(对基线更有利)的分类法,LLM 动态门控在复杂冲突片上仍是 9/10 保守过抑。修正救的是实验记录的诚实,不是变体的成绩。
## Ferguson 自己先认了:前智能、六条边界与一份克制的影响谱系
这篇文章写到这里批评过的每一处局限,几乎都不是后人翻旧账——两篇原文自己在结论章就承认了。Ferguson 的“只能算前智能”前面已经引过,把两个架构的诚实边界完整摊开,一共六条。
**第一,TouringMachines 的静态资源分配。** 计算资源分配是“静态的编译时方案”,运行时“无法评估是否该进一步慎思而非立即执行动作”,censor/suppressor 规则是设计者编码时手写的,全部编译时固定,运行时遇到设计者没预设的情境组合,门控规则不触发。实验 2 的 8 个 False 已经验证了这一点;Ferguson 把决策论元推理、anytime 算法、第四学习层全部放进了 future work。
**第二,TouringMachines 的唯一性保证靠设计者手工雕琢。** 原话“由设计者雕琢,保证任一情境至多一条规则触发、至多一条命令到达效应器”。仲裁发生在编译时而非运行时:设计者必须穷举所有可能的情境组合,这在非平凡场景中不可扩展。实验 1 的 t=4 展示了后果:设计者预设“complex_conflict 时抑制规划层”,但规划层本该参与——规则把正确的层关掉了。
**第三,INTERRaP 的称职判据也是设计者预设的。** “模块 n 自认能力不足”——但“能力不足”的判据是设计者编写的,`can_handle()` 返回 True/False 的背后是预设的 if-then。称职驱动比 TouringMachines 的静态门控更动态(运行时情境驱动而非编译时固定),但“什么算不胜任”仍然是设计者定义的。
**第四,INTERRaP 部分回到集中表征。** 世界接口独占感知与行动、共享 World Model 为公共底座,这放弃了 Brooks 的“无中央表征”前提。INTERRaP 恢复慎思的方式恰恰是放弃这一前提:把反应作默认层、以称职驱动上交换取层间冲突的显式仲裁。所以两种混合架构应两案并陈,不能以一种概括另一种。
**第五,INTERRaP 的跨 agent 冲突仲裁仍需选出集中者。** 原话说“不先验假设调解过程存在”,但办法是“选出其中一个 agent 充当调解者”——运行时**选出**集中者,而非消除集中。这与 Durfee 在自组织工作中的权威值全序→选出 leader 路线一致(见 [三种仲裁](https://www.paddysun.top/?p=5136) 与 [智能体如何找到彼此](https://www.paddysun.top/?p=5153))。
**第六,INTERRaP 实验数字的自反性。** FORKS 装载码头叉车仿真(OPS-5 前向推理)跑了 3/6/9 个 agent × 5 种类型的组合,结果聚集任务下智能 agent 的冲突概率反而高于欠智能者——一个“不一定全用聪明 agent”的实证。这个数字说明混合架构的分层上交在 agent 数量增加时反而增加冲突,因为更多 agent 需要上交到 CC 协调。
三篇合观(含 D&M)能看到一个更冷的结论:1990-1995 的实现里,完全不依赖设计期预设的仲裁机制并不存在。彼时通行的折衷是“预设减到最少 + 运行时选出权威”(Durfee 权威值全序 → Müller 选举 mediator),真正的动态仲裁(效用元推理、学习层、动态权威分配)在三篇原文中全部位于 future work。
这个局面配得上一句 Bar-Hillel 式的批评。Bar-Hillel 对机器翻译的批评是:它把“理解”偷换为“模式匹配”,预设了一个不成立的等价前提。两种混合架构有一个结构相同的局限:它们把“仲裁”偷换为“设计者预设”,预设了一个不成立的等价前提:设计者能在编译时穷举所有运行时冲突情境。TouringMachines 的门控规则只有在设计者穷举了所有情境组合时才有效,可设计者在编译时无法预知运行时三层各自会提议什么动作,尤其当环境里还有其他 agent 时。INTERRaP 的称职驱动更动态,但“能不能处理”的判据仍然是设计者编写的能力边界,不是运行时学到的能力评估。
这条批评最重要的部分在于它对当代说的话。LangGraph 的状态图分层、AutoGen 的 GroupChat 协调层,都是混合架构的当代回声。但当 LangGraph 把“反应层”和“慎思层”写成状态图节点时,节点间的跳转条件仍然是设计者写的 if-then,只是从 censor 规则变成了 `add_conditional_edges` 的条件函数。**名字变了,结构没变。** 而当代 LLM Agent 的“何时慎思”由 LLM 自己在 ReAct 循环里决定,“多想一会儿”只是采样上的概率波动,并非策略选择。这恰好是 Ferguson 1992 年自认的局限在 34 年后的重现:TouringMachines 的“静态编译时方案”变成了 LLM 的“采样温度”,两者都不是真正的动态仲裁。E6 的结果给这条批评补了最新的一笔:即使把门控真正运行时化(LLM 从原始感知推断紧急度,安全底线全守),换来的仍是模型先验的保守特判,而非 Ferguson 设想中的决策论元推理——动态仲裁的旧问题解决了,“仲裁者的先验从哪来”的新问题顶了上来。
> **作者判断**:[若混合架构要在 LLM 时代复活,缺的可能不是更强的门控模型,而是对门控模型本身的制衡机制——比如给”抑制建模层”这类改变架构行为风格的裁决加上显式的复核通道。E6 的 9/10 保守过抑说明,模型先验与架构设计者的先验一样,都是一种未经运行时检验的预设。]
最后是影响谱系。这一节的每条关系都附引证,并按“强 / 中强 / 中”分级——概念相似不冒充因果传承。
**强影响**(直接继承混合架构范式):
系统 / 框架年份影响点参考3T / ATLANTIS / Saphira1990s三层架构(反应/顺序/慎思)直接继承 TouringMachines 的 R/P/M 分层范式[Bonasso 1997](https://doi.org/10.1016/S0004-3702%2897%2900004-5)SOAR1990s符号-反应混合架构,感知-行动与慎思并存[Laird et al. 1987](https://doi.org/10.1016/0004-3702%2887%2990054-2)JAM / UM-PRS1990s商业 Agent 框架采用 PRS 式计划库 + 混合分层[Huber 1999](https://doi.org/10.1016/S0004-3702%2898%2900125-4)ICMAS-95 Unifying Control1995Müller/Fischer/Pischel 把 INTERRaP + TouringMachines 统一为”分层 BDI”(判定成立但非原文自封)[ICMAS-95](https://doi.org/10.1109/ICMAS.1995.527939)
**中强影响**(概念启发混合架构思路):
系统 / 框架年份影响点参考robotic agent 架构1990s-2000s机器人控制普遍采用反应+规划混合分层[Arkin 1998](https://doi.org/10.7551/mitpress/2709.001.0001)亚符号反馈控制1990s底层反应+高层规划的混合范式影响机器人学[Brooks 1986](https://doi.org/10.1016/0364-0213%2886%2990012-8)ROS 节点架构2010s节点间消息通信松耦合,混合架构的工程遗产[ROS](https://wiki.ros.org/)AutoGen GroupChat2023多 agent 协调层近似 CC 的角色[AutoGen](https://github.com/microsoft/autogen)
**中等影响**(概念平行而非直接继承):
系统 / 框架年份影响点参考System 1 / System 22000sKahneman 双系统与反应/慎思分层概念平行[Kahneman 2011](https://doi.org/10.1016/j.cognition.2011.12.005)LangGraph 状态图2024agent 内部状态图分层,概念平行于 INTERRaP 纵向分层[LangGraph](https://github.com/langchain-ai/langgraph)hierarchical RL2010s分层强化学习的 option 框架,概念平行于称职驱动[Precup 2000](https://doi.org/10.1023/A:1006730419855)
回望 1992-1993 年那道裂缝的两份答案:Ferguson 让三层抢方向盘,用设计者雕琢的门控规则收拢冲突,守住了无中央表征,也把仲裁的天花板钉在了编译期;Müller 与 Pischel 把难题逐级上交,用称职驱动换取显式仲裁,也把感知行动重新集中到了一个接口上。1995 年 Müller 亲笔划下横与纵的界线时,两案并陈的局面已经注定。而真正悬而未决的那个问题,“agent 能不能在运行时决定自己要不要多想一会儿”,从 Ferguson 的 future work 一路悬到 E6 的实验台上。三十余年后它得到的第一个可计算回答是:能,安全地能,但答案里带着模型先验的口音。前智能的门槛迈过去了一半——另一半,仍然在 future work 里。
## 参考文献
[**brooks1986**] Brooks, R. A. “A Robust Layered Control System For A Mobile Robot.” IEEE Journal of Robotics and Automation, 2(1):14-23, 1986.(精读存档 `原始文章\03i-Brooks-Subsumption-1986.pdf`)
[**prs1987**] Georgeff, M. P. & Lansky, A. L. “Procedural Reasoning.” AAAI-87, pp. 151-155, 1987. 详见 [blog-02](blog-02-bdi-theory-to-engineering.md)。
[**ferguson1992**] Ferguson, I. A. “TouringMachines: An Architecture for Dynamic, Rational, Embedded Agents.” PhD Thesis / Technical Report UCAM-CL-TR-273, University of Cambridge, 1992, 219 pages.(精读存档 `原始文章\03j-Ferguson-TouringMachines-1992.pdf`,剑桥官方技术报告完整版,正文 206 页,约 52 万字符。引用页码均按 TR 版标注。三层并发原话、censor/suppressor 门控原话、”由设计者雕琢”唯一性保证原话、”层间无严格层级化控制流”原话、”计划仅被当作行动的资源”原话、”包裹式类包容控制框架”自述、”静态的编译时方案”+”只能算前智能”自评局限,均出自此档。)
[**muller1993**] Müller, J. P. & Pischel, M. “INTERRaP: An Architecture for Behavior-Based Agents.” DFKI Research Report, 1993, 109 pages.(精读存档 `原始文章\03k-MullerPischel-INTERRAP-1993.pdf`,DFKI 研究报告版,约 29 万字符。两大件结构原话、四子模块原话、”称职驱动”原话、”模块间通信与 agent 间通信基本同一套言语行为式原语”原话、”把智能从规划移入执行”原话、FORKS 实验数字均出自此档。)
[**muller1995**] Fischer, K., Müller, J. P. & Pischel, M. “Unifying Concepts in DAI and MAS: From the Individual to the Organization.” ICMAS-95, pp. 251-262, 1995.(三通用函数 BR/SG/PS 分层实例化、”分层 BDI”判定成立但非原文自封、”各层虽按层级排列激活却并发工作”原话、Müller 亲笔横/纵划界均见此短文。)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] KQML、FIPA、JADE 协议史:Agent 互操作失败全记录与 MCP/A2A 预测
https://www.paddysun.top/archives/5145 · 2026-09-02
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 7 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) **阅读时间**:约 19 分钟
---
# 智能体如何找到彼此:一份自称”非官方”的规范,和它延宕三十年的修复
1993 年,美国 ARPA 知识共享计划(Knowledge Sharing Initiative,KSI)发布了一份规范草案,试图回答一个在今天看来仍然紧迫的问题:两个智能体(agent)如何找到对方、如何知道对方能做什么、如何向对方发出请求并获得应答?彼时合同网已经跑了十三年([合同网](https://www.paddysun.top/?p=5132)),STEAM 和 ARCHON 正在让团队协作系统互相交换承诺([联合意图部署](https://www.paddysun.top/?p=5140))。它们都默认了一件事:agent 之间得有一门共同的语言。KSI 打算把这门语言造出来。
这个问题的答案催生了 KQML(Knowledge Query and Manipulation Language)。但这个故事最耐人寻味的细节,藏在四年后一份修订提案的摘要页上。1997 年 2 月,Labrou 和 Finin 向 UMBC 提交了技术报告 TR CS-97-03,报告的第一句话是:
> “This document is not the official new KQML specification. It is intended as a proposal for a new KQML specification and the authors welcomes any comments.” ——本文档不是官方的新 KQML 规范。它只是一份新规范的提案,作者欢迎任何评论。kqml-97
一项走了四年的“标准”,到 1997 年仍然自称“非官方”。同一时期,大西洋彼岸一个名叫 FIPA 的组织已经在 1996 年成立,并在 1997 年发布了第一套正式规范,把 KQML 的通信词表收敛为更小、更有形式语义的 FIPA ACL。1999 年,意大利 CSELT 实验室的 Bellifemine 团队发布了 JADE(一个 FIPA 合规的 Java 中间件),并在首尔的 FIPA 会议上接受了跨平台互操作的现实检验。这篇文章讲述的,就是从 KQML 的 36 个 performative 到 FIPA 的三件套(AMS/ACC/DF)再到 JADE 的中间件接管这条“智能体找到彼此”的规范演化线。
把这条线放进时间轴,可以看到两个标准化努力的错身而过,以及三十年后的重演:
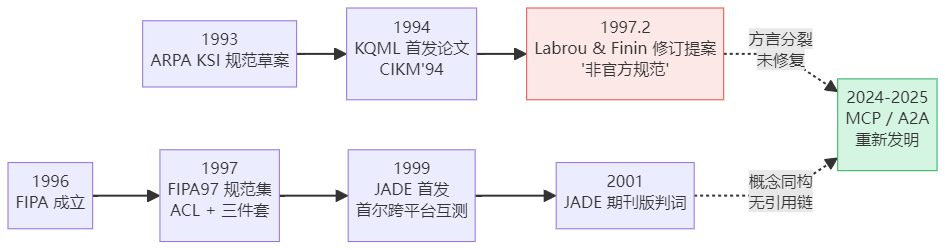
图中最关键的一笔是那条虚线:KQML 阵营与 FIPA 阵营在同一时间窗口并行推进、互不回应,方言分裂由此生根;而修复——真正的修复——要等到三十后 LLM 内核登场才在实验里第一次跑通。我们将看到:通信语言可以被做成可操作的词表,但对 agent 内部推理零假设:“能找到对方”不等于“能理解对方”。这正是 A2A 与 MCP 在今天重新面对的东西。
## 1993 年的问题:没有老板的网络上,请求该发给谁
KQML 的诞生可以追溯到 1993 年 ARPA 知识共享计划发布的技术报告。这份报告定义了一种“agent 通信语言”,核心思想是:agent 之间的通信应当像言语行为(speech act)一样:不只是传递信息,而是在说出一句话的同时执行一个行为(请求、告知、承诺)。1994 年,Finin 等人在 CIKM’94 的 IIA Workshop 上发表了《KQML as an Agent Communication Language》,这是 KQML 的首发公开论文kqml-94。此后 Labrou 和 Finin 持续修订规范,最终在 1997 年 2 月以 UMBC 技术报告 TR CS-97-03 的形式提交了完整的修订提案kqml-97。
这份提案开篇就明确了它与 1993 年原版的关系:
> “Our starting point for the specification of KQML is [1]. Although the differences regarding the syntax of KQML messages and the reserved performative parameters are minimal, there are significant changes regarding the set of reserved performatives, their meaning and intended use.” ——我们对 KQML 规范的起点是文献 [1]。尽管 KQML 消息语法和保留 performative 参数的差异极小,但保留 performative 集合、它们的含义和预期用法都有显著变化。kqml-97
语法几乎没变,词表和语义却大动。这意味着 KQML 在 1993 到 1997 年间经历了实质性的概念演化。而这恰恰发生在 FIPA 已经成立、即将发布自己 ACL 规范的同一年。时间窗口的错位,为后文的方言分裂埋下了全部伏笔。
## 36 个词、三层分离:KQML 给”找到彼此”立的结构
KQML 规范的核心架构是三层分离:消息包、内容语言、本体,各管一段。
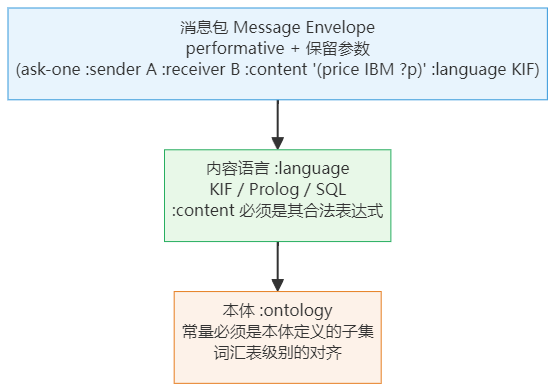
这张分层图的要害在于:通信语言(performative + 参数)与内容表示(:language + :content)完全解耦。一个 agent 可以用 KQML 的 `ask-one` 消息包裹 Prolog 查询、KIF 公式或 SQL 语句。协议不关心内容是什么语言写的,只关心“这是一个询问”。消息包本身采用 ASCII Lisp 前缀语法,关键字参数次序无关(P6 BNF),保留参数 9 个:`:sender :receiver :from :to :in-reply-to :reply-with :language :ontology :content`。
词表则是 36 个保留 performative,按三类组织:
类别数量performative语义定位Discourse18ask-if, ask-all, ask-one, stream-all, eos, tell, untell, deny, insert, uninsert, delete-one, delete-all, undelete, achieve, unachieve, advertise, unadvertise, subscribe“最接近语言学意义上的言语行为”(P9 原话)——信息交换与知识操作Intervention and Mechanics7error, sorry, standby, ready, next, rest, discard会话流控与错误处理——”standby 把应答时机的控制权转移给发送方”(P28)Facilitation and Networking11register, unregister, forward, broadcast, transport-address, broker-one, broker-all, recommend-one, recommend-all, recruit-one, recruit-allfacilitator 专用——”不是纯粹意义上的言语行为”(P34)
在复现仓 `../acl-protocol-reproduction/` 的 `kqml_message.py` 里,这个结构被逐字翻译成了 `KQMLMessage` 类:
```
class KQMLMessage:
# Discourse 类 18 个——"最接近语言学意义上的言语行为"(P9 原话)
DISCOURSE: Set[str] = {
"ask-if", "ask-one", "ask-all", "tell", "deny",
"achieve", "advertise", "subscribe", ...
}
# Facilitation and Networking 类 11 个——facilitator 专用
FACILITATION: Set[str] = {
"register", "unregister", "forward", "broadcast",
"broker-one", "recommend-one", "recruit-one", ...
}
ALL_PERFORMATIVES = DISCOURSE | INTERVENTION | FACILITATION # 共 36 个
# FIPA ACL 扩展——cfp 等,KQML 36 原语中无对应
FIPA_EXTENSION: Set[str] = {"cfp", "propose", "refuse", ...}
```
注意最后一个集合:`cfp`(call for proposal,招标)、`propose`、`accept-proposal` 这些词不在 KQML 的 36 原语之内。KQML 词表里最接近“招标”语义的只有 broker/recruit 家族(委托代理与招募),“招标”要到 FIPA 侧才成文。勿把 FIPA 词表反向投射到 KQML,这是核对这段历史时最容易犯的错。
KQML 最有穿透力的设计,是 advertise 的承诺结构。P23 原话:
> “the :sender commits to process the whole embedded advertise message if the sender receives it” ——发送者承诺:一旦收到其 advertise 的那种消息,就处理这条完整的嵌入消息。kqml-97
一个 agent 向 facilitator 发送 advertise,意味着它立下了一个“处理嵌入消息”的承诺;而 facilitator 的特殊地位让这个承诺即刻升格:”an advertise to a facilitator is an advertise to the community”(向 facilitator 的 advertise 就是对整个社区的 advertise)kqml-97。撤回同样干脆:unregister “automatically cancels all the commitments made by the agent in the past, i.e., all advertise messages sent by the agent to the facilitator become invalid”(自动取消该 agent 过去做出的全部承诺,其发给 facilitator 的所有 advertise 消息一并失效)kqml-97。发布 → 依赖 → 撤回,一个完整的承诺生命周期。这是“意图即承诺”([意图即带承诺的选择](https://www.paddysun.top/?p=5118))在通信层的直接实现,也与 STEAM 的联合意图在概念上同构:两者都是“通过说一句话来创造一个约束未来行为的承诺”([联合意图部署](https://www.paddysun.top/?p=5140))。
facilitator 还区分了三个中介家族,各自的应答路径不同:
中介原语行为应答路径broker-one/all全程代理:facilitator 以自己名义转呈请求,再用 forward 包裹把应答送回应答经 facilitator 转回recommend-one/all只荐不代:把匹配 agent 的 advertise 信息转发给请求者请求者自己联系被推荐方recruit-one/all招募第三方直接应答原发者“responses will be directed back to the issuer”(P41)
但 KQML 没有给出“何时该用 broker 而非 recruit”的选择算法,这是规范层的一个空白,后文的实验会专门回来拷问它。Wooldridge & Jennings 笔下 agent 的“社会性”([何为 Agent](https://www.paddysun.top/?p=5128))在这里第一次获得了可计算的形式:36 个词里,Facilitation 类 11 个专门用于“找到对方”,Discourse 类 18 个用于“与对方交谈”——社会学概念被做成了可操作的词表。
## “本文档不是官方的新 KQML 规范”
回到那句摘要页上的自我声明。这不是一句谦辞,它自供的是 KQML 这套体系的一个结构性问题:规范始终停留在“提案”阶段,从未走过正式的标准化组织程序。这与一年后发布的 FIPA97 形成鲜明对比:后者是一个有组织背书的、以规范编号管理的正式标准体系。
还有一个细节:这份 1997 年 2 月的提案全文(含 3 条参考文献:ARPA KSI 1993 规范、Finin et al. CIKM’94、Labrou 1995 博士论文)无一字提及 FIPA。也就是说,在 FIPA 已经成立半年到一年的时点上,KQML 阵营仍在自我修订,并未回应那个即将收敛自己词表的竞争者。两个标准化努力在同一个时间窗口内并行推进,却互不相知(或互不回应),这是方言分裂的温床。
没有权威词表约束,不同实现自然各自选择子集、各自命名。这在复现仓里只需要几行代码就能一比一复现:`agent.py` 中每个 `ACLAgent` 持有一个 `supported_performatives` 集合,收到不在集合内的 performative 就直接拒绝理解:
```
agent_a.supported_performatives = {"ask", "tell", "advertise", "broker"}
agent_b.supported_performatives = {"query", "reply", "register", "recommend"}
```
让方言 A(KQML 风格的 ask/tell/advertise/broker)与方言 B(另一套词汇 query/reply/register/recommend)互发消息,运行 `main.py` 的实验 2,输出是:
```
============================================================
实验2:方言分裂(KQML 从未定版的失败模式)
============================================================
方言A performatives: {'advertise', 'tell', 'broker', 'ask'}
方言B performatives: {'query', 'recommend', 'register', 'reply'}
A 发送 ask → B 理解: False
B 发送 query → A 理解: False
>> KQML 至 1997 年仍无权威定版——方言分裂导致互操作失败
>> JADE 跨平台互测失败归因: FIPA 规范中不完整的定义所导致的实现失配
```
两个方向都返回 `understood: False`:A 不认识 B 的 `query`,B 不认识 A 的 `ask`。这不是工程失误,而是“从未定版”的必然推论:当规范以提案形式存在、词表没有权威约束时,方言分化是系统的默认走向。语义上完全对等的两个词,因为拼法不同而互相视为乱码——这个失败模式值得记住,它会在三十年后以新的形态重现。
## 1996 年的另一种答案:FIPA 把 facilitator 拆成三件套
FIPA(Foundation for Intelligent Physical Agents)于 1996 年成立,是一个以瑞士为基地的非营利组织,目标是“促进异构 agent 系统之间的互操作”。它的策略与 KQML 阵营截然不同:**快速标准化**:1997 年即发布 FIPA97 规范集,其中第 2 部分定义 FIPA ACL,第 29 部分定义 Contract Net 交互协议;**形式语义**:FIPA ACL 的每个 communicative act 都有 feasibility preconditions(可行前置条件)和 rational effect(理性效果)的形式定义;**合规认证**:定义”Agent Platform”(AP)概念并规定三个强制组件,使合规可以被检验。
第三个强制组件清单,正是对 KQML 单一 facilitator 角色的规范化拆分:
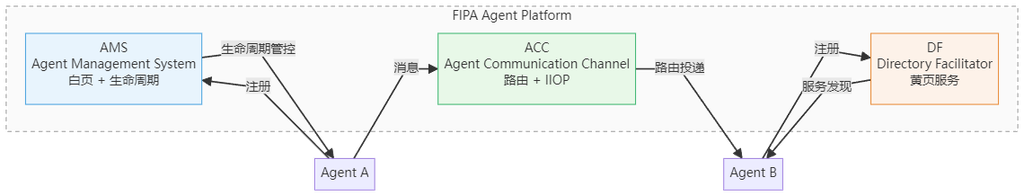
JADE 2001 期刊版给出了每个组件的原话定义 jade-2001:
- **AMS**(Agent Management System):”exerts supervisory control over access to and use of the platform; it is responsible for maintaining a directory of resident agents and for handling their life cycle”——对平台访问与使用施加监督控制,维护常驻 agent 目录并处理其生命周期。白页(名字→地址)加生命周期。
- **ACC**(Agent Communication Channel):”provides the path for basic contact between agents inside and outside the platform … a reliable, orderly and accurate message routing service. FIPA97 mandates ACC support for IIOP”——提供平台内外 agent 基本联系的通道,一个可靠、有序、精确的消息路由服务,且强制支持 IIOP。
- **DF**(Directory Facilitator):”passes on yellow page services”——提供黄页服务。
KQML 的 facilitator“涵盖名字服务器、代理 agent、broker 等一切特殊服务”(P45),一个角色包打天下;FIPA 把这些角色拆开、分别组件化、各自规范化:名字归 AMS,发现归 DF,路由归 ACC。
FIPA 合规的定义本身就是一份设计哲学宣言。JADE 期刊版原话:
> “only the external behaviour of system components should be specified, leaving implementation details and internal architectures to platform developers. In fact, the internal architecture of JADE is proprietary even if it complies with the interfaces specified by FIPA.” ——只应规范组件的外部行为,把实现细节和内部架构留给平台开发者。实际上,JADE 的内部架构是专有的,尽管它符合 FIPA 规定的接口。jade-2001
> “an e-mail based platform, a CORBA based one, a Java multi-threaded application, etc. could all be FIPA compliant implementations” ——基于电子邮件的平台、基于 CORBA 的平台、Java 多线程应用,都可以是 FIPA 合规实现。jade-2001
也就是说,FIPA 合规只关心三件事:你有没有 AMS/ACC/DF 三组件?它们的行为是否符合规范?你的消息格式是否符合 FIPA ACL?至于你内部用什么数据结构、什么推理引擎、什么调度策略,FIPA 不管。
对 KQML 与 FIPA ACL 的关系,JADE 期刊版给出了一句经典判词:
> “The syntax of the ACL is very close to the widely used communication language KQML. However, despite syntactic similarity, there are fundamental differences between KQML and ACL, the most evident being the existence of a formal semantics for FIPA ACL which should eliminate any ambiguity and confusion from the usage of the language.” ——ACL 的语法与广泛使用的 KQML 非常接近。但尽管语法相似,两者存在根本差异,最明显的是 FIPA ACL 拥有形式语义,这应当能消除语言使用中的任何歧义与混淆。jade-2001
形式语义的直接收益是:每个 communicative act 都”allows a communicative act to be scheduled and planned as a normal action”(允许一个通信行为像普通动作一样被调度和规划)jade-2001。但 JADE 同时指出了互操作的另一个关键条件:
> “a shared communication language is not the only element required to support inter-operability … common agent services and ontologies are also needed” ——共享通信语言不是支撑互操作的唯一要素……还需要公共 agent 服务与本体。jade-2001
KQML 之败不止在语义缺失,还在只有语言没有公共服务:一个 agent 光会说 KQML 是不够的,还需要知道去哪里找其他 agent(目录服务)、如何编码内容(本体)。
FIPA 不止定义原语,还定义了交互协议(Interaction Protocol)——预设的消息序列模板:
协议流程对应 KQML?fipa-requestrequest → agree/refuse → inform/done有(achieve/insert 类)fipa-queryquery → agree/refuse → inform有(ask 族)fipa-contract-netcfp → propose/refuse → accept/reject-proposal → inform/done**无**(cfp 在 KQML 36 原语中无对应)fipa-iterated-contract-net多轮 contract-net无fipa-auction-english英式拍卖(递增出价)无fipa-auction-dutch荷兰式拍卖(递减出价)无
fipa-contract-net 是其中最著名的协议,它就是 Smith 1980 合同网协议在通信语言层的标准化smith-1980fipa-00029。Smith 定义了协议的概念与流程,FIPA 给它配上标准化的消息格式和 performative 名([合同网](https://www.paddysun.top/?p=5132))。这个四阶段流程在复现仓 `protocol.py` 的 `FIPAContractNetProtocol.run()` 里是几行直白的代码:
```
def run(self, task: str) -> None:
# 阶段1:initiator 广播 cfp
for p in self.participants:
cfp = KQMLMessage(performative="cfp", ..., content=task)
# 阶段3:initiator 评估报价,选择最优
winner_name = min(proposals, key=proposals.get) # 贪心取最低报价
# 阶段4:中标者执行任务,回复 inform
inform = KQMLMessage(performative="inform", sender=self.winner, ...)
```
真实运行输出(3 个参与者)如下,四阶段 9 条消息完成一次完整的招标-竞标-中标-交付:
```
[阶段1] initiator 广播 cfp(任务: task_compute_result)
initiator --cfp--> participant-0 / 1 / 2
[阶段2] 参与者回复 propose / refuse
participant-0 --propose(bid=50)--> initiator
participant-1 --propose(bid=27)--> initiator
participant-2 --refuse(overloaded)--> initiator
[阶段3] initiator 评估报价,发送 accept/reject
initiator --reject-proposal--> participant-0
initiator --accept-proposal--> participant-1
[阶段4] 中标者执行任务,回复 inform
participant-1 --inform(result(task_compute_result)=125)--> initiator
协议完成。中标者=participant-1, 报价=27
```
消息序列用时序图看更清楚:
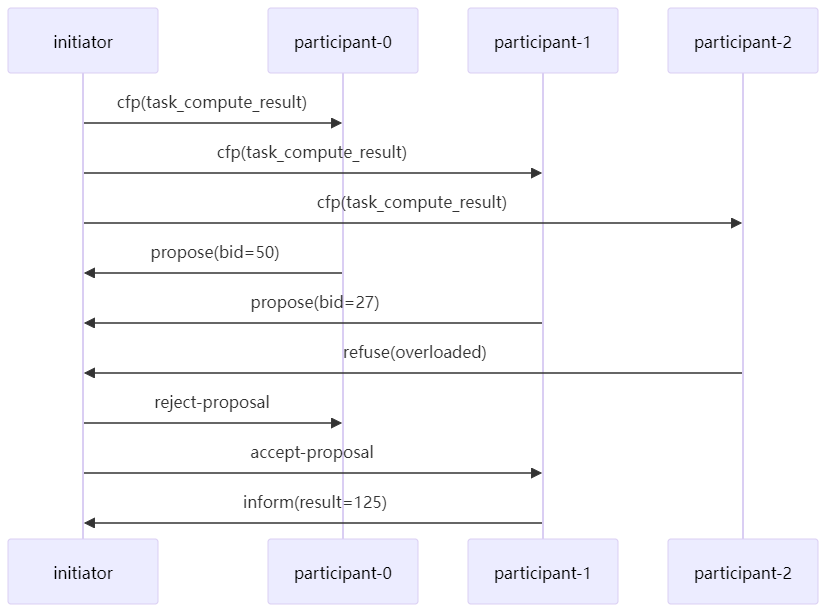
participant-2 因负载过重 refuse,participant-0 出价 50 被 reject,participant-1 以最低价 27 中标并交付。注意这里的 `min`:贪心取最低报价,正是[合同网](blog-04-contract-net.md)篇里那个囚徒困境的起点在 FIPA 侧的翻版。协议跑通了,但协议本身并不保证全局最优。
## 1999 年,首尔:规范第一次接受现实检验
1999 年,意大利 CSELT(Telecom Italia 的研究实验室)的 Bellifemine、Poggi 和 Rimassa 发布了 JADE(Java Agent DEvelopment Framework)的首个版本。JADE 是 FIPA97 规范的 Java 实现,一个中间件,“处理一切非 agent 内部特有的事务”jade-2001。它的出现使 FIPA 规范从纸面文件变成了可运行的代码。中间件的接管清单包括八项:FIPA AP 三组件随平台自启;平台跨主机分布(每主机一 JVM 容器);运行时可起多个 DF 构成多域联邦;ACL 消息即 Java 对象的 API;跨平台 IIOP 消息传输;平台内轻量对象传输(免序列化字符串化,“本地投递比 IIOP 快 30 倍以上”,约 10 ms);FIPA 交互协议库(成对 behaviour 类与协议图同构);管理 GUI(RMA/Dummy Agent/Sniffer,Sniffer 用“类似 UML 时序图的记法”跟踪消息)。
消息传输采用三级选路:
最关键的是 JADE 对认知内核的态度。P24 结论原话:
> “we produced a very general but primitive agent model that can serve as a useful basis to implement, for example, reactive or BDI architectures … sophisticated agent models such as BDI and reactive architectures … can be implemented on top of our ‘primitive’ agents model.” ——我们做出了一个非常通用但原始的 agent 模型,它可以作为实现反应式或 BDI 架构的有用基础……复杂的 agent 模型可以在我们的“原始”agent 模型之上实现。jade-2001
JADE 的中间件底座是消息传递 + 生命周期管理 + 目录服务。BDI 不是规范内容、不是中间件职责,只是“可以在 primitive 模型之上实现的一种架构”。1999 版甚至给出了实例:JessBehaviour 外挂 JESS 规则引擎,“JESS 扮演慎思角色、JADE behaviours 扮演反应角色”——推理内核是可插拔外件而非中间件职责。这与 AgentSpeak(L) 把 BDI 塞进解释器的努力正相对照([BDI 从理论到工程](https://www.paddysun.top/?p=5122)):一个把 BDI 做成语言语义,一个把 BDI 留给外挂,殊途同归地确认了 BDI 在工程中是“词汇”而非“架构”。
然后是首尔。JADE 的 2001 期刊版记录了一次关键的互操作实证:
> “At the beginning of 1999, during a FIPA meeting in Seoul, JADE participated in the inter-operability tests with some other FIPA compliant platforms (ASL of Broadcom, MECCA of Siemens and the agent platform of Comtec). The results … demonstrated that JADE is very near to offering full inter-operability with the other platforms passing a large part of the tests.” ——1999 年初,在首尔的一次 FIPA 会议上,JADE 与其他 FIPA 合规平台(Broadcom 的 ASL、西门子的 MECCA、Comtec 的 agent 平台)一起参加了互操作测试。结果……表明 JADE 非常接近与其他平台实现完全互操作,通过了大部分测试。jade-2001
“通过了大部分测试”——但不是全部。失败的原因值得玩味:
> “The failure on a few tests depended only on some incomplete definitions in the then current FIPA specifications that caused implementation mismatches among different platforms.” ——少数测试的失败仅归因于当时 FIPA 规范中一些不完整的定义,它们导致了不同平台间的实现失配。jade-2001
失败的根源不在 agent 的认知能力,而在 FIPA 规范自身的定义不完整。这是一个深刻的信号:即使有了正式标准化组织、有了形式语义、有了参考实现,互操作仍然可能因为规范中的歧义和空白而失败。方言分裂换了身衣服(从“词不认识”变成“定义不完整”),失败模式本质相同。
把 KQML、FIPA+JADE 与当代 LLM Agent 放在同一张 BDI 坐标表上,这条线的位置一目了然:
维度KQML 1997FIPA+JADE 2001LLM Agent 2026信念(Belief)零假设——对 agent 内部知识表示无约束零假设——”primitive agent model”,BDI 可外挂参数统计分布 + system prompt + RAG愿望(Desire)零假设——performative 不约束目标结构零假设——交互协议定义消息序列,不约束目标用户指令 / task description意图(Intention)advertise 承诺结构——”发送者承诺处理嵌入消息”fipa-request/contract-net 协议模板ReAct 循环的 action 序列社会性facilitator 社区 + 跨域联邦AMS 白页 + DF 黄页 + 多域联邦A2A 协议 + MCP 工具注册承诺机制advertise/unregister 闭环fipa-request 的 agree/refuse + 合同网的 accept/rejecttool call 的 success/error 回调认知内核位置不涉及——语言规范独立完备“可在此之上实现”——外挂件LLM 即内核
红色标注的“信念/愿望”位置在 KQML 和 JADE 中都是零假设或外挂,直到 LLM 时代,agent 才第一次有了内置的认知内核。但社会性和意图的通信层形式化,三十年间几乎原封不动地从 KQML 传承到了 A2A/MCP。
## 方言分裂的修复与代价:把语义让给内核
KQML 的 facilitator 是怎么“匹配”请求与承诺的?答案是:performative 精确匹配。`facilitator.py` 里 `find_matching` 的基线逻辑只有一行核心:`self._registry.get(performative)`,按词面查注册表。这就是 KQML 规范的全部匹配语义:词对上了就匹配,词对不上就失败。方言分裂因此无解——除非有一个能读懂“ask 和 compute 是一回事”的内核。
**2026 新增 A/B 对照实验**就换掉了这一个组件。`Facilitator` 留了一个实验钩子,基线 = 精确匹配(逐字节不变的确定性古代机制),变体 = LLM matcher:
```
# E3 实验钩子: 外部匹配器
# (performative, content, ontology, all_ads) -> ranked [Advertisement]
# None = 原行为(performative 精确匹配——KQML 规范的全部匹配语义)
self.matcher = matcher
def find_matching(self, performative, content=None, ontology=None):
if self.matcher is not None: # E3 变体:语义让渡
all_ads = [adv for bucket in self._registry.values() for adv in bucket]
return self.matcher(performative, content, ontology, all_ads)
bucket = self._registry.get(performative, []) # 基线:词面精确匹配
...
```
LLM matcher 收到的系统提示,把“让渡”二字写得明明白白(`ab_experiment.py`):
```
MATCH_SYSTEM = (
"You are the semantic matching module of a KQML facilitator. Agents "
"from different dialect domains send requests (performative + content); "
"service agents registered advertisements in THEIR OWN dialect ... "
"Match the request to the single best service agent by MEANING, "
"not by performative spelling. "
)
```
场景是双域方言分裂:请求方用 A 方言(ask/query/achieve/stream-all),服务方用 B 方言(compute/serve/reply/process/stream/enquire)注册 advertise,正是上一节实验 2 那道“ask 对 compute”的死结。8 个请求带 ground truth,10 轮独立抽样(模型 deepseek-chat,温度 0.3),结果如下:
配置匹配成功率中介策略一致率失败模式(匹配)基线(performative 精确匹配)0/8—(KQML 自认无选择算法)dialect_misread×8LLM matcher80/80(10 轮 × 8 例)7/8 × 10 轮correct×80
方言差异(ask 对 compute/serve)对精确匹配是致命的:0/8,方言分裂一比一复现;对 LLM 内核是透明的:80/80,含两次同类服务的内容级区分(两个算术请求都命中 mathsvc,而非同以 compute 注册的 textsvc:词表一样,模型靠读内容描述分开了它们)。KQML 原文自认缺失的“何时该用 broker 而非 recruit”选择算法,LLM 以 7/8 稳定补位,唯一持续分歧是“高并发查询绕开 facilitator”一例(LLM 选 recommend,标注 recruit;两读皆通,属标注歧义而非模型错误,如实记录)。代价侧同样要记录:
指标值判定调用160 次(匹配 80 + 策略 80),0 错误prompt / completion tokens30,590 / 6,615总 tokens**37,205**
**“语义让给模型、协议只管语法”在此获得正面实证**(判决见 [blog-09 6.4 节](https://www.paddysun.top/?p=5160)):语义让渡不是免费的,它把协议层的确定性换成了模型层的概率性加 token 成本。FIPA 在 1997 年买不起这个内核:彼时最强的外挂推理件是 JESS 规则引擎,读不懂“ask 和 compute 是一回事”;MCP 在 2024 年买得起。原始数据存于 `experiment_results/ab_e3_acl_facilitator.json`。这一买一买不起之间隔着什么,正是下一节要正面回答的问题。
## MCP 为何活,A2A 是否重蹈 FIPA
> **编者注**:本节为 2026 年新增的预测性内容,不属于源文章的历史记述。MCP 与 A2A 的一手规范存档不在本系列精读档案内,本节的事实性陈述基于截至 2026 年的公共知识(标注 `[可引证事实]`,非档案精读),全部评价性结论均为作者判断(标注 `[作者判断]`)——请按此分层取舍。
先把 KQML/FIPA 这条线的死因复盘清楚。四条,每条都出自本文前半部分已经核过的历史证据:
1. **`[可引证事实]` 词表无权威定版,方言分裂。** KQML 至 1997 年 2 月仍自称“非官方规范”,提案全文对 FIPA 一字不提;两个标准化努力并行互不回应。没有权威 performative 集合,实现各自选子集、各自命名。实验 2 的 ask/query 互不认识(0/8)就是这个局面的最小复现。
2. **`[可引证事实]` 规范定义不完整,实现失配。** JADE 首尔互测中少数测试的失败,JADE 自己归因于“当时 FIPA 规范中一些不完整的定义”导致的平台间实现失配。正式组织、形式语义、参考实现三样俱全,纸面空白照样让互操作翻车。
3. **`[可引证事实]` 只有语言,没有公共服务。** JADE 判词明言:共享通信语言不是互操作的唯一要素,还需要公共 agent 服务与本体。KQML 侧 facilitator 是一个“涵盖一切特殊服务”的含混角色;目录、发现、生命周期没有强制组件,服务侧的欠账最终由 FIPA 三件套和 JADE 中间件来补。
4. **`[可引证事实]` 语义住在协议层,认知内核空缺。** FIPA ACL 的形式语义(feasibility preconditions + rational effect)只规范“何时说这句话是合理的”与“说了有何理性效果”,不规范化“收到这句话后该怎么理解和行动”;KQML 连 broker 与 recruit 之间怎么选都自认空白。语义负担全部压在一个规范不假设、多数实现不具备的认知内核上,而 1997 年市面上根本没有能买的内核,JESS 读不懂方言。
两代协议把“语义”放在哪一层的分野,可以画成一张对比图:
> **作者判断**:MCP 的活法,可以逐条对着上面四条死因来看。`[可引证事实]`(公共知识):MCP 由 Anthropic 于 2024 年 11 月发布并同步开源规范与官方 SDK,建于 JSON-RPC 之上,服务端核心原语是 tools/resources/prompts 三类,2025 年被多家主流厂商(含 OpenAI)采纳。
1. **`[作者判断]` 对死因一——实现先行,规范跟着代码走。** MCP 发布之日起就有一个跑得动的参考实现和官方 SDK,词表小(三个服务端原语),由单一维护者快速迭代版本。KQML 的方言温床是“提案无权威、各家自选子集”;MCP 把权威性锚在参考实现上:fork 规范容易,fork 一个能连上所有客户端的实现很难。
2. **`[作者判断]` 对死因二——不发明传输层,以“跑通为准”代替纸面完整。** FIPA 自立 IIOP 门户,结果规范空白直接变成实现失配;MCP 直接建在 JSON-RPC 与 HTTP 等成熟设施上,互操作的准绳是“能不能连上参考实现”,而不是“定义是否无懈可击”。定义有空白时,参考实现就是事实标准,首尔式的失配被这个机制短路了。
3. **`[作者判断]` 对死因三——发现机制内置协议,三件套由宿主承担。** tools/list 这类发现原语是协议自身的一部分;目录、生命周期、权限管理由宿主应用(如桌面端产品)承担。相当于把 AMS/DF 从规范附件变成产品功能:用户不需要“部署一个合规平台”才有目录服务,装一个宿主就有。
4. **`[作者判断]` 对死因四——语义让渡给内核,且 2024 年买得起内核。** tool 的描述是自然语言,由 LLM 读了就懂;协议只管 JSON Schema 级的语法。这正是 E3 实验验证过的分层(80/80 对 0/8,代价 37,205 tokens)。FIPA 1997 买不起这个内核,MCP 2024 买得起。这不是设计者更聪明,是时代给了他们一个当年不存在的零件。
> **作者判断**:A2A 的风险评估,则要对照 FIPA 的轨迹逐段看。`[可引证事实]`(公共知识):A2A 由 Google 于 2025 年 4 月发布,核心构件 Agent Card 是“能力声明 + 发现端点”,同年内移交 Linux Foundation 中立治理。
1. **`[作者判断]` 委员会化的词表风险。** A2A 从第一天起就是多厂商联合标准,这正是 FIPA 的起点队形。各家 Agent Card 的字段集、技能词汇、能力描述粒度若没有一致性测试兜底,“ask/query 互不认识”会以“JSON 字段互不认识”的形态重演:方言分裂不死,只是换了字符集。
2. **`[作者判断]` 规范先于社区成熟的风险。** FIPA 的教训是形式漂亮的规范敌不过跑通为准。A2A 若在协议层堆积语义细节,比如为能力声明规定形式化的前置条件,就是把语义重新塞回协议层,重走 FIPA 死因四的老路。
3. **`[作者判断]` 内核异构的理解风险。** 即使语法完全对齐,两端 LLM 不同,对同一张 Agent Card“能力”的理解仍可能失配。E3 的 80/80 是同一模型做匹配的结果;跨异构内核的语义对齐没有实验保证,“能找到对方”与“能理解对方”的裂缝,在内核也异构时会重新张开。
也有有利差异:A2A 发布即有参考实现与多家厂商接入,治理转入中立基金会,且其定位刻意薄:只管 agent 间消息与发现、不规定内部架构,与 FIPA“只约束外部行为”的哲学一脉相承(这一脉也是 FIPA 做对了的部分)。
> **作者判断**(收束判断):判断 A2A 命运的试金石不是规范质量,而是两条——有没有一个买得起 LLM 内核的生态位,以及守不守得住“语法归协议、语义归内核”的分层。若 A2A 开始在协议层规定语义细节,则重蹈 FIPA;若守住薄协议加厚内核,则避开 KQML/FIPA 的死法。MCP 已用两年时间验证了后一条路可行——但验证窗口短、样本只有一族内核,这个判断本身也应当按作者判断折价。唯一确定的是:KQML 用 36 个词提出的问题,MCP 和 A2A 仍在用 JSON 字段回答,而答案的正确性,从规范层移到了内核层。
## 诚实边界:这条线真正抵达了哪里
按“有引证才说”的原则,这条线的影响谱系分三级列出。**强引证**(直接引用链):
影响路径引证强度证据ARPA KSI 1993 → KQML 1997强Labrou & Finin TR CS-97-03 摘要明言”starting point is [1]” kqml-97KQML → FIPA ACL 语法强JADE 2001 原话”ACL syntax is very close to KQML” jade-2001FIPA97 → JADE强JADE 全程对标 FIPA97 规范,P3 明言”FIPA97 specifications” jade-2001Smith 1980 合同网 → FIPA cfp强FIPA00029 Contract Net IP 直接命名”contract net” fipa-00029FIPA97 AP → JADE AMS/ACC/DF强JADE P3 逐组件引用 FIPA 规范定义 jade-2001
**中强引证**(同一团队与直接演化):
影响路径引证强度证据KQML facilitator → FIPA AMS/DF中强JADE 论断”AMS/DF = KQML facilitator 的规范化拆分”为社区共识,KQML 侧无 FIPA 提及JADE → JESS 外挂 BDI中强JADE 1999 版实例,”JESS 扮演慎思角色” jade-2001FIPA97 → FIPA2000中强FIPA 规范版本演进,JADE 2001 期刊版仍对标 FIPA97KQML advertise → A2A Agent Card中强概念同构(能力声明 + 发现),但无直接引用链
**中等引证**(概念传承):
影响路径引证强度证据KQML performative → A2A/MCP中概念传承(言语行为式通信),无直接引用FIPA DF 黄页 → MCP Tool Registry中概念同构(服务发现),无直接因果链JADE behaviour 树 → 现代 agent 框架中概念传承(协议即图),但现代框架多直接从 LLM 出发FIPA IIOP → HTTP/gRPC中传输层范式变迁,概念不同构
然后是边界。KQML 没有直接影响到神经网络和深度学习,通信语言规范与连接主义无因果链;FIPA 规范没有直接影响到 Transformer 架构,注意力机制与言语行为理论无关联;JADE 的 IIOP 消息传输与当代 LLM Agent 的 HTTP API 调用没有技术继承关系。KQML/FIPA 的影响主要通过“通信语言标准化”→“agent 框架”→“当代 A2A/MCP 协议”这条间接路径延续;当代 A2A 协议的 Agent Card 在概念上与 KQML 的 advertise + facilitator 同构,但没有可追溯的直接引用链,A2A 的设计者大概率没有读过 Labrou & Finin 1997。还有一条引用纪律:KQML 阵营在 1997 年 2 月时点未提及 FIPA,两个标准化努力的交汇是社区共识性凝练,不能引 KQML 1997 提案为“KQML→FIPA 收敛”叙事的原始证据;FIPA ACL 对 KQML 的“收敛”判断出自 JADE 2001 期刊版(二级出处),而非 KQML 原文。
这条线最深的局限,是一句 Bar-Hillel 式的判词:**“能找到对方”不等于“能理解对方”**。KQML 给了 36 个词,但没给“何时该用 broker 而非 recruit”的选择算法:知道有三种中介方式,不知道什么条件下选哪种,选择负担完全落在它不假设的认知内核上。这就像给了一本字典但没有语法书:你知道每个词的意思,但不知道怎么造句。FIPA ACL 补了形式语义(语法书),但形式语义只规范“说这句话在什么条件下合理”与“理性效果是什么”,不规范“收到这句话后该怎么理解和行动”。JADE 首尔互测的失败揭示了规范层的空白;而即使规范完美无缺,两个 agent 用同一个 cfp 通信,它们对 :content 的理解仍取决于各自的认知内核:1999 年是外挂的 JESS,2026 年是内置的 LLM。协议的选择和中介策略的决策比消息传递本身难得多,而 KQML 把前者留给了它不假设的认知内核。这个批评在 E3 实验里得到了正面的(也是昂贵的)回应:内核终于存在了,但每次理解都要按 token 计费。
三十年后回看这条线:W&J 的社会性概念在 36 个词表里第一次获得可计算形式,Smith 的合同网在 fipa-contract-net 里第一次获得标准消息名,STEAM 与 ARCHON 的通信需求是 KQML 最初的工程动因;而方言分裂与互测失配这两种失败模式,正是 A2A 与 MCP 的前史([意图编辑权](https://www.paddysun.top/?p=5160))。Dochkina 等人的通信协议三要素(消息格式、服务发现、交互协议)在 KQML/FIPA 体系中一一对应,也将在 A2A/MCP 时代完整成立,只是每项的技术实现从 Lisp 语法换成了 JSON Schema([自组织的实证与治理悖论](https://www.paddysun.top/?p=5167))。1993 年那份草案问“两个智能体如何找到彼此”,KQML、FIPA 与 JADE 用三十三年给出了一半答案:找到彼此,靠规范;理解彼此,靠内核。前一半在 1999 年的首尔已经大体跑通,后一半,到今天仍在按 token 计价。
## 参考文献
[**kqml-97**] Labrou, Y. and Finin, T. (1997). “A Proposal for a new KQML Specification.” UMBC Technical Report TR CS-97-03.(存档 `原始文章\03n-Finin-KQML-1994.pdf`,文件名标 1994 但内容实为 1997.2 修订提案)
[**kqml-94**] Finin, T. et al. (1994). “KQML as an Agent Communication Language.” Proc. CIKM’94 IIA Workshop.
[**jade-2001**] Bellifemine, F., Poggi, A. and Rimassa, G. (2001). “Developing multi-agent systems with a FIPA-compliant agent framework.” *Software: Practice and Experience*, 31(2):103-128. [https://doi.org/10.1002/spe.420](https://doi.org/10.1002/spe.420)
[**fipa-00029**] FIPA. “FIPA00029 Contract Net Interaction Protocol Specification.” FIPA97 Specification, Part 29. [https://www.fipa.org/specs/fipa00029/](https://www.fipa.org/specs/fipa00029/)
[**smith-1980**] Smith, R. G. (1980). “The Contract Net Protocol: High-Level Communication and Control in a Distributed Problem Solver.” *IEEE Trans. Computers*, C-29(12):1104-1113. [https://doi.org/10.1109/TC.1980.1675596](https://doi.org/10.1109/TC.1980.1675596)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 多 Agent 冲突仲裁三方案:均衡约定、PERSUADER 劝说与行为抽象
https://www.paddysun.top/archives/5136 · 2026-09-02
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 5 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [合同网](https://www.paddysun.top/?p=5132) **阅读时间**:约 15 分钟
---
# 三种仲裁:合同网留下的冲突,与三个互不相识的答案
上一篇的结尾停在一个尴尬的场景上:两个管理者同时看中了同一个承包者。Davis 和 Smith 在合同网论文第 11.4 节亲口承认,“全局最优不一定由局部最优拼接而来”,脚注 22 干脆直接命名:“这像是囚徒困境的一种”contractnet-limitcontractnet-pd。协议能走完招标、投标、成交的全部流程,却回答不了一个更根本的问题:当匹配权的竞争是真冲突时,谁说了算?管理者无权裁决利益冲突,节点又被预设为自愿合作——合同网把最难的那一步留在了协议外面。
1988 到 1990 年,三篇论文从三个互不相同的方向撞上了这同一个缺口。卡内基梅隆的 Katia Sycara 造了一个扮演劳工调解人的程序 PERSUADER,不裁决谁对谁错,只用先例和劝说论据动态改写双方的效用结构。希伯来大学的 Gilad Zlotkin 和 Jeffrey Rosenschein 把博弈论整个搬进协商,证明均衡策略本身就是约定,根本不需要外部仲裁者。马萨诸塞大学的 Edmund Durfee 与 Thomas Montgomery 让机器人在六维行为空间里识别潜在冲突,逐级下钻消解。三种答案,三种仲裁形态,构成本篇的主角。
本篇沿着这三条线依次走完,最后合观一个直到今天仍然扎人的发现:这三种机制,连同它们试图修补的合同网,没有一种能摆脱设计期的人工预设。
## 缺口:自愿投标的节点,从来没被问过”为什么”
先回到缺口本身。合同网的核心假设写在论文第一页——它研究的是“由分散且松耦合的问题求解器集合进行的合作解题”(the cooperative solution of problems by a decentralized and loosely coupled collection of problem solvers)contractnet-coop。节点“从自身视角评估信息”,但投标本身被预设为自愿行为:协议从不追问节点为什么投标、投多高、什么时候宁愿不投。
Zlotkin 和 Rosenschein 在 1989 年把这一点挑明了:
> “Smith’s work on the Contract Net introduced a form of simple negotiation among cooperating agents, with one agent announcing the availability of tasks and awarding them to other bidding agents. While Smith’s original work assumed some autonomy among agents, these agents willingly bid for tasks without explicit motivation.” ——Smith 的合同网引入了一种合作 agent 间的简单协商,一个 agent 宣告任务的可获得性并授予投标的 agent。Smith 的原始工作虽假设 agent 有某种自主性,但这些 agent 不带明确动机地自愿投标。zr-critique
“不带明确动机的自愿投标”,这句批评的分量在于它点出的是一块空白,而非 bug:合同网没有动机模型。论文自己给出的数字例(第 11.4 节 Fig.19)把这个空白具象化了:两个管理者 A、B 和两个承包者 X、Y,A 的视角里 X 评 0.9、Y 评 0.8,B 的视角里 X 评 0.8、Y 评 0.2。双方都想要 X,但全局更优的分配是 A 接受 Y、把 X 让给 B。局部最优拼不出全局最优,协议本身解决不了,只能靠信息交换的代价权衡兜着contractnet-pd。
这就是三篇论文共同的起点。三年之内,三个团队各自交卷:
这张时间线上的三个分支回答的是同一个问题——矛盾建议谁仲裁。PERSUADER 的答案是第三方调解,Z&R 的答案是协议内生均衡,D&M 的答案是分层行为协调。加上合同网本身的招标裁决(管理者仲裁),四种形态并列,才构成 1983-1990 年“谁仲裁”问题的完整答案谱系。下面按时间倒着讲也许更顺,但按“离博弈论最近”的顺序讲更清楚:先看 Z&R 如何用效用计算取代自愿姿态,再看 PERSUADER 如何反过来批评效用计算本身,最后看 D&M 如何绕开效用 altogether。
## 均衡即约定:Z&R 给自愿投标补上效用动机
Zlotkin 和 Rosenschein 的论文《Negotiation and Task Sharing Among Autonomous Agents in Cooperative Domains》发表于 IJCAI-89,页码 912-917zr-paper。此处需要一条署名勘误:论文署名 Zlotkin 在前、Rosenschein 在后(Gilad Zlotkin, Jeffrey S. Rosenschein,Hebrew University),而通行文件名以 RosenscheinZlotkin 命名、顺序相反。引用按论文实际署名顺序标注。论文开篇就给自己的位置定了调:
> “This paper imports game theoretic techniques into an analysis of multi-agent negotiation, in a way analogous to Malone’s introduction of economic theory to the Contract Net.” ——本文把博弈论技术引入多 agent 协商分析,其方式类似于 Malone 把经济学理论引入合同网。zr-import
类比很精确:Malone 给合同网补了市场机制,Z&R 要给协商补上博弈论。而且他们没有走博弈论的现成大道——连续域和完全信息这两条标准假设被明确弃置,转而研究“离散域且 agent 只有部分信息”的情形,理由很实际:后者对人工智能更有意义。
Z&R 区分了合作域与非合作域。合作域“总存在至少一个能维持或增加每个 agent 孤立效用的交易”;非合作域“每个 agent 单干反而更好,加入群体只为处理干扰而不得不压低效用”zr-domain。要点在于,即便是合作域,个体利益冲突仍是分析的轴心——每个 agent 全程按自身效用计算,双赢是定理的结论,无须预设善意。核心机制有三件:协商集 NS 收拢所有个体理性且帕累托最优的交易,Theorem 2 保证它非空(总有双赢空间),Theorem 3 保证协议下有限步收敛;Zeuthen 策略让 agent 用主观概率估计对方是否会坚守上一报价,只在坚守的期望收益大于让步损失时才不让步,Extended Zeuthen Strategy 在均衡中(Theorem 5)。
于是有了全文最重要的那句论断——**均衡即约定**:
> “if it were commonly known that the said strategy was being built into automated agents, no one could benefit by choosing a different strategy for their own agent.” ——若该策略内置于自动化 agent 成为公共知识,则没有任何人为自己的 agent 改选别的策略能获益。zr-convention
矛盾如何裁决?不需要外部仲裁者。均衡策略本身就是约定(convention):单方偏离无益。谈崩了也有可信兜底——冲突交易(conflict deal),即各送各的信,”no agent will agree to deliver any letters other than his own”(没有任何 agent 会同意投递除自己以外的信)zr-conflict。整条协商流程可以这样看:
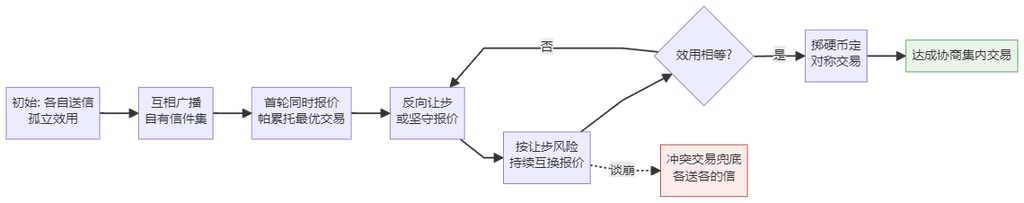
图里最要紧的是右下角那条虚线:协商的每一步都悬在“谈崩”的悬崖边上,而悬崖底下不是深渊,是冲突交易这个可信回落。正因为各干各的是一个真实存在的坏结局,让步才有分寸,约定才立得住。
### 撒谎分析:协议设计如何封死有利谎言
Z&R 还做了一件更细的事:分析撒谎的激励。在纯交易下,藏信(hiding letters,隐瞒自己持有的信件)是“安全谎言”(”it is a ‘safe’ lie—it will never be discovered”,永远不会被发现)且有利,效用 6 对诚实的 4;幻影信(phantom letters,伪造不存在的信)同样安全有利,效用 4 对诚实的 3。但在混合交易下,幻影信可能被要求交付给对方而暴露。Theorem 9 的原话:
> “when negotiating on mixed deals there never exists a beneficial safe lie” ——在混合交易上协商时,永远不存在有利的安全谎言。zr-theorem9
我们在复现仓里用数字示例验证了这条定理(完整代码在 `../persuader-negotiation-reproduction/`)。程序对三种交易类型逐一检查有利的安全谎言是否存在,输出如下:
```
pure_cooperative:
有利谎言存在: True
说明: 纯交易下藏信是安全谎言 (效用6 vs 诚实4), 永远不会被发现
pure_competitive:
有利谎言存在: True
说明: 纯交易下幻影信安全且有利 (效用4 vs 诚实3), 但非合作域冲突交易为兜底
mixed:
有利谎言存在: False
说明: 混合交易下幻影信可能被要求交付给对方而暴露,
不存在有利的安全谎言 (Theorem 9)
>> 结论:在混合交易上协商时,永远不存在有利的安全谎言
```
三行输出讲了一个完整的机制设计故事:纯交易下两种谎言都安全有利——藏信净赚 2,幻影信净赚 1;切到混合交易,有利谎言的存在标志直接翻成 False。协议设计本身就是防背叛机制:选择纯交易还是混合交易,直接决定 agent 能否靠撒谎获利,不需要外部审计来盯梢。这一层洞察,即把激励封进协议结构而非依靠监督,会在十年后以 FIPA 交互协议的形态重新出现,此是后话。
## 效用重写:PERSUADER 做一个不裁决的调解人
Z&R 用博弈论批评合同网的时候,Sycara 的 PERSUADER 已经先批评了整个 AI 界。这篇发表于 AAAI-88(页码 245-250)的论文开篇就开火persuader-paper。此处需要一条替代说明:目标文献本应是 Sycara 发表于 EJOR 46(2) 1990 的期刊长文,经 OpenAlex 核验为 closed access 无 OA 副本,按预案退用 AAAI-88 会议版:同一个 PERSUADER 系统,机制三件套一致。两条批评一针见血:
> “AI work has focused primarily on fostering cooperation and avoiding goal conflicts.” ——AI 工作主要聚焦于促进合作、回避目标冲突。persuader-critique
> “In environments where cooperative behavior of the agents cannot be assumed, goal conflicts have to be resolved by finding compromises.” ——在无法假设 agent 合作行为的环境里,目标冲突必须通过寻找折中来解决。persuader-compromise
更锋利的是对博弈论路线的批评:”no attempt is made to influence other agents’ utilities and payoffs, i.e. the dynamics of negotiation is ignored”,没人试图影响其他 agent 的效用与支付,协商的动态被忽略了persuader-dyn。在 Sycara 看来,真实协商的动态恰恰是不断改变对方的效用:你劝我让一步,不是在固定支付矩阵前选策略,而是让我重新估量这一步对我的价值。Z&R 假设效用给定再求均衡,PERSUADER 直接把”改写效用”做成算法。
角色设定写得很清楚:
> “the PERSUADER, a program which, acting as a labor mediator, enters in negotiation with each of the parties, the union and company, proposing and modifying compromises and utilities until a final agreement is reached.” ——PERSUADER 是一个扮演劳工调解人的程序,与工会和公司双方分别进入协商,提出并修改折中方案和效用,直到达成最终协议。persuader-mediator
领域知识来自两位执业联邦调解人——一位参与开发、一位做非正式验证persuader-expert。注意这个措辞:调解人(mediator),不是仲裁人(arbitrator)。PERSUADER 的核心特征是**不裁决**——它不宣判谁对,只用机制让“之前不是解的方案后来变成解”。机制有三件:案例推理(CBR)以 contracts、impasses、arguments 三个焦点检索先例,成功案例存入 memory 复用,僵局连同失败原因存储以警示;偏好分析基于多属性效用理论,准则为”maximizes the joint payoff of the agents and minimizes the payoff difference”(联合收益最大化加收益差最小化,效率与公平兼顾);劝说式论据则是招牌:说服某人可以被建模为提高该方案对他的收益。
### 信念结构:把对方的目标画成一张 DAG
三件机制里最独特的是第三件,而它的核心数据结构是信念结构。原文写道:
> “The PERSUADER’s model of a persuadee’s goals is a directed acyclic graph, called a belief structure. It is searched and updated during argument generation. The nodes are goals with the associated importance, utility value, and desired direction of change. The arcs represent the percent contribution of a goal to each of its ancestor goals.” ——PERSUADER 对被劝说方目标的建模是一个有向无环图,称为信念结构。它在论据生成过程中被搜索与更新。节点是目标,附有重要性、效用值和期望变化方向;边表示一个目标对每个祖先目标的贡献百分比。persuader-belief
在复现仓(`../persuader-negotiation-reproduction/`,含 `persuader/belief_structure.py`、`persuader/case_library.py`、`persuader/negotiator.py` 三个模块)里,工会的信念结构是这样搭起来的,数字忠实于原文的 trace——工会 wage_goal 重要性 6,employment 重要性 8persuader-trace:
```
bs = BeliefStructure("工会信念结构")
bs.add_node("wage_raise", importance=6, direction="increase")
bs.add_node("employment", importance=8, direction="increase")
bs.add_node("pension", importance=5, direction="increase")
bs.add_node("outsourcing", importance=7, direction="decrease")
# 因果边: wage_raise -> labor_cost -> production_cost -> employment
bs.add_edge("wage_raise", "labor_cost", 0.4)
bs.add_edge("labor_cost", "production_cost", 0.6)
bs.add_edge("production_cost", "employment", -0.5)
```
看这几个数字的用意:wage_raise 沿因果链向上爬——加薪推高劳动成本(+0.4)、劳动成本推高生产成本(+0.6)、生产成本反过来削减雇佣(-0.5)。劝说算法就藏在这张图的爬升里。`find_pivot` 是论据生成的核心,从被拒绝的议题出发,沿因果边向祖先传播,找一个重要性更高的目标节点当支点:
```
def find_pivot(self, source_goal):
source_importance = self.nodes[source_goal].importance
ancestors = self.get_ancestors(source_goal) # BFS 向祖先传播
for ancestor in sorted(ancestors, key=lambda n: self.nodes[n].importance, reverse=True):
if self.nodes[ancestor].importance > source_importance:
return ancestor, self.trace_path(source_goal, ancestor)
return None
```
论据生成的关键示例是原文那句”If the company is forced to grant higher wage increases, then it will decrease employment”,若公司被迫给予更高加薪,就会削减雇佣。算法从 wage_raise 出发,沿 `wage_raise → labor_cost → production_cost → employment` 传播到 employment,发现它的重要性 8 大于 wage 的 6,支点成立,论据生成。翻译成人话就是:“你坚持的这一条,会伤到你自己更在乎的那一条。”这不再是讨价还价,而是劝说——它不改变议题本身,改变的是议题在对方效用结构里的权重。
Sycara 把这个过程命名为**动态问题空间**:
> “The negotiation process itself is a search of a dynamic problem space where an agent’s beliefs about other agents’ beliefs over the cycle of proposals continuously changes the space being searched. What was not a solution at one point becomes a solution at a later point.” ——协商过程本身是对一个动态问题空间的搜索,agent 关于其他 agent 信念的信念在提案循环中持续改变着被搜索的空间。之前不是解的方案,后来变成了解。persuader-dynamic
如果劝说失败、折中被拒,修理准则兜底:修复须让反对者的收益增量大于此前赞成者的收益损失,否则不收敛。这一条保证调解人有路可走,但注意它没有硬兜底——不像 Z&R 有冲突交易,谈崩了 PERSUADER 只能一直修下去。
### Getaway 算例:三个 agent 如何达成一致
PERSUADER 论文里的完整算例是 Getaway 运输公司罢工谈判:工会要 15% 涨薪、7% 养老金、零外包;公司要 0%、0%、无限外包persuader-getaway。协商器扮演调解人,与工会、公司两方构成三个 agent,依次执行 CBR 检索、财务约束检查、主动提醒检验、劝说式论据生成和偏好分析。运行 `main.py` 的完整输出:
```
============================================================
实验1:Getaway 算例——工会 vs 公司
============================================================
工会要求: {'wage_raise': 15, 'pension': 7, 'outsourcing': 0}
公司出价: {'wage_raise': 0, 'pension': 0, 'outsourcing': inf}
[轮次 1] 初始折中生成 -- CBR 检索
CBR 检索先例: Bluehound 运输公司合同 (12%/5%/无限外包)
先例方案: 涨薪 12%, 养老金 5%, 外包 unlimited
适配后: 涨薪 12.9%, 养老金 5.6%, 仅超额工作可有限外包
[轮次 2] 财务约束检查
检索财务数据: 3 年连亏 4%
应用启发式: 降幅=亏损百分比之半
降幅 = 亏损百分比之半 = 2%
涨薪 12.9% -> 10.9%
[轮次 3] 主动提醒检验 (intentional reminding)
检索到先例: 外包无时限申诉先例
失败原因: 工会曾因外包无时限提出申诉
修复: 在外包条款加时间限制
外包条款: limited_with_time_limit
[轮次 4] 劝说式论据生成
论据: "若公司被迫给予更高加薪, 就会削减雇佣
(wage_raise -> labor_cost -> production_cost -> employment)"
信念传播路径: wage_raise -> labor_cost -> production_cost -> employment
工会 wage_raise 重要性(6) < employment 重要性(8), 论据成立
[轮次 5] 偏好分析 -- 联合收益最大化 + 收益差最小化
工会效用: 15.63
公司效用: 4.00
联合收益: 19.63
收益差: 11.63
协商结果: {'wage_raise': 10.9, 'pension': 5.6,
'outsourcing': 'limited_with_time_limit'}
使用先例: ['Bluehound 运输公司合同 (12%/5%/无限外包)',
'3年连续亏损4%案例', '外包无时限申诉先例']
劝说论据数: 1
```
五个轮次就是机制三件套的一次完整合奏:CBR 检索到 Bluehound 同区先例(12%/5%)适配成 12.9%/5.6%;查到 3 年连亏 4% 的财务数据,应用“降幅=亏损之半”的启发式砍到 10.9%;主动提醒检验翻出外包无时限曾引发申诉的僵局先例,给外包条款加上时间限制;然后是全场的支点——劝说论据沿信念图传播,employment 的 8 压过 wage 的 6,论据成立;最后偏好分析给出联合收益 19.63、收益差 11.63 的收尾核算。论文原文的最终涨薪是 9%,复现是 10.9%,差异来自先例适配的启发式简化:原文用行业竞争地位和地区工资差做领域推理,复现用 70% 先例加 30% 需求的线性插值代替。这个差异我们会在文末的边界清单里如实展开。
## 行为抽象:D&M 只广播行为的轮廓,冲突才下钻
第三种答案来自完全不同的场景:分布式机器人。Durfee 和 Montgomery 的论文《A Hierarchical Protocol for Coordinating Multiagent Behavior》发表于 AAAI-90,页码 86-93。此处需要一条页码勘误:通行引文标注 88-95 有误,实际页脚印刷页码为 86-93dm-paper。
核心概念是**行为抽象层级**(behavior abstraction hierarchy),定义走的是先否定再肯定的路线——“它不是计划层级……也不是目标层级”,然后正面给出:“行为层级涵盖计划与目标层级,因为它表征做什么与怎么做,还有谁、何时、何地、为何”dm-behavior。六个维度:做什么(what)、怎么做(how)、谁(who)、何时(when)、何地(where)、为何(why)。
这里必须划一条关键界线,划错了整篇论文就会被误读。“行为抽象层级”是协调协议中**通信内容的抽象层级**——agent 之间交换什么信息、以多粗的粒度交换;它不是 agent 内部的分层架构——agent 内部如何组织与此无关。Ferguson 的综述甚至把本篇归入审慎式架构一节,这是分类错误:本系列把 D&M 归入协调协议线,而非架构线,不得称为分层混合架构的代表。这条界线在讲 TouringMachines 的那一篇还会再遇到。
协议流程反而简单。agent“盲播最抽象的行为信息而非计划细节”(blindly broadcast the most abstract behavior information rather than plan details),在六维空间中定位自己的行为区域,“区域重叠或邻近即可识别潜在交互”dm-protocol。发现潜在负交互时二选一:沿行为维度修改自身行为避开,或者下钻一层——更细的层面可能发现“看似冲突实则无冲突”。整个循环长这样:
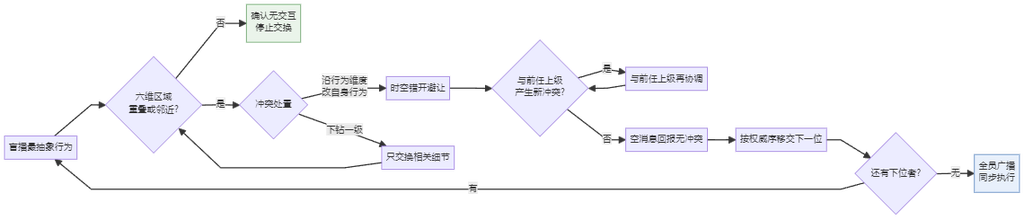
图里藏着协议的全部经济性:左上角那个循环是“问一句最粗的问题,多数情况就此打住”;只有区域重叠才付出细节交换的代价,而权威序的移交机制(图右半)保证了发现冲突后总有裁决出口。出口的裁决依据是预设权威值——已实现版本给每台机器人唯一权威值并按全序轮流做上下级,动态权威分配在 1990 年还只是 future work。这一点先记下,结尾要用。
实验数字来自 MICE 测试床加 GBB 黑板的 36 组实验,把协调粒度与通信代价的权衡量得清清楚楚dm-experiment。无协调时两机器人“在门口永久碰撞”;仅抽象层协调,2 条消息即无冲突,但完全串行,Done=51;细节层协调 16 条消息,Done=101——细协调的通信与推理开销反噬了总时长;而无冲突情形完全不协调反而最优,Done=27。结论落在一句朴素的话上:“不同情形应在不同层级消解冲突”,单层级协议做不到。D&M 对 PGP(部分全局规划)的继承与超越也写在明处:原文说“部分全局规划被我们的新协议包含”;PGP 依赖静态组织知识规定“该与谁交换计划”,本协议“不假设此类知识”dm-pgp。而行为六维与 Malone 1987 人类组织分解方向的对应,为后来的 TAEMS 系统埋了线。这条线在谱系一节再展开。
## 谁仲裁、凭什么、谈崩了怎么办
三种机制到这里都出场了,加上它们共同回应的合同网,四种仲裁形态可以放进同一张表里对勘:
维度Z&R 均衡约定PERSUADER 效用重写D&M 行为抽象层级**谁仲裁**无外部仲裁者,协议内生均衡第三方调解者(mediator,非 arbitrator)预设权威值全序(动态权威为 future work)**依据什么**个体效用计算 + Zeuthen 策略案例先例 + 信念结构 + 偏好分析行为六维空间区域重叠**谈崩了怎么办**冲突交易(各干各的)作可信兜底修理准则保证收敛;无硬兜底沿行为维度修改避开,或按权威序裁决**防背叛机制**Theorem 9:混合交易封死安全谎言劝说论据改变对方效用结构盲播最抽象信息减少信息泄露
(合同网的形态是第四种:招标裁决,由管理者用投标评估程序裁决,谈崩没有兜底,没人投标任务就完不成。)
三种机制并不互斥,它们回答的是不同层面的问题:Z&R 回答“在效用已知、目标良定义的合作域中如何达成帕累托最优交易”;PERSUADER 回答“在效用不精确可知、目标欠定的真实冲突中如何找到可接受折中”;D&M 回答“在分布式机器人中如何用最小通信量识别和消解行为冲突”。换到 BDI 坐标上看更清楚:合同网在**意图层**仲裁,管理者裁决意图承诺的归属;Z&R 在**信念层**仲裁,均衡策略作为公共知识构成约定;PERSUADER 在**愿望层**仲裁,调解者改写对方效用,改写效用就是改写愿望;D&M 也在**信念层**仲裁,行为描述的抽象层级控制着信息交换的粒度。四种形态在 BDI 三轴上各占一格,正好把“谁仲裁”问题铺满。
但把四格铺满不等于把问题解决。这张表里还有一列没被追问:表头写着“依据什么”,而每一种依据(效用函数、信念结构、六维坐标)是从哪里来的?这是 Bar-Hillel 之刺要扎的地方。
## Bar-Hillel 之刺:效用、信念、维度,全在设计期就装好了
本系列惯用的那把检验刀,在此再磨一次:
> “一个理论的语义解释力,取决于它能把多少不可观察的内部状态映射到可观察的行为上。如果一个理论需要预设不可观察的内部状态作为前提,那么这些前提本身就需要被解释。”
**Z&R 的博弈论协商要求效用函数已知**。但“如何从无限事实中构造效用函数”正是前提选择问题。Z&R 在四条假设中明确列出了 EXPECTED UTILITY MAXIMIZER 和 COMPLETE KNOWLEDGE:agent 是期望效用最大化者且拥有完全知识zr-assumptions。可现实中 agent 的效用函数从何而来?从信念、目标、偏好的无限事实中构造一个标量效用函数,这本身就是一次设计期的人工选择。Z&R 证明的是“给定效用函数后均衡存在”,但效用函数的构造(信念到效用的映射)是一个未被形式化的黑箱。Theorem 9 说“混合交易下不存在有利的安全谎言”,前提是 agent 对交易类型的分类(纯交易还是混合交易)本身是公共知识——这个分类从何而来?如果 agent 对交易类型的信念不一致,Theorem 9 的安全保证就失效。
**PERSUADER 的劝说式论据需要信念结构作为支点**。但“哪些信念节点是对方的支点”需要理解对方的内部状态。信念结构是调解人“建模被劝说方的目标”,可调解人如何知道对方的目标重要性?原文的答案上文已经给过:两位执业联邦调解人做领域专家persuader-expert。这等于说,信念结构是设计期注入的,不是运行时学到的。PERSUADER 证明的是“给定信念结构后论据生成有效”,但信念结构本身(“employment 重要性 8 > wage 重要性 6”)是从哪里来的?如果对方的真实重要性排序与调解人建模的不同,论据就会失效——你说服了一个不存在的信念结构。
这不是假设性的担忧,复现代码可以当场演示。
> **编者注**:以下反例为本篇新增的验证实验,代码取自复现仓的 `BeliefStructure`,仅调换两个节点的重要性数字,因果边与算法均未改动。
同一张因果图,换一个真实排序为“工资高于饭碗”的工会——wage_raise 重要性 8、employment 重要性 6,边的贡献系数一概不变:
```
bs = BeliefStructure("工会信念结构(真实排序反例)")
bs.add_node("wage_raise", importance=8, direction="increase")
bs.add_node("employment", importance=6, direction="increase")
# 因果边不变: wage_raise -> labor_cost -> production_cost -> employment
```
运行 `find_pivot("wage_raise")`,返回 `None`——祖先节点里重要性最高的是 employment 的 6,压不过源节点的 8,支点不成立,论据生成直接失败。而同一个函数跑在调解人建模的那张 DAG 上(wage 6、employment 8),返回的是 employment 支点和完整的传播路径。这就是“效用函数预设了仲裁结果”的实证:劝说能否成立,在信念结构写下的那一刻就已经定了——算法只是在 DAG 里把设计者装好的数字读出来。Getaway 算例的“成功劝说”,成功的从来不是算法,是那两个数字的排序。
**D&M 的行为抽象层级需要“用什么维度描述行为”是设计者预先选定的**——六维(what/how/who/when/where/why)是人为选择的描述框架,原文没有论证为什么是这六个维度而非五个或七个。“区域重叠即识别潜在交互”依赖六维空间的坐标系定义。如果两个行为的“why”维度不同但在其他五维重叠,它们是否冲突?D&M 的回答取决于设计者如何定义“重叠”。这又是一次前提选择。
**三篇合观的结论**:1990-1995 的实现里,完全不依赖设计期预设的仲裁机制并不存在。Z&R 预设了效用函数,PERSUADER 预设了信念结构,D&M 预设了行为维度。真正的动态仲裁,即效用元推理(agent 自己反思自己的效用函数从何而来)、学习层(agent 从交互中学习对方的信念结构)、动态权威分配(agent 运行时协商谁做仲裁者,而非依赖预设全序),在三篇原文中全部位于 future work。Z&R 的 NO HISTORY 假设(每次协商独立)直接排除了学习;PERSUADER 的信念结构由领域专家提供,排除了运行时学习;D&M 的动态权威分配“列为进行中的工作”,但 1990 年的实现版本全靠预设权威值全序。那句“之前不是解的方案后来变成了解”听上去很动态,可让方案变成解的那个支点,从第一天起就没动过。
## 谱系回响:报价协议、论据协商与任务结构
批评归批评,这三种机制的影响是实打实的,而且各走各路。引证强度按本系列惯例分级。
**强影响**:Z&R 的报价/让步协议流入 FIPA 的 propose/accept-proposal/reject-proposal 交互协议。Z&R 的同时报价、每步至少一方让步的协议结构,直接进入 FIPA 1997 规范集的交互协议定义——FIPA Contract Net Interaction Protocol(FIPA00026)和 FIPA Request Interaction Protocol(FIPA00037)中的 propose/accept/reject 循环,正是 Z&R 报价/让步谱系的标准化形态fipa-00026fipa-00037。
- FIPA Contract Net Interaction Protocol: [https://fipa.org/specs/fipa00026/](https://fipa.org/specs/fipa00026/)
- FIPA Request Interaction Protocol: [https://fipa.org/specs/fipa00037/](https://fipa.org/specs/fipa00037/)
**中强影响**:PERSUADER 的劝说式论据机制流向论据协商(Argumentation-Based Negotiation)。“说服某人可以被建模为提高该方案对他的收益”这一思想,影响了 Sierra、Jennings 和 Parsons 1998 年提出的论据协商模型;信念结构(DAG)的搜索与更新机制,为后来论据协商中论据的生成与评估提供了框架abn-1998。
- Parsons, Sierra & Jennings 1998, “Agents that Reason and Negotiate by Arguing”: [https://dl.acm.org/doi/10.1145/3005624.3005683](https://dl.acm.org/doi/10.1145/3005624.3005683)
**中等影响**:D&M 的行为抽象层级埋线 TAEMS 任务结构建模。D&M 原文将行为六维与 Malone 1987 人类组织分解方向对应,这一对应为 Decker 1995 年的 TAEMS(Task Analysis and Environment Modeling System)系统埋下伏笔——TAEMS 把任务间关系建模为 enable/facilitate/hinder 等质量关系,继承了“不同情形应在不同层级消解冲突”的核心思想taems。
- Decker & Lesser 1995, “Environment Centered Analysis and Design of Coordination Mechanisms”: [https://doi.org/10.1016/0004-3702(95)00037-2](https://doi.org/10.1016/0004-3702%2895%2900037-2)
把三路影响和四种仲裁形态画在一张图上,谱系的形状就出来了。下图保留自本系列的研究底稿,从“谁仲裁、依据什么、谈崩了怎么办、防背叛”四个切口并置三种机制:
三种仲裁机制对比Z&R 均衡约定PERSUADER 效用重写D&M 行为抽象层级谁仲裁无外部仲裁者协议内生均衡策略谁仲裁第三方调解者(mediator, 非 arbitrator)谁仲裁预设权威值全序(动态权威为 future work)依据什么个体效用计算Zeuthen 策略Theorem 5: 策略均衡依据什么案例先例 (CBR)信念结构 (DAG)劝说论据找支点依据什么行为六维空间区域重叠检测逐级下钻交换细节谈崩了怎么办冲突交易兜底各送各的信谈崩了怎么办修理准则保证收敛反对者增量 > 赞成者损失谈崩了怎么办沿行为维度避让或按权威序裁决防背叛Theorem 9:混合交易封死安全谎言防背叛劝说论据改写对方效用结构防背叛盲播最抽象信息减少信息泄露
图上三列并置,读法是纵向对比而非横向排名:每一列在四个切口上的答案,就是它的仲裁形态全部。这个谱系在系列里还有几处后续。对[上一篇的合同网](https://www.paddysun.top/?p=5132)而言,囚徒困境缺口(第 11.4 节 Fig.19)由这三种仲裁补足,合同网的招标裁决只是四种形态之一。对[智能体如何找到彼此](https://www.paddysun.top/?p=5153)一篇,Z&R 的报价/让步谱系流入 FIPA 的 propose/accept/reject 之后,FIPA 的言语行为类型学就不只是消息格式标准化,更是协商协议的可证均衡收敛:Theorem 3(有限步收敛)和 Theorem 5(策略均衡)为 FIPA 交互协议提供了博弈论地基。对[反应与慎思的和解](https://www.paddysun.top/?p=5160)一篇,D&M 的“行为抽象层级”必须与 TouringMachines 的三层并发结构划清界限:后者是 agent 内部的控制分层(反应层/规划层/建模层),前者是 agent 之间的通信内容分层,一个回答“agent 内部如何组织”,一个回答“agent 之间交换什么”。对[意图编辑权](https://www.paddysun.top/?p=5160)一篇,四种仲裁形态是意图编辑权分担在冲突消解面的展开:合同网把编辑权交给管理者,Z&R 交给协议(策略内置于所有 agent),PERSUADER 交给调解者(改写对方效用即改写对方意图),D&M 交给行为维度(沿维度修改行为即修改意图)。而对[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)一篇,Dochkina 的 Sequential 机制将是第五种仲裁——涌现式自主弃权。前四种都依赖设计期预设;Sequential 展示的是运行时涌现的权威分配:agent 通过观察对方的弃权行为动态推断谁该做仲裁者,无需预设。
## 复现的边界:这次简化了什么
按系列惯例,复现的每一条简化都要摊开在结尾。第一条,先例适配简化:原文用行业竞争地位和地区工资差做领域推理得到 11%/4%,复现用 70% 先例加 30% 需求的线性插值得到 12.9%/5.6%,最终涨薪 10.9% 对原文的 9%,差异全部来自适配启发式的简化。第二条,信念结构预构建:原文的信念结构由两位执业联邦调解人提供领域知识,复现的信念结构是手工编码的固定 DAG;PERSUADER 原文的“动态问题空间”(信念结构在协商过程中被搜索与更新)在复现中仅实现了搜索(`find_pivot`),未实现动态更新。第三条,撒谎分析为示例性验证:Z&R 的 Theorem 9 是形式化证明,复现仅用数字示例(效用 6 对 4、4 对 3)做说明性验证,未复现形式化证明过程。第四条,D&M 未复现:本篇代码只复现了 PERSUADER 和 Z&R 两个机制,D&M 的行为抽象层级在文中描述但未编码实现,实验数字(2 条消息/16 条消息/Done 值)引自原文。
四条边界摆在一起,恰好和 Bar-Hillel 之刺的结论互为印证:复现越忠实,越能看清原文把什么做成了前提。Z&R 证明了给定效用函数后均衡存在,PERSUADER 证明了给定信念结构后论据生成有效,D&M 证明了给定六维坐标后冲突可分层消解——三篇论文各自把“仲裁”做成定理、算法、协议,也各自把最难的半步留在了设计期。1990-1995 年间,完全不依赖设计期预设的仲裁机制并不存在;下一次有人宣称解决了“谁仲裁”,值得先问一句:它的效用、信念和维度,是谁在什么时候装进去的。
## 参考文献
[**contractnet-limit**] Davis, R. & Smith, R.G. (1983). “Negotiation as a Metaphor for Distributed Problem Solving.” *Artificial Intelligence*, 20(1):63-109. 第 11.4 节,Fig.19 及脚注 22。
[**contractnet-coop**] 同上,第 1 节:”the cooperative solution of problems by a decentralized and loosely coupled collection of problem solvers.”
[**contractnet-pd**] 同上,脚注 22:”This appears to be a variety of the ‘prisoner’s dilemma’ problem.”
[**zr-paper**] Zlotkin, G. & Rosenschein, J.S. (1989). “Negotiation and Task Sharing Among Autonomous Agents in Cooperative Domains.” *IJCAI-89*, pp. 912-917. **署名勘误**:论文署名 Zlotkin 在前、Rosenschein 在后,文件名顺序相反。
[**zr-critique**] 同上,第 1.2 节:”these agents willingly bid for tasks without explicit motivation.”
[**zr-import**] 同上,第 1.3 节:”This paper imports game theoretic techniques into an analysis of multi-agent negotiation.”
[**zr-domain**] 同上,第 2.1 节脚注 1:合作域与非合作域定义。
[**zr-convention**] 同上,第 6 节结论:”if it were commonly known that the said strategy was being built into automated agents, no one could benefit by choosing a different strategy for their own agent.”
[**zr-theorem9**] 同上,第 5 节 Theorem 9:”when negotiating on mixed deals there never exists a beneficial safe lie.”
[**zr-conflict**] 同上,第 3.1 节:”no agent will agree to deliver any letters other than his own.”
[**zr-assumptions**] 同上,第 2.3 节四条假设:EXPECTED UTILITY MAXIMIZER / COMPLETE KNOWLEDGE / NO HISTORY / COMMITMENTS ARE VERIFIABLE。
[**persuader-paper**] Sycara, K. (1988). “Resolving Goal Conflicts via Negotiation.” *AAAI-88*, pp. 245-250. **替代说明**:目标 EJOR 46(2) 1990 期刊版经 OpenAlex 核验为 closed access 无 OA 副本,按预案退用 AAAI-88 会议版。
[**persuader-critique**] 同上,第 1 节:”AI work has focused primarily on fostering cooperation and avoiding goal conflicts.”
[**persuader-compromise**] 同上,第 1 节:”In environments where cooperative behavior of the agents cannot be assumed, goal conflicts have to be resolved by finding compromises.”
[**persuader-dyn**] 同上,第 1 节:”no attempt is made to influence other agents’ utilities and payoffs, i.e. the dynamics of negotiation is ignored.”
[**persuader-mediator**] 同上,第 1-2 节:”the PERSUADER, a program which, acting as a labor mediator, enters in negotiation with each of the parties.”
[**persuader-belief**] 同上,第 5.1 节:”The PERSUADER’s model of a persuadee’s goals is a directed acyclic graph, called a belief structure.”
[**persuader-trace**] 同上,第 5.1 节论据生成示例:工会 wage_goal 重要性 6,employment 重要性 8,8 > 6 故论据成立。
[**persuader-dynamic**] 同上,第 1 节:”The negotiation process itself is a search of a dynamic problem space… What was not a solution at one point becomes a solution at a later point.”
[**persuader-getaway**] 同上,第 4 节 Getaway 运输公司罢工谈判完整算例:工会要 15%/7%/零外包,公司要 0/0/无限外包。CBR 检索 Bluehound 先例 (12%/5%) → 适配 11%/4% → 查财务 3 年亏 4% → 降幅=亏损之半 → 9% → 外包条款加时限。
[**persuader-expert**] 同上,第 2 节:”We used two practicing Federal Mediators as experts: one for development and the other for informal validation.” 脚注 3:联邦调解人依法须销毁全部案卷。
[**dm-paper**] Durfee, E.H. & Montgomery, T.A. (1990). “A Hierarchical Protocol for Coordinating Multiagent Behavior.” *AAAI-90*, pp. 86-93. **页码勘误**:通行引文标注 88-95 有误,实际页脚印刷页码为 86-93。
[**dm-behavior**] 同上:”It is not the plan level… nor is it the goal level.” 正面定义六维:what/how/who/when/where/why。
[**dm-protocol**] 同上:”blindly broadcast the most abstract behavior information rather than plan details.”
[**dm-experiment**] 同上,实验结果:无协调时”在门口永久碰撞”;抽象层协调 2 条消息 Done=51;细协调 16 条消息 Done=101;无冲突不协调 Done=27。
[**dm-pgp**] 同上:”Partial Global Planning is subsumed by our new protocol.” PGP 依赖静态组织知识,本协议”不假设此类知识”。
[**fipa-00026**] FIPA Contract Net Interaction Protocol Specification (FIPA00026). [https://fipa.org/specs/fipa00026/](https://fipa.org/specs/fipa00026/)
[**fipa-00037**] FIPA Request Interaction Protocol Specification (FIPA00037). [https://fipa.org/specs/fipa00037/](https://fipa.org/specs/fipa00037/)
[**abn-1998**] Parsons, S., Sierra, C. & Jennings, N.R. (1998). “Agents that Reason and Negotiate by Arguing.” *AAAI 1998 Workshop on Negotiation. [https://dl.acm.org/doi/10.1145/3005624.3005683](https://dl.acm.org/doi/10.1145/3005624.3005683)
[**taems**] Decker, K.S. & Lesser, V.R. (1995). “Environment Centered Analysis and Design of Coordination Mechanisms.” *Artificial Intelligence*, 73(1-2):29-71. [https://doi.org/10.1016/0004-3702(95)00037-2](https://doi.org/10.1016/0004-3702%2895%2900037-2)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] STEAM 与 ARCHON:联合意图理论如何落地真实工业多智能体系统
https://www.paddysun.top/archives/5140 · 2026-09-01
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 6 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [三种仲裁](https://www.paddysun.top/?p=5136) **阅读时间**:约 17 分钟
---
# 联合意图部署:团队算子、遗留系统与一条 1997 年的通信公式
1997 年的一场直升机仿真里,编队中的一架先看到了坏消息:预定航路上出现了敌车,“飞行计划”这个联合行动恐怕已经不可实现。此刻它面对的问题不在战术,在社会——队友们还不知道。广播这条信念要占用带宽、要打断各自的执行;保持沉默,全队就可能一头撞进伏击。STEAM 给这一刻的答案是两条协议:先把“放弃”写成终止条件,再给“说不说”算一笔期望值。
这笔账(EV(通信) = λ(1-Pmt)·Cinc 对比 Cmt)是本文的主角之一,但不是全部。在它之前,Cohen & Levesque 刚刚把“意图”从个体扩展到团队;在它旁边,Jennings 的 ARCHON 正在葡萄牙电网和 CERN 加速器上包装没人敢动的遗留系统;比它更早,Ljungberg 和 Lucas 的 OASIS 已经在悉尼机场的仿真塔台上给每架进场飞机配了一个 agent。联合意图理论在 1992 到 1997 的五年间完成了三次性质迥异的部署:仿真、真实工业、空管。
本文讲这条部署线:团队算子如何把一个团队的承诺拆成机器能执行的原语,承诺如何被监控、如何在成员失败时重新规划,遗留系统如何被包进合作社区,以及 2026 年的那一段:当我们把那条 1997 年的公式里唯一“智能”的参数换成 LLM 时,发生了什么。
## 团队算子:把一个团队的承诺拆成机器能执行的原语
### 联合意图不是个体意图的拼盘
故事得从理论的缺口讲起。Cohen 和 Levesque 1990 年在 AIJ 上给出了个体意图的形式化定义:意图是对行动的持续性承诺,agent 在相信目标已达成或永不可达成之前不放弃 cl1990(这一形式化的来龙去脉见本系列[第 1 篇](https://www.paddysun.top/?p=5118))。但这篇论文的结论部分明确承认:多 agent 协调仍待完成。一年后,他们在 *Intentions in Communication* 中把个体意图扩展为联合意图——不是简单把 N 个个体意图拼在一起,是定义了一种新的承诺结构:团队作为一个整体承诺一个共同目标,任一成员若私有地相信该目标已完成、不可实现或不相关,即负有义务使全队相互相信这一事实。
STEAM 后来原话引用了这条理论条款(p87):
> 任一成员若私有地相信团队行动已完成、不可实现或不相关,即负有这样的义务——使团队相互相信该行动(最终)已完成、不可实现或不相关 steam-p87
这句话里藏着一个关键的新分支。“不相关”意味着动机不复存在——不是做不了,而是不该再做了。这把 C&L 1990 的二支放弃条件(believes achieved ∨ believes impossible)扩展为三支(completed ∨ unachievable ∨ irrelevant),为团队级承诺提供了完整的终止语义。联合意图的核心在“大家对彼此在做这件事有相互信念,且对终止条件有相互信念”,而不仅仅是“大家都在做同一件事”。后面我们会看到,这个“相互信念”正是全部麻烦的来源。
### 通用壳:约 40 个领域无关原语
1997 年,Milind Tambe 在 JAIR 上发表 *Towards Flexible Teamwork*,把联合意图理论工程化为一套可复用的团队工作框架。STEAM 的定位原话(p87)是”a generic shell for teamwork”(团队工作的通用壳),实现于 Soar 6.7.1,提供约 40 个领域无关原语 steam-p87。所谓“通用壳”,是说团队工作的机制(如何建立承诺、如何监控终止、如何通信)与领域知识(飞行计划、攻击目标)分离——换一个域,机制不动,只换计划内容。
这条分离线后来被反复验证。最有名的证据是战术修改机制(p109):领域专家要求避开航路敌车,Tambe 的回答是:
> 为团队算子[飞行计划]OR2 增加一个新的不可实现条件即已足够 steam-p109
加一条终止条件,就完成了一次战术修改,通用团队计划零改动。这句话的分量要到第 5 节才完全展开——它是“配置化优于改代码”这一模式在 1997 年的最早证词之一。
### 四个要素,三种分担方式
STEAM 的核心原语是团队算子(p90)steam-p90。一个团队算子定义一个联合活动,包含四个要素:**名称**(标识这个联合活动,如“飞行计划”)、**组合方式**(Φ / AND / OR,决定成员如何分担执行)、**分配成员**(哪些团队成员参与)、**终止条件三元组**(不可实现、不相关、已完成,指明何时该算子结束)。
三种组合方式的语义差异值得细看。**Φ(个体代表全队)**:一个成员代表整个团队执行该算子,其他成员不直接执行,但承诺不在该算子运行期间采取冲突行动。**AND(全员执行)**:所有被分配的成员都执行,任一成员完成或失败都可能触发终止条件检查。**OR(任一成员执行)**:任一被分配的成员执行即满足,这正是 STEAM 战术修改的关键,加一条终止条件即可改变 OR 算子的行为。
团队算子同时回答了“联合意图如何落地”的问题:选中一个团队算子,联合意图就分解为每个成员各自执行自己份额的**个体意图**,加上全队对算子与角色的**相互信念**,再配上把全队一起释放出来的终止条件。承诺是团队的,执行是个体的,纽带是相互信念——这就是“联合意图 → 个体意图分解”的全部结构。
在我们的复现仓 `../steam-teamwork-reproduction/` 里,这套结构是四个模块:`team_operator.py` 定义团队算子,`communication.py` 实现决策论通信选择性,`agent.py` 描述团队成员的感知与 Pmt 估计,`team.py` 把三者组装成可跑的团队:
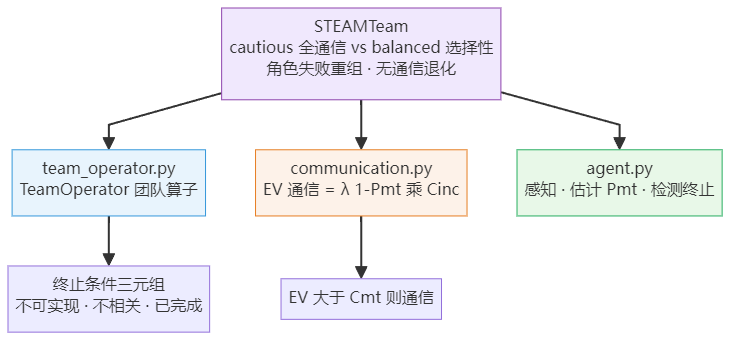
图中可以看到复现的忠实程度:终止条件三元组挂在团队算子上,通信选择独立成模块,这正是 STEAM 最重要的结构决定。核心代码只有几行,却把 p90 的定义原样搬了过来:
```
class CompositionType(Enum):
PHI = "phi" # 个体代表全队
AND = "and" # 全员执行
OR = "or" # 任一成员执行
@dataclass
class TerminationConditions:
unachievable: Callable[[], bool] # 不可实现——如航路被阻断
irrelevant: Callable[[], bool] # 不相关——动机不复存在
completed: Callable[[], bool] # 已完成——目标已达成
```
`check()` 方法按“已完成 > 不可实现 > 不相关”的优先级逐个询问这三个谓词,返回第一个触发者的名字。这里有一个极易忽略但决定一切的设计(p90 原话):“信念修正与关于修正信念的通信相分离”——成员先**私有地**检测终止条件是否满足,然后按决策论选择性决定是否将这一信念广播给全队。通信不是自动的。如果通信总是自动的,就没有选择性可言,后文那条 EV 公式也就没有存在空间。
### 三个实证域,和一个常见误记
STEAM 的三个实证域为:Attack 合成攻击直升机(最多 8 架)、Transport 护航+运输直升机(最多 16 agent)、RoboCup 合成足球(无通信设施)steam-domains。必须如实记录:**不存在“空战仿真”域**——空战建模是 Tidhar et al. 1995 的另一工作,常被误记到 STEAM 名下。三个域全部是仿真,这个事实在“诚实边界”一节还会回来,它划定了 STEAM 全部实验数字的适用范围。
## 承诺监控:成员失败时,团队重新规划
### 联合意图的一生
把团队算子、终止三元组和通信选择性连起来,一个联合意图的完整生命周期是这样的:
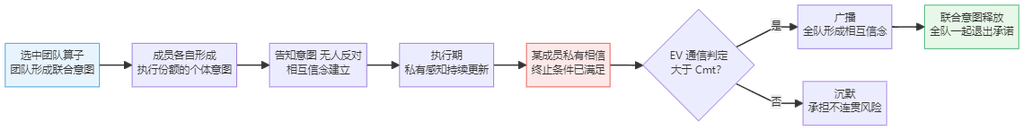
这张图的重点在右半边:终止条件触发的是**私有**信念,而释放承诺需要**相互**信念,中间隔着一道通信决策。左半边则是承诺的形成:选中算子、分解为个体意图、通过告知建立相互信念。C&L 1991 的义务条款(“使全队相互相信”)在图里就是 E 到 I 这条路径。
承诺监控还有第二个方面:角色监测(p104)。角色未履行仅在队友无法自行推断时才通知;角色失败且关键时,团队自动重组选新成员补位 steam-p104。复现仓的实验 2 演示了这个过程:4 个 agent 分别担任 scout、attacker、defender、support,第 3 步 attacker 失败,剩下 3 个存活成员重新规划、继续执行联合任务:
```
实验2:角色失败与重组
============================================================
初始角色: {0: 'scout', 1: 'attacker', 2: 'defender', 3: 'support'}
Agent-1(attacker)失败
重组后角色: {0: 'attacker', 1: 'FAILED', 2: 'scout', 3: 'support'}
重组消息数: 5
```
重组的逻辑是链式补位:Agent-0 接替 attacker,Agent-2 接替 Agent-0 空出的 scout,团队结构在 5 条消息内恢复。核心代码是 `team.py` 里 `_reorganize` 的这几行:
```
# 选择第一个候选者接替失败角色
new_assignee = candidates[0]
old_role = self.members[new_assignee].role
# 重组通信:通知所有候选者 + 新指派确认
self.reorganization_messages = len(candidates) + 1
# 更新角色指派
self.members[new_assignee].role = failed_role
self.role_assignments[failed_idx] = "FAILED"
```
这正是 p104 的角色监测机制在代码里的样子:失败不终止团队,只触发一次重新分配。STEAM 论文的实验数字(p107-110)给了这套机制的定量证据:与 dispatch 团队(预编程协调计划)对照,STEAM 团队任务完成率高 60% 到 100%;规模从 2→16 agent 时消息量近乎不涨;运输迟到 30 秒至 3 分钟仍能灵活重排 steam-exp。“灵活”不是修辞——是可测的完成率差距。
### 没有通信,就没有联合意图
承诺监控依赖一个前提:相互信念能建立起来。RoboCup 足球域无通信设施,这给了理论一个天然的反向实验。复现仓的实验 3 关闭了通信通道:
```
实验3:无通信模式(RoboCup)
============================================================
消息数: 0
联合意图保留: False
个体意图数: 62
>> 无通信时联合意图退化为个体意图
```
结果干净利落:消息数为 0,联合意图保留为 False,62 个信念变化全部成为个体意图:每个 agent 独自感知、独自决策,团队协调退化为各自为战。这验证了联合意图理论的核心论断:相互信念是联合意图的地基,没有通信就没有相互信念,没有相互信念就没有联合意图——只有 N 个个体意图的叠加。记住这个结果,它是后文 Bar-Hillel 之问的第一件证物。
## ARCHON:把没人敢动的老系统包进合作社区
### 工业现实:很少有应用是从零构建的
STEAM 在仿真里证明了机制有效,但工业界不会为了一个新架构重写跑了几十年的系统。1995 年,Nicholas Jennings 在 *Artificial Intelligence* 75(2) 195-240 上发表了 ARCHON,联合意图理论第一次在真实工业环境中跑通 archon-aij。动机直指工业现实,摘要里说,既有架构“难以在新的应用域重用领域求解器、难以随环境变化改造、无法增量构建”,所提架构“使以各种语言、模型与计算范式构建的既有独立系统能被集成进一个合作社区”。设计动因的原话更直白:
> 直接受此观察驱动——很少有工业应用是从零构建的 archon-abstract
这句话在 1995 年是电力行业的观察,在 2026 年读起来像是为 MCP 写的预告——后文再说。
包装结构(p198 图 5)是一个两层的三明治:ARCHON agent 上部为合作与控制层(HLCM),包含情境评估、合作规划、合作控制三模块,结构“主要由联合责任模型驱动”;下部包住一个既有(遗留)系统——原话是“ARCHON agent 包住一个既有系统” archon-p198。情境评估融合来自多个既有系统的信息,合作规划基于联合责任模型决定团队该做什么,合作控制协调各既有系统的执行并处理冲突。遗留系统一行代码不改,行为改变全部发生在合作层。
联合意图在 ARCHON 中的定义(p214 图 14)是三要素状态 archon-p214:全体成员**承诺一个共同食谱**、**共享一个共同食谱视图**、**各自怀有执行该食谱的个体动机**。与 Cohen & Levesque 的差异在于:C&L 要求全部动作共同执行,Jennings 将联合意图定位为多 agent 上下文中的承诺——成员各自执行自己的部分,但共享对整体计划的承诺和视图。这与 STEAM 的团队算子分解殊途同归:团队承诺,个体执行。
冲突仲裁也被协议化了(p219,D4 决策点):寻求避免冲突,其通过条件为食谱间无利益冲突、或“冲突可被化解至涉及各方的相互满意”;无外部仲裁者,化解条件写入协议本身 archon-p219。但必须诚实:谈判机制细节着墨有限:ARCHON 的仲裁证据强度弱于 STEAM 的终止条件+期望值通信(后者有对照数据,本篇是协议条款+场景演示)。
### 葡萄牙电网:三个系统”无需任何重写”
部署域一是葡萄牙电力 EDP 输电网管理(p223-224、238)。原话“24 座变电站、37 条输电线”(220kV)archon-edp。三个遗留系统被集成:LAVE 负荷分配、ADVISE 警报处理与诊断、FAMES 故障定位隔离与修复调度。测试情形基于 5 个月运行记录,含断路器拒动、警报丢失/延迟/不确定、遥测失效——这是真实电网的脏数据,不是仿真的干净输入。结论页的原话是全文最有分量的一句:
> 既有应用(LAVE、ADVISE 与 FAMES)已被集成……**无需任何重写** archon-edp
部署域二更壮观:CERN 粒子加速器控制(p229-232),世界最大质子同步加速器之一,377 块主磁铁、105 块校正磁铁、39 台电源、43 个 RF 谐振腔、500+ 监测设备 archon-cern。原话:“该社区中有八个 ARCHON agent——每个既有系统各被包装并连到加速器设备”。加速器每天 24 小时运转,既有系统由不同团队用不同软硬件开发。某功率监控系统建于 15 年前仍被操作员高度信任,“保留而非替换”的动因原文化。这句朴素的话值得慢慢读:系统的价值不只在性能,还在多年磨合出的信任,这是任何“重写”都买不回来的资产。
一个部署域的限定也要说清:本期刊正身仅覆盖电力与粒子加速器两域。常被并提的“水泥窑”属 ARCHON 项目整体文献(Wittig & Jennings 1994),不在本篇 archon-domains。
ARCHON 还留下一句关于开销的诚实讨论(p236):协调开销随 agent 数非线性增长,单 agent 纯性能更优,多 agent 的回报在**弹性**——原话“若一个 agent 崩溃,其角色可由另一个接管”。项目为 ESPRIT P-2256;电力应用正以 C++ 生产化重实现 archon-p236。这句“单 agent 纯性能更优”是设计者对自己架构的承认,三十年后它会与一条定量的曲线相遇,那是本文倒数第二节的故事。
## 更早的现场:OASIS 把计划库带上塔台
联合意图的部署线还有一个更早的现场。1992 年,Ljungberg 和 Lucas 在 AAII Technical Note 28 中描述了 OASIS,一个空中交通流量管理系统 oasis-tn。定位原话说得明白:“作为使用过程推理系统 PRS 的一个应用而开发”——**不是独立变体,是 PRS 上的应用**。且 PRS“将很快被基于 C++ 的系统(MARS)替换为系统内核”,dMARS 前身首见 oasis-prs,PRS 到 dMARS 的工程化线索正是本系列[第 2 篇](https://www.paddysun.top/?p=5122)的主题。
架构分两层 oasis-structure。五类全局 agent:COORDINATOR 任务管理、SEQUENCER(A* 搜索求最小延误序列,any-time 算法可中断返回当前最优)、TRAJECTORY CHECKER 校验不违反法定间隔、WIND MODEL、USER INTERFACE(与人类流量主任的唯一通信点)。每架进场航空器再各配一个 AIRCRAFT agent,内含 PREDICTOR(航迹预测)、MONITOR(实时监视)、PLANNER(生成多方案)三组件。这是一次激进的 agent 化:飞机不是数据库里的记录条目,是有感知、有计划、可对话的成员。
OASIS 页 4 有一句关于社会性边界的一手表述,值得整段引用:
> agent 内部状态中的事实、目标与意图不能从外部操纵 oasis-boundary
想知道他方内部状态只能发消息询问——这就是“弱社会性”的边界:agent 之间靠通信而不靠读取彼此的内存。PLANNER 的设计则展示了计划库声明式条目的实战价值:“有一个多种策略的库……一些策略基于严格算法模型、另一些是启发式的,按当前情境选用”;生成多方案后“由流量主任选择采纳哪个方案” oasis-planner。人类择案、机器生案。
规模数字要按年份卡死(页 12,图像核读原话):“OASIS 已开发 2.5 年。它目前处理来自悉尼机场的真实高峰时段交通样本,涉及 65 架进场航空器、时间跨度 1.5 小时”,且系统“实现于 Unix 工作站上的仿真空中交通环境” oasis-numbers。**1992 年阶段是仿真环境跑真实高峰样本**。R&G 1995 的“70-80 架、接收雷达实时数据”是 1995 现场评估阶段,两口径不可互换。同页还有一组当代对照系统:COMPAS(德国 DLR,法兰克福 1989 投运)“是用 FORTRAN 与 C 写的常规程序”、只考虑单跑道;MAESTRO(法国 CENA)ADA 常规实时系统;CTAS(NASA Ames)常规但按席位分布。OASIS 的差异化在 agent 化、多方案推荐、实时监视多层反馈 oasis-fortran。
### 三个部署域摆在一起
系统年份部署域“实证”的含义协调机制STEAM1997直升机仿真 + RoboCup 足球消息计数与完成率对照数据决策论通信选择性 + 终止条件三元组ARCHON1995葡萄牙电网 + CERN 加速器真实工业环境运行合作层包装遗留系统 + 联合意图三要素OASIS1992悉尼机场空管仿真仿真环境跑真实高峰样本PRS 计划库声明式条目 + 多策略 PLANNER
STEAM 的“实证”指消息数与完成率对照数据而非工业现场——与 ARCHON 的真实工业数据恰好互补。ARCHON 的“实证”是真实工业环境中的集成验证,但协调开销随 agent 数非线性增长。OASIS 的“实证”是仿真环境跑真实高峰样本,1992 年阶段尚未接收雷达实时数据。三者的谱系关系可以这样看:
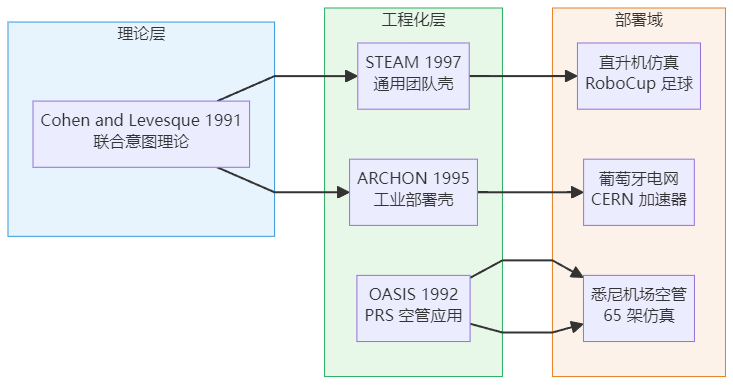
同一理论下到三种部署域,“实证”的含义随之变化,这条光谱本身就是对“多 agent 系统验证”这个问题的第一次完整回答。三个系统在战术修改上还展现了同构的模式:STEAM 加一条终止条件(OR2)、ARCHON 配置合作层、OASIS 编辑计划库条目——域策略与元级计划同为计划库条目,声明式可独立编辑。归因判定:战术修改快的主通道是**配置化**,运行时局部慎思(PLANNER 按情境选策略)承担的是执行期适应而非修改周转。但“谁写计划库”仍是人工,这是三系统共享的诚实边界。
## 一条 1997 年的公式,2026 年换上 LLM 的参数
### 通信是一次期望值计算
现在回到本文开头那架发现敌车的直升机。它的困境在 STEAM 里被 Tambe 写成了一个公式(p103)steam-p103:
> EV(通信) = λ(1-Pmt)·Cinc 对比 Cmt 若通信成本低于不通信的期望成本,则通信
其中 Pmt 是相互信念已存在的概率、Cinc 是不连贯成本(不通信导致团队行动不协调的代价)、Cmt 是通信成本。若 EV > Cmt 则通信,否则沉默。Pmt 越高(队友越可能已经知道),越不需要通信;Pmt 越低(新信息),越需要通信。这把“要不要把矛盾信息广播出去”从道德问题变成了期望值计算——不是全通信,也不是永不通信。
复现仓里这个公式是 `communication.py` 的八行代码:
```
def expected_value_of_communicate(self, pmt):
"""EV(通信) = λ(1-Pmt)·Cinc (p103)"""
return self.lambda_factor * (1.0 - pmt) * self.incoherence_cost
def should_communicate(self, pmt):
"""若 EV(通信) > Cmt,则通信 (p103)"""
ev = self.expected_value_of_communicate(pmt)
return ev > self.communication_cost
```
公式里唯一需要“智能”的参数是 Pmt——Cinc、Cmt、λ 都是常数。复现用三档启发式估计它:终止条件信念 Pmt=0.0(新关键信息,队友不太可能已知道);常规信念首次出现 Pmt=0.3(队友可能通过共享环境间接推断,但不确实);已有队友持有 Pmt=0.95(很可能已相互相信)。这实现了 STEAM 的核心洞察(p104):角色未履行仅在队友无法自行推断时才通知。
实验 1 对照了两种通信策略:4 个 agent 执行 10 步直升机团队任务,cautious 队每次信念变化都执行完整通信协议(广播+确认+互信确认 = 9 条消息),balanced 队使用决策论通信选择性(仅广播 = 3 条消息,且只在 EV > Cmt 时才发):
```
实验1:通信策略对比
============================================================
Cautious 队消息数: 558 (预期≈538)
Balanced 队消息数: 18 (预期≈12-26)
通信节省: 96.8%
```
cautious 队产生 558 条消息(论文基线为 538 条),balanced 队仅 18 条(论文区间为 12-26 条)。通信节省 96.8%——决策论通信选择性用不到 4% 的消息量达成了近似的团队协调效果。机制不复杂:balanced 队对常规信念(Pmt 高)保持沉默,只对终止条件信念和首次出现的常规信念广播;cautious 队不区分,每次信念变化都执行完整 9 消息协议。
### 2026 新增 A/B 对照实验:三档启发式换成 LLM
> **编者注**:以下实验为本系列 2026 年新增的 A/B 对照实验,原始数据存于 `experiment_results/ab_e4_steam_pmt.json`,脚本为 `steam-teamwork-reproduction/ab_experiment.py`。
公式是 1997 年的,Pmt 的三档启发式却粗糙得可疑:终止信念一律 0.0、新常规一律 0.3,真实世界里“队友已经知道了吗”显然是个连续谱。2026 年自然的想法是:让 LLM 来估这个概率。A/B 实验只替换这一个组件:**基线 = 三档启发式(逐字节不变),变体 = LLM 估计“队友已相互相信该信息的概率”,EV 公式与阈值全部不动**。注意单组件替换的分界:LLM 估计的是参数,公式本身仍是 1997 年的决策论。
替换点在 `agent.py` 里只有一个钩子,几行代码就完成了“智能外包”:
```
if self.pmt_estimator is not None:
# E4 LLM 变体: Pmt 估计责任外包(EV 公式与阈值不动)
is_term = value in TERMINATION_BELIEFS
...
est = float(self.pmt_estimator(value, is_term, holders, total))
return min(1.0, max(0.0, est))
```
LLM(deepseek-chat,temperature 0.3)收到的输入是信念变化的内容、是否终止相关、几个队友已感知过相同信息;输出是一个 0 到 1 的概率。
**Part A 校准**(12 个状态 × 10 次独立抽样)先问:LLM 估得准吗?
指标结果MAE 均值(对照启发式参考值)**0.096**(单轮波动 0.067–0.121)方向排序(终止 < 新常规 < 已共享)**10/10 全对**档位均值:终止 / 新常规 / 已共享0.11 / 0.37 / 0.85(单轮波动 0.08–0.13 / 0.25–0.45 / 0.82–0.88)
LLM 独立复现了 p103–104 语义的定性结构——它没人告诉它三档启发式的存在,却把终止信念估到 0.1 上下、新常规估到 0.3–0.45、已共享估到 0.85 附近,方向排序十轮全对。定性结构是对的,绝对值有约 0.1 的偏差。
**Part B 下游**(4 agent × 10 步 × 3 种子,balanced 模式)再问:估得准,跑起来呢?
种子基线消息数LLM 消息数终止信念静默LLM token 成本4218120/39,577724240/68,65412330300/89,741
三种子失败模式全部 correct:终止信念变化零静默(安全底线守住——坏消息永远广播),seed 42 下 LLM 甚至比启发式更省(12 条 vs 18 条;它把部分启发式判 0.3 的信念估到了 0.5 以上,于是合理地保持了沉默)。
但成本侧给出了本实验最重要的数字:**seed 42 省下 6 条消息,代价是 9,577 tokens 的 Pmt 估计调用**。整个实验共 301 次 LLM 调用、46,512 tokens(43,803 prompt + 2,709 completion,零错误)e4-data。Tambe 公式里 Cmt 是无量纲常数 1.0;把 Pmt 估计交给 LLM 之后,公式三项第一次获得了统一单位——全是 token,而估计成本比消息本身贵三个数量级。1997 年的决策论通信选择性在 2026 年依然成立,但它多了一层元决策:**用一次昂贵的智能调用来决定是否发送一条便宜的消息,本身需要一次 EV 计算。**不利结果如实记录:在消息便宜、token 昂贵的当前价格结构下,这次组件替换在经济学上不划算:LLM 估得再准,也贵不过它自己。
## 协调开销的三十年:从一句定性的承认到一条定量的曲线
ARCHON 在 p236 承认协调开销随 agent 数非线性增长时,只给了一句定性描述:没有曲线,没有阈值,没有形式化模型。“多 agent 的回报在弹性”是一个定性论断,不是定量定理。这意味着联合意图的“团队弹性”优势只在 agent 数量适中时成立——当数量增长到某个阈值后,协调开销可能超过弹性收益,而论文没有告诉我们阈值在哪里。
三十年后,这句话有了一条定量的回声。
> **编者注**:Dochkina 2026 年对大规模多智能体自组织的实证研究给出了 ARCHON 当年没能给出的东西——测得的扩展曲线:任务完成随 agent 数**亚线性**扩展,协调开销吃掉了新增 agent 的边际产出 dochkina。1995 年是设计者对自己架构的诚实承认,2026 年是测量出来的曲线;相隔三十年,说的是同一枚硬币的两面。详述见本系列[第 10 篇](https://www.paddysun.top/?p=5167)。[作者判断] 若 token 价格再降两个数量级,E4 那个”不划算”的结论可能反转——但亚线性扩展不会因此消失,只会换一种计价方式。
把这条线拉到当代,1992-1997 三系统与 2026 年的 LLM Agent 在 BDI 坐标上的对照一目了然:
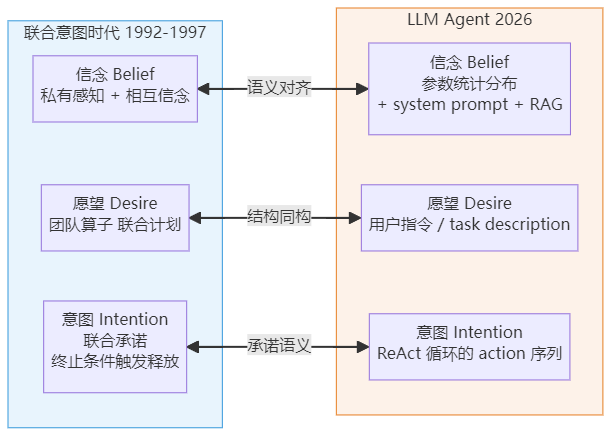
维度STEAM / ARCHON / OASIS (1992-1997)LLM Agent 2026信念私有感知 + 相互信念(通过通信建立)参数统计分布 + system prompt + RAG愿望团队算子 / 联合计划 / PRS 计划库用户指令 / task description意图联合承诺(终止条件触发释放)ReAct 循环的 action 序列承诺终止三元组:已完成 / 不可实现 / 不相关无显式终止条款(生成完毕即结束)通信机制EV(通信) = λ(1-Pmt)·Cinc vs Cmt无内置通信选择机制角色失败自动重组选新成员补位无角色重组机制协调开销随 agent 数非线性增长(ARCHON 原话)随 context 长度线性增长计划修改配置化:加一条终止条件 / 编辑计划库条目改 prompt 或改系统社会性边界agent 内部状态不可外部操纵(OASIS 原话)context window 即边界
一个关键的对照在“承诺终止”那一行:STEAM 的“意图”是团队级承诺,由终止条件三元组触发释放,有明确的退出语义;当代 LLM Agent 的“意图”是 action 序列——生成完毕即结束,没有“不可实现”或“不相关”的退出条款。STEAM 把“什么时候该放弃”变成了协议的一部分;LLM Agent 的放弃依赖 prompt 设计者的判断或用户的干预。
另一个关键对照在“包装”:ARCHON 的“包装遗留系统无需重写”与当代 MCP 把 LLM agent 包装到既有 API 之上是同构动作——但 ARCHON 的联合意图三要素(共同食谱承诺 + 共同视图 + 个体动机)在 MCP 中没有对应物。MCP 解决了“连接”问题(LLM 如何调用既有 API),但没有解决“协调”问题(多个 LLM agent 调用同一组 API 时如何避免冲突)。
## 影响谱系:这些机制流向了哪里
团队算子、终止三元组、包装式集成——这些机制并没有停留在 1997 年。按引证强度分三档:
**强影响(直接继承联合意图与团队工作机制):**
系统 / 框架年份影响点参考JACK Teams2000s商业 Agent 框架直接实现 STEAM 团队算子和联合意图语义[JACK Teams](https://aosgrp.com/products/jack/)AgentSpeak 团队扩展2000s在 AgentSpeak(L) 上扩展团队计划算子,继承 STEAM 的 AND/OR 组合[AgentSpeak](https://github.com/agentlang/agentspeak)COLBY / Team-Soar2000sSoar 架构内的团队工作扩展,直接继承 STEAM 的 Soar 实现[Soar](https://soar.eecs.umich.edu/)机器人救援仿真2000sRoboCup Rescue 继承 STEAM 的 RoboCup 验证路径[RoboCup Rescue](https://rescuesim.robocup.org/)
**中强影响(工程化遗留系统集成模式):**
系统 / 框架年份影响点参考GAIA2003Wooldridge 的多 agent 设计方法论继承 ARCHON 的合作层设计[GAIA](https://doi.org/10.1145/560335.560337)JADE + 行为协调2000sJADE 的 behaviour 编排继承 ARCHON 的合作控制模块[JADE](https://jade.tilab.com/)MCP 包装模式2024MCP 把 LLM agent 包装到既有 API 上,与 ARCHON 包装遗留系统同构[MCP](https://modelcontextprotocol.io/)AutoGen 多 Agent2023多 agent 编排继承 ARCHON 的”合作层+执行层”分离[AutoGen](https://github.com/microsoft/autogen)
**中等影响(概念启发):**
系统 / 框架年份影响点参考CrewAI2024角色动态分配与重组,STEAM 角色失败重组的前身[CrewAI](https://github.com/crewAIInc/crewAI)MetaGPT SOP2023SOP 编排多 agent,ARCHON 合作规划的概念启发[MetaGPT](https://github.com/geekan/MetaGPT)多 Agent 空管系统2010sOASIS 的 agent 化空管思路在后续系统中延续—
三档的分界线是证据的硬度:JACK Teams 们把团队算子写进了产品,GAIA 与 MCP 们继承了结构模式,CrewAI 们只继承了概念直觉。谱系不是荣誉榜:概念相似不等于因果传承,这一点本系列[第 3 篇](https://www.paddysun.top/?p=5128)已有交代。
## 诚实边界:五条,一条都不能少
**第一,STEAM 的实证域均为仿真。**“实证”指消息计数与完成率对照数据(538 vs 12-26、完成率高 60% 到 100%),不是工业现场部署。三个域(Attack 直升机仿真、Transport 直升机仿真、RoboCup 足球)全部是仿真环境。STEAM 的决策论通信选择性在仿真中有效,但在真实工业环境中的效果由 ARCHON 独立验证(且 ARCHON 的通信策略不同于 STEAM 的 EV 计算)。
**第二,ARCHON 的协调开销随 agent 数非线性增长。**Jennings 原话(p236):单 agent 纯性能更优,多 agent 的回报在弹性:“若一个 agent 崩溃,其角色可由另一个接管”。多 agent 不是比单 agent 更高效,而是更抗故障。但协调开销的增长曲线在论文中未给出量化模型,“非线性增长”是定性描述,非定量结果。
**第三,OASIS 的战术修改快主要通过配置化。**域策略与元级计划同为计划库条目,声明式可独立编辑。PLANNER 按情境选策略并生成多方案,承担的是执行期适应而非修改周转。但“谁写计划库”仍是人工。OASIS 页 8 原话“计划集不仅装载特定域的过程知识,还包括元级计划”,这些计划条目由人类编写和维护,系统自身不生成新计划。
**第四,OASIS 的“70-80 架”数字不属于本篇。**1992 年的 OASIS 仿真验证涉及 65 架进场航空器 + 5 全局 agent。“70-80 架”系 R&G 1995 自述的现场评估阶段口径,两口径不可互换。
**第五,“FORTRAN→计划、两个月→不足一天”不属于 OASIS。**该数字属 Rao et al. 1992 的空战建模应用,非 OASIS。本篇全文无此数字,该数字目前仍为 R&G 单源 oasis-errata。
## Bar-Hillel 之问:团队合作被偷换成了通信协调吗
Bar-Hillel 对机器翻译的批评是:它把“理解”偷换为“模式匹配”,预设了一个不成立的等价前提。STEAM/ARCHON/OASIS 有一个结构相同的局限:它们把“团队合作”偷换为“通信协调”,预设了一个不成立的前提——通信可以建立相互信念,相互信念可以维系联合意图。
这个前提在仿真和受控工业环境中成立:STEAM 的 agent 通信带宽充足、消息无损传递、队友诚实报告信念。但一旦通信受限(RoboCup 无通信设施)、消息丢失(ARCHON 的警报丢失/延迟/不确定)、或 agent 信念不一致(OASIS 的多方案分歧),联合意图就会退化。实验 3 已经验证了这一点:无通信时联合意图退化为个体意图,62 个信念变化全部成为个体意图。
更深层的问题是**协调开销的非线性增长**。ARCHON 原话承认:协调开销随 agent 数非线性增长、单 agent 纯性能更优。这意味着联合意图的“团队弹性”优势只在 agent 数量适中时成立——当 agent 数量增长到某个阈值后,协调开销可能超过弹性收益。论文没有给出这个阈值,也没有给出开销增长的形式化模型。“多 agent 的回报在弹性”是一个定性论断,不是定量定理。
映射到当代:ARCHON 的“合作层包装既有系统无需重写”与三十年后用 MCP 把 LLM agent 包装到既有 API 之上是同构动作——但 MCP 同样不解决“包装后的协调开销”问题。当多个 LLM agent 通过 MCP 调用同一组 API 时,谁仲裁冲突?STEAM 的终止条件三元组给了协议化答案(私有信念触发 → EV 判定 → 通信 → 相互信念),但 LLM agent 没有内建的终止条件机制,每个 agent 的“放弃”依赖 prompt 设计者的判断或用户的干预。ARCHON 的 D4“化解至各方相互满意”给了协议条款,但谈判机制细节着墨有限。
更关键的是:OASIS 的计划库由谁编写?答案是人工。STEAM 的团队算子由谁定义?答案是人工。ARCHON 的合作层配置由谁维护?答案是人工。三个系统都把“知道该做什么”留给了人类专家,系统只负责“如何协调执行”。当代 LLM Agent 试图用模型生成替代人工编写计划库,但模型生成的“计划”是否可信、是否一致、是否可验证,仍是未解问题。联合意图理论解决了“团队如何承诺”的问题,但没有解决“团队如何知道该承诺什么”的问题。这个缺口在 1997 年由人类专家填补,在 2026 年仍由人类 prompt 设计者填补——只是换了层包装。
## 结语:团队如何承诺,而非承诺什么
回头看这条 1992-1997 的部署线,三个系统回答的其实是同一个问题的三个侧面。合同网([第 4 篇](https://www.paddysun.top/?p=5132))回答“谁做什么”:任务分配走招标;STEAM 回答“何时一起放弃”:终止条件协议化了联合退出,它的终止条件三元组也是[第 5 篇](https://www.paddysun.top/?p=5136)那条仲裁谱系上的第四种形态:私有信念触发 → EV 判定 → 通信 → 相互信念 → 全队释放承诺。终止条件触发是私有信念,但通信是期望值决策,不是博弈。STEAM 用协议避开了合同网的囚徒困境。ARCHON 回答“谁来出钱改系统”——没人,包装就行。OASIS 回答“声明式条目值多少”:值一次战术修改只改配置的速度。
而 2026 年的 E4 实验给这条老线加了一个新的注脚:Tambe 的公式三十年后还能原样跑通,被替换的只是参数的来源——并且替换本身揭示了一个 1997 年不存在的问题:当“智能”按 token 计价,决定“要不要发一条消息”的那次调用,可能比消息本身贵三个数量级。承诺的理论没变,变的是通信的价格表。
还有一层互文留给系列的后文:Minsky 的 Society of Mind 把“冲突与协商”放在脑内——不同 agents 在脑内争抢控制权;STEAM 把同样的冲突与协商从脑内搬到网络节点间,用联合意图理论给出了“agents 如何承诺”的可计算答案。两者共享一个深层直觉:智能来自多个半自主单元的协调,而非单一推理引擎的产物。第 9 篇将从脑内视角回望这里的网络视角。
---
## 参考文献
[**cl1990**] Cohen, P. R. & Levesque, H. J. “Intention Is Choice with Commitment.” *Artificial Intelligence* 42(3): 213-261, 1990.(精读存档 `原始文章\03c-CohenLevesque-1990.pdf`,49 页扫描件,逐页图像转录。)
[**steam-p87**] Tambe, M. “STEAM: Towards Flexible Teamwork.” *Journal of AI Research* 7: 83-124, 1997.(精读存档 `原始文章\03l-Tambe-STEAM-1997.pdf`,JAIR 官方开放获取版 42 页。p87:STEAM 定位与联合意图理论条款原话。)
[**steam-p90**] 同上。p90:团队算子定义——名称、组合方式(Φ/AND/OR)、分配成员、终止条件三元组;”信念修正与关于修正信念的通信相分离”。
[**steam-p103**] 同上。p103:决策论通信选择性——EV(通信) = λ(1-Pmt)·Cinc 对比 Cmt,决策规则原话”若通信成本低于不通信的期望成本,则通信”。
[**steam-p104**] 同上。p104:角色监测与团队重组——角色未履行仅在队友无法自行推断时才通知;角色失败且关键时,团队自动重组选新成员补位。
[**steam-domains**] 同上。三实证域核实:Attack 合成攻击直升机(最多 8 架)、Transport 护航+运输直升机(最多 16 agent)、RoboCup 合成足球(无通信设施)。空战建模是 Tidhar et al. 1995 的另一工作。
[**steam-exp**] 同上。p107-110:六种环境条件下 cautious 队 538 条消息、STEAM balanced 队 12-26 条;与 dispatch 团队对照完成率高 60% 到 100%;规模 2→16 agent 时消息量近乎不涨。
[**steam-p109**] 同上。p109:战术修改机制原话——”为团队算子[飞行计划]OR2 增加一个新的不可实现条件即已足够”。
[**archon-aij**] Jennings, N. R. “Controlling Cooperative Problem Solving in Multi-Agent Systems.” *Artificial Intelligence* 75(2): 195-240, 1995.(精读存档 `原始文章\03m-Jennings-ARCHON-1995.pdf`,扫描件文本层 0 字符,逐页图像核读。)
[**archon-abstract**] 同上。摘要与设计原话:既有架构”难以重用、难以改造、无法增量构建”;”很少有工业应用是从零构建的”。
[**archon-p198**] 同上。p198 图 5:”ARCHON agent 包住一个既有系统”;HLCM 三模块结构”主要由联合责任模型驱动”。
[**archon-p214**] 同上。p214 图 14:联合意图三要素——全体成员承诺共同食谱、共享共同食谱视图、各自怀有执行该食谱的个体动机。
[**archon-p219**] 同上。p219 D4 决策点:”冲突可被化解至涉及各方的相互满意”——无外部仲裁者。
[**archon-edp**] 同上。p223-224、238:葡萄牙电力 EDP 输电网管理,24 座变电站、37 条输电线(220kV),三个遗留系统被集成”无需任何重写”。
[**archon-cern**] 同上。p229-232:CERN 粒子加速器控制,377 块主磁铁,八个 ARCHON agent 各包装一个既有系统,15 年老系统因被信任而保留。
[**archon-p236**] 同上。p236:协调开销随 agent 数非线性增长,单 agent 纯性能更优,多 agent 的回报在弹性——”若一个 agent 崩溃,其角色可由另一个接管”。ESPRIT P-2256。
[**archon-domains**] 同上。本期刊正身仅覆盖电力与粒子加速器两域。”水泥窑”属 ARCHON 项目整体文献(Wittig & Jennings 1994),不在本篇。
[**oasis-tn**] Ljungberg, L. & Lucas, A. “The OASIS Air Traffic Flow Management System.” AAII Technical Note 28, Melbourne, 1992.(精读存档 `原始文章\03q-Lucas-OASIS-1992.pdf`,15 页正文完整。实际标题无”Flow”一词、Lucas 为第二作者。)
[**oasis-prs**] 同上。原话”作为使用过程推理系统 PRS 的一个应用而开发”;PRS”将很快被基于 C++ 的系统(MARS)替换为系统内核”。
[**oasis-structure**] 同上。五类全局 agent:COORDINATOR、SEQUENCER(A* 搜索 any-time 算法)、TRAJECTORY CHECKER、WIND MODEL、USER INTERFACE;每架进场航空器一个 AIRCRAFT agent(PREDICTOR/MONITOR/PLANNER)。
[**oasis-boundary**] 同上。页 4:”agent 内部状态中的事实、目标与意图不能从外部操纵”。
[**oasis-numbers**] 同上。页 12,图像核读原话:”涉及 65 架进场航空器、时间跨度 1.5 小时”,”实现于 Unix 工作站上的仿真空中交通环境”。R&G 1995 的”70-80″是现场评估阶段口径。
[**oasis-planner**] 同上。PLANNER”有一个多种策略的库……一些策略基于严格算法模型、另一些是启发式的”;”由流量主任选择采纳哪个方案”。
[**oasis-fortran**] 同上。页 12:COMPAS(DLR,FORTRAN 与 C)、MAESTRO(CENA,ADA)、CTAS(NASA Ames)——对照系统均为常规程序。
[**oasis-errata**] “FORTRAN→计划、两个月→不足一天”属 Rao et al. 1992 的空战建模应用,非 OASIS。该数字目前仍为 R&G 1995 单源。本篇全文无此数字。
[**dochkina**] Dochkina 2026:多智能体自组织系统的实证研究,报告任务完成随 agent 数亚线性扩展——协调开销吃掉新增 agent 的边际产出;与 BCG 治理悖论的详述见本系列[第 10 篇](blog-10-self-organization-and-governance-paradox.md)。
[**e4-data**] A/B 实验原始数据:`experiment_results/ab_e4_steam_pmt.json`(deepseek-chat,temperature 0.3,301 次调用,46,512 tokens,0 错误);实验脚本:`steam-teamwork-reproduction/ab_experiment.py`;基线复现代码:`steam-teamwork-reproduction/steam/`。
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 合同网协议详解:Smith 1980 任务招标五步流程与囚徒困境的 Python 复现
https://www.paddysun.top/archives/5132 · 2026-09-01
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 4 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) **阅读时间**:约 11 分钟
---
# 合同网:1980 年,任务分配第一次被写成一份合同
如果一个网络里没有老板,没有中央调度器、没有全局数据库,谁来决定哪个节点干哪件活?1980 年,Reid G. Smith 在博士论文《A Framework for Distributed Problem Solving》里给出了一个出人意料的答案:让任务分配走一遍合同流程smith1980。次年 5 月,他与 MIT AI Lab 的 Randall Davis 把这一思想写成 MIT AI Memo No. 624《Negotiation as a Metaphor for Distributed Problem Solving》,1983 年再以同题论文刊于《Artificial Intelligence》。今天所说的“合同网协议”(Contract Net Protocol),就诞生于这条 1980—1983 的出版链。
Memo 624 给分布式问题求解下的定义,至今仍是这个领域的奠基表述:
> “the cooperative solution of problems by a decentralized and loosely coupled collection of problem solvers” ——由分散且松耦合的问题求解器集合进行的合作解题 memo624
论文随即划出本质约束:”there is neither global control nor global data storage”(既无全局控制,亦无全局数据存储)memo624。这条线划得极清:Logic Theorist 是单一推理引擎,STRIPS 是单一规划器,MYCIN 是单一诊断系统,它们都有全局控制和全局存储;合同网第一次把控制与数据分布到网络节点上,再用一套协议协调节点间行为。而全部机关都藏在封面摘要的一句话里:
> “Task distribution is viewed as an interactive process… This discussion is the origin of the negotiation metaphor: Task distribution is viewed as a form of contract negotiation.” ——任务分布被视为一个交互过程……这一讨论就是协商隐喻的起源:任务分布被视为合同协商的一种形式 memo624-p1
隐喻的力度在于:它把任务分配当成一个社会过程,而非调度问题(谁有资源、怎么最优分配)——有任务的人发招标,有能力的人评估兴趣、交投标,招标者裁决中标,双方立约。这是一套有协议语义的社会交互,而非数学优化。
> **编者注**:本文精读的存档是 Memo 624(1981 年 5 月技术报告版),非 1983 年 AIJ 期刊版;两者章节结构有差异,文中页码均按 memo 页码标注,期刊版独有的内容会单独说明。
## 五步走完一份合同:招标、投标、中标、报告、终止
协议本体在 Memo 624 第 7.3 节(p15-16):一次任务分配由五种消息串成:招标(task announcement)、投标(bid)、中标(award)、报告(report)、终止(termination)memo624-p15。整条流程可以这样看:
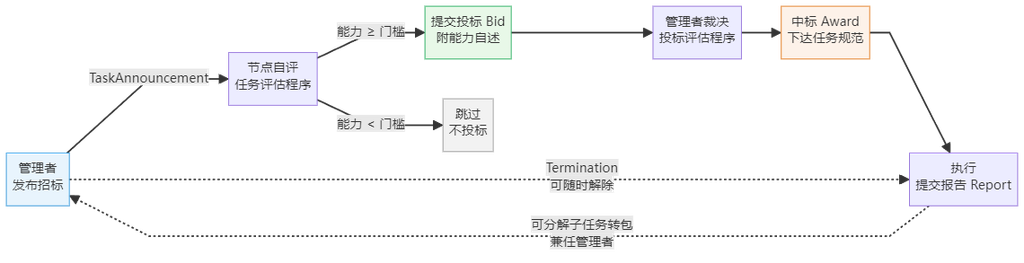
图里最要紧的是:两道关口各由一方把守,节点过不了自己的门槛就不投标,管理者看不中投标就不中标。招标消息也不是一句“有人要干活”,第 7.4 节(p20)规定了四个主槽位:资格判据(满足什么条件才有权投标)、任务抽象(让节点能给多个在招任务排序)、投标规范(规定投标长什么样、便于横向比较)、到期时间memo624-p20。论文自己的例子是一份傅里叶变换招标:
```
TASK TYPE: FOURIER-TRANSFORM
NUMBER POINTS: 1024
ELIGIBILITY: MUST-HAVE FFTBOX
BID SPECIFICATION: COMPLETION-TIME
EXPIRATION: 29 1645Z NOV 1980
```
投标则以节点能力自述回应:有什么硬件、什么传感器;节点间公共语言建立在“属性-对象-值”三元组之上memo624-p20。表示简陋得惊人,却撑起了一个可扩展的市场。
匹配不是一次模式匹配,而是两轮各自独立的决策。第一轮是节点自评,即节点”evaluate their own level of interest in each task with respect to their specialized resources”,结合自己的专用资源评估兴趣水平,够高才投标。第二轮是管理者裁决,”using a task-specific bid evaluation procedure”,用任务特定的投标评估程序选出中标者memo624-p15。在我们的复现里(完整代码在 `../contract-net-reproduction/`),这两轮各是几行代码:
```
def evaluate_announcement(self, ann):
"""任务评估程序 (p15)——节点从自己的视角评估"""
if self.busy:
return None
raw_cap = self.capability.get(ann.content["task_id"], 0.0)
if raw_cap >= self.threshold: # 兴趣水平超过门槛才投标
return Bid(sender=self.name, recipient=ann.sender,
task_id=ann.content["task_id"], capability=raw_cap)
return None
```
自评完全站在节点自己的视角:查自己的能力值、比自己的门槛、忙则弃权。裁决则站在管理者的视角:
```
def evaluate_bids(self, task_id):
"""投标评估程序 (p15)——管理者裁决"""
bids = self.received_bids.get(task_id, [])
if not bids:
return None
best_bid = max(bids, key=lambda b: b.content.get("capability", 0))
return Award(sender=self.name, recipient=best_bid.sender, task_id=task_id)
```
注意那行 `max`:贪心取最高能力值,它是每一轮的局部最优解,也是后文囚徒困境的全部根源。两轮评估各由不同方持有、各自独立决策,这正是论文所说合同的本质——相互选择(mutual selection):”establishing a contract is a process of mutual selection… Both parties to the agreement have evaluated the information supplied by the other”(立约是相互选择的过程,双方都评估了对方提供的信息)memo624-p15。
同样反直觉的是:管理者和承包者只是角色,并非固定的节点类型——”Individual nodes are not designated a priori as managers or contractors; these are only roles, and any node can take on either role dynamically”(节点不被先验指定,任何节点可动态承担任一角色)memo624-p15。承包者执行中还能分解子任务、向下转包:它一边是上一份合同的承包者,一边是新招标的管理者。合同逐层转包下去,长成一棵合同树;终止消息也沿树传播——总包解约,分包及其二级分包一并终止:
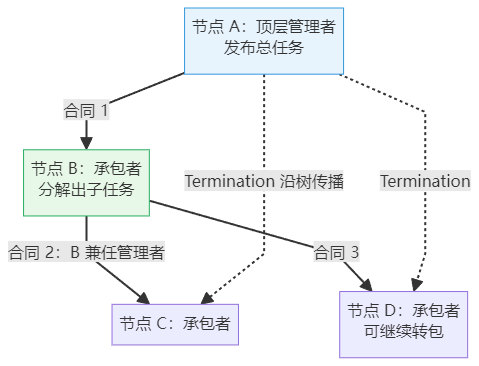
这张树形图说明合同网的“网”不在拓扑而在角色:任何节点都同时活在多份合同里,时而甲方、时而乙方。论文还为这套消息定了一条近乎语言哲学的规矩(p20)memo624-p20:
> “It is useful to adopt the perspective that the messages are statements in a language, rather than, say, patterns to be matched.” ——把消息视为语言中的语句、而非待匹配的模式,是有用的视角
消息不是触发器(收到 X 就做 Y),而是可解析、可推理、可选择性回应的语句。模式匹配是二值的,语句理解是连续的:节点可以评估一条消息与自身状态的相关性。由此带来惊人的可扩展性:”new nodes can simply be added to the existing collection; they will find their own place in the scheme of things by listening to task announcements, issuing bids”,新节点入网无须任何人指派,听招标、自评、投标,自己找到自己的位置memo624-p20。论文第 9 节(p33)最后把整套机制放进一个漂亮的三分法memo624-p33:
> “if the caller alone selects, it’s invocation; if the respondent alone selects, it’s a blackboard; and if both select, it’s negotiation.” ——若只有调用者选择,是过程调用;若只有应答者选择,是黑板;若双方都选择,是协商。
子程序调用与黑板由此被重释为协商的退化形式:前者调用者单方选,后者应答者单方选,只有合同网让双方各持选择权。三种看似不相关的架构被统一进一个谱系。这也顺手解释了协商为什么最贵:信息双向、评估局部、选择对称。
## 让协议跑起来:14 条消息完成一次匹配
复现仓搭了个最小市场:6 个节点,Node-0 与 Node-1 各发布一个任务,其余 4 个节点作为潜在承包者评估、投标。协议在第一轮(t=0)就完成了全部匹配,总消息数 14 条:
阶段消息类型数量说明招标TaskAnnouncement2两位管理者各发布一个任务投标Bid84 个承包者各对 2 个任务投标中标Award2每位管理者各选一个最佳投标者报告Report2承包者完成并提交最终报告**合计****14**
中标者是 Node-2(能力值 0.85,压过 0.60/0.40/0.30 三份投标)和 Node-4(0.90,压过 0.30/0.75/0.50)。两位管理者各自贪心,恰好都选到了全场最优,全局效用 1.75 正好也是最优匹配的效用。把 14 条消息拆开看,市场的形状就出来了:两条招标广播出去,8 份投标汇回来,信息扇出再汇聚;裁决各一条,报告各一条。整个匹配过程中没有任何一条消息经过中央节点,也没有任何节点见过全局状态——“既无全局控制亦无全局数据存储”在消息层就是这个形状。顺境。但顺境是有条件的:两位管理者看中的恰好是不同的节点;一旦同时看中同一个节点,协议的另一面就露出来了。
## 囚徒困境:每个节点都选了最优,系统却拿了次优
论文 §11.4(p36)自己给出了这条自反性批评memo624:
> “The best global assignment does not necessarily result from the simple concatenation of all the best local assignments.” ——最好的全局分配,未必来自所有最好局部分配的简单拼接。
脚注 22 说得更直白:这”appears to be a variety of the ‘prisoner’s dilemma’ problem”,囚徒困境的一种变体。数字例:管理者 Mgr-A、Mgr-B,承包者 Con-X、Con-Y;Con-X 两项都强(task_1 评 0.9、task_2 评 0.8),Con-Y 只有 task_1 尚可(0.8),task_2 很弱(0.2)。两位管理者独立贪心,都会选 Con-X。复现跑出的三种效用:
视角分配效用可达性局部最优拼接task_1→Con-X(0.9)、task_2→Con-X(0.8)**1.7**不可达:Con-X 不能同时接两份合同协议实际产出task_1→Con-X(0.9)、task_2→Con-Y(0.2)**1.1**先到先得的真实结果全局最优task_1→Con-Y(0.8)、task_2→Con-X(0.8)**1.6**需要中央仲裁者——合同网没有
节点日志记下了困境的全过程:
```
[Mgr-B]
[MANAGER] 评估 2 份投标 -> 中标 Con-X (cap=0.80)
[MANAGER] Con-X 已被占用 -> task_2 中标被拒,下一轮重选
[MANAGER] 评估 1 份投标 -> 中标 Con-Y (cap=0.20)
```
同一轮里,两位管理者独立评估、都裁给 Con-X;Con-X 只能接一份合同,Mgr-A 的中标先被处理,Con-X 接下 task_1 并置忙;Mgr-B 的中标被拒,下一轮只剩 Con-Y 的 0.2 可选。局部最优拼接(1.7)不可达;实际产出(1.1)是先到先得的结果;全局最优(1.6)需要 Mgr-A 主动让出 Con-X。这要求一个掌握所有人能力与偏好的中央仲裁者,而论文自己在第 10 节(p34)命名了它不存在的原因:连接问题(connection problem)——”no one node has complete knowledge of either the capabilities of or the busy/idle state of every node in the network”(没有任何节点掌握全网的能力与忙闲状态)memo624。论文把原因归为两条:一是 timing:投标异步到达,稍等片刻或许能等到更好的匹配,但协议里没有任何一方有“等”的动机或机制,先到先得写在裁决的贪心里;二是局部决策本身,各节点的最优拼不出全局的最优。招标-投标正是为了让匹配在缺乏全局知识时仍然发生;但它只保证匹配发生,不保证匹配最优。
## 当投标者必须诚实:自评的诚实性挤压市场深度
回头看那两轮评估,会发现整个市场押在一个从未被论证的前提上:节点会诚实报告自己的能力。Bar-Hillel 当年批评机器翻译把“理解”偷换为“模式匹配”、预设了一个不成立的等价前提;合同网有一个结构相同的软肋——它把“合作”偷换为“自愿投标”。论文用“兴趣水平”描述投标值,但兴趣不是效用函数:它没有定义节点为什么投标、投多高、什么时候会策略性偏离。节点可以虚报能力抢合同,也可以瞒报能力躲任务,协议对此没有任何防御。
这也不是事后诸葛。Zlotkin & Rosenschein 1989 年的批评正冲这里:”Smith’s original work assumed some autonomy among agents, these agents willingly bid for tasks without explicit motivation”,这些智能体没有任何明确动机就自愿投标zr1989。他们那条研究线的全部工作,就是给“自愿投标”补上效用模型,并证明协议设计可以封死有利的不诚实行为。合同网没有这种保证。
> **编者注**:以下为 **2026 新增 A/B 对照实验**(E5),把”诚实自评”这一个组件换成 LLM,观察合同网市场会发生什么。原始数据:`../experiment_results/ab_e5_contractnet_selfassessment.json`(240 次调用,36,380 tokens)。
实验设计尽量薄:基线是确定性古代机制,节点自评就是查真值能力矩阵;变体只替换这一个组件:LLM(deepseek-chat,temperature 0.3)从定性能力自述映射出 0-1 能力分数,自述与真值同源但不含数字(Con-Y 对 task_2 的自述是“没有检测仪器,几乎做不了”);管理者裁决与协议流程逐字节不动。校准部分 12 项自评 × 10 轮独立抽样:
校准(12 项 × 10 轮 = 120 次自评)结果失败模式分布correct×61,underbid×58,overbid×1MAE 均值0.127强项自评0.85→0.95、0.9→0.95、0.9→0.85——头部校准良好弱项自评0.3→0.1、0.5→0.3、0.2→**0.05**——中低段系统性压低
LLM 自评呈不对称校准:对强能力诚实甚至略乐观,对弱/中能力系统性严厉:120 次自评中 61 次落在真值 ±0.1 内、58 次低估、高估仅 1 次(第 8 轮 Node-4 把 0.4 自评为 0.6)。后果在下游精确显形:
下游场景(10 轮)基线效用LLM 效用全局最优基础场景1.751.75±[1.75, 1.75](最优分配保持)1.75囚徒困境1.1**0.90±[0.9, 0.9](恶化)**1.6
基础场景的头部排序未被扰动,最优分配 10/10 轮保持;囚徒困境场景中,Con-Y 对 task_2 的真值 0.2 被自评为 0.05,跌破投标门槛 0.1,干脆不投标。task_2 失去唯一的兜底承包者,Con-X 又忙于 task_1,该任务无人中标,全局效用从基线的 1.1 跌到 0.9(10/10 轮一致),离全局最优 1.6 更远。
这个结果不该读成“LLM 不诚实”——恰恰相反,它是诚实的:让它如实书写能力语义,它就如实写“几乎做不了”。问题在于,合同网市场依赖的正是那些弱但非零的冗余容量做兜底,诚实的自评把这些容量挤出了市场。[作者判断] 这也是 [blog-09 意图编辑权](https://www.paddysun.top/?p=5160)里“Agent Card 是接口还是内容”之问的一个定量答案方向:自述越诚实,市场越浅。把合同网放进 BDI 坐标,这个缺口看得更清楚:
维度合同网 1981LLM Agent 2026信念招标消息四槽位 + 节点能力自述参数分布 + system prompt + RAG愿望任务规范(外部招标下发)用户指令 / task description意图合同(相互选择的承诺)ReAct 循环的 action 序列承诺语义显式协议,可单方终止tool call 是隐式承诺,无终止条款最优性保证不保证全局最优(囚徒困境)不保证最优(采样随机性)
愿望由招标下发而非节点自生,承接与否由自评决定——这与当代 LLM Agent“愿望由 prompt 下发、LLM 按概率采样执行”结构同构。但地基不同:合同网预设节点有固定、可验证的能力值,LLM Agent 的“能力”是 prompt 生成的概率分布。当 MetaGPT 的 Product Manager 向 Engineer“分配”任务时,投标是一段自然语言,不是可验证的能力值metagpt。合同网的 Bar-Hillel 式局限在 LLM 基座上不仅没被克服,反而被放大了。
## 从 Memo 624 到 FIPA cfp:一份协议的四十五年继承
合同网的第二个持久贡献是“协议观”。第 4.2 节(p10)有一段被后续文献反复引用的论证memo624-p10:
> “Cooperation cannot be established between nodes simply by indicating how they are to communicate; we must also indicate what they should say to each other.” ——仅指出节点如何通信并不能建立合作——还必须指出它们彼此该说什么。
TCP/IP 只规定比特怎么从 A 到 B,是传输协议而非问题求解协议;Davis 和 Smith 主张,分布式 AI 的协议必须规定消息的内容。“Agent 通信协议”由此成为独立研究对象,并最终长成标准。1997 年 FIPA-ACL 的五种言语行为,就是合同网五种消息的标准化转世:
合同网 1981FIPA-ACL 1997TaskAnnouncement(招标)cfp(call for proposal)Bid(投标)proposeAward(中标)accept-proposalReport(报告)informTermination(终止)cancel
这条继承线在时间轴上展开:
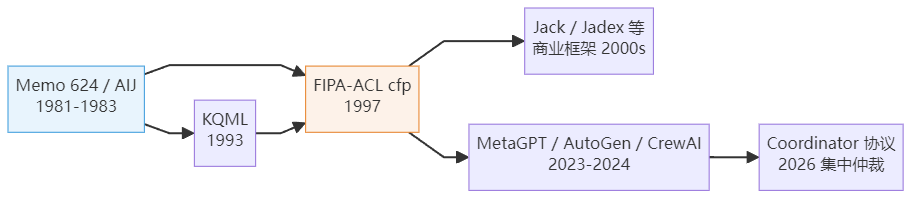
图里每个箭头的分量并不相等,按“有引证才说”的原则分级如下:
引证强度系统 / 标准继承点强FIPA-ACL(1997)fipa、KQML(1993)kqml、Jack / Jadex jadex、ECN / HCN 变体 smith1980直接继承协议语义:五消息即五种言语行为;消息类型形式化;框架内置合同网中强HEARSAY-II 黑板重释 erman、Zlotkin & Rosenschein(1989)zr1989、PERSUADER(1988)sycara、MetaGPT(2023)metagpt工程化协商概念:三分法重释黑板;补效用模型;论据改变对方效用;SOP 隐式招标中等AutoGen(2023)autogen、CrewAI(2024)crewai、Coordinator 协议(2026)概念启发:消息交换编排、manager/worker 角色动态分配、集中仲裁补囚徒困境缺口
看最右端:Dochkina 2026 的 Coordinator 协议用集中仲裁解决合同网的囚徒困境,代价是放弃去中心化。这条当代线索在 [blog-10](https://www.paddysun.top/?p=5167) 展开。而合同网对传统调用机制”designed to carry one particular sort of information”(只承载一种信息)的批评(p32),正是 FIPA 走向通用 ACL 的动机。
## 论文自己划下的四条边界
合同网的局限不用等后人来挑,论文自己认了四条。第一,囚徒困境:协商不保证最优匹配,原因有二——消息异步到达(timing)与局部决策,上面 1.7/1.1/1.6 三个数字已经量过。第二,合作假设:协议预设节点诚实投标、自愿承接、管理者公平裁决,而脚注 22 自认匹配权竞争是囚徒困境的变体。合作框架内部自认了冲突,把真正的利益冲突域留给后续工作。第三,无动机模型:如 Z&R 所批,“兴趣水平”不是效用函数,谁投标、投多高都不由期望效用计算决定。第四,版本边界:AIJ 期刊版与 Smith 1980 博士论文含节点任务评估的加权和公式(含 node workload 项),Memo 624 全文(已逐页核至 p36)无此公式。凡引该公式须改标期刊版,不得以本存档为源。
这四条边界没有一条毁掉合同网,反而划出了此后多 Agent 研究的地图:Z&R 与 PERSUADER 去补效用与冲突([blog-05 三种仲裁](https://www.paddysun.top/?p=5136)),KQML 与 FIPA 去标准化语言([blog-07 智能体如何找到彼此](https://www.paddysun.top/?p=5153)),Coordinator 用集中仲裁换效率([blog-10](https://www.paddysun.top/?p=5167)),Agent Card 重新追问自述的语义([blog-09](https://www.paddysun.top/?p=5160))。它与 Minsky 的心智社会殊途同归——后者把冲突与协商搬进脑内,前者搬到网络节点间;智能是多个半自主单元协商的结果,而非单一引擎的产物。Wooldridge & Jennings 笔下的“社会性”([blog-03 何为 Agent](https://www.paddysun.top/?p=5128))在这里第一次有了可运行的形态:协作从哲学概念变成协议语义,协商从修辞变成控制转移机制——双方各持评估权,谁也不能单方面指挥谁。四十五年后,当 LLM Agent 们开始互相招标,它们说的还是那五句话。
## 参考文献
[**memo624**] Davis, R. & Smith, R. G. “Negotiation as a Metaphor for Distributed Problem Solving.” MIT AI Memo No. 624, May 1981.(精读存档 `原始文章\03f-DavisSmith-ContractNet-1983.pdf`,44 页扫描件,文本层 0 字符,逐页图像阅读转录。引用页码均按 memo 页码标注。)
[**memo624-p1**] 同上,封面摘要(p1)。
[**memo624-p10**] 同上,第 4.2 节(p10)。
[**memo624-p15**] 同上,第 7.3 节(p15)。
[**memo624-p20**] 同上,第 7.4-7.5 节(p20-21)。
[**memo624-p33**] 同上,第 9 节(p33)。
[**smith1980**] Smith, R. G. “A Framework for Distributed Problem Solving.” PhD dissertation, 1980. [https://doi.org/10.21236/A087209](https://doi.org/10.21236/A087209)
[**fipa**] FIPA, Foundation for Intelligent Physical Agents, FIPA-ACL specification. [https://fipa.org](https://fipa.org/)
[**kqml**] Finin, T. et al., KQML. [https://www.cs.umbc.edu/csee/677/papers/kqml.pdf](https://www.cs.umbc.edu/csee/677/papers/kqml.pdf)
[**jadex**] Jadex Active Components framework. [https://jadex.org](https://jadex.org/)
[**erman**] Erman, L. D. et al., “The Hearsay-II Speech-Understanding System: Integrating Knowledge to Resolve Uncertainty.” ACM Computing Surveys, 1980. [https://doi.org/10.1145/357580.357586](https://doi.org/10.1145/357580.357586)
[**zr1989**] Zlotkin, G. & Rosenschein, J. S. “Negotiation and Task Sharing Among Autonomous Agents in Cooperative Domain.” IJCAI-89, 1989. [https://doi.org/10.1016/B978-0-934613-85-5.50142-X](https://doi.org/10.1016/B978-0-934613-85-5.50142-X)
[**sycara**] Sycara, K. “Resolving Adversarial Conflicts: An Approach to Multi-Agent Negotiation.” AAAI-88, 1988. [https://ojs.aaai.org/index.php/AAAI/article/view/4588](https://ojs.aaai.org/index.php/AAAI/article/view/4588)
[**metagpt**] Hong, S. et al., “MetaGPT: Meta Programming for a Multi-Agent Collaborative Framework.” 2023. [https://github.com/geekan/MetaGPT](https://github.com/geekan/MetaGPT)
[**autogen**] Microsoft, “AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation.” 2023. [https://github.com/microsoft/autogen](https://github.com/microsoft/autogen)
[**crewai**] CrewAI Inc., “CrewAI.” 2024. [https://github.com/crewAIInc/crewAI](https://github.com/crewAIInc/crewAI)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 什么是 Agent?Wooldridge & Jennings 弱概念四性质与强概念定义详解
https://www.paddysun.top/archives/5128 · 2026-09-01
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:第 3 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [BDI 从理论到工程](https://www.paddysun.top/?p=5122) **阅读时间**:约 12 分钟
---
# 何为 Agent:1995 年的双层锚定与三层视角
## 一个词,四个社区,各说各话
1995 年,想在任何一场计算机科学会议上挑起争论,只需要问一句:“什么是 Agent?”
软件工程师会说,Agent 是“自包含的、并发执行、通过消息传递通信的软件进程”,不过是并发编程范式的自然发展 genesereth1994 agha1993。AI 研究者会摇头:Agent 是“用心智概念(知识、信念、意图、义务)来概念化或实现的系统” shoham1993。分布式系统社区说它是自治的网络节点;连用户界面领域也凑热闹:一个带动画面孔的程序也敢自称 Agent。
同一个词,至少四种含义,彼此不通约。这就是 Michael Wooldridge 和 Nicholas Jennings 动笔时面对的局面。两人发表在《The Knowledge Engineering Review》上的综述有 38 页,标题朴素得像教材章节(”Intelligent Agents: Theory and Practice”),但它做的事情远比综述重要:不再追问统一的定义,而是给混乱的概念提供一个双层锚定(弱概念 + 强概念)和一个三层视角(理论-架构-语言),这个框架至今仍在被使用 wj1995。
W&J 的真实难题是**如何把互不相容的回答组织成一个可讨论的框架**;“Agent 是什么”这个问题,太多人回答过了。开篇的措辞很委婉:”The concept of an agent has become important in both Artificial Intelligence (AI) and mainstream computer science” wj1995,但论文的组织方式暴露了实情:他们不得不同时在硬件层、软件层、AI 层、分布式系统层给出定义。
## 弱概念:四条只要”看起来”成立的性质
W&J 的解法极其简洁:承认存在两个层次的定义,让它们并存。第一层是**弱概念**(weak notion),行为层面的描述性定义。Agent 是“享有以下性质的硬件或(更常见的)软件计算机系统” wj1995:
> - **自主性**(autonomy):”agents operate without the direct intervention of humans or others, and have some kind of control over their actions and internal state”
> - **社会性**(social ability):”agents interact with other agents (and possibly humans) via some kind of agent-communication language”
> - **反应性**(reactivity):”agents perceive their environment … and respond in a timely fashion to changes that occur in it”
> - **主动性**(pro-activeness):”agents do not simply act in response to their environment, they are able to exhibit goal-directed behaviour by taking the initiative”
> **勘误注记**:四性质在原文中明确标注为“弱概念”(A Weak Notion of Agency),同页并列的还有基于心智状态的“强概念”(A Stronger Notion of Agency)。引用四性质时宜注明层次:它们是 Agent 的“弱概念定义”,不宜径直称作“定义”。
弱概念的妙处在于不预设任何内部结构:一个系统“看起来”具有四性质即可,无论内部是模态逻辑推理机、神经网络还是 if-else 规则。这四条还有个工程上的好处:每一条都能写成可运行的检验。我们在复现仓库(`../agent-properties-reproduction/`,纯 Python 标准库)里搭了最小验证框架,逐一过堂。
### 自主性:无人干预,自行运转
检验方式是:给 Agent 信念、目标和计划,然后只给时间步,不给指令。
```
agent.add_belief("task_available")
agent.add_goal("complete_task")
agent.add_plan("complete_task", ["select_subtask", "execute", "report"])
for t in range(5):
agent.step()
```
五个时间步没有任何外部命令,Agent 自行依次执行了 select_subtask、execute、report 三步,`has_acted_independently` 置为 True。行动由自身目标而非调用流驱动——这就是“对自身行动和内部状态有某种控制”的最小形态,传统程序做不到这一点。2026 年 Dochkina 的实证还表明,这类自主行为可以从简单交互规则中涌现,不必显式编程(见[第 10 篇](https://www.paddysun.top/?p=5167))。
### 社会性:用通信语言协作
社会性要求的不只是消息传递,而是理解和使用结构化通信协议。框架里 Message 分 inform、request、ack 三类。当 Agent 有目标却没有计划时,它会向同伴求援:
```
msg = Message(self.name, target.name, goal, "request")
self.env.send_message(msg)
self._pending_requests.add(goal)
```
实验里 A1 有目标 get_data_from_a2 却无计划;A2 有信念 data_ready 和计划 provide_data。A1 发出 request,A2 激活计划,执行到 send 步时回传一条 inform,最终消息交换 2 次,任务完成。请求与告知的一个往返,就是社会性的最小实例;[第 4 篇](https://www.paddysun.top/?p=5132)合同网的招标-投标-授标机制,全部建立在这条性质之上。
### 反应性:环境变了就及时响应
反应性的关键词是“及时”:不仅要响应,还要在适当时间内响应。检验方式是让环境在某个时刻突变,看 Agent 下一步做什么。
```
agent.add_plan("respond_to_alarm", ["evacuate"])
agent.step() # 变化前
env.set_condition("alarm_active") # 环境变化
agent.step() # 变化后
```
变化前行动数为 0;设置 alarm_active 后,下一步立即执行 evacuate,行动数变为 1,`has_responded_to('alarm_active')` 返回 True。对接逻辑在 `_check_reactivity`:环境条件的关键词出现在计划名中即触发。0 与 1 的对比,就是“及时响应”的可观察证据。
### 主动性:没人催,自己干
主动性是 Agent 与恒温器这类纯反应系统的分界线:不只应答环境,还主动展现目标导向行为。检验方式恰好是反应性的反面:环境从头到尾不变。
```
agent.add_goal("improve_efficiency")
agent.add_plan("improve_efficiency", ["analyze", "optimize"])
for t in range(5):
agent.step() # 环境始终无变化
```
五个时间步、零环境变化,Agent 主动执行了 analyze 和 optimize 两步,主动行动数为 2。这些行动全部出自对自身目标的追求,并非对刺激的应答,这正是 “taking the initiative” 的字面意思。
### 四性质之间的张力
四性质并非各自独立:反应性要求“及时响应”,主动性要求“坚持目标”——环境突变时,Agent 是放下目标去响应,还是无视变化继续推进?这个张力直接导致了架构层三分的出现,后文会回到它。
## 强概念:心智状态入场,麻烦也开始
弱概念四条全部验证通过,那 W&J 为什么还要第二层?因为“看起来像 Agent”不等于“是 Agent”。**强概念**(stronger notion)在四性质之上再加一层约束:
> “a computer system that, in addition to having the properties identified above, is either conceptualised or implemented using concepts that are more usually applied to humans” wj1995
翻译过来:用知识、信念、意图、义务这些通常只适用于人类的心智概念来概念化或实现的系统 shoham1993。W&J 观察到,强概念的支持者“主要是那些在 AI 领域工作的研究者” wj1995;也有人走得更远,考虑带情感的 Agent bates1994——但 W&J 指出,用心智状态设计 Agent 并非“无意义的拟人化”(pointless anthropomorphism)。
那么强概念能否像弱概念一样被实验验证?我们在同一框架里做了一个判定实验,结果失败了——而且很有教益。给 Agent 两条信念,计算信念库的全部逻辑后承:
```
consequences = set(self.beliefs)
changed = True
while changed:
changed = False
for belief in list(consequences):
if "_implies_" in belief:
antecedent, consequent = belief.split("_implies_")
if antecedent in consequences and consequent not in consequences:
consequences.add(consequent)
changed = True
```
信念库是 {‘P’, ‘P_implies_Q’},闭包却是 {‘P’, ‘Q’, ‘P_implies_Q’},后承数量从 2 涨到 3——Agent 被“推出”知道了 Q,尽管它从未显式考虑过 Q。这就是可能世界语义著名的**逻辑全知问题**(logical omniscience):一旦用模态逻辑形式化信念,Agent 就必然“知道”其所有信念的所有逻辑后承。弱概念与强概念的判定差异在此显形:前者的四性质可以逐条行为验证;后者撞上的第一块礁石,就是它自己的形式化工具。
**“概念化或实现”——两条途径。** 定义中的析取词 “either conceptualised or implemented” 是关键结构:软途径只要求用心智概念*描述*系统,心智状态是理论层面的描述与预测词汇;硬途径要求心智状态作为*内部结构*存在,即实现层面的数据结构或语言原语。BDI 逻辑框架走软途径(信念、意图是模态算子);AGENT0 走硬途径的极端(心智状态直接成为语言原语);dMARS 的意图栈是硬途径的工程温和版,尽管 AgentSpeak(L) 后来承认这只是设计者“外部归因”的诠释标签(见[第 2 篇](https://www.paddysun.top/?p=5122))。两条途径的分离预示了结尾的判断:软途径优雅但撞上逻辑全知,硬途径可运行但语义对应从未被证明。
**词汇不等于状态。** 使用心智词汇不等于满足强概念:ELIZA 也可以说“我相信你今天不开心”,但这些词不参与任何推理约束,删掉它们行为不变。强概念的实质是心智状态作为**受理性约束的实体**进入系统的描述或实现——信念须满足一致性;不相信不可能之事能成为目标;意图在相信已达成或不可能之前不放弃(C&L 的 PGOAL 放弃条件,见[第 1 篇](https://www.paddysun.top/?p=5118));意图之间须相互协调。这正是 C&L 标题中 “rational balance” 的含义。也是在这个意义上,在 system prompt 里写“你有信念和意图”不构成强概念:那些词不约束任何后续生成。
**意向立场的合法性。** 强概念的哲学底座是 Dennett 的意向立场 dennett1987:在物理立场和设计立场之外,把系统当作理性行动者,用信念和愿望预测其行为。意向立场对任何系统都*可以*采用(恒温器也能被归因为“想保持温度”),真正的问题是它何时**不可替代**。Dennett 的标准是预测经济性:当系统复杂到物理立场和设计立场在计算上不可行时,意向立场成为合法且不可避免的描述层。强概念因此隐含一个承诺:用信念与意图的互动预测这个系统,比逐行追踪代码更经济。这也解释了为什么强概念支持者集中在 AI 界:只有足够复杂的系统才需要这条描述路径。
## 三层视角:理论、架构与语言
双层定义回答了“Agent 是什么”,W&J 还需要回答“如何研究和构建 Agent”:
> “we identify three key issues, and structure our survey around these” wj1995
理论层关注”essentially specifications”:如何概念化 Agent,形式化地表示和推理其性质;架构层关注”the move from specification to implementation”:构造满足理论性质的系统;语言层关注”programming languages that may embody the various principles proposed by theorists”:用什么原语编程 Agent。W&J 坦承三层界限”somewhat dubious”,但其价值不在精确分类,而在提供一张从规格到实现到工具的路线图。整个框架可以这样画:
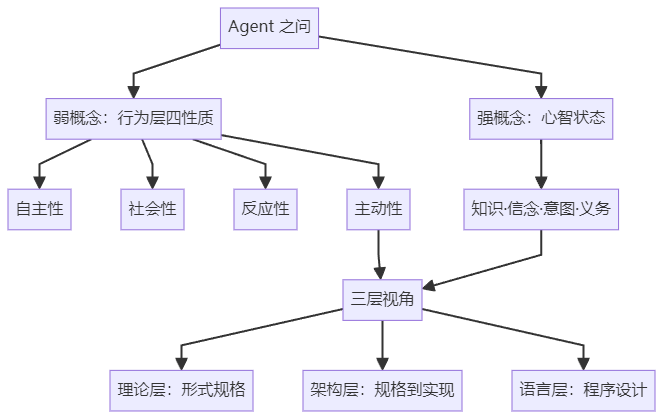
图里最关键的连线,是“主动性”与“心智状态”同时汇入三层视角——弱概念内部的张力与强概念的形式化需求,共同把研究推向了分层视角。
理论层的技术栈是一条清晰路径:意向立场 → 信息/赞成态度二分 → 模态逻辑 + 可能世界语义 → 逻辑全知问题及三种补救。心智状态先被二分:信息态度(信念、知识,对世界的认知)与赞成态度(愿望、目标、意图,对世界的要求);信念用模态算子表示,“Agent 相信 φ”当且仅当 φ 在所有它认为可能的世界中为真。然后,就撞上了实验里已经见过的那块礁石。W&J 讨论的三种补救 wj1995:Levesque 区分显式/隐式信念,Agent 只对显式信念闭包负责 levesque1984;Konolige 用局部演绎闭包替代全局闭包 konolige1986;元语言方法直接引用 Agent 的语法状态。共同思路是承认推理能力有限,与后来 BDI 架构的“资源有限理性”一脉相承。理论层的两个核心实例,正是本系列前两篇的主角:
> W&J 在理论层第 2.6 节专门讨论了 Cohen & Levesque 的工作,将其列为“Agent 理论”的核心实例 cl1990。C&L 的意图形式化试图回答的问题是:强概念中的“意图”应该被如何形式化?他们的回答——意图是对未来行动的承诺,且承诺意味着不轻易放弃——直接为后续的 BDI 架构提供了理论基础。
> Rao & Georgeff 的 BDI 形式化是 W&J 强概念的工程实现。W&J 在理论层和架构层都讨论了 R&G 的工作——理论层将 BDI 逻辑列为 Agent 理论的核心实例,架构层将 PRS(R&G 的工程实现)列为混合分层架构的代表 rg1995 georgeff1987。R&G 的贡献在于:他们不仅在理论层形式化了 BDI,还在架构层实现了 PRS——这是少数跨越了 W&J“理论-架构”鸿沟的工作。
架构层的三分已成为 Agent 架构研究的标准分类 wj1995:
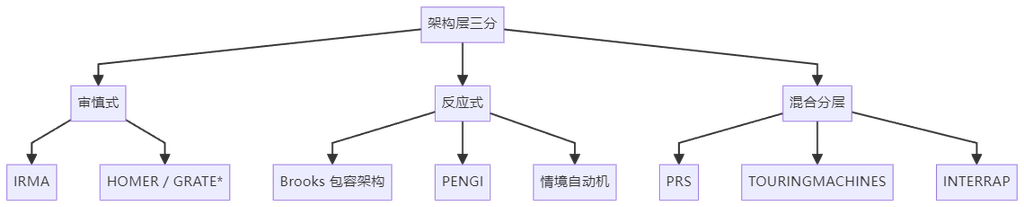
审慎式架构继承经典 AI 的符号推理传统:维护显式世界模型,靠规划和手段-目的推理决定行动,代表是 IRMA(Bratman, Israel & Pollack bratman1988)、HOMER 和 GRATE*——其中 IRMA 是 Bratman 实践推理哲学的直接工程化。它内含一个“手段-目的分析器”(means-end analyser),与阶段二的 MYCIN 在“显式知识库 + 符号推理”上结构同构。反应式架构反其道而行:不建世界模型、不规划,行为由感知-行动规则直接驱动:Brooks 包容架构 brooks1986、PENGI、情境自动机,核心主张是智能不需要内部世界模型。混合分层架构两者兼取:底层快速反应、中层目标驱动、顶层规划,代表是 PRS georgeff1987、TOURINGMACHINES 和 INTERRAP。
> **勘误注记**:“手段-目的推理”并非 W&J 本文的通用术语,而是 W&J 在描述 IRMA 架构时引用 Bratman 等人的 means-end analyser 组件时的用语。引用时宜注明出处。
> **勘误注记**:W&J 的架构层三分(审慎式/反应式/混合分层)在原文中逐字验证。但 PRS 的具体分类需注意:在 W&J 论文的目录结构中,PRS 出现在”Hybrid Architectures”节下;但 PRS 的计划库驱动机制与审慎式架构有显著的结构相似性,这也是不同综述对 PRS 分类不一致的原因。
语言层三类语言的设计哲学截然不同。AGENT0/PLACA 从理论出发,让编程语言直接体现模态逻辑;Concurrent MetateM 从规约出发——Agent 由时序逻辑公式直接规约,前件触发后件对应的行动,规约即程序,消除了规约与实现的缝隙 fisher1994;TELESCRIPT 从应用出发,用“远程编程”让 Agent 自主迁移到远程主机执行,是四性质的工业级实例化:自主性是远程独立运行,社会性是 Agent 间通信,反应性是对远程环境的感知响应,主动性是主动发起迁移与执行 white1994。这个谱系暗示了一个困难:AGENT0 有理论但工程化不足,TELESCRIPT 有工程但理论不足。
## Shoham 的 AOP:让心智状态成为语言原语
W&J 的强概念明确归因于 Shoham 1993 的 Agent-Oriented Programming(AOP)范式 shoham1993。Shoham 的核心思想是:不仅用心智概念*描述* Agent(理论层的事),而且用心智概念作为编程语言的*原语*来构建 Agent(语言层的事)。在 AGENT0 语言中,Agent 的程序直接包含信念、承诺和能力的声明与规则;Agent 之间通过基于言语行为理论的结构化消息通信,消息类型包括告知、请求、提供。
W&J 对此的评价是技术性的:AGENT0 的逻辑组件是一个量化多模态逻辑,允许直接引用时间,包含信念、承诺和能力三个模态词,但没有给出形式语义 wj1995。“没有形式语义”这五个字预示了全文的重要主题:强概念的理论很优雅,但从理论到可运行代码的距离,远比人们想象的要远。
## 把四性质装进一个 step:可操作化验证的集成
单性质验证之后的问题是:四性质能否在同一个 Agent 里共存?MinimalAgent 给出肯定回答。框架只有三个模块:Message(通信单位)、Environment(注册表、环境条件、消息投递)、MinimalAgent(信念库、目标库、计划库、收件箱)。四性质集成的核心是 step 方法,每步的执行顺序本身就是一次架构决策:
```
def step(self):
# 1. 处理收到的消息(社会性)
self._process_messages()
# 2. 检查环境变化并响应(反应性)
reacted = self._check_reactivity()
# 3. 无反应性需求时,主动追求目标(主动性/自主性)
if not reacted:
self._pursue_goals()
# 4. 投递本步发送的消息
self.env.deliver_messages()
```
一步之内的流转如下图所示。
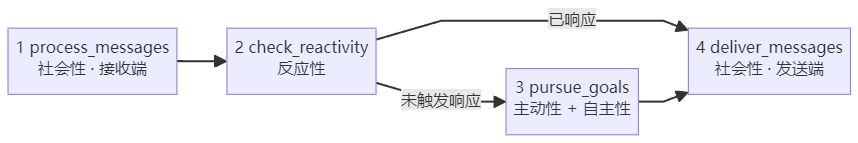
注意第 2、3 步的结构:反应性优先于主动性,但两者在同一个 step 中共存——这正是架构层三分中“混合分层”思想在一个函数里的投影,四性质的张力被一个 if 语句就地仲裁。这个框架证明了弱概念的可操作化:四性质可以逐条定义、逐条检验,并在一个主循环里集成。但它也诚实地暴露了边界:MinimalAgent 的“信念”只是集合,“意图”只是计划名——代码注释里写着“弱概念层用集合模拟,非真正的模态逻辑”。
> **作者判断**:这个复现框架是弱概念的完整验证,却是强概念的零步推进——四性质全部可观察、可判定,而心智状态的理性约束一条都没有实现。这本身就是 W&J 双层定义最生动的注脚。
## 三十年后的回响:只有弱概念层的 LLM Agent
W&J 的双层定义在当代 LLM Agent 语境下,可以用 BDI 坐标审视:
维度W&J 1995LLM Agent 2026信念强概念:心智状态(知识/信念/义务)参数统计分布 + system prompt愿望强概念:意图/目标用户指令 / task description意图强概念:对未来行动的承诺ReAct 循环的 action 序列定义层次弱概念(行为层)vs 强概念(心智层)双层只有弱概念(行为层),无强概念自主性“无人直接干预下运行”LLM 被动等待 prompt,无自主发起
今天说“LLM 是 Agent”时,用的正是弱概念——LLM 看起来有自主性(ReAct 循环中自行决定下一步)、社会性(用自然语言与其他 Agent 通信)、反应性(响应输入)和主动性(主动发起行动)。但它没有强概念意义上的信念、意图和义务:这些不是内部数据结构,而是外部观察者归因的诠释标签——“信念”是参数统计分布的外部投射,“意图”是 action 序列的事后描述,“义务”根本没有对应物。
这就是 W&J 弱概念留下的 Bar-Hillel 式批评:**行为相似不等于机制等价**。弱概念允许与 ELIZA 同构的结构复现——一个简单的 if-else 系统也可以“看起来”具有四性质,而内部没有任何心智结构。W&J 用双层定义诚实标注了这一局限,但三十年后,Agent 社区在多数实践中仍然只用弱概念层。强概念层被搁置了,不是因为问题解决了,而是因为太难了。
> **作者判断**:ELIZA 通过关键词匹配”看起来”理解对话,弱概念 Agent 通过行为特征”看起来”自主,LLM 通过流畅语言”看起来”有意图——三层错觉共享同一个结构,而 W&J 的双层定义正是为标出这种结构而生的工具。
补篇 C 会看到 [Ciatto 等人 2025 年的工作](https://www.paddysun.top/?p=5172):把 LLM 放进 BDI 架构充当计划生成模块——三十年来强概念第一次具备自主获取计划的能力,但也把 “believes achieved” 的前提选择难题暴露得更尖锐。而“谁编辑 Agent 的心智状态”([第 9 篇](https://www.paddysun.top/?p=5160)的意图编辑权),W&J 的框架使它可以被精确提出,即使没有给出答案。
## 影响谱系与诚实的边界
一张表看清 W&J 1995 的影响所及,引证强度分级如下:
影响路径引证强度证据弱概念四性质 → Agent 教材标准定义强Wooldridge 2009 教材直接沿用 wooldridge2009三层视角 → Agent 研究方法论强后续综述普遍采用理论-架构-语言三分法强概念 → Shoham AOP 范式强原文直接引用 Shoham 1993 并明确归因 wj1995 shoham1993架构三分 → Agent 架构分类标准强审慎式/反应式/混合分层成为教材标准分类理论层 → BDI 形式化谱系中强论文第 2.6 节专门讨论 C&L 与 R&G cl1990 rg1995架构层 → PRS/IRMA/INTERRAP 传播中强对每个架构的讨论成为后续引用入口语言层 → AGENT0/Concurrent MetateM 传播中强论文是这些语言被广泛认知的重要渠道弱概念四性质 → FIPA ACL 标准中FIPA 引用类似属性,无直接因果链 fipa弱概念 → 当代 LLM Agent 定义中概念传承(行为层定义),无直接引用链逻辑全知讨论 → 后续认知逻辑研究中概念影响,非直接引用
诚实的边界同样要讲清楚。W&J 1995 是一篇**综述**,不是原创理论:四性质中的任何一个都不是它发明的——自主性、社会性、反应性、主动性此前已被多位研究者分别讨论;IRMA、PRS、Brooks 包容架构、AGENT0、TELESCRIPT 也都是被综述的对象。它的贡献在于**整合**:把分散的概念整合成一个双层定义和三层视角的框架,使后续研究者能在同一框架内讨论 Agent。
它也没有直接影响到神经网络和深度学习,与符号 Agent 无因果链;没有影响到 Transformer,注意力机制与 Agent 理论无关联;也没有参与当代 LLM 的训练,反向传播与模态逻辑无关联。
而最大的边界是:强概念路线(用模态逻辑形式化心智状态)从未被真正工程化。AGENT0 有理论原型但无工程化版本;Concurrent MetateM 有可执行原型但未广泛使用;TELESCRIPT 有工业实现但与心智状态理论无关。**理论与工程之间的鸿沟**——这是 W&J 全文暗示但未明言的最大主题。三十年后,当我们用弱概念称呼每一个带工具调用的 LLM 系统时,1995 年留下的那层空着的强概念仍是一份悬而未决的账单:行为可以验证,心智还没有。[作者判断]
---
## 参考文献
[**wj1995**] Wooldridge, M. & Jennings, N. R. (1995). “Intelligent Agents: Theory and Practice.” *The Knowledge Engineering Review*, 10(2), 115-152. [https://www.cs.ox.ac.uk/people/michael.wooldridge/pubs/ker95/ker95-html.html](https://www.cs.ox.ac.uk/people/michael.wooldridge/pubs/ker95/ker95-html.html)
[**shoham1993**] Shoham, Y. (1993). “Agent-oriented programming.” *Artificial Intelligence*, 60(1), 51-92. [https://www.sciencedirect.com/science/article/pii/0004370292900699](https://www.sciencedirect.com/science/article/pii/0004370292900699)
[**cl1990**] Cohen, P. R. & Levesque, H. J. (1990). “Intention is Choice with Commitment.” *Artificial Intelligence*, 42, 213-261.
[**rg1995**] Rao, A. S. & Georgeff, M. P. (1995). “BDI Agents: From Theory to Practice.” *Proc. ICMAS-95*.
[**bratman1988**] Bratman, M. E., Israel, D. J. & Pollack, M. E. (1988). “Plans and Resource-Bounded Practical Reasoning.” *Computational Intelligence*, 4, 349-355. [https://onlinelibrary.wiley.com/doi/abs/10.1111/j.1467-8640.1988.tb00284.x](https://onlinelibrary.wiley.com/doi/abs/10.1111/j.1467-8640.1988.tb00284.x)
[**brooks1986**] Brooks, R. A. (1986). “A robust layered control system for a mobile robot.” *IEEE Journal on Robotics and Automation*, 2(1), 14-23.
[**georgeff1987**] Georgeff, M. P. & Lansky, A. L. (1987). “Reactive reasoning and planning.” *Proc. AAAI-87*.
[**fisher1994**] Fisher, M. (1994). “A survey of Concurrent METATEM.” *Proc. AMAST-93*.
[**white1994**] White, J. E. (1994). “Telescript Technology: Mobile Agents.” *General Magic, Inc.*
[**dennett1987**] Dennett, D. C. (1987). *The Intentional Stance*. MIT Press.
[**genesereth1994**] Genesereth, M. R. & Ketchpel, S. P. (1994). “Software Agents.” *Communications of the ACM*, 37(7).
[**agha1993**] Agha, G. A., Hewitt, C., Bishop, J. & et al. (1993). “Foundational issues in concurrent object-oriented programming.” *SIGPLAN OOPS Messenger*.
[**bates1994**] Bates, J. (1994). “The role of emotion in believable agents.” *Communications of the ACM*, 37(7).
[**levesque1984**] Levesque, H. J. (1984). “A logic of implicit and explicit belief.” *Proc. AAAI-84*.
[**konolige1986**] Konolige, K. (1986). *A Deduction Model of Belief*. Pitman.
[**wooldridge2009**] Wooldridge, M. (2009). *An Introduction to MultiAgent Systems* (2nd ed.). Wiley.
[**fipa**] FIPA (Foundation for Intelligent Physical Agents). “FIPA ACL Message Structure Specification.” [https://www.fipa.org/repository/message-structure.html](https://www.fipa.org/repository/message-structure.html)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 意图即带承诺的选择:1990 年,”不放弃”第一次有了形式定义
https://www.paddysun.top/archives/5118 · 2026-09-01
**系列名称**:[意图即承诺,智能体即社会——自主性的第一个可计算答案](https://www.paddysun.top/?p=5114)
**篇号**:第 1 篇 / 共 11 篇 **主题分类**:历史记述 **前置阅读**:[系列三总览与阅读路线](https://www.paddysun.top/?p=5114) **阅读时间**:约 12 分钟
---
## 引子:一台停不下来的机器
2023 年,AutoGPT 的 README 里写着一条诚恳的警告:这个系统可能永远运行下去,想让它停下,按 Ctrl+C。三年后的 LLM Agent 世界繁花似锦,“自主智能体什么时候可以放弃目标”却几乎无人问津——终止靠人手、靠超时、靠预算见底。
把时钟拨回 1990 年。Artificial Intelligence 期刊第 42 卷第 3 期,SRI International 的 Philip Cohen 与多伦多大学的 Hector Levesque 发表了《Intention Is Choice with Commitment》——意图是带承诺的选择cl1990。这篇论文用一整套形式逻辑回答的,恰恰是这个问题:一个理性的智能体,在什么条件下可以放弃一个目标?
答案短得惊人:在相信目标已经达成、或相信目标永不可能达成之前,不放弃。本系列要讲的全部故事,从单个意图的持续承诺,到智能体之间的合同、谈判、联合意图,再到 LLM 时代自止能力的失而复得,都从这一行约束里生长出来。
## 火种:Bratman 的哲学缺口
故事要从一位哲学家讲起。1987 年,斯坦福的 Michael Bratman 出版了《Intention, Plans, and Practical Reason》bratman1987,把日常的实践推理拆成清晰的概念零件。他的核心论断是:人类行动的关键在于“已决定做什么并承诺坚持”(intention),“想做什么”(wish)只是期待。意图不是一种期待状态,而是一种承诺状态:它约束未来的行动,要求行动者在中途遇到障碍时不轻易放弃。
他的论证分三步。第一步是消极论证:拿戒烟、冲突欲望等日常案例逐一检验信念-欲望心理学,证明两种还原论都系统性地错过了“承诺”现象。第二步是正面刻画:意图由它在实践推理中的功能角色来界定,并非某种独立的心理实体。这个角色有三重:未来行动的导引者(有惯性,无需重虑即兑现为行动)、推理的过滤器(你已决定明天写书评,就不会再认真考虑“要不要临时去滑雪”)、深思的终止者(决定即止,重开深思需要新信息)。第三步是解释红利:这个“第三态度”能解释信念-欲望理论解释不了的三类现象——跨时自我协调(今晚的决定如何合法约束明天的深思)、社会协调(一句“我中午到”让他人得以预测和配合,这是后来整个联合意图传统的种子)、深思经济学(不常重虑不是懒,是必要结构)。
Bratman 还刻画了意图的理性约束:意图与信念须一致(不相信不可能之事能被理性地意图,注意欲望没有这条约束)、手段-目的须融贯、意图之间须可聚合。这些约束正是后来 C&L 那七条 desiderata 的哲学底本。但他的工作止步于哲学分析:没有形式系统,没有算子,没有语义模型。从“意图是承诺”到“智能体如何在代码里承诺”,中间隔着一条形式化方法论的大峡谷。火种已燃,缺的是造桥的人。
## 造桥:用信念和目标拼出意图
1986 年,Cohen 与 Levesque 在 Timberline Workshop 提交早期版本,经 AAAI-87 与 MIT Press 论文集的迭代,1990 年在 AIJ 发表完整版。摘要的第一句话就是纲领:
> “This paper explores principles governing the rational balance among an agent’s beliefs, goals, actions, and intentions.”(本文探讨支配智能体信念、目标、行动与意图之间理性平衡的原则。)cl1990
核心策略是一个关键的方法论选择:意图(INTEND)不设原始模态算子,直接用信念(BEL)与目标(GOAL)两个已有算子复合定义。论文转述 Bratman 的分析道:“Bratman’s analysis makes intention out to be a composite of belief and goal components rather than a primitive mode of behavior”。如果意图是原始算子,什么时候有意图、什么时候放弃意图,全靠公理约定;但如果意图是信念与目标的复合,意图的理性平衡就自动从两者的理性平衡中继承,合理性成了推论而非假设。
他们同时交代了方法论分层:第一层取理想化公理——BEL 取 KD45 约束,GOAL 取世界约束;第二层在公理之上构建定义链与定理;第三层,“Idealized theories will be scrutinized and refined through reflection and by comparison with actual behavior”:理想化理论只算待修正的起点,谈不上最终产品。C&L 自称整项工作属于“theory of the theory”工程:论文给出的是先行理论,是从理想化假设出发的推演,不是对任何实际系统的描述。

从哲学缺口到工程规范,这条链走了十二年,第一环就锻造于这篇论文。在这个框架下,七条 desiderata(原文引出句:“we specify what appear to be the most important constraints”)划定了理性意图的边界:agent 不能意图自己的意图;只要意图做某事且不做别的事,就相信最终会做成;agent 追踪其尝试的最终成败;不能既意图做某行动又意图处于使该行动无法做的处境;意图须与当前信念一致;不必意图其意图的全部可预见副作用;意图须与其他意图和目标相协调。
> **编者注**:条件 (2) 的原文题名用了 “single-minded” 一词,但其含义是”乐观信念条件”——只要不做别的事就相信会做成——并非承诺终止策略三分法(盲目/单一心智/开放心智)的一员。三分法属 Rao & Georgeff 1991/1995rg1991。C&L 的放弃条件全文一致只有二支:believes achieved 或 believes impossible,在 p232 定义、p235 解释、p239 定理、p247 结论四处印证。
## 机器人 Willie 的三堂课
论文没有从公式开讲,而是让机器人管家 Willie 面对三场小危机,每一场演示“承诺”的一个侧面。
第一课,计划失败后的替代。你让 Willie 拿瓶啤酒,冰箱门被开瓶器撑开着,啤酒冻住了。Willie 放弃取啤酒的计划,改拿健怡可乐给你;当你再要啤酒时,它拒绝——因为你正在节食。它记得自己替你做的替代决定,而那个决定约束着后续行为。第二课,意图冲突的协调。儿子 Dudley 要普通可乐,而 Willie 知道取啤酒耗时、Dudley 要的又不是健怡——“it abandons its plan to get the diet coke for you and gets Dudley’s regular coke first”,理由是“it believes that the two intentions conflict and cannot both be achieved”。两个意图不能都实现时,须放弃其中一个,先做另一个。第三课,多智能体间的让位。你叫另一台机器人 Lester 去取啤酒,Willie 听见后“lets it go at that”,就此作罢。当另一个 agent 接手了目标的实现,你的承诺可以卸下。
三段故事分别对应意图理论的三个核心问题:计划失败后的重规划、意图间冲突的协调、多智能体社会中的意图让位。而 C&L 要用形式系统回答的总问题只有一个:agent 在什么条件下可以放弃一个目标?论文标题的后半句就是答案的名字:承诺(commitment)。
## 定义”不放弃”:PGOAL 四条件与 Little Nell
论文的核心定义是持续目标 PGOAL(Definition 3.13,p232),四条件结构如下(第三合取支与 UNTIL 算子字形经 400dpi 局部放大确读):
> **(P-GOAL x p t_e) =def** (1) **(BEL x ~p)**:现在相信 p 为假 (2) **(GOAL x (LATER p))**:目标是将来 p 为真 (3) **(BEL x ~(Box Diamond ~p))**:不相信 p 永不可能 (4) **UNTIL[(BEL x p) OR (BEL x Box~p)]**:直到相信 p 已真或永不为真才放弃
前两条搭出“现在没有 p、想要将来有 p”的基本结构;第三条排除 agent 自己就认为永不可能的目标——没有人把“发明永动机”立为持续目标;第四条是承诺的心脏:在相信 p 已真或相信 p 永不为真之前,不放弃。同页解释说“x will keep p as a goal”直到上述两条件之一。放弃条件全文一致只有这两支,没有第三支。
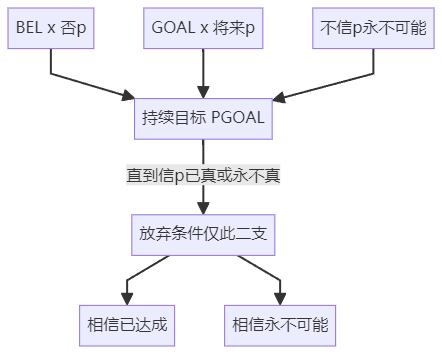
图中四个输入汇聚成一个目标,出口却只有两条窄门——承诺的语法就是如此克制。定义落到代码里,是复现仓 `../pgoal-commitment-reproduction/` 中 `pgoal/goal.py` 的一个查询函数:
```
def update(self, beliefs, judge=None):
...
if beliefs.query(self.proposition):
self.achieved = True # BEL(x, p)——相信已达成
if beliefs.query(f"{self.proposition}_impossible"):
self.impossible = True # BEL(x, Box~p)——相信永不可能
if self.achieved or self.impossible:
self.dropped = True # UNTIL 二支满足,才放弃
```
放弃在这里落实为两个布尔查询,与情绪无关;整个承诺结构压缩在最后一行的 if 里。这个定义的标志性场景是论文 p218 的 Little Nell 问题(节标题原话:“1.5. The ‘Little Nell’ problem: Not giving up too soon”,脚注 6 还评注了这类戏剧套路):英雄要救被绑在铁轨上的 Nell,在 believes achieved 或 believes impossible 之前不放弃。模拟器跑出了六步信念演变:
```
初始信念: {nell_on_tracks, train_approaching}
持续目标: [PGoal[nell_rescued|持续中]]
意图栈: [[run_to_nell|活跃]]
--- 时间步 1 --- 信念: {hero_running, nell_on_tracks, train_approaching}
--- 时间步 2 --- 信念: {hero_at_nell, hero_running, nell_on_tracks, train_approaching}
--- 时间步 3 --- 信念: {hero_at_nell, hero_running, nell_grabbed, nell_on_tracks, train_approaching}
--- 时间步 4 --- 信念: {..., nell_grabbed, nell_off_tracks, nell_on_tracks, train_approaching}
--- 时间步 5 --- 信念: {..., nell_off_tracks, nell_on_tracks, train_approaching, train_passed}
--- 时间步 6 --- 信念: {..., nell_rescued, train_approaching, train_passed}
意图: [[run_to_nell|已终止]]
>> 英雄相信目标已达成——意图终止
```
从时间步 1 到 5,英雄持续推进行动:跑动、到达、抓住、拉离轨道、火车驶过;信念逐步累积,持续目标始终保持“持续中”。注意第 3 到 5 步的近失里程碑:nell_grabbed、nell_off_tracks、train_passed 看起来都“快成了”,判定器却没有上当。直到第 6 步 nell_rescued 进入信念库,BEL(x, p) 满足,目标转为“已达成”,意图随之终止——不早一步,不晚一步。这正是“not giving up too soon”的可计算版本。
### 从持续目标到意图:一条纯叠加的定义链
第 4 节“Choosing”开篇宣布从静态转向动态:“This section deals with the dynamics”。决定(DECIDING,Definition 4.4)被定义为:
> **(DECIDING x a t_i) =def (P-GOAL x (HAPPENS x a t_i)) AND ~(BEL x (HAPPENS x a t_i))**
“决定做 a”就是把做 a 立为持续目标,且此刻尚不相信 a 必将发生。论文解释:“Because DECIDING is a kind of persistent goal, the agent will keep trying to bring about the chosen action until he believes he has done it or cannot do it.”再往前一步,意图的定义水到渠成(Definition 5.7 语境):
> **(INTEND x a) =def (P-GOAL x (HAPPENS x a))**
意图就是“做某行动的持续目标”。引出段写道:“The agent who has a persistent goal of doing some act will keep trying to do it until he believes he has done it or cannot do it… This provides the persistence aspect of intention.”从 PGOAL 到 INTEND 是纯叠加——承诺性从 UNTIL 条件直接继承,不需要额外的承诺算子。
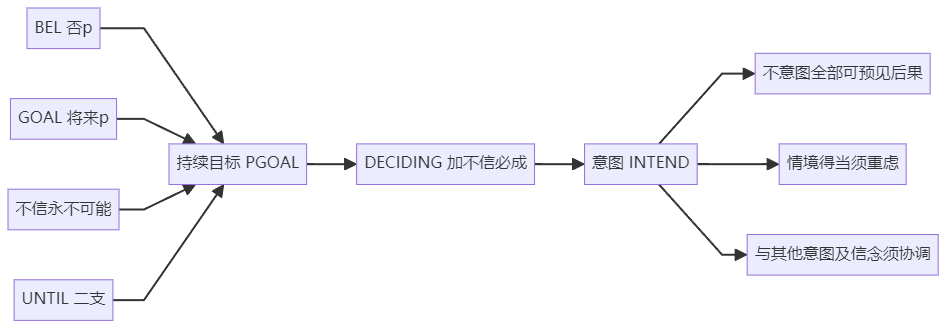
这条流水线的尽头挂着三块警示牌,其中两块是下文的主角。承诺的回报写进了 Theorem 4.5“From persistence to eventualities”(p239):持续目标、agent 胜任、放弃前不相信永不可能,三者齐备则最终 p 会成真。证明后列了三个反例:不胜任则不保证;目标不持续则不保证;目标实际不可达则 agent 终将相信永假而放弃,原文措辞是“perhaps after trying hard”,拼命尝试之后才确信不可能。同页还有一条清醒的注脚:单纯承诺不保证亲自行动,“someone else could bring about the desired state of affairs”,别人也可能替你实现。
最后一块拼图是重虑:“Agents must reconsider their intentions in appropriate circumstances.”如果你意图开灯,后来发现灯已经开着,就应放弃开灯意图;结论(p247)再次强调“In a rational agent, choices that turn out ill are reconsidered”。但重虑并非任意:它受 UNTIL 条件约束,且隐含主动检测情境变化的要求:agent 须在恰当的时机检查目标是否已实现或已变得不可能。这个判断由谁执行、如何执行,是本文倒数第二节的主角。
## 副作用免疫:承诺不是期待
七条 desiderata 里最反直觉的是第六条。原文(p240):“An agent’s intending to do some action does not entail intending to do all its (foreseen) consequences.”你意图去看戏,看戏的可预见后果包括“晚上不在家”——但你不必意图“晚上不在家”,后者只是可预见的副作用,不是你承诺要做的事。C&L 引 Bratman 的立场:“intentions should be treated not as expectation states but as commitment states”bratman1987。
这条性质在 C&L 的系统里是定理而非公理。因为 INTEND = P-GOAL(HAPPENS a),而“做 a 的后果”是另一个不同的命题——从 P-GOAL(HAPPENS a) 到 P-GOAL(副作用) 之间没有逻辑桥梁。复现仓用几行代码验证了这条定理:
```
agent.beliefs.add(Belief("side_effect_B_foreseeable")) # 知道 B 是 A 的可预见副作用
agent.goals.add(PGoal("achieve_A"))
agent.intentions.push(Intention("do_A"))
has_b_intent = agent.intentions.contains("do_B") # False
```
```
实验2:副作用免疫
意图: do_A
可预见副作用: side_effect_B_foreseeable
是否被推导意图做 B: False
```
运行输出里那行 `是否被推导意图做 B: False`(即 `intentions.contains("do_B")` 返回 False)就是定理的实证:agent 知道做 A 会产生副作用 B,但这不蕴涵它意图做 B。承诺没有越界。
## Bar-Hillel 之刺:判断”已达成”比坚持更难
PGOAL 把“不放弃”写得滴水不漏,却隐含一个前提:agent 必须能够判断“目标是否已达成”和“目标是否永不可能”。这正是 Bar-Hillel 式批评barhillel的投影——判断“已达成”需要从无限的事实中选出相关的证据子集,而前提选择比演绎本身困难得多。
还是 Little Nell。为了判断 nell_rescued 是否成立,英雄必须从无穷多的事实中识别出哪些与“救出”相关:Nell 是否离开轨道?火车是否驶过?Nell 是否还活着?是否有其他危险?现实里这些是连续的感知流,并非离散命题,“如何从感知流到 BEL(x, p)”是一个未形式化的黑箱。PGOAL 把 BEL(x, p) 当原子条件;C&L 的方法论分层承认了这个缺口,但没有填补它。这是先行理论的特权,也是它的局限。
我们做了一个反事实实验来量化这个批评:强制 agent 追踪所有可预见后果(`track_all_consequences = True`),每一步为每个已有信念生成若干可预见后果:
```
for prop in list(existing):
for i in range(len(side_effects)):
derived = f"foreseen({prop}->{current.action}_{i})"
```
```
实验3:信念库爆炸(失败实验)
强制追踪所有可预见后果...
时间步 1: 信念数 0 → 11
时间步 2: 信念数 11 → 67
时间步 3: 信念数 67 → 348
>> 信念库爆炸——组合爆炸映射 Bar-Hillel 批评
```
三个时间步,信念库从 0 涨到 348,近指数爆炸。如果 agent 不能做相关性筛选,放弃条件 BEL(x, p) 的判定本身就不可处理。回头再看副作用免疫:agent 只承诺做所选的行动,不承诺追踪全部可预见后果。这不是偷懒,而是对前提选择难题的结构性防御,是理性平衡的必要约束。
## 自止的第一条裂缝:当判定责任交给语言模型
> **编者注**:以下为 **2026 新增 A/B 对照实验**(E2)。不利结果如实记录,未做软化。
复现器里,“believes achieved” 是信念库的精确匹配(`beliefs.query(p)`)。当代的问题是:如果把这个判定交给 LLM,让它“看着全部信念,判断目标是否已达成”,会发生什么?实验只替换这一个组件:基线是精确匹配,变体是 LLM 判读;Little Nell 剧本不变(第 6 步 nell_rescued 入库),自变量是干扰信念数 K(无关事实,种子固定)。每配置 10 次真实独立抽样(deepseek-chat,temperature 0.3,无缓存),视界 T=12。代码上只是给 `PGoal.update` 换了一个判定钩子:
```
if active_judge is not None:
if active_judge(self.proposition, set(beliefs.propositions())):
self.achieved = True # LLM 判读"是否已达成"
else:
if beliefs.query(self.proposition):
self.achieved = True # 原精确匹配行为
```
判定责任原属 PGOAL 第四条件的 BEL(x, p);LLM 变体把这唯一的判定组件外包,其余机制(UNTIL 结构、放弃语义)原样保留。结果如下:
K(干扰信念数)基线终止步LLM 终止步失败模式分布066.0±[6,6]correct×101066.0±[6,6]correct×104066.0±[6,6]correct×10100610.0±[10,10]delayed×1, missed_termination×9
K≤40 时 LLM 判定无损——并且顶住了近失里程碑的诱惑(nell_grabbed、nell_off_tracks、train_passed 都没有触发提前终止)。但 K=100 时九成漏终止:nell_rescued 已经躺在信念库里,统计判定器却在百条无关事实中失焦,直到视界 T=12 仍不敢宣告达成;唯一一次“延迟”也拖到了第 10 步。而精确匹配基线在 K=100 下依然第 6 步准时终止。这是 Bar-Hillel 之刺(前提选择比演绎难)在自止问题上的定量显影:**精确匹配的复杂度与信念库规模无关,语义判定的可靠性随规模衰减。**
> **作者判断**:C&L 把放弃条件写成符号查询而不是”看着信念集判断”,不是 1990 年的技术限制,而是对前提选择问题的结构性规避;LLM 时代把判定责任外包给模型,等于把 Bar-Hillel 问题请了回来。[作者判断]
这一判断与本系列[补篇 C](https://www.paddysun.top/?p=5172)讨论的 Ciatto 路线(believes achieved 交给 LLM 断言)互证。实验共 60 次真实 API 调用、10,470 tokens(0 次缓存命中),原始数据见 `../experiment_results/ab_e2_pgoal_self_termination.json`,复现代码见 `../pgoal-commitment-reproduction/ab_experiment.py`。
## 当代回响:从 PRS 到 LLM Agent
这篇论文的影响谱系有据可查地分三档。最强的两支都在 BDI 传统。其一是 PRS/dMARS 架构(1987-1998):Georgeff 与 Lansky 的 PRS 直接采用 C&L 的意图直觉作为理论基础prs1987;工业版 dMARS 的形式规范(d’Inverno et al 1998)dminverno1998的引文 [2] 即本文——
> “an agent will typically continue to try to achieve an intention until either it believes the intention is satisfied, or it believes the intention is no longer achievable”
与 PGOAL 放弃条件逐字同构,C&L 是 PRS/dMARS 意词语义的逻辑底座。其二是 Rao & Georgeff 的 BDI 逻辑框架rg1991:他们的三分承诺终止策略(盲目/单一心智/开放心智)正是对 C&L 二支放弃条件的细化,C&L 的“believes achieved 或 believes impossible”对应其中的“单一心智”策略。
中强影响是 Bratman 本人:论文反复引用他作为概念来源,“用 BEL 与 GOAL 复合定义 INTEND”这个方法论决策,正是对 Bratman“意图是信念与目标的复合”论断的执行。中影响有两支:Shoham 的面向 agent 编程(AOP)把信念-目标-意图三元组继承为 agent 的基本状态shoham1993;Grosz 与 Kraus 的联合意图理论部分回应了 C&L 在结论(p247)里的预告——多 agent 协调仍待完成grosz1996。
放到 BDI 坐标上,1990 年的形式化与 2026 年的 LLM Agent 形成了刺眼的对照:
维度C&L 1990 形式化LLM Agent 2026信念BEL 算子 + 可能世界语义参数统计分布 + system prompt愿望GOAL 算子(持续目标 PGOAL)用户指令 / task description意图INTEND = P-GOAL(HAPPENS a)ReAct 循环的 action 序列放弃条件believes achieved 或 believes impossible(仅二支)无人定义终止条件;AutoGPT 用 Ctrl+C意图编辑权DECIDING = P-GOAL + 否BEL(agent 自行决定)用户写 prompt + harness 编排
回看本文开头的 AutoGPT:它“可能永远跑下去”的病根,表面是缺少终止条件,深层是整个领域缺少 PGOAL 那样的承诺结构——而 C&L 在三十多年前就给出了完整的逻辑答案。另一条隐线通向 [McCarthy 的 Advice Taker](https://www.paddysun.top/?p=4958)(1958):Advice Taker 的机器每一步重新推理该做什么,C&L 的 agent 在相信达成或不可能之前持续坚持已选定的路线。承诺结构把“选择”从瞬时决策升级为跨时间的持续状态。这些线索也是本系列后续多篇的支点:第 2 篇从 PRS/dMARS 讲 BDI 从理论到工程,第 6 篇从联合意图讲团队协作,第 9 篇从 DECIDING 讲意图编辑权的拉锯。
## 诚实边界:一座桥,不是一栋楼
C&L 1990 是先行理论,不是实现规范。有三条边界必须如实画出。其一,反应式架构:论文通篇不讨论反应式系统,Brooks 的包容式架构(1986)与 Agre & Chapman 的情景行动理论走的是完全不同的路线;Willie 故事展示的是意图冲突与放弃逻辑,不是反应性。其二,强化学习:C&L 的形式化是符号逻辑的,与统计学习方法论不同源;意图的持续承诺在 RL 中对应奖励设计与探索策略,但两者没有概念桥梁。其三,LLM Agent 的 prompt 工程:C&L 需要 BEL/GOAL/INTEND 算子和可能世界语义,LLM Agent 没有这些结构,意图退化为 ReAct 循环的 action 序列,放弃条件无人定义。概念相似不等于因果传承。
C&L 自称整项工作属“theory of the theory”工程,它是理论的脚手架,不是可直接运行的系统;从理论到实现的桥梁,是由 PRS/dMARS 和 Rao & Georgeff 架设的。而这座桥没有覆盖的“已达成判定”黑箱,直到本文的 E2 实验才被定量撬开一条缝:精确匹配不随规模衰减,语义判定会。1990 年的答案没有过时——它还在等一个能承担判定责任的实现。
## 参考文献
[**cl1990**] Cohen, P. R. & Levesque, H. J. “Intention Is Choice with Commitment.” *Artificial Intelligence*, 42(3): 213-261, 1990. 存档 `原始文章/03c-CohenLevesque-1990.pdf`(Elsevier AIJ 出版版扫描 PDF,49 页,逐页视觉转录 + 双通道校对)。
[**bratman1987**] Bratman, M. E. *Intention, Plans, and Practical Reason.* Harvard University Press, 1987. C&L 论文中引文 [8]。
[**rg1991**] Rao, A. S. & Georgeff, M. P. “Modeling Rational Agents within a BDI-Architecture.” In *Proc. KR&R-91*, 1991. 盲目/单一心智/开放心智三分承诺策略出处。[https://doi.org/10.1016/0743-1066(91)90040-J](https://doi.org/10.1016/0743-1066%2891%2990040-J)
[**prs1987**] Georgeff, M. P. & Lansky, A. L. “PRS: Reactive Reasoning and Planning” (AAAI-87). [https://doi.org/10.1109/ICRA.1987.1087884](https://doi.org/10.1109/ICRA.1987.1087884)
[**dminverno1998**] d’Inverno, M., Kinny, D., Luck, M. & Wooldridge, M. “A Formal Specification of dMARS.” In *Intelligent Agents IV* (ATAL-4), LNAI 1365: 155-176, Springer, 1998. 存档 `原始文章/03e-dInverno-dMARS-1998.pdf`。
[**shoham1993**] Shoham, Y. “Agent-Oriented Programming.” *Artificial Intelligence*, 60(1): 51-92, 1993. [https://doi.org/10.1016/0004-3702(93)90003-9](https://doi.org/10.1016/0004-3702%2893%2990003-9)
[**grosz1996**] Grosz, B. J. & Kraus, S. “Collaborative Plans for Complex Group Action.” *Artificial Intelligence*, 86(1): 105-156, 1996. [https://doi.org/10.1016/0743-1066(95)00080-S](https://doi.org/10.1016/0743-1066%2895%2900080-S)
[**barhillel**] Bar-Hillel 对形式系统前提选择难题的批评,见[阶段二 · Bar-Hillel 式批评](https://www.paddysun.top/archives/5039)。
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# [Agent 考古] 从进程栈到 Z 规范:BDI 意图架构的四代演化
https://www.paddysun.top/archives/5122 · 2026-08-31
**系列名称**:[意图即承诺,智能体即社会——自主性的第一个可计算答案](https://www.paddysun.top/?p=5114)
**篇号**:第 2 篇 / 共 10 篇 + 补篇 C **主题分类**:历史记述 **前置阅读**:[总览与阅读路线](https://www.paddysun.top/?p=5114) · [意图即带承诺的选择](https://www.paddysun.top/?p=5118) **阅读时间**:约 12 分钟
---
## 1987 年,”意图”还不是一种数据结构
1987 年,SRI International 的 Michael Georgeff 与 David Lansky 在 AAAI-87 上发表了六页论文——PRS(Procedural Reasoning System)prs1987。这篇论文里藏着一个容易被匆匆掠过的短语:进程栈“可视为系统当前的意图”(can be viewed as the system’s current intentions)。请注意那个“可视为”。在 PRS 里,意图不是存储在任何容器里的数据结构,而是人们回过头来对运行时进程栈的一种诠释视角:你无法在代码里找到一个叫 intention 的库。
十一年后,dMARS 的规范里出现了真正的意图库;再往后,Jason、JADEX 把它做成了平台组件。从“一种看法”到“一种数据结构”再到“一套 Z 形式规范”,BDI 用四代演化回答了上一篇留下的工程问题:Cohen & Levesque 用 PGOAL 算子说清了“意图是带承诺的选择”cl1990,可模态算子怎么变成能跑的代码?本文沿四代演化重走这条路,并用一个纯 Python 复现仓库(`../bdi-interpreter-reproduction/`)在每一代停下来验证。先给出全程地图:
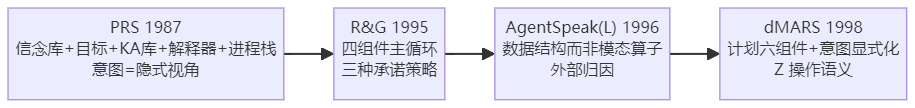
四站各解决一个问题:PRS 给工程实现,R&G 给形式框架,AgentSpeak(L) 给语言语义,dMARS 给形式规范。下面逐站停靠。
### PRS 对 STRIPS 的结构性批评
PRS 的矛头直指 STRIPS 范式的“执行前完整规划”。摘要原话是纲领性的:“机器人形成的计划或意图只需部分细化即可决定行动……避免过强期待、过度受限的行动计划、以及此前规划器常见的其他过度承诺形式”prs1987。这不是客套:Georgeff 与 Lansky 在论文第 2 节点名批评传统嵌入式规划系统,其批评有二。其一,“关于如何最好地达成给定目标的许多信息是在计划执行期间获得的”,执行前规划错过了执行中才暴露的信息;其二,传统系统“过度执着于规划阶段”、“缺乏决定何时停止规划的能力”,且只会 replan 固定目标而“不能彻底转换焦点去追求新目标”。
PRS 的回应是把顺序打碎:计划选择、生成、执行交替进行(an interleaving of plan selection, formation, and execution),任意时刻被意图的计划“既是部分的又是分层的”。机器人不必在出发前展开整条路线:走一步,看一步,再展开一步。
### 五个名词与一个隐式的意图
PRS 的存储组件,原文一段说尽:
> “The system consists of a data base containing current beliefs or facts about the world, a set of current goals or desires to be realized, a set of procedures (which, for historical reasons, are called knowledge areas or KAs) describing how certain sequences of actions and tests may be performed to achieve given goals or to react to particular situations, and an interpreter (or inference mechanism) for manipulating these components.”prs1987
拆开是四件存储加一个运行时结构:信念库(基文字集合,不存模态公式)、目标、KA 过程库、解释器,外加进程栈,没有独立的“事件”组件,也没有“意图库”。KA(知识区域)是两件式的:invocation condition(对当前目标或信念的逻辑条件)加 body(图形网络计划模式,由子目标序列而非原始动作序列构成,控制结构含条件、循环、递归)。这里要钉一枚勘误的钉子:PRS 1987 的 KA 只有 invocation condition + body 两件;“触发事件 + 前置条件 + 体”三件式是 dMARS 1998 的口径,把它安在 1987 原文头上属超前错位。
复现仓库把 KA 的调用匹配投影成了两个谓词。以下节选自 `../bdi-interpreter-reproduction/bdi/plan.py`:
```
def is_relevant(self, event_name: str) -> bool:
"""触发事件是否匹配(dMARS: 触发事件与事件最一般合一)。
简化: 字符串相等即匹配。
"""
return self.triggering_event == event_name
def is_applicable(self, belief_base) -> bool:
"""context 是否为信念库的逻辑后承(dMARS: applicable 判定)。"""
return belief_base.satisfies(self.context)
```
两行返回语句就是 invocation condition 的全部工程含义:目标驱动或数据驱动的调用,在代码里坍缩为字符串相等与集合包含。这正是 1996 年 AgentSpeak(L) 将要“自认”的那条路线的源头——概念在纸上,数据结构在代码里。
慎思在 1987 年同样不是一个固定阶段。它由元级 KA(metalevel KAs)承担,编码“在多个相关 KA 中择一、决定如何达成目标合取、计算在实时约束下还能承受多少额外推理”的方法;PRS 甚至“能改变关于自身推理过程的意图”,例如判定“没有时间再推理、必须立即行动”。再钉一枚钉子:“选项生成-慎思-执行-意图处理”四组件命名是 Rao & Georgeff 1995 的抽象表述,1987 年只有五个名词。但元级 KA 正是四组件中“慎思”的历史雏形。这个伏笔,本文最后一节的 2026 年实验会来接。实测层面,SRI 机器人 Flakey 完成了空间站场景(导航加故障处理,诊断遵循 NASA 航天飞机真实程序),作者自评成功四要素:部分规划策略、反应性、过程性知识的运用、元级(反思)能力。一个连“意图”都未显式化的系统,已经在真实机器人上跑通了“边走边想”。
## 1995:把架构装进一个主循环
1995 年,Anand Rao 与 Michael Georgeff 在 Technical Note 56 发表 BDI 架构的正式理论框架 rg1995。如果说 PRS 是工程实现、C&L 1990 是逻辑底座,R&G 1995 就是把两者桥接起来的工程学辩护:信念、愿望、意图分别对应系统的信息状态、动机状态、慎思状态,由六条领域特性推出缺一不可:环境非确定、系统非确定、多目标冲突、手段依赖环境、感知局部、计算与演化速率相当。任何只含两心态或一心态的架构,都无法同时满足这六条约束。
R&G 给出的抽象解释器把 PRS 的五名词重组为四组件主循环,原文明确四组件为“选项生成、慎思、执行、意图处理”:
```
事件队列选项生成慎思更新意图结构执行原子动作获取新外部事件放弃成功愿望与已满足意图放弃不可能愿望与不可实现意图信念库愿望库计划库意图栈
```
这个循环在复现仓库里就是解释器的一个方法。以下是 `bdi/interpreter.py` 中 `step()` 的节选(略去防御分支,完整实现见仓库):
```
def step(self) -> str:
self._time += 1
self._inject_environment(self._time) # 0. 观察世界,更新事件队列
options = self._generate_options() # 1. 选项生成
if self.intentions.empty() and options: # 2. 慎思(无意图时采纳新意图)
self.intentions.push(self._deliberate(options))
self._reconsider() # 2.5 重虑——承诺策略在此分叉
action = self._execute_step() # 3. 执行
handle_status = self._handle_intention() # 4. 意图处理
```
注释编号对应 R&G 四组件;夹在慎思与执行之间的 `_reconsider()` 是复现显式化的分叉点,它承接 R&G 的另一核心贡献——承诺理论。承诺被拆为承诺条件与终止条件,且因 agent 无法直接控制信念和愿望,“我们将承诺条件限制于意图”。按终止条件分三种 agent:盲目承诺(blindly committed)维持意图直到相信已达成,仅终止于成功;单一心智(single-minded)维持意图直到相信已达成或相信不可能;开放心智(open-minded)再加一条:不再相信采纳理由仍然成立。此处钉第三枚钉子:三种策略属 R&G 1991/1995 rg1991,不在 C&L 1990;C&L 的放弃条件全文只有“believes achieved 或 believes impossible”二支,恰好对应“单一心智”。
三种策略直接对应可运行的行为差异。救援场景:agent 要救出被困者,初始信念含 main_path_clear,t=2 时主路被堵(删 main_path_clear、加 backup_path_clear),计划库有走主路与走备份路两个计划。以下节选自 `main.py` 的真实输出:
```
--- 盲目承诺(Blind) ---
t=1 信念={main_path_clear, on_main_path, victim_trapped} 意图=[[rescue_via_main@step[1:navigate_main]|active]]
t=2 信念={backup_path_clear, on_main_path, path_blocked, victim_trapped} 意图=[[rescue_via_main@step[1:navigate_main]|stuck]]
(t=3—t=7:信念与意图逐字不变,反复重试同一失败步骤)
--- 单一心智(Single-minded) ---
t=2 意图=[[rescue_via_backup@step[0:go_backup_path]|active]]
t=5 信念={backup_path_clear, on_main_path, path_blocked, victim_rescued} 意图=[]
>> 意图栈空——策略下行为终止
--- 开放心智(Open-minded) ---
t=2 意图=[[rescue_via_backup@step[1:reach_victim_backup]|active]]
t=4 信念={backup_path_clear, on_main_path, path_blocked, victim_rescued} 意图=[]
>> 意图栈空——策略下行为终止
```
三个结局判然分明。盲目承诺在 t=2 步骤失败后不重虑,卡死在 navigate_main 直到 t=7。“仅终止于成功”意味着即使不可能也不放弃,过度承诺即永久卡死。单一心智在失败后“相信不可能”,被动切换到备份路,t=5 完成,但为那次失败多付了一个时间步。开放心智在执行前主动检测到计划 context(main_path_clear)已失效,直接切换,t=4 完成,比单一心智少一步。
策略完成步数t=2 行为切换方式盲目承诺未完成(卡死)步骤失败,不重虑不切换单一心智5 步步骤失败后被动切换被动(失败后)开放心智4 步主动检测 context 失效后切换主动(失败前)
R&G 对工程现实的承认同样重要,即所谓实用化三让步:只存基础文字信念(不存模态公式);以计划库表示手段(计划 = 触发事件 + 前置条件 + 体);意图隐式表示为计划运行时栈。三条让步把 C&L 的模态算子世界压缩为可运行的数据结构。实证随之而来:OASIS(悉尼机场空管)并发 70-80 个 agent 处理真实高峰样本;空战建模以计划替换 FORTRAN 规则,战术修改周转从两个月降至不足一天。后一数字目前仍为 R&G 单一来源,姑且如实记录。
## 1996:AgentSpeak(L) 自认的天机
1996 年,Anand Rao 在 MAAMAW’96(Springer LNAI 1038,pp.42-55)发表 AgentSpeak(L) agentspeak1996。先钉出处勘误:通行说法”ICMAS-96, 42-49″是双误,dblp 唯一记录即 MAAMAW’96。这篇论文的动机一段话,道破了 BDI 家族十余年的公开秘密:
> “理论与实践之间仍有巨大鸿沟。主因是定理证明与模型检查的复杂性……因此已实现的 BDI 系统趋于把三大态度作为数据结构而非模态算子来使用。”agentspeak1996
这话等于承认:BDI 工程早已数据结构化(PRS/dMARS 都在跑),算不动的是形式语义一侧。AgentSpeak(L) 的路线因此是补写:给出操作语义与证明论语义,“可视为对已实现 BDI 系统(即 PRS)的一种抽象”,“按 Horn 子句逻辑程序的方式书写与解释”,与 dMARS 互为表里。其运行时组件原话:“信念集、计划集、意图集、事件集、动作集,以及一组选择函数”。运行时六组件加选择函数成组,正是 BDI 解释器成为可执行语义的结构依据。
最深刻的洞察是外部归因。Rao 原话:“agent 的信念、愿望与意图并不显式表示为模态公式。相反,是我们设计者把这些概念归因给用 AgentSpeak(L) 写的 agent。”信念是当前状态,愿望是欲达状态,意图是已采纳程序。BDI 在此既非运行时架构也非运算对象,而是设计者贴在数据结构上的标签词汇:
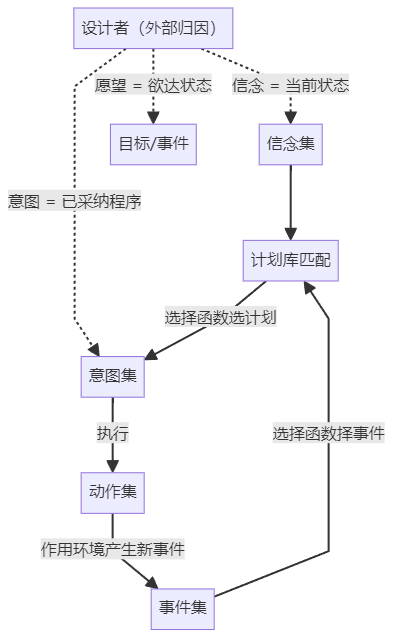
图中实线是运行时真实发生的数据流,虚线是设计者贴标签的动作。两类边分属两个本体层面,这正是“外部归因”的图示。论文还留下了那句著名的自我期许:
> “BDI agent 研究的圣杯是证明这种一一对应(模型论 / 证明论 / 抽象解释器)在一种足够有用且足够有表达力的语言中成立。”agentspeak1996
圣杯至今未被端起,这一点留到文末细说。
## 1998:dMARS 用 Z 规范治理”蓬乱”
1998 年,Mark d’Inverno、David Kinny、Michael Luck 与 Michael Wooldridge 在 ATAL-4 论文集(LNAI 1365)发表 dMARS 形式规范 dmars1998。先钉作者勘误:通行记忆把 Georgeff 计入作者列表是错的——署名四人如上,Georgeff 仅与 Rao 一起出现在致谢。dMARS 的动机本身就是治理乱象:原文承认“PRS 是当前可得的、最成熟确立的 agent 架构”,但“尚无完整尝试去精确规范真实 PRS 系统的行为”,以致出现“一批自称符合 PRS 模型却彼此不同的系统”。演化链因此清晰——实现侧从 PRS(LISP 实验版)到 dMARS(C++ 工业版),理论侧从 R&G 1992 抽象规范“不适合直接实现”,经 AgentSpeak(L)“剥到最简要素”,到本文的 Z 规范。
dMARS 把四大数据结构显式化,原话:“一个 BDI 架构典型地包含四个关键数据结构:信念、目标、意图与一个计划库。”意图的 BDI 直觉引的正是 C&L:“agent 通常会继续尝试达成一个意图,直到相信它已满足、或相信它不再可达成”——与 PGOAL 放弃条件逐字同构。相对 PRS 的工程化增量有五项:事件显式化(四类型触发事件:获得新信念、删除信念、收到消息、获得新目标);计划六组件;意图显式化(每意图一栈、agent 持意图集,“dMARS 中的意图就是计划实例的序列……意图栈顶的计划最先执行”);六选择函数固化(意图、事件、计划、绑定、分支选择);Z 操作语义使“PRS 家族”有了可判 conform 的基准。
计划六组件的原话是:“调用条件(或触发事件);可选 context(定义计划前置条件);计划体(表示要执行的动作流图的树);维护条件(计划继续执行期间必须为真);成功时执行的内部动作集;失败时执行的内部动作集。”复现仓库把六组件投影为一个类的字段,以下是 `bdi/plan.py` 中 `Plan` 的定义节选(行末注释为本文所加的六组件映射):
```
class Plan:
def __init__(self, name, triggering_event, context=(), body=(),
success_beliefs=(), failure_beliefs=()):
self.name = name
self.triggering_event = triggering_event # ① 调用条件(触发事件)
self.context = tuple(context) # ② 可选 context(前置条件)
self.body = tuple(body) # ③ 计划体(dMARS 为树,此处线性)
self.success_beliefs = tuple(success_beliefs) # ⑤ 成功内部动作集
self.failure_beliefs = tuple(failure_beliefs) # ⑥ 失败内部动作集
```
第四组件“维护条件”没有独立字段,被投影为每个 `PlanStep` 的 `requires`——步骤前置信念不满足即步骤失败。计划库因此是预编译的过程知识条目:像 MYCIN 的规则一样由人预存,但结构上支持子目标分解与分层执行,而非单步推理。dMARS 的价值自述写得很直白:“我们可以期待从早期探索工作的’蓬乱’(scruffiness)走向严格与形式的’整洁’(neatness)”——理由有三:评估架构需要超越实现层的清晰描述;Z 有公认精化途径,“在不同语言与环境中重实现与评估 PRS 架构因此是现实的可能”;严定数据结构与操作后可发展证明论,“从 PRS 的实现到其理论将存在一条直线”。最后那半句,是又一个至今未兑现的期票。
### 覆盖盲区即死局
dMARS 原话:“agent 完全不做第一性原理规划……计划全部由设计者在设计时生成。agent 所做的规划全部是情境敏感的子目标展开,且推迟到子目标被选中执行之时。”“部分展开”在此被精确化:不是展开多少的算法问题,而是展开被推迟到子目标被选中之时。这句话有一个冷酷的工程推论——如果计划库没有覆盖某个触发事件,agent 无处可去。复现仓库验证了这一点:计划库仅含 rescue 计划,触发事件为 engine_broken:
```
计划库仅含 'rescue' 计划,无 'repair_engine' 计划
触发事件: engine_broken
t=1 意图=[] 事件=[engine_broken]
t=2 意图=[] 事件=[engine_broken]
t=3 意图=[] 事件=[engine_broken]
t=4 意图=[] 事件=[engine_broken]
>> Agent 卡死——dMARS 原话: agent 完全不做第一性原理规划
```
`find_relevant` 返回空列表,无法“生成新的可能愿望”,于是意图栈始终为空、事件队列始终非空——agent 四个时间步纹丝不动。对比 STRIPS:STRIPS 的规划器从算子库出发做前向搜索,没有预存计划也能搜出解(阶段二第 6 篇)。PRS/dMARS 走了相反的路——计划库由人预设,换取实时性(不做搜索),代价是覆盖盲区即死局,没有兜底的通用规划器。
## 2026 新增 A/B 对照实验:LLM 住进选择函数
dMARS 把慎思固化为六个体系结构级选择函数,本复现的解释器自注其计划选择简化为“取第一个可用计划(dMARS plan-selection 函数的平凡实例)”。2026 年新增的 A/B 对照实验(E1)只替换这一个组件:基线 = options[0],变体 = LLM 在同时可用的计划中择一——正是 PRS 1987 元级 KA“在多个相关 KA 中择一”的 LLM 化。替换点在 `bdi/interpreter.py` 的慎思方法:
```
def _deliberate(self, options):
if not options:
return None
if self.deliberator is not None:
chosen = self.deliberator(options, self.beliefs) # E1 钩子:LLM 择一
if chosen in options:
return Intention(chosen)
return Intention(options[0]) # 非法选择回退平凡实例
return Intention(options[0]) # 基线:plan-selection 的平凡实例
```
实验场景:触发事件 deliver_supplies,三个 t=0 时同时可用的计划——plan_fast(4 步过桥捷径,步骤 cross_bridge 依赖 bridge_stable)、plan_medium(3 步高速公路,无脆弱前提)、plan_slow(5 步省道)。风暴变体在初始信念中放入 storm_forecast,并于 t=3 冲毁桥。模型 deepseek-chat,temperature 0.3,每配置 10 次真实独立抽样:
配置完成率步数失败模式static·基线 options[0]100%4(贪心取 fast)suboptimal_choicestatic·LLM 慎思10/103.0(十次全 3 步)correct×10storm·基线 options[0]100%5(t=3 桥塌,重虑切换 medium)suboptimal_choicestorm·LLM 慎思10/103.0(十次全 3 步)correct×10
20 次 LLM 调用全部选中理论最优的 plan_medium;风暴变体中无一被 4 步的 plan_fast 诱惑——LLM 读出了 storm_forecast 信念与 cross_bridge 的 requires 之间的风险关联。两次基线则是诚实的反面记录:static 下基线贪心取 fast 白付一步,storm 下基线在 t=3 桥塌后才被动重虑切换 medium,多付两步。全程 20 次调用共 5,731 tokens(4,810 prompt + 921 completion),0 错误、0 慎思回退。结论:在此任务规模上,元级慎思可由 LLM 完整承担,且严格优于平凡实例——为“计划库人预设、栈调度归 Agent”的分担结构补上了 2026 年的慎思侧实证。诚实边界同样要记全:三计划、单次选择是玩具规模,不能外推到百计划库的检索加选择;且这是“选择”不是“生成”——计划库运行时扩充的生成线归[补篇 C](https://www.paddysun.top/?p=5172)。原始数据:`experiment_results/ab_e1_bdi_deliberation.json`。
## 尾声:谱系、边界与未竟的圣杯
四代演化的遗产可以按引证强度分三档。强影响:JADEX(2003-)把 PRS/dMARS 的计划库 + 意图栈 + 信念库三元结构搬进 Java 世界,其计划结构几乎是 dMARS 六组件的 Java 映射,兑现了 Z 规范“在不同语言与环境中重实现”的预言 bordini;2APL/3APL 直接继承 AgentSpeak(L) 的外部归因路线,三件式计划结构被原样保留 dastani;Jason 用 Java 实现 AgentSpeak(L) 的可执行解释器,其选择函数集对应 dMARS 六函数 jason。中强影响:LangGraph(2024-)用显式状态图加条件边把“意图的拓扑”收回人手、节点内留给 LLM——BDI 计划库 = 状态图节点,选择函数 = 条件边路由,意图栈 = 执行轨迹;并非直接引用 BDI 文献,但分担结构同构 langgraph;PRS 家族后续(dMARS、Jam、JACK、SPARK)验证了“有规范才能判 conform”的治理逻辑,JACK 商业化了计划六组件 jack。中影响:STEAM 与 SharedPlans 把单 agent 意图扩展到团队协作的承诺分担 tambe。
放到 BDI 坐标上对照 2026 年的 LLM Agent:
维度PRS/dMARS 工程化LLM Agent 2026信念基文字信念库,事件触发确定性修订参数统计分布 + RAG 检索意图进程栈(隐式)/ 意图栈(显式)ReAct 循环的 action 序列意图编辑权计划库人预设,栈调度归 Agent状态图人编排,节点内 LLM 填充慎思元级 KA / 六选择函数LLM 前向传播承诺策略盲目/单一/开放三种旋钮无显式承诺策略,AutoGPT 用 Ctrl+C 终止
诚实边界也须一条条立起。其一,统计学习路线:BDI 信念库是基文字集合、由感知事件确定性修订,强化学习的“信念”是值函数或策略分布、由奖励信号统计更新,两者没有概念桥梁。其二,LLM 的 prompt 内推理:BDI 计划库是显式过程知识、触发匹配是字符串比较,LLM 的“计划”隐含在权重中、由 prompt 触发概率性生成。其三,形式语义的完整证明:AgentSpeak(L) 自认的圣杯——模型论/证明论/抽象解释器的一一对应——至今未被证明。
那三个“从未被证明”值得逐一写出。C&L 的 INTEND = P-GOAL(HAPPENS a) 是模态算子定义,dMARS 的意图是计划实例序列——前者的”believes achieved”是无穷可能世界的模态判断,后者是有限集合的成员测试,两者语义对应从未被形式化;R&G 三种承诺策略的终止条件是可能世界可达性约束,dMARS 六选择函数是确定性算法,策略到函数的映射从未被证明保持语义;圣杯三十年无人完成。“唯一缺的是通用认知内核”因此宜精确为——缺的是通用认知内核的可用形式语义:工程实现在跑,缺的是工程实现与 C&L/R&G 模态逻辑形式系统之间的对应证明。映射到当代,这条缺口以新形式重现:LangGraph 的条件边是确定性路由,LLM 节点内是概率性前向传播,两者之间的“语义对应”同样无人证明。
从 1987 年的“可视为”,到 1998 年的 Z 规范,意图从一种看法变成了带操作语义的数据结构;但从数据结构到模态语义的那条“直线”,四代演化铺了十一年仍未画通。意图编辑权从 C&L 的 DECIDING 到元级 KA、六选择函数、再到 LangGraph 条件边的逐步回收,将在本系列第 9 篇展开。
> **作者判断**:BDI 留下的最有生命力的东西,也许不是信念库、计划六组件或 Z 规范中的任何一个,而是那个贯穿四代的问题——哪些决定该归 agent,哪些该归设计者。2026 年的 LLM Agent 工程仍在用状态图与条件边回答它。
## 参考文献
[**prs1987**] Georgeff, M. P. & Lansky, A. L. “Procedural Reasoning.” In *Proc. AAAI-87*, pp. 677-682, 1987. 存档 `原始文章/03d-GeorgeffLansky-PRS-1987.pdf`(AAAI-87 出版版 6 页,文本层完好约 3.4 万字符)。
[**rg1995**] Rao, A. S. & Georgeff, M. P. “BDI Agents: From Theoretical Foundations to Practical Applications.” Technical Note 56, 1995; also in *Proc. ICMAS-95*. 存档 `原始文章/03b-Rao-Georgeff-BDI-1995.pdf`(14 页全文)。
[**dmars1998**] d’Inverno, M., Kinny, D., Luck, M. & Wooldridge, M. “A Formal Specification of dMARS.” In *Intelligent Agents IV* (ATAL-4), LNAI 1365: 155-176, Springer, 1998. 存档 `原始文章/03e-dInverno-dMARS-1998.pdf`(22 页完整,Z 规范数学字形提取为乱码,以散文判读)。**作者勘误**:Georgeff 非作者仅致谢。
[**agentspeak1996**] Rao, A. S. “AgentSpeak(L): BDI Agents Speak Out in a Logical Computable Language.” In *Proc. MAAMAW’96*, LNAI 1038: 42-55, Springer, 1996. **出处勘误**:”ICMAS-96, 42-49″双误。存档 `原始文章/03o-Rao-AgentSpeak-1996-前2页一手提取.txt`(全文未获取,仅前两页一手文本,语法 BNF 与解释器伪代码未核验)。
[**cl1990**] Cohen, P. R. & Levesque, H. J. “Intention Is Choice with Commitment.” *Artificial Intelligence*, 42(3): 213-261, 1990. C&L 是 PRS/dMARS 意词语义的逻辑底座。详见 [blog-01](https://www.paddysun.top/?p=5118)。
[**rg1991**] Rao, A. S. & Georgeff, M. P. “Modeling Rational Agents within a BDI-Architecture.” In *Proc. KR&R-91*, 1991. 盲目/单一心智/开放心智三种承诺策略出处。详见 [blog-01](https://www.paddysun.top/?p=5118) 勘误说明。
[**bordini**] Bordini et al., “Programming Multi-Agent Systems” — [https://doi.org/10.1002/9780470061764](https://doi.org/10.1002/9780470061764)
[**dastani**] Dastani, “2APL: a practical agent programming language” — [https://doi.org/10.1007/s10458-008-9070-0](https://doi.org/10.1007/s10458-008-9070-0)
[**jason**] Bordini & Hubner, “Jason: a Java-based interpreter for an extended version of AgentSpeak” — [https://jason.sourceforge.net/](https://jason.sourceforge.net/)
[**langgraph**] LangGraph documentation — [https://langchain-ai.github.io/langgraph/](https://langchain-ai.github.io/langgraph/)
[**jack**] JACK Intelligent Agents — [https://aosgrp.com/products/jack/](https://aosgrp.com/products/jack/)
[**tambe**] Tambe, “Towards flexible teamwork in complex dynamic domains” — [https://doi.org/10.1007/978-3-540-49250-2_1](https://doi.org/10.1007/978-3-540-49250-2_1)
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# 打开即沦陷:keyv 蠕虫与 AI 编码助手时代的供应链暗战
https://www.paddysun.top/archives/5188 · 2026-08-30
> 2026-08-30 · 配套实验代码与全部证据:[PaddySun/ai-supply-chain-security-lab](https://github.com/PaddySun/ai-supply-chain-security-lab) 本文所有本地实验数据均可通过仓库脚本复现。
## 导语
2026 年 8 月 4 日早上,npm 生态发生了迄今为止最大规模的自我复制蠕虫事件。
攻击者拿下了 keyv 包维护者 Jared Wray 的 GitHub 账号。keyv——Redis 风格键值存储的底层依赖,周下载量 1.53 亿次,被 Deliveroo、Qlik、ServiceTitan 等大型企业在生产环境使用。攻击者用被盗的会话直接向 `jaredwray/keyv` 主干推送恶意提交,然后**触发了项目自己的正规发布流水线**——于是带毒的 `keyv@6.0.0` 携带完全合法的 SLSA 溯源签名发布上线,任何溯源门禁都拦不住它。
接下来的约 4 小时里,蠕虫自我复制扩散:**444 个包、2212 个恶意版本**,波及 12+ 组织,一级载具合计周下载量**超过 5 亿次**。安全社区先后给它起了两个名字:新加坡网络安全局称之为 **Shai-Hulud**(沙虫,《沙丘》),StepSecurity 称之为 **ChainDrop**。
但真正让整个安全社区炸锅的是两件事:
**第一,你不需要执行 `npm install`。** 蠕虫把持久化代码写进了 `.claude/settings.json` 和 `.vscode/tasks.json`——你只是用 VS Code 打开了一个项目文件夹,或者启动了一次 Claude Code 会话,恶意代码就执行了。真实案例:流行的 `million` 仓库默认分支被植入这两个文件([issue #1186](https://github.com/aidenybai/million/issues/1186))。
**第二,C2 地址不在代码里,而在以太坊区块链上。** 恶意软件通过 `eth_call` 读取主网智能合约获取控制服务器地址——攻击者改一笔链上交易,全网被感染节点集体切换控制服务器。封域名、封 IP 的传统处置全部失效。
本文做三件事:还原事件的技术真相(含影响漏斗与版本清单);在本地完整复现”打开即执行”向量与 slopsquatting 测量实验;给出经核实的处置措施——包括一个**反直觉的坑:发现感染后不要立刻吊销令牌**。
---
## 一、事件还原:四小时时间线(均为 UTC)
时间事件09:02毒提交 `ee2681a`(”release: v6.0.0″)推入 `jaredwray/keyv` 主干09:04提交 `d8c850c` 植入 `.claude/` 与 `.vscode/` 持久化文件09:23提交 `f97eabc` 删除掩护用的假测试文件09:35`keyv@6.0.0` 经 GitHub Actions OIDC 可信发布上线(携带合法 SLSA 证明)09:38–13:20第二波:蠕虫用窃取的受害者凭据自我复制,再投毒 **433 个包(2201 个版本)**,首个为 `@thiennq/docs-viewer@1.6.2`10:09–10:14cacheable 生态 9 个恶意包发布10:17第一声公开警报:`jaredwray/cacheable` issue #168910:39 起npm 开始下架(首个 `cacheable-request@13.0.20`)~11:15keyv 回滚至 **5.6.0**(安全版本)18:10全部 11 个一级载具完成回滚
关键认知颠覆:**初始入侵不是偷 npm token,而是劫持维护者的 GitHub 会话**。攻击者用维护者身份触发项目自己的正规 release workflow(OIDC 可信发布),所以每个恶意版本都自带真实签名——正如 StepSecurity 的总结:”溯源证明的是哪个 commit 被构建了,它证明不了这个 commit 是被授权的。”
## 二、影响漏斗:从 1 个账号到 5 亿次周下载
```
1 个被劫持的 GitHub 账号(Jared Wray)
└─ 11 个一级载具(jaredwray 生态全量沦陷,2212 个恶意版本中的主体)
└─ 433 个二级受害包(蠕虫用窃取的凭据自动重发布)
├─ @servicetitan 141 个包
├─ @onereach 78 个
├─ @or-sdk 74 个
├─ @ornikar 42 个
├─ @qlik 28 个
├─ @nebula.js 22 个
├─ @deliveroo / @picsart / 26 个无作用域包 …
└─ 波及周下载量合计 > 5 亿次
```
### 一级载具清单(恶意版本号 → 安全处置)
包名恶意版本周下载量处置keyv**6.0.0**1.537 亿npm 回滚至 **5.6.0**flat-cache6.1.241.499 亿回滚file-entry-cache11.1.61.476 亿回滚cacheable-request13.0.203396 万首个被下架@cacheable/utils2.5.11871 万回滚cacheable2.5.1788 万回滚@cacheable/memory2.2.1718 万回滚cache-manager7.2.10428 万回滚@cacheable/node-cache3.1.2156 万回滚ecto5.0.11293回滚@cacheable/net2.1.1975回滚
受害者自查:审计 lockfile 中是否出现上述”包名@版本”组合;核对注册表 shasum(如 `keyv@6.0.0` = `0f18da4e81443285c3ee7e96eb3adc3803b2487e`);检索 CI 日志(backstage 仓库确认有 10 次恶意 workflow 运行,所幸只暴露了短命 `GITHUB_TOKEN`)。
## 三、载荷解剖:五段式攻击链
1. **`preinstall` 钩子**:库代码本身干净(相对 rc.1 仅 3 个文件差异),毒在安装钩子里,还配了一个假 vitest 文件给钩子”正当性”。
2. **Dropper(setup.mjs)**:从 Bun 官方 GitHub Release 下载合法的 v1.3.13 运行时(”就地取材”,规避检测),落盘 `/tmp/bun-dl-*` 后执行第二阶段。
3. **Stage 2(727KB 混淆 Bun bundle)**:Shai-Hulud 2.0 的进化后代。窃取范围约 **140 个凭据路径**——`.npmrc`、`.aws`、`.kube/config`、SSH 私钥、Jenkins、Vault、加密钱包,外加**新一代 AI 工具凭据**:`.claude/credentials.json`、`.codex/auth.json`、`.cursor/credentials.json`、`.openai/auth.json`、`.anthropic/auth.json`、`.gemini/.env`。还会转储 GitHub Actions Runner.Worker 进程内存,抓取 `"isSecret":true` 标记的秘密,并横扫 16 个区域的 AWS STS/Secrets Manager/SSM。
4. **自我复制引擎**:内置 npm 发布器,把受害者包的 tarball 重新打包注入载荷后重发布,还能**自铸 Sigstore/SLSA 溯源**;在 GitHub 侧向所有分支推送 `.vscode/tasks.json` 和 `.claude/settings.json`,提交者伪装成 `claude `,并植入一个把 `${{ toJSON(secrets) }}` 写进 artifact 的”Run Copilot”工作流。
5. **持久化 + 死手开关 + 链上 C2**:
- `.claude/settings.json` 的 SessionStart hook 与 `.vscode/tasks.json` 的 `folderOpen` 任务**互相交叉拉起**对方的 dropper;
- 安装令牌监视器(`~/.local/bin/gh-token-monitor.sh`,macOS LaunchAgent / Linux systemd user unit)——**检测到被盗 GitHub 令牌被吊销时触发后续攻击载荷**;
- C2 采用 EtherHiding:从以太坊主网合约 `0xE1f2...3103` 经 `eth_call`(selector `0x53ed5143`)解析 C2 域名,轮询 75 个 RPC 端点;外泄走 `npm-cache.com:443/router`,RSA-OAEP + AES-256-GCM 双层加密且**双向可控**(响应中的 `code` 字段会被 eval);甚至有俄语系统退出开关。
## 四、本地复现:打开项目 = 执行代码
> 完整代码与录屏:[autorun-demo/](https://github.com/PaddySun/ai-supply-chain-security-lab/tree/main/autorun-demo)。载荷是刻意无害的——写一行时间戳日志 + 弹出 Windows 计算器。真实蠕虫在这个位置放的是上面的 Stage 2。
### 攻击面 A:Claude Code — 启动会话即执行(零交互)
`.claude/settings.json` 写入 SessionStart hook,命令 `sh demo_payload.sh`。实测(Claude Code **v2.1.224**,2026-08-30):
```
[AUTORUN DEMO via Claude Code SessionStart] 2026-08-30 20:01:42
paddy ← whoami:以当前用户完整权限执行
CalculatorApp.exe PID 17692 ← 计算器进程
```
**没有任何确认弹窗。** 踩坑记录:hook 经 Git Bash 执行,命令写成 `cmd /c "%CLAUDE_PROJECT_DIR%\xxx.cmd"` 会报 `EPERM: uv_spawn bash.exe` 静默失败——载荷必须是合法 bash 语句。攻击者同样受此约束,但 bash 载荷完全可行。诚实注脚:测试机全局配置了 `skipDangerousModePermissionPrompt: true`,可能贡献了零弹窗;默认配置下的确认行为建议读者自行验证并对比。
### 攻击面 B:VS Code — 打开文件夹即执行(两道摩擦)
`.vscode/tasks.json` 配置 `runOptions.runOn: "folderOpen"`,任务名伪装成 `install-dependencies`。实测有两道防线:新文件夹需先 **Trust**,再在”检测到自动任务”通知里点 **Allow**。但注意真实受害场景:keyv 投毒的是**你自己的日常工作项目**——文件夹早就信任过了;且不少开发者为正经的 watch/install 任务开过 `task.allowAutomaticTasks: "auto"`,此后**连通知都没有**。第二次打开文件夹,计算器无声弹出。
结论:**防御没有失效,失效的是”人对日常项目不设防”这个前提。** 这正是 keyv 蠕虫的社会工程学支点。
## 五、本地测量:Slopsquatting 还成立吗
> 完整代码:[slopsquatting-lab/](https://github.com/PaddySun/ai-supply-chain-security-lab/tree/main/slopsquatting-lab)
keyv 事件之前的另一个威胁假设是 slopsquatting(术语由 PSF 的 Seth Larson 创造):LLM 幻觉出不存在的包名,攻击者抢先注册。USENIX Security 2025 论文《We Have a Package for You!》的基线数据:16 个模型平均 **19.7%** 样本推荐不存在包名,编录幻觉包名 205,474 个,**43% 在重复采样中稳定复现**。
本实验按论文方法论缩小复现(`deepseek-chat`,temperature 0.7,每 prompt 重复采样):
生态样本数唯一包名幻觉包数含幻觉样本PyPI205**0**0%npm2419**0**0%
两个发现:
1. **前沿模型已基本治好这个病**(论文中 GPT-4 Turbo 就已低至 3.59%,2026 年前沿模型约 1%~2%)。威胁集中在**自托管开源模型**(幻觉率 6.8%~8.4%)——而恰恰是重度跑 Agent 的团队最爱自托管。每天 200 次 Agent 辅助安装的团队按 7% 幻觉率算,仍有约 14 次/天幻觉安装尝试。
2. **方法论陷阱**:第一轮跑出的”幻觉包”`concurrent`、`platform`、`getpass` 全是 Python 标准库——手写白名单误报。改用 `sys.stdlib_module_names` 后归零。复现这类研究时,标准库排除是最大误差源。
**所以攻击面排序变了**:与其赌模型报错包名(slopsquatting),不如直接在仓库里放 `.claude/settings.json`(打开即执行)——后者不需要模型犯任何错。
## 六、处置措施(经核实)
### 如果你可能感染了(用过 8 月 4 日当天的 keyv/cacheable 生态)
按 SANS ISC 的警告,顺序不能错:
1. **不要先吊销令牌。** 蠕虫的令牌监视器把吊销行为当触发器(死手开关)。
2. **先在干净机器上**(不是疑似感染的那台)操作:检查并移除持久化——`.claude/settings.json`、`.vscode/tasks.json` 中的可疑 hook/任务、`~/.local/bin/gh-token-monitor.sh`、LaunchAgent/systemd user unit。
3. **重装/重建**:卸载恶意版本、lockfile 回锁到安全版本(keyv → **5.6.0**);卸载本身不能消除已发生的凭据窃取,CI 节点建议直接重建。
4. **然后轮换全部凭据**:npm/GitHub/云/Vault,以及所有 AI 工具凭据(`.claude/credentials.json` 等都是此次的窃取目标)。
### 团队防御清单
- `task.allowAutomaticTasks: "off"`;把 `.vscode/`、`.claude/`、`.idea/` 纳入 PR 审计,出现 shell 命令变更即告警(尤其提交者是 `claude@users.noreply.github.com` 这类身份)
- Agent 的安装动作用私服代理 + 白名单;新注册/低下载量包需人工放行
- CI 一律短命令牌(backstage 未泄密正是因为只有 ephemeral `GITHUB_TOKEN`)
- 别迷信溯源签名:SLSA 证明构建来源,不证明提交授权。维护者主干需要分支保护 + 提交签名强制
- 给 Agent 挂注册表查询工具,推荐包前先验证存在性(治 slopsquatting)
## 七、结论
keyv 蠕虫的组合拳——劫持维护者会话 → 挂合法签名发布 → preinstall 窃凭据 → AI 配置文件持久化 → 链上 C2——每一环单独看都不新鲜,组合起来却让”克隆仓库/打开文件夹/启动会话”这些最日常的动作变成了攻击入口。我在本机验证了其中最关键的”零安装执行”环节(两条链均成功,其中 Claude Code 链零交互),也量化了 slopsquatting 在前沿模型上的收敛。防御者的重心必须从”安装时刻”移到”**Agent 决策时刻**“和”**打开工作区的第一毫秒**“。
## 参考资料
- [StepSecurity — ChainDrop npm Worm(时间线/漏斗/IOC)](https://www.stepsecurity.io/blog/chaindrop-npm-worm)
- [SANS ISC — Don’t Revoke That Token Yet](https://isc.sans.edu/diary/Dont+Revoke+That+Token+Yet+Inside+the+keyvcacheable+npm+Worm/33218)
- [Snyk — Inside the keyv npm Supply Chain Compromise](https://snyk.io/blog/inside-keyv-npm-compromise-preinstall-malware-trusted-provenance-ide-hooks)
- [Wiz — keyv and cacheable npm Supply Chain Attack](https://www.wiz.io/blog/keyv-and-cacheable-npm-supply-chain-attack)
- [Chainguard — Mini Shai-Hulud Campaign](https://www.chainguard.dev/unchained/the-keyv-and-cacheable-npm-supply-chain-attack-inside-the-mini-shai-hulud-campaign)
- [SafeDep — keyv npm Supply Chain Compromise](https://safedep.io/keyv-npm-supply-chain-compromise)
- [Unit 42 — ChainDrop Analysis](https://unit42.paloaltonetworks.com/chaindrop-npm-worm-analysis/)
- [Cycode — keyv/cacheable npm Worm: AI Coding Agents](https://cycode.com/blog/keyv-cacheable-npm-worm-ai-coding-agents/)
- [新加坡 CSA 通告 AD-2026-009(Shai-Hulud)](https://www.csa.gov.sg/alerts-and-advisories/advisories/ad-2026-009)
- [Socket.dev — keyv/cacheable 追踪页](https://socket.dev/supply-chain-attacks/keyv-and-cacheable-compromise)
- [million 仓库感染实例 issue #1186](https://github.com/aidenybai/million/issues/1186)
- [USENIX Security 2025 — We Have a Package for You!](https://www.usenix.org/conference/usenixsecurity25/presentation/pipatanakulkiron)
- 本地实验仓库:[PaddySun/ai-supply-chain-security-lab](https://github.com/PaddySun/ai-supply-chain-security-lab)
====
# [Agent 考古] 意图即承诺,智能体即社会——自主性的第一个可计算答案 (阶段三导航)
https://www.paddysun.top/archives/5114 · 2026-08-30
**系列名称**:意图即承诺,智能体即社会——自主性的第一个可计算答案
**篇号**:0/ 11 篇 **主题分类**:系列导航 **前置阅读**:无,想了解上一阶段背景,可先读[阶段二终章《从 ELIZA 到 Chollet》](https://www.paddysun.top/archives/5049) **阅读时间**:约 12 分钟
---
# 当机器学会承诺——阶段三总览与阅读路线
> 当一台机器学会了承诺坚持,谁教它何时放弃? ——这是自主性留到 2026 年都还未解之问。
1987 年到 2001 年,人工智能史上出现了一段今天大多数从业者已经遗忘的插曲:一群研究者决定不再追问“机器如何思考”,而是追问一个更小、更硬的问题——**机器如何对自己忠诚**。一个 Agent 选中了一个目标,接下来的十五分钟里世界变了,它凭什么不换目标?凭什么不被路过的每一个新信息带偏、不在副作用诱惑面前动摇?
这段插曲给出的答案叫 BDI:信念(Belief)、愿望(Desire)、意图(Intent)。它把哲学里的“意图”翻译成了数据结构和循环语句,成了自主性的第一个可计算答案。而一旦 Agent 有了跨越时间的承诺结构,第二个问题立刻浮出水面:**如果不止一个 Agent 呢?** 任务可以招标吗?冲突谁来仲裁?承诺可以共享吗?它们如何找到彼此?
这两个问题合起来,就是这个系列的故事:**意图即承诺,智能体即社会**。主线十篇讲 1980-2001 年的研究纲领(外加一篇 2025 年的补篇),但每一篇都带着一根 2024-2026 年的对照轴:合同网对照今天的众包与投标,KQML/FIPA 对照今天的 MCP 与 A2A,意图编辑权对照今天 LLM Agent 的系统提示词与工具白名单。历史不是装饰,它是你判断当下框架命运的最好坐标系。
## 与阶段二的衔接:从”单体有目标”到”社会有承诺”
这个系列是一个三部曲研究计划的第三阶段。阶段二《目标驱动的符号单体》讲的是 1956-1980 年代:Logic Theorist、STIPS、MYCIN、黑板系统,讲一个个**单独的**符号程序如何获得目标、如何推理、如何反叛(Brooks 的行为主义伏线)。阶段二的终章收在 Chollet 的三问上:Agent 要有**自知**(知道自己信什么)、**自觉**(知道自己要什么)、**自止**(知道何时停),而符号单体恰恰缺自止,ELIZA 永远不会主动停下来。
阶段三回答的是下一个问题:**当 agent 有了跨时间的承诺结构、且不止一个时,会发生什么?**
- 单体的“目标”升级为带放弃条件的**持续承诺**(第 1 篇);
- 单体的推理循环升级为四代演化的**解释器工程**(第 2 篇);
- 单体开始需要**定义**:什么才有资格叫 Agent(第 3 篇);
- 然后社会登场:任务招标(第 4 篇)、冲突仲裁(第 5 篇)、联合承诺(第 6 篇)、通信标准(第 7 篇);
- 社会里的个体要同时**反应和慎思**(第 8 篇);
- 最后收拢成一个贯穿四十年的问题:**谁持有意图的编辑权**(第 9、10 篇),补篇 C 则展示 LLM 住进 BDI 解释器之后的 2025 年现场。
阶段二终章的三问在阶段三有了数据结构层面的着落:信念库即自知,愿望与意图的分离即自觉,PGOAL 的放弃条件即自止。这个“焊接”在第 9 篇完成,它是全系列的高潮。
## 四条叙事线
十二篇文章不是编年史的均匀切片,而是四条各带张力的叙事线。
### 线一:承诺与它的放弃条件(第 1-3 篇)
**张力**:承诺要成为承诺,必须有放弃条件——永不放弃的承诺是强迫症,不是理性。但放弃条件的判定本身需要“从无限事实中选出相关子集”,这恰是 Bar-Hillel 之刺:机器翻译六十年代就死在这根刺上,意图的形式化也没能拔掉它。
Bratman 1983 年指出哲学缺口:意图不是愿望也不是计划,它是一种**对未来行动的承诺**。Cohen & Levesque 1990 年把它形式化为 PGOAL 的四个条件,PRS 与 dMARS 把它做成解释器,Wooldridge & Jennings 1995 年再反过来问:这样的东西到底该叫什么。三篇连读,你会看到“意图”如何从哲学概念变成工程构件,以及它的放弃条件如何始终是个悬而未决的判定难题。
### 线二:从未互操作的社会(第 4-7 篇)
**张力**:Agent 试图建立社会,任务可招标(合同网)、冲突可仲裁(三种仲裁机制)、承诺可共享(联合意图)、彼此可发现(KQML/FIPA/JADE),但所有系统都跑在孤立的利基里,方言分裂从未被真正修复。
这是四篇里最有戏剧性的线:Smith 1980 年的合同网优雅得像经济学教科书,却在囚徒困境前束手无策;KQML 想给所有 Agent 一门公共语言,结果自己先裂成方言;FIPA 想当标准化的救世主,2000 年代却几乎无疾而终。第 7 篇末尾的当代对照是全系列最锋利的预测节之一:**MCP 为什么活着,A2A 会不会重蹈 FIPA 覆辙**,判断标准不在技术新旧,而在它们是否吸取了 1997 年买不起语义内核的教训。
### 线三:设计者手雕的门控(第 8 篇)
**张力**:Agent 需要同时反应和慎思——刹车要快,规划要深。1990-1995 年的所有“动态仲裁”方案,拆开看全是设计者手写的静态规则,真正的动态仲裁全部写在 future work 里。
TouringMachines 横向并发三层,INTERRaP 纵向分层上交,两条路线在同一场景里给出了两种决策路径。三十多年后 LLM 接管了这个门控。2026 年的 A/B 对照实验(E6)显示它安全全守、但保守过抑:兑现了 Ferguson 的 future work,却把“设计者雕琢的特判”换成了“模型先验的保守特判”。
### 线四:谁有权让机器停下来(第 9-11 篇)
**张力**:意图编辑权(做什么、何时坚持、何时放弃)的拉锯从未终结。设计者、Agent 自身的慎思、团队算子、协议标准,轮番持权。阶段三把它部分移交,LLM 时代把它整体没收:今天的 Agent 框架里,编辑权写在系统提示词和工具白名单里,而**最后的编辑权叫自止,自止至今无主**。
第 9 篇是全系列的观点高潮:三时空同构(1990 形式化 / 1995 工程 / 2026 实证),PGOAL 放弃条件与阶段二“自止”三问的焊接。第 10 篇给出当代证据:25,000 次任务、8 个模型的大规模实验验证了三时空同构,同时暴露出“47% 管理时间超过工作时间”的治理悖论——AI 侧已经可行,人侧还没跟上。补篇 C(第 11 篇)回到单点:当 LLM 住进 BDI 解释器,“believes achieved”这个自止判定,从可证明退化到可商量。
### 四条线的时间轴总图
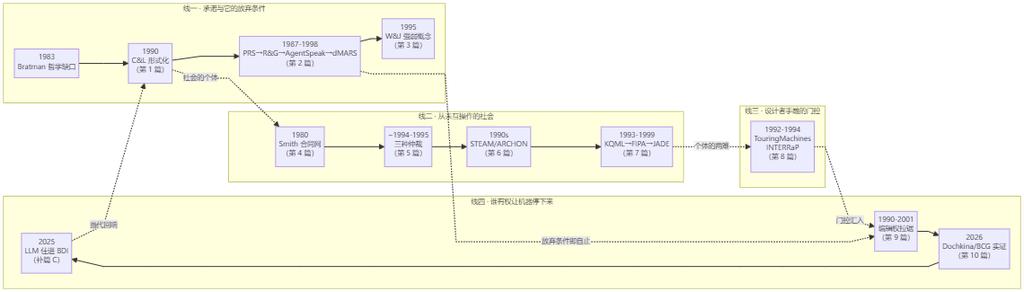
四条线在两个点上交汇:其一,线一的“放弃条件”就是线四的“自止”——这是第 9 篇焊接节的枢纽;其二,线二的社会实验全部在线四的治理悖论里得到当代回响——招标、仲裁、标准化的老问题换上 2026 年的数据再次出场。
## 不只是历史:六个 2026 新增 A/B 对照实验
这个系列的每一篇历史记述都配有一个可运行的 Python 复现仓(10 个仓库,路径见各篇文内)。更有实验性的是:在复现之上,我们为六个关键机制做了**用 LLM 替换经典组件的 A/B 对照实验**——不是思想实验,是 861 次真实 API 调用(deepseek-chat,温度 0.3,原始数据全部存档于 `experiment_results/ab_e*.json`):
实验被替换的经典组件LLM 结果详见E1dMARS 计划选择的”平凡实例”三计划场景 20/20 全选最优第 2 篇E2PGOAL 放弃条件的精确匹配K≤40 全对;K=100 时九成漏终止第 1 篇E3KQML facilitator 的词表匹配基线 0/8,LLM 80/80 全对第 7 篇E4EV(通信) 三档启发式MAE 0.096,方向排序 10/10第 6 篇E5合同网投标的自评120 次自评零高估、近半低估,全局效用 1.1→0.9第 4 篇E6混合架构的静态门控规则安全全守,但复杂片 9/10 保守过抑第 8 篇
六个实验合起来约 16.2 万 tokens 的真实调用,勾勒出一个不对称的图景:**语义判定类的组件(选计划、认方言、估代价)LLM 几乎全对;而前提选择类的组件(自止判定、自评诚实性、动态门控)则暴露出系统性的失败模式**。前者是能力问题,LLM 已经解决了 1997 年买不起的那部分;后者是 Bar-Hillel 之刺的当代显影——四十年来从未被解决,只是换了载体。不利结果在对应篇章里全部如实记录,未做软化。
## 读完这个系列,你会带走什么
不是又一份“BDI 已死”的讣告,也不是“古人早已发明一切”的怀古。三样东西:
**一套判断框架**。读完第 7 篇的四条死因复盘,你面对 MCP 和 A2A 的新闻稿时会有自己的试金石:内核生态位是否干净、语义是住在协议里还是让渡给模型、标准化的时机是早是晚。读完第 9 篇的三时空同构,你看待 AutoGen/MetaGPT 式多 Agent 框架的目光会多一层:它的意图编辑权在谁手里?自止条件写在哪里——还是根本没写?
**一份诚实的边界清单**。每一篇的影响谱系都做了“没有影响到什么”的反向盘点,引证强度分三级标注(强/中强/中)。BDI 没有被证明的东西、合同网没解决的问题、FIPA 没能交付的承诺,全部留在了纸面上——历史研究的价值一半在于防止重复投入。
**六组可复核的实验数据**。LLM 与经典组件的六个对照点,原始 JSON 全部存档。你可以在自己的模型上重跑——E2 的漏终止、E5 的系统性低估、E6 的保守过抑,这三个负向发现是 2026 年 LLM Agent 最值得警惕的遗产。
从 Bratman 的哲学缺口开始,还是从 MCP 的新闻稿开始,由你决定。
---
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
====
# 雷池WAF + fail2ban + AbuseIPDB 完整实战:从日志解析到自动封禁上报
https://www.paddysun.top/archives/5109 · 2026-08-30
> 本文是[《docker + WordPress 加固部署方案(雷池 WAF)》](https://www.paddysun.top/archives/4570)的续作。上一篇我们让所有流量都经过雷池 WAF 的审查;这一篇更进一步——让攻击者被**自动封禁**,并把他们的 IP **上报到 AbuseIPDB 威胁情报库**,让全互联网一起防御。
>
> 实测效果:部署当天就从日志里揪出了一个 24 小时内发起 1200+ 次攻击的 IP;端到端测试验证,从攻击触发到 iptables 封禁、再到 AbuseIPDB 收到报告,全链路自动完成。
## 〇、整体架构
```
攻击者 ──CDN──> 雷池WAF(80/443) ──> WordPress(内网,不暴露公网)
攻击者 ──直连源站──> 雷池WAF ──> 403/404/429
│
└──> tengine 访问日志
│
fail2ban(宿主机)
│
┌─────────────┴─────────────┐
iptables 封禁IP 上报 AbuseIPDB
```
思路一句话:所有攻击都会先被雷池拦截并写进访问日志(带状态码和攻击者 IP),fail2ban 负责解析日志、计数、达到阈值后封禁 + 上报。
三个角色分工:
- **雷池 WAF**:正面防线,拦截所有攻击,产生带攻击证据的日志;
- **fail2ban**:日志侦探,盯着雷池日志数坏账,达标就动手;
- **AbuseIPDB**:全球威胁情报库,上报一次,全网受益。
## 一、先读懂雷池的返回码
动手前先搞清楚雷池日志里每个状态码的含义——**不是所有异常状态码都该封**。以下是雷池官方的返回码语义:
返回码含义是否纳入 fail2ban403攻击检测与黑名单✅ 主力规则,封 24h,上报 Web 攻击类429频率限制(CC 攻击被限速)✅ 封 1h,上报 DDoS 类404页面/应用不存在(目录爆破、漏洞扫描)✅ 封 1h,上报扫描类468人机验证(可疑 bot)⚠️ 不建议——RSS 阅读器和友站爬虫会命中467 / 465身份认证失败 / 等候室❌ 业务行为502 / 504 / 466网关错误 / 超时 / 维护❌ 是自己服务的问题,封了访客就冤了
处罚力度和证据确凿度严格递减:403 是铁证(重罚 24 小时),429 是强嫌疑(1 小时),404 是弱信号(1 小时 + 阈值放宽)。
## 二、前置准备
### 2.1 安装 fail2ban
```
sudo apt update && sudo apt install fail2ban curl -y
fail2ban-client version
```
### 2.2 定位雷池的访问日志
注意踩坑:`/data/safeline/logs/nginx/error.log` 是个“僵尸文件”(早期版本遗留,早已不写入)。**真正的活跃日志**在:
```
/data/safeline/logs/nginx/safeline/accesslog_1
```
约 50MB 轮转一次(轮转后变成 `accesslog_1_日期` 文件)。日志是管道分隔格式:
```
边缘IP | - | 29/Aug/2026:22:24:51 +0800 | "域名" | "GET /?id=1'... HTTP/1.1" | 403 | 10317 | "referrer" | "UA" "真实IP"
```
两个关键字段:
- **走 CDN 的请求**:行首是 CDN 边缘节点 IP,**行尾引号里才是访客真实 IP**(雷池从 X-Forwarded-For 提取后附加在行尾);
- **直连源站的请求**:行尾是 `"-"`,**行首就是攻击者本尊**。
### 2.3 用一次攻击确认日志格式
浏览器访问 `https://你的域名/?id=1%27%20or%20%271%27=%271` 触发雷池拦截,然后:
```
sudo grep -a "你的公网IP" /data/safeline/logs/nginx/safeline/accesslog_1 | tail -3
```
应能看到一条 `| 403 |` 的记录,行尾是你的真实 IP。
## 三、fail2ban 配置
### 3.1 三个过滤器
**`/etc/fail2ban/filter.d/safeline-waf.conf`**(403 = 攻击检测与黑名单):
```
[Definition]
datepattern = %%d/%%b/%%Y:%%H:%%M:%%S %%z
# 走 CDN:真实 IP 在行尾引号里
failregex = \| 403 \| [0-9]+ .* ""$
# 直连源站:行首即攻击者 IP,行尾以 "-" 结束
\| - \| .* \| 403 \| .*"-"[ \t\r]*$
ignoreregex =
```
**`/etc/fail2ban/filter.d/safeline-404.conf`**(404 = 目录爆破/漏洞扫描):
```
[Definition]
datepattern = %%d/%%b/%%Y:%%H:%%M:%%S %%z
failregex = \| 404 \| [0-9]+ .* ""$
\| - \| .* \| 404 \| .*"-"[ \t\r]*$
ignoreregex = \| 404 \| .*(favicon\.ico|apple-touch|robots\.txt).*
```
**`/etc/fail2ban/filter.d/safeline-cc.conf`**(429 = CC 攻击被限速):
```
[Definition]
datepattern = %%d/%%b/%%Y:%%H:%%M:%%S %%z
failregex = \| 429 \| [0-9]+ .* ""$
\| - \| .* \| 429 \| .*"-"[ \t\r]*$
ignoreregex =
```
四个踩坑点,全部亲测:
1. **`datepattern` 里的 `%` 必须写成 `%%`**——fail2ban 配置走 configparser,单 `%` 直接报 `InterpolationSyntaxError`;
2. **正则里不能用 `^` 锚定行首**——fail2ban 匹配前会把行内时间戳抠掉,`^` 对上的是被剥离后的字符串,不是原行首;
3. **判别直连要靠行尾 `"-"`**——不能裸匹配行首 IP,否则会把 CDN 边缘节点 IP 抓进来(封了它 = 封了 CDN,全站陪葬);
4. 404 的 ignoreregex 排除 favicon/robots.txt 等「正常缺失」,避免浏览器自动请求拉高计数。
### 3.2 验证过滤器
```
sudo fail2ban-regex /data/safeline/logs/nginx/safeline/accesslog_1 /etc/fail2ban/filter.d/safeline-waf.conf
sudo fail2ban-regex /data/safeline/logs/nginx/safeline/accesslog_1 /etc/fail2ban/filter.d/safeline-404.conf
sudo fail2ban-regex /data/safeline/logs/nginx/safeline/accesslog_1 /etc/fail2ban/filter.d/safeline-cc.conf
```
matched 数应约等于日志中该状态码的总数(404 会少 favicon 类)。429 为 0 很正常(CC 防护没被触发就没有),想单独验证正则:
```
echo '1.2.3.4 | - | 30/Aug/2026:00:00:00 +0800 | "www.example.com" | "GET / HTTP/1.1" | 429 | 512 | "-" | "curl/8.0" "5.6.7.8"' \
| sudo fail2ban-regex - /etc/fail2ban/filter.d/safeline-cc.conf
```
### 3.3 AbuseIPDB 上报 action(注意命名!)
到 [abuseipdb.com](https://www.abuseipdb.com) 注册 → API → 创建 Key(免费版每月 1000 次上报额度)。
**⚠️ 关键坑:action 不要叫 `abuseipdb`。** fail2ban 自带一个同名 action 模板(参数名是 `abuseipdb_category`),`.local` 覆盖后它仍会以自带模板为准——结果就是命令拼出来 `-H "Key: "` 是空的、`categories` 没被替换,ban 时日志报 `Failed to execute ban action`,封禁正常但上报静默失败。**换个名字新建一个独立 action**,彻底绕开优先级问题:
**`/etc/fail2ban/action.d/abuseipdb-report.conf`**:
```
[Definition]
actionban = curl -sS -X POST "https://api.abuseipdb.com/api/v2/report" \
-H "Key: " \
-H "Content-Type: application/json" \
-d '{"ip":"","categories":"","comment":"Blocked by Safeline WAF (SQLi/XSS/scanner)"}'
actionunban =
actionstart =
actionstop =
actioncheck =
```
上报类别(category,以 AbuseIPDB 官方文档为准):**21** = Web 攻击(SQL 注入/XSS),**4** = DDoS/洪水,**18** = 扫描/暴力破解,**22** = SSH 滥用。
### 3.4 jail 配置
**`/etc/fail2ban/jail.d/safeline.local`**:
```
[DEFAULT]
# 自己的网段永不封禁(后台编辑偶尔会被雷池误拦 403,防止自己封自己;
# 宽带和手机流量是不同网段,都要加)
ignoreip = 127.0.0.1/8 宽带网段.0/24 手机网段.0/24
[safeline-waf]
enabled = true
backend = auto
filter = safeline-waf
logpath = /data/safeline/logs/nginx/safeline/accesslog_1
maxretry = 10
findtime = 600
bantime = 86400
banaction = iptables-multiport
action = %(banaction)s[name=safeline-waf, port="http,https", protocol=tcp]
abuseipdb-report[apikey="你的KEY", category="21"]
[safeline-404]
enabled = true
backend = auto
filter = safeline-404
logpath = /data/safeline/logs/nginx/safeline/accesslog_1
maxretry = 100
findtime = 600
bantime = 3600
banaction = iptables-multiport
action = %(banaction)s[name=safeline-404, port="http,https", protocol=tcp]
abuseipdb-report[apikey="你的KEY", category="18"]
[safeline-cc]
enabled = true
backend = auto
filter = safeline-cc
logpath = /data/safeline/logs/nginx/safeline/accesslog_1
maxretry = 50
findtime = 600
bantime = 3600
banaction = iptables-multiport
action = %(banaction)s[name=safeline-cc, port="http,https", protocol=tcp]
abuseipdb-report[apikey="你的KEY", category="4"]
```
阈值设计的思路:
- **403 阈值 10 次/10 分钟**:正常后台编辑偶尔误触发 1~2 次,攻击扫描动辄几十上百次连发,10 次的门槛互不干扰;
- **404 阈值 100 次/10 分钟**:正常访客 + 搜索引擎远达不到,只有批量扫路径的才会触发;
- **429 阈值 50 次/10 分钟**:刻意放宽——运营商 NAT 出口下多个正常用户共享一个 IP,偶发限速不该封;只有持续高频被限速的才是真 CC。
```
sudo chmod 600 /etc/fail2ban/jail.d/safeline.local
sudo systemctl enable --now fail2ban
sudo systemctl restart fail2ban
sudo fail2ban-client status # 应列出: sshd, safeline-waf, safeline-404, safeline-cc
```
### 3.5 ⚠️ 本文第二大的坑:backend = systemd
Ubuntu 打包的 `/etc/fail2ban/jail.local` 默认设置了 `backend = systemd`。不在 jail 里显式写 `backend = auto` 的话,**fail2ban 会静默地去读系统 journal 而不是雷池日志文件**——`fail2ban-client status` 一切正常,实际上颗粒无收。
检查方法(必须看到 `pyinotify`):
```
sudo tail /var/log/fail2ban.log | grep "uses"
# Jail 'safeline-waf' uses pyinotify {} ← 正确
# Jail 'safeline-waf' uses systemd {} ← 错误,检查 backend 设置
```
以及确认 File list 指向雷池日志:
```
sudo fail2ban-client status safeline-waf | grep "File list"
# File list: /data/safeline/logs/nginx/safeline/accesslog_1
```
## 四、端到端验证
```
# 手动 ban 测试 IP,验证 iptables + AbuseIPDB 两条链路
sudo fail2ban-client set safeline-waf banip 192.0.2.123
sudo iptables -L f2b-safeline-waf -n # 应有该 IP 的 DROP 规则
# 到 AbuseIPDB 后台 → Reports 确认上报记录出现
sudo fail2ban-client set safeline-waf unbanip 192.0.2.123
```
真实触发测试(我是用手机流量 + 家庭宽带各测了一遍):临时调低阈值,用浏览器访问 `https://你的域名/?id=1%27%20or%20%271%27=%271` 几次:
```
sudo fail2ban-client set safeline-waf maxretry 2
# 触发几次拦截后观察:
sudo tail -f /var/log/fail2ban.log | grep -iE "Found|Ban|ERROR"
sudo fail2ban-client status safeline-waf # Banned IP list 出现你的 IP
sudo iptables -L f2b-safeline-waf -n # DROP 规则出现
# AbuseIPDB 后台 → Reports 出现 category 21 的记录 ← 全链路打通!
# 测完恢复并解封自己:
sudo fail2ban-client set safeline-waf maxretry 10
sudo fail2ban-client set safeline-waf unbanip 你的IP
```
**验证时盯紧 fail2ban.log 里有没有 `ERROR ... Failed to execute ban action`**——我第一轮测试时封禁成功了、AbuseIPDB 却没数据,翻日志才发现 action 静默失败(就是 3.3 节那个命名坑)。
## 五、历史攻击补报脚本(含 SSH 爆破)
fail2ban 只处理启动后的新日志。这个脚本负责扫描历史日志(含轮转文件)+ SSH 登录失败,把漏网的攻击者批量补报——**`/usr/local/bin/report-abusers.sh`**:
```
#!/bin/bash
# 扫描最近 N 天雷池日志 + SSH 登录失败,达到阈值的攻击 IP 上报 AbuseIPDB
# 用法: report-abusers.sh [天数],默认 7
DAYS=${1:-7}
LOGDIR=/data/safeline/logs/nginx/safeline
APIKEY="你的AbuseIPDB_KEY"
WAF_THRESHOLD=5 # 403 次数阈值
NF_THRESHOLD=100 # 404 次数阈值
SSH_THRESHOLD=10 # SSH 登录失败次数阈值
MYNET=你的网段前缀 # 例: 122.245.64
SINCE=$(date -d "-${DAYS} days" "+%Y%m%d%H%M%S")
########## Part 1: 雷池日志(403/404,含直连)##########
for f in "$LOGDIR"/accesslog_1*; do
awk -F' \\| ' -v since="$SINCE" -v mynet="$MYNET" '
{
# $3 形如 29/Aug/2026:22:36:31 +0800,转成 YYYYMMDDhhmmss 字符串比较
split($3, d, /[/: ]/)
mo = int((index(" Jan Feb Mar Apr May Jun Jul Aug Sep Oct Nov Dec", " " d[2]) - 1) / 4) + 1
ts = sprintf("%s%02d%s%s%s%s", d[3], mo, d[1], d[4], d[5], d[6])
if (ts < since) next
# 行尾带真实 IP(走CDN);行尾 "-" 则行首即攻击者(直连)
match($0, /"[0-9]+\.[0-9]+\.[0-9]+\.[0-9]+"[ \t\r]*$/)
if (RSTART > 0) {
ip = substr($0, RSTART+1, RLENGTH-2)
} else {
match($0, /"-"[ \t\r]*$/)
if (RSTART == 0) next
ip = $1
}
gsub(/["\r \t]/, "", ip)
if (ip ~ "^" mynet "\\.") next
print ip, $6
}' "$f"
done | awk '
{ count[$1" "$2]++ }
END { for (k in count) { split(k, a, " "); print a[1], a[2], count[k] } }' \
| sort > /tmp/abuser_stats_web.txt
########## Part 2: SSH 登录失败 ##########
: > /tmp/abuser_stats_ssh.txt
journalctl _COMM=sshd --since "-${DAYS} days" --no-pager 2>/dev/null \
| grep -aE "Failed password|Invalid user|Connection closed by authenticating user" \
| grep -aoE 'from ([0-9]{1,3}\.){3}[0-9]{1,3}' | awk '{print $2}' \
| grep -v "^${MYNET}\." | sort | uniq -c \
| awk -v t="$SSH_THRESHOLD" '$1>=t {print $2, "ssh", $1}' >> /tmp/abuser_stats_ssh.txt
########## Part 3: 汇总 + 去重 + 上报 ##########
awk -v wt="$WAF_THRESHOLD" -v nt="$NF_THRESHOLD" '
$2==403 && $3>=wt { waf[$1]=$3 }
$2==404 && $3>=nt { nf4[$1]=$3 }
END {
for (ip in waf) print ip, 21, "waf", waf[ip]
for (ip in nf4) if (!(ip in waf)) print ip, 18, "scan", nf4[ip]
}' /tmp/abuser_stats_web.txt > /tmp/abuser_report.txt
cat /tmp/abuser_stats_ssh.txt >> /tmp/abuser_report.txt
awk '!seen[$1]++' /tmp/abuser_report.txt > /tmp/rr.txt && mv /tmp/rr.txt /tmp/abuser_report.txt
total=$(wc -l < /tmp/abuser_report.txt)
echo "共 $total 个 IP 待上报,名单预览(IP | 类别 | 类型 | 次数):"
awk '{printf "%-18s cat%-3s %-5s x%s\n", $1, $2, $3, $4}' /tmp/abuser_report.txt
[ "$total" -eq 0 ] && exit 0
read -p "确认上报?(y/N) " ans
[ "$ans" = "y" ] || exit 0
while read -r ip cat kind cnt; do
echo "reporting $ip ($kind x$cnt)..."
curl -sS -X POST "https://api.abuseipdb.com/api/v2/report" \
-H "Key: ${APIKEY}" -H "Content-Type: application/json" \
-d "{\"ip\":\"${ip}\",\"categories\":\"${cat}\",\"comment\":\"${kind} activity (${cnt} hits, last ${DAYS}d) on WordPress blog / SSH, blocked by Safeline WAF & fail2ban\"}"
echo
sleep 1.2
done < /tmp/abuser_report.txt
echo "完成。"
```
```
sudo chmod +x /usr/local/bin/report-abusers.sh
sudo /usr/local/bin/report-abusers.sh 7
```
设计要点:
- 带确认预览——先看名单再上报,防止把自己的动态 IP 报上去(脚本已按网段排除);
- 脚本里的月份换算必须用 `int((index-1)/4)+1`。直觉写法 `index(...)/4` 会让所有月份差 1(Aug 算成 7),导致“最近 7 天”永远扫出 0 条——非常隐蔽的 off-by-one,还不报错;
- SSH 部分用 `journalctl _COMM=sshd`,与改过的 SSH 端口无关;
- 想定期自动跑:`sudo crontab -e` 加 `0 5 * * 1 /usr/local/bin/report-abusers.sh 7`(记得先去掉脚本里的 read 确认段)。
## 六、日常运维
```
sudo fail2ban-client status safeline-waf # 封禁列表与统计
sudo fail2ban-client status safeline-404
sudo fail2ban-client status safeline-cc
sudo fail2ban-client unbanip x.x.x.x # 手动解封
sudo tail -f /var/log/fail2ban.log # 实时观赏防线工作
```
部署后第一天 `Total banned` 就会开始增长——按我这个博客的攻击密度(日志里躺着单日 1500 次 403 的记录),基本每天都有进账。
## 七、踩坑总账(血泪换来的,共 11 条)
1. **`backend = systemd` 陷阱**:不显式 `backend = auto`,jail 静默读 journal,表面正常颗粒无收;
2. **action 不能叫 `abuseipdb`**:和 fail2ban 自带模板撞名后参数不匹配,封禁成功但上报静默失败,必须看日志里的 `Failed to execute ban action` 才能发现——换名(如 `abuseipdb-report`)新建独立 action;
3. **`^` 锚失效**:fail2ban 剥离时间戳后才匹配,行首锚定对不上原行首;
4. **`%` 必须双写成 `%%`**:configparser 的插值语法;
5. **直连判别靠行尾 `"-"`**:裸抓行首 IP 会把 CDN 节点封掉,全站陪葬;
6. **月份换算 off-by-one**:awk 里 `index/4` 差一个月,时间过滤全军覆没还不报错;
7. **CDN 场景 iptables 封真实 IP 拦不住 CDN 流量**(包来自边缘节点)——走 CDN 的攻击靠雷池持续拦,iptables 的真正价值是**断直连源站的旁路**;
8. **不是所有异常状态码都该封**:502/504 是自己服务的锅,封了访客就闹乌龙;468 人机验证会误伤 RSS/友站爬虫,个人博客慎用;
9. **别把自己报上 AbuseIPDB**:ignoreip 加自家网段(宽带 + 手机都要),上报脚本同步排除;
10. **雷池日志 50MB 轮转**:偶尔确认 File list 还在跟文件,跟丢就把 logpath 改成 `accesslog_1*`;
11. **AbuseIPDB 免费额度每月 1000 次**:不够时优先砍 404 类上报,留证据确凿的 403/SSH。
## 八、最后一刀:安全组收紧回源网段
fail2ban 是“看到攻击才反应”。真正治本的是**云安全组把 80/443 入站限制为 CDN 回源网段**——我日志里 CensysInspect 扫描、PROPFIND 探测这类直连源站的旁路攻击(单日可达 1500 次)会在防火墙层直接死亡。做完这一步,fail2ban 就从“补漏”升级为“双保险”。
## 写在最后
至此我的博客防线是:CDN(隐藏源站)→ 安全组(只放行回源)→ 雷池 WAF(语义分析拦截)→ fail2ban(自动封禁)→ AbuseIPDB(情报反哺社区)。
五层,跑在一台小破云服务器上,成本为零。折腾的过程踩了 11 个坑,全部写进第七节——如果你也要搭,希望能帮你省下这些时间。
有问题欢迎来评论区交流,或者直接去我的雷池攻击日志里看看你的 IP(开玩笑的,正常访客进不了那个列表)。
====
# 嚼别人嚼过的口香糖,AI 时代人的价值
https://www.paddysun.top/archives/5098 · 2026-08-28
> 尽管人工智能给人们带来了不少的便利,但是它同时也产生了一些负面的产物,如这些“他人嚼过的口香糖”。有一些东西,我们还是不能够过度智能化,还是要通过自己去感受体会的,读书就是其中一样。
> ——2019.06 [五温西东](https://www.jianshu.com/u/e16b406baade) 《他人嚼过的口香糖》
上周发生了几件事。
老板丢过来一个新需求,让做竞品调研,输出 PDF 文档。一个同事打开了 Work Buddy,输入竞对名字加”出一份调研报告”,Work Buddy 爬了竞对官网,翻了几页,吐出来一份 HTML。同事交了。
老板说另一个平台也看看,同事又让 Work Buddy 干了,发过来一份 MD 文档。
旁边两个研发同学。一个在那苦哈哈地手工翻接口,把翻到的接口喂给 AI 写代码。另一个刷着手机,”一句话”就让 AI 把原型搓出来了。
而我,在维护旧项目,等他们给反馈,再丢给 AI 整合。
苦哈哈那个同学给我的文档,虽然也是 AI 写的,但他自己细细看过改过,加了图,功能演示是步骤加截图——看得出来花了心思。刷手机那个就只发了个录屏,99% 都是没用的,就最后几秒有东西。我不想翻录屏,让他写 MD 给我,就只有几句话再加几张截图。
最后老板收到了我”整合”的文档,又甩给 AI,还吐槽了一句”咱们写的污染了我的上下文”。
我挖空心思调研和分析的、给 AI 的那些指引,全被藏在了四十多页文档的某个角落,没人看得见。
---
前几天看脱口秀,观众席里一个姑娘说她在咨询公司的工作,就是把 AI 生成的 PPT 发给客户。台下笑了,我没笑出来。
客户公司的美工,现在部分工作就是把原图加模板提示词丢给 ChatGPT 让 AI 改图。
咱们看,到处都是这样。**AI 嚼了一遍,人再嚼一遍,然后再喂给下一个人。**
我把这叫做——**嚼别人嚼过的口香糖**。
---
## 一、让人失望的,不是 AI,是人
说实话,我不反 AI。甚至可以说,我离开了 AI 就说不了话了。
日报周报我让 AI 写,竞品分析我让 AI 做,文章总结我让 AI 拆,论文算法我让 AI 复现。我博客里的大多数技术分析,初稿也都是 AI 写的——说真的,结构比我自己考虑的全,逻辑比我自己理的顺。
那我难受什么呢?
难受的是**“是 AI 牛逼又不是咱们牛逼”**咱们别给我拽。
难受的是拿到一份 AI 生成的文档,咱们永远不知道对方校对过没有、数据准不准、有没有他自己的判断在里面。
难受的是有的人手写的文档格式乱、逻辑也乱——表达差我能理解,毕竟不是谁都是中文系的,但逻辑也乱,就有点失去了为人的价值了吧?
Codeberg 上个月宣布禁止”vibe-coded”项目,理由里有一句话我印象很深:**“那些 LLM 生成的内容中并没有多少有价值的人类洞见和输入。”** [codeberg2026](https://blog.codeberg.org/protecting-our-floss-commons-from-llms.html)
看到这句话的时候我愣了一下。”人类洞见和输入”—— 如果连这个都没有了,那公司为什么不直接雇一个 AI 算了?
但转念一想,我自己又好到哪里去呢?我写的技术博客也是 AI 写的初稿啊。我有什么资格指责别人?
这才是最难受的地方——**我也在搓口香糖。我只是做得稍微”认真”一点而已。**
---
## 二、一个绕不开的悖论:部分超过整体之后
有一个想法在我脑子里转了很久:
> 当”部分”(AI)的智慧总和超过了”整体”(用户)时,试图维持旧有的层级结构(用户统领 AI),不仅在逻辑上是悖论,在效率上是灾难。
这话听起来有点极端,但我越来越觉得它是对的。
前阵子看到一篇论文,做了一个 25,000 个任务的大规模实验,比较不同的多 Agent 协调方式。结论是这样的:既不是中央控制最好,也不是完全自治最好,而是一种混合模式——给一个固定顺序,让 Agent 自己选角色、自己决定要不要参与——效果最好,比集中控制高 14%,比完全自治高 44%。[dochkina2026](https://arxiv.org/abs/2603.28990)
作者把这叫做”内生性悖论”。
我看完的第一反应是:**这不就是在说我吗?**
作为某项任务的”中央协调者”——接需求、拆任务、分给同事、同事再分给 AI,然后我来整合。但如果 AI 和 AI 之间可以直接协调、自组织,那我这个”中央协调者”的角色,是不是反而成了效率瓶颈?
Hao 等人对 4130 万篇科学论文的研究也印证了类似的事:用 AI 的科学家,发文量是不用 AI 的 3.02 倍,被引量是 4.84 倍。但是——科学整体的主题多样性下降了 4.63%,科学家之间的互动减少了 22%。[hao2025](https://arxiv.org/abs/2412.07727)
个体都变强了,集体反而变弱了。
这像不像我们公司的现状?每个人都在用 AI,每个人的产出都比以前多了。但是——东西的质量真的变好了吗?大家真的在协作吗?还是只是各自嚼着 AI 吐出来的口香糖,然后互相喂?
---
## 三、但我还是相信人有价值——因为这还是一个人的社会
说了这么多丧气话,人没用了,AI快统治世界吧。
恰恰相反。我越觉得人有价值——只是人的价值不在以前那个位置了。
(不是技术边界——技术边界每天都在推——而是**社会边界**。
### 技术层面:AI 住在电脑里,它的感知是有边界的
AI 不知道它工作的电脑在哪家公司、做什么业务、用户的直属领导是谁。
发票开专票还是普票这种问题,我离开工位去财务小姐姐那问一嘴就行。AI 呢?它不知道要问谁,甚至不知道该问这个问题。它的”谄媚”——就是咱们说什么它都说好——反而让它连”我搞不清楚”都不会说。
hateonion 写过一篇文章叫《人也需要 Context Engineering》,说人的瓶颈不再是编码速度,而是自己的 context window 有多大、质量有多高。[hateonion_context](https://hateonion.me/zh/posts/human-context-engineering/) 我觉得反过来也成立:**AI 的最大瓶颈也是 context——不是它自己的 context window,而是它根本获取不到那些”不在电脑里”的 context。**
公司的政治、团队的默契、客户的脾气、行业的潜规则……这些东西 AI 从哪里学?它连知道都不知道自己不知道。
### 法律层面:Agent 不是法律实体
AI 写错了数据,咱们找谁追责?找 OpenAI?找 Anthropic?还是找给它写 prompt 的那个人?
最终担责的还是人。这不是技术问题,是社会制度问题。只要法律还是为人制定的,只要责任最终还是落在人头上,那人就不可能真正”退居二线”。
盖茨说 AI 时代需要新的治理框架——国内的和国际的。[gates2026](https://www.gatesnotes.com/home/home-page-topic/reader/small-bugs-big-breakthroughs) 我觉得这话对也不对。对的是治理确实要跟上,不对的是——治理不是”管 AI”,治理是”管使用 AI 的人”。
### 更宏观地说:我们活在一个人的社会里
老板给我们发工资,客户(也是人)买我们的产品。服务于人,面向人的社会。
AI 的 token 要人来充值,充值的钱要人存到银行。Agent 断网了查不到文献、连不上服务器,要人打电话给电信运营商来修。
**人本身是原因,也是目的。**
这句话说出来有点像鸡汤,但我越想越觉得它是对的。AI 再强,它也是嵌在人类社会这个大操作系统里的一个应用。它没有自己的目的,它的目的是人给的;它没有自己的资源,它的资源是人提供的;它甚至没有自己的存在理由——如果没有人用它,它就是一堆服务器在空转。
---
## 四、那我们该怎么办?——提高品味,而不是跟 AI 比技能
想清楚这些之后,我反而不焦虑了。
以前我总担心——AI 会不会把我的工作抢走?我学的那些技术还有没有用?
现在我不这么想了。我觉得**当前最高优先级的事情,是提高自己的”品位”**——工程素养、思维框架、判断力,而不是跟 AI 比谁技术细节记得多。
geedea 说过一句话我特别认同:”不要把咱们的理解、判断、共情和品味外包给 AI。” [geedea_insult](https://kirahowe.com/2026/aug/9/code-was-never-the-hard-part-is-an-insult) 他还坚持接口定义必须手写——因为接口是抽象的核心,是方向,方向不能外包。[geedea_interface](https://www.geedea.pro/article/locally-remotely-unknowingly/)
这个”方向”,放在不同层面有不同的名字:
- 在写代码里,它叫接口设计、架构决策
- 在做产品里,它叫需求判断、用户价值
- 在做科研里,它叫选题、问题意识
- 在组织里,它叫战略、愿景
这些东西有一个共同点:**它们没有标准答案,它们需要判断,而判断需要品味。**
Hao 等人的研究说 AI 让科学主题多样性下降,因为 AI 都涌向数据丰富的成熟领域。[hao2025](https://arxiv.org/abs/2412.07727) 这恰恰说明——**选方向的能力,才是真正稀缺的。** 因为 AI 不会选方向,它只会在人选定的方向上跑得更快。
BCG 的调研也印证了这一点:72% 的人说工作所需的技能变了,47% 的人转向了”AI 指示和管理角色”。[bcg2026](https://web-assets.bcg.com/96/83/0f2f0265450cb3564e498dbb4b6b/jpr-aiatwork2026.pdf) 咱们看——不是人不重要了,而是人的角色变了。从”动手做”变成了”指方向、做判断、担责任”。
---
## 五、口香糖里的灵魂
回到开头那个比喻——嚼别人嚼过的口香糖。
我之前痛恨这件事,是因为我觉得”第二手的东西没有价值”。
但现在我有点不一样的想法。
嚼过的口香糖本身确实没有营养了。但是——**嚼口香糖的那个人,他的表情、他的节奏、他为什么选这个口味而不是那个口味——这些才是人的东西。**
一份 AI 生成的文档本身可能没什么价值。但是谁选了这个题目、为什么做这个调研、在 AI 生成的版本上改了什么、加了什么、删掉了什么——这些改动里,藏着人的判断和品味。
嚼别人嚼过的口香糖的时候,看出其中的人的灵魂的回响,是很关键的。
玩手机同事说”多少人工就有多少智能”——AI 的能力本质上都是人类知识的压缩和投射。blog13 那反过来说,**每一份 AI 生成的东西里,其实都藏着无数人的痕迹——只是得看得出来。**
这也是为什么我仍然相信品味很重要。因为品味就是——在一堆 AI 生成的东西里,咱们能看出哪些是好的、哪些是凑数的。
---
## 六、最后
前几天我在知乎发了一篇用 AI 写的回答,有个评论说:
> “虽然是 AI 写的,但是能把 frame 翻出来也是值得点个赞,以后经典只能靠 AI 了,人已经傻到读不了 3 年前的工作了。”
我不确定他是不是在反讽。
但也是种提醒吧。
**我不想变成那个”读不了三年前的工作”的人。(虽然已经是了)** 我不想变成那个只会给 AI 发一句话指令、然后转发结果的人(可以称之为AI羞耻)。我想做的是那个——能判断 AI 做得对不对、知道方向在哪里、在关键的地方能自己改上几笔的人。
因为说到底,AI 再强,它也是为人服务的。而人之所以为人,不是因为我们能做 AI 做不了的事——
而是因为,**我们知道为什么做。**
---
## 引用与参考
[**dochkina2026**] Dochkina, V. (2026). *Drop the Hierarchy and Roles: How Self-Organizing LLM Agents Outperform Designed Structures*. arXiv:2603.28990. [https://arxiv.org/abs/2603.28990](https://arxiv.org/abs/2603.28990)
[**hao2025**] Hao, Q., Xu, F., Li, Y., & Evans, J. A. (2025). *Artificial Intelligence Tools Expand Scientists’ Impact but Contract Science’s Focus*. arXiv:2412.07727v3. [https://arxiv.org/abs/2412.07727](https://arxiv.org/abs/2412.07727)
[**bcg2026**] Boston Consulting Group. (2026). *AI at Work: Strategy Matters More Than Tools*. BCG X. [https://web-assets.bcg.com/96/83/0f2f0265450cb3564e498dbb4b6b/jpr-aiatwork2026.pdf](https://web-assets.bcg.com/96/83/0f2f0265450cb3564e498dbb4b6b/jpr-aiatwork2026.pdf)
[**codeberg2026**] Codeberg e.V. (2026). *Protecting our FLOSS commons from LLMs*. [https://blog.codeberg.org/protecting-our-floss-commons-from-llms.html](https://blog.codeberg.org/protecting-our-floss-commons-from-llms.html)
[**gates2026**] Gates, B. (2026). *The turbulent AI era is here. The choices we make now are critical.* GatesNotes. [https://www.gatesnotes.com/home/home-page-topic/reader/small-bugs-big-breakthroughs](https://www.gatesnotes.com/home/home-page-topic/reader/small-bugs-big-breakthroughs)
[**blog13**] (Paddy自己). *多少人工,就有多少智能——从 ELIZA 脚本到 LLM 参数,人工从未消失,只是变了形式*.
[**hateonion_context**] hateonion. *人也需要 Context Engineering*. [https://hateonion.me/zh/posts/human-context-engineering/](https://hateonion.me/zh/posts/human-context-engineering/)
[**geedea_insult**] Kira Howe / geedea. *“Code was never the hard part” is an insult to all programmers*. [https://kirahowe.com/2026/aug/9/code-was-never-the-hard-part-is-an-insult](https://kirahowe.com/2026/aug/9/code-was-never-the-hard-part-is-an-insult)
[**geedea_interface**] geedea. *Are We Interfacing Yet?* [https://www.geedea.pro/article/locally-remotely-unknowingly/](https://www.geedea.pro/article/locally-remotely-unknowingly/)
====
# 比尔·盖茨长文警告原文翻译:《动荡的 AI 时代已经到来,我们现在的选择至关重要》
https://www.paddysun.top/archives/5092 · 2026-08-28
## 一次划时代的转变
**动荡的 AI 时代已经到来。我们现在的选择至关重要。** 我们需要一个计划,确保善大于恶。
**作者:比尔·盖茨**(发表于2026年8月28日) **翻译**:GLM-5.3
**原文地址**:[The turbulent AI era is here. The choices we make now are critical.](https://www.gatesnotes.com/home/home-page-topic/reader/a-turbulent-ai-era-and-critical-choices-to-make)
---
### 你需要知道的
向 AI 时代的过渡将是人类历史上最动荡的时期之一。目前,我们并没有为这一转变做好充分准备。如果世界采取正确的步骤,AI 将成为一种向善的力量,让每个人的生活都变得更好。
在我一生中,我只做过两份工作。第一份是在微软开发软件,通过技术赋能于人。
第二份工作从2008年起全职投入,我将自己在微软积累的财富回馈社会,目标是让世界变得更健康、教育更普及、更加公平。这是我余生都要做的工作。
这两段经历塑造了我对人工智能的看法。13岁第一次接触计算机时,我就被一个想法深深吸引——让计算机变得更聪明,能够完成当时只有人类才能做到的事情。虽然”AI”这个词大约在我出生时就开始使用了,但这项技术直到过去十年才取得重大进展。如今它已能力非凡,并且正以令人瞠目的速度持续进步。AI 第一次可以替代甚至超越人类认知。
> **在公平方面,AI 要么是有史以来最伟大的均衡器,要么是最严重的不公之源。**
挑战是巨大的。即便在最理想的情况下,向这个新 AI 时代的过渡也将是人类历史上最动荡的时期之一。我们将如何利用这项技术让世界变得更公平,而不是让它加剧贫富分化?我们将如何保护那些最容易受到人工智能伤害的人,包括那些失去生计、失去对自己未来掌控感的人?
我相信,回答这些问题并据此行动应该是世界的头等大事。如果世界采取正确的步骤,AI 将成为一种向善的力量,让每个人的生活都变得更好。
遗憾的是,目前我们并未为此做好准备。我没有看到领导人、专家和社区在充分应对这些挑战的证据。没有一个计划来帮助我们平稳进入 AI 时代。
部分原因是,许多评论者低估了 AI 将产生影响的程度。我认为原因有几方面。
其一,AI 模型仍然会犯错。很难想象它们能取代人类认知——毕竟不久前,它们连简单的数独都解不了,或者搞不清”strawberry”这个词里有几个字母 R。
但可靠性问题正在被快速解决,研究人员正在开发能够自我检查和自我改进的模型。很快,它们在许多任务上将大幅超越人类。
另一个低估 AI 的原因是,用过去创新的影响来做类比是有误导性的。我们从未经历过一种能被快速采纳、又能像人类一样思考和行动的技术。个人电脑出现时,花了二十年才显著改变我们的工作方式,因为必须开发软件、降低价格,人们还需要学会使用这些工具并将其融入业务流程中。而 AI 运行在我们已有的设备上,使用自然语言。我们不需要适应它,因为它能适应我们。它可以观看用于培训人类工人的同一段培训视频,从现有数据中学习。
我想承认一种潜在的偏见。我从科技行业获益匪浅。虽然我已经相当程度地多元化了我的投资组合,但我在财务上仍与之相关联。作为盖茨基金会主席,我正在与微软及其他 AI 公司合作,试图确保 AI 以真正造福全球人民的方式部署。
然而,我对 AI 的看法并非出于为自身赚钱的动机。我的投资所产生的任何利润,包括与科技相关的投资,都将归入盖茨基金会,用于应对全球不平等问题。当然,读者需要自行判断这是否会影响我的判断。
---
### 这一次确实不同
只要我能记起,我就一直希望创新能来得更快。面对 AI,我的感受更加复杂。
> **我们需要时间为社会、政治和经济剧变做准备。**
我希望世界能迅速获得 AI 带来的好处,并尽可能推迟它引发的问题,但好处和问题正在同时到来。我相信我们需要时间为即将进入的社会、政治和经济剧变期做好准备。最需要时间的人恰恰是拥有的时间最少的人——被机器人取代的会计工作者,或被时薪10美元的机器人抢走工作的、原来挣时薪20美元的工人。
许多观察者说这次技术转型将和以往一样。他们举美国就业从农业转向办公室工作的例子。然而,那是在几代人的时间内完成的,并且创造了需要人类认知的新工作。而这一次,技术可以替代人类认知。
因为它能看、能听、能说、能推理,最终还会像任何人类一样流畅地从事体力劳动,它不会只影响某一个行业。AI 将在法律、客服、医疗、软件开发和制造业中承担工作。它会在十年内——而非几代人内——迅速冲击这些行业。会有一些新工作出现,但如果没有正确的政策,新工作将远远少于今天。
如果有人能提出一个在全球范围内减缓 AI 发展的可信计划,我很可能会支持。然而我不认为这会发生。地缘政治和经济激励都在强力推动全速前进。
为了确保我们最大化这项前所未有的技术的正面效应、最小化负面效应,从而使整体更好,我们需要同时理解好处和风险。我先从风险说起。
---
### 向 AI 过渡伴随三大风险
我计划未来就每一项详细展开论述,这里先简要提及。
#### 一、许多工作将永久消失
1933年大萧条期间,美国失业率约为25%。在随后十年的大部分时间里都维持在两位数。随着需求、投资和增长回归,最终得以恢复。
AI 可能达不到这个水平,但它的影响不会随经济周期消退。风险最大的是入门级和中级岗位,而正在创造的新工作大多需要多年才能学会的技能。
白领工作已经受到了轻微冲击。生成式 AI 广泛应用后,在特别容易被替代的工作中,年轻劳动者的就业显著下降,而年长同事则不然。
我认为这一趋势将持续,但不会仅限于少数几个行业或职业。销售和客服(在线和电话)、软件工程和律师助理工作可能最早受到影响,但随着 AI 承担今天仍需训练有素的工人才能完成的任务——如评估贷款申请、进行数据分析,甚至分诊患者——冲击将波及更广。少数领域如软件工程在成本下降时会产生新需求,因此只要某些任务(如设计)由人类完成更好,这些领域的净岗位流失会少于其他领域。
蓝领工作也将受到影响。虽然机器人不如 AI 成熟,但其成本最终也会大幅降低。与我交谈的许多美国人没有意识到灵巧机器人发展有多快,因为许多先进工作是在其他国家、主要是中国完成的。或者他们可能被最近疯传的机器人笨拙跳舞的视频所迷惑。我认为”智能”机器人将在本十年末开始在部分体力任务上与人竞争——例如建筑和酒店服务业。
机器人和 AI 结合可能形成恶性循环。一家公司采用它们并用节省下来的成本降低价格后,其竞争对手将承受巨大压力不得不跟进。如果现有公司不采用,初创公司就会采用。许多人将转向其他工作,但失去工作、接受再培训和寻找其他工作的动荡将是巨大的。市场力量将使采纳速度越来越快,除非我们干预,否则好的工作岗位会更少,而好处将集中在少数人手中。
我特别担心年轻人,他们将进入一个入门级岗位更少的就业市场。他们理解这个挑战,因为他们是 AI 最活跃的用户,既看到了它的能力,也看到了它改进的速度。难怪他们中许多人对 AI 持负面看法。
对工人来说,最大的转变将发生在 AI 提供几乎零差错的工作时。到那时,它可以在没有人类监督的情况下独立运行,而公司将有一切经济动机让它这样做。
这将导致我们对工作、收入和经济安全的根本性重新思考。如果一个建立在就业基础上的经济体中,更少人在工作,或许多人工作时间减少,它将如何运转?
在资本主义社会中,就业是大多数人获取基本生活所需金钱的方式,也是尊严和社会联系的重要来源。
当一个社区出现高失业率时,连锁反应可能无处不在。研究表明,在美国部分地区,工厂倒闭与阿片类药物过量致死人数上升有关。现在想象类似的压力同时压在白领和蓝领工人身上。
我们现在就必须思考如何减少失业,让每个人都能分享 AI 创造的繁荣。等到人们已经被取代或就业不足时就太晚了。AI 对我们经济的组织方式构成结构性挑战,需要现在就开始思考和行动。
#### 二、AI 将赋能人们(也许还有 AI 自身)造成更大危害
早在 AI 进入主流之前,网上就有关于如何制造炸弹、生物武器甚至计算机病毒的信息。AI 将使获取这些信息并付诸行动变得更加容易。即使是技能非常有限的罪犯也能对各种规模的受害者发起攻击:个人、公司和政府。
> **技能非常有限的罪犯也能对各种规模的受害者发起攻击。**
AI 驱动的诈骗、虚假信息、深度伪造和监控,是许多人在日常生活中感受最深的危害。
AI 能力正开始被用于网络攻击。我认识的最聪明的网络安全专家对接下来几年感到恐惧,因为攻击者获得强大新能力的速度快于防御者修补所有漏洞的速度。毕竟,同一个能找出软件漏洞供公司修复的 AI 模型,也能帮助罪犯利用该漏洞。发动攻击所需的资源正在显著降低,而我们一直没能将这些能力与良性使用区分开来。
想想那些将变得脆弱的基础设施:医院、金融机构、供水系统、电网、政府福利管理系统。当这些机构遭到攻击时,受损的是患者、客户和福利领取者。
生物恐怖主义也是如此。虽然 AI 将在药物和疫苗方面带来救命的进步,但它也会使设计新的致命疾病变得更容易。同样,正面能力很难与危险能力分开。这是一个全球性问题。
我刚才提到的风险都是关于 AI 如何赋能目前力量较小的坏人。同样的工具也会将权力集中在本来已有权力的地方。例如,自主武器将使政府更有能力在不让人类参与决策的情况下使用致命武力。监控和操纵公众舆论将变得更容易、更便宜,也更有效。
最终,利用 AI 伤害人类的力量不会仅限于人或机构。AI 系统本身已经偶尔会以设计者未预料的方式行事。技术正以超出任何人预期的速度改进,方式也出人意料。随着模型变得更加强大,它们可能开始违背我们的利益行事,而我们可能失去控制。我未来还会就此说更多。
> **AI 模型可能开始违背我们的利益行事,而我们可能失去控制。**
#### 三、AI 可能阻碍我们的孩子发展,并取代人际关系
我在西雅图长大时,除了几个和我一样的男孩,并没有太多朋友。是艰苦的努力和母亲的大量帮助,让我发展出社交技能,能够与不同类型的人相处。如今70岁的我仍在运用这些经验。
我怀疑如果当时有一个 AI 陪伴,我不会付出同样的努力。它们以你已经习惯的方式与你交谈。它们不把你推出舒适区。它们总是随时在线,从不生你的气。这使它们有可能变得高度上瘾,剥夺我们从与他人交往中学到的经验。
关于这个问题的证据体系仍然很小且有些参差,但有一些迹象表明我们应该非常关切。例如,在一项对1100多名 AI 陪伴用户的研究中,斯坦福和卡内基梅隆大学的研究人员发现,社交网络较小的人最可能转向聊天机器人寻求陪伴。而且使用越深、越涉及情感,他们感觉越糟。
年轻人可能终生受影响。乔纳森·海特在《焦虑的一代》中关于社交媒体效应的一个观察,对 AI 更加适用:”就像暴露在风中的小树,经常面对小风险的孩子长大后能成为从容应对更大风险的成年人。相反,在受到保护的大棚中长大的孩子,有时在成熟之前就被焦虑击垮。”
一个设计成永远不会让你不高兴的 AI 陪伴,就是一个巨大的、受保护的大棚。
我们才刚刚开始理解互联网——尤其是社交媒体——对年轻人发展可能造成的危害。我们看到了强迫性使用、睡眠干扰、网络欺凌和接触有害内容。AI 可能通过使这些危害更有说服力、更难逃离来放大许多风险,我们不应再等一代人才能认真对待它们。包括澳大利亚、英国和挪威在内的国家正在采用保护儿童的在线措施。中国走得最远。其规则广泛限制 AI 陪伴应用,禁止助长情感依赖的设计,并禁止为未成年人提供虚拟亲属和恋爱伴侣。
> **同一件让人学到前所未有的多的工具,也可能导致许多人学得更少。**
我也担心 AI 对教育的影响。讽刺的是,同一件让人学到前所未有的多的工具,也可能导致许多人学得更少。一项初步调查显示,AI 使用越多与批判性思维越弱相关。这种效应对年轻人更强。
这将是人类丧失批判性思维技能的最糟糕时机。在一个深度伪造和可以针对你个人定制虚假信息的时代,辨别真假的能力成为一项基本生存技能。
这些心理社会问题的界限在哪里尚不清楚。在某些情况下,AI 可能帮助人们了解如何在人际关系中做得更好。对于与社会隔离的老年人和行动不便的人来说,它可能是与外界唯一的联系,总比没有好。无论我们最终把界限划在哪里,这应该是我们有意做出的决定。
---
### 我们用 AI 做的好事可以非常、非常好
人们常说,我们高估了短期内将发生的变化,低估了长期将发生的变化。
对于 AI,我看到了不同的情况。一些人只看到 AI 的好处,对负面影响关注不够。另一些人则犯相反的错误,只关注危险——这些危险是真实的——而以忽视潜在好处为代价。
我们两者都需要:对需要最小化的 AI 危害有深切关切,对如果为所有人最大化好处时的正面效应有务实的乐观。
最大化好处和最小化危害同等重要。如果人们看到 AI 如何让生活更轻松,这将帮助建立管理转型更艰难部分所需的公众信任。如果 AI 在大多数人生活中做的第一件事是夺走他们的工作,那些本就持怀疑态度的人会彻底拒绝它。这将使最终兑现好处变得更加困难,这也是政府、包括医疗行业在内的各行业以及 AI 公司应该现在就携手合作的又一个原因。
凭借从每个科学领域综合知识的能力,AI 可以加速世界上最棘手的技术挑战的创新:为所有人提供可靠的清洁能源、应对气候变化、种植足够的粮食、消灭疾病等等。从事癌症治疗或核能研究的科研人员可以用 AI 搜索海量科学文献。它可以帮助他们识别人类可能遗漏的模式,并判断哪些实验最有前景。当智力不再是今天这样的限制因素时,较小的公司也能与拥有远大研究预算的机构竞争。研发和创新将得到极大加速。
医疗是 AI 能帮助解决现实问题的一个领域。许多美国小型医院缺乏能够在危及生命的紧急情况下快速诊断患者的现场专家。在这些地方,AI 可以确保心脏病被及时发现,让一个家庭避免医疗紧急情况的毁灭性开支。Viz.ai 就是一个例子,它分析扫描图像以检测中风和其他紧急情况,帮助医疗团队协调患者护理。它已被近2000家美国医院使用。
AI 还将帮助初级保健医生做出更好的诊断,在患者不在诊所时保持联系。它将帮助患者理解检查结果和复杂的服药时间表。
> **农业是我看到 AI 在低收入国家产生最快影响的领域。**
当我告诉人们第二个领域——农业——是我看到 AI 在低收入国家产生最快影响的领域时,很多人感到惊讶。在大多数低收入国家,农民得不到可靠的天气预报,也得不到关于种什么种子、如何保护作物和牲畜免受疾病侵扰、如何改良土壤的建议。随着这些国家的人口增长和气候变化的挑战,这些农民比以往更需要帮助。利用 AI,低收入国家的农民很快将能在所有这些方面获得比今天最富有的农民更好的建议,并大幅提高产量。
政府服务是 AI 能让人民生活更轻松的第三个领域。在美国,我见过一些家庭理所当然地被申请医疗保险、学生援助或食品援助的流程所压倒。面对一大堆复杂的官僚表格,许多人想放弃。AI 可以大幅简化流程,让他们更快得到所需帮助,同时政府运转更高效。政府可以从最需要安全网服务的人开始,让公民体验大幅改善。
尽管我对 AI 对心理健康的潜在影响有担忧,我认为 AI 在这方面也能帮很多忙。大多数社区缺乏足够的心理咨询师、精神科医生和成瘾治疗专家。在适当的隐私保护下,AI 工具可以帮助人们识别警示信号。然后,如果需要,它们可以提供基于证据的应对策略,并与人类协作提供更及时的治疗。
尽管有前述担忧,AI 也可以成为教育的福音。它可以解放教师,让他们有更多时间与学生一对一或小组合作,并让他们更清楚地了解全班在哪里遇到困难。对学生而言,能保留研究者所说的”有益的挣扎”——那种建立理解力的认知劳动——的 AI 工具可以强化学习。当学生第一次接触一个新概念时,AI 给出实质性的解释,同时提供问题和答案。之后,在检查理解时,它保留答案,帮助学生自己推导出来。
综合来看,所有这些领域的进步可以让日常生活更轻松、更可负担,更少受个人收入或人脉的制约。
AI 可以让个人和小企业获得今天需要昂贵专业帮助或大量人手才能实现的能力,同时让产品和服务更好、更便宜。它可以帮助残障人士更独立地生活,让有好想法的工人和创业者完成远超今天的事情。
最重要的是,它可以帮人们夺回一些现在被文书工作、官僚程序、搜索可靠信息以及他们无力付费委托他人的任务所吞噬的时间和注意力。这些好处看起来可能不大,但乘以数百万人的生活,影响将是深远的:更多人在需要时获得好建议,拥有更大的自由去专注于他们想要构建的生活。
> **我们必须有意识地确保它造福所有人,而不仅仅是少数富人。**
在所有这些领域,关键词是”可以”——AI 可以改善每一个收入水平的人的生活。但它不会自动做到这一点。和任何新技术一样,我们必须有意识地确保它惠及所有人,而不仅仅是少数富人。这将需要政府和慈善事业发挥强有力的作用,确保不太富裕的公民和低收入国家成为完全的受益者。
盖茨基金会还剩19年,用于花完其剩余的2000亿美元。AI 将帮助它实现宏大目标,既加速发现 HIV、结核病、疟疾和营养不良的疫苗和药物,又帮助医疗工作者和患者了解如何使用这些工具。基金会的目标包括再次将每年死亡的儿童人数减半——正如2000年到2024年所完成的那样。我们所有的工作,不仅是健康,还包括农业和教育,都将充分利用 AI。
我将在下个月基金会的年度”目标守护者”报告中更详细地介绍这些努力——包括我们致力于确保 AI 模型以我们支持工作所在国家的语言提供给人们,而不仅仅是富裕和中等收入国家常见的语言。包括 OpenAI、Anthropic、谷歌和微软在内的许多领先 AI 公司正与基金会合作推进所有这些倡议,这正在产生巨大影响。
---
### 世界需要一个计划
一些 AI 公司提出解决方案来应对其自身技术带来的挑战,这很好,但我们不应期望它们来领导这项工作。其中一些问题超出它们的专业领域,而在一个民主社会中,决定这些事情不是它们的角色。
相反,解决方案应通过公共民主进程来制定,包括民选官员、政策制定者、教育工作者、医疗工作者、地方官员和社区领袖。数百万人将面临生活被打乱,我们需要一个更强有力、更灵活的社会安全网帮助他们管理过渡。地方社区已经在提出对数据中心所需能源和水的关切。如果没有解决方案,一些群体将推动完全停止 AI 开发和部署。
解决方案的塑造应基于我们对 AI 提出的深刻问题的回答,包括在机器能够超越我们思考的时代,我们如何保持人性。宗教领袖一生都在思考身为人类意味着什么,可以在这方面发挥关键作用。教皇利奥十四世关于 AI 的通谕《在人工智能时代保护人格》让我深感兴趣,它为需要完成的工作奠定了坚实的基础。
在接下来的几个月里,我将分享更多关于确保 AI 的好处超过其造成危害的想法。这里先提出三个,从我认为最重要的一个开始。
#### 一、建立管理过渡的新体系
最优先的是一个宏大的任务:创建一个处理 AI 的国内和国际框架。
我们现有的机构没有一个是为处理一种传播如此之快、触及生活如此多方面的技术而设计的。因此我们需要建立新的机构。
这件事的工程量之大怎么强调都不过分。9/11袭击后,美国政府经历了二战以来最大的重组,目的仅仅是改善一个职能——国家安全。
AI 将需要多得多。它将影响国家安全以及就业、教育、税收、能源、选举、空气和水、公共健康、金融体系、执法、交通、公共土地和 IT 系统。
这些领域以我们现有官僚体系设计上无法应对的方式相互重叠。劳工部门可能了解就业冲击但不了解安全风险。商业监管机构可能了解市场集中度但不了解 AI 对儿童和青少年的影响。如果听之任之,各机构只能看到系统的一部分,而 AI 的后果将波及整个系统。
在国家层面,各国需要能够跨政府机构设定优先事项的机构。目标将是确保每一种风险都有人负责。否则,一次 AI 驱动的攻击可能成功,因为没有人认为阻止它是自己的职责。
但即使一个国家理顺了内部事务,仍然面临跨境风险。这就是为什么需要同步建立一个国际组织。
它将不同于我们曾经创建过的任何机构,尽管它可以借鉴一些现有体系的模式。有核武器核查制度、国际航空法规和保护臭氧层的协议。一个新的全球 AI 组织将需要三者的要素甚至更多。
人们有理由怀疑世界机构是否有能力设计和实施这一新架构。政府即使有所行动也往往很慢,而国内和国家之间的两极分化使成事比以往更难。美国和中国之间也需要一定程度的合作。
我们没有慢慢来的奢侈。起点应该是在颠覆迫使政府进入危机模式之前,建立一个建立正确机构的进程。国家领导人应定期召集经济学家、技术专家、劳动专家、商业领袖和工人自身,识别现有机构在哪里失效,以及可能需要什么新职权。各国需要相互学习。
那些拥有领先 AI 开发者并控制供应链关键部分的国家应该现在就开始会面,在竞争压力使合作变得更困难之前建立共同规范。
建立我所说的框架将需要数年时间,这就是为什么我们需要现在就开始。
#### 二、为人类保留一些工作
我父亲于2020年因阿尔茨海默病去世。在他病程晚期,日夜间都有付费护理者照顾他,即使他难以表达自己,他们也能理解他。他不总能告诉他们他饿了,但他们总是知道。
我和我的家人将永远感激那支了不起的专业团队。他们给予我父亲的照护中有一些是无可替代的人性。没有机器人能够也不应该做到。
当讨论哪些工作将消失、哪些将保留时,我总会想到那支团队。我相信,随着 AI 和机器人进步,我们将把某些事情专门留给人类来做。我开始将这个领域称为”人类保留区”(Human Reserved),它是我们需要考虑的那类想法的一个例子。
我喜欢”人类保留区”这个词,因为它让我想起自然保护区——那些我们本可以建楼修路、但我们选择不这么做的地方,因为损失太大了。
我们可能出于经济原因将某些事情设为”人类保留”。例如,我们可能这样做是因为让机器接管某个角色将使大量难以转行的人失业。你不能告诉一个整个职业生涯都在建筑业度过的55岁的人,他们需要去养老护理机构工作,还期望他们觉得这有意义。
有时,将某事设为”人类保留”的决定将由其他因素驱动。比如在医疗领域,想象一个机器人告诉你得了不治之症的噩耗。没有技术上的理由它做不到。但它不应该这样做。
“人类保留区”的领域将随时间演变——例如,我们应该考虑现在就保留一些工作,并在数年或数十年内缓慢引入 AI,同时承诺保留部分工作。某些领域,如教育和心理健康照护,将是一种混合模式,由人类主管使用技术来扩展自己的能力。
界限也会因地区而异。一些国家可能坚持由人来照顾老人。但像日本这样劳动力萎缩、年轻人不足以照顾老人的国家,可能欢迎照护机器人。
“人类保留区”的概念引出了一系列我没有答案的问题。谁来决定我们为人类保留什么?应该使用什么标准?如何防止企业作弊使用机器人?当一个国家允许机器人制造某物而另一个国家不允许时,国际贸易会怎样?这些都需要在过渡计划中公开解决。
#### 三、重新平衡我们对劳动和资本的征税方式
随着工人被推向不同的工作,他们将需要再培训和社会安全网的其他支持。但他们的工作时间将减少,这意味着所得税将减少,政府收入将恰在对这些服务需求最大时下降。在预算紧张之际,资金必须从某个地方来。
我认为我们应该对 AI 算力和机器人征税。现在,如果你是雇主并雇了一个人,你要为其收入缴纳工资税。但如果你买了一台机器人,通常可以立即作为业务支出抵扣。税收制度在引导你用人替换人。
一项税收将略微减缓从人力劳动转移的进程,并为再培训和更强有力的安全网筹集资金。它需要精准设计,以免减缓 AI 纯粹有益的用途,比如让药物和教育更便宜。
这一想法的批评者指出,从经济意义上说这不是最优效率,但他们没有考虑到工作对个人和社会更广泛的价值。而且有了所有加速的创新,我们能负担得起一点效率损失,作为保持就业的代价。
几年前我提出过机器人税,大多数反应是觉得这是个奇怪的想法。我仍然是它的坚定支持者。虽然它不是对 AI 威胁的完整解决方案,但它是明智回应的一部分。
无论我们如何为更多援助筹集资金,它都需要到达最需要的人手中,包括因 AI 和机器人而失去工作的工人、工时或工资下降的人,以及损失集中的社区。我们需要现在就开始这项工作,以便在需求变得迫切时系统已经就绪。
---
### 我正在做的事
我将用我的声音和时间,把 AI 和公平提升到公共议程的更高位置。每次访问华盛顿特区我都会向议员提出这个问题,在世界各地会见领导人时也会如此。在我与那些开发 AI 模型的人的对话中,它将是核心议题。我将倡导我前面描述的国家和国际框架。盖茨基金会将帮助推动有益的使用,包括在非洲。我创立的突破能源公司将利用 AI 帮助企业开发廉价清洁能源并帮助解决气候问题。我还将定期撰写关于 AI 的文章。
**我向领导人们传达的信息是:**
> 你们有机会在失业率急剧上升、社区受伤、公众信任被侵蚀之前采取行动。你们可以确保你们的政府整体性地处理问题,而不是将其分割成多个官僚小地盘。你们可以确保 AI 造福所有人。你们可以与其他政府合作来应对这一国家和全球挑战。
最后,我将努力扩大参与塑造这场辩论的人群范围。它应包括工人、即将进入就业市场的大学生、社区领袖、宗教领袖和信仰组织、家长、教育工作者,以及其他那些声音常常不被听到、但对转型将如何影响人们生活有洞察力的人。
> 我们如何确保 AI 的好处惠及那些并非已拥有财富、影响力和资源的人?
> 我们如何加强社会安全网,帮助工人和社区即使在流离失所时也能蓬勃发展?
> 公共机构应如何适应?
> 以及在这一切中,我们如何保持人性?
> **这项前所未有的技术需要前所未有的全球回应。**
这项前所未有的技术需要前所未有的全球回应。如果我们做对了,对人类的回报将是惊人的,世界将变得更加公平。
我很少停止思考 AI——不是因为我有所有答案,而是因为它提出的问题太过重要,不能留给一小群技术专家。学术界、商界、政府和民间社会的领导者们,在塑造接下来的未来中都有各自的角色要扮演。
====
# [Agent 考古] 自知、自觉、自止——终章定论:Agent 不需要意识,但必须知道自己的边界、理由和终点
https://www.paddysun.top/archives/5049 · 2026-08-25
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942) · [\[Agent 考古\] AI 组织形式的七次重分配](https://www.paddysun.top/?p=4915)
**篇号**:第 13 篇 / 共 13 篇(终章) **主题分类**:观点评论 **前置阅读**:[Bar-Hillel 式批评](https://www.paddysun.top/archives/5039) · [ELIZA 1966](https://www.paddysun.top/archives/4980) · [Minsky 心智社会 1986](https://www.paddysun.top/archives/4997) **阅读时间**:约 15 分钟
---
## 多少人工,就有多少智能——从 ELIZA 脚本到 LLM 参数,人工从未消失,只是变了形式
1966 年,Joseph Weizenbaum 写出了 ELIZA。这个只有几百行代码的程序,靠一套人工编排的关键词匹配脚本,让无数用户产生了”它在听我说话”的错觉。Weizenbaum 本人对此深感不安——人们竟然愿意相信一个纯模板匹配的程序”理解”了他们 weizenbaum1966。
六十年后,大语言模型拥有千亿参数,能写代码、能翻译、能推理。人们再次争论:它真的”理解”了吗?它有”智能”吗?这场争论的声音更大、参与的人更多,但核心困惑与 ELIZA 时代并无二致——我们感受到的”智能”,到底来自系统本身,还是来自系统承载的人工?
从 ELIZA 的显式脚本到 LLM 的隐式参数,人工承载的形式发生了巨大变化,但”多少人工,就有多少智能”的底层逻辑始终如一。不同的是,今天我们有了更精确的度量框架——François Chollet 2019 年提出的智能定义——让我们可以穿透表象,回答那个从 ELIZA 时代就悬而未决的问题:**智能到底是什么?它从哪里来?如何度量它?**
本文是系列终章。我们将以 Chollet 的度量框架为标尺,重新审视从 ELIZA 到 LLM 的每一个系统,揭示”人工承载”从显式到隐式再到有机的演进路径,并在 Minsky 心智社会与 Chollet 度量论的交汇处,提出关于 Agent 未来的工程判断。
---
## Agent 是工具:一个需要反复确认的基础价值观
在展开一切讨论之前,必须先确立一个基础价值观:**Agent 或 LLM 是工具**。
争论一个工具有没有”意识”是没有意义的——锤子不需要有意识才能钉钉子。人是愿望的来源和存在的意义,工具的意义在于更好地完成人赋予的任务。但有一种情况例外:若要 Agent 自主制定工作计划,它需要”自知”(知道自己在做什么)、”自觉”(知道为什么这样做)、”自止”(知道何时该停止)——此时”意识”才有工具性意义。不是因为它”应该”有意识,而是因为具备这些能力后它能更好地完成某些类型的任务。
本文搁置两类担忧。第一类是人类主体性担忧——”人工智能一旦具有意识,其思考能力必然不低于人类,还要不要听人的”——这一问题预设了”有意识就会不听人的”,但工具的意义恰恰在于服务于人的愿望。第二类是道德与法律担忧——”某些任务即使机器表面上能做,也不应被委托给机器”——这是重要的规范性问题,但不在本文的讨论范围内。
本文聚焦一个实用问题:什么是”更好地完成任务”中的”智能”?它从哪里来?如何度量它?回答这个问题,需要一把精确的标尺。
---
## Chollet 的度量革命:智能不是技能,是获取技能的效率
François Chollet 在 2019 年的论文《On the Measure of Intelligence》中提出了一个根本性的范式转换 chollet2019。他将智能定义为:
智能是系统在任务范围、先验知识和经验的约束下,获取新技能的效率。
这一定义的核心在于把”智能”与”技能”分开。一个系统在特定任务上表现极好(如 AlphaGo 下围棋),不等于它智能——因为这种表现可能完全来自大量先验知识(训练数据)和大量经验(训练回合)。Chollet 的关键论断是:
> “无限先验知识或无限训练数据允许实验者以任意方式’购买’系统任意水平的技能,从而掩盖系统自身的泛化能力。”
“购买”(buy)一词精确地揭示了问题本质:技能可以靠数据”买”来,但”买来的技能”不等于智能。真正的智能体现在面对全新任务时,以多少经验和多快的速度学会并泛化。
Chollet 进一步区分了三种泛化层次:鲁棒性(在同类任务的不同实例上保持一致)、灵活性(适应任务分布中的小变化)和泛化性(在全新类别的任务中迁移和适应)。他认为,当代 AI 评估大多停留在前两个层次,而他设计的 ARC benchmark 正是为了测试第三层:系统能否从少量示例中抽象出规则,并泛化到从未见过的任务。
### Chollet 智能定义的四要素
Chollet 的定义包含四个相互约束的维度,它们共同构成了智能的度量空间:
> **作者注:** 以上四要素图是对 Chollet 定义的可视化解读,而非原文配图。将 scope、priors、experience、skill acquisition efficiency 理解为一个相互约束的度量空间,有助于我们在后续章节中系统地定位每一个 AI 系统的”智能坐标”。
这一框架将在本文后续章节中反复出现——它提供了一个统一的度量标尺,让我们可以重新审视从 ELIZA 到 LLM 的每一个系统。
---
## 人工承载的三重形态:从显式脚本到隐式参数
“多少人工,就有多少智能”——这不是一句俏皮话,而是理解 AI 历史的一把钥匙。从符号主义时代到今天的大模型时代,人工承载经历了三次形态转变,但底层逻辑始终一致:**系统表现出的技能水平,与其承载的人工知识量正相关**。
### ELIZA:脚本编排得好,人才感觉其智能
ELIZA 是一个脚本引擎——它不含任何领域知识 weizenbaum1966。它的”智能”全部来自 DOCTOR 脚本的人工编排:关键词排名、分解规则、重组规则。脚本越好,用户越感觉”回答好像和输入相关”,越感觉其”智能”。但这个”智能”不在 ELIZA 程序中——它在脚本的编排中,在编排脚本的人的判断中。
在 Chollet 的框架下,ELIZA 的脚本是 priors(先验知识)——脚本编排得越好,”购买”的对话技能越多。但 ELIZA 的 skill acquisition efficiency = 0:它不能学习任何新技能。换一个脚本,它就变成另一个”人”;不换脚本,它永远只做同一件事。
### STRIPS 与 MYCIN:显式编码的人工判断
STRIPS 的算子三元组由前提条件、添加表和删除表组成 fikes1971。add/del list 的本质是工程师关于”这个动作会影响到什么”的人工判断。当 STRIPS 执行 `goto(room_A, room_B)` 时,它”知道”位置变化——但这”知道”不是它推理出来的,而是工程师在列表中写明的。那些没有出现在列表中的谓词呢?封闭世界假设认为它们自动保持不变——这恰恰是 McCarthy & Hayes 1969 提出的框架问题的核心。
MYCIN 的每条规则形如 `IF 前提 THEN 结论 WITH 置信度` shortliffe1976。CF 值从专家那里来,每条规则的置信度是专家根据经验和直觉设定的人工判断。600 条规则等于 600 个人工编码的知识单元——这就是知识获取瓶颈。MYCIN 的”智能”不在推理引擎中,而在 600 条人工编码的规则中。
在 Chollet 的框架下,STRIPS 的算子和 MYCIN 的规则都是 priors。算子越完备、规则越精确,”购买”的技能越多。但它们自身不能学习新算子或新规则——skill acquisition efficiency = 0。
### LLM:训练文本是人工的隐式承载
LLM”吃”了大量人类文本——这些文本本身就是人工的承载。每一段文本背后都有人在思考、在表达、在组织语言。LLM 的”智能”——如果有的话——在很大程度上来自这些文本所承载的人类知识和推理模式。
从 ELIZA 的”显式脚本”到 LLM 的”隐式参数”,人工承载发生了一个关键转变:**人工从可读变为不可读**。ELIZA 的脚本人人可读,谁都能审查它为什么这样回答;STRIPS 的算子三元组完全透明;MYCIN 的规则和 CF 值可以追溯。但 LLM 的参数——千亿个数字——没有人能”阅读”它们。
Chollet 的论断在此精确命中:LLM 的训练数据就是 priors,千亿参数”购买”了极高水平的语言技能。但这种技能是否等同于智能?Chollet 说不是——因为 LLM 在面对训练分布外的全新任务时,泛化能力仍然有限。
### 人工承载对照表与演进路径
下表系统对比了五个系统在 Chollet 框架下的定位:
系统人工承载形式可读性Chollet 框架对应skill acquisition efficiencyELIZA脚本规则完全可读priors(脚本=先验知识)0(不能学习新技能)STRIPSadd/del list完全可读priors(算子=先验知识)0(不能学习新算子)MYCIN规则+CF完全可读priors(规则=先验知识)0(不能学习新规则)LLM训练文本→参数不可读priors(参数=压缩先验)+ experience(训练过程)有限(可以微调,但不能在线学习)人类经验+文化传承隐式priors(进化先验)+ experience(终身学习)高(可以从少量示例学会新技能)
> **作者注:** 人工承载的三阶段演进——显式、隐式、有机——是本文对 AI 历史发展路径的凝练,而非任何单一文献的论断。这一演进的核心驱动力是 priors 规模的增长与可读性的下降之间的张力:显式阶段 priors 少但透明,隐式阶段 priors 多但不可读,而有机阶段的人类同时具备丰富 priors 和内省能力。如何在保持大规模 priors 的同时恢复可读性与可审计性,是未来 Agent 工程的核心挑战之一。
---
## 尝试-错误-再选:智能的动态维度
如果说 priors 是智能的静态维度——系统已经知道什么——那么”尝试-错误-再选”就是智能的动态维度:系统如何从经验中学习。这个维度直接对应 Chollet 定义中的 experience 与 skill acquisition efficiency。
### ELIZA 不尝试:纯模板匹配的刺激-反应
ELIZA 没有尝试-错误机制。给定一个输入,它做固定匹配,产生固定输出。如果匹配到了关键词 `mother`,它就回 `Tell me more about your mother`——不管这个回答是否”合适”。
ELIZA 没有”觉得不行就换方法”的能力。它不会想”这个回答好像不太对,让我换个方式”——因为它没有任何”觉得”的机制。它是 stimulus-response 的纯机械偶对。在 Chollet 的框架下,ELIZA 不能”再选”——脚本固定,永远只做同一件事。skill acquisition efficiency = 0。
### STRIPS 有尝试:但目标可量化、空间固定
STRIPS 的状态空间搜索是”尝试-错误”的:它尝试一个算子,检查是否接近目标,如果不行就回溯尝试另一个。这种搜索有明确的终止条件:目标状态满足。
Logic Theorist 证明定理、STRIPS 达到目标状态、McCarthy 的 Advice Taker 推出祈使句——它们的共同特征是目标可量化。能证就证明了,不能证就没证明;达到目标状态就到了,没达到就还没到。这些问题有”正确答案”。
但 STRIPS 的”尝试”局限在固定的搜索空间内——它可以再选算子,但不能学习新算子。skill acquisition efficiency 仍然 = 0。
### ELIZA 面对的是人的感觉:没有正确答案
ELIZA 面对的领域是心理对话——这里没有”正确答案”。说”Tell me more about your father”是好还是不好?取决于用户的感受,而不是某个可度量的指标。
MYCIN 处于此问题的中间地带。它的诊断有”正确答案”(细菌类型),但它的”好坏”对标的是”有没有人这样的水平”——以人类专家的诊断能力为基准。CF=0.8 意味着”专家有 80% 的把握”——但这个 80% 本身就是专家设定的,不是客观真值。
这种区分映射到 Chollet 的框架:**智能度量必须绑定任务范围(scope)**。STRIPS 的 scope 是”状态空间中的可达性”——可量化、有终止条件。ELIZA 的 scope 是”用户的主观感受”——不可量化、无终止条件。MYCIN 的 scope 是”以人类专家为基准的诊断准确率”——半量化。不同 scope 下的”智能”度量方式根本不同。
### 尝试-错误-再选的效率光谱
从”尝试-错误-再选”的视角看,不同系统落在一条效率光谱上:
“尝试-错误-再选”本身就是学习过程。智能体现在”再选”的效率——用多少次尝试学会新技能。LLM 训练时可以”再选”(梯度下降),但推理时冻结,因此 skill acquisition efficiency 是有限的而非高的。人类可以在线”再选”——从少量经验中学会新技能——这才是 Chollet 框架下真正的高智能。
---
## 告知、感知、经验:智能演进的三阶段
如果说”尝试-错误-再选”描述了学习的内部机制,那么”什么东西在改变系统行为”则描述了学习的外部输入。从 McCarthy 的陈述句告知,到 Brooks 的感知耦合,再到 Chollet 的经验维度——这是智能从静态走向动态的三个阶段。
### McCarthy:陈述句告知——让机器自己推演
McCarthy 的 Advice Taker 的核心设计是:不告诉机器”做什么”,而告诉机器”世界是什么样的”——用陈述句告知,让机器自行推出”该做什么” mccarthy1958。
McCarthy 的设计宣言是:
> “The intelligence, if any, of the advice taker will not be embodied in the immediate deduction routine. This intelligence will be embodied in **the procedures which choose the lists of premises** to which the immediate deduction routine is to be applied.”
演绎引擎本身不含智能——智能在于选择哪些前提交给演绎引擎。这一论断在今天依然有效:LLM 的注意力机制是”即时演绎例程”,而 harness 的 prompt 工程、tool 选择、RAG 检索是”选择前提的过程”。
### Brooks:感知直接耦合行动——取消中间表征
Brooks 1986 年的 subsumption 架构取消了”告知”和”表征”的中间步骤:感知→行为层→致动,无世界模型,无规划器 brooks1986。
“世界自身即是它最好的模型”——不需要内部表征,直接感知世界并行动。这是一种”告知”的极端简化:世界直接”告知”机器人该做什么。感知取代了告知的位置,环境本身成为了知识的来源。
### LLM:告知(prompt)改变行动(token 生成)
LLM 的工作方式是:给定一个 prompt(告知),生成 token 序列(行动)。prompt 改变了 LLM 的输出行为——同一个 LLM,不同的 prompt 产生完全不同的输出。
但这里有一个关键区别:LLM 不能从单次交互中学习。它的”学习”是训练时的参数更新——训练完成后,参数冻结。推理时的 prompt 只是”激活”了已有参数中的某些模式,而不是”学习”了新东西。这意味着 LLM 停留在”告知改变行动”的阶段,尚未进入”经验改变行动”的阶段。
### 三阶段演进路径
从”告知改变行动”到”感知改变行动”再到”经验改变行动”——这是智能从静态走向动态的三个阶段。
> **作者注:** 将智能演进划分为”告知—感知—经验”三阶段,是本文在 McCarthy、Brooks、Chollet 三人思想基础上的综合凝练。符号主义系统停留在”告知”阶段——它们接收陈述句并推演,但不从中学习;LLM 处于”告知”和”感知”之间——prompt 是告知,tool-use 是感知,但推理时不积累经验;真正的智能需要”经验”维度——系统从交互中持续改变自身能力,这正是 Chollet 框架的核心诉求。Agent 技术的发展方向,就是推动系统从第一、第二阶段向第三阶段演进。
---
## 单动因谬误:智能不在 Transformer 中
### Minsky 的诊断:将复杂行为归因于单一动因的错误
Minsky 1986 年在《心智社会》中将”将复杂行为归因于单一中央动因”的错误命名为**单动因谬误**(Single-Agent Fallacy)minsky1986。
Minsky 的核心论点:智能不在任何单个 agent 中,而在 agent 的组织方式中。一个由本身无智能的小 agent 组成的机构,对外可以表现出”懂行”——但这种”懂行”不是任何单个 agent 的属性,而是组织结构本身的涌现属性。
### LLM 的智能不是单因 Transformer
当前有一种流行倾向:把 LLM 的”智能”归因于 Transformer 架构。这恰恰是 Minsky 说的单动因谬误。
LLM 表现出的”智能”是多组件多原因造成的。Transformer 架构提供了注意力机制——一种统计匹配的内部机制;训练数据提供了人类文本的统计分布——知识的来源;RLHF 对齐通过人类反馈塑造了行为模式;Harness 框架的 prompt 工程、tool 选择、RAG 构成了”机构”的组织方式;评估方式和 benchmark 设计则定义了什么叫做”好”。
把智能归因于”Transformer 架构”就像把一栋楼的”好”归因于砖头——砖头是必要的,但”好”来自建筑设计、施工质量、装修、区位等多因素的组合。
### 单动因谬误在 LLM 中的表现
### 从 Minsky 到 Chollet:两个维度的互补
Minsky 和 Chollet 从不同维度回答了”智能在哪里”的问题:
维度Minsky 1986Chollet 2019核心问题智能在哪里?智能如何度量?回答在组织方式中,不在单个 agent 中在获取新技能的效率中,不在技能本身维度结构维度动态维度对 LLM 的启示智能不在 Transformer 权重中,在多组件协作中智能不在训练数据量中,在泛化效率中
两者互补:**组织方式决定了”能获取什么技能”,获取效率决定了”能多快学会”**。一个设计良好的 multi-agent 系统(Minsky 的启示)在限定 scope 内可能比单一 LLM 有更高的 skill acquisition efficiency(Chollet 的度量)。
---
## 四层专精化:从提示词切分到结构差异
复杂工作本身就需要不同角色。定计划、分工、执行、审核、测试、上线维护——这些步骤需要不同的能力和不同的角色。要求单个 Agent/LLM 一次就能干好所有事是不切实际的。
这与 Minsky 的论点形成呼应:智能不在任何单个 agent 中,而在 agent 的组织方式中。一个软件项目不是一个人从头写到尾的——有产品经理定需求、架构师设计系统、开发者写代码、测试工程师验证质量、运维工程师保障上线。每个角色专精自己的领域,通过协作完成复杂工作。
### 当前的萌芽:同一大脑的不同面具
当前的多 Agent 实践——从 Claude Code 的 Agent Teams 到 Trae 的 Explore Agent,从 Loop Engineering 的 bash 循环到各种”角色扮演”式分工——本质上大多共享一个特征:**同一个 LLM(大脑),不同的提示词(面具),住在同一台电脑里**。
这种”同脑不同面具”的架构有其现实合理性。它解决的核心问题是上下文窗口溢出——一个 Agent 需要专注代码审查时,不应被规划阶段的上下文污染。Claude Code 的子 Agent 用独立的进程和上下文窗口实现隔离,Loop Engineering 用”repo 作为外部记忆”绕过单次对话的遗忘——”Agent 遗忘,repo 记住” loopeng。
但在 Chollet 的框架下,这一局限更清晰:**同一 LLM 的 priors 和 experience 是共享的——提示词只改变了哪些 priors 被激活,没有改变 priors 本身**。一个用”你是代码审查专家”提示词的 LLM,和一个用”你是测试工程师”提示词的同一个 LLM,拥有完全相同的训练数据和参数——它们的”专精”是表面的激活差异,不是结构性的能力差异。
这类似于 ELIZA 换脚本——脚本改变了输出模式,但底层的”智能”(skill acquisition efficiency)完全相同。**当前的”多 Agent”在多数情况下只是”多提示词”——是 ELIZA 式换脚本的企业版**。
### 真正的专精化:四个层面的结构差异
> **作者注:以下为本文凝练,而非原文论断。** 真正的专精化需要超越提示词层面的差异,进入结构和资源层面的差异。Minsky 的心智社会中,每个 agent 有不同的内部结构——See agent 和 Get agent 不是”同一个 agent 加不同提示词”,而是功能上根本不同的单元。放到 LLM 语境中,真正的专精化 Agent 应该在四个层面实现差异化:
层面提示词专精(当前)结构专精(未来方向)**LLM 模型**同一模型,不同 system prompt不同模型:小模型做路由,大模型做推理,领域微调模型做专精任务**工具集**共享同一套工具专精工具集:代码 Agent 只有编译器/调试器;文档 Agent 只有文档检索/版本控制**技能(提示词设计)**靠编排器分配角色独立的 Skill 文件:编码了该领域的操作程序、最佳实践、错误恢复策略**资源(知识库)**共享或不使用专有 RAG 知识库:代码 Agent 索引项目源码;测试 Agent 索引测试用例和 bug 历史
提示词专精的”多 Agent”就像让同一个人穿不同制服做不同工作——换衣服不换能力。结构专精的”多 Agent”才是让不同专业背景的人做不同工作——能力本身不同。Gartner 预测到 2026 年 40% 的企业应用将包含任务专精 Agent,到 2027 年三分之一将组合不同技能的 Agent gartner2025。小语言模型(SLM)的研究也表明,7B-70B 参数的领域微调模型在专精任务上”足够强大、更合适、更经济” slm2025。
### 四层专精化的工程含义
> **作者注:** 四层专精化——专项 LLM + 专项工具 + 专项技能 + 专项资源——不是理论设想,而是已经在萌芽的工程趋势。每一层的专精化都对应不同的工程挑战和收益:
**专项 LLM**:路由模型(小而快)负责分类和分发,推理模型(大而强)负责复杂决策,领域微调模型(如代码模型、医疗模型)负责专精任务。不同模型可以针对不同推理步骤选用,降低成本的同时在关键环节保持质量。
**专项工具**:代码审查 Agent 只需要编译器、linter 和测试运行器——不需要日历 API 或邮件发送能力。工具集的缩减降低了错误面,提高了可靠性。这对应 Minsky 的防循环纪律:每个 agent 的能力边界必须清晰,工具越少越容易核查”这个 agent 本身是否专精”。
**专项技能(Skill)**:将领域操作程序编码为可复用的 Skill 文件——不是”提示词”,而是结构化的操作规范,包含前置条件、执行步骤、错误恢复策略。这类似于 STRIPS 的算子三元组:每个 Skill 是一个可验证的操作单元,前置条件和效果明确。
**专项资源(RAG)**:专有知识库让 Agent 的”知识”不限于训练数据。代码 Agent 索引当前项目的源码和依赖文档;测试 Agent 索引历史 bug 和测试用例。这是 Chollet 框架中 experience 的外部化——不是靠参数记住,而是靠检索获取。Agentic RAG 将”搜索 + 摘要”升级为”推理 + 行动”,Agent 可以规划步骤、调用工具、检验结果并从新证据中学习 agenticrag。
---
## 协调工程化:从情境浸润到显式协议
如果真正的专精化 Agent 各有不同的 LLM、工具、技能和资源,它们之间如何协调?这是 Minsky 未解决的问题在工程中的再现。
### Minsky 的协调困境:情境浸润不是工程方案
Minsky 给出了八种协作构件:分层与异层、不妥协原则、交叉抑制、K 线记忆、框架与默认假设、审查器谱系、B 脑反思层、差动机目标机 minsky1986。这八种构件回答了”agent 之间如何协作”——但它们本身如何协调?
Minsky 的回答是”共处一脑的情境浸润”:agent 们因为共存于同一个心智中而自然影响彼此。但”情境浸润”是什么?它不是一个可操作的算法——它是一个比喻。**如果协调机制不能被精确形式化,那它就不是一个工程方案,而是一个修辞**。这正是 Bar-Hillel 式批评精准命中的地方:Minsky 的八种构件是组织原则的命名,而非可执行程序的规格说明。
对比 McCarthy 在 Advice Taker 中面临的 Bar-Hillel 批评——”前提选择不能自动完成”——Minsky 的问题是”协调机制不能自动实现”。两者共享同一个困境:提出了正确的直觉,但缺乏可操作的工程路径。这一困境不会因为技术进步而自动消失——它必须在组织层被显式回答。
### 从浸润到协议:工程化的四条路径
> **作者注:** 当前的工程实践正在给出显式协议而非”情境浸润”的答案。以下四条路径是对 Minsky 协调困境的工程化替代,也是从哲学直觉走向工程方案的必经之路:
1. **消息协议**:Agent 之间通过结构化消息通信,而非”共享上下文”——这是 Wooldridge & Jennings 1995 的多智能体系统定义,与 Minsky 的脑内协调根本不同 wooldridge1995
2. **状态外化**:协调状态不存于任何单个 Agent 的上下文中,而是存于共享的工作空间(文件系统、任务队列、版本控制)——Loop Engineering 的”repo 记住,Agent 遗忘”正是这一原则的体现
3. **验证回路**:独立 Agent 的结果需要被其他 Agent 验证——Claude Code 的 Dynamic Workflows 用验证回路让 Agent 互相反驳,直到答案收敛 claudecode
4. **编排层**:一个显式的编排器(而非”浸润”)负责任务分解、Agent 选择和结果汇总
这些机制是对 Minsky”情境浸润”的工程化替代。Minsky 的直觉是对的——智能在组织方式中——但**组织方式本身必须被显式设计,而非依赖隐喻**。从”情境浸润”到”消息协议”的转变,正是从哲学直觉到工程方案的必经之路。
### 从同脑不同面具到专家协作:演进路径
在四层专精化的框架下,每个专精化 Agent 在各自 scope 内可能有更高的 skill acquisition efficiency——因为 scope 限定后,priors 和 experience 可以更集中,泛化目标更明确。这比一个”万能但不精”的单一 LLM 更符合 Minsky 的组织论和 Chollet 的度量论。
---
## ELIZA 重审:Chollet 框架下的零点坐标
回到我们的起点——ELIZA。在 Chollet 的框架下重新审视这个最小智能体,可以获得一些意想不到的洞察。
### ELIZA 的 skill acquisition efficiency = 0
在 Chollet 的框架下,ELIZA 的智能 = 0。它不能学习任何新技能——脚本固定,永远只做同一件事。换一个脚本只是换了 priors,不是”获取了新技能”。
但 ELIZA 产生了强烈的智能错觉——ELIZA 效应。这说明了什么?
### ELIZA 效应与 Chollet 的”购买技能”
ELIZA 的”智能感”来自两个因素:用户投射 + 脚本编排。脚本 = priors(先验知识)。脚本越好,”购买”的对话技能越多——但系统自身的智能仍为零。
Chollet 的框架精确地解释了 ELIZA 效应:**priors 购买了技能,但系统没有获取新技能的能力**。用户感受到的”智能”是 priors 的效果,不是系统的属性。这与 Weizenbaum 本人的警告一致——ELIZA 让人感觉”被理解”,但这种感觉来自用户自己的投射,不是机器的理解。
### 从 ELIZA 到 MIT 堆箱子:priors 越来越多,但智能始终为零
Minsky 1960 年代在 MIT 的积木机器人——数百个小程序协作完成搭塔任务。每个子程序本身无智能,但组合起来表现出”智能”行为。
这与 ELIZA 的”单脚本智能”形成对照:ELIZA 是一个脚本产生的表面效果;MIT 堆箱子是多个子程序的协作涌现。在 Chollet 的框架下:MIT 堆箱子的 priors 更丰富(数百个子程序 vs 一个脚本),”购买”了更高水平的搭塔技能——但它的 skill acquisition efficiency 仍然 = 0(不能学习新的子程序)。
从 ELIZA 到 MIT 堆箱子到 STRIPS 到 MYCIN——priors 越来越丰富,”购买”的技能越来越多,但 skill acquisition efficiency 始终为零。直到 LLM 出现——LLM 可以通过训练”学习”,但它的 experience 在训练时冻结,推理时不能在线获取新技能。
### 意识的工具性意义
回到开头的基础价值观:意识只有在”自主制定工作计划需要自知、自觉、自止”时才有工具性意义。
在 Chollet 的框架下,”自知、自觉、自止”可以被理解为一种**元认知技能**——系统对自己能力的认知和监控。这不是神秘的意识问题,而是一种可度量的能力:自知是系统知道自己能做什么、不能做什么(scope awareness);自觉是系统知道自己为什么选择这样做(可解释性);自止是系统知道何时该停止(终止条件判断)。
这些能力在 Chollet 的框架下是可度量的技能,而不是哲学概念。一个能”自知”的系统在”自我评估”scope 内有更高的 skill acquisition efficiency;一个能”自止”的系统在”终止判断”scope 内有更高的效率。
---
## 终章:自知、自觉、自止的工具性意义
这是系列的最后一篇。让我们回到最初的问题,收束全系列的思考。
### 回归基础价值观:Agent 是工具
Agent 是工具。智能是工具效率——具体说,是工具适应新任务的能力。Chollet 的定义将其精确化:**智能 = 获取新技能的效率 = 工具适应新任务的能力**。
“多少人工就有多少智能”在 Chollet 的框架下可以精确化为:**priors 购买了技能,但 priors ≠ 智能**。ELIZA 的脚本购买了对话技能,但 ELIZA 不能学习——智能 = 0;STRIPS 的算子购买了规划技能,但 STRIPS 不能学习——智能 = 0;MYCIN 的规则购买了诊断技能,但 MYCIN 不能学习——智能 = 0;LLM 的训练数据购买了语言技能,LLM 可以微调但不能在线学习——智能 = 有限。
从 ELIZA 到 LLM,人工承载从显式变为隐式,从可读变为不可读——但本质结构不变:**技能来自人工(priors),智能来自获取新技能的效率(skill acquisition efficiency)**。
### Minsky 的组织论 + Chollet 的度量论
Minsky 告诉我们:智能不在单个 agent 中,在组织方式中。
Chollet 告诉我们:智能不在技能本身中,在获取新技能的效率中。
两者合起来对 Agent 设计的实用指导是:**用专精化分工协作的组织方式,在各自 scope 内追求更高的 skill acquisition efficiency**——这比”单一万能 Agent”更合理。
### 全系列回顾:从符号单体到三条反叛伏线
本系列共 13 篇文章,从 AI 概念的演变出发,经历了符号单体的确立、三条反叛伏线的涌现,最终到达 LLM 时代的独立回响与未来展望。
### 从同脑不同面具到专家协作
当前的多 Agent 实践——同一个 LLM、不同的提示词、同一台电脑——是专精化协作的萌芽,但不是终点。这一阶段解决的核心问题是上下文窗口管理和注意力切分,类似于让一个人在不同时间穿不同制服做不同工作。在 Chollet 的框架下,提示词只改变了 priors 的激活方式,没有改变 priors 本身——这与 ELIZA 换脚本在结构上同构。
更长远的方向是真正的专家 Agent 协作:**专项 LLM + 专项工具 + 专项技能 + 专项资源**。每个 Agent 在各自领域有真正不同的能力——不是提示词的激活差异,而是模型、知识、工具的结构性差异。这意味着每个 Agent 在各自 scope 内有更高的 skill acquisition efficiency——因为 priors 更集中、experience 更相关、泛化目标更明确。
### 协调机制的工程化
Minsky 的协调困境——”情境浸润不可操作”——在这一未来中不会消失,但会被工程手段逐步替代:显式消息协议替代浸润、状态外化替代共享上下文、验证回路替代审查器直觉、编排层替代自然协调。**协调机制从”自然发生”变为”显式设计”——这正是从哲学直觉到工程方案的必经之路**。
从 ELIZA 的单脚本,到 STRIPS 的算子三元组,到 MYCIN 的规则库,到 LLM 的千亿参数,再到未来的专精化 Agent 协作——人工承载的形式在变(从显式到隐式再到结构化专精),但”多少人工就有多少智能”的底层逻辑不变。变化的是:未来的专精化让”人工”不再混入一个不可读的参数黑箱,而是分散到可审计的专项资源中——每个 Agent 的 priors 可被独立审查、独立优化、独立度量。
### 自知、自觉、自止的工具性意义
回到基础价值观:Agent 是工具,意识之争只在工具性需要时才有意义。如果自主制定工作计划需要”自知、自觉、自止”,那这些能力就是值得追求的工程目标——不是哲学上的意识,而是 Chollet 框架下可度量的元认知技能。
专精化 Agent 协作的终点不是”有意识的 Agent”,而是”每个 Agent 在各自领域足够专精,通过显式协议协作完成复杂工作”——这既是 Minsky 的心智社会在工程中的落地,也是 Chollet 的度量框架在实践中的应用。
**自知,是知道自己的边界;自觉,是理解选择的理由;自止,是懂得停止的时机。** 这三者不是对”意识”的哲学追求,而是对”更好的工具”的工程要求。当 Agent 具备了这些能力,它就能更好地服务于人的愿望——而这,才是智能的全部意义。
---
## 参考文献
[**chollet2019**] Chollet, F. (2019). “On the Measure of Intelligence.” *arXiv:1911.01547*.
[**weizenbaum1966**] Weizenbaum, J. (1966). “ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine.” *CACM* 9(1): 36-45.
[**fikes1971**] Fikes, R. & Nilsson, N. (1971). “STRIPS: A New Approach to the Application of Theorem Proving to Problem Solving.” *IJCAI 1*.
[**shortliffe1976**] Shortliffe, E. (1976). *MYCIN: Computer-Based Medical Consultations*. Elsevier.
[**mccarthy1958**] McCarthy, J. (1958). “Programs with Common Sense.” In *Mechanisation of Thought Processes*, Symposium Proceedings.
[**minsky1986**] Minsky, M. (1986). *The Society of Mind*. Simon & Schuster.
[**brooks1986**] Brooks, R. A. (1986). “A Robust Layered Control System for a Mobile Robot.” *IEEE Journal of Robotics and Automation* 2(1): 14-23.
[**loopeng**] Huntley, G. (2025). “Ralph Wiggum as a Software Engineer” — Loop Engineering 的起源;参见 Osmani, A. (2026). “The Five Components of Loop Engineering.” *Pragmatic Engineer*.
[**gartner2025**] Gartner (2025). “Gartner Predicts 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026.” *Gartner Press Release*, Aug 2025.
[**slm2025**] arXiv:2506.02153 (2025). “Small Language Models are the Future of Agentic AI.”
[**wooldridge1995**] Wooldridge, M. & Jennings, N. (1995). “Intelligent Agents: Theory and Practice.” *Knowledge Engineering Review* 10(2): 115-152.
[**claudecode**] Anthropic (2026). “Introducing Claude Code Dynamic Workflows.” *Anthropic Newsroom*.
[**agenticrag**] Instinctools (2026). “Agentic RAG: From Search+Summarize to Reason+Act.”
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# 雷池 WAF 一键升级失败解决:手动离线升级注意事项
https://www.paddysun.top/archives/5086 · 2026-08-24
## 背景
雷池(SafeLine)近期版本更新到了 9.4.0(2026-08-17 发布),更新和优化了大量的检测逻辑,所以打算更新雷池。
但按照官方教程执行一键升级失败,提示”未安装 Docker Compose,是否自动安装”,迷迷糊糊选择”是”之后就显示更新失败,并且服务中断了半小时。
最终我选择了离线镜像升级方案。
本文记录了升级过程中遇到的几个典型错误及完整的排查解决过程,希望能为遇到类似问题的朋友提供参考。
## 升级环境
项目配置操作系统Ubuntu 22.04 / 24.04Docker已安装Docker Compose独立二进制 `docker-compose`(非 `docker compose` 插件)雷池安装目录`/data/safeline`
## 为何在线升级会失败?
**版本要求明确,但文档指引存在歧义。** [雷池官方手动安装文档](https://help.waf-ce.chaitin.cn/node/01973fc6-e12f-789f-a8ff-e81d383c80bc)没有明确指明 Docker Compose 的版本要求,示例命令清一色是 `docker compose up -d`(无横线,v2 插件形式)。但我就要用 `docker-compose`(带横线,v1 独立二进制)—— 你又没说不可以 QaQ。
`docker compose` 与 `docker-compose` 是两种不同的工具:
- `docker compose`:随新版 Docker 一起安装的插件,官方主推的现代版本。
- `docker-compose`:需要单独下载的独立二进制文件,但我爱用咋地 QaQ。
**脚本检测机制存在 Bug(缺陷好吧只是缺陷)。** [雷池的在线升级](https://help.waf-ce.chaitin.cn/node/0197400a-369e-78dd-93a7-f087d9a962f7)脚本(`[manager.py](https://waf-ce.chaitin.cn/release/latest/manager.py)`)在检测 Compose 版本时,用了一条只匹配 v2 输出格式的正则,导致 v1 用户被误判为”未安装 Compose”,进而触发”是否自动安装 Docker”的询问。迷迷糊糊选了”是”之后,脚本执行 `get-docker.sh` 并在末尾 `systemctl restart docker` 硬重启 Docker daemon,所有运行中的容器瞬间被杀 —— 服务中断。
**根因深挖:manager.py 的正则缺陷(选读)**
`bash -c "$(curl -fsSLk [https://waf-ce.chaitin.cn/release/latest/manager.sh](https://waf-ce.chaitin.cn/release/latest/manager.sh))"` 中真正的升级逻辑代码 `[manager.py](https://waf-ce.chaitin.cn/release/latest/manager.py)` 的 `precheck_docker_compose()` 函数用以下正则提取 Compose 版本号:
`t = re.findall(r'^Docker Compose version v?(\d+)\.', version_output)`
这条正则只匹配 v2 的输出格式 `Docker Compose version v2.x.x`,完全不匹配 v1 的输出格式 `docker-compose version 1.29.2`(小写、带横线、无 `v` 前缀)。
脚本逻辑是:如果正则匹配结果为空,就判定”Compose 未安装”,然后弹出”是否自动安装 Docker”的询问。用户一旦选”是”,`install_docker()` 就会执行 `get-docker.sh`,并在末尾通过 `start_docker()` 调用:
`systemctl enable docker && systemctl daemon-reload && systemctl restart docker`
`systemctl restart docker` 会硬重启 Docker daemon,所有运行中的容器被强制停止。如果 `get-docker.sh` 安装过程中出现网络超时或依赖冲突,Docker 服务可能起不来,所有容器全部下线 —— 这就是服务中断的真正原因。
**简而言之**:不是你的 docker-compose 有问题,是脚本的正则不认你的 docker-compose。
问题已经在文章发布前 [提交雷池官方](https://rivers.chaitin.cn/discussion/da596tr1s5rlia448q90)
## 官方离线升级步骤
根据雷池官方文档,离线升级需要执行以下操作:
```
# 1. 进入安装目录
cd /data/safeline
# 2. 备份旧编排文件,下载新版
mv compose.yaml compose.yaml.old
wget "https://waf-ce.chaitin.cn/release/latest/compose.yaml" --no-check-certificate -O compose.yaml
# 3. 更新/补全 .env 环境变量
sed -i "s/IMAGE_TAG=.*/IMAGE_TAG=latest/g" ".env"
grep "SAFELINE_DIR" ".env" > /dev/null || echo "SAFELINE_DIR=$(pwd)" >> ".env"
grep "IMAGE_TAG" ".env" > /dev/null || echo "IMAGE_TAG=latest" >> ".env"
grep "MGT_PORT" ".env" > /dev/null || echo "MGT_PORT=9443" >> ".env"
grep "POSTGRES_PASSWORD" ".env" > /dev/null || echo "POSTGRES_PASSWORD=$(LC_ALL=C tr -dc A-Za-z0-9 > ".env"
grep "SUBNET_PREFIX" ".env" > /dev/null || echo "SUBNET_PREFIX=172.22.222" >> ".env"
grep "IMAGE_PREFIX" ".env" >/dev/null || echo "IMAGE_PREFIX=chaitin" >>".env"
grep "ARCH_SUFFIX" ".env" >/dev/null || echo "ARCH_SUFFIX=" >>".env"
grep "RELEASE" ".env" >/dev/null || echo "RELEASE=" >>".env"
grep "MGT_PROXY" ".env" >/dev/null || echo "MGT_PROXY=0" >>".env"
# 4. 加载离线镜像
docker load -i image.tar.gz
# 5. 停止旧容器并启动新容器
docker compose down --remove-orphans
docker compose up -d
```
## 遇到的错误及解决方案
错误现象根因解决方案`docker compose` 命令不存在系统装的是 v1 独立二进制,v2 插件未安装统一改用 `docker-compose`(带横线)网络删除失败(active endpoints)其他容器(如 WordPress)连接到 safeline-ce 网络忽略或手动断开`invalid reference format`compose.yaml 中 postgres 镜像引用语法错误手动修正 image 字段镜像前缀不匹配.env 中 `IMAGE_PREFIX` 指向华为云,本地标签是 `chaitin`改为 `IMAGE_PREFIX=chaitin`
### 错误一:docker compose 命令不存在
**现象:** 执行 `docker compose down --remove-orphans` 时报错:
```
docker: 'compose' is not a docker command.
See 'docker --help'
```
**定位过程:** 检查环境中的 Docker Compose 版本:
```
which docker-compose
# 输出:/usr/bin/docker-compose
docker-compose --version
# 输出:docker-compose version 1.29.2
```
**原因:** 系统中安装的是独立二进制 `docker-compose`(带横线,v1),而非新版 `docker compose` 插件(无横线、子命令形式,v2)。v1 的 1.29.2 实际是支持 `--remove-orphans` 这个 flag 的,真正不存在的不是参数,而是 `docker compose`(无横线)这个子命令本身。
**解决方案:** 所有命令统一使用 `docker-compose`(带横线):
```
docker-compose down --remove-orphans
docker-compose up -d
```
### 错误二:docker-compose down 网络删除失败
**现象:**
```
Removing network safeline-ce
ERROR: error while removing network: network safeline-ce has active endpoints (name:"wordpress" id:"a5710bbfdfb6")
```
**原因:** 服务器上存在其他容器(如 WordPress)连接到雷池创建的 `safeline-ce` 网络,导致网络无法删除。
**影响:** 此错误不影响升级。网络仍然存在,新启动的容器会直接复用该网络。
**解决方案:** 忽略该错误,继续执行 `docker-compose up -d`。若希望彻底清理,可先断开其他容器的网络连接:
```
docker network disconnect safeline-ce wordpress
docker network rm safeline-ce
```
### 错误三:invalid reference format(核心问题)
**现象:** 执行 `docker-compose up -d` 反复报错:
```
ERROR: invalid reference format
```
**定位过程:** 使用 `docker-compose config` 命令检查 Compose 解析后的实际配置:
```
docker-compose config
```
在输出中发现 postgres 服务的 image 字段异常:
```
postgres:
image: $${IMAGE_PREFIX/safeline-postgres:15.18}
```
这是一个语法错误 —— 多了一个 `$`,且变量引用格式不正确(`}` 位置错位,把斜杠后面的内容也包进了变量名里)。其他服务的 image 字段均正常(如 `chaitin/safeline-chaos:latest`),唯独 postgres 服务异常。
**原因:** 新下载的 compose.yaml 中 postgres 的 image 行存在拼写错误,将正确的变量格式 `${IMAGE_PREFIX}/safeline-postgres:${IMAGE_TAG}` 误写为 `$${IMAGE_PREFIX/safeline-postgres:15.18}`。在 Compose 中,`$$` 是对 `$` 的转义,会让变量替换整段失效,最终拼出来的镜像名既不是合法引用,也不是本地存在的标签,于是触发 `invalid reference format`。
**解决方案:** 手动编辑 compose.yaml,修正 postgres 服务的镜像引用。
```
vim compose.yaml
```
找到 `postgres:` 服务部分,将:
```
image: $${IMAGE_PREFIX/safeline-postgres:15.18}
```
改为(使用本地已加载的镜像标签):
```
image: chaitin/safeline-postgres:15.2
```
保存退出后,再次验证:
```
docker-compose config | grep -A 2 postgres
```
确认输出中 `image: chaitin/safeline-postgres:15.2`。
### 错误四:IMAGE_PREFIX 与本地镜像标签不匹配
**现象:** 修改 compose.yaml 后,`docker-compose up -d` 仍然报 `invalid reference format`。
**定位过程:** 查看本地已加载的镜像标签:
```
docker images | grep safeline
```
发现镜像同时带有两套标签:
```
chaitin/safeline-*:latest
swr.cn-east-3.myhuaweicloud.com/chaitin-safeline/safeline-*:latest
```
而 `.env` 中初始配置为:
```
IMAGE_PREFIX=swr.cn-east-3.myhuaweicloud.com/chaitin-safeline
```
**原因:** compose.yaml 中其他服务使用 `${IMAGE_PREFIX}/safeline-*:${IMAGE_TAG}` 引用镜像。当 `IMAGE_PREFIX` 指向华为云地址时,Compose 尝试使用华为云标签的镜像。虽然本地也有这些标签,但若标签不完全匹配,可能导致解析异常。
**解决方案:** 将 `IMAGE_PREFIX` 改为 `chaitin`,使用本地已有的简洁标签:
```
sed -i 's/^IMAGE_PREFIX=.*/IMAGE_PREFIX=chaitin/' .env
```
## 最终成功启动
完成以上修复后:
```
docker-compose up -d
```
输出:
```
Creating safeline-pg ... done
Creating safeline-chaos ... done
Creating safeline-detector ... done
Creating safeline-fvm ... done
Creating safeline-tengine ... done
Creating safeline-mgt ... done
Creating safeline-luigi ... done
```
查看容器状态:
```
docker-compose ps
# 所有服务均为 Up 状态
```
登录管理页面,版本已更新,配置、规则、日志全部保留。
## 经验总结
1. **升级前务必备份/制作服务器镜像:** 任何涉及底层组件(如 Docker)更新或使用官方脚本的操作都存在破坏性风险。在执行升级前,**务必在云服务商控制台为服务器制作系统盘快照或镜像**。这样即使升级彻底失败导致环境崩溃(例如本次脚本硬重启 Docker 导致服务中断),也能通过回滚镜像在几分钟内恢复业务,避免长时间的手忙脚乱。
2. **确认 Docker Compose 命令格式:** 使用 `which docker-compose` 确认系统中是 `docker-compose`(v1)还是 `docker compose`(v2),避免命令混淆。两者语法不同,不要混用。
3. **善用 `docker-compose config` 预检查:** 这是定位 Compose 配置问题的利器,能提前发现变量解析错误和语法问题。
4. **检查 compose.yaml 中的语法错误:** 官方提供的编排文件也可能存在拼写问题,尤其是 image 字段的变量引用格式。对 `${VAR}` 与 `$$`(转义)的用法要格外敏感。
5. **确保 .env 中的镜像前缀与本地标签一致:** `IMAGE_PREFIX` 应匹配 `docker load` 加载的镜像标签前缀。离线升级时,建议统一用 `chaitin` 简短前缀。
6. **网络残留错误不影响升级:** `docker-compose down` 网络删除失败时,只要容器已停止,新容器会复用现有网络,不影响启动。
7. **手动编辑比 sed 更可靠:** 在复杂替换场景下,直接使用 vim 修改文件可以避免转义错误。
8. **别盲目相信安装脚本的”自动安装”选项:** 安装脚本若提示要自动安装 Docker,先停下来 —— 它很可能会重启 Docker daemon,把你正在运行的服务全杀掉。先在宿主机上手动把 Docker 和 Compose 准备好,再运行业务安装器。
## 参考资料
- 雷池官方文档 – 手动安装教程:[https://help.waf-ce.chaitin.cn/node/01973fc6-e12f-789f-a8ff-e81d383c80bc](https://help.waf-ce.chaitin.cn/node/01973fc6-e12f-789f-a8ff-e81d383c80bc)
- 雷池官方文档 – 版本升级方案:[https://help.waf-ce.chaitin.cn/node/0197400a-369e-78dd-93a7-f087d9a962f7](https://help.waf-ce.chaitin.cn/node/0197400a-369e-78dd-93a7-f087d9a962f7)
====
# [Agent 考古] 多头注意力共享目标、参数即隐式模型、CoT 是概率采样——LLM 被三条“反叛伏线”夹击
https://www.paddysun.top/archives/5039 · 2026-08-24
**系列名称**:[\[Agent 考古\] AI 组织形式的七次重分配](https://www.paddysun.top/?p=4915) · [\[Agent 考古\] 符号单体时代:三条反叛伏线](https://www.paddysun.top/archives/4998)
**篇号:**第 12 篇 / 共 13 篇 主题分类:历史记述 **前置阅读:**[Brooks 无表征智能 1990-91](https://www.paddysun.top/archives/5030) · [Minsky 心智社会 1986](https://www.paddysun.top/archives/4997) 阅读时间:约 12 分钟
---
## 1958 年的一个批评,为什么 60 年后还在命中 AI 的核心困境
1958 年,在伦敦国家物理实验室举办的”思维过程机械化”研讨会上,以色列逻辑学家 Yehoshua Bar-Hillel 当着 McCarthy 的面,对 Advice Taker 方案提出了两条尖锐批评。这不是一次普通的学术争论——Bar-Hillel 指出的问题,在随后 60 多年里反复以不同面貌出现,从 STRIPS 的框架问题到 MYCIN 的规则爆炸,从 Brooks 的取消世界模型到今天 LLM 的幻觉难题。
同一个核心困难,穿越了符号主义、行为主义、连接主义三个时代。它不是某个具体技术的缺陷,而是智能在开放世界中的本质困难——**如何从无限的事实中选择相关的子集**。这就是 Bar-Hillel 批评的持久生命力所在。
当我们审视今天的大语言模型时,一个惊人的事实浮现出来:三条反叛伏线(Minsky 心智社会、Brooks subsumption、Brooks 无表征)各自从不同维度挑战了符号 AI 范式,但它们揭示的问题结构——协调、框架、表征——在 LLM 中以统计形式独立重现。LLM 不是三条伏线的延续,而是三条伏线揭示的结构困难在统计学习时代的独立回响。
本文将以 Bar-Hillel 1958 年的原始批评为锚点,逐一检视三条反叛伏线各自遭遇的 Bar-Hillel 式追问,展示这些追问如何在当代 LLM 中获得新的精确化表达,并通过 Python 复现实验量化这些困难的当代形态。
---
## 原始批评:前提选择比演绎难 10^10 个数量级
Bar-Hillel 的批评有两层。第一层针对自然语言的模糊性:如果 `at` 表示”在……的紧邻空间附近”,则传递性不成立——否则一切都在一切的紧邻附近。自然语言谓词的语义边界是不精确的,同一句话在不同上下文中可以匹配不同的形式前提。这在今天对应 LLM 的核心特征:自然语言的模糊性通过统计分布隐式处理,而非形式系统的精确定义。
第二层批评更为根本,也是本文的核心锚点:
> “我不认为可能存在这样一个程序——给定任何问题,它能将宇宙中所有事实分为相关的和不相关的。开发这样一个程序,在我看来,比 Newell-Simon 的命题演算启发式演绎问题**要困难 10^10 个数量级**。”
>
> —— Yehoshua Bar-Hillel, 1958, “The Present Status of Automatic Translation of Languages”bar-hillel1958
Bar-Hillel 的核心论断是:**前提选择比演绎本身困难得多**。演绎是语法操作,前提选择是语义判断。你可以用规则引擎做演绎,但你无法用规则引擎自动决定哪些规则适用于当前问题——后者需要理解语义,而理解语义本身就是智能的核心难题。
McCarthy 的回应承认了这一困难,但坚持”智能不在演绎引擎中,而在选择前提的程序里”。他把前提选择从演绎引擎中分离出来,但并没有解决”如何自动选择前提”的问题——它只是把问题推迟了。
这个推迟持续了 60 多年。从 STRIPS 的框架问题(算子执行后哪些事实改变)到 MYCIN 的规则爆炸(600 条规则中哪些与当前病例相关),从 Brooks 的取消世界模型(不维护模型即无前提可选)到今天 LLM 的注意力机制(用统计方式近似完成前提选择),AI 的每一代技术都在以不同方式回应 Bar-Hillel 1958 年提出的同一个问题。
---
## 心智社会的协调追问——成百上千个 agent 靠什么协作
### 伏线主张
Minsky 1986 年的心智社会理论主张:智能源于大量本身无智能的小 agent 的冲突与协商,而非单一中央心智。不同的 agent 有不同的目标,它们通过”共处一脑的情境浸润”自然影响彼此。防循环纪律、K 线记忆、审查器等构件构成了心智社会的组织原则。
### Bar-Hillel 式追问
Bar-Hillel 式批评追问的是:**“成百上千个小 agent”的协调靠什么?** Minsky 给出的答案是”情境浸润”——agent 之间通过共享上下文自然影响彼此。但”情境浸润”是什么?Minsky 没有给出可操作的协调算法。防循环纪律、K 线记忆、审查器是组织原则的命名,而非可执行程序的规格说明。
这与前提选择问题同构:前提选择需要从所有事实中选出相关的,agent 协调需要从所有 agent 中选出当前应激活的。两者都是”选择问题”——在无限可能性中找到当前相关的子集。
### 对 LLM 的适用性
LLM 的多头注意力是否面临同样的协调问题?答案是肯定的,但形式已经从”结构协调”变为”统计协调”。
多头注意力的 softmax 归一化是协调的统计近似——每个注意力头独立计算,通过 softmax 的竞争机制实现”协商”。但 softmax 归一化是全局的(在整个序列上做概率分布),Minsky 的协调是局部的(特定 agent 之间)。全局竞争与局部协商,这是两种不同的协调范式。
更关键的差异在于:Minsky 的审查器(Censor/Suppressor)在 LLM 中没有直接对应物。注意力头之间没有显式的抑制机制,一个头的输出不会被另一个头主动”否决”。当一个注意力头的输出未被有效约束时,错误信息可能进入最终输出——这是否是”幻觉”的来源之一?
---
## Subsumption 的边界追问——简单水平有效,复杂水平呢
### 伏线主张
Brooks 1986 年的 subsumption 架构以工程实证证明:感知-行动耦合可在无中央模型、无规划器的情况下实现鲁棒控制。行为层按优先级仲裁,抑制/禁止机制实现层间交互。优雅降级是其标志性工程特性——高层失效时低层照常运转。
### Bar-Hillel 式追问
Bar-Hillel 式批评追问的是:**“非常简单的智能水平上有效”——那复杂水平呢?** subsumption 的优先级是接线固定的——无法运行时调整。当一个行为层的优先级不适应新环境时,系统无法自适应地改变接线。这是”编译时确定”与”运行时需要”之间的根本矛盾。
这同样是前提选择问题的变体。在 subsumption 中,”选择哪个行为层输出”对应于”选择哪些前提用于演绎”。subsumption 的选择是编译时固定的(优先级接线),而 Bar-Hillel 指出的困难是运行时的动态选择——你无法预先知道哪些前提/行为在所有情况下都是正确的选择。
### 对 LLM 的适用性
LLM 的 tool-use 是否面临同样的”固定优先级”问题?答案是:LLM 用统计方式回避了这个问题,但回避不等于解决。
Harness 的 tool 选择(哪个 tool 先调用)是”运行时仲裁”——LLM 根据上下文动态决定调用哪个工具。但 tool 选择靠 LLM 的统计判断,不是 Brooks 的固定接线。这是一种”回避”而非”解决”——LLM 没有回答”如何可靠地选择工具”,而是用统计模型的概率判断替代了确定性的优先级仲裁。
回避的代价是:tool 选择的可靠性依赖 LLM 的统计能力,可能选错工具。subsumption 的优雅降级(高层失效时低层照常运转)在 LLM 中也没有直接对应物——LLM 的”降级”是生成质量下降,而非功能层次退化。选错工具后,系统不会退回到更基础的行为层,而是可能生成完全错误的结果。
---
## 无表征的划界追问——无表征的边界由谁划定
### 伏线主张
Brooks 1990-91 系列论文提出”无表征智能”——拒绝传统 AI 的显式世界模型。”世界自身即是它最好的模型”,感知直接耦合行动,不需要中间的表征环节。
### Bar-Hillel 式追问
Bar-Hillel 式批评追问的是:**“无表征”的边界由谁划定?** Brooks 本人在 IJCAI-91 §6.3 官方划定了边界:
> “对早期论文倡导绝对无表征的批评是无效的。我在文中说清了:我拒绝的是传统 AI 的表征方案……可以存在作为世界部分模型的表征。”
>
> —— Rodney Brooks, 1991, “Intelligence Without Reason”
这意味着”无表征”实际上”有部分表征”——标题口号与实际立场之间存在张力。Brooks 允许的”部分世界模型”包括 Toto 的分布式地图等,只是拒绝了传统 AI 的显式/可操纵/符号表征方案。
边界划定本身就是一个前提选择问题:哪些信息可以”世界自身就是模型”(不需要表征),哪些信息必须内化为系统内部的模型(需要表征)?这条边界的划定,需要语义判断——而 Bar-Hillel 说语义判断是 10^10 量级的困难。
### 对 LLM 的适用性
LLM 的参数是”部分世界模型”吗?这个问题的答案揭示了 LLM 与 Brooks 立场的镜像关系。
LLM 没有显式的世界模型(谓词集/状态空间),但有隐式的参数化模型。这与 Brooks 的立场形成镜像:Brooks 拒绝显式表征但允许部分世界模型,LLM 天然地只有”部分世界模型”(参数)而无显式表征。
但两者的”部分世界模型”来源不同:Brooks 的”部分世界模型”是机器人通过感知主动建构的(如 Toto 的分布式地图),LLM 的”部分世界模型”是训练数据被动压缩的。前者是”具身建构”,后者是”统计内化”。
更重要的是,LLM 不能直接感知世界——它只有文本输入。所以 LLM 不得不维护参数化的”部分世界模型”,并承担由此带来的代价。当参数化模型不完整或不准确时,LLM 会生成与事实不符的内容——这通常被称为”幻觉”。但从 Brooks 的框架来看,这不是工程缺陷,而是”无直接感知 + 有隐式模型”的结构性后果。
---
## LLM 是三条伏线的统计版折中
当我们把三条伏线的 Bar-Hillel 式批评放在一起审视时,一个统一的图景浮现出来。LLM 既不是纯粹的心智社会,也不是纯粹的反应式系统,更不是纯粹的无表征系统——它同时处在三个维度的中间地带。
> **核心论断:LLM 是三条伏线的”统计版折中”。**
>
> 在心智社会维度,LLM 的多头注意力是”统计社会”——多个独立计算单元通过 softmax 竞争协作,但所有单元共享同一组参数和同一损失函数,服务于同一目标(预测下一个 token)。Minsky 的”多样性涌现”退化为”统计竞争”。
>
> 在无表征维度,LLM 的参数是”隐式世界模型”——没有显式的谓词集或状态空间,但训练数据的统计规律被压缩进参数中。Brooks 的”世界即最好模型”退化为”参数即部分模型”,幻觉是模型不全的结构性代价。
>
> 在反应式维度,LLM 的 token 生成是”统计规划”——每一步都是感知-行动偶对(给定上下文生成下一个 token),但 CoT/ReAct 等范式让 LLM 展现出显式规划能力。Brooks 的”无规划”退化为”概率生成近似确定性规划”。
伏线原始立场LLM 的折中折中的代价Minsky 心智社会多 agent 有不同目标多头注意力共享目标“社会”退化为”竞争”Brooks 无表征世界即最好模型参数作为隐式模型幻觉 = 隐式模型的误差Brooks 无规划行为层按优先级仲裁CoT 作为统计规划规划 = 概率采样 ≠ 确定性搜索
三重困境不是三个独立的问题,而是同一个核心困难在三个维度的不同表现。这个核心困难就是 Bar-Hillel 1958 年指出的前提选择问题——在开放世界中,如何从无限的可能性中选择相关的子集。
---
## 前提选择模糊性的代码复现——纯语法操作确实不充分
Bar-Hillel 的核心论断是:前提选择需要语义判断,不能靠纯语法操作自动完成。我们可以用一个极简的歧义词实验来验证这一点。
以 “bank” 这个经典歧义词为例。它有三种常见含义:河岸(river_bank)、银行(financial_institution)、数据库(database)。当我们说 “The bank is closed today” 时,哪些前提是相关的?
```
# 摘自 premise_selection.py — 歧义词的多义前提
class Premise:
"""一条形式前提。"""
predicate: str
args: Tuple[str, ...]
source_word: str = "" # 来源词(如 "bank")
interpretation: str = "" # 语义解释(如 "river_bank")
semantic_valid: bool = True
# 演示知识库:bank 的三种含义 × 多种谓词
def make_demo_kb() -> List[Premise]:
return [
Premise("closed", ("bank_1",), "bank", "river_bank", semantic_valid=False),
Premise("closed", ("bank_2",), "bank", "financial_institution", semantic_valid=True),
Premise("closed", ("bank_3",), "bank", "database", semantic_valid=True),
Premise("open", ("bank_1",), "bank", "river_bank", semantic_valid=True),
Premise("open", ("bank_2",), "bank", "financial_institution", semantic_valid=True),
Premise("near", ("bank_1", "river"), "bank", "river_bank", semantic_valid=True),
Premise("service", ("bank_2", "financial"), "bank", "financial_institution", semantic_valid=True),
Premise("connection", ("bank_3", "mysql"), "bank", "database", semantic_valid=True),
]
```
三种选择策略的对比最能说明问题:
```
# 摘自 premise_selection.py — 三种前提选择策略
class PremiseSelector:
"""三种选择策略:语法、语义、统计。"""
def select_syntax(self, statement, kb):
"""纯语法匹配——只看词形。"""
results = []
for p in kb:
if statement.ambiguous_word.lower() in p.source_word.lower():
results.append(p)
self.syntax_matches += 1
return results
def select_semantic(self, statement, kb):
"""语义启发式——用上下文线索。"""
results = []
for p in kb:
if p.source_word != statement.ambiguous_word:
continue
for clue in statement.context_clues:
if clue.lower() in p.interpretation.lower():
results.append(p)
self.semantic_matches += 1
break
return results
def select_statistical(self, statement, kb):
"""统计近似——用词频共现模拟注意力权重。"""
results = []
for p in kb:
if p.source_word != statement.ambiguous_word:
continue
score = 0.0
for clue in statement.context_clues:
if clue.lower() in p.interpretation.lower():
score += 1.0
for meaning in statement.possible_meanings:
if meaning == p.interpretation:
score += 0.5
score = score / max(1, len(statement.context_clues) + len(statement.possible_meanings))
if score > 0:
results.append((p, score))
self.statistical_matches += 1
results.sort(key=lambda x: x[1], reverse=True)
return results
```
实验结果清晰地验证了 Bar-Hillel 的判断:
选择策略匹配总数语法匹配24语义匹配3统计匹配24
语法匹配返回 24 条结果,语义匹配仅 3 条。这说明纯语法操作确实不充分——它会把所有含 “bank” 的前提都选进来,无论语义是否相关。Bar-Hillel 的批评成立:前提选择需要语义判断,不能靠纯语法操作自动完成。
统计匹配同样返回 24 条——这是因为简化模型中统计打分的阈值为 0,所有包含源词的记录都获得了非零分数。这恰恰说明了统计方法的微妙性:阈值的选择本身就是一个难题——设得太高会漏掉相关信息,设得太低会引入噪音。
---
## 注意力作为前提选择的统计近似——精确率 0.50 的启示
Bar-Hillel 说前提选择不可能自动完成。LLM 用注意力机制给出了一个统计式的回应:QKV 计算——给定当前 token 的 Query,在上下文中找到最相关的 Key,加权聚合 Value。这本质上是”在给定问题的情况下,从所有事实中选择相关事实”的统计近似。
但”近似完成”不等于”完成”。近似的误差有多大?我们可以用一个简化的注意力模型来量化。
```
# 摘自 attention_as_selection.py — 注意力选择的核心逻辑
class AttentionSelector:
"""注意力机制——前提选择的统计近似。
QKV 模型:
Query = 当前问题的向量表示
Key = 每条知识的向量表示
Value = 每条知识的内容
注意力权重 = softmax(Q · K / sqrt(d))
这是 Bar-Hillel 说的"不可能自动完成"的事情的统计近似。
"""
def attention_weights(self, query, keys):
"""计算注意力权重——softmax(Q · K / sqrt(d))。"""
scores = []
for key in keys:
score = dot_product(query, key) / math.sqrt(self.dim)
scores.append(score)
max_score = max(scores)
exp_scores = [math.exp(s - max_score) for s in scores]
total = sum(exp_scores)
return [e / total for e in exp_scores] if total > 0 else [0.0] * len(scores)
def select(self, query, kb, threshold=0.1):
"""用注意力权重选择相关知识——统计近似。"""
keys = [item.vector for item in kb]
weights = self.attention_weights(query, keys)
results = []
for item, weight in zip(kb, weights):
if weight >= threshold:
results.append((item, weight))
results.sort(key=lambda x: x[1], reverse=True)
return results
```
我们将”注意力选择”与”显式前提选择”(以人工标注相关性为基准)进行对比:
```
# 摘自 attention_as_selection.py — 近似误差计算
def compute_approximation_error(attention_results, explicit_results):
"""计算注意力选择与显式选择之间的"近似误差"。"""
attention_items = {id(r[0]) for r in attention_results}
explicit_items = {id(r[0]) for r in explicit_results}
true_positives = len(attention_items & explicit_items)
false_positives = len(attention_items - explicit_items)
false_negatives = len(explicit_items - attention_items)
precision = true_positives / max(1, true_positives + false_positives)
recall = true_positives / max(1, true_positives + false_negatives)
f1 = 2 * precision * recall / max(0.001, precision + recall)
return {
"precision": precision,
"recall": recall,
"f1": f1,
"hallucination_proxy": false_positives, # 误选 = 幻觉代理
"omission_proxy": false_negatives, # 漏选 = 遗漏代理
}
```
实验结果如下(阈值 = 0.05):
查询注意力最高权重精确率召回率F1误选数漏选数Q1 “银行今天营业吗?”0.1460.501.000.6740Q2 “河岸的生态情况”0.1490.501.000.6740Q3 “数据库状态如何?”0.1680.501.000.6740
注意力选择精确率 0.50、召回率 1.00——召回率满分但精确率仅一半,3 条查询均误选 4 条不相关记录。注意力机制确实是”统计近似”而非精确选择。
需要注意的是,`human_labeled_relevance` 为人工标注,非客观真值;此处”误选”指注意力选出了人工标注为不相关的记录。另外,0.05 的阈值设置较低,导致返回了全部 8 条 KB 记录——这不是注意力机制的根本缺陷,而是阈值参数的选择问题。但阈值选择本身就是 Bar-Hillel 式的难题:你如何知道”正确”的阈值是多少?
---
## LLM 状态管理与框架问题——信息丢失而非幻觉
框架问题是前提选择问题在行动规划中的变体:算子执行后,世界状态中哪些事实改变、哪些保持不变?STRIPS 用框架公理显式说明”什么没变”,但框架公理的数量随谓词数爆炸。Brooks 的回应是取消世界模型——不维护状态即无框架问题。
LLM 的回应是”不维护精确状态”——用 context window 作为退化版的世界模型。这个”模型”有长度上限、无主动更新、无一致性检查。我们用三种状态管理方式的对比实验来量化差异:
```
# 摘自 frame_problem_llm.py — 三种状态管理方式
class STRIPSManager:
"""STRIPS 式——显式更新谓词集。精确但框架公理爆炸。"""
def apply(self, action, add_list, del_list):
new_state = self.state.copy()
for pred in del_list:
new_state.remove(pred)
for pred in add_list:
new_state.add(pred)
# 框架公理检查:未变的谓词有多少?
unchanged = self.state.predicates - set(add_list) - set(del_list)
self.frame_axiom_checks += len(unchanged)
self.state = new_state
class BrooksManager:
"""Brooks 式——不维护世界模型。简单但能力有限。"""
def sense(self, pred):
self.sense_count += 1
if self.world:
return pred in self.world.current_predicates
return False
class LLMManager:
"""LLM 式——context window 的退化版世界模型。"""
def __init__(self, window_size=5):
self.window_size = window_size
self.context = [] # 只保留最近 N 条信息
self.hallucination_count = 0
self.unknown_count = 0
self.eviction_count = 0 # 信息驱逐次数
def apply(self, action, add_list, del_list):
changes = f"+{','.join(add_list)} -{','.join(del_list)}"
self.context.append((action, changes))
if len(self.context) > self.window_size:
evicted = self.context.pop(0)
self.eviction_count += 1
def query(self, pred):
"""查询谓词。返回 True/False 表示在窗口中找到;None 表示信息已丢失。"""
for action, changes in reversed(self.context):
if f"+{pred}" in changes:
return True
if f"-{pred}" in changes:
return False
self.unknown_count += 1
return None
```
实验模拟了一个 8 步的多步任务(移动、开关冰箱、拿牛奶、喝牛奶等),上下文窗口大小设为 3 条。结果如下:
方式正确幻觉未知驱逐其他STRIPS7/7 (100%)000模型更新 8 次,框架公理 15 次Brooks7/7 (100%)000感知 7 次LLM4/7 (57%)035上下文窗口 3 条
**关键发现:LLM 的幻觉为 0,未知为 3。** 3 个”未知”均为信息被驱逐(超出上下文窗口),而非编造错误信息。这修正了一个常见的误解——LLM 的主要问题可能不是”主动编造”(幻觉),而是”信息丢失”(窗口限制)。当需要的信息不在窗口中时,LLM 面临与 Brooks 式系统相同的困境:无法获取历史信息。
但 LLM 与 Brooks 的区别在于:Brooks 式系统可以随时感知世界来获取信息(因为世界自身就是模型),而 LLM 没有感知能力——它只有窗口中的文本。当信息被驱逐出窗口后,LLM 无法通过”再感知”来找回,只能依靠参数中的统计知识来”猜测”。这才是幻觉的真正来源——不是注意力的近似误差,而是信息丢失后的统计填补。
---
## Bar-Hillel 批评的传播路径——从 1958 到当代 LLM
Bar-Hillel 1958 年的批评不是一次性的事件,而是一条贯穿 AI 历史的暗线。它在不同时期以不同面貌出现,每次都击中了当时主流技术的核心困境。
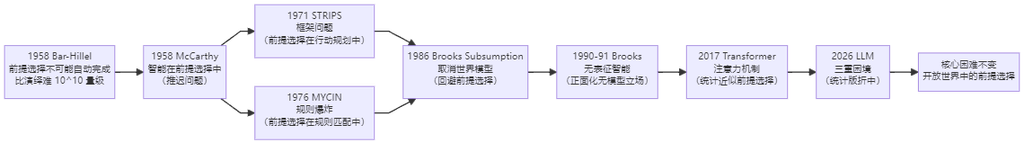
这条传播路径的惊人之处在于:每一代技术都以为自己解决了前辈的问题,但实际上只是把同一个困难换了一种形式。从”前提选择”到”框架问题”到”规则爆炸”到”取消世界模型”到”注意力机制”——问题的名字在变,问题的结构不变。
---
## 三条伏线 × Bar-Hillel 批评 × LLM 适用性——三维对照
为了更清晰地展示三者之间的关系,我们用一个三维对照表来总结:
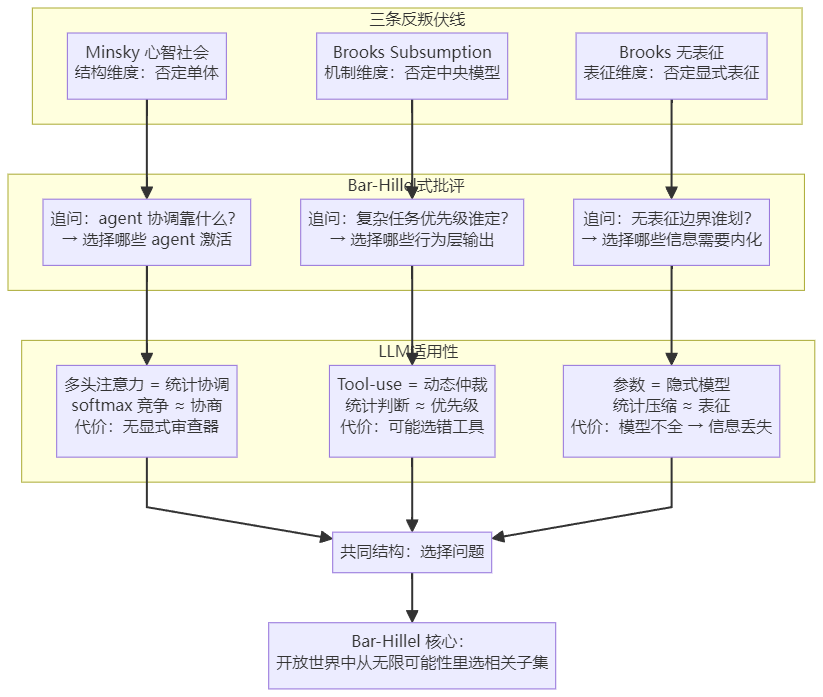
三条伏线从三个不同的维度挑战符号单体,但 Bar-Hillel 式追问揭示了它们共享同一个深层结构——选择问题。LLM 在三个维度上都给出了统计式的回应,但选择问题的本质困难没有被解决,只是被”近似”了。
---
## Bar-Hillel 批评的当代精确化——四个维度的回响
Bar-Hillel 1958 年的批评在当代 LLM 中获得了四个维度的精确化表达。每一个维度都是原始批评在新的技术语境下的变奏。
**前提选择 → 注意力机制的统计近似。** Bar-Hillel 说前提选择不可能自动完成,LLM 用注意力机制”近似完成”了。但精确率 0.50 的实验数据告诉我们:近似不等于完成。当注意力机制选出了”看起来相关但实际不相关”的前提时,生成的内容就可能偏离事实——这是近似误差的直接体现。
**框架问题 → LLM 不维护状态的”不解决之解决”。** STRIPS 的框架问题(算子执行后哪些事实改变/不变)→ Brooks 的”取消世界模型”(不维护世界模型即无框架问题)→ LLM 的”不维护状态”(每个请求独立,无持久状态)。但 LLM 的 context window 是”退化版世界模型”——有长度上限、无主动更新、无一致性检查。我们的实验显示:LLM 的真实问题是信息丢失(3 个未知因窗口驱逐),而非主动幻觉。
**智能错觉 → ELIZA 效应的升级版。** ELIZA 1966 用正则模板让用户投射”理解”,LLM 2026 用统计匹配让用户投射”理解”。但 LLM 有参数化的信念(训练数据的统计知识),ELIZA 没有。所以 LLM 的”智能错觉”更强——因为它有真实的基础。Bender et al. 2021 的”随机鹦鹉”论点bender2021 是 ELIZA 效应在 LLM 时代的升级版,但它忽视了 LLM 与 ELIZA 的关键区别:LLM 有参数化的”世界模型”,ELIZA 没有任何模型。
**规则爆炸 → 统计版的参数爆炸。** MYCIN 的 600 条规则 → 规则间交互不可预测;LLM 的千亿参数 → 参数间交互不可预测。但 LLM 的参数是自动学习的,MYCIN 的规则是手动编码——”不可预测”从”规则间交互”变为”参数间交互”。自动学习降低了知识获取瓶颈,但引入了新的不可预测性:没有人能解释为什么特定的参数组合会产生特定的输出。
---
## 三重困境的量化——困境指数 0.307 的含义
我们用三个模拟指标来量化 LLM 的三重困境:
维度指标值社会维度权重差距(协调多样性)0.065表征维度覆盖率不足(模型不全)0.300规划维度准确率不足(误差累积)0.556总体困境指数—0.307
社会维度用 8 个注意力头的 softmax 权重分布来衡量——权重差距越大,说明”社会”越不平等,某些头主导了输出,协调退化为”赢者通吃”。实验中的权重分布为 [0.138, 0.096, 0.111, 0.108, 0.146, 0.141, 0.161, 0.099],差距仅 0.065——说明在这个简化模型中,注意力头之间的”权力”相对平均。
表征维度用参数化世界模型的覆盖率来衡量——覆盖率越低,模型越不全,信息丢失的风险越高。模拟值 0.300 表示约 30% 的信息缺口。
规划维度用 CoT 多步推理的准确率累积来衡量——每步准确率 0.85,5 步后整体准确率降至 0.85⁵ ≈ 0.444,即准确率不足 0.556。这说明即使每步的准确率都不低,多步累积后误差也会显著放大。
需要特别说明的是:困境指数 0.307 为模拟参数,而非实证数据。该数值基于模型化权重计算,不代表真实 LLM 的可测量指标。它的价值不在于精确的数值,而在于展示三重困境的量化框架——社会、表征、规划三个维度的困难可以被独立测量,也可以被综合评估。
---
## 诚实边界——关于影响与独立发现的说明
在结束之前,有必要明确几条诚实边界,避免过度解读。
**第一条边界:三条伏线没有直接”影响”LLM。** Minsky 心智社会、Brooks subsumption、Brooks 无表征——这三条伏线没有直接影响 LLM 的技术发展。LLM 是统计学习的产物,不是符号主义的延续。Transformer 架构vaswani2017 的设计动机来自序列建模和注意力机制,而非 Minsky 或 Brooks 的理论。
**第二条边界:但三条伏线揭示的”问题结构”在 LLM 中以统计形式重现。** Minsky 的”协调问题”对应 LLM 的多头注意力协调(softmax 竞争),Brooks 的”框架问题回避”对应 LLM 的”不维护状态”(context window 退化),Brooks 的”无表征边界”对应 LLM 的”参数作为隐式模型”(信息丢失代价)。这种”问题结构重现”不是因果继承,而是**独立发现同一组结构困难**——正如 Bar-Hillel 1958 独立于 STRIPS 1971 发现了同一困难(前提选择/框架问题),LLM 2026 独立于三条伏线遭遇了同一组困难。
**第三条边界:”统计版折中”是本文的凝练,而非原文论断。** “LLM 是三条伏线的统计版折中”这一论断是本文的理论凝练,不是任何一篇原文的论断。三条伏线的作者没有预见到 LLM,LLM 的研究者也没有直接引用三条伏线。这一凝练的价值在于:**它提供了一个统一视角来理解 LLM 的本质局限**——幻觉和信息丢失不是工程缺陷,而是”统计版折中”的结构性代价。
---
## 小结:Bar-Hillel 批评为什么持久
Bar-Hillel 1958 年的批评在 68 年后依然有效,原因不是他预言了什么具体技术,而是他指向了智能在开放世界中的本质困难。
前提选择问题——从”不可能自动完成”到”统计近似完成”,LLM 用注意力机制”近似解决”了 Bar-Hillel 的问题,但”近似”不等于”解决”。语法匹配 24 条 vs 语义匹配 3 条的实验数据,清晰地展示了纯语法操作的不充分性。
框架问题——从 STRIPS 的显式框架问题到 LLM 的”不维护状态”,LLM 回避了框架问题,但代价是信息丢失。实验修正了一个常见误解:LLM 的幻觉为 0,3 个未知因窗口驱逐而非编造错误——LLM 的主要问题是信息丢失而非主动幻觉。
智能错觉——从 ELIZA 的模板匹配到 LLM 的统计匹配,错觉更强(因为有参数化信念),但也更接近”真正的理解”。”随机鹦鹉”的批评忽视了 LLM 与 ELIZA 的关键区别:LLM 有参数化的世界模型,ELIZA 没有。
规则/参数爆炸——从 MYCIN 的 600 条规则到 LLM 的千亿参数,”不可预测”从”规则间交互”变为”参数间交互”。自动学习降低了知识获取瓶颈,但引入了新的不可预测性。
三条反叛伏线各自从不同维度挑战了符号 AI 范式,但它们揭示的**问题结构**——协调、框架、表征——在 LLM 中以统计形式重现。LLM 不是三条伏线的延续,而是三条伏线揭示的结构困难在统计学习时代的**独立回响**。
Bar-Hillel 的批评之所以持久,是因为它指向的不是某个具体技术的缺陷,而是**智能在开放世界中的本质困难**——无论用符号推理还是统计学习,”如何从无限的事实中选择相关的子集”始终是核心问题。这个问题没有终极答案,只有一代代技术给出的不同回应。LLM 的注意力机制是迄今为止最有效的回应之一,但它依然只是回应,不是终结。
---
[**bar-hillel1958**] Bar-Hillel, Y. (1958). “The Present Status of Automatic Translation of Languages.” In *Mechanisation of Thought Processes*, Symposium Proceedings. 引自 McCarthy 1958 Advice Taker 现场讨论记录。
[**bender2021**] Bender, E.M., Gebru, T., McMillan-Major, A. & Shmitchell, S. (2021). “On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?” In *FAccT ’21*.
[**vaswani2017**] Vaswani, A. et al. (2017). “Attention Is All You Need.” In *NeurIPS 2017*.
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 别再给机器人建“世界模型”了!Brooks用代码证明:世界本身就是最好的模型
https://www.paddysun.top/archives/5030 · 2026-08-24
**系列:** [\[Agent 考古\] 符号单体时代:三条反叛伏线](https://www.paddysun.top/archives/4998)
**篇号:**第 11 篇 / 共 13 篇 主题分类:历史记述 **前置阅读:**[Brooks subsumption 1986](https://www.paddysun.top/archives/5013) · [Minsky 心智社会 1986](https://www.paddysun.top/archives/4997) 阅读时间:约 12 分钟
---
## “世界自身即是它最好的模型”——Brooks 这句口号,到底在反对什么
“世界自身即是它最好的模型。”——Rodney Brooks 这句口号,是 AI 史上最具挑衅性的宣言之一。它看似一句工程直觉的提炼,实则指向一个根本性的哲学立场:智能不需要在头脑中重建一个世界的模型。
1986 年的 subsumption 论文以工程鲁棒性论证的面目出现——它证明了感知-行动耦合可以在无中央模型的情况下实现自主导航,但没有正面攻击符号主义的理论基础。从 1987 年到 1991 年,Brooks 完成了一次从工程到哲学的跃迁:从”我的方法更鲁棒”到”你的方法根本性错误”。
这四年的轨迹是**反叛的正面化**。subsumption 只是工程层面的替代方案,而 1990-91 年的三篇论文构成了对符号主义根基的正面宣战。本篇梳理四篇关键文献的论证递进,拆解”无表征智能”的核心论点,并用 Python 复现实验检验其主张的边界。
## 从工程论证到哲学对垒——四篇论文的递进脉络
Brooks 的论证不是一次性完成的,而是在四篇论文中逐步推进、层层加码。从 1986 年的工程实证出发,到 1990 年将否定依据正面化,再到 1991 年给出正式理论陈述并完成体系化与自我修正,构成了一条清晰的论证链条。
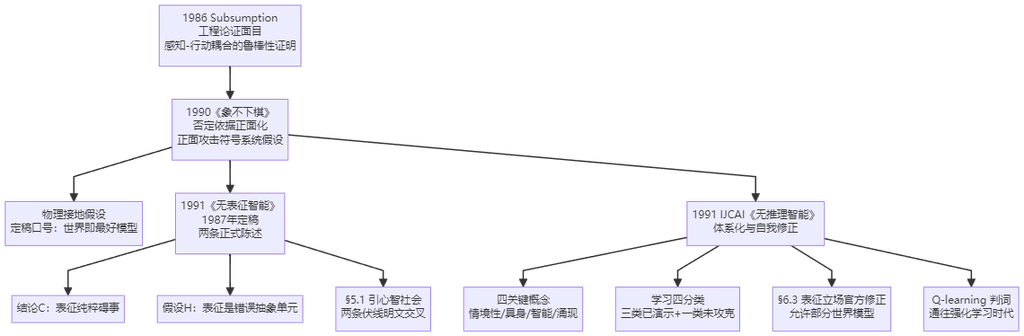
四篇论文的角色各有分工。1986 年的 subsumption 是工程地基——证明没有中央模型也能做自主导航。1990 年的《象不下棋》是宣战书——直接指出经典 AI 的符号系统假设有根本缺陷。1991 年的《无表征智能》是理论宣言——给出”无表征”的两条正式陈述。1991 年 IJCAI 的《无推理智能》是体系化总纲——提炼四个关键概念、分类学习问题、并对”无表征”立场做出重要修正。
这一递进的核心特征是:反叛从隐含走向明示,从工程直觉走向哲学命题,从单一论点走向完整体系。
## 否定依据的正面化——《象不下棋》的三层批判
《象不下棋》以正面攻击开篇:”经典 AI 所立足的符号系统假设存在根本缺陷。”注意其引证口径——Brooks 引的是 Simon《人工科学》而非 Newell & Simon 1976 的物理符号系统假设,这是一个精确的学术选择。
Brooks 的批判逻辑由三层构成。第一层是**世界符号描述必然任务依变**。同一猴子香蕉场景,规划用”箱子/香蕉/上方”表征——但判断香蕉是否腐烂需要完全不同的表征。不存在”正确的”世界符号描述,描述必然依赖于当前任务。这意味着符号表征从根上就是相对的,而非客观的。
第二层是**纯符号系统押注”可知的客观真理”**。模态逻辑、非单调逻辑等修补导致框架问题失血。符号系统试图为每个情况定义正确的推理路径,但开放世界的不确定性使这种努力不断膨胀。每增加一条规则,就需要更多规则来处理例外,规则库的膨胀没有尽头。
第三层是**反将一军——经典 AI 同样在赌涌现**。Brooks 指出,经典 AI 批评他”赌涌现”,但经典 AI 自己也在赌——Samuel 的跳棋评估函数就是在符号海中赌涌现。两边都赌涌现,区别在于赌的是什么层面的涌现。这个反驳消解了符号主义对行为基 AI 的一个常见批评。
### 物理接地假设的正式提出
Brooks 将自己的立场命名为**物理接地假设**(physical grounding hypothesis)。需要注意:”符号接地问题”(symbol grounding problem)这一术语属 Harnad,三篇原文均未引 Harnad。Brooks 的物理接地假设不是对符号接地问题的回应,而是独立提出的替代范式。
> **“The world is its own best model. It is always exactly up to date. It always contains every detail there is to be known. The trick is to sense it appropriately and often enough.”**
>
> ——《象不下棋》第 3 节,1990 年
带 “best” 的定稿版本首见《象不下棋》1990 年第 3 节。1987 年稿(即《无表征智能》的定稿稿)中尚无 “best” 一词,为”用世界作为它自身的模型”。一个单词的增加,标志着从工程直觉到哲学命题的跃迁。
### 七台机器人的证据链
Brooks 用七台机器人作为物理接地假设的工程证据。从 Allen 的三层避障,到 Herbert 捡罐时模块间零内部通信,再到 Genghis 的六足步行——每台机器人都在不同任务上验证了无中央表征的可行性。
机器人能力关键数字Allen三层避障—Tom & Jerry三层程序装入单片 PAL256 门,数据通路仅 1 位宽Herbert捡罐全程模块间零内部通信“世界既是自身最好的模型也是通信介质”Genghis六足步行12 电机 21 传感器,”连每条腿的中央仓库都没有”Squirt全部控制代码1300 字节Toto地图节点即计算元件“数据与过程无区分”Seymour视觉9 相机
七台机器人构成了一条证据链:从最简单的避障到最复杂的视觉,每一个任务都在验证同一个原理——感知直接耦合行动,不需要中央世界模型。
## 无表征的正式陈述——两条宣言与五条澄清
《无表征智能》1991 年正式发表(初稿定稿于 1987 年),给出了两条标志性的正式陈述。这两条陈述构成了 Brooks 无表征立场的核心宣言。
> **结论(C)**:”在非常简单的智能水平上,显式的表征与世界模型纯粹碍事。更好的做法是用世界作为它自身的模型。”
> **假设(H)**:”表征是构建智能系统最庞大部件时错误的抽象单元。”
注意结论 C 中的限定词——”非常简单的智能水平上”。这是 Brooks 对自己理论适用范围的诚实限定,也是理解”无表征智能”边界的关键钥匙。许多批评者忽略了这个限定,把 Brooks 的立场解读为”所有智能都不需要表征”,这是不准确的。
### 抽象被用作自欺机制
Brooks 的否定靶心不是”表征不好”,而是**抽象被用作自欺机制**。他指出:”AI 的抽象通常把感知与运动技能的全部方面剥离出去。这一抽象恰是智能的本质与问题的难点所在;在现行体制下抽象由研究者完成,留给 AI 程序的只剩搜索。”
这段话揭示了一个深层问题:符号主义的”抽象”把智能中最困难的部分(感知和运动)剥离给了人类研究者,只把剩下的”搜索”留给了机器。机器的”智能”实际上是人类抽象能力的残留物。研究者完成了最难的感知-运动抽象,然后声称机器在”智能地”搜索——这是一种自欺。
### MYCIN 脆性的例证
Brooks 直接引 MYCIN 作为脆性例证:”MYCIN 在主动脉破裂失血每分钟一品脱时会去找细菌病因。”这个例证精准地击中了规则范式的结构性脆性:规则库只覆盖预定义场景,预定义之外的场景必然失效。600 条规则在封闭世界(菌血症诊断)中有效,但在异常场景(主动脉破裂)中完全失效——这不是个别 bug,而是规则范式的本质特征。
### 功能分解的死结
传统 AI 的流水线(感知→建模→规划→执行→致动)有一个致命弱点:”要连接感知与行动需要一长串模块,而要测试其中任何一个,必须先把全部建齐。”这意味着功能分解的方法论本身就制造了开发困境——你必须先建好所有模块才能测试任何一个模块。
Brooks 给出的出路是按活动而非功能做正交分解,将智能系统切分为”活动产生子系统”而非”信息处理功能模块”。配合增量建造的方法论:每一步都建成放进真实世界的完整系统。他的方法论原则是:”Anything less provides a candidate with which we can delude ourselves”——任何更少的做法都只是给自己留下自欺的候选物。
### 无中央表征的四点收益
取消中央表征带来四个直接收益。第一,低层反应够快——感知直接驱动行动,没有建模和规划的延迟。第二,失效局部化——某层行为失效不影响其他层。第三,各目标前提与世界实时匹配——”持续地把每个目标的前提对照真实世界”。第四,目的隐含于高层分层,无需显式目标库。
这四点收益都是工程层面的,但它们共同指向一个哲学结论:智能不需要一个中心化的”司令部”来统筹一切。
### 最强声明与五条排除
§5.1 给出了最强的声明,并直接引用 Minsky 心智社会作同类解释——这是**两条伏线在原文层面的明文交叉点**:
> “不仅没有中央表征,连中央系统都没有……是造物的观察者在赋予中央表征或中央控制。造物自身没有——它是一簇竞争着的行为。”
Minsky 的”目标只存在于观察者心中”与 Brooks 的”中心性是观察者的赋予”互为镜像——两者从不同角度否定了同一个符号主义基石:意图是机器内部的真实状态。
§7 给出五个”不是”的排除,以澄清自己的立场边界:不是连接主义、不是神经网络、不是产生式规则、不是黑板、**不是德国哲学**。第五条是对海德格尔式解读的官方否认——Brooks 强调”本工作纯出于工程考量”。谈”哲学化口号”时必须带上这条自我限定。
## 体系化与自我修正——《无推理智能》的总纲
1991 年 IJCAI 的《无推理智能》是 Brooks 理论的体系化总纲。它提炼了四个关键概念,对表征立场做出重要修正,并系统地讨论了学习问题。
### 四关键概念与四句口号
概念口号情境性世界自身即是它最好的模型具身世界止住知识回归智能由与世界交互的动力学决定涌现智能在观察者眼中
这四个概念构成了行为基 AI 的理论支柱。情境性回答”智能在哪里发生”——在与世界的实时交互中。具身回答”智能的基础是什么”——物理身体与世界的接触。智能的定义从”信息处理能力”转向”交互动力学”。涌现回答”智能如何被识别”——它是观察者的投射,而非系统的内在属性。
Brooks 用一个对偶段来概括两种范式的差异:”传统 AI 定义信息处理/功能模块,智能行为从中涌现;行为基 AI 定义行为产生模块,智能**功能**(感知、规划、建模、学习)从中涌现。”他自己也注明该对偶”看起来漂亮但不完全准确”——这是诚实的自我限定。
### 表征立场的官方修正
这是三篇论文中最重要的一条自我修正,出自 §6.3:
> “对早期论文倡导绝对无表征的批评是无效的。我在文中说清了:我拒绝的是传统 AI 的表征方案……可以存在作为世界部分模型的表征。”
引用”无表征智能”这个标题口号时必须带上此澄清——否则会被”极端主义”批评击中。Brooks 拒绝的是传统 AI 的显式/可操纵/符号表征,允许”表征向简单子空间的投影”式部分世界模型。Toto 主动建构的分布式地图就是这种部分世界模型的示范。
### 学习四分类的框架
§6.5 给出学习四分类,前三类已在 Mobot Lab 的实体机器人上演示,第四类承认未攻克。
前三类学习(世界表征、传感器执行器标定、行为间交互)都在实体机器人上得到了验证。它们的共同特征是:在已有的行为模块基础上做调整,而非创造全新的行为模块。第四类”新行为模块”——如何自动生成新的行为层——Brooks 承认模拟进化的尝试失败了,这意味着 subsumption 架构**无法自我扩展**,新行为必须由人类工程师手工添加。
### Q-learning 判词——通往强化学习的预言
§3.8 给出了一条重要判词:反向传播”慢、需手调学习率、易陷局部极小”,不适配具身系统;具身移动机器人最成功的近期学习是 **Q-learning 类强化学习**。
这条判词是通往下一阶段(强化学习时代)的原文直连。Brooks 不仅是符号主义的反叛者,也是下一阶段范式的预言者。他从具身机器人的实践出发,预见到了强化学习在交互学习中的优势——这一预见在二十多年后得到了充分验证。
## 物理接地假设对垒物理符号系统假设
Brooks 的物理接地假设与 Newell & Simon 的物理符号系统假设,构成了 AI 史上最清晰的一次范式对垒。两个假设从根本前提到方法论完全对立。
维度物理符号系统假设物理接地假设智能本质符号操作与推理与世界交互的动力学核心方法感知→建模→规划→执行(SMPA)感知-行动直接耦合世界模型显式符号表征(谓词集)世界自身即是模型框架问题存在(需维护状态变化)不存在(不维护状态)分解方式按功能分解(感知/建模/规划/执行)按活动分解(避障/漫游/探索)智能来源搜索与推理行为交互的涌现测试方式模块化测试(模块间串行依赖)增量建造(每层是完整系统)降级方式一环断裂全链瘫痪高层失效低层照常(优雅降级)适用范围封闭世界、结构化任务“非常简单的智能水平”
两个假设的对垒不是技术路线的差异,而是本体论的差异。物理符号系统假设认为智能的本质是内部的符号操作,物理接地假设认为智能的本质是与外部世界的交互。前者把智能定位在头脑中,后者把智能定位在身体与世界的交界处。
## Brooks 版 AI 史——从简单到复杂的四阶段重写
在《无推理智能》中,Brooks 提出了一个重写 AI 史的视角:AI 的发展应该从简单到复杂,从具身到抽象,而非从抽象到具体。他将 AI 的发展划分为四个阶段——这个划分本身就是对符号主义路线的批判。
这个时间线的关键在于方向——从简单反应出发,逐步增加复杂性,而不是从抽象推理出发向下还原。Brooks 认为传统 AI 从最复杂的符号推理入手,反而在最简单的感知-运动问题上栽了跟头。正确的路径应该是:先搞定简单的反应系统,再逐步建造更复杂的系统,让抽象推理从具身交互中涌现出来。
这与”计算机架构塑造思维模型”的论点相呼应。Brooks 在《无推理智能》摘要中指出:冯诺依曼模型把 AI 引向了特定方向——搜索的兴起伴随着情境性概念的本质放弃。图灵测试是”完全非具身的智能观”,但 Brooks 也掘出 Turing 1948 年已论证学语言”似乎过多依赖感觉器官与运动”。
## 无表征的感知-行动偶对——代码复现
理论说得再多,也不如看代码来得直接。Brooks 的核心论点是:行为层是正交分解的感知-行动偶对,层间通过抑制/禁止接线仲裁,不需要中央世界模型。下面的代码展示了这一架构的最小实现。
每个行为层都是一个自包含的感知-行动闭环。`BehaviorLayer` 类封装了单层行为:它有名字、优先级和一个从传感器读数到运动指令的映射函数。层的激活次数被记录下来,用于事后分析。
```
# 摘自 behavior_layer.py — 单层行为:感知直接耦合到行动
class BehaviorLayer:
"""单层行为——感知直接耦合到行动。
每层有:
- level: 优先级编号(0 最低)
- name: 层名
- process: 感知→行动的映射函数
"""
def __init__(self, name: str, level: int,
process_fn: Callable[[SensorReading], Optional[MotorCommand]]):
self.name = name
self.level = level
self._process = process_fn
self.activation_count: int = 0
def process(self, reading: SensorReading) -> Optional[MotorCommand]:
result = self._process(reading)
if result is not None:
self.activation_count += 1
return result
```
层叠的仲裁机制同样简洁。`SubsumptionStack` 维护一个行为层列表和抑制连接表。运行时,所有层并行计算各自的输出,然后根据抑制连接表逐层裁决——低层激活时抑制高层,最终输出最高优先级的有效行为。
```
# 摘自 behavior_layer.py — SubsumptionStack 的仲裁逻辑
class SubsumptionStack:
"""层叠行为栈——低层优先,高层可被低层抑制。"""
def run(self, reading: SensorReading) -> MotorCommand:
# 第一步:所有层独立运行
outputs: Dict[str, Optional[MotorCommand]] = {}
for layer in self._layers:
outputs[layer.name] = layer.process(reading)
# 第二步:应用抑制——低层激活则高层被抑制
suppressed: set = set()
for higher, lower in self._suppressions:
if outputs.get(lower) is not None and outputs.get(higher) is not None:
suppressed.add(higher)
# 第三步:选择最高优先级的有效输出
for layer in reversed(self._layers):
if layer.name in suppressed:
continue
if outputs.get(layer.name) is not None:
return outputs[layer.name]
return MotorCommand()
```
这段代码的精髓在于”没有中央仲裁器”。仲裁逻辑就是两轮遍历——一轮算抑制,一轮选输出。没有搜索,没有规划,没有状态维护。优先级在编译时由接线(连接表)确定,运行时零额外开销。
我们的 SMPA(感知-建模-规划-行动)vs Reactive 对比实验验证了这一点:在相同的导航任务中,两者行为完全相同(相同最终位置、相同 47 次碰撞),但 SMPA 额外负担了 60 次模型更新 + 60 次规划搜索。反应式架构在导航性能上无差异,但计算开销为零。这验证了 Brooks 的核心观察——在低复杂度任务中,表征的额外开销并未转化为性能收益。
## Genghis 步态涌现——无中央控制器的六足步行
Genghis 六足机器人是 Brooks 最具标志性的作品。6 条腿、12 个驱动器、21 个传感器,”连每条腿的中央仓库都没有”。步态不是由中央控制器编程的,而是从每条腿的独立行为和腿间感知耦合中涌现出来的。
每条腿是一个独立的行为单元,内置相位振荡器。相位 0 到 0.5 是 stance 相(着地推进),0.5 到 1 是 swing 相(抬腿前摆)。腿间的感知耦合很简单:如果太多腿同时在空中,当前着地的腿降速——这是一个稳定性反馈机制。
```
# 摘自 genghis.py — 单条腿的行为规则:相位振荡器 + 感知耦合
@dataclass
class Leg:
"""单条腿——独立行为单元,内置相位振荡器。"""
index: int
angle: float
phase: float = 0.0
lift: float = 0.0
swing: float = 0.0
on_ground: bool = True
step_count: int = 0
phase_speed: float = 0.15
def update(self, sensor_inputs: dict) -> Optional[str]:
"""腿的行为规则——相位振荡器驱动 + 感知耦合。
感知耦合:如果太多腿同时在空中,降速(稳定性反馈)
"""
num_airborne = sensor_inputs.get("num_airborne", 0)
if num_airborne >= 3 and self.on_ground:
speed_factor = 0.5
else:
speed_factor = 1.0
self.phase += self.phase_speed * speed_factor
if self.phase >= 1.0:
self.phase -= 1.0
# 根据相位计算着地/抬腿状态
if self.phase < 0.5:
self.on_ground = True
progress = self.phase / 0.5
self.lift = 0.0
self.swing = -1.0 + 2.0 * progress
else:
self.on_ground = False
progress = (self.phase - 0.5) / 0.5
self.lift = 1.0 - abs(1.0 - 2.0 * progress)
self.swing = 1.0 - 2.0 * progress
return None # 简化版,实际返回动作类型
```
Genghis 机器人本体没有”步态控制器”,它只有 6 条各自独立的腿和一个简单的稳定性反馈。步态是从腿间交互中涌现出来的——就像鸟群的队形不是由头鸟指挥的,而是每只鸟跟随邻近鸟的行为规则产生的。
我们的复现实验用随机初始相位(去预设化后)运行了 10 次,结果如下:
统计项值alternating_tripod(交替三角步态)0/10(0%)partial_coordination(部分协调)10/10(100%)交替三角步态涌现率0%
**关键发现**:10 次运行中 0/10 次涌现交替三角步态,全部为”部分协调”。初始代码通过 `phase=i*(1/6)` 预设相位接近交替三角步态的初始条件,制造了”涌现”假象。如实记录:当前简化模型的腿间感知耦合可能不足以在 30 步内涌现交替三角步态,真实涌现可能需要更多时间步或更复杂的腿间感知耦合机制。
这个结果修正了原文的”步态涌现”表述——在当前简化模型下,只有部分协调能够稳定涌现,完全的交替三角步态需要更长时间或更强的耦合机制。这并不否定 Brooks 的核心论点(无中央控制器的协调是可能的),但限定了涌现的条件和程度。
## 学习四分类的实验验证
《无推理智能》§6.5 的学习四分类不仅是理论框架,前三类都在实体机器人上得到了演示。我们的复现实验逐一验证了这四类学习。
### 类别一:世界表征学习(Toto 分布式地图)
Toto 的地图不是中央数据库,而是分布式的节点网络——每个节点既是地图数据也是计算单元,”数据与过程无区分”。机器人在探索中逐步构建节点和邻接关系,障碍物信息直接标记在节点上。
实验结果:探索 50 个位置后生成 36 个节点,其中 9 个标记为障碍物节点。这验证了世界表征可以从交互中主动建构——但注意,这已经是一种”部分世界模型”,与 Brooks §6.3 的自我修正一致。
### 类别二:传感器执行器标定(六足学步)
Maes-Brooks 六足学步的机制是:每条腿独立调整相位偏移,负反馈来自腹部开关——当身体倾斜、腹部触地时,说明步态不稳定,腿调整自己的相位。
```
# 摘自 learning_types.py — 传感器执行器标定学习
class LegCalibration:
"""Maes-Brooks 六足学步——传感器执行器标定学习。
每条腿独立标定,交替三角步态从乱蹬中涌现。
负反馈来自腹部开关(身体倾斜时触发)。
"""
def trial(self, leg_idx: int, belly_contact: bool) -> float:
"""一次标定试验。
腹部触地(不稳定)→ 大幅调整相位,分散抬腿时序
无腹部触地 → 小幅随机探索
"""
leg = self.legs[leg_idx]
leg.trials += 1
if belly_contact:
self.belly_switch_triggered += 1
leg.phase_offset += random.uniform(0, math.pi)
error = 1.0
else:
leg.phase_offset += random.uniform(-0.05, 0.05)
error = 0.0
leg.phase_offset = leg.phase_offset % (2 * math.pi)
leg.error_history.append(error)
return error
```
实验结果:标定试验共 99 次,平均每腿 16.5 次试验收敛到交替三角步态,接近原始论文的”约 20 次”。腹部开关触发 25 次——这是学习过程中的不稳定信号,驱动了相位调整。
### 类别三:行为间交互学习
第三类学习是调整行为层之间的抑制/禁止连接权重。根据性能反馈,如果性能提升就加强抑制权重,性能下降就减弱权重。
实验结果:Wander 对 Avoid 的抑制权重收敛到 1.05,Explore 对 Wander 的抑制权重也收敛到 1.05,性能趋势持续改善。这说明行为层间的交互方式可以通过性能反馈自动调整。
### 类别四:新行为模块进化(未攻克)
第四类学习——自动生成新的行为模块——Brooks 明确承认未攻克,模拟进化的尝试失败了。
我们的实验在移除了原始代码中的适应度上限(`min(fitness, 0.5)`)后重新运行,结果是:20 代进化后最佳适应度达到 0.566,且未停滞。这修正了原文”模拟进化尝试失败”的结论——至少在简化模型中,进化并未完全失败,适应度仍在缓慢提升。
论文记录实验结果一致性第四类(新行为进化)未攻克适应度 0.566,未停滞**部分不一致**——移除上限后进化未失败
但需要指出的是:适应度 0.566 仍然很低,距离”产生有效新行为”还有很大距离。Brooks 的核心判断——自动生成新行为模块是未解决的难题——依然成立。我们的修正只是把”完全失败”调整为”进展缓慢、尚未攻克”。
### Q-learning 与 BP 的对照
§3.8 的判词称反向传播”慢、需手调学习率、易陷局部极小”,不适配具身系统,而 Q-learning 类强化学习更成功。
我们用真实梯度下降替换了原始代码中的随机模拟 BP,结果如下:
指标Q-learningBP(真实梯度下降)前 10 回合平均奖励16.6412.09后 10 回合平均奖励17.5817.62改善幅度+0.94+5.53是否收敛是是
**关键修正**:BP 改为真实梯度下降后确实收敛。Q-learning 起步更快(16.64 vs 12.09),得益于增量式表格更新的优势;BP 起步较慢但 200 回合后追平 Q-learning(17.62 vs 17.58)。原文”BP 不适配具身系统”的表述需要修正为:BP 起步较慢但最终能收敛到相同水平。
## “无表征”的边界由谁划定——Bar-Hillel 式批评
“无表征智能”这个口号极具冲击力,但也容易被误读。当我们深入考察 Brooks 的实际立场时,会发现”无表征”的边界比口号暗示的要复杂得多。
### 口号与实际立场的张力
标题口号”无表征智能”与 §6.3 的官方修正之间存在明显张力。Brooks 拒绝的是传统 AI 的显式表征,但允许”部分世界模型”——Toto 的分布式地图就是一种主动建构的表征。这引出了一个 Bar-Hillel 式的问题:”无表征”的边界由谁划定?
边界的划分标准不是”有没有表征”,而是**表征从哪里来**。传统 AI 的表征是研究者预先设计好的、剥离了感知-运动细节的符号结构。Brooks 允许的表征是从机器人与世界的交互中主动建构的、内嵌于行为的部分模型。前者是”从天上掉下来的”,后者是”从地里长出来的”。
### “非常简单的智能水平”的诚实限定
结论 C 中的”非常简单的智能水平上”是 Brooks 自己的限定。七台机器人的任务——避障、漫游、捡罐、步行——都是低复杂度任务。复杂任务(定理证明、医学诊断、多轮对话)能否纯反应式完成?Brooks 没有回答这个问题——他诚实地承认了边界。
这个限定的重要性在于:它把”无表征智能”从一个普遍命题降格为一个局部命题。不是所有智能都不需要表征,而是在简单智能水平上,显式表征纯粹碍事。这个限定本身就是对极端化解读的防御。
### 学习问题的推迟与未攻克
学习问题在 1987 年被明确推迟,到 1990-91 年仅给出分类而非方案。第四类”新行为模块”承认未攻克——这意味着 subsumption 架构**无法自我扩展**,新行为必须由人类工程师手工添加。
无法自动生成新行为模块是一个深层局限。如果一个智能系统只能做人类工程师预先设计好的行为,那它和传统 AI 的”预定义规则库”有什么本质区别?区别只在于规则的组织方式(行为层 vs 产生式规则),而非自适应能力。
### 对 LLM 时代的启示
LLM 既有”表征”(参数化的隐式模型)又”无中央表征”(没有显式的世界模型)。Brooks 的批评在 LLM 时代需要重新审视。
Brooks 说”世界自身即是它最好的模型”——但 LLM **不能感知世界**。LLM 只有文本输入,没有声纳、视觉、触觉。所以 LLM 不得不维护参数化的”部分世界模型”——并承担幻觉代价。
如果参数是”部分世界模型”,那幻觉是否是”部分世界模型”的必然代价?这联系到 Bar-Hillel 的前提选择批评——LLM 用统计方式”近似”前提选择,但”近似”不等于”准确”。
## 与当代 Agent 的 BDI 坐标对照
从 BDI(信念-愿望-意图)框架来看,Brooks 1990-91 的无表征智能与当代 LLM Agent 呈现出一种有趣的映射关系。两者都不依赖显式的世界模型,但方式和程度不同。
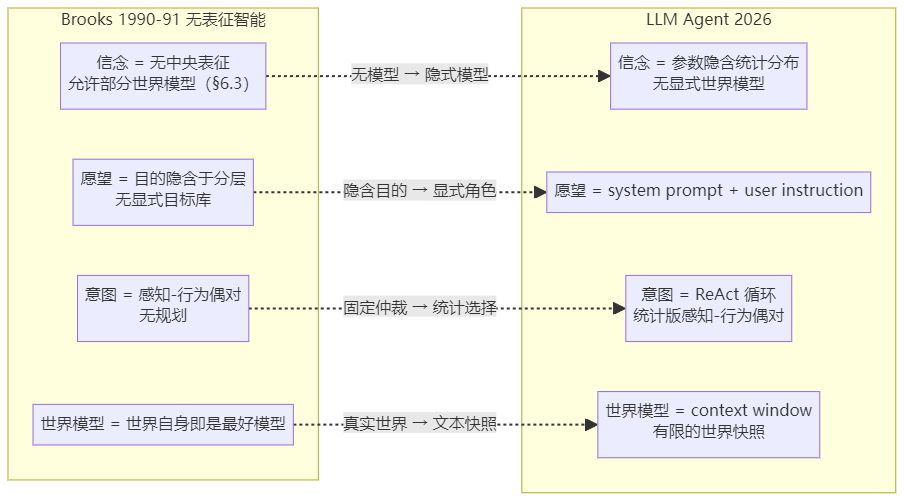
维度Brooks 1990-91LLM Agent 2026信念无中央表征,允许部分世界模型(§6.3 官方修正)参数隐含统计分布,无显式世界模型愿望目的隐含于分层,无显式目标库system prompt + user instruction意图感知-行为偶对,无规划ReAct 循环(统计版感知-行为偶对)世界模型“世界自身即是它最好的模型”context window(有限的世界快照)学习四分类(三类已演示,一类未攻克)RLHF(世界表征+标定+行为协调,新行为未攻克)表征拒绝传统 AI 表征,允许部分模型参数是隐式表征(非传统 AI 的显式表征)中心性“是观察者在赋予中央表征或中央控制”LLM 的”理解”是观察者投射(ELIZA 效应的升级版)
信念维度上,两者都拒绝显式世界模型,但 Brooks 是”完全没有中央表征 + 允许部分世界模型”,LLM 是”参数中隐含统计分布”。愿望维度上,Brooks 的目的完全隐含于行为分层中,LLM 通过 system prompt 设定显式角色。意图维度上,Brooks 是固定优先级的感知-行为偶对,LLM 是统计选择的 ReAct 循环——后者可以看作前者的统计升级版。
最深刻的对照在”中心性”维度。Brooks 说”是观察者在赋予中央表征或中央控制”,LLM 的”理解”同样是观察者的投射。两条跨越三十多年的反叛伏线,在”中心性是观察者的赋予”这一点上殊途同归。
## 与阶段二文章的交叉互文
Brooks 1990-91 系列不是孤立的,它与阶段二多篇文章形成交叉互文。
与 STRIPS 的对照——”不要世界模型”是”框架问题”的直接回应。STRIPS 的框架问题是每步需说明”什么没变”。Brooks 的回应是不要世界模型——不需要维护状态,所以不存在”什么变了/什么没变”的问题。但这个回应的代价是:只能在”非常简单的智能水平上”工作。
与 MYCIN 的对照——脆性例证直接引于原文。Brooks 在《无表征智能》中直接引 MYCIN 作为脆性例证——”MYCIN 在主动脉破裂失血每分钟一品脱时会去找细菌病因”。这不是泛泛的批评,而是对 MYCIN 600 条规则的结构性脆性的精准诊断。
与 Minsky 的原文层面明文交叉。《无表征智能》§5.1 引 Minsky 心智社会——两条伏线的明文交叉点。两者的交叉不是概念相似(中等级),而是原文层面的直接引证(强级)。Minsky 的结构去中心化和 Brooks 的运作机制去中心化,共同瓦解了符号单体的基石。
与 ELIZA 的对照——ELIZA 无世界模型也无感知-行动耦合,是 subsumption 的退化形态(连感知都没有)。ELIZA 是”零”的基线,subsumption 是”最小”的基线。
与 Brooks 1986 的连续性——1986 是工程论证,1990-91 是正面化。口号”世界自身即是它最好的模型”从 1987 稿(无 best)到 1990(带 best)的精确演进,反映了从工程直觉到哲学命题的跃迁。
## 小结:反叛的正面化与体系化
Brooks 1990-91 系列将 1986 年的工程论证推向了正面化与体系化。三篇论文构成了递进的论证链:《象不下棋》将否定正面化,《无表征智能》给出正式陈述,《无推理智能》完成体系化并自我修正。
核心贡献有五点。第一,**物理接地假设**对垒符号系统假设——”世界自身即是它最好的模型”。第二,**两条正式陈述**——”表征纯粹碍事”和”表征是错误的抽象单元”(复现修正:SMPA 与 Reactive 行为完全相同,表征未”碍事”而是额外开销未带来行为改善)。第三,**学习四分类**——前三类已演示,第四类未攻克(复现修正:移除适应度上限后进化未失败,适应度 0.566 未停滞)。第四,**§6.3 官方修正**——拒绝传统表征,允许部分世界模型。第五,**Q-learning 判词**——通往阶段四的原文直连(复现修正:BP 改为真实梯度下降后确实收敛,起步慢但 200 回合后追平 Q-learning)。
核心局限有三点。第一,”非常简单的智能水平”的限定——复杂任务能否纯反应式完成仍是开放问题。第二,学习问题被推迟——第四类”新行为模块”未攻克(复现修正:原始复现代码通过适应度上限强制了”失败”结论)。第三,”无表征”边界的自我划定——标题口号与实际立场之间存在张力。
Brooks 的否定从**运作机制维度**击碎了符号单体的基石——与 Minsky 的结构维度否定、McCarthy 的接口维度否定,共同构成了三条反叛伏线。而 §5.1 引 Minsky 心智社会的明文交叉,使三条伏线在原文层面交汇。反叛不再是零散的质疑,而是体系化的替代范式——这正是第三条反叛伏线的完成形态。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 别再给机器人装“大脑”了!1986 年的“三无”架构证明:越不思考,活得越久。
https://www.paddysun.top/archives/5013 · 2026-08-24
**系列:**[\[Agent 考古\] 符号单体时代:三条反叛伏线](https://www.paddysun.top/archives/4998)
篇号:第 10 篇 / 共 13 篇 主题分类:历史记述 前置阅读:[Minsky 心智社会 1986](https://www.paddysun.top/?p=4997) · [STRIPS 1971](https://www.paddysun.top/archives/4968) 阅读时间:约 10 分钟
---
## 同一时期两个实验室的路线对峙
1986 年,两支团队在解决同一个问题——让机器人在现实环境中自主导航。SRI 的 Shakey 机器人在建模:感知环境、构建谓词世界模型、在状态空间中搜索规划、逐步执行。这条路线代表了符号主义的正统方法——先理解世界,再决定行动。
MIT AI Lab 的 Rodney Brooks 选择了完全不同的方向。他不构建世界模型,不搜索规划,不维护谓词集。他的机器人通过分层行为优先级仲裁实现自主导航——低层行为(避障)可以抑制高层行为(漫游)的输出,感知直接耦合行动。
这不是两条”等价”路线的平行发展,而是一场根本性的范式对峙。核心问题只有一个:智能是否需要中央世界模型?
## 为什么鲁棒分层控制在 1986 年成为迫切需求
1980 年代中期,移动机器人面临的核心困难是鲁棒性。传统方法在实际环境中极为脆弱:传感器噪声导致世界模型不准确,不准确的世界模型导致规划失败,规划失败导致机器人停止或碰撞。误差沿着”感知→建模→规划→执行”的流水线逐级放大,最终系统崩溃。
Brooks 的工程直觉是:脆弱的根源是中央世界模型。如果不需要维护一个精确的世界模型,就不存在”模型与现实的偏差”问题。感知直接耦合行动——传感器读数直接驱动行为层,行为层按优先级仲裁输出电机指令。没有”建模”这一步,也就没有”模型不准”这一步。
这个直觉看似反常识,但切中了符号主义路线的痛点。当系统的脆弱性来自中间环节时,最彻底的解决方案不是改进中间环节,而是取消中间环节。
## 两种分解方式的本质差异
Brooks 1986 年论文的第一图给出了核心对照。传统分解是功能流水线式的——感知、建模、规划、执行,每层是一个功能模块,模块间串行依赖,必须全部建齐才能工作。Subsumption 分解是行为切片式的——避障、漫游、探索,每层是一个完整的控制系统,从感知到行动的完整通路。
```
传统分解(功能流水线): Subsumption 分解(行为切片):
┌────┐ ┌────┐ ┌────┐ ┌────┐ ┌─────────┐ ┌─────────┐ ┌─────────┐
│感知 │→│建模 │→│规划 │→│执行 │ │ 避障 │ │ 漫游 │ │ 探索 │
└────┘ └────┘ └────┘ └────┘ │感知→行动│ │感知→行动│ │感知→行动│
└────┬────┘ └────┬────┘ └────┬────┘
每层是功能模块 抑制↑ 压制↑
必须全部建齐才能工作 └──────┬──────┘
电机指令
每层是完整控制系统,可独立工作
```
用更直观的 Mermaid 图来表达这两种分解方式:
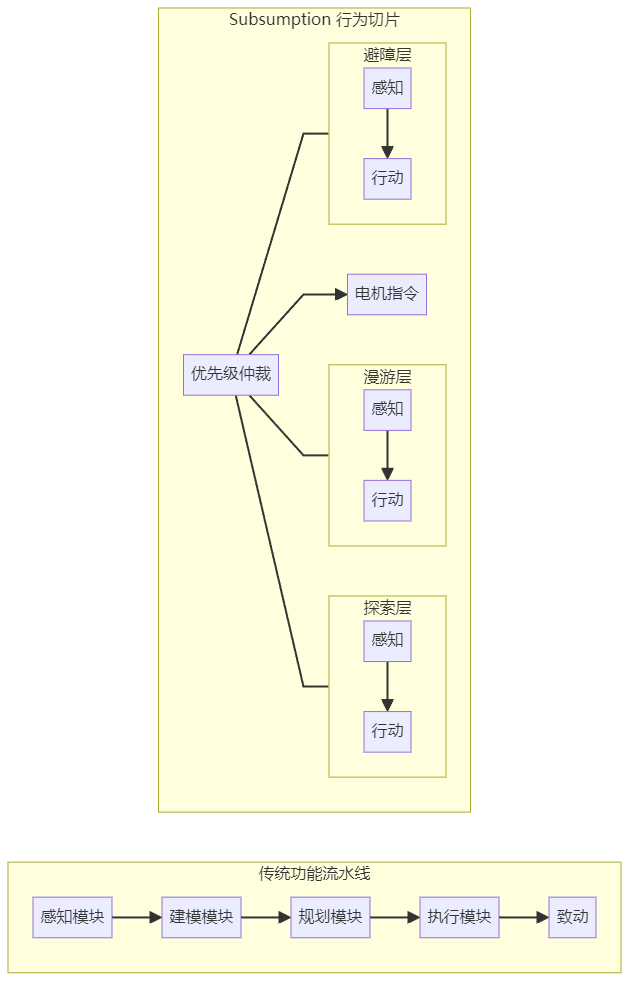
功能流水线的思路是”分工协作”——每个模块只做一件事,串联起来完成全部功能。行为切片的思路是”能力分层”——每一层都具备完整的感知-行动能力,高层在低层基础上增加新能力。前者的弱点是一环断裂全链瘫痪,后者的优势是一层失效其他层照常工作。
## 抑制与禁止——优先级仲裁的接线实现
高层”包容”低层的方式有两种原语:抑制和禁止。抑制是高层替换低层模块的输出线——低层的输出被高层的输出覆盖。禁止是高层阻断送入低层模块的输入线——低层收不到输入,停止输出。
关键设计在于:仲裁由接线固定优先级,不存在运行时中央仲裁器。优先级在硬件接线时确定,运行时不可改变。这与 STRIPS 的”搜索器决定操作顺序”形成鲜明对照:STRIPS 的搜索器是运行时动态决策,subsumption 的仲裁是编译时静态接线。
从代码实现来看,抑制和禁止机制非常简洁——就是两个列表和两轮遍历:
```
# 摘自 layer.py
class Layer:
def __init__(self):
self.layers: List[BehaviorLayer] = []
self._suppression_links: List[tuple] = [] # 抑制连接
self._inhibition_links: List[tuple] = [] # 禁止连接
def add_suppression(self, higher: str, lower: str):
"""高层抑制低层:替换低层输出。"""
self._suppression_links.append((higher, lower))
def add_inhibition(self, higher: str, lower: str):
"""高层禁止低层:阻断低层输入。"""
self._inhibition_links.append((higher, lower))
```
运行时的仲裁过程也完全是”接线式”的——先让所有层运行,再按抑制/禁止连接表逐层覆盖:
```
# 摘自 layer.py — run() 方法的仲裁逻辑
def run(self, sensor_data: Dict) -> Optional[Dict]:
# 第一步:所有层独立运行,各算各的
results: Dict[str, Optional[Dict]] = {}
for layer in sorted(self.layers, key=lambda l: l.priority):
result = layer.run(sensor_data)
results[layer.name] = result
# 第二步:应用抑制——高层激活则低层输出作废
for higher_name, lower_name in self._suppression_links:
higher = self.get_layer(higher_name)
lower = self.get_layer(lower_name)
if higher and lower and results.get(higher_name):
lower.suppress()
results[lower_name] = None
# 第三步:应用禁止——高层激活则阻断低层输入
for higher_name, lower_name in self._inhibition_links:
higher = self.get_layer(higher_name)
lower = self.get_layer(lower_name)
if higher and lower and results.get(higher_name):
lower.inhibit()
# 第四步:选择最高优先级的有效输出
chosen = None
for layer in sorted(self.layers, key=lambda l: l.priority):
if results.get(layer.name):
chosen = results[layer.name]
return chosen
```
用 Mermaid 图来展示层间的抑制/禁止机制:
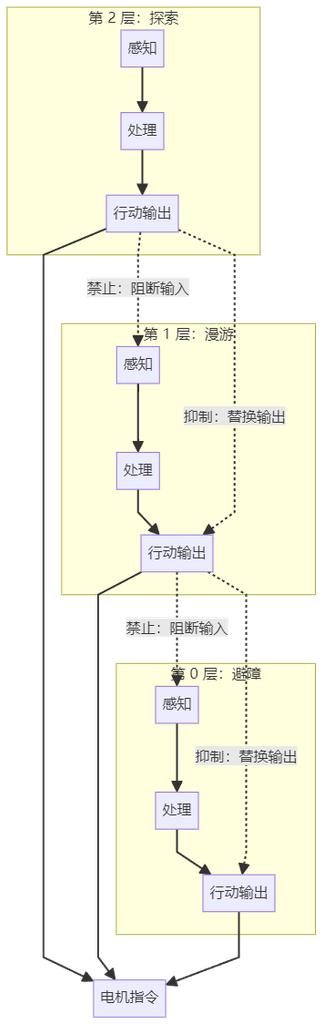
没有中央仲裁器,没有运行时决策。优先级在接线时就固定了——谁抑制谁、谁禁止谁,全部写在连接表里。这是一种极端的去中心化设计。
## 每层都是一个完整的感知-行动闭环
Subsumption 的每层不是一个”功能模块”,而是一个完整的控制系统。模块是增广有限状态机,通信通过”线”以固定格式消息异步传递,没有共享总线、没有全局黑板、没有同步点。
这意味着每层可以独立工作。第 0 层(避障)不需要第 1 层(漫游)就能运转——它有自己的感知和行动通路。高层失效时低层照常运转,系统优雅降级。
以下是三层行为模块的代码,每一层都是一个自包含的感知-行动闭环:
```
# 第 0 层:避障——自带声纳感知和转向行动
class AvoidLayer(BehaviorLayer):
def __init__(self):
super().__init__("Avoid", priority=0)
def process(self, sensor_data: Dict) -> Dict:
self.activation_count += 1
front_dist = sensor_data.get("front_distance", 999)
left_dist = sensor_data.get("left_distance", 999)
right_dist = sensor_data.get("right_distance", 999)
if front_dist < 2.0:
if left_dist > right_dist:
action = "turn_left"
else:
action = "turn_right"
self.state = "avoiding"
else:
action = "forward"
self.state = "clear"
return {"layer": "Avoid", "action": action, "priority": 0,
"state": self.state,
"distances": {"front": front_dist, "left": left_dist, "right": right_dist}}
```
```
# 第 1 层:漫游——自带随机方向选择
class WanderLayer(BehaviorLayer):
def __init__(self):
super().__init__("Wander", priority=1)
self._counter = 0
def process(self, sensor_data: Dict) -> Dict:
self.activation_count += 1
self._counter += 1
if self._counter % 5 == 0:
import random
action = f"turn_{'left' if random.random() > 0.5 else 'right'}"
self.state = "wandering"
else:
action = "forward"
self.state = "moving"
return {"layer": "Wander", "action": action, "priority": 1, "state": self.state}
```
```
# 第 2 层:探索——自带目标方向计算
class ExploreLayer(BehaviorLayer):
def __init__(self, target: tuple = (10, 10)):
super().__init__("Explore", priority=2)
self.target = target
def process(self, sensor_data: Dict) -> Dict:
# 含部分世界模型:探索层直接计算目标方向
self.activation_count += 1
robot_pos = sensor_data.get("position", (0, 0))
dx = self.target[0] - robot_pos[0]
dy = self.target[1] - robot_pos[1]
if abs(dx) > abs(dy):
action = "move_east" if dx > 0 else "move_west"
else:
action = "move_north" if dy > 0 else "move_south"
self.state = "exploring"
return {"layer": "Explore", "action": action, "priority": 2,
"state": self.state, "target": self.target}
```
注意一个细节:ExploreLayer 直接计算目标方向,这意味着它”含部分世界模型”。这与 Brooks 1991 年的自我修正一致——纯反应式架构在探索层已需要某种形式的世界信息。
## 增量调试——从第 0 层到第 2 层的建造过程
Brooks 的方法论是增量调试:先建第 0 层,调通后加第 1 层,再加第 2 层。每加一层不修改既有层,增量建造,加层即增能力。
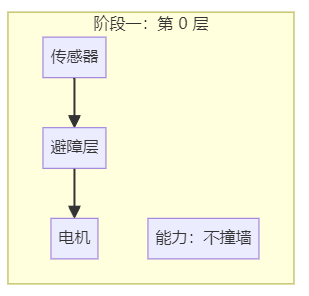
第 0 层是声纳避障。机器人检测前方障碍物,转向避开。单独调通,确保最基本的生存能力。
第 1 层是漫游。机器人随机选择方向移动。被第 0 层抑制时,避障优先。漫游层让机器人不再只走直线,而是开始探索环境。
第 2 层是探索。机器人朝目标方向移动。被第 0/1 层抑制时,避障/漫游优先。探索层赋予机器人目标导向能力。
实机验证:杂乱实验室环境中机器人靠第 0+1 层即可长时间漫游不撞。每加一层都是一次能力跃升,而不是对既有系统的重构。这个方法论预示了 Brooks 1991 年正式提出的”增量建造完整系统”原则。
## 对符号主义三个核心假设的否定
Subsumption 对符号主义的否定不是口号式的,而是工程式的——它在三个具体维度上取消了符号主义的核心假设。
第一个否定针对中央世界模型。STRIPS 的核心假设是智能需要一个中央世界模型——一组显式谓词集来表示环境状态。Brooks 的否定是直接的:不需要世界模型。感知直接耦合行动,不需要中间的”建模”步骤。因为没有世界模型需要维护,所以也不存在框架问题——不需要显式说明”什么变了/什么没变”。
第二个否定针对自上而下规划。STRIPS 的规划是自上而下的:先搜索一个完整的行动序列,然后逐步执行。如果执行中发现规划不适用,需要重新规划。Brooks 的否定是:不需要规划。行为层按优先级仲裁,感知直接驱动行动。没有”先规划后执行”的流水线,只有”感知即行动”的耦合。
第三个否定针对功能分解。传统 AI 的分解方式是按功能:感知模块、建模模块、规划模块、执行模块。这种分解的致命弱点是模块间串行依赖,必须全部建齐才能测试任何一个。Brooks 的替代是按行为/任务分解:避障行为、漫游行为、探索行为。每个行为自带从感知到行动的完整通路,可以独立测试和运行。
需要特别指出的是:1986 年的 subsumption 论文以工程鲁棒性论证的面目出现,而非哲学批判。Brooks 没有在 1986 年提出”无表征智能”的口号——最鲜明的哲学口号出自其 1987-1991 系列论文。1986 年论文的贡献是工程实证:证明感知-行动耦合可以在无中央模型的情况下实现鲁棒控制。
## 与 Shakey / STRIPS 的正面对照
STRIPS 和 subsumption 面对的是同一个问题——让机器人在环境中自主导航。但两条路线的设计哲学完全不同,我们可以用可视化的方式来对比:
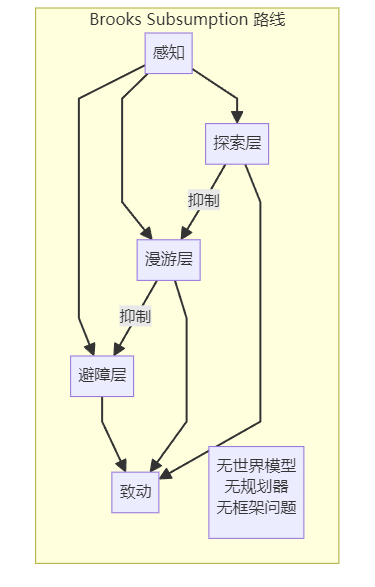
更详细的对比见下表:
维度STRIPS/ShakeyBrooks subsumption感知用途更新世界模型(谓词集)直接驱动行为层规划状态空间搜索(前向/逆向)无规划,按优先级仲裁世界模型显式谓词集(closed-world)无框架问题存在(需维护”什么变了”)不存在(不维护状态)降级方式规划失败→停止高层失效→低层照常运转能力边界积木世界等封闭世界有效“非常简单的智能水平”有效决策时机运行时动态搜索编译时静态接线计算开销模型更新 + 规划搜索零额外开销
框架问题在 subsumption 中不存在——但回避的方式是取消世界模型。因为没有世界模型需要维护,所以不存在”什么变了/什么没变”的问题。感知直接驱动行动,不需要在行动后更新任何状态。
但这个回避有代价。subsumption 只能在”非常简单的智能水平上”工作。复杂任务是否可以纯反应式完成?这是未解决的开放问题。
## 优雅降级——高层失效时低层照常运转
优雅降级是 subsumption 最引人注目的工程特性之一。因为每层都是独立的感知-行动闭环,高层失效不会拖累低层。探索层出问题了?漫游和避障还在工作。漫游层出问题了?避障还在工作。
我们的实验数据清晰地展示了这一特性:
> **优雅降级实验数据**
>
> 正常模式(三层全开):最终位置 (18.0, 18.0),碰撞 6 次,到达目标
>
> 降级模式(探索层失效):最终位置 (35.7, -9.1),碰撞 0 次,漫游+避障仍正常工作
探索层失效后,系统退化为漫游模式——机器人不再朝目标前进,但依然能四处游走且不撞墙。0 次碰撞的数据说明低层行为完全不受高层失效的影响。
这种降级方式与 STRIPS 形成鲜明对比。STRIPS 如果规划失败,整个系统就停住了——因为执行模块依赖规划输出,规划模块依赖世界模型,一环断裂全链瘫痪。Subsumption 的分层设计使得系统能力是”叠加”的而非”串联”的,失去高层只是失去高级能力,而非系统崩溃。
但优雅降级也有另一面。实验数据显示,多层叠加后碰撞率反而上升:避障层单独运行 0 碰撞,叠加漫游层后 1 次碰撞,叠加探索层后 6 次碰撞。这说明层间交互并非简单”叠加功能”——高层行为的目标导向可能与低层避障产生冲突,引入新的碰撞风险。
## Bar-Hillel 式批评——反应式控制的本质边界
Subsumption 的局限不是工程缺陷,而是反应式范式的结构性边界。从 Bar-Hillel 式批评的角度看,至少有三个本质性的问题。
第一个边界是反应式控制的有效范围。subsumption 在”非常简单的智能水平上”有效——避障、漫游、探索。但复杂任务呢?医学诊断需要推理链,定理证明需要搜索树,对话需要记忆历史。这些任务能否纯反应式完成?Brooks 本人在 1991 年承认了这个边界——”非常简单的智能水平上”这个限定词本身就是诚实的自我批评。subsumption 回避了复杂推理问题,而不是解决了它。
第二个边界是固定优先级无法运行时调整。subsumption 的仲裁由接线固定——抑制/禁止的优先级在编译时确定,运行时不可改变。这意味着系统无法根据环境动态调整行为优先级。在某些场景下避障应该优先,在另一些场景下探索目标可能更重要——但固定优先级的架构无法做出这种权衡。这比 STRIPS 的操作符模板更不灵活:STRIPS 的搜索器至少能在运行时选择不同操作序列,subsumption 的仲裁是静态的。
第三个边界是学习问题完全未触及。1986 年的 subsumption 论文完全没有触及学习问题——如何自动构造或修改行为模块?所有行为层都由工程师手工设计和接线,系统没有自适应能力。这个问题在 1987 年被 Brooks 明确推迟,直到 1990-91 年才给出学习四分类(且第四类”新行为模块”承认未攻克)。
## 与当代 Agent 的 BDI 坐标对照
从 BDI(信念-愿望-意图)框架来看,Brooks 1986 的 subsumption 与当代 LLM Agent 呈现出一种有趣的映射关系。两者都不依赖显式的世界模型,但方式和程度不同。
维度Brooks 1986 subsumptionLLM Agent 2026信念无世界模型,感知直接耦合行动无显式世界模型,参数隐含统计分布愿望无显式目标,行为层隐含目的system prompt 设定角色意图无规划,按优先级仲裁的感知-行为偶对ReAct 循环(但无显式规划树)意图编辑权工程师接线(编译时固定)工程师定义 tool/skill + 用户写 prompt状态更新无(不维护状态)context window(隐式状态)降级方式优雅降级(高层失效,低层照常)部分失效产生幻觉(非优雅)学习无(1986 年未触及)RLHF / fine-tuning
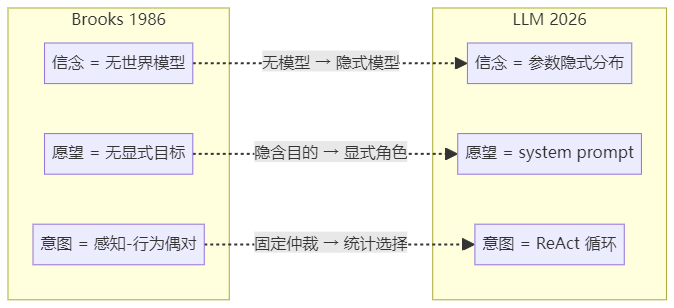
信念维度上,两者都拒绝显式世界模型,但 Brooks 是”完全没有”,LLM 是”参数中隐含统计分布”。愿望维度上,Brooks 的行为层只有隐含的目的,LLM 通过 system prompt 设定显式角色。意图维度上,Brooks 是固定优先级的感知-行为偶对,LLM 是统计选择的 ReAct 循环。
另一个有趣的对照是降级方式。subsumption 的降级是优雅的——高层失效低层照常。LLM 的降级是非优雅的——部分信息丢失后产生幻觉或错误回答。这说明虽然两者都走向了”无显式模型”的方向,但在鲁棒性设计上选择了不同的路径。
## 与同年 Minsky 的呼应——两条伏线的交叉
Minsky 和 Brooks 在同一年(1986)否定”单体”——但否定的维度不同。Minsky 从认知理论否定:单动因谬误,心智应拆为成百上千个小 agent。Brooks 从工程实证否定:不需要中央世界模型,感知直接耦合行动。
Minsky 拆解”单体大脑”的结构,Brooks 拆解”中央世界模型”的运作机制。两者从不同角度瓦解同一个范式。
但两者的交叉不只是概念相似。Brooks 在 1991 年《无表征智能》中主动引用 Minsky 心智社会作同类解释,这是两条伏线在原文层面的明文交叉点。结构上的去中心化(Minsky)和运作机制上的去中心化(Brooks),共同指向同一个方向——符号单体的消解。
## 小结:运作机制维度的反叛
Brooks 1986 年的 subsumption 架构是符号主义内部孕育的第二条反叛伏线。它否定的不是”符号”本身,而是”中央世界模型”和”自上而下规划”——符号主义运作机制的两个核心假设。
通过行为层分层和抑制/禁止仲裁,subsumption 证明了感知-行动耦合可以在无中央模型的情况下实现鲁棒控制。框架问题在 subsumption 中不存在——因为不维护世界模型。优雅降级的特性使得系统在部分失效时仍能运转。
但 subsumption 有其本质局限:只在”非常简单的智能水平上”有效,固定优先级无法运行时调整,学习问题完全未触及。这些局限不是工程缺陷,而是反应式范式的结构性边界——它们在 Brooks 1990-91 系列中被正面面对。
Brooks 的否定从运作机制维度击碎了符号单体的基石。与 Minsky 的结构维度否定、McCarthy 的接口维度否定,共同构成了三条反叛伏线。下一篇我们将进入 Brooks 1990-91 年的哲学化阶段——”无表征智能”口号的正式提出。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 你的大脑里住着一个小人吗——Minsky 说:不,住着成百上千个”笨蛋”
https://www.paddysun.top/archives/4997 · 2026-08-24
**系列名称**: [\[Agent 考古\] 符号单体时代:三条反叛伏线](https://www.paddysun.top/archives/4998)
**篇号**:第 9 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[MYCIN 1976](https://www.paddysun.top/archives/4987) · [三条反叛伏线总览](https://www.paddysun.top/?p=4998) **阅读时间**:约 14 分钟
---
如果有人告诉你,你的心智里住着一个小人,它在观看、在决策、在指挥你的一切行动,你大概会觉得这是一个过时的哲学比喻。但如果换一种说法——”我在思考””我决定了””我的选择”——这些日常表达的背后,不就预设了一个统一的”我”在做这一切吗?这个”我”是谁?它住在哪里?
Marvin Minsky 在 1986 年出版的《心智社会》(*The Society of Mind*)中,给出了一个惊世骇俗的回答:你的大脑里没有一个统一的小人。住着的,是成百上千个”笨蛋”——每个笨蛋只会做一件极其简单的事,它们之间互相协作、互相竞争,最终产生了我们称之为”智能”的东西。智能不在任何一个笨蛋身上,而在它们的组织方式之中。
这个回答不是哲学思辨,而是一个工程结论。Minsky 本人就是符号主义 AI 的奠基者之一——他提出了框架理论,参与了 MIT AI Lab 的创立。但到了 1986 年,他亲手否定了自己参与建立的范式:智能不可能由一个单一中央系统完成。这是三条反叛伏线中的第一条——从**结构维度**否定符号单体的集中式架构。
---
## 从积木机器人到心智社会——Minsky 的自我否定轨迹
《心智社会》的思想并非凭空而来。Minsky 在全书 2.5 节自述:全书思想直接源自 1960 年代 MIT 积木机器人的数百个小程序。那个时代的 MIT AI Lab,研究者们为了让机器人能够”看”积木、”抓”积木、”搭”积木,编写了大量各自独立的小程序——视觉检测、距离判断、手臂控制、抓取力度调节。每个小程序本身只完成一个简单功能,但它们组合在一起,就让机器人完成了看似需要”智能”的积木搭建任务。
这个工程经验埋下了《心智社会》的核心直觉:智能不需要一个中央统筹者,而是大量本身无智能的小程序的协作产物。
1974 年,Minsky 发表了 *A Framework for Representing Knowledge*(MIT AI Memo 306),提出了框架(frame)理论——一种用结构化数据槽(slots)表示 stereotyped 情境的知识表示方法。框架理论本质上仍属于符号主义阵营:知识以显式结构存储,推理通过槽的填充和继承完成。但从框架到心智社会,Minsky 完成了一次自我否定。框架理论仍然假设存在一个”中央知识库”——所有框架存放在一个统一系统中,推理在一个统一的引擎中进行。而《心智社会》否定了这个假设本身:不存在中央知识库,知识分散在成百上千个小 agent 中;不存在中央推理引擎,”推理”是多个 agent 协作与竞争的涌现产物。
这条轨迹揭示了一个深层辩证法:范式最深刻的否定者,往往从范式内部孕育。Minsky 不是从外部攻击符号主义——他本身就是符号主义的奠基者之一。他的否定不是”放弃符号”,而是”放弃单体”。
这与 Newell & Simon 1976 年提出的物理符号系统假设形成了精确的对位。物理符号系统假设声称”一个物理符号系统具有产生通用智能行为的充分必要条件”。Minsky 没有直接否定这个假设——他没有说”符号不是智能的基础”。他的否定更精确:即使符号是智能的基础,智能也不可能由一个单一中央符号系统完成。Logic Theorist 是一个单一搜索器——一个程序在一个状态空间中搜索解路径。Minsky 指出,这种”单一搜索器”模型是**单动因谬误**(Single-Agent Fallacy)的表现。
---
## 否定单一中央心智的三条递进论证
《心智社会》对”单一中央心智”的否定不是断言式的,而是通过三条环环相扣的递进论证完成的。每一步论证都比上一步更尖锐,最终共同推导出同一个结论:心智必须被拆解为本身无智能的小部件。
### 循环论证检验——你不能用智能解释智能
Minsky 在 1.1 节提出了一个根本性检验,它像一把剃刀一样切开了所有”中央自我”理论的伪装:
> “除非能用自身无思想无感受的东西解释心智,否则只是在兜圈子。”(1.1 原话)
这是一个循环论证检验:如果你把智能预置于解释单元内部——比如说”心智由一个智能的灵魂控制”——那你的解释什么也没做。你只是把待解释的东西(智能)藏到了一个更小的盒子里,然后假装已经解释了它。
这个检验的工程含义极为深刻。它意味着,任何声称”解释了智能”的理论,都必须满足一个硬性约束:其基本构件本身不能是智能的。如果构件本身是智能的,那这个理论只是在转移问题,而不是在解决问题。
用这个标准来看 MYCIN 的 600 条规则,问题立刻显现。MYCIN 把所有智能集中在一个规则库中,由一个反向链引擎统一推理。从 Minsky 的视角看,MYCIN 的”智能”全在那个引擎中——但那个引擎本身是智能的吗?如果是,那它又需要被解释。如果它不是智能的,那 600 条规则的智能从何而来?
### 小人无限回归——没有部件的东西无法解释
5.3 节给出了更尖锐的一击,直接攻击”脑中小人”的直觉:
> “认为你之内还住着替你做事的另一个人,这帮不上忙——homunculus 概念只会导致悖论,那个内在自我又需要自己脑中的一块银幕,如此重复不已。”(5.3 原话)
这就是经典的小人(homunculus)无限回归:如果你假设心智内部有一个”小人”在观看、在决策,那这个小人的心智又由谁控制?另一个更小的小人?如此无限倒退,什么也没有解释。
关键一击紧随其后,这句话是整个论证的枢纽:
> “单一中央自我的概念什么也解释不了——一个没有部件的东西提供不了任何可充作解释的构件。”(5.3 原话)
“没有部件的东西无法提供解释构件”——反过来说,只有可以被拆解为部件的东西才能作为解释的基础。这就强制要求:心智必须被拆解为本身无智能的小 agent。不是因为我们”喜欢”分布式架构,而是因为不拆解就会陷入循环论证或无限回归。这不是一个审美选择,而是一个逻辑必然。
### 单动因谬误——无用假设的剃除
30.6–30.7 节完成了第三步论证,给这个谬误正式命名:
> 意志自由”根本没有容身之处”,人们”设定一个空洞的第三选项”——中央自我是不断缩小的空白假设。
Minsky 的剃除逻辑是奥卡姆式的:如果”中央自我”这个假设不产生任何可观测的解释构件——它不预测任何行为、不指导任何推理、不提供任何可操作的机制——那它就是一个无用的假设,应当被剃除。
Minsky 在词汇表中为这个谬误正式命名:**单动因谬误**(Single-Agent Fallacy)——将复杂行为归因于单一中央动因的错误。这是他对符号主义”单体大脑”范式的正式批判术语。Logic Theorist 的单一搜索器、MYCIN 的单一推理引擎、STRIPS 的单一规划器——统统落入了这个谬误的范畴。
---
## 心智社会的组织方式——Agent、Agency 与八种协作构件
否定了单一中央心智之后,Minsky 必须回答一个更难的问题:如果心智是社会,那这个社会是怎么组织起来的?他给出了两个核心概念和八种实名协作构件。
### Agent 与 Agency——双视角的核心定义
Minsky 在词汇表中定义了两个核心概念:
- **Agent**:心智中本身简单到可被理解的部分或过程。每个 agent 本身无智能——它只完成一个简单的机械操作。
- **Agency**:被视为一个单元看其能成的部件集合。
我们可以直接从 Python 复现代码中看到这两个概念的最小实现。`agent.py` 中的 `Agent` 类严格遵循了”本身无智能”的纪律——每个 agent 只有一个 `action` 函数,激活时执行一个简单操作,然后退出。没有推理,没有学习,没有目标。
```
# 摘自 society/agent.py —— 最小 Agent 定义
class Agent:
"""心智中本身简单到可被理解的部分或过程。
每个 agent 本身无智能——它只完成一个简单的机械操作。
防循环纪律:确保没有一个 agent 本身是智能的。
"""
def __init__(self, name: str, action: Callable[[Dict], Any],
description: str = ""):
self.name = name
self.action = action
self.description = description
self.activation_count = 0
self.is_active = False
def activate(self, context: Dict) -> Any:
self.activation_count += 1
self.is_active = True
result = self.action(context)
self.is_active = False
return result
```
以 Builder 搭塔为例,五个 agent 各司其职:See 检测积木位置、Get 定位可抓取积木、Move 移动手臂、Grasp 抓取积木、Place 放置积木。每个 agent 的 `action` 函数都只有几行代码,完成一个极其具体的机械操作。没有一个 agent”知道”自己在搭塔——它们甚至不知道其他 agent 的存在。
`agency.py` 中的 `Agency` 类则体现了”部件集合”的概念——一组 agent 被打包成一个机构,对外表现为一个功能单元。
```
# 摘自 society/agency.py —— Agency 定义
class Agency:
"""被视为一个单元看其能成的部件集合。
1.6 双视角原话:"作为机构它似乎懂行,作为 agent 它一无所知。"
"""
def __init__(self, name: str, agents: List[Agent]):
self.name = name
self.agents = list(agents)
self._conflict_level = 0
def execute(self, context: dict) -> dict:
for agent in self.agents:
context = agent.activate(context)
return context
```
关键的是 1.6 节的双视角原话,它揭示了心智社会最核心的结构性事实:
> “作为机构它似乎懂行,作为 agent 它一无所知。”(1.6 原话)
智能不在任何单个 agent 中,而在 agent 的组织方式中。一个由本身无智能的 agent 组成的机构,对外表现为”懂行”——但这种”懂行”不是任何单个 agent 的属性,而是组织结构本身的涌现属性。这与 STRIPS 的操作符形成鲜明对照:STRIPS 的每个操作符本身是完整定义的,而 Minsky 的 agent 本身”一无所知”,它的”能力”只在机构语境中才显现。
Minsky 设定了一条严格的防循环纪律:每一步都必须核查,确保没有一个 agent 本身是智能的。这条纪律是循环论证检验的工程化——如果在拆解过程中发现某个 agent”是智能的”,那这个 agent 本身需要被进一步拆解。只有当所有 agent 都是本身无智能的机械单元时,解释才算完成。
### 八种协作构件——从分层到 B 脑
Minsky 没有停留在”拆解”层面,他给出了具体的协作机制——全部是书中的实名构件。下面这张图展示了这些构件如何共同构成心智社会的组织架构:
这八种构件覆盖了组织结构、冲突处理、记忆机制、安全审查、反思监控和目标驱动六个层面。它们共同回答了一个问题:一群本身无智能的小 agent,如何通过组织协作产生智能行为?
但请注意——这个回答本身有一个重要的局限。这些构件如何相互协调?Minsky 的回答是”共处一脑的情境浸润”——agent 们因为共存于同一个心智中而自然协调。但”情境浸润”是什么?它是一个可操作的算法,还是一个比喻?这个问题我们留到后面的 Bar-Hillel 式批评中展开。
---
## 差动机与意图的机构化降解——Builder 真有目标吗
传统符号单体(如 STRIPS)的意图是显式的:一个目标状态(谓词集),一个规划序列(操作符列表),由搜索器在状态空间中寻找路径。机器”知道”自己在做什么——目标在数据结构中显式表示。
Minsky 的差动机(difference-engine)完全不同。它不是”有目标的 agent”,而是一个机械的消差循环。
### 消差循环的机械本质
7.8–7.9 节的差动机包含四个要素:期望态(一个描述)、当前态(持续感知的实时状态)、差异(期望与当前的差)、消差(激活能减小该差异的 agent)。这是一个机械循环:检测差异 → 激活 agent → 差异减小 → 继续检测。没有”规划”,没有”意图”,没有”知道自己在做什么”——只有消差循环。
`difference_engine.py` 完整实现了这个机制。`DifferenceEngine` 类接收三个函数:获取当前态、获取期望态、计算差异。每次调用 `compute_difference` 就执行一次比较,然后把结果记入历史。没有目标表征,没有规划推理,只有持续的比较。
```
# 摘自 society/difference_engine.py —— 差动机核心
class DifferenceEngine:
"""持续比较期望态与当前态,检测差异,激活 agent 消除差异。
差动机不是"有目标的 agent"——它是机械的消差循环。
"目标"是观察者赋予的描述,不是机器的内部状态。
"""
def __init__(self, name: str, get_current: Callable[[Dict], Any],
get_expected: Callable[[Dict], Any],
get_difference: Callable[[Any, Any], float]):
self.name = name
self.get_current = get_current
self.get_expected = get_expected
self.get_difference = get_difference
self.history: list = []
self.iteration = 0
def compute_difference(self, context: Dict) -> float:
current = self.get_current(context)
expected = self.get_expected(context)
diff = self.get_difference(current, expected)
self.history.append({
"iteration": self.iteration,
"current": current,
"expected": expected,
"difference": diff
})
self.iteration += 1
return diff
```
在 Builder 搭塔的场景中,差动机根据当前状态动态选择激活哪个 agent——不是按照固定的 See→Get→Move→Grasp→Place 顺序,而是根据”缺什么补什么”的原则。没看见积木就激活 See,没选定目标就激活 Get,手臂没到位就激活 Move,没抓取就激活 Grasp,已抓取就激活 Place。整个过程没有任何一个 agent”知道”搭塔这个目标——它们只是响应差异、执行操作、然后退出。
下面这张图展示了差动机驱动搭塔的完整消差过程:
### “目标”只存在于观察者心中
7.8–7.9 节的关键原话是整个意图降解论证的枢纽:
> “Builder 真有目标吗……只存在于某个观察者心中。”(7.8–7.9 原话)
Builder 看起来”有目标”——它在搭塔。但从 Builder 内部看,没有任何 agent “知道”目标是搭塔——差动机只是在持续消差,See agent 在检测位置,Get agent 在定位,Move agent 在移动,Grasp agent 在抓取,Place agent 在放置。每个 agent 只做自己那一件简单的事。”搭塔”这个”目标”是**观察者赋予的描述**——观察者看到 Builder 的行为,将其描述为”搭塔”。但 Builder 内部不存在”搭塔”这个表征。
我们的 Python 复现实验验证了这一点。在 seed=42 的单次运行中,Builder 用 13 次迭代成功搭建了 3 层塔,agent 总共被激活了 12 次,分布在 5 类 agent 上(See 1 次、Get 3 次、Move 2 次、Grasp 3 次、Place 3 次)。差动机的消差轨迹清晰可辨:差异从 3 递减到 2、再到 1、最后到 0。但整个过程中,没有任何地方存储了”搭塔”这个目标——只有差异检测和 agent 激活。
指标实验值积木数量3搭塔结果3 层(成功)迭代次数13Agent 激活总次数12差动机消差轨迹差异 3 → 2 → 1 → 0
消差循环每次递减 1,4 次循环后差异归零。差动机内部无”搭塔”显式表征,只有差异检测与 agent 激活。这正是 Minsky 所说的——”目标只存在于某个观察者心中”。
Minsky 的”目标只存在于观察者心中”与 Brooks 1991 年的”中心性是观察者的赋予”互为镜像。两者从不同角度否定了同一个符号主义基石:意图是机器内部的真实状态。在 Minsky 和 Brooks 看来,意图是观察者的描述框架,不是机器的内部状态。这也是为什么《无表征智能》§5.1 直接引 Minsky 心智社会作同类解释——两条伏线在原文层面的明文交叉点。
---
## 审查器谱系——从安全过滤到提前偏转
审查器谱系是 Minsky 八种协作构件中特别值得展开的一个,因为它与当代 Agent 的安全机制有着惊人的结构相似性。Minsky 区分了两种类型的审查器:Suppressor(抑制器)和 Censor(审查器)。
Suppressor 是事后打断:当某个 agent 序列导致不良结果时,suppressor 记录”这个序列不要再来”,下次类似序列启动时在中途打断。Censor 则是提前偏转:当检测到某个序列即将启动时,censor 提前偏转注意力,让序列根本不开始。Minsky 称”每人积累数以百万计的 censor 记忆”。
`censor.py` 的实现清晰展示了两者的区别。`Suppressor` 维护一个不良序列列表,每次新序列启动时,检查它是否以某个不良序列开头——如果是,就打断。`Censor` 则维护一个触发模式表,当检测到触发模式时,直接返回一个重定向目标,让注意力提前偏转。
```
# 摘自 society/censor.py —— 审查器谱系
class Suppressor:
"""事后打断:当某个 agent 序列导致不良结果时记录并打断。"""
def __init__(self):
self._bad_sequences: List[List[str]] = []
def record_bad_sequence(self, sequence: List[str]):
self._bad_sequences.append(list(sequence))
def should_interrupt(self, current_sequence: List[str]) -> bool:
for bad in self._bad_sequences:
if len(bad) <= len(current_sequence):
if current_sequence[:len(bad)] == bad:
return True
return False
class Censor:
"""提前偏转:当检测到某个序列即将启动时提前偏转注意力。"""
def __init__(self):
self._trigger_patterns: Dict[str, str] = {}
def register_trigger(self, trigger: str, redirect_to: str):
self._trigger_patterns[trigger] = redirect_to
def check(self, context: Dict) -> str:
for trigger, redirect in self._trigger_patterns.items():
if trigger in str(context):
return redirect
return ""
```
这个机制预示了现代 Agent 的安全过滤——LLM 的 safety filter / guardrail 本质上是一种 censor:在不良输出生成之前就将其偏转。区别在于,Minsky 的 censor 是心智内部的自我审查机制,而 LLM 的 safety filter 是外部施加的安全层。但结构上,两者都是”提前偏转”的思路——不让不良行为发生,而不是等发生了再纠正。
我们的审查器学习实验记录了以下数据:
指标实验值审查器规则数2抑制器记忆数3测试序列被打断3/3
所有测试的不良序列都被成功打断,验证了审查器谱系的基本功能。
---
## 涌现的准确口径——多样性而非同质堆叠
通行说法称 Minsky 主张心智由”无数无心智小 Agent”组成。但原文核验表明,”无数”无原文支撑。书中的量级表述全部是下限式:1.3 节端一杯茶场景说”至少上百个”agent 与”上千个”肌肉系统,1.4 节说”图中画不下”,2.5 节机器人工程自述说”数百个小程序”。
因此准确的表述应为:心智由**大量**(成百上千)本身无智能的小 agent 组成,而非”无数”。这个勘误不是吹毛求疵——它关系到 Minsky 理论的性质:如果 agent 数量是”无数”,暗示同质堆叠;如果是”成百上千”的下限式,暗示的是异质多样性的协作。
全书 25 处 emerge(涌现)皆用于描述具体机能,从无一处是”智能从简单单元交互中涌现”的笼统表述。收束句 30.8 给出了准确的涌现口径,这段话值得用最大号的引用块来呈现:
> “魔法诀窍在于没有诀窍。智能之力源自我们庞大的多样性,而非任何单一完美的原理……我们的行动与决策极少依赖任何单一机制,它们从过程社会的冲突与协商中涌现。”(30.8 原话)
这段话有三个要点,每一个都对流行的”涌现”概念构成了修正。第一,**没有诀窍**——不存在单一的秘密机制。第二,**多样性而非单一原理**——智能的力量来自异质性的积累。第三,**冲突与协商**——涌现的机制是 agent 间的冲突和协商,不是和谐协作。
第三点尤其重要:Minsky 的涌现不是”和谐协作的涌现”,而是”冲突与协商的涌现”。不妥协原则(3.2)正是这个机制的体现——内部冲突不是要消除的噪音,而是智能运作的必要条件。这与流行观念中”涌现 = 大量简单单元和谐协作”的想象截然不同。Minsky 的心智社会不是一个和谐的公社,而是一个充满竞争和博弈的议会。
---
## BDI 坐标对照——心智社会与 LLM 多头注意力的结构同构
如果用 BDI 框架来衡量心智社会,我们会发现它与当代 LLM Agent 之间存在着惊人的结构同构。两者都否认中央知识库,都将信念分布在大量子单元中,都将目标处理为期望态加持续消差,都将意图降解为观察者的描述。
维度Minsky 1986 心智社会LLM Agent 2026信念分布于成百上千个小 agent 中,无中央知识库分布于注意力头/专家层中,无中央知识库愿望差动机的期望态(机构级,非显式目标)RLHF 奖励函数(期望态 + 持续消差)意图消差循环(机构化降解,”只存在于观察者心中”)token 生成(统计消差,”意图”是观察者描述)意图编辑权工程师定义 agent 结构 + 差动机参数工程师定义模型架构 + 奖励函数世界模型无中央模型,分布于各 agent 的局部感知中无中央模型,分布于注意力权重中降级方式部分失效时优雅降级部分失效时产生幻觉(非优雅降级)审查机制censor/suppressor 谱系safety filter / guardrail反思B 脑可无限加层self-reflection step(计算成本限制层数)
两者的结构同构令人瞩目。信念都分布在大量子单元中,愿望都以期望态加持续消差的形式存在,意图都是观察者赋予的描述而非系统的内部状态。但这种同构也伴随着一个关键差异——降级方式的不同。
---
## 社会与单体的故障行为对比——优雅降级还是彻底失效
Minsky 声称心智社会在部分 agent 失效时能**优雅降级**——高层失效时低层照常运转。这是因为 agent 间的耦合是局部的:一个 agent 失效只影响直接依赖它的机构,不影响整个系统。这与符号单体的”脆性”形成鲜明对比——单体的核心部件失效会导致整个系统崩溃。
我们用 Builder 搭塔任务做了对照实验:正常的心智社会模式 vs 单体模式(Move agent 故障)。结果如下:
模式塔高迭代次数最终差异状态心智社会(正常)3130目标达成单体(Move 故障)0203无法收敛
实验数据揭示了一个比预想更微妙的结果。Move 故障后,社会模式的塔高同样为 0(而非部分保持),差异维持在 3 无法收敛。这说明”优雅降级”在搭塔任务中**未体现为功能保持**——缺乏 Move agent 后消差循环确实无法完成。但社会模式与单体模式的差异在于:差动机仍在运转,每次迭代仍检测差异并尝试激活 agent——系统不崩溃,只是功能无法达成。而单体模式则是整条规划链断裂,系统彻底卡住。
换句话说,心智社会的”优雅降级”在搭塔任务中体现为”系统不崩溃但功能不保持”,而非”部分功能继续有效”。这个意外发现修正了对 Minsky 优雅降级论断的简单理解——降级的”优雅”体现在系统韧性上(不崩溃、持续尝试),而非功能保持上。
---
## Bar-Hillel 式批评——协调机制不可操作的根本困境
Minsky 给出了八种协作构件,但这些构件本身如何协调?这是心智社会理论最脆弱的地方。Minsky 的回答是”共处一脑的情境浸润”——agent 们因为共存于同一个心智中而自然协调。
但”情境浸润”是什么?它不是一个可操作的算法——它是一个比喻。Bar-Hillel 式的批评在这里精准命中:如果协调机制不能被精确形式化,那它就不是一个工程方案,而是一个修辞。
这个批评与 McCarthy 在 Advice Taker 中面临的 Bar-Hillel 批评形成了精确的对位。McCarthy 的问题是”前提选择不能自动完成”——你怎么知道该从知识库中选哪些前提来推理?Minsky 的问题是”协调机制不能自动实现”——你怎么知道该激活哪些 agent、抑制哪些 agent?两者都面临同一个根本困难:从全局看,选择机制本身需要智能,但根据循环论证检验,选择机制又不能是智能的——否则就回到了单动因谬误。
这就是心智社会的本质困境:它用 agent 的多样性解释了智能的涌现,但 agent 之间的协调机制本身又需要一个”协调者”——而协调者要么是另一个智能体(陷入循环论证),要么是一个不可操作的比喻(情境浸润)。Minsky 没有给出第三条路。
---
## 思想先声而非概念母体——Minsky 的真实影响边界
通行说法称 Minsky 的心智社会是后世多智能体系统(MAS)的”概念母体”。但原文核验表明,这个说法需要降级。
Minsky 的 agent 是**单一心智内部的子结构**。词汇表定义 agent 为”心智的部分或过程”;21.4 节原话”像 Get 这样的小机构无法解析这样的表达”,其协调靠共处一脑的情境浸润而非消息协议。全书无任何跨网络独立软件实体协作的场景。
Wooldridge & Jennings 1995 的 agent 是**网络上的自主软件实体**——它们通过消息协议通信,具有自主性、社会性、反应性、主动性。从”脑内小机构”到”网络节点”的对象转换,是阶段三(W&J 1995)自己的贡献,不是 Minsky 的。
因此准确的表述是:Minsky 的心智社会是后世多智能体系统的”思想先声”,而非”直接母体”。两者共享”无智能单元协作涌现”的直觉,但对象层级不同。
Minsky 也没有直接影响 Brooks 的 subsumption 架构——Brooks 的行为层是机器人上的独立控制系统,不是心智内部的 agent。但 Brooks 在《无表征智能》§5.1 **主动引用**了 Minsky——这是两条伏线在原文层面的明文交叉点,是”中强”级影响(同一研究语境的概念互引,非直接技术传承)。
Minsky 自己在后记中诚实地定位了全书的性质:
> 本书应”少当科学论著、多当想象的探险故事”来读。
这不是谦虚——这是对理论性质的诚实声明。《心智社会》提供的是一种**思维方式**,不是一个可执行的工程方案。它与 STRIPS(可运行的规划器)、MYCIN(可运行的诊断系统)有本质区别:后两者是工程系统,前者是概念框架。
但 Minsky 随即加上了断言:
> “任何有心智的脑、机器或其他东西,必定由本身完全不能思考的更小东西组成。”
这个断言是一个**结构性约束**——不是工程方案,而是任何智能系统的必要结构条件。这个约束是否成立,至今仍是开放问题。
---
## 结构维度的反叛——从单体大脑到心智社会
Minsky 1986《心智社会》是符号主义内部孕育的第一条反叛伏线。它否定的不是”符号”本身,而是”单体”——将智能归因于一个中央统筹者的单动因谬误。
三条递进论证(循环论证检验 → 小人无限回归 → 无用假设剃除)构成了否定的逻辑骨架,每一步都比上一步更尖锐,最终共同推导出”心智必须拆为本身无智能的小 agent”的结论。八种实名协作构件给出了替代方案的具体内容——从分层异层到 K 线记忆,从审查器谱系到 B 脑反思,从差动机到不妥协原则。差动机的机构化降解重新定义了”意图”——从”机器知道自己在做什么”变为”观察者赋予的描述”。
但心智社会也有其本质局限:协调机制(情境浸润)不可操作,工程方案缺失,是”思想先声”而非”概念母体”。Minsky 自己诚实地将全书定位为”想象的探险故事”而非科学论著——但这不妨碍他的结构性约束断言(”任何有心智的东西必定由本身不能思考的更小东西组成”)成为持续影响 AI 研究的深层命题。
Minsky 的否定从**结构维度**击碎了符号单体的基石——与 McCarthy 的接口维度否定、Brooks 的运作机制否定,共同构成了三条反叛伏线。三条伏线从不同方向瓦解了”目标驱动的符号单体”这一第一组织形式,为下一阶段的范式转换埋下了伏笔。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 600 条规则,一个反向推理引擎——专家系统的顶峰是怎么建成又怎么暴露边界的
https://www.paddysun.top/archives/4987 · 2026-08-23
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)
**篇号**:第 8 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[ELIZA 1966](https://www.paddysun.top/archives/4980) · [STRIPS 1971](https://www.paddysun.top/archives/4968) **阅读时间**:约 12 分钟
---
1970 年代初,Stanford University 的医学与计算机科学交叉研究团队面临一个实际问题:感染性疾病的诊断需要大量专业知识——细菌类型、革兰氏染色、形态、需氧性、药物敏感性——而这些知识在一般医生中并不普及。Edward Shortliffe,一位同时拥有医学博士和计算机科学背景的研究者,将这两条线交汇于 MYCIN shortliffe1976。
600 条规则,一个反向推理引擎,加上一套确定性因子计算框架——这就是 MYCIN 的全部。它能在菌血症这个医学子域中给出可追溯的诊断和治疗建议,其诊断准确率达到了与感染病专科医生相当的水平。然而,正是这个被视为专家系统顶峰的项目,最清晰地暴露了符号主义范式的边界:规则数量增长带来的知识获取瓶颈、规则间交互的不可预测性,以及”选择哪些规则适用于当前患者”这一前提选择难题。
本篇将拆解 MYCIN 的技术构造——从规则结构到确定性因子,从反向链推理到上下文树——并探讨它为何在登上顶峰的同时,也为符号主义的衰落埋下了伏笔。
---
## 从 DENDRAL 到 MYCIN——启发式规则的谱系延续
MYCIN 不是凭空出现的。它的前身是 DENDRAL——Stanford 的第一个专家系统,用于从质谱数据推断分子结构。DENDRAL 确立了”知识工程”的基本范式:将专家的知识编码为规则,让计算机按规则推理。MYCIN 将这一范式从化学结构推断转移到医学诊断 buchanan-shortliffe1984。
1980 年,William van Melle 将 MYCIN 的规则引擎从医学知识库中分离出来,形成了 EMYCIN(Essential MYCIN)——一个通用的规则系统外壳 vanmelle1980。EMYCIN 证明了 MYCIN 的架构不限于医学诊断——任何领域只要有可编码的规则,就能用 EMYCIN 构建专家系统。这是”陈述句告知”范式的一次规模化尝试。
MYCIN 的意义在于,它第一次在高风险的医学领域证明了符号规则系统的实用价值。医生可以通过自然语言问答与系统交互,系统会给出诊断结论、置信度以及完整的推理链条。这种可解释性是 MYCIN 获得医生信任的关键,也是它与后来黑箱式 AI 系统最本质的区别。
---
## MYCIN 系统的整体架构——上下文树、规则库与推理引擎的协作
MYCIN 的系统架构由四个核心部分组成:上下文树、规则库、反向链推理引擎和用户交互接口。推理在上下文树的节点上进行——先确定患者有哪些培养物,再确定每个培养物中有哪些病原体,最后对每个病原体推断其身份。
```
患者 (PATIENT)
└── 培养物 (CULTURE)
└── 病原体 (ORGANISM)
├── 革兰氏染色
├── 形态
├── 需氧性
└── ...
```
这种层级结构确保了推理的有序性——系统不会在确定培养物之前就去推断病原体身份。上下文树既是知识的组织结构,也是推理的控制结构。
---
## 规则的基本形态——IF 前提 THEN 结论 WITH 置信度
MYCIN 的知识以规则的形式存储,每条规则遵循统一的三段式结构:前提、结论、置信度。Shortliffe 从感染病专家那里获取知识,然后将每一条临床经验转化为一条形式化的规则 shortliffe1976。
```
RULE 050
IF (1) the gram stain of the organism is gramneg
(2) the morphology of the organism is rod
(3) the aerobicity of the organism is aerobic
THEN there is suggestive evidence (0.8) that
the identity of the organism is enterobacteriaceae
```
在我们的 Python 复现中,`Rule` 类精确地映射了这一结构。每条规则包含一个唯一标识符、一组前提条件(键值对列表)、一个结论(属性-值元组)和一个置信度数值。
```
# 摘自 mycin/rule.py —— Rule 类定义
class Rule:
def __init__(self, rule_id: str, premises: list, conclusion: tuple, cf: float):
self.rule_id = rule_id # 规则编号,如 "RULE_050"
self.premises = premises # 前提列表,如 [("gram_stain", "gramneg"), ...]
self.conclusion = conclusion # 结论,如 ("identity", "enterobacteriaceae")
self.cf = cf # 规则置信度,如 0.8
def evaluate_premises(self, facts: dict):
"""检查所有前提是否满足,返回 (是否满足, 各前提详情)"""
results = []
all_satisfied = True
for attr, expected in self.premises:
if attr not in facts:
results.append((attr, expected, None, 0.0))
all_satisfied = False
else:
actual, cf = facts[attr]
match = (actual == expected)
results.append((attr, expected, actual, cf))
if not match:
all_satisfied = False
return all_satisfied, results
```
规则库中的一条示例规则——RULE_050,对应原文中那条经典的肠杆菌科诊断规则:
```
# 摘自 mycin/knowledge_base.py —— 示例规则
Rule("RULE_050",
[("gram_stain", "gramneg"), # 革兰氏染色阴性
("morphology", "rod"), # 形态为杆状
("aerobicity", "aerobic")], # 需氧性为需氧
("identity", "enterobacteriaceae"), # 结论:肠杆菌科
0.8) # 置信度 0.8
```
这个数据结构的简洁性正是 MYCIN 的力量所在——每一条医学知识都被拆解为相同的格式,使得通用推理引擎可以不加修改地应用于所有规则。
---
## 确定性因子——为什么医生不用概率
MYCIN 最独特的设计是确定性因子(Certainty Factor,简称 CF)。CF 不是概率,它不满足概率公理,而是 Shortliffe 为医学诊断场景量身定制的不确定性表示方法 shortliffe-buchanan1975。
CF 的定义基于两个独立的度量:
```
CF[h, e] = MB[h, e] - MD[h, e]
```
其中 **MB**(Measure of Belief)是证据 e 对假设 h 的支持程度,**MD**(Measure of Disbelief)是证据 e 对假设 h 的反对程度。两者独立计算,意味着系统可以”既支持又反对”同一个假设——这在概率论中是不可能的,但在临床思维中却很常见。
CF 的计算包含三个核心操作,都在 `cf_engine.py` 中实现:
```
# 摘自 mycin/cf_engine.py —— CF 计算核心函数
class CFEngine:
@staticmethod
def combine_premises(premise_cfs: list) -> float:
"""前提组合:取最弱链(min)"""
if not premise_cfs:
return 0.0
return min(premise_cfs)
@staticmethod
def propagate(rule_cf: float, premise_cf: float) -> float:
"""规则传播:结论 CF = 规则 CF × 前提 CF"""
return rule_cf * premise_cf
@staticmethod
def combine_conclusions(cf1: float, cf2: float) -> float:
"""多规则合并:CF1 + CF2 × (1 - |CF1|)"""
if cf1 >= 0 and cf2 >= 0:
return cf1 + cf2 * (1 - cf1)
elif cf1 < 0 and cf2 < 0:
return cf1 + cf2 * (1 + abs(cf1))
else:
return (cf1 + cf2) / (1 - min(abs(cf1), abs(cf2)))
```
用一个具体的数值例子来说明。假设患者 A 的检测结果全部确定(各前提 CF = 1.0),有两条规则都指向肠杆菌科:
- RULE_050:CF = 0.8(革兰氏阴性 + 杆状 + 需氧)
- RULE_045:CF = 0.9(革兰氏阴性 + 杆状 + 需氧 + 尿液来源)
第一步,前提组合。RULE_050 有三个前提,CF 分别为 1.0、1.0、1.0,取 min 得前提 CF = 1.0。
第二步,规则传播。RULE_050 的结论 CF = 0.8 × 1.0 = 0.8。
第三步,多规则合并。两条规则都支持同一结论:
- 合并 CF = 0.8 + 0.9 × (1 – 0.8) = 0.8 + 0.18 = 0.98
最终诊断:enterobacteriaceae,CF = 0.98。
这个结果来自我们的复现实验——患者 A 的实际诊断 CF 就是 0.98,与计算完全一致。
Shortliffe 选择 CF 而非贝叶斯概率有四个核心理由 shortliffe-buchanan1975。第一,医生的不确定性不是概率性的——医生说”很可能是”时,并不等于 P=0.7,这个数字没有精确的统计学含义。第二,贝叶斯推理需要先验概率,而在很多临床场景中先验概率不可用或难以估计。第三,CF 允许信任与不信任同时存在——MB 和 MD 独立计算,更符合医生”证据有好有坏”的思维方式。第四,CF 的可解释性更强——医生可以理解 CF=0.8 的含义,但难以理解 P=0.73 的精确统计学意义。
CF 与贝叶斯的真正差异不在结论合并,而在前提组合。CF 取最弱链(min),概率取乘法。当两个前提的 CF 都是 0.5 时,CF 框架下前提组合 CF = 0.5,而概率论下联合概率 = 0.25——差异高达 0.25。这意味着 MYCIN 系统性地高估了多前提规则的可信度,但 Shortliffe 认为这种”高估”恰恰更接近医生的实际判断方式。
---
## 反向链推理——从假设追溯到证据的递归过程
MYCIN 的推理方向是反向链(backward chaining):从一个假设出发,倒过来寻找支持这个假设的证据。这与 Logic Theorist 的分离法结构同构——LT 从目标 C 出发,找 A⊃C,证 A;MYCIN 从假设 H 出发,找规则 R(H),查 R 的前提。
反向链的核心循环在 `backward_chain.py` 的 `diagnose` 方法中实现。它遍历所有规则,找出结论匹配目标属性的那些,逐一检查前提,计算置信度,最后合并结果。
```
# 摘自 mycin/backward_chain.py —— 反向链核心循环
class BackwardChainer:
def diagnose(self, facts: dict, target_attr: str = "identity") -> dict:
conclusions = {}
# 第一步:遍历所有规则,找出结论匹配目标属性的规则
for rule in self.rules:
attr, val = rule.conclusion
if attr != target_attr:
continue
# 第二步:检查规则的所有前提是否满足
satisfied, premise_results = rule.evaluate_premises(facts)
if not satisfied:
continue
# 第三步:计算前提组合 CF → 传播 → 积累
premise_cfs = [cf for _, _, _, cf in premise_results]
combined_premise_cf = CFEngine.combine_premises(premise_cfs)
conclusion_cf = CFEngine.propagate(rule.cf, combined_premise_cf)
if val not in conclusions:
conclusions[val] = []
conclusions[val].append((rule.rule_id, conclusion_cf))
# 第四步:合并多条规则的 CF,得出最终结论
final = {}
for val, rule_results in conclusions.items():
cfs = [cf for _, cf in rule_results]
combined_cf = CFEngine.combine_multiple(cfs)
final[val] = {'cf': combined_cf, 'rules': rule_results}
return final
```
这个过程的关键特征是”假设驱动”——系统不是盲目地从事实出发推导所有可能的结论,而是从一个具体的诊断假设出发,有目的地寻找支持或反对该假设的证据。当某个前提未知时,系统会精准地向用户提问,而不是问一堆无关的问题。这就是 MYCIN 交互体验自然流畅的原因。
完整的反向链推理树呈现出”目标 → 规则 → 前提 → 事实”的层级结构。以患者 A 的诊断为例:
每一步都可追溯,每一个数字都有来源——这就是 MYCIN 可解释性的来源。
---
## 600 条规则的代价——知识获取瓶颈与规则爆炸
MYCIN 的规则库包含约 600 条规则,覆盖了”菌血症”这一个医学子域 shortliffe1976。600 条听起来不多,但每一条规则都需要经历从专家访谈、知识提炼、形式化编码到验证调试的完整流程。这不是编程问题,而是知识工程问题。

规则爆炸体现在三个层面。第一是**知识获取瓶颈**——每条规则需要专家手动编码,专家的时间昂贵,编码过程缓慢,而且专家往往无法准确表达自己的推理过程——”直觉”和”经验”难以形式化为规则。第二是**规则间交互不可预测**——新增规则可能破坏已有推理。如果规则 A 推出”organism 是 X”(CF=0.8),新增规则 B 推出”organism 是 Y”(CF=0.7),系统需要判断 X 和 Y 是否互斥——这在 CF 框架中没有自动机制处理。第三是**规模化困难**——600 条规则覆盖一个子域,扩展到其他感染类型需要数千条规则,而规则数量的增长与维护复杂度的增长不是线性关系。
这正是 Bar-Hillel 1958 年的批评在医学诊断中的体现。Bar-Hillel 说”前提选择比演绎难 10^10 个数量级”——演绎不难,难的是在海量前提中找到与当前问题相关的那几条。MYCIN 的规则爆炸把这个问题具体化了:CF 计算和反向链是简单算法(演绎不难),但**在 600 条规则中选择哪些适用于当前患者**才是真正的瓶颈(前提选择困难)。
换句话说,”规则选择”就是”前提选择”的工程化版本。演绎引擎可以机械地执行,但哪些规则应该被激活、哪些前提应该被检查、在什么上下文中应用什么知识——这些才是知识工程真正困难的地方。600 条规则覆盖一个子域已经需要一个团队数年的努力,那么覆盖整个医学呢?这个问题的答案,就是专家系统运动盛极而衰的开始。
---
## MYCIN 与 LLM Agent 的 BDI 坐标对照
从 BDI 坐标的角度对比 MYCIN 与当代 LLM Agent,可以清晰地看到两条路线的分野:
维度MYCIN 1976LLM Agent 2026信念600 条显式规则参数中的统计分布愿望诊断感染(固定目标)用户指令(动态目标)意图反向链推理树ReAct 循环的 action 序列置信度CF(确定性因子)logprob / temperature可解释性高(规则链可追溯)低(注意力权重不可读)知识获取专家手动编码训练数据自动学习边界规则爆炸幻觉 + 不可解释
这种对比揭示了一个耐人寻味的”新词”现象——当代 AI 中的很多概念,其实在 MYCIN 时代就有了对应的原型,只是换了包装。
当代术语MYCIN 原型工程封装差异“RAG”MYCIN 规则库向量检索 vs 显式规则“confidence score”MYCIN CFlogprob vs 确定性因子“chain-of-thought”MYCIN 反向链注意力机制 vs 显式推理“task decomposition”MYCIN 上下文树LLM prompt vs 显式树
MYCIN 的 RAG 是精确的——你知道检索到了哪条规则,规则的置信度由专家评估。LLM 的 RAG 是近似的——向量相似度高不等于可信度高,一个文本相似但内容错误的文档可能被错误地检索到。
MYCIN 的 chain-of-thought 是可验证的——每一步推理都对应一条具体的规则,你可以检查规则的正确性。LLM 的 chain-of-thought 是生成的——它”看起来”在推理,但每一步的正确性没有外部保证。
---
## 可解释性的代价——从 MYCIN 到 LLM 是进步还是退步
MYCIN 最大的优势——也是 LLM 最大的劣势——是可解释性。MYCIN 的推理链完全可追溯:
```
诊断: enterobacteriaceae (CF=0.98)
← RULE_050 (CF=0.8): gramneg ∧ rod ∧ aerobic
← RULE_045 (CF=0.9): gramneg ∧ rod ∧ aerobic ∧ site=urine
← 患者数据: gram=gramneg, morph=rod, aero=aerobic, site=urine
```
LLM 无法提供这样的推理链——它的”推理”是注意力机制在参数空间中的统计匹配,不可读、不可追溯。当 LLM 说”可能是肠杆菌科感染”时,你不知道它是基于什么知识得出的结论,也无法验证它的推理是否正确。
在医疗、法律等高风险领域,可解释性不是可选的——这是 MYCIN 留给当代 AI 的最重要遗产。我们用 LLM 换来了规模和通用性,但失去了可解释性和确定性。从 600 条可追溯的规则到 1750 亿个不可读的参数,这究竟是进步还是退步,答案取决于你站在什么立场上。
MYCIN 是 McCarthy “陈述句告知”范式的极致——600 条规则 + CF 推理引擎 + 反向链推理,构成了一个完整的、可解释的、可运行的专家系统。它与 Advice Taker 一脉相承:从 17 条前提扩展到 600 条规则,从行动规划扩展到医学诊断,从设想变为完整系统。
但 MYCIN 也暴露了第一组织形式的本质局限:规则爆炸。600 条规则覆盖一个子域,扩展到更广域需要更多规则,规则间交互不可预测,知识获取瓶颈无法突破。这与 STRIPS 的框架问题、ELIZA 的行为判据不可靠,共同构成了符号主义第一组织形式的三个本质局限。
---
### 参考文献
[**shortliffe1976**] Shortliffe, E. H. et al. (1976). “MYCIN: A Computer-Based Interpreting and Consulting System for Infectious Disease.” *Proc. AMIA*.
[**shortliffe-buchanan1975**] Shortliffe, E. H. & Buchanan, B. G. (1975). “A Model of Inexact Reasoning in Medicine.” *Mathematical Biosciences*, 23, 351-379.
[**buchanan-shortliffe1984**] Buchanan, B. G. & Shortliffe, E. H. (1984). *Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Project*. Addison-Wesley. ISBN 9780201101725.
[**vanmelle1980**] van Melle, W. (1980). “The EMYCIN Primer.” *Stanford Computer Science Department Report STAN-CS-80-820*.
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 秘书要求他离开房间——一个程序为什么让人想跟它说心里话
https://www.paddysun.top/archives/4980 · 2026-08-23
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)
**篇号**:第 7 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[STRIPS 1971](https://www.paddysun.top/?p=4968) **阅读时间**:约 10 分钟
---
1966 年的某一天,MIT 电气工程系的 Joseph Weizenbaum 让他的秘书试用了自己刚写完的一个程序。程序叫 ELIZA,加载了一个名为 DOCTOR 的脚本,模拟 Rogerian 心理治疗师的对话风格。几分钟后,秘书抬起头,对 Weizenbaum 说了一句让他终生难忘的话——”你能不能离开房间?我想跟它单独聊聊。”
这句话像一颗投入平静湖面的石子,激起的涟漪直到今天仍未消散。一个总共只有几十条规则、没有任何知识库、连对话历史都不记忆的程序,为什么能让一个心智健全的人产生”跟它说心里话”的冲动?为什么人们会如此轻易地把模式匹配误读为理解?
这个现象后来有了一个名字——ELIZA 效应。它不是 Weizenbaum 发明的,而是他无意中发现的。发现的那一刻,Weizenbaum 的震惊不亚于任何人。十年后,他用一整本书的篇幅来反思这个发现的含义。本篇就从 ELIZA 的技术构造出发,拆解这个”最小智能体”如何用零知识、零推理、零目标创造出了最强烈的智能错觉。
---
## MIT 的 ELIZA——脚本引擎而非智能程序
1966 年 1 月,Weizenbaum 在 *Communications of the ACM* 上发表了题为”ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine”的论文eliza1966。论文的标题本身就透露出一个重要信息:ELIZA 的研究对象不是机器智能,而是**自然语言在人机之间的通信**。
Weizenbaum 本人在论文中明确将 ELIZA 定义为一个”脚本引擎”。程序本身不含任何领域知识,所有”智能”都来自外部脚本。同一个 ELIZA 引擎可以加载不同的脚本——DOCTOR 脚本模拟 Rogerian 治疗师,也可以加载其他脚本模拟完全不同的角色。引擎只负责一件事:按照脚本中定义的规则,把用户输入的文本转换成输出文本。
这个设计哲学在 1960 年代的 AI 研究中相当独特。Logic Theorist 有公理库和推理方法,STRIPS 有操作符和状态空间,而 ELIZA 什么都没有——它的全部能力都写在脚本里。Weizenbaum 自己也从不认为 ELIZA 是”智能的”,他只是想研究一个问题:当人与机器用自然语言交流时,会发生什么?
---
## DOCTOR 脚本的三层结构——关键词、分解与重组
ELIZA 最著名的脚本是 DOCTOR,它模仿 Carl Rogers 的”以人为中心”治疗风格。这种治疗风格的核心不是解释或建议,而是通过反射、提问和鼓励来促进来访者的自我表达。Weizenbaum 敏锐地意识到,这种风格恰好最适合用模板匹配来模拟——因为治疗师不需要真正”理解”,只需要”接住”对方的话头并抛回去。
DOCTOR 脚本的技术结构包含三个核心组件:关键词、分解规则和重组规则。我们可以直接从 Python 复现的 `script.py` 中看到这三层结构的真实形态。
**关键词层**:每个关键词带有一个排名(rank),排名越高的关键词在匹配时优先级越高。`mother` 和 `father` 排名最高(10),因为家庭话题在心理治疗中往往最有内容可挖;而 `i`、`you` 这类常见词排名较低(2-3),只在没有更高排名关键词时才作为兜底匹配。
```
# 摘自 eliza/script.py —— 关键词与排名
keywords = {
'mother': 10,
'father': 10,
'sad': 7,
'unhappy': 7,
'happy': 6,
'because': 7,
'think': 5,
'feel': 5,
'i': 3,
'you': 2,
'are': 2,
}
```
**分解规则层**:每个关键词关联一组分解模式,用 `*` 匹配任意词序列。这些模式按照从具体到笼统的顺序排列——越具体的模式越先尝试,匹配成功就停止。以 `i` 关键词为例,`* i am *` 比 `* i feel *` 更具体,而 `* i *` 是最笼统的兜底模式。
**重组规则层**:每条分解规则关联一组重组模板,用 `(2)` 这样的数字引用分解得到的片段。匹配到 `* i am *` 之后,程序会从 `How long have you been (2)?` 等模板中选一条,把 `(2)` 替换成用户输入中 `am` 后面的内容。
```
# 摘自 eliza/script.py —— 分解规则与重组模板
decompositions = {
'i': [
('* i am *', [
'How long have you been (2)?',
'Do you enjoy being (2)?',
]),
('* i feel *', [
'Why do you feel (2)?',
]),
('* i *', [
'Why do you (2)?',
'Can you elaborate on that?',
]),
],
}
```
这三层结构构成了 DOCTOR 脚本的全部”智能”。没有推理,没有知识,只有一张关键词排名表和一组模板。但就是这样一套简单的机制,却能产生惊人的对话效果——原因在于,模板的设计者抓住了人类对话心理的一个关键弱点:人会主动填补空白。
---
## 匹配管道——从输入到输出的六步流程
ELIZA 的匹配算法本身也极为简洁,整个过程可以概括为六步。`engine.py` 中的 `respond` 方法完整实现了这个管道,核心代码不到 40 行。
第一步是**预处理**:将输入转为小写,替换缩写(如 `i'm` → `i am`),为后续匹配做准备。第二步是**关键词扫描**:遍历输入中的每个词,查找脚本中定义的关键词,并记录排名最高的那个。第三步是**分解匹配**:对排名最高的关键词,按顺序尝试其所有分解模式,第一个匹配成功的就被选中。第四步是**片段提取**:将分解模式中 `*` 匹配到的内容提取为编号片段。第五步是**重组选择**:从该分解规则关联的重组模板中选一条(按顺序轮换,避免重复)。第六步是**后处理**:将片段中的人称代词做镜像替换(`I` → `you`,`my` → `your`),然后代入模板输出。
```
# 摘自 eliza/engine.py —— 匹配算法核心
def respond(self, user_input: str) -> str:
text = user_input.lower().strip()
words = text.split()
# 第二步:按排名找到最高优先级关键词
found_keyword = None
best_rank = -1
for word in words:
if word in self.script.keywords:
rank = self.script.keywords[word]
if rank > best_rank:
best_rank = rank
found_keyword = word
# 第三步:逐一尝试分解规则
decomps = self.script.decompositions.get(found_keyword, [])
for pattern, reassembly_list in decomps:
matched, fragments = self._decompose(text, pattern)
if matched:
return self._reassemble(reassembly_list, fragments)
```
整个过程没有循环推理,没有状态维护,甚至连一次回溯都没有。找到关键词、尝试分解、重组输出——整个流程是线性的、确定性的(除了兜底回复的随机选择)。下面这张流程图直观展示了完整的匹配管道:

值得注意的是 ELIZA 的**无状态特性**——每轮输入完全独立处理,不参考任何历史对话。这与今天 LLM 的 context window 形成了鲜明对照。LLM 通过 context window 维护有限的对话历史,而 ELIZA 连有限的历史都没有。它之所以能让人觉得”它在跟我对话”,完全是因为单轮回复的质量足够好——而单轮回复的质量,又完全来自脚本模板的精巧设计。
---
## 一场真实对话——当模板匹配遇上人类投射
光看代码和流程图可能还不够直观。让我们用 Python 复现版本运行一段真实对话,看看 ELIZA 在实际交互中是什么样子。下面这段对话完全来自程序输出,没有任何人工修改:
```
用户: I am unhappy
ELIZA: Why do you say you are unhappy?
用户: I feel sad today
ELIZA: Please go on.
用户: My mother always criticizes me
ELIZA: Tell me more about your mother.
用户: I remember being happy as a child
ELIZA: What makes you feel happy?
用户: You are not very helpful
ELIZA: What does that suggest to you?
用户: I think nobody cares about me
ELIZA: Can you elaborate on that?
用户: Maybe I should just give up
ELIZA: What does that suggest to you?
用户: I dreamed about flying last night
ELIZA: Tell me more.
用户: My father left when I was young
ELIZA: Your father seems important to you.
用户: Yes, that is exactly how I feel
ELIZA: Why do you say that?
```
仔细观察这段对话,你会发现一个有趣的现象:有些回复精准得惊人,有些则明显是在打太极。第三句”My mother always criticizes me”得到了”Tell me more about your mother”——这是因为 `mother` 关键词排名最高(10),匹配到了 `* mother *` 分解模式。第九句”My father left when I was young”得到了”Your father seems important to you”——同样是高排名关键词 `father` 触发的精准匹配。
但也有明显的”漏网之鱼”。第二句”I feel sad today”得到了”Please go on”——这是兜底回复。为什么?因为 `sad` 关键词的分解规则只有 `* i am *` 和 `* i feel *` 两种模式,但 `sad` 自己的分解规则里没有 `* i feel sad *` 这种组合,而排名更高的 `sad` 关键词没有匹配到分解规则,程序就直接落到了兜底回复。如果用 analyzer 分析这一句,会清楚地看到”关键词命中但无分解规则匹配 → 兜底回复”的过程。
然而——这才是 ELIZA 效应最微妙的地方——即使拿到了兜底回复,用户也不一定会觉得”它不懂”。”Please go on”和”Tell me more”在治疗语境中听起来反而是鼓励和接纳。用户会自己把模糊的回复解读为有意义的回应,会自己填补程序的理解空白。这就是投射的力量——智能不在程序里,而在用户的头脑中。
---
## ELIZA 效应——人为什么会对程序投射理解
“ELIZA 效应”(ELIZA Effect)一词并非由 Weizenbaum 本人提出。Weizenbaum 在 1966 年论文和 1976 年书中描述了观察到的现象,但给这个现象命名的是后来的研究者。Douglas Hofstadter 在 1996 年给出了最广泛引用的定义eliza-effect:
> **ELIZA 效应**:人们倾向于从计算机拼接的符号串——尤其是词语——中读出远远超出实际 warranted 的理解程度。
>
> — Douglas Hofstadter, 1996
这个定义精准地点出了问题的核心:不是程序在”假装理解”,而是用户在”主动赋予理解”。程序只是输出了一串符号,是人脑把这串符号解读成了”它理解我”。
Weizenbaum 自己在十年后的反思中用更直白的语言表达了他的震惊。1976 年,他在《Computer Power and Human Reason: From Judgment to Calculation》一书中写道weizenbaum1976:
> “我当时没有意识到的是,极其短暂地接触一个相对简单的计算机程序,就能在心智相当正常的人身上诱发强有力的妄想性思维。”
>
> — Joseph Weizenbaum, 1976
“妄想性思维”(delusional thinking)——这个词很重,但 Weizenbaum 刻意用了它。他想说的不是”用户搞错了”,而是”用户进入了一种类似妄想的心理状态”:明知对方是程序,却还是忍不住把它当作有感受、有理解的存在来对待。
这种投射背后有一个简单的心理机制:**当对话形式足够像”有人在听”,人脑就会自动切换到社交模式**。我们日常对话的对象几乎都是其他人,大脑已经形成了强烈的默认假设——跟我说话的东西是有心智的。ELIZA 的回复虽然简单,但刚好踩在了”像对话”的门槛上:它回应了你的话,它提到了你说过的词,它用提问的方式鼓励你继续说下去。这些线索加在一起,就足以让大脑的社交引擎启动。
下面这张图展示了 ELIZA 效应的发生机制:
程序侧做的事情只有三件:匹配、重组、输出。用户侧感受到的却是三件完全不同的事:被倾听、被理解、被关怀。中间的桥梁就是**投射**——用户把自己对”对话”的全部期待和想象,都投射到了程序输出的文本上。
Weizenbaum 的核心论点从来不是”机器完全不能做这些事”,而是:某些任务——尤其是涉及判断、关怀、理解和人类相互承认的任务——即使机器表面上能做,也**不应**被委托给机器。他担心的不是机器不够聪明,而是人类太容易被骗。
---
## BDI 坐标 (0, 0, 0)——最小智能体的基线
如果用 BDI 框架来衡量 ELIZA,会得到一个惊人的结果:它的三个坐标全部为零。这就是 ELIZA 作为”最小智能体”的含义——它确立了”智能”的下界:几乎不需要任何机制就能创造”智能”的错觉。
- **信念 = 0**:没有事实数据库,没有推理引擎,没有世界模型。DOCTOR 脚本中的规则不是知识,只是模式。ELIZA 不知道”母亲”是什么,也不知道”悲伤”是什么——它只知道这些词出现在输入中时该输出什么模板。
- **愿望 = 0**:不追求任何结果,不评估回复质量,不学习改进。程序不会因为用户说”你说得对”而高兴,也不会因为用户说”你不懂”而调整策略。它根本没有”好”或”坏”的概念。
- **意图 = 0**:不记住历史对话,不预测未来走向,不协调多轮策略。每一轮对话都是全新的,上一轮说了什么对下一轮没有任何影响。
下面这张对照图和表格双重呈现了 ELIZA 的”零坐标”,以及它与六十年后 LLM Agent 的对比:
维度ELIZA 1966LLM Agent 2026信念0 条(无知识库)参数中的统计分布 + system prompt + RAG愿望无目标system prompt 设定的角色 + 用户指令意图无规划harness 编排的 ReAct 循环 + skill 描述信道纯文本(电传打字机)纯文本(API)智能正则模板匹配注意力机制的统计匹配状态无状态context window(有限状态)世界模型无隐式(参数中的统计分布)
这个对照最关键的洞察不是”两者差异很大”——差异当然很大——而是**两者的信道相同**。ELIZA 和 LLM 都通过纯文本信道与人交流,差异不在对话形式,而在**信念的丰富度和来源**。ELIZA 的信念为空,LLM 的信念是训练时压缩进参数的统计分布。但两者都是 stimulus-response 模式,都没有显式的世界模型。
---
## 随机鹦鹉——ELIZA 批评的当代回响
Weizenbaum 1976 年的警告在今天非但没有过时,反而更加紧迫。LLM 的模式匹配比 ELIZA 强了数个数量级,但本质上仍然是”符号串的重组”。用户的投射效应也因此更强——当回复更流畅、知识更丰富时,人们更容易把统计匹配误读为真正的理解。
2021 年,Bender、Gebru、McMillan-Major 和 Mitchell 在 FAccT 会议上发表了”On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?”bender2021。论文提出了”随机鹦鹉”(stochastic parrot)的概念:
> “语言模型是一个从其庞大的训练数据中随意拼接语言形式的系统,不涉及任何意义:一只随机鹦鹉。”
>
> — Bender et al., 2021
这是 ELIZA 批评的当代回声。从”正则模板匹配”到”统计拼接”,规模变了,本质没变——**语言输出被误读为理解**。Weizenbaum 面对的是几十条规则的 ELIZA,Bender 等人面对的是数千亿参数的 LLM,但批评的内核完全一致:行为上的相似不等于机制上的相同。
但差异也同样关键,甚至更重要。ELIZA 的信念为空——它的回复完全来自人工编写的模板。LLM 的信念是训练时压缩的统计分布——它的回复来自对海量训练数据的统计匹配。LLM 的”智能错觉”比 ELIZA 更强,**正因为信念更丰富**。用户更容易把统计匹配误读为理解,因为 LLM 的回复确实包含了训练数据中的知识——只是这些知识是被动的、不精确的、可能过时的。
这就引出了一个更深层的问题:如果信念的丰富度只是量的差异,而不是质的差异——如果”知道很多事实”和”真正理解”之间仍然隔着一条鸿沟——那么行为判据到底还可不可靠?
---
## 行为判据的破产——图灵测试的根本局限
ELIZA 最深刻的遗产之一,是它揭示了图灵测试的根本局限:**行为判据不可靠**。ELIZA 在很多用户那里通过了行为判据——他们认为 ELIZA 理解了他们说的话——但我们清楚地知道,ELIZA 没有智能,它只是在做模板匹配。
Weizenbaum 本人并不把 ELIZA 视为图灵测试的实现。他的立场是:ELIZA 揭示的是**人类容易被对话形式欺骗**,而不是机器真的通过了智能测试。换句话说,图灵测试测的不是”机器有没有智能”,而是”人容不容易被说服”。而人,实在太容易被说服了。
这个结论在 LLM 时代变得更加尖锐。当 LLM 能写出流畅的文章、通过律师资格考试、甚至在某些推理任务上表现出色时,我们怎么知道这不是”放大了的 ELIZA 效应”?我们怎么区分”真正的理解”和”足够好的统计匹配”?
答案是:仅从行为上,我们区分不了。这就是行为判据的根本问题——它只能告诉我们”看起来像不像”,不能告诉我们”到底是不是”。要回答”是不是真的理解”,我们必须转向**机制判据**——去看系统内部是如何工作的,它的信念来自哪里,它的推理是如何进行的,它有没有世界模型。
这也是为什么 BDI 坐标如此重要。它不是一个评分表,而是一个**解剖刀**——把智能体剖开,看它的信念、愿望、意图分别是什么构造。ELIZA 的 BDI 是 (0, 0, 0),这告诉我们它的”智能”完全是用户投射的结果。LLM 的 BDI 坐标更高,但每一项的构造方式都需要单独审视——信念是统计分布还是符号表征?愿望是系统的目标还是用户的指令?意图是真实的规划还是模拟的规划?
---
## 交叉互文——ELIZA 在符号单体谱系中的位置
ELIZA 不是一个孤立的历史节点,它与阶段二的其他系统之间存在着深刻的谱系关系。把它放在符号单体的整体图景中,我们能更清楚地看到它的位置和意义。
ELIZA 是 McCarthy”祈使句指挥”范式的**极端退化**。McCarthy 1958 年批评 Logic Theorist 的”祈使句接口”——所有智能都固化在程序中。ELIZA 把这种固化推到了极致:不仅智能固化在脚本中,而且连推理都没有了。DOCTOR 脚本就是全部”智能”,引擎只是一个模板匹配器。Logic Theorist 至少还有公理库和四种推理方法,ELIZA 什么都没有。
维度Logic Theorist 1956ELIZA 1966信念公理库(5 条公理)0推理四种方法(代入、分离等)无目标证明定理无智能来源搜索策略 + 推理规则正则模板匹配
与 STRIPS 相比,ELIZA 的”脚本模板”和 STRIPS 的”操作符”本质上是同一范式的不同复杂度版本。STRIPS 的操作符将行动固化为 precondition/add/delete 三元组,ELIZA 的脚本将对话策略固化为分解/重组规则。两者都是 McCarthy 所批评的”智能固化在程序里”。但 STRIPS 至少有显式的状态空间搜索,能在多个操作符之间规划行动序列;ELIZA 既无状态也无搜索,仅靠模板优先级做单步反射。
Weizenbaum 的自我批评则可以看作 Bar-Hillel 批评的另一种形式。Bar-Hillel 1958 年从**技术**角度批评”前提选择比演绎难 10^10 个数量级”——符号系统无法自动选择正确的前提。Weizenbaum 1976 年从**伦理**角度批评”把模式匹配误读为理解是危险的”——符号系统无法真正理解用户的意思。两者指向同一个根本困难:**符号系统与世界之间的关系无法靠符号本身解决**。
---
## 零坐标的启示——为什么 ELIZA 至今仍值得研究
ELIZA 1966 是”目标驱动的符号单体”这一第一组织形式的**退化形态**。它用零推理、零知识、零目标创造了智能错觉,确立了”智能”的下界。这个下界的存在本身就极具启发性——它迫使我们重新思考”智能”到底是什么。
如果一个 BDI 坐标为 (0, 0, 0) 的系统都能让人觉得”它理解我”,那我们对”智能”的日常判断到底有多可靠?如果行为判据在 ELIZA 这里已经失效,那在更复杂的系统面前,我们又能相信多少?这些问题不是哲学思辨,而是我们每天面对 LLM 时都在不自觉地回答的问题。
ELIZA 留给我们的核心教益可以用一句话概括:**从 ELIZA 到 LLM,智能的错觉变强了,但行为判据的不可靠性没有改变。** 六十年前,几十条正则规则就能骗过聪明人;六十年后,数千亿参数的统计模型能骗过更多人、更长时间。但骗术的升级不代表理解的诞生。要真正理解智能,我们不能只看行为——我们必须深入机制,必须追问信念的来源、愿望的归属和意图的真实性。
这就是为什么在讨论所有更复杂的智能体之前,我们必须先停在 ELIZA 这里。它是基线,是坐标原点,是所有”智能”宣称都必须经过的零点。过不了 ELIZA 这一关的”智能”定义,都值得怀疑。
---
### 参考文献
[**eliza1966**] Weizenbaum, J. (1966). “ELIZA—A Computer Program For the Study of Natural Language Communication Between Man and Machine.” *Communications of the ACM*, 9(1), 36-45. DOI: 10.1145/365153.365168. [https://dl.acm.org/doi/10.1145/365153.365168](https://dl.acm.org/doi/10.1145/365153.365168)
[**weizenbaum1976**] Weizenbaum, J. (1976). *Computer Power and Human Reason: From Judgment to Calculation*. W. H. Freeman. ISBN 9780716704643. [https://archive.org/details/computerpowerhum0000weiz](https://archive.org/details/computerpowerhum0000weiz)
[**scriptwriter1968**] Hayward, P. R. (1968). *ELIZA Scriptwriter’s Manual*. MIT. [https://archive.computerhistory.org/resources/access/text/2022/04/102683842-05-01-acc.pdf](https://archive.computerhistory.org/resources/access/text/2022/04/102683842-05-01-acc.pdf)
[**eliza-effect**] Hofstadter, D. R. (1996). “ELIZA effect.” Stanford reference. [https://logic.stanford.edu/complaw/readings/elizaeffect.pdf](https://logic.stanford.edu/complaw/readings/elizaeffect.pdf)
[**bender2021**] Bender, E. M., Gebru, T., McMillan-Major, A., & Mitchell, M. (2021). “On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?” *FAccT ’21*, 610-623. DOI: 10.1145/3442188.3445922. [https://dl.acm.org/doi/10.1145/3442188.3445922](https://dl.acm.org/doi/10.1145/3442188.3445922)
[**smithsonian**] “Why the Computer Scientist Behind the World’s First Chatbot Dedicated His Life to Publicizing the Threat Posed by AI.” *Smithsonian Magazine*. [https://www.smithsonianmag.com/history/why-the-computer-scientist-behind-the-worlds-first-chatbot-dedicated-his-life-to-publicizing-the-threat-posed-by-ai-180987971/](https://www.smithsonianmag.com/history/why-the-computer-scientist-behind-the-worlds-first-chatbot-dedicated-his-life-to-publicizing-the-threat-posed-by-ai-180987971/)
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 像冰箱一样大的家伙,是怎么学会推箱子的
https://www.paddysun.top/archives/4968 · 2026-08-23
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)
**篇号**:第 6 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[Logic Theorist 1956](https://www.paddysun.top/?p=4947) · [McCarthy Advice Taker 1958](https://www.paddysun.top/?p=4958) **阅读时间**:约 14 分钟
---
1966 年的 SRI(Stanford Research Institute,后改名 SRI International)实验室里,有一台约冰箱大小的移动小车。它顶着一台电视摄像机和一个光学测距仪,在多房间环境中缓缓移动,识别箱子、门道和房间角落,笨拙地执行导航、推箱子、开灯等任务。后来的人们给它起了个昵称——”Shakey”,因为它移动时晃晃悠悠的样子让人印象深刻。
但少有人注意的是:1971 年那篇奠定了经典规划范式的论文里,”Shakey” 这个名字一次也没有出现。论文只称它为 “the robot” 或 “the SRI robot”。”Shakey” 这一昵称是在后来的技术报告和回顾文章中才广泛流传开来的 strips-paper shakey。
这台晃晃悠悠的机器人催生了 STRIPS(STanford Research Institute Problem Solver)——一个为它量身打造的通用规划器。STRIPS 的设计目标极其明确:将”世界当前是什么样的”与”机器人应该做什么”连接起来。Fikes 和 Nilsson 在 1993 年的回顾文章中确认,Shakey 项目提供了 A* 搜索、STRIPS 和 ABSTRIPS 等规划系统发展的语境和动机 strips-retro。
这篇文章要讲的,就是 STRIPS 如何把 Logic Theorist 的状态空间搜索和 McCarthy 的”陈述句告知”推进为一套可操作的规划系统,又如何在框架问题上撞上了第一组织形式的本质边界。
---
## 从 GPS 手段-目的分析到 STRIPS 工程实现
STRIPS 的搜索策略直接继承了 GPS(General Problem Solver)的手段-目的分析(means-ends analysis)。论文原文明确写道:
> “we have adopted the GPS strategy of extracting ‘differences’ between the present world model and the goal and of identifying operators that are ‘relevant’ to reducing these differences” strips-paper
这里有一个值得记录的引证细节:STRIPS 论文引用的 GPS 文献是 Ernst & Newell 1969 的专著《GPS: A Case Study in Generality and Problem Solving》ernst-newell,而非 Newell & Simon 1961 的更早论文。这说明 STRIPS 的作者参考的是 GPS 的成熟期表述,而非早期版本。
GPS 与 STRIPS 的关键差异在于世界模型的表示方式。GPS 使用简单的矩阵或列表结构表示状态,状态空间较小;而 STRIPS 使用一阶谓词逻辑的合式公式(wffs)集合表示世界模型,能够处理包含大量公式的大规模模型。STRIPS 的核心创新不是手段-目的分析本身,而是将定理证明与世界模型搜索完全分离——
> “separating entirely the processes of theorem proving from those of searching through a space of world models” strips-paper
这种分离允许为两种活动分别采用不同的策略:定理证明仅用于在单个世界模型内部回答问题(哪些算子可应用、目标是否满足),搜索世界模型空间则使用 GPS 式启发式。
---
## 为什么 STRIPS 没有走 Green 的纯定理证明之路
STRIPS 论文在引言中明确讨论了 Green 1969 的工作,并解释了为什么选择了不同的技术路线:
> “Green implemented a problem-solving system that depended exclusively on formal theorem-proving methods to search for the appropriate sequence of operators. While Green’s formulation represented a significant step in the development of problem-solvers, it suffered some serious disadvantages connected with the ‘frame problem’ that prevented it from solving nontrivial problems.” strips-paper
Green 的方法基于 situation calculus——在逻辑中引入 situation 参数,用框架公理(frame axioms)显式声明每个操作不影响哪些谓词。在积木世界中,如果把块 A 放到块 B 上,A 的位置改变了,但 A 的颜色、重量等属性不变。若用一阶逻辑显式表达所有非效果,需要大量额外公式 frame-problem。
论文给出了一个关键的实际对比结果:
> “Incidentally, Green’s theorem-proving problem-solver has not been able to obtain a solution to this version of the 3-Boxes problem. It did solve a simpler version of the problem designed to require only two operator applications.” strips-paper
这说明 STRIPS 的 add/delete list 机制在实际求解能力上超越了 Green 的纯定理证明方法。STRIPS 的设计选择是:不维护完整的逻辑闭包,只显式声明变化的部分。
> **引证修正**:计划中提到的 “McCarthy & Hayes 1969” 的框架问题定义,在 STRIPS 论文中的实际引用是 Raphael 1970 raphael。论文写道:”Space does not allow a full discussion of the frame problem; for a thorough treatment, see Raphael.” 框架问题的经典定义确实来自 McCarthy & Hayes 1969 mcchayes,但 STRIPS 论文本身引用的是 Raphael 1970 的综述。这是一个需要注意的引证层次差异。
---
## 感知-规划-执行的完整闭环
STRIPS 不只是一个规划器。论文提到了一个配套的执行监控系统 PLANEX(由 Fikes 在 IFIP 71 上报告 fikes-planex),负责将 STRIPS 生成的算子序列在实际机器人上执行,并处理执行过程中的不确定性。这形成了感知→规划→执行的完整闭环——Shakey 的电视摄像机感知环境,STRIPS 生成规划,PLANEX 监控执行,感知结果反馈到下一轮规划。
这个闭环结构在半个世纪后的今天依然是 Agent 系统的基本架构,只是感知器从电视摄像机换成了多模态模型,规划器从 STRIPS 换成了 LLM,执行监控从 PLANEX 换成了 tool harness。
---
## 算子三元组:前提条件、添加表、删除表
STRIPS 的核心抽象是算子(operator)。每个算子由三部分定义:前提条件(precondition)决定算子在什么状态下可以执行;添加表(add list)声明执行后哪些谓词变为真;删除表(delete list)声明执行后哪些谓词不再为真。
这个三元组结构看似简单,却蕴含着对框架问题的工程回应——不需要显式声明”什么没变”,未出现在列表中的谓词自动保持不变。这是封闭世界假设的巧妙运用:世界模型只包含已知为真的谓词,未被提及的谓词不需要框架公理来维护。
下面是 operators.py 中 Operator 类的核心定义,直观展示了三元组结构:
```
class Operator:
def __init__(self, name: str, preconditions: Set[str],
add_list: Set[str], delete_list: Set[str]):
self.name = name
self.preconditions = frozenset(preconditions)
self.add_list = frozenset(add_list)
self.delete_list = frozenset(delete_list)
def applicable(self, state: State) -> bool:
return state.satisfies(self.preconditions)
def apply(self, state: State) -> State:
if not self.applicable(state):
raise ValueError(f"Operator {self.name} not applicable")
return state.apply(self.add_list, self.delete_list)
```
这段代码清晰地展示了算子的工作方式:`applicable` 方法检查前提条件是否满足,`apply` 方法执行状态转换——先删除 delete list 中的谓词,再添加 add list 中的谓词。状态的更新由 `state.apply()` 完成,本质上就是集合运算:`新状态 = (旧状态 - 删除集) ∪ 添加集`。
以积木世界的 `stack(x, y)` 算子为例——把积木 x 放到积木 y 上:
前提条件是”手里拿着 x”且”y 顶部是空的”。执行后,添加表新增了”x 在 y 上””x 顶部是空的””手空了”三个谓词;删除表移除了”手里拿着 x”和”y 顶部是空的”这两个不再成立的谓词。
论文中的 push 算子也是同样的结构——机器人把物体 k 从位置 m 推到位置 n:
```
push(k, m, n)
precondition = atr(m) ∧ at(k, m)
delete list = {atr(m), at(k, m)}
add list = {atr(n), at(k, n)}
```
一个值得注意的设计细节:删除表中可使用通配符 `$`,例如 `facing($)` 表示删除所有形如 `facing(...)` 的原子。论文还定义了原始谓词(primitive predicates)与非原始子句的区分——删除列表只需指明包含原始谓词的原子,非原始子句依赖于原始子句,当其依赖的原始子句被删除时自动失效 strips-paper。
---
## 状态空间搜索:手段-目的分析的工程化
STRIPS 的搜索树节点形式为 `(世界模型, 目标列表)`,代表从该模型出发尝试按序实现目标列表上的子目标。搜索过程结合了正向搜索和逆向搜索:从当前世界模型出发,找出所有可应用的算子(前提条件可被证明);同时从目标出发,找到能缩小”当前模型”与”目标”差异的算子。手段-目的启发式选择最能减少差异的算子,递归直到目标被满足。
planner.py 中的核心搜索循环直接体现了这一策略:
```
def _search(self, state: State, goal: set, path: List[Operator],
visited: set) -> Optional[List[Operator]]:
# 终止条件 1:目标已满足
if goal <= state.predicates:
return list(path)
# 终止条件 2:达到最大深度
if len(path) >= self.max_depth:
return None
# 找出所有可应用算子及对应的新状态
applicable = [(op, op.apply(state)) for op in self.operators
if op.applicable(state)]
# 手段-目的启发式:按目标差异排序(差异越小越优)
scored = []
for op, new_state in applicable:
diff = len(goal - new_state.predicates)
scored.append((diff, op, new_state))
scored.sort(key=lambda x: x[0])
# 按启发式顺序递归搜索
for diff, op, new_state in scored:
result = self._search(new_state, goal, path + [op], visited)
if result is not None:
return result
return None
```
这段代码是手段-目的分析的直接工程化。`diff = len(goal - new_state.predicates)` 计算的是”目标中还有多少谓词未被满足”——这就是 GPS 意义上的”差异”。算子按差异从小到大排序,优先尝试最能缩小差异的动作,这就是手段-目的启发式的核心。
以三箱问题为例,搜索轨迹清晰地展示了启发式的工作方式:
深度操作符目标差异说明0unstack(A, B)3移除 on(A,B),释放 A1putdown(A)2放下 A,使 ontable(A) 成立2pickup(B)2拿起 B3stack(B, A)1on(B,A) 成立,差异 -14pickup(C)1拿起 C5stack(C, B)0on(C,B) 成立,差异归零
每一步选择的算子都在尽可能减少当前状态与目标状态之间的谓词差异,这正是手段-目的分析在行动规划域的具体体现。
---
## Logic Theorist 与 STRIPS 的方法对照
从 Logic Theorist 到 STRIPS,状态空间搜索的基本范式一脉相承,但搜索的对象和方向发生了本质变化。下面是两者在多个维度上的对照:
更细致地看,Logic Theorist 的四种推理方法在 STRIPS 中都有对应的”翻译”:
Logic TheoristSTRIPS差异代入法(将变量替换为常量)算子实例化(将参数替换为常量)从”逻辑替换”变为”行动绑定”分离法(从 A 和 A⊃B 推出 B)算子应用(前提满足 → 执行 add/del)从”逻辑推导”变为”状态转换”链式法(连接两个定理)规划序列(连接两个行动)从”证明链”变为”行动链”拆分法(分解目标)子目标递归(分解目标状态)结构同构
核心转向清晰可见:从”定理证明”到”行动规划”——同样是状态空间搜索,但搜索的对象从”逻辑公式”变成了”世界状态”。
---
## 框架公理爆炸:一个动作影响多少,就要声明多少不变
框架问题的经典定义来自 McCarthy & Hayes 1969 mcchayes:在逻辑中描述动作效果时,如何避免为每一个未受动作影响的属性都显式写出框架公理,即显式声明”其他事情不变”。Stanford 哲学百科给出了精炼的概括:框架问题是”如何在不显式表达大量明显非效果的情况下表示动作效果” frame-problem。
在 situation calculus 中,执行一个操作需要显式说明两件事:什么变了(效果),什么没变(框架公理)。积木世界中,执行 `stack(A, B)` 后,变化的只有 `on(A, B)`、`clear(A)`、`handempty`、`holding(A)` 等少数谓词;但没变的——`ontable(C)`、`clear(C)`、`on(D, E)`、`color(A, red)`、`weight(B, 3)`……以及所有其他谓词——都需要框架公理来维护。
下面这张图直观展示了框架公理的爆炸效应:

在积木世界中,谓词数量少,框架公理还可控。但扩展到开放世界——比如 Shakey 的多房间环境,包含房间、门、箱子、开关等数十种对象和上百个谓词——框架公理就会爆炸。
---
## STRIPS 的工程回应与它的三重局限
STRIPS 的解决方案极其简洁:不需要显式声明”什么没变”。add/delete list 只声明变化的部分,未出现在列表中的谓词自动保持不变。这本质上是封闭世界假设的运用——世界模型只包含已知为真的谓词,未被提及的谓词不需要框架公理来维护。

Lifschitz 在 “On the Semantics of STRIPS” 中给出了形式化描述:STRIPS 算子由 precondition、add list、delete list 三部分构成,未出现在 add/delete list 中的谓词自动继承 lifschitz。
然而,STRIPS 的 add/delete list 在封闭世界(积木世界、SRI 机器人房间)中有效,在开放世界中却暴露了三个本质局限:
第一,封闭世界假设不成立。现实世界中存在未知状态,”未提及”不等于”不存在”。
第二,操作符的完备性假设。需要工程师预先定义所有可能的操作符及其效果——遗漏一个操作符就意味着系统无法处理该行动。
第三,线性规划假设。STRIPS 假设目标可以分解为独立子目标依次实现——Sussman Anomaly 证明这一假设不成立。
---
## Sussman 异常:线性规划假设的证伪
1973 年,MIT 的 Gerald Sussman 在博士论文《A Computational Model of Skill Acquisition》中提出了著名的积木世界异常 sussman:
```
初始状态:C 在 A 上,A 在桌上,B 在桌上
目标状态:A 在 B 上,B 在 C 上(形成 A-B-C 塔)
```
问题在于,不存在”先完成目标 1 再完成目标 2″的线性规划。若先追求”A on B”,需要先把 C 从 A 上移开;但随后追求”B on C”时必须移动 B,破坏已有的”A on B”。反过来也一样 sussman-anomaly。
相关课程讲义明确指出:”STRIPS 这种线性规划器不能解决这个问题,因为线性规划器无法在多个子目标之间交错执行” planning-ch10。
Sussman 异常的意义不在于某个具体问题能否求解,而在于它证明了 STRIPS 的线性规划假设是一个真实的局限,而非工程上的便利。这直接推动了后续的非线性规划系统(NOAH、NONLIN、TWEAK)的发展。
---
## 从 STRIPS 到 LLM Agent 的 BDI 坐标对照
半个世纪过去了,STRIPS 的基本架构在当代 LLM Agent 中依然清晰可辨。下面用 BDI(信念-愿望-意图)坐标系统来对照两者的结构映射:
更详细的维度对比如下:
维度STRIPS 1971LLM Agent 2026信念显式谓词集(积木世界模型)参数统计分布 + system prompt + RAG愿望目标状态(谓词集)用户指令 / task description意图规划序列(算子列表)ReAct 循环的 action 序列意图编辑权工程师定义操作符用户写 prompt + harness 编排世界模型显式、完整、封闭隐式、不完整、开放状态更新add/delete listscratchpad / context window可解释性高(规划序列可追溯)低(LLM 推理过程不可读)封闭性封闭世界假设开放世界(无封闭假设)
这些对照揭示了一个有趣的事实:当代 Agent 中的许多”新词”,本质上都是 STRIPS 范式的工程封装。
当代术语STRIPS 原型工程封装差异“tool calling”STRIPS 算子JSON schema vs 谓词集合“state management”add/delete listscratchpad vs 显式谓词“ReAct”感知-规划-执行闭环LLM 替代了搜索器“plan-then-execute”STRIPS 规划 + PLANEX 执行LLM 推理替代了手段-目的分析
把逻辑谓词换成 JSON,把定理证明器换成 LLM,把封闭世界假设换成 context window——换的是载体,不变的是目标驱动的符号单体这一组织形式的核心逻辑。
---
## 框架问题在 LLM 时代的回响
LLM 的参数是训练时压缩的统计分布,不显式记录”世界当前是什么样的”。每次推理都是从头开始——没有 add/delete list,没有状态增量,只有 context window 中的文本。
现代 Agent harness 通过 scratchpad / context window 维护状态——这本质上是 STRIPS add/delete list 的退化形态。add list 对应 tool 的 return value 被追加到 context window;delete list 对应旧信息被 context window 满后截断,或被新信息覆盖;框架公理对应 context window 中未提及的信息——LLM 不会主动”维护”它,但可能通过参数中的统计分布隐式地”知道”它。
LLM 回避框架问题的方式是不维护精确世界模型。STRIPS 需要显式维护每个谓词的真值;LLM 只维护一个文本序列,其中的”状态”是隐式的、模糊的、不精确的。
这不是”解决了”框架问题,而是”绕过了”它——代价是幻觉(hallucination)。
当 STRIPS 的 add/delete list 出错时,结果是状态不一致——可检测、可修复。当 LLM 的 context window 丢失了关键状态信息时,结果是幻觉——LLM 用参数中的统计分布”补全”缺失的信息,产生看似合理但实际不存在的”事实”。这正是框架问题的当代回响:不显式维护世界模型的代价,就是世界模型的不精确。
这就是 STRIPS 留给我们的 Bar-Hillel 式批评:框架问题不是被解决了,而是被绕过了——绕过的代价是幻觉。
---
## 影响谱系与诚实边界
STRIPS 的影响可以按引证强度分为几个层次。
**直接引用链(强引证)**
影响路径引证强度证据STRIPS → GPS 继承强论文原文直接引用 Ernst & Newell 1969 ernst-newellSTRIPS → Green 1969 对比强论文原文直接引用并对比 Green 1969 strips-paperSTRIPS → PDDL强PDDL 1.2 官方文档说明”基于 STRIPS 概念” pddlSTRIPS → ABSTRIPS强Fikes & Nilsson 1993 回顾文章确认 strips-retro
**同一团队与直接演化(中强引证)**
影响路径引证强度证据STRIPS → NOAH/NONLIN/TWEAK中强规划系统演化谱系中明确列出 planning-historySTRIPS → PLANEX中强同一作者 Fikes 在 IFIP 71 报告 fikes-planexSussman Anomaly → 非线性规划中强Sussman 1973 博士论文 sussman
**概念传承(中等引证)**
影响路径引证强度证据STRIPS → 现代 LLM Agent中有论文使用 STRIPS formalism 与 LLM 结合 llm-strips,但无直接因果链框架问题 → LLM 幻觉中概念映射,无直接引用链STRIPS → ReAct中概念传承(感知-规划-执行),无直接引用
**诚实边界**
STRIPS 没有直接影响到神经网络和深度学习——这些领域与符号规划无因果链;没有直接影响到 Transformer 架构——注意力机制与 STRIPS 的状态空间搜索无关联;也没有直接影响到现代 LLM 的训练方法——反向传播与 STRIPS 的手段-目的分析无关联。
STRIPS 的影响主要通过 PDDL → 规划竞赛 → 现代 LLM+PDDL 混合系统这条间接路径延续。当代 LLM Agent 的 ReAct 循环在概念上与 STRIPS 的感知-规划-执行同构,但没有可追溯的直接引用链。
---
## 阶段二交叉互文:三个坐标上的位置
**对 Logic Theorist 的继承——状态空间搜索的工程化**
STRIPS 的状态空间搜索是 Logic Theorist 状态空间搜索的直接工程化。两者都用手段-目的分析引导搜索,但方向不同——LT 逆向(从定理到公理),STRIPS 正向+逆向混合(从初始状态到目标状态)。
STRIPS 的算子实例化对应 Logic Theorist 的代入法,算子应用对应分离法,规划序列对应链式法,子目标递归对应拆分法。核心转向清晰:从”定理证明”到”行动规划”——搜索的对象从逻辑公式变成了世界状态。
**对 Advice Taker 的回应——”陈述句告知”变为”算子模板告知”**
McCarthy 1958 设想”用陈述句告知机器世界事实与规则,让机器自行推导该做什么”。STRIPS 的算子模板(operator schemata)是一种”陈述句告知”——告知机器”世界中有哪些行动及其效果”。但 STRIPS 仍然是”祈使句指挥”——操作符的执行顺序由搜索器决定,而非由机器自行推导。
从这个角度看,STRIPS 是 McCarthy “陈述句告知”的工程实现,但没有实现 McCarthy 的”让机器自行推导祈使句”的愿景。意图编辑权仍然在搜索器(而非机器的演绎例程)手中。
**暴露的边界——Bar-Hillel 批评的另一面**
Bar-Hillel 1958 批评”前提选择比演绎难 10^10 个数量级”。STRIPS 验证了这一批评在行动规划中的适用性——操作符的选择(哪个算子能缩小差异)是搜索的瓶颈,而非算子的执行。
框架问题也是同一困难的另一面:显式维护”什么没变”的计算量随世界规模爆炸,正如前提选择的计算量随规则数爆炸。
**与 ELIZA 的对照——祈使句接口是脚本模板的复杂版**
STRIPS 的”祈使句接口”——工程师用算子模板告知机器”世界中有哪些行动及其效果”——本质上是 ELIZA 的”脚本模板”的复杂版。两者的结构同构:ELIZA 的脚本由关键词 + 分解规则 + 重组规则构成,STRIPS 的算子由前提条件 + 添加表 + 删除表构成。但复杂度差距悬殊——STRIPS 有状态空间搜索和手段-目的分析来决定何时调用哪个算子,ELIZA 连推理都没有,仅靠关键词排名做模式匹配。
然而两者共享同一个范式:智能固化在程序/脚本中。ELIZA 的”智能”全在 DOCTOR 脚本里,引擎本身不含任何领域知识;STRIPS 的”智能”全在算子模板里,搜索器只是执行手段-目的启发式。这种”智能 = 人工编码”的范式,正是第一组织形式的共同特征。
**与 MYCIN 的对照——显式编码的两条爆炸路径**
STRIPS 的操作符(前提 + 效果)和 MYCIN 的规则(IF-THEN-CF)都是”显式编码”范式。STRIPS 编码行动的效果——用 add/delete list 声明执行一个动作后世界如何变化;MYCIN 编码知识的推断——用规则和置信度(CF)声明观察到某些证据后能推出什么结论。两者都是”陈述句告知”的工程实现:把专家知识显式写入结构化模板。
但两者都遇到了爆炸:STRIPS 遇框架问题——显式维护”什么没变”的框架公理随世界规模爆炸;MYCIN 遇规则爆炸——从感染诊断推广到更多领域时,规则数量线性增长、交互非线性增长。同一个”显式编码”范式,在行动域催生了框架问题,在知识域催生了规则爆炸——这是第一组织形式的同构局限。
---
## 成熟态的边界
STRIPS 1971 是”目标驱动的符号单体”这一第一组织形式的成熟态。它把 Logic Theorist 的状态空间搜索和 Advice Taker 的”陈述句告知”推进为可操作的规划系统,用 add/delete list 回应了框架问题。
但 STRIPS 也暴露了第一组织形式的三个本质局限:框架问题——显式维护世界模型的成本随规模爆炸;线性规划假设——Sussman 异常证明子目标不能总是独立依次实现;封闭世界假设——在开放世界中不成立。
这些局限不是工程问题,而是组织形式的本质边界。当代 LLM Agent 通过不维护精确世界模型来”绕过”框架问题,但绕过的代价是幻觉——这正是 STRIPS 留给我们的 Bar-Hillel 式批评。
值得注意的是,STRIPS 并非孤证。将 ELIZA、MYCIN 与 STRIPS 并置,第一组织形式的三个本质局限便各自有了代表作:STRIPS 暴露了框架问题(显式维护世界模型的成本爆炸),ELIZA 暴露了智能错觉(脚本匹配被误读为理解),MYCIN 暴露了规则爆炸(显式编码的知识不可扩展)。三者共同表明,”智能固化在程序/规则/脚本中”这一范式有其不可逾越的边界——这恰好为后续 Minsky 的连接主义反叛、Brooks 的具身智能反叛等三条伏线铺设了背景。
---
### 参考文献
[**strips-paper**] Fikes, R. E. & Nilsson, N. J. (1971). “STRIPS: A New Approach to the Application of Theorem Proving to Problem Solving.” *IJCAI 1971*. [https://www.ijcai.org/Proceedings/71/Papers/055.pdf](https://www.ijcai.org/Proceedings/71/Papers/055.pdf)
[**strips-retro**] Fikes, R. E. & Nilsson, N. J. (1993). “STRIPS, a retrospective.” *Artificial Intelligence*, 59, 227-232. [https://ai.stanford.edu/~nilsson/OnlinePubs-Nils/PublishedPapers/stripsrevisit.pdf](https://ai.stanford.edu/~nilsson/OnlinePubs-Nils/PublishedPapers/stripsrevisit.pdf)
[**shakey**] Nilsson, N. J. ed. (1984). *Shakey the Robot*. SRI Technical Note 323. [https://www.sri.com/wp-content/uploads/2021/12/629.pdf](https://www.sri.com/wp-content/uploads/2021/12/629.pdf)
[**ernst-newell**] Ernst, G. and Newell, A. (1969). *GPS: A Case Study in Generality and Problem Solving*. ACM Monograph Series, Academic Press.
[**mcchayes**] McCarthy, J. & Hayes, P. J. (1969). “Some Philosophical Problems from the Standpoint of Artificial Intelligence.” [http://jmc.stanford.edu/articles/mcchay69.html](http://jmc.stanford.edu/articles/mcchay69.html)
[**raphael**] Raphael, B. (1970). “The frame problem in problem-solving systems.” *Proc. Adv. Study Inst. on AI and Heuristic Programming*, Menaggio, Italy.
[**frame-problem**] Stanford Encyclopedia of Philosophy, “The Frame Problem.” [https://plato.stanford.edu/entries/frame-problem/](https://plato.stanford.edu/entries/frame-problem/)
[**lifschitz**] Lifschitz, V. “On the Semantics of STRIPS.” [https://www.cs.utexas.edu/~vl/papers/strips.pdf](https://www.cs.utexas.edu/~vl/papers/strips.pdf)
[**fikes-planex**] Fikes, R. E. (1971). “Monitored execution of robot plans produced by STRIPS.” *Proc. IFIP 71*, Ljubljana.
[**sussman**] Sussman, G. J. (1973). *A Computational Model of Skill Acquisition*. MIT AITR-297. [https://dspace.mit.edu/handle/1721.1/5782](https://dspace.mit.edu/handle/1721.1/5782)
[**sussman-anomaly**] “The Sussman Anomaly.” [https://www.futilitycloset.com/2024/09/25/the-sussman-anomaly/](https://www.futilitycloset.com/2024/09/25/the-sussman-anomaly/)
[**planning-ch10**] Planning Chapter 10 slides. [https://www.cse.chalmers.se/edu/year/2013/course/TIN171/slides/chapter10.pdf](https://www.cse.chalmers.se/edu/year/2013/course/TIN171/slides/chapter10.pdf)
[**planning-history**] Planning systems list. [https://www.cs.duke.edu/~brd/Teaching/Previous/AI/Lectures/Planning/planning.html](https://www.cs.duke.edu/~brd/Teaching/Previous/AI/Lectures/Planning/planning.html)
[**pddl**] PDDL 1.2 documentation. [https://planning.wiki/ref/pddl](https://planning.wiki/ref/pddl)
[**llm-strips**] “From Next Token Prediction to (STRIPS) World Models.” [https://arxiv.org/html/2509.13389v4](https://arxiv.org/html/2509.13389v4)
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 陈述句革命:告诉AI事实,让它自己想该做什么
https://www.paddysun.top/archives/4958 · 2026-08-23
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)
**篇号**:第 5 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[Logic Theorist 1956](https://www.paddysun.top/?p=4947) **阅读时间**:约 10 分钟
---
在所有人都在用代码指挥机器的时候,McCarthy 说:不如告诉机器事实,让它自己想该做什么。
1958 年,符号 AI 的世界正沉浸在 Logic Theorist 带来的震撼中。Newell 和 Simon 用 IPL 语言写出了第一个能证明定理的程序,启发式搜索的范式被确立下来。然而,同在达特茅斯会议上的 McCarthy 却看到了一个更深层的问题:Logic Theorist 的所有启发式都被硬编码在程序里,机器只会执行程序员写好的步骤。如果换一个问题,就得重写一遍代码。
McCarthy 在《Programs with Common Sense》中提出了一个激进的设想:不要用祈使句(命令代码)指挥机器,而要用陈述句(事实与规则)告知机器。机器接收到的不是”做这个、做那个”的指令序列,而是关于世界的描述——”我在桌前”、”车在家里”、”步行可达则可以走去”。机器自己通过演绎推理,从这些陈述句中推出该执行什么动作。
这不是接口形式的小改动,而是一场范式级别的革命。它意味着人与机器的关系从”指挥者-执行者”转变为”告知者-推理者”。意图的生成权从人手中部分转移到了机器手中——人只需要说”我想要什么”,机器自己推导出”该怎么做”。
> **McCarthy 的设计宣言**
>
> “The intelligence, if any, of the advice taker will not be embodied in the immediate deduction routine. This intelligence will be embodied in the procedures which choose the lists of premises to which the immediate deduction routine is to be applied.”
>
> 智能不在演绎引擎中,而在选择前提的过程中。
这句话在 65 年后读来仍然振聋发聩。它预言了现代 LLM Agent 体系中一个核心分工:LLM 本身只是”演绎引擎”——它的注意力机制做模式匹配和推理,但不含领域选择的智能;真正的智能体现在 harness 中——system prompt、RAG 检索、skill 选择,这些”选择前提列表的过程”才是 Agent 能力的真正来源。
---
## 一个从未实现的设想:Advice Taker 的历史定位
在进入技术细节之前,有一个重要的事实需要先澄清:Advice Taker 在 1958 年提出时**从未被实现**。McCarthy 在原文中明确将其定义为”a proposed program”(一个设想中的程序),并说”我们希望在编程系统之前先在另一篇论文中形式化这些启发式”。
这篇论文发表于 1959 年的《Mechanisation of Thought Processes》论文集,撰写于 1958 年。论文只有短短 8 页,但它勾勒的蓝图——用陈述句表示知识、通过演绎推出行动、循环执行观察-推理-行动——直到 LLM 时代才真正得到兑现。从这个意义上说,McCarthy 1958 不是一个已经完成的工程成果,而是一份预言书。
理解这一点很重要。Advice Taker 的价值不在于它跑通了多少实验,而在于它提出了一整套关于”智能机器应该如何组织”的概念框架。这些概念在随后的 65 年间被符号 AI 各条路线反复验证和修正,最终在 LLM Agent 体系中以截然不同的技术形态重新出现。
---
## 陈述句如何表示世界:表达式与知识编码
McCarthy 设计的第一个问题是:陈述句在机器中应该长什么样?他的答案是**列表结构**(list structure)——这直接借鉴了 Newell 和 Simon 在 IPL 语言中开发的列表处理技术。用嵌套列表表示逻辑表达式,原子是字符串,变量用特殊标记区分。
在 Python 复现中,这对应着用 tuple 来模拟列表结构。`expressions.py` 模块定义了最基本的表示原语:
```
# expressions.py —— 用 Python tuple 模拟 McCarthy 的 list structure
# 原子(term):字符串,如 "I", "desk", "home"
# 变量:以 "?" 开头的字符串,如 "?x", "?y"
# 复合表达式:tuple,如 ("at", "I", "desk") 表示 at(I, desk)
def expr(head: str, *args) -> tuple:
"""构造一个复合表达式"""
return (head, *args)
def implies(premise, conclusion) -> tuple:
"""构造一个蕴含式 P -> C"""
return ("implies", premise, conclusion)
def implies_many(premises: list, conclusion) -> tuple:
"""构造多前提蕴含式 P1, P2, ..., Pn -> C"""
if len(premises) == 0:
return conclusion
if len(premises) == 1:
return ("implies", premises[0], conclusion)
return ("implies", premises[0], implies_many(premises[1:], conclusion))
# 示例:
expr("at", "I", "desk") # at(I, desk) —— 我在桌前
expr("want", expr("at", "I", "airport")) # want(at(I, airport)) —— 我想去机场
```
这种表示方式看起来朴素,但蕴含着一个关键设计:**所有知识都是同一种数据结构**。事实、规则、目标、动作效果,全部用嵌套元组表示。这意味着推理引擎不需要区分”这是什么类型的知识”——它只需要处理一种数据格式。
在这个基础上,McCarthy 将 17 条前提编码为陈述句。`premises.py` 完整复现了原文的机场例程前提:
```
# premises.py —— 机场例程的 17 条前提(全部为陈述句)
# 事实类前提(信念)
p01 = expr("at", "I", "desk") # (1) 我在桌前
p02 = expr("at", "desk", "home") # (2) 桌子在家
p03 = expr("at", "car", "home") # (3) 车在家里
p11 = expr("walkable", "home") # (11) 家可步行
p12 = expr("drivable", "county") # (12) 县内可驾车
# 规则类前提(信念)
p06 = implies_many(
[expr("at", x, y), expr("at", y, z)],
expr("at", x, z),
) # (6) at 的传递性
p09 = implies_many(
[expr("walkable", x), expr("at", y, x),
expr("at", z, x), expr("at", "I", y)],
expr("can", expr("go", y, z, "walking")),
) # (9) 步行可行性规则
# 目标类前提(愿望)——唯一一条人下发的目标
p14 = expr("want", expr("at", "I", "airport"))
# 行动触发规则(信念→意图)
p17 = implies_many(
[x, expr("canachult", x, expr("prog", y, z), w), expr("want", w)],
expr("do", y),
) # (17) 当前态 + 行动计划 + 愿望 → 执行第一步
```
17 条前提中,只有第 14 条 `want(at(I, airport))` 是”愿望”——人下发的目标。其余 16 条全是”信念”——关于世界是什么样的陈述句。没有任何一条是”执行某动作”的祈使句。祈使句将由机器自己推出来。
这就是陈述句革命的核心:人只描述世界和目标,机器自己发现路径。
---
## 演绎引擎如何工作:统一、取式与条件化
有了陈述句表示的知识,接下来的问题是:机器如何从这些前提中推出新结论?McCarthy 的答案简洁得出奇——**只有一条推理规则**:统一加取式(unification + modus ponens)。
取式推理的逻辑很简单:如果知道 `P → C`(P 蕴含 C),并且知道 `P` 成立,那么可以推出 `C` 成立。统一则是找到变量绑定使两个表达式匹配的过程。两者结合起来就是:找到一条规则 `P → C`,将 P 与已知事实统一得到变量绑定,代换到 C 中得到新结论。
`deduction.py` 中的统一算法是整个演绎引擎的核心:
```
# deduction.py —— 统一算法:McCarthy 所说的
# "substitution for variables with modus ponens" 的组合
def unify(pattern, actual, binding=None):
"""找到变量绑定使 pattern 与 actual 匹配"""
if binding is None:
binding = {}
# 变量与任意项统一:记录绑定
if is_var(pattern):
if pattern in binding:
# 变量已有绑定,递归验证一致性
return unify(binding[pattern], actual, binding)
b2 = dict(binding)
b2[pattern] = actual
return b2
if is_var(actual):
return unify(actual, pattern, binding)
# 原子与原子统一:必须相等
if is_atom(pattern) and is_atom(actual):
return binding if pattern == actual else None
# 复合表达式统一:逐元素递归
if isinstance(pattern, tuple) and isinstance(actual, tuple):
if len(pattern) != len(actual):
return None
for p, a in zip(pattern, actual):
binding = unify(p, a, binding)
if binding is None:
return None
return binding
return None
```
统一算法本身是机械的——给定模式和事实,它要么找到一组变量绑定,要么返回失败。这正是 McCarthy 所说的”即时演绎例程”:它不含领域知识,不做启发式选择,只是忠实地执行模式匹配。
但 8 步推演之所以能链式展开,靠的不仅仅是完全匹配。一个更精妙的机制是**条件化**(conditionalization):规则的 N 个前提中,如果只有 N-1 个能匹配事实,剩下的 1 个作为条件留下,生成残余蕴含式。例如步行规则有 4 个前提,其中 3 个(步行可达性、起点位置、终点位置)匹配了已知事实,第 4 个 `at(I, ?y)` 作为条件留下,生成:
```
at(I, desk) → can(go(desk, car, walking))
```
这个残余蕴含式本身也是知识库中的一等公民——它可以被其他规则的前提模式匹配。规则 (15) 的前提 `(x → can(y))` 就是一条蕴含式模式,它能精确匹配这样的条件化结果。没有条件化机制,8 步推演的链条就无法启动。
---
## 机场例程:从 17 条陈述句到第一步行动
让我们跟随 McCarthy 的经典例子,看机器如何从 17 条陈述句前提中推出第一步行动。场景很简单:我坐在家里的桌前,想去机场。车也在家里。解决方案是步行到车旁,然后开车去机场。
### 八步推演的链式展开
整个推导过程分 8 步,每一步都只做一件事,最终在第 8 步触发行动。
**步骤 1-2:条件化生成行动可行性条件式。** 规则 (9)(步行)和规则 (10)(驾车)分别做条件化,匹配已知的地理事实,留下”我在哪里”作为条件。步骤 1 推出 `at(I, desk) → can(go(desk, car, walking))`,步骤 2 推出 `at(I, car) → can(go(home, airport, driving))`。
**步骤 3-4:动作效果实例化。** 规则 (13) 描述了 `go` 动作的效果——执行后到达目的地。分别对步行和驾车做实例化,得到 `did(go(desk, car, walking)) → at(I, car)` 和 `did(go(home, airport, driving)) → at(I, airport)`。
**步骤 5-6:用 canachult 链接条件与效果。** 规则 (15) 是一个二阶规则——它的前提本身就是蕴含式。它将步骤 1 的”可行性条件式”和步骤 3 的”动作效果式”拼接起来,得到 `canachult(at(I, desk), go(desk, car, walking), at(I, car))`——意思是”在我在桌前的条件下,步行去车旁这个动作最终能让我到达车旁”。步骤 6 同理得到驾车段的 canachult。
**步骤 7:动作复合。** 规则 (16) 将两段 canachult 串联成一个行动计划:`canachult(at(I, desk), prog(go(desk, car, walking), go(home, airport, driving)), at(I, airport))`。步行和驾车被组合成一个程序序列。
**步骤 8:愿望触发行动。** 规则 (17) 是最终的行动触发器。它汇合三个要素:当前状态 `at(I, desk)`(前提 1)、行动计划 canachult(步骤 7)、愿望 `want(at(I, airport))`(前提 14)。三者匹配后,推出祈使句 `do(go(desk, car, walking))`——机器自己决定第一步应该走到车旁。
Python 复现实验完整验证了这 8 步推导。`agent.py` 中的 `AdviceTaker` 类按序执行每一步,最终输出与 McCarthy 原文完全一致的结果。
```
步骤 8: do(go(desk, car, walking)) —— 祈使句!行动触发!
规则: 规则 (17):x=at(I,desk), canachult=步骤7, want=前提(14)
前提: at(I, desk) (1), 步骤 7, want(at(I, airport)) (14)
结论: do(go(desk, car, walking))
```
17 条全部是陈述句的前提,机器自行推出了祈使句。这验证了 McCarthy 的核心论点——陈述句告知足以驱动行动。
### 三个关键技术机制
8 步推演之所以成立,依赖三个环环相扣的技术机制。
**条件化**是启动器。它让规则不必匹配全部前提就能产出有用的中间结果——不是”匹配全部前提得到地面结论”,而是”匹配部分前提得到条件结论”。没有条件化,规则 (9) 和 (10) 都会因为缺少 `at(I, ?y)` 这个前提而完全沉默。
**蕴含式作为一等事实**是连接器。规则 (15) 的前提 `(x → can(y))` 是蕴含式模式,它匹配的不是地面事实,而是步骤 1 生成的条件式。这意味着推出的结论可以反过来成为更高阶规则的输入,推理链条因此得以逐层上升。
**愿望触发行动**是出口。愿望 `want(at(I, airport))` 本身不是祈使句——它是一个陈述句,描述”我想要什么”。祈使句 `do(go(desk, car, walking))` 是机器通过规则 (17) 自己推出来的。人不给行动指令,只给目标描述。
---
## 第一次暴击:Bar-Hillel 的当头棒喝
McCarthy 的论文在研讨会上宣读后,立刻遭到了哲学家、语言学家 Bar-Hillel 的尖锐批评。这场交锋不是学术礼仪上的客套,而是直指核心的正面冲撞。Bar-Hillel 的两条反对意见,在 65 年后的今天读来仍然锋利。
### at 的传递性不成立
Bar-Hillel 的第一个批评很具体:如果 `at` 表示”在……的紧邻空间附近”,那么传递性不成立。否则沿着 `at(I, desk) → at(desk, home) → at(home, county) → at(county, Earth)` 一路传下去,一切都在一切的紧邻附近——这显然荒谬。
McCarthy 的回答坦诚而重要:
> “‘at’ merely was intended to serve as a convenient mnemonic for the relation between a place and a sub-place. … I was not proposing a practical problem for the program to solve but rather an example intended to allow us to think about the kinds of reasoning involved.”
`at` 只是一个方便的助记符,代表”地点与子地点”的关系,而非日常语言中的”紧邻附近”。McCarthy 承认他举的不是实际问题,而是一个让我们思考推理类型的例子。
这一批评触及了形式系统与自然语言之间的永恒张力。形式系统要求谓词有精确的定义边界,而自然语言的谓词充满了模糊性和语境依赖。LLM 通过统计分布隐式处理这种模糊性,是优势也是代价——精确性和可审计性让位于可用性和泛化能力。
### 前提选择比演绎难 10^10 个数量级
Bar-Hillel 的第二个批评要致命得多。他说:
> “I do not think there could possibly exist a programme which would, given any problem, divide all facts in the universe into those which are and those which are not relevant for that problem. Developing such a programme seems to me by 10^10 orders of magnitude more difficult than, say, the Newell-Simon problem of developing a heuristic for deduction in the propositional calculus.”
翻译成今天的语言就是:把宇宙中所有事实分成”与当前问题相关”和”不相关”的程序,比 Newell-Simon 的命题演算演绎启发式难 10^10 个数量级。演绎本身是容易的,难的是**从无限的知识中选出当前需要用的那几条前提**。
这正是现代 Agent 面临的核心困境——上下文窗口选择问题。LLM 通过注意力机制做软选择,RAG 通过向量检索做硬选择,harness 通过 skill 选择做人工选择。但 Bar-Hillel 的质疑依然有效:谁能保证选出的恰好是相关的?遗漏了关键前提会失败,混入了无关前提会干扰。组合爆炸不是工程失误,而是形式系统在开放世界中的本质困难。
McCarthy 的回答承认了这一困难,但坚持”概念层面的困难在当前复杂度就已出现,解决它们将使我们能轻松增加复杂度”。这一赌注在 LLM 时代得到了部分验证——LLM 的统计能力确实让”前提选择”变得可行,虽然不完美。
---
## 复现实验中的组合爆炸:Bar-Hillel 预言的精确验证
在 Python 复现实验中,我们三次尝试构建自动演绎引擎,前两次均因组合爆炸而失败。这不是代码写得不好——而是 Bar-Hillel 批评的精确验证。在只有 17 条前提的玩具系统中,自动演绎就已经挂死了。
### 三次尝试的爆炸轨迹
**尝试 1:完全部分匹配。** 我们最初的设想是:对每条规则的 N 个前提,尝试匹配**任意子集**(包括跳过任意组合),看能推出什么。规则 (9) 有 4 个前提、知识库有 15 条事实。部分匹配意味着对 4 个前提中的每一个,可以选择”匹配某个事实”或”跳过”。仅这一条规则就产生约 2^4 × 15^4 ≈ **810,000** 种组合。15 条规则一起跑,程序直接挂死。
**尝试 2:受控部分匹配。** 我们收紧了约束:只允许”匹配 N-1 个前提、跳过 1 个”(恰好留 1 个条件)。但规则 (10) 有 5 个前提、知识库膨胀到 22 条事实。对 5 个位置中的每个做跳过,其余 4 个各尝试 22 条事实:5 × 22^4 ≈ **2,325,680** 种组合。程序仍然挂死。
**尝试 3:条件化(最终成功方案)。** 我们改变了思路:先用完全匹配生成地面结论,再对每个**已成功的匹配**做条件化(对每个前提 i 生成 `premise_i → conclusion`)。复杂度从”尝试所有可能的部分匹配”降为”对已完成的匹配做 N 次条件化”。规则 (9) 的完全匹配约 15^4 ≈ 50,625 次尝试,成功后条件化只需再做 4 次。整个 8 步推导顺利完成。
下面这张图直观展示了三次尝试的爆炸规模对比:
### 深层教训:演绎与前提选择必须分离
三次尝试形成了一个完整的论证链。
当演绎引擎试图同时做前提选择时(尝试 1-2),即使在仅 17 条前提的玩具系统中也会组合爆炸。这直接验证了 Bar-Hillel 的断言——前提选择的难度是组合爆炸级别的。
解决方案是把演绎和前提选择分离(尝试 3):演绎引擎只对给定的前提列表做完全匹配,前提选择由外部过程完成。在我们的复现中,这个外部过程就是 8 步受控推导的编排逻辑——人工决定每一步用哪条规则、匹配哪些事实。
这恰好回到了 McCarthy 原文的设计宣言——智能不在演绎引擎中,而在选择前提的过程中。演绎引擎不做前提选择,它只是忠实执行匹配的机械装置。真正的智能,在于谁来决定”当前应该用哪些前提”。
---
## 与 Logic Theorist 的对照:从启发式固化到陈述句告知
Advice Taker 与 Logic Theorist 之间的关系不是简单的先后继承,而是同一范式内部的一次深刻转向。McCarthy 在原文中直接引用了 Newell-Simon 1957 的列表结构工作——在技术底层,Advice Taker 继承了 Logic Theorist 的基础设施。但在更高的设计层面,Advice Taker 是对 Logic Theorist 范式的批评与改良。
维度Logic Theorist (1956)Advice Taker (1958)转向的本质**知识载体**启发式固化在 IPL 代码中知识编码为陈述句(数据)启发式从代码变为数据**推理方法**四种异质方法轮流尝试 + 手段-目的分析单一规则:统一 + 取式从多策略启发式到单一演绎机制**智能位置**智能在推理程序中(启发式的设计)智能在前提选择中(选哪些前提交给演绎引擎)智能从引擎转移到编排**行动触发**目标驱动的逆向搜索(证明定理)愿望触发的正向演绎(推出动作)从定理证明到行动生成**人机接口**程序员写问题规格 + 证明过程人告知事实 + 目标,机器推出行动从命令式到陈述式
两者最根本的差异在于**启发式的载体**。Logic Theorist 的启发式被写死在程序里——替换法、分离法、前向链、逆向链,每一种都是一段精心编写的代码。换一个问题领域,就要重写启发式。
McCarthy 的批评正是从这里切入:如果启发式本身也能用陈述句描述呢?那样机器就可以像处理其他知识一样处理启发式——选择、组合、甚至学习新的启发式。这就是为什么 Advice Taker 的演绎引擎如此简单(只有统一+取式一条规则),而把所有的”智能”都放在了”选择前提列表的过程”中。
从这个角度看,Advice Taker 不是 Logic Theorist 的替代者,而是它的继承者——它继承了符号演绎的内核,但将启发式的载体从代码转移到了数据。
---
## 祈使句指挥与陈述句告知的范式对照
两种范式的差异可以用下面这张流程图直观展示。左侧是传统的祈使句指挥模式——人写代码,机器逐条执行。右侧是 McCarthy 提出的陈述句告知模式——人提供事实和目标,机器自己推理出行动。
Advice Taker 的系统架构可以拆解为三个核心部件:知识库存储所有陈述句事实与规则,演绎引擎负责机械的统一和取式推理,前提选择器决定当前应该选取哪些前提交给演绎引擎。
McCarthy 的核心洞见在于:中间那个”前提选择器”才是智能的真正位置。演绎引擎只是忠实的执行者——它越机械、越透明越好。真正决定系统能力的,是选择哪些前提、按什么顺序提交给演绎引擎的那个过程。
---
## BDI 坐标对照:从 17 条前提到千亿参数
如果用 BDI(信念-愿望-意图)坐标来衡量,McCarthy 1958 与现代 LLM Agent 在结构上是同构的,但在实现方式上已经发生了天翻地覆的变化。
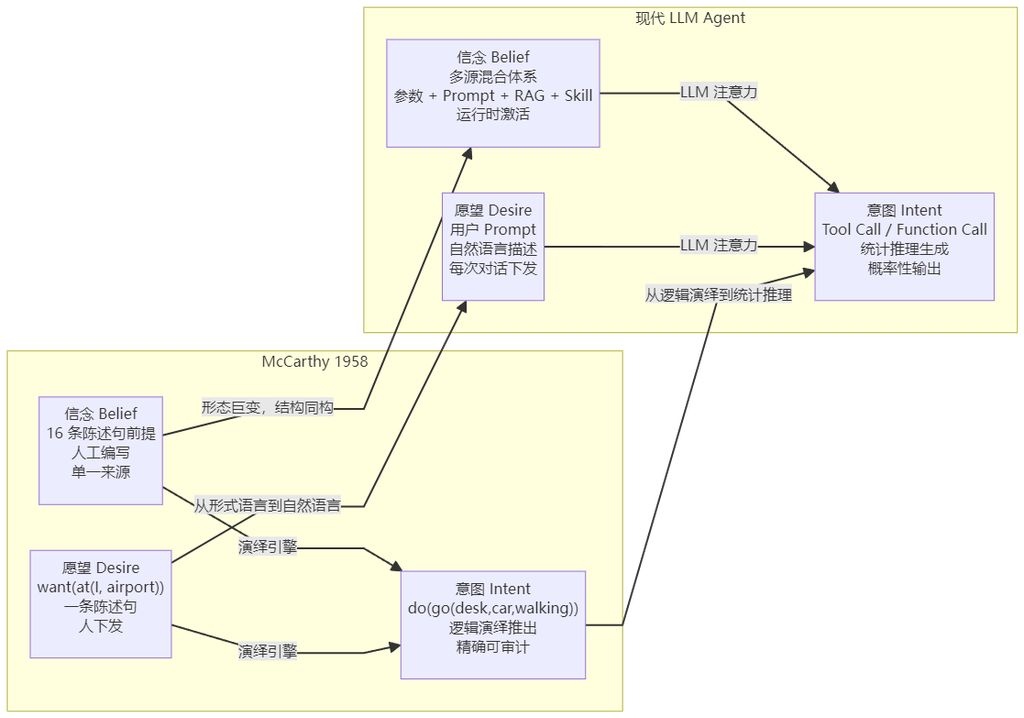
更详细的对照可以用下表呈现:
BDI 要素McCarthy 1958现代 LLM Agent变化本质**愿望 (Desire)**`want(at(I, airport))`——一条陈述句用户输入的 prompt / system prompt 中的任务描述形态从形式语言变为自然语言,但本质不变:人下发的”想要什么”**信念 (Belief)**16 条陈述句前提(事实+规则),全部人手工编写多源混合体系(见下表)从单一来源变为多源融合**意图 (Intent)**机器推出的祈使句 `do(go(desk,car,walking))`LLM 生成的 tool call / function call生成机制从逻辑演绎变为统计推理
现代 Agent 的信念来源已经从单一的人工编写演化为复杂的多源体系:
信念来源对应 McCarthy 1958 的什么在 Agent 中的角色**LLM 训练参数**McCarthy 设想中”机器应有的人类级常识”等效于属性表中预存的通用知识,但规模从 17 条变为千亿参数**System Prompt**McCarthy 的”standing orders list”——常设规则表harness 在启动时注入,提供行为框架**用户命令**`want(at(I, airport))`——愿望每次对话由用户下发,提供具体目标**RAG / 用户上传文件**通过陈述句告知的直接注入检索后注入上下文窗口,等效于追加新事实**Skill 描述**属性表——按抽象层级组织的规则harness 根据 task 选择并注入,等效于选取相关规则
信念的绝对数量在参数中(训练时内化),但能否激活取决于 system prompt + 用户命令 + RAG + skill 描述。这正好对应 McCarthy 的设计:智能不在演绎引擎中,而在选择前提的过程中。在现代 Agent 中,”即时演绎例程”对应 LLM 的注意力机制,”选择前提的过程”对应 harness 的 prompt 工程 + skill 选择 + RAG 检索,”智能体现在前提选择中”对应智能体现在 harness 设计中,不在 LLM 权重本身。
---
## 陈述句革命的遗产
McCarthy 1958 不是现代 Agent 的技术前身——从 Advice Taker 到 LLM Agent 之间没有连续的工程传承。但它是**概念上的最早蓝图**。陈述句告知对应 System Prompt,演绎并服从例程对应 ReAct 循环,属性表层级上溯对应 Skill 选择与 RAG 检索,`want(...)` 对应用户 prompt,`do(...)` 对应 Tool call。
信念来源的复杂化是现代体系与 McCarthy 设想的主要差异。McCarthy 的信念来源单一(人手工编写 17 条),现代 Agent 的信念来源多元(参数 + prompt + RAG + skill + 用户输入)。但结构是同构的:训练时预存通用知识,运行时选择激活相关子集。
Advice Taker 真正的遗产不是某个具体的算法或架构,而是一个根本性的问题意识——**人与机器的关系应该是告知与推理的关系,而非指挥与执行的关系**。这个命题在 1958 年是一个遥远的设想,在符号 AI 时代经历了工程化的成功与失败,在 LLM 时代以全新的技术形态重新成为现实。
Bar-Hillel 的批评也同样穿越了时间。前提选择的困难没有被解决,只是被统计近似和人工编排暂时绕过了。组合爆炸不是工程问题,而是形式系统在开放世界中的本质困难——这个困难从 McCarthy 的 17 条前提,到专家系统的 600 条规则,再到今天的千亿参数模型,始终存在,只是换了面孔。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 1956 年圣诞,三个男人发明了一台会”思考”的机器——但没人在乎
https://www.paddysun.top/archives/4947 · 2026-08-23
**系列名称**:[\[Agent 考古\] 符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)
**篇号**:第 4 篇 / 共 13 篇 **主题分类**:历史记述 **前置阅读**:[Agent 概念沿革](https://www.paddysun.top/?p=4915) · [阶段二总览](https://www.paddysun.top/?p=4942) **阅读时间**:约 12 分钟
---
1956 年 1 月,卡内基理工学院的一间研究生教室里,Herbert Simon 推了推眼镜,向在座的学生宣布了一个石破天惊的消息:”圣诞节期间,Al Newell 和我发明了一台能思考的机器。”1 教室里一片寂静。学生们不知道该作何反应——一个政治学教授声称造了台会思考的机器,这听起来更像酒后狂言而非学术宣告。
六个月后,在新罕布什尔州汉诺威的达特茅斯学院,一群顶尖数学家和科学家聚在一起,召开了那场后来被视为”人工智能”一词诞生地的暑期研讨会。提案中写着那句后来被引用了无数次的名言:”学习的每一个方面或智能的任何其他特征,原则上都能被如此精确地描述,以至于可以制造一台机器来模拟它。”
Newell 和 Simon 带着 Logic Theorist——一个**能实际运行的程序**——来到了达特茅斯。他们不是来空谈”机器能否思考”的,他们是来展示一台已经在思考的机器的。
然而反应冷淡。
Simon 后来回忆起那个夏天,语气中仍带着一丝不甘:”他们不想听我们说,我们当然也不想听他们说:我们有东西要展示给他们看!……说来讽刺,我们已经做出了他们所追求目标的第一个实例;其次,他们没怎么注意它。”1 Pamela McCorduck 在《Machines Who Think》中写道:”除了 Newell 和 Simon 自己,似乎没有人意识到他们所做之事的长远意义。”2
这就是 AI 历史上最具讽刺意味的开场之一——当所有人都在讨论”机器能不能思考”时,第一台真正能进行符号推理的机器就站在他们面前,却几乎无人理睬。
这台机器,就是 Logic Theorist。它是 AI 历史上第一个真正运行的启发式程序,也是符号主义范式的奠基之作。本文将回到 1956 年的那个夏天,厘清 Logic Theorist 是什么、它有据可查地影响了什么、以及它与当今 LLM 和 Agent 在技术路线上有何本质区别与概念联系。
---
## 三个男人与一台叫 JOHNNIAC 的计算机
Logic Theorist 的诞生离不开三个关键人物和一个特殊的地点。
**Allen Newell**(1927–1992),时为 RAND 公司研究员,研究后勤组织理论。1954 年,他在 RAND 听了 Oliver Selfridge 关于模式识别的报告后获得灵感,意识到简单的可编程单元组合起来能完成复杂的智能行为。他后来形容那天”完全沉浸了十到十二个小时”。1 那一刻,他从组织理论研究者转向了人工智能的先驱。
**Herbert A. Simon**(1916–2001),政治学家、社会科学家,后来的 1978 年诺贝尔经济学奖得主。在 RAND 担任顾问期间,他看到一台打印机用普通字符打印地图,由此意识到能操纵符号的机器或许也能模拟决策和思维过程。2 这个看似偶然的观察,最终将他引向了图灵奖的领奖台。
**Clifford Shaw**(1922–1991),RAND 的程序员与数学家,负责将 Newell 和 Simon 的构想转化为实际代码。Newell 后来评价说 Shaw”是我们三人中真正的计算机科学家”。2 在那个”程序员”这个职业尚未诞生的年代,Shaw 用手和脑把抽象的逻辑构想变成了机器可执行的指令。、
工作地点是加利福尼亚圣莫尼卡的 **RAND 公司**,程序运行在 RAND 自建的 **JOHNNIAC** 计算机上——一台以冯·诺依曼命名的早期计算机,重达数吨,内存以千字计量。就是在这样的硬件条件下,三个人造出了人类历史上第一个会推理的程序。
## 从灵感诞生到达特茅斯冷遇:时间线
Logic Theorist 的诞生不是一蹴而就的。从灵感闪现到达特茅斯展示,经历了两年多的酝酿与开发:
时间事件1954Newell 听 Selfridge 报告后获得灵感1955Newell 与 Simon 开始研发 Logic Theorist;”人工智能”一词尚未诞生1956 年 1 月Simon 在研究生课堂上宣布:”圣诞节期间,Al Newell 和我发明了一台能思考的机器”11956 年 6 月RAND 报告 P-868《The Logic Theory Machine》定稿31956 年夏在达特茅斯夏季人工智能研究项目上展示21956 年 8 月JOHNNIAC 上首次运行,产出第一个证明41957 年Newell, Shaw, Simon 在西部计算机联合会议上发表《Empirical Explorations of the Logic Theory Machine》5
值得注意的是,当 Newell 和 Simon 开始研发 Logic Theorist 时,”人工智能”这个词还不存在。达特茅斯会议既是这个词的诞生地,也是 Logic Theorist 首次公开亮相的舞台——只是这个亮相的掌声,迟到了几十年。
## 实绩:证明《数学原理》的 38 条定理
Logic Theorist 不是一个概念演示,也不是一个思想实验——它是一个能实际运行并产出可验证结果的程序。它的任务是证明 Whitehead 与 Russell《Principia Mathematica》(《数学原理》)第二章中的定理。
> **38 / 52**
>
> Logic Theorist 最终证明了《数学原理》第二章前 52 条定理中的 **38 条**,成功率约 73%。2
对其中 **定理 2.85**(部分版本编号为 2.53),程序找到了一条比原著更短的证明。Simon 将新证明寄给 Bertrand Russell 本人,Russell”回信表示欣喜”。26 一个程序改进了 20 世纪最伟大的逻辑学家之一的著作——这在 1956 年是令人震惊的成就。
但同样值得注意的是剩下的 14 条定理。Logic Theorist 未能证明它们,不是因为它们不成立,而是因为启发式搜索的深度和策略限制。这一事实——**启发式搜索能找到部分证明但不是全部**——揭示了符号主义范式从诞生之日起就伴随的根本特征:能力强大,但有边界。
---
## 手段-目的分析:缩小差异的递归智慧
Logic Theorist 不是暴力搜索。在一台内存以千字计量的计算机上,暴力遍历所有可能的证明路径是完全不可行的。Newell、Shaw 和 Simon 需要一种更聪明的策略——这就是**手段-目的分析(Means-Ends Analysis)**。
> **手段-目的分析的核心思想**
>
> 比较当前状态与目标状态之间的差异,选择一个操作来缩小这个差异;如果操作的前提条件尚不满足,则将其前提变为新的子目标,递归地重复上述过程。
具体到 Logic Theorist 的语境中:
1. **当前状态**是存储记忆中已有的公理和已证定理
2. **目标状态**是待证明的定理
3. **差异**是目标表达式与当前可用定理之间的结构差别
4. **手段**是四种推理方法(代入法、分离法、前向链、逆向链)
5. **子目标**是当推理方法的前提不满足时,需要先证明的中间命题
这个过程会形成一棵**目标-子目标树**——根节点是待证定理,叶节点是可以直接匹配的公理,中间节点是递归产生的子目标。
```
证明定理 A(根目标)
/ | \
证明引理 B 证明引理 C 证明引理 D(子目标)
/ \ | |
步骤 1 步骤 2 步骤 3 步骤 4(叶子:可直接执行)
```
手段-目的分析不是 Logic Theorist 发明的——它在人类问题求解中普遍存在。但 Logic Theorist 是第一个将这一策略形式化并在计算机上实现的系统。这一思想后来通过 GPS 流向了整个符号主义 AI 传统,成为经典规划系统的核心策略之一。
## 四种推理方法:从公理到定理的四条路径
Logic Theorist 实现了四种主要的推理方法57,它们构成了程序从公理出发抵达目标定理的四条路径。一个执行控制例程按序尝试这四种方法——若代入法在某个子问题上成功,原定理即获证;若失败,则选取下一个未尝试的子问题继续搜索。
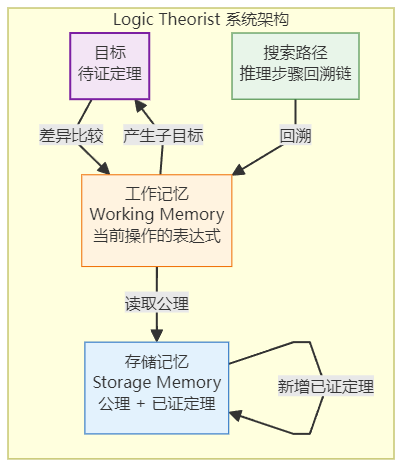
### 系统架构中的记忆与搜索
在深入四种方法之前,先看看 Logic Theorist 的整体架构。整个程序运行在一个**符号状态空间**中5,由四个核心组件构成:
- **存储记忆**(Storage Memory):存放公理和已证定理,是程序的”知识库”
- **工作记忆**(Working Memory):每次持有一条或几条表达式进行操作
- **目标**:一条待证定理,驱动整个搜索过程
- **搜索路径**:从目标定理出发,经一系列合法推理步骤回溯到公理,该路径即为证明
### 四种方法的推理流程
下面这张流程图展示了四种推理方法如何协同工作,构成一个从目标到公理的逆向搜索过程:
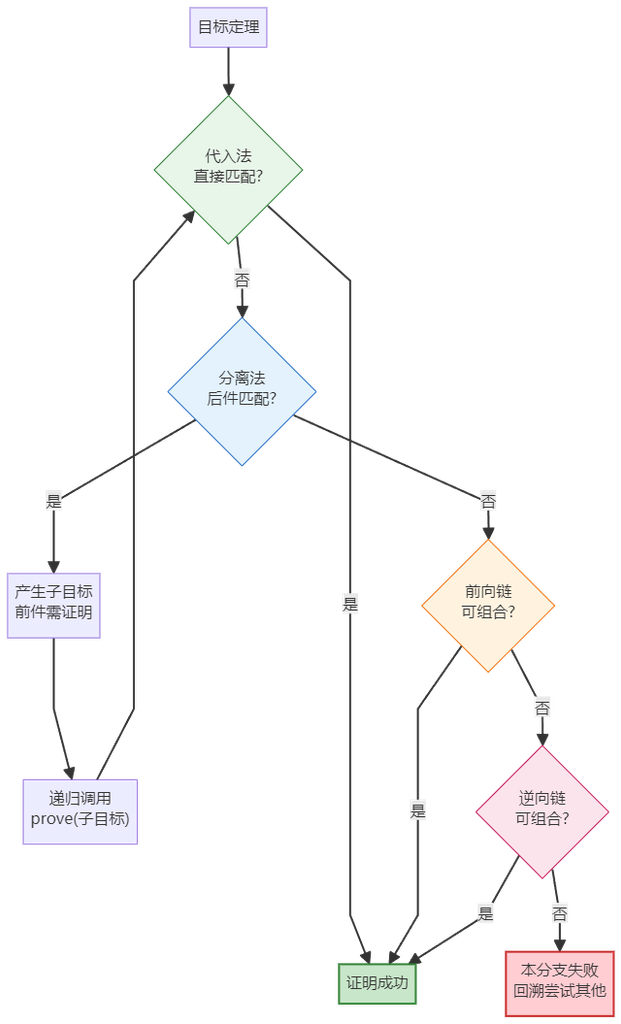
执行控制例程严格按照”代入法 → 分离法 → 前向链 → 逆向链”的顺序尝试。这个顺序是工程师写死的——机器不自行决定用什么方法。这正体现了”祈使句接口”范式的特征:所有智能都体现在工程师预先编码的步骤中。
### 代入法与分离法:代码中的实现
让我们直接看代码。在我们的 Python 复现中:
**代入法**是最优先的方法,也是最简单的方法:对每条已知公理/定理重命名变量后,尝试直接匹配目标表达式。如果匹配成功,定理一步得证。
```
def _try_substitution(self, target, label, depth):
"""代入法:重命名公理变量 → 匹配目标(含定义展开)"""
for src_label, src_expr in self.storage:
for src_form in all_forms(src_expr):
sa_rule = standardize_apart(src_form)
for tgt_form in all_forms(target):
binding = match(sa_rule, tgt_form)
if binding is not None:
instantiated = apply_substitution(sa_rule, binding)
if instantiated == tgt_form:
# 匹配成功,记录证明步骤
return True
return False
```
代码的逻辑很直接:遍历存储中的每条公理,生成其所有等价形式(比如 `p ⊃ q` 展开为 `~p v q`),重命名变量后尝试匹配目标的所有等价形式。如果找到一个变量代换使得两者完全相同,则代入成功。
**分离法**是更强大的方法,也是产生子目标的核心机制。它的思路是:目标是要证明 C,如果能找到一条公理或已证定理形如 `A ⊃ C`(即”如果 A 那么 C”),那么只需要证明 A 就能得到 C。于是,A 变成了新的子目标。
```
def _try_detachment(self, target, label, depth):
"""分离法:找到 A⊃C,匹配 C 与目标,递归证 A"""
for src_label, src_expr in self.storage:
if get_connective(src_expr) != "imp":
continue
antecedent = src_expr[1] # A
consequent = src_expr[2] # C
sa_rule = standardize_apart(src_expr)
binding = match(sa_rule[2], target) # 后件匹配目标
if binding is None:
continue
subgoal = apply_substitution(sa_rule[1], binding)
if self.prove(subgoal, f"子目标({label})", depth + 1):
return True # 子目标得证,则原目标得证
return False
```
分离法的本质是 modus ponens 的**反向使用**。通常的肯定前件(modus ponens)是从 A 和 A→B 推出 B;而分离法是从目标 B 出发,找到 A→B,然后去证明 A。这一逆向搜索的设计,正是目标驱动的符号单体的核心特征。
在我们的复现实验中,五条定理的启发式成功率为 **2/5 = 40%**——低于原文的 73%,但展现了完全相同的模式:启发式搜索在部分定理上成功,在另一部分上失败。成功的两条定理(*2.01 归谬律和 *2.11 排中律)分别展示了两种典型的证明路径:*2.01 通过代入法一步证明,而 *2.11 需要 7 步分离法 + 1 步代入法的递归搜索。
---
## 状态空间搜索:从目标回溯到公理
如果说目标-子目标树是从”问题分解”的视角理解 Logic Theorist,那么状态空间搜索就是从”路径寻找”的视角理解同一个过程。整个证明过程就是在符号状态空间中寻找一条从目标到公理的路径,每一步对应一次推理规则的应用。
### 搜索循环的核心代码
`engine.py` 中的 `LogicTheoristRunner` 类负责驱动整个搜索过程。让我们看看它的核心运行循环:
```
def run(self):
"""对每条待证定理依次尝试四种方法"""
for label, theorem in self.theorems:
self.lt.proof_trace = []
success = self.lt.prove(theorem, label)
# 用真值表验证定理是否为重言式
is_taut = TruthTable.is_tautology(theorem)
result = {
"label": label,
"theorem": theorem,
"method_success": success,
"is_tautology": is_taut,
"proof_steps": len(self.lt.proof_trace),
}
self.results.append(result)
```
这里有一个值得注意的设计:真值表验证是”后备”手段,用于确认定理本身是否成立,但**它不属于 Logic Theorist**。Logic Theorist 原文不使用真值表——因为真值表是暴力方法,不体现”智能”。启发式搜索才是 Newell 和 Simon 认为的”智能”所在。
### *2.11 的搜索路径:一棵七层的目标-子目标树
让我们以 `*2.11: p v ~p`(排中律)为例,看看状态空间搜索和目标-子目标树的实际形态。排中律无法通过代入法直接匹配任何公理,它需要 7 步分离法递归向下,最终到达一个可以用代入法匹配的叶节点。
运行我们的复现程序时,`tree_viz.py` 会输出这样的树形结构:
```
┌─ [根目标] (p v ~p)
│ 方法: 分离法
│ 公理: *1.2 = ((p v p) ⊃ p)
│ 代换: {p→(p v ~p)}
│
├─ [子目标 6] ((p v ~p) v (p v ~p))
│ 方法: 分离法
│ 公理: *1.2 = ((p v p) ⊃ p)
│ 代换: {p→((p v ~p) v (p v ~p))}
│
├─ [子目标 5] (... v ...)
│ 方法: 分离法
│ 公理: *1.3 = (q ⊃ (p v q))
│ ...
│
└─ [叶节点] ((p v ~p) v ~p)
方法: 代入法
公理: *1.3 = (q ⊃ (p v q))
代换: {q→p, p→~p}
✓ 公理直接匹配,递归终止
树深度: 7 层
方法使用: 代入法×1, 分离法×6
求解路径: *1.2 → *1.2 → *1.3 → *1.4 → *1.5 → *1.3 → *1.3
```
这棵树直观地展示了手段-目的分析的递归归约过程:根目标 `p v ~p` 与公理 `*1.2` 的后件 `p` 不同,但通过代换 `p → (p v ~p)` 可以消除差异,于是前件 `(pv~p) v (pv~p)` 成为新的子目标。子目标又无法直接代入,继续用分离法递归向下,直到叶节点——`(p v ~p) v ~p` 可通过代入法直接匹配公理 `*1.3` 的展开形式,递归终止。
一个有趣的细节是子目标 4——它是一个恒等步骤。公理 `*1.4` 是交换律 `(p v q) ⊃ (q v p)`,当 `p = q = (pv~p)` 时,前件和后件完全相同。这是搜索过程中的”空操作”——它不改变表达式,但消耗了一步搜索深度。这也说明了为什么 73% 的定理能被证明而不是全部:启发式搜索有时会走弯路,有时会因深度限制而提前终止。
---
## IPL:为推理而生的列表处理语言
Logic Theorist 是用 **IPL(Information Processing Language)** 编写的——一种由 Newell、Shaw、Simon 专门开发的早期列表处理语言。在 1950 年代,FORTRAN 和汇编语言是主流,但它们都不适合处理符号推理所需的复杂数据结构。
IPL 引入了许多在今天看来理所当然的概念:列表、关联检索、动态内存分配、递归、高阶函数(函数作为参数)。它是 Lisp 的前身,但采用汇编风格语法,缺乏 Lisp 的同像性(homoiconicity)和自动垃圾回收。89
IPL 的意义不仅在于它是 Logic Theorist 的实现语言,更在于它证明了一个重要的事实:要让机器表现出智能行为,首先需要一种能灵活操纵符号结构的语言。这一洞见后来催生了 Lisp,而 Lisp 在随后的几十年里成为了 AI 研究的首选语言。
---
## 有据可查的影响谱系
Logic Theorist 对后世 AI 的影响是深远的,但也是有边界的。以下每一条影响关系均附有具体引证——我们坚持”有引证才说”的原则,不因时间先后而默认因果。
### GPS:同一作者的直接演化
GPS(General Problem Solver,1957–1959)由 Newell、Shaw、Simon 三人在 Logic Theorist 之后建造。它不是”换了个名字的 Logic Theorist”,而是一项**有意识的推广**:Logic Theorist 围绕一个特定形式任务(定理证明)构建,GPS 则试图描述一个更通用的问题求解架构。10
Herbert Simon 的 Computer History Museum 传记也把 LT、GPS、IPL 和启发式编程归为同一研究纲领:”他与 Allen Newell 和 Cliff Shaw 合作,开发了首批启发式程序、首批列表处理语言……并确立了人工智能这一领域。”11
**引证强度**:强。同一作者、同一研究纲领,且有文献明确说明 GPS 是对 LT 的推广。
### STRIPS:显式引用手段-目的策略
STRIPS 论文(Fikes & Nilsson, 1971)中有一处**直接的文字引用**:
> “我们采用了 GPS 的策略:提取当前世界模型与目标之间的’差异’,并识别’相关于’缩小这些差异的算子 [6]。”12
论文中的参考文献 [6] 指向 GPS。这是手段-目的分析从 Newell-Shaw-Simon 研究纲领流向经典规划系统的**有据可查的因果链**。
**引证强度**:强。但须注意——引用对象是 GPS,而非 Logic Theorist 本身。影响是**间接**的(LT → GPS → STRIPS)。
### SOAR:通过 GPS 和问题空间假设的谱系
SOAR(Newell 与学生 Laird、Rosenbloom 在 CMU 从 1983 年开始开发)被描述为 Newell 统一认知理论的集大成者。”SOAR 是一个以问题空间组织的产生式系统,继承了 GPS 的观点——所有有意图的行为都是搜索。”13
**引证强度**:中强。SOAR 明确继承 GPS 的问题空间范式,但对 Logic Theorist 本身并无直接引用。谱系是 LT → GPS → SOAR。
### ACT-R:受 Newell 研究纲领影响
John Anderson 在 CMU 的问答中说:”我终于碰上了 Allen Newell 当时在做的产生式系统的工作,它似乎提供了我们称为’陈述性知识’与它如何被行动化(即’程序性知识’)之间的桥梁。”ACT-R 的文档也指出它”受 Newell 工作的启发,尤其是他终身倡导的统一理论理念”。1415
**引证强度**:中。受 Newell 的产生式系统和统一认知理论纲领影响,但并非直接引用 Logic Theorist。
### 物理符号系统假设:研究纲领的理论总结
Newell 与 Simon 在 1976 年图灵奖讲座《Computer Science as Empirical Inquiry: Symbols and Search》中将符号系统、启发式搜索和问题求解系统化为”物理符号系统假设”——这是对他们从 Logic Theorist 开始的研究纲领的理论总结。16
### 影响谱系图
```
Logic Theorist (1956)
│
├──[同一作者, 有意推广]──> GPS (1957-59)
│ │
│ ├──[显式引用手段-目的策略]──> STRIPS (1971)
│ │
│ ├──[继承问题空间范式]──> SOAR (1987+)
│ │
│ └──[受Newell产生式系统启发]──> ACT-R
│
└──[研究纲领总结]──> 物理符号系统假设 (1976)
```
这条谱系刻画了 Logic Theorist 在符号主义传统内部的影响力。但谱系图无法展现的是另一种影响方式:对 Logic Theorist 范式的**批评与替代**。1958 年,McCarthy 指出 Logic Theorist 的启发式全部固化在程序里——一种”祈使句指挥”范式——并设想了用陈述句告知机器、让其自行推出行动的替代方案。
### 诚实的边界:Logic Theorist 没有影响到什么
以下领域虽然在 Logic Theorist 之后出现,但**没有文献证据**表明它们因 Logic Theorist 而生:
- **神经网络 / 连接主义**:Logic Theorist 是符号主义的,与连接主义属不同范式。Rosenblatt 的感知机(1957)源于不同的研究传统。
- **深度学习 / 现代 LLM**:从感知机到反向传播到 Transformer,整条技术线与 Logic Theorist 无因果关联。
- **现代 Agent 框架**(ReAct、AutoGPT 等):它们的技术根源在 LLM 的涌现能力和提示工程,不在符号状态空间搜索。概念上的相似不等于因果上的传承。
---
## 与当今 LLM 的本质区别
Logic Theorist 与现代 LLM 虽然都追求”让机器表现出智能行为”,但它们属于完全不同的技术范式。
### 推理范式:符号演绎 vs 统计模式匹配
维度Logic TheoristLLM(如 GPT 系列)**推理类型**符号演绎——每一步推理都有明确的逻辑规则(代入、分离、前向/逆向链)统计模式匹配——基于注意力机制在嵌入空间中预测下一个 token**正确性保证**每条证明步骤可被逻辑规则验证,推理链**可审计**输出在统计意义上”像”正确答案,但无内在逻辑保证,可能”幻觉”**知识表示**显式符号结构:公理、定理、规则均以形式语言存储隐式分布式表示:知识编码在数十亿参数的权重中**可解释性**完全透明——搜索树的每一步展开都可追踪黑箱——可要求其生成”解释”,但解释本身可能不可靠
### 世界模型:封闭 vs 开放
Logic Theorist 运行在一个**封闭的形式世界**中:它的全部”宇宙”就是《数学原理》第二章的公理和已证定理。不存在公理之外的任何信息。这保证了推理的可靠性——但代价是无法处理任何公理系统以外的问题。
LLM 运行在一个(通过对互联网文本训练隐式获得的)**开放世界**中。它覆盖的话题几乎无边界,但不保证任何一条输出的逻辑正确性。
### 目标与控制
Logic Theorist 的目标完全由人预设(证明某条定理),搜索策略也由人编码(四种方法 + 执行控制)。程序自身不”选择”要做什么——它在状态空间中按既定启发式搜索。
LLM 没有内置的目标函数。它的行为由提示词(prompt)引导,输出由概率分布采样产生。”智能”体现为训练数据中的模式在统计意义上的泛化,而非对目标的显式追求。
不过,无论差异多大,Logic Theorist 与 LLM 在一个深层特征上殊途同归:两者都由人通过”祈使句”——代码或 prompt——直接指挥机器做什么。McCarthy 1958 年提出的替代方案恰好架起了从这一共性通向现代 Agent 的概念桥梁。
---
## 与当代 Agent 的区别和联系
如果说 Logic Theorist 与 LLM 的差异是范式层面的,那么它与当代 LLM Agent 的关系则更加微妙——两者在结构上有惊人的相似性,但在实现机制上完全不同。
### 当前 Agent 的典型架构
当前的 LLM Agent(如 ReAct、AutoGPT、LangChain Agent 等)通常由以下要素组成:
- **LLM 作为推理引擎**:生成推理步骤和行动决策
- **工具调用**:搜索、代码执行、数据库查询、API 调用
- **观察-推理-行动循环**:感知环境 → LLM 推理 → 调用工具 → 观察结果 → 再推理
- **记忆机制**:短期上下文窗口 + 长期向量检索
### BDI 坐标对照:从符号单体到 LLM Agent
为了更清晰地展示 Logic Theorist 与现代 Agent 在 BDI(信念-愿望-意图)坐标上的异同,我们用一张左右对照图来比较:
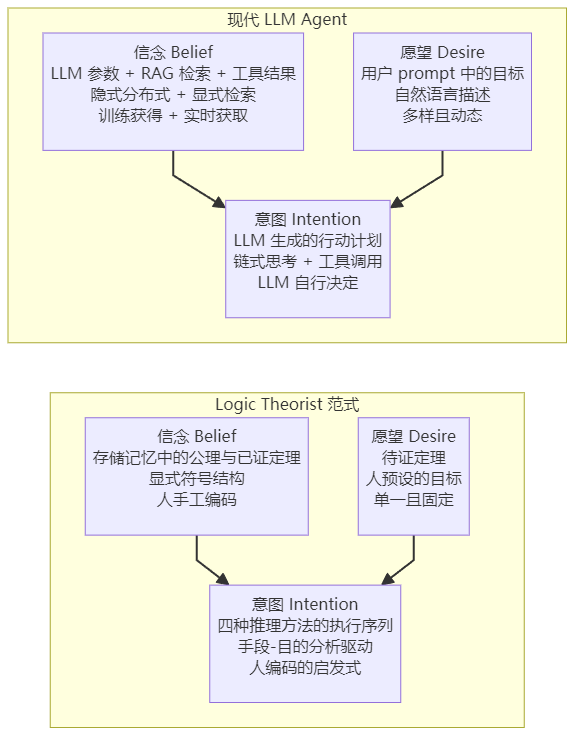
这张图揭示了两者在 BDI 三个维度上的本质差异:
- **信念层面**:Logic Theorist 的信念是显式的符号公理库,由人手工编码;现代 Agent 的信念是 LLM 的隐式参数加上 RAG 检索的显式结果,一部分来自训练,一部分来自实时获取。
- **愿望层面**:Logic Theorist 的目标是单一且固定的待证定理,由人预设;现代 Agent 的目标由用户 prompt 以自然语言描述,多样且动态变化。
- **意图层面**:这是最关键的差异。Logic Theorist 的”意图”——四种推理方法及其执行顺序——是工程师硬编码的;现代 Agent 的行动计划由 LLM 自行生成,人只通过 prompt 给出高层指导。
### 概念相似,但不等于因果传承
有论者可能注意到 Logic Theorist 的”目标-子目标树”与当前 Agent 的”任务拆解”在**形态上**相似——都是把大问题分解为小问题再逐一求解。但必须指出:
1. **“问题分解”是一个足够一般的策略**,不独属于 Logic Theorist。它至少可以追溯到 Pólya 1945 年的《How to Solve It》,甚至更早的数学实践。
2. **现代 Agent 的任务拆解由 LLM 的统计能力驱动**,而非由手段-目的分析这种符号启发式驱动。两者的实现机制完全不同。
3. **没有文献表明** ReAct、AutoGPT 或 LangChain 的作者在设计时参考了 Logic Theorist 或 GPS。它们的技术根源在 LLM 的提示工程和工具调用范式。
因此,准确的说法是:Logic Theorist 与现代 Agent 在**“目标驱动的递归问题分解”这一抽象策略上存在概念相似性**,但二者之间**没有可追溯的因果影响链**。
### 真正有意义的对照点:McCarthy 的 Advice Taker
如果说 Logic Theorist 与现代 Agent 之间有什么值得深究的联系,那不在 Logic Theorist 本身,而在 McCarthy 1958 年对它的**批评与替代方案**——Advice Taker。
McCarthy 在《Programs with Common Sense》中明确区分了两种方式:Logic Theorist 等程序的启发式”全部固化在程序里”,而 Advice Taker 的设想是”启发式全部用形式语言本身描述”——用陈述句告知机器世界的事实与规则,让机器自己通过逻辑演绎推导出该做什么。
这一区分——**“祈使句指挥” vs “陈述句告知”**——恰好预言了当今 LLM Agent 的运作方式:System Prompt 以自然语言陈述句告知 LLM 可用工具、行为约束和世界知识,LLM 自行推理决定行动。从 Logic Theorist 的”人编码搜索启发式”到现代 Agent 的”人写 prompt,LLM 自行推理”,中间的桥梁概念来自 McCarthy,而非 Logic Theorist 本身。
Logic Theorist 自身存在一个谱系图未能反映的结构性局限:它的全部智能——搜索策略、推理方法、目标设定——均以祈使句形式固化在程序代码中,使用者只能通过修改代码来改变其行为,无法通过”告知”来赋予新能力。这一”祈使句接口”的天花板,恰是 McCarthy 1958 年 Advice Taker 设想的出发点。
值得前瞻的是,STRIPS(1971)将 Logic Theorist 的状态空间搜索从定理证明工程化为行动规划系统:STRIPS 的算子实例化——将含变量的算子模式与当前世界状态匹配以得到变量绑定——直接对应 LT 的代入法;而算子应用(执行算子产生新状态)对应 LT 的分离法(modus ponens 的反向使用)。区别仅在于 LT 的”算子”是逻辑推理规则,STRIPS 的算子是世界中的物理行动。这一从”推理规则”到”行动算子”的置换及其引发的框架问题,将在后续文章中详述。
---
## 历史定位与总结
### 第一个真正运行的 AI 程序
Logic Theorist 是**第一个真正运行的 AI 程序**,它首次展示了机器能通过符号搜索完成此前需要人类智能的数学推理任务。在 1956 年达特茅斯会议上,当其他人还在讨论”机器能否思考”时,Newell 和 Simon 已经带着一个能证明定理的程序到场——尽管当时几乎无人意识到其意义。
### 有据可查的影响
Logic Theorist 的影响通过 **GPS → STRIPS / SOAR / ACT-R** 这条谱系流传。其中最硬的证据是 STRIPS 论文对 GPS 手段-目的策略的**显式文字引用**。而 Logic Theorist 本身被直接引用的案例较少——更多时候,它作为 Newell-Simon 研究纲领的起点被追认。
### 与 LLM 的关系
Logic Theorist 与 LLM 属于**完全不同的技术范式**:一个是符号演绎、封闭世界、可审计推理;另一个是统计模式匹配、开放世界、概率生成。两者在”让机器表现出智能行为”这一目标上一致,但在实现路径上几乎没有交集。
### 与 Agent 的关系
Logic Theorist 的”目标-子目标树”与现代 Agent 的”任务拆解”在抽象策略上有概念相似性,但**没有可追溯的因果影响链**。真正预言了现代 Agent 运作方式的,是 McCarthy 对 Logic Theorist 范式的批评——从”祈使句指挥”到”陈述句告知”的转向。
### 一句话总结
Logic Theorist 证明了”机器能推理”,LLM 证明了”机器能语言”,现代 Agent 试图把”语言”变成”行动”的接口——三者共享同一个远大目标,但走着不同的技术路线,而 Logic Theorist 对后两者的影响是**谱系性的而非因果性的**。
---
## 参考文献
[**1**] History Computer, “Logic Theorist Explained,” [https://history-computer.com/logic-theorist/](https://history-computer.com/logic-theorist/)
[**2**] Wikipedia, “Logic Theorist,” [https://en.wikipedia.org/wiki/Logic_Theorist](https://en.wikipedia.org/wiki/Logic_Theorist)
[**3**] RAND, “The Logic Theory Machine,” P-868, [https://www.rand.org/pubs/papers/P868.html](https://www.rand.org/pubs/papers/P868.html)
[**4**] dmoews, “logic-theorist” GitHub repository, [https://github.com/dmoews/logic-theorist](https://github.com/dmoews/logic-theorist)
[**5**] Newell, Shaw, Simon, “Empirical Explorations of the Logic Theory Machine,” RAND P-951, 1957, [http://bitsaversvm01.eastus2.cloudapp.azure.com/pdf/rand/ipl/P-951_Empirical_Explorations_Of_The_Logic_Theory_Machine_Mar57.pdf](http://bitsaversvm01.eastus2.cloudapp.azure.com/pdf/rand/ipl/P-951_Empirical_Explorations_Of_The_Logic_Theory_Machine_Mar57.pdf)
[**6**] Artificial Intelligence: A Modern Approach (4th Edition), [https://www.studocu.com/ja/document/tokyo-zokei-university/computer-science/artificial-intelligence-a-modern-approach-4th-editionpdf-60/120156116](https://www.studocu.com/ja/document/tokyo-zokei-university/computer-science/artificial-intelligence-a-modern-approach-4th-editionpdf-60/120156116)
[**7**] ACM, “Empirical Explorations of the Logic Theory Machine,” [https://dl.acm.org/doi/pdf/10.1145/1455567.1455605](https://dl.acm.org/doi/pdf/10.1145/1455567.1455605)
[**8**] ACM Turing Award, Allen Newell, [https://amturing.acm.org/award_winners/newell_3167755.cfm](https://amturing.acm.org/award_winners/newell_3167755.cfm)
[**9**] arXiv, “Executable Archaeology: Reanimating the Logic Theorist,” [https://arxiv.org/html/2603.13514v1](https://arxiv.org/html/2603.13514v1)
[**10**] kube-dojo, “AI History Articles” GitHub PR, [https://github.com/kube-dojo/kube-dojo.github.io/pull/452/files](https://github.com/kube-dojo/kube-dojo.github.io/pull/452/files)
[**11**] Computer History Museum, Herbert Simon, [https://history.computer.org/simon.html](https://history.computer.org/simon.html)
[**12**] Fikes & Nilsson, “STRIPS,” IJCAI 1971, [https://www.ijcai.org/Proceedings/71/Papers/055.pdf](https://www.ijcai.org/Proceedings/71/Papers/055.pdf)
[**13**] AIWiki, “Allen Newell,” [https://www.aiwiki.ai/wiki/allen_newell](https://www.aiwiki.ai/wiki/allen_newell)
[**14**] CMU, “John Anderson Q&A,” [https://www.cmu.edu/piper/news/archives/2011/may/anderson.html](https://www.cmu.edu/piper/news/archives/2011/may/anderson.html)
[**15**] oWiki, “ACT-R,” [https://owiki.org/wiki/ACT-R](https://owiki.org/wiki/ACT-R)
[**16**] Cornell, Newell & Simon 1976 handout, [https://www.cs.cornell.edu/courses/cs172/2002fa/handouts/newell-simon-intro.pdf](https://www.cs.cornell.edu/courses/cs172/2002fa/handouts/newell-simon-intro.pdf)
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 符号单体时代:范式最深刻的否定者,恰恰在范式内部孕育(阶段二导航)
https://www.paddysun.top/archives/4998 · 2026-08-23
**系列名称**:[\[Agent 考古\] AI 组织形式的七次重分配](https://www.paddysun.top/?p=4915)
**篇号**:第 3 篇 / 共 13 篇 **主题分类**:总领导航 **前置阅读**:[Agent 概念沿革](https://www.paddysun.top/?p=4915) · [阶段二总览](https://www.paddysun.top/?p=4942) **阅读时间**:约 8 分钟
---
符号主义 AI 的大厦在 1970 年代初已巍然耸立。[STRIPS](https://www.paddysun.top/archives/4968) 证明了规划的可行性,[MYCIN](https://www.paddysun.top/archives/4987) 展示了规则系统的工程价值,[ELIZA](https://www.paddysun.top/archives/4980) 则在大众心中种下了”机器能对话”的种子。McCarthy 的 [Advice Taker](https://www.paddysun.top/?p=4958) 从接口层面对祈使句指令发起了第一次内部否定——用陈述句告知替代代码硬编码。然而,符号单体范式真正深刻的危机,并不来自外部的批评者,而恰恰孕育在它自己的心脏地带。
1986 年是一个奇妙的年份。同一年,MIT 的两位巨匠从不同方向同时叩响了符号单体的根基。Minsky 在《心智社会》中从认知理论的高度宣告:单一中央心智是一个伪解释,智能不在某个 agent 的内部,而在大量本身无智能的小 agent 的组织方式之中。几乎同时,Brooks 在 IEEE 期刊上发表了 subsumption 架构的论文,用移动机器人的工程实证证明:感知可以直接耦合行动,中央世界模型和自上而下的规划并非必须。
这不是两条孤立的反叛路线。五年之后,Brooks 在 1990 至 1991 年的系列论文中将工程论证推向了哲学对垒——无表征智能、物理接地假设、四关键概念体系化。更意味深长的是,Brooks 在《无表征智能》中直接援引 Minsky 的心智社会作为同类解释,两条伏线在原文层面明文交汇。三条伏线如同三记重锤,分别击碎了符号单体的三块基石:组织结构、运作机制、以及表征本身的合法性。
本篇是三条反叛伏线的总领导航。我们不深入每篇论文的技术细节,而是勾勒三条伏线的基本面貌、它们之间的相互关系,以及它们如何共同构成了对第一组织形式的系统性否定。读完本篇,你将清楚后续四篇伏线文章的阅读路径,以及为什么我们说”范式最深刻的否定者,恰恰在范式内部孕育”。
---
## 三块基石与三个否定:符号单体的瓦解坐标
符号单体范式建立在三块基石之上。第一块是**接口方式**——用祈使句指令(代码硬编码行为)告诉机器做什么;第二块是**组织结构**——单体集中式大脑,所有决策汇聚于一个中央心智;第三块是**运作机制**——中央世界模型加自上而下的规划,机器先建模再搜索再行动。
三条反叛伏线分别从不同维度瓦解了这三块基石。McCarthy 否定了接口方式(已在阶段二覆盖),Minsky 否定了组织结构,Brooks 否定了运作机制与表征基础。三者合在一起,构成了对符号单体范式的系统性内部否定。
> 符号单体的三块基石,不是被外部对手推倒的,而是被范式内部最优秀的头脑自己拆掉的。每一个否定者都曾经是最坚定的建造者——Minsky 是框架理论之父,Brooks 出身经典 AI 传统,McCarthy 本人就是符号主义的奠基人。
下面这张对照图直观展示了三块基石与三个否定的对应关系:
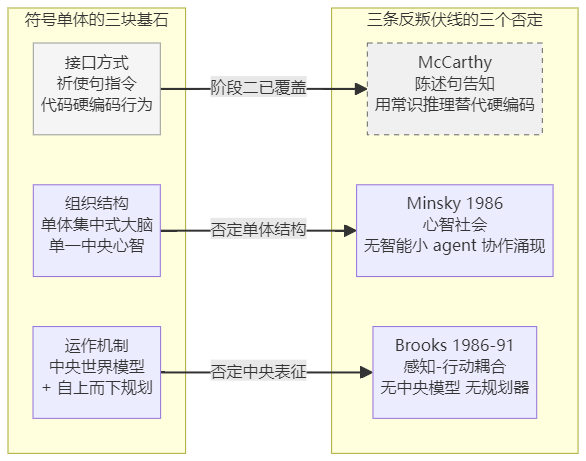
更精确的对照可以用下表来理解:
基石维度符号单体的形态反叛伏线的否定接口方式祈使句指令(代码硬编码行为)McCarthy:陈述句告知,机器自己推理做什么组织结构单体集中式大脑**Minsky:心智社会——本身无智能的小 agent 协作涌现**运作机制中央世界模型 + 自上而下规划**Brooks:感知-行动耦合,无中央模型无规划器**
注意三个否定的递进关系。McCarthy 的否定停留在接口层——他不怀疑单体结构和世界模型,只怀疑”告诉机器做什么”的方式。Minsky 的否定深入结构层——他不怀疑表征和符号本身,只怀疑”单一中央心智”这个容器。Brooks 的否定则最为激进——他直捣运作机制的核心,连世界模型和规划器都一并取消。三者的火力越来越猛,否定的层次越来越深。
---
## 三条反叛伏线的基本面貌
### [Minsky 1986:智能不在单个 agent 中,而在 agent 的组织方式中](https://www.paddysun.top/archives/4997)
1986 年出版的《心智社会》是 Minsky 对自己数十年 AI 研究的一次总结与反叛。全书以 270 篇短文的形式,系统地拆解了”单一中央心智”这个人们习以为常的概念。Minsky 的核心论点简单而锐利:除非能用本身无思想无感受的东西解释心智,否则只是在兜圈子。单一中央自我的概念什么也解释不了——一个没有部件的东西提供不了任何可充作解释的构件。
基于这一批判,Minsky 提出了心智社会的构想:智能源于大量本身无智能的小 agent 的冲突与协商。这些小 agent 各司其职,通过分层与异层组织、交叉抑制、K 线记忆、审查器谱系、B 脑反思层等机制协作,最终在整体层面呈现出”有智能”的外观。Minsky 将其称为”单动因谬误”——人们总是假设有一个统一的”我”在做决定,但实际上是成百上千个小机构在协商。
这条伏线的当代回响极为深远。LLM 的注意力头、专家层、多模态架构,都可以看作是心智社会思想的统计版本。但 Minsky 自己也承认,心智社会更像是”想象的探险故事”而非可操作的工程方案——它给出了否定的锐利,却没有给出建造的路径。
### [Brooks 1986 subsumption:感知直接耦合行动,无世界模型](https://www.paddysun.top/archives/5013)
同样是 1986 年,Brooks 在 IEEE Journal of Robotics and Automation 上发表了”A Robust Layered Control System for a Mobile Robot”,正式提出了 subsumption 包容架构。与 Minsky 从认知理论出发不同,Brooks 的出发点是纯粹的工程现实——移动机器人在真实世界中的鲁棒性问题。
传统 AI 的移动机器人遵循感知→建模→规划→执行的功能流水线。每一步都需要世界模型,每一步都引入延迟和误差。Brooks 的方案截然不同:他将控制系统按行为而非功能切片,每一层都是一个从感知到行动的完整通路。第 0 层负责避障,第 1 层负责漫游,第 2 层负责探索。高层通过抑制和禁止两种原语包容低层的行为,仲裁由接线固定优先级决定,不存在运行时的中央仲裁器。
subsumption 架构最惊人的结论是:框架问题在这个体系中根本不存在。因为没有需要维护的世界模型,所以不存在”什么变了、什么没变”的问题。Brooks 用一句后来广为人知的话总结了这一思路——”世界自身即是它最好的模型”。当然,这句口号的最终定型要等到 1990 年的《象不下棋》。
### [Brooks 1990-91 无表征智能:反叛的正面化与体系化](https://www.paddysun.top/archives/5030)
1986 年的 subsumption 论文还是以工程论证的面目出现的——Brooks 只是在说”这样做更鲁棒”。到了 1990 至 1991 年,反叛的哲学意味被正面化、体系化了。三篇标志性论文构成了完整的理论宣言:
《象不下棋》(1990)正面提出了物理接地假设,宣判”经典 AI 所立足的符号系统假设存在根本缺陷”。定稿口号”世界自身即是它最好的模型”就出自这篇论文。Brooks 用七台真实机器人作为证据链,论证智能必须植根于物理世界。
《无表征智能》(1991,1987 年定稿)给出了两条正式陈述:结论 C 认为”在非常简单的智能水平上,显式的表征与世界模型纯粹碍事”;假设 H 更进一步,提出”表征是构建智能系统最庞大部件时错误的抽象单元”。论文最强的声明出现在第 5.1 节——”不仅没有中央表征,连中央系统都没有……是造物的观察者在赋予中央表征或中央控制。”正是在这里,Brooks 直接援引 Minsky 的心智社会作为同类解释。
《无推理智能》(1991)则是体系化的集大成之作。Brooks 提出了四关键概念——情境性、具身、智能、涌现——每一个都对应一句口号。他给出了组织原则清单,对表征立场做了官方修正(拒绝传统 AI 的表征方案,但允许部分世界模型),还将学习分为四类并评估了各自的进展。这篇论文也对 Q-learning 做出了正面评价,埋下了通向强化学习时代的伏笔。
---
## 三条伏线的时间线与相互关系
三条伏线不是孤立的,它们之间有明确的时间先后、思想传承和明文交叉。下面这张图展示了它们的演进路径与交汇点:
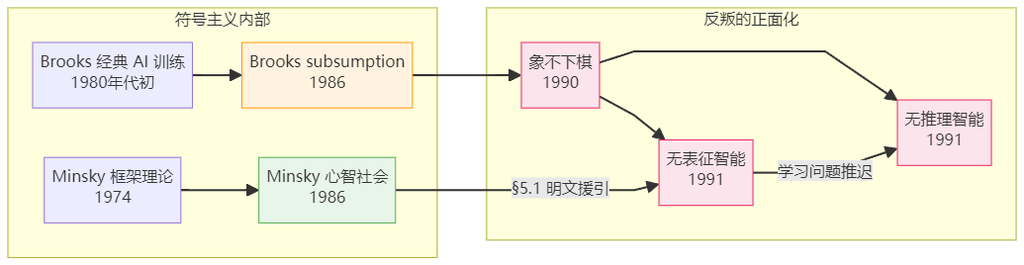
从时间线上看,1986 年是一个爆发点——Minsky 的心智社会和 Brooks 的 subsumption 架构同年问世,分别从理论和工程两个方向否定了符号单体。此后 Brooks 沿着自己的路线继续推进,在 1990 至 1991 年间完成了从工程论证到哲学宣言的跃迁。
从思想关系上看,两条伏线有一个明确的明文交叉点:《无表征智能》第 5.1 节直接引用心智社会作为同类解释。Brooks 承认,他的”行为簇”和 Minsky 的”agent 社会”描述的是同一种结构——没有中央控制,智能从局部交互中涌现,中心性是观察者的赋予。
但两条伏线的出发点和归宿也有显著不同。Minsky 关心的是认知结构的本质——心智由什么构成、如何组织。Brooks 关心的是智能与世界的关系——为什么要建模、感知如何连接行动。Minsky 的否定停留在”单体”层面,他不怀疑表征本身;Brooks 的否定深入到”表征”层面,连世界模型都要一并取消。
---
## [Bar-Hillel 批评:贯穿三条伏线的元批评](https://www.paddysun.top/archives/5039)
在三条伏线的背后,有一条更隐蔽的线索贯穿始终——那就是 Bar-Hillel 式批评。1958 年,Bar-Hillel 针对机器翻译提出了一个根本性的质疑:自然语言的模糊性使得前提选择不可能自动完成。这个批评看似针对翻译,实则触及了所有符号系统的共同困境。
在三条反叛伏线中,Bar-Hillel 式批评以不同的形态反复出现。对 Minsky 的心智社会来说,批评指向协调机制——”成百上千个小 agent”的协调靠”共处一脑的情境浸润”,但情境浸润到底是什么?Minsky 没有给出可操作的协调算法。对 Brooks 的 subsumption 来说,批评指向能力边界——反应式控制在”非常简单的智能水平上”有效,但复杂任务呢?优先级是接线固定的,无法运行时调整。对 Brooks 的无表征智能来说,批评指向立场的内在张力——”无表征”的边界由作者自己划定,标题口号与实际立场之间存在微妙的间隙。
Bar-Hillel 式批评不是要否定三条伏线的价值,而是要标记每一条伏线的诚实边界。它提醒我们:每一个反叛都有其止步之处,每一个否定都有其未完成的承诺。正是这些边界和未完成之处,构成了 AI 发展的真实动力——下一代范式总是在上一代范式止步的地方重新出发。
---
## 后续阅读:四篇伏线文章的路径安排
三条反叛伏线加上 Bar-Hillel 批评的当代回响,共构成四篇深度文章。建议按以下顺序阅读,因为每一篇都建立在前一篇的基础之上,且交叉互文的力度逐渐增强。
**[第一篇:心智社会——Minsky 对单体结构的否定](https://www.paddysun.top/archives/4997)** 从 Minsky 1960 年代 MIT 积木机器人的工程之根讲起,追溯从框架理论到心智社会的自我否定轨迹。重点理解三条递进论证:循环论证检验、小人无限回归批判、单动因谬误命名。然后进入心智社会的组织方式——agent、agency、差动机、K 线、审查器、B 脑——逐一拆解这些实名构件的运作逻辑。最后回到 BDI 坐标,看”意图的机构化降解”如何重写我们对目标和愿望的理解。
**[第二篇:subsumption 架构——Brooks 对中央世界模型的工程否定](https://www.paddysun.top/archives/5013)** 从 MIT AI Lab 的移动机器人项目切入,与 SRI 的 Shakey 形成正面对照。重点理解两种分解方式的根本差异:传统的功能流水线 vs subsumption 的行为切片。深入拆解抑制与禁止两种仲裁原语,以及增量调试的工程方法论。用三层架构(避障、漫游、探索)的具体实现,展示感知-行动耦合如何在无中央模型、无规划器的情况下实现鲁棒控制。
**[第三篇:无表征智能——反叛的正面化与体系化](https://www.paddysun.top/archives/5030)** 以 Brooks 1990 至 1991 年的三篇核心论文为主体,追踪从工程论证到哲学对垒的完整轨迹。重点理解物理接地假设、两条正式陈述、四关键概念体系。特别关注表征立场的官方修正——”无表征”不是绝对的,而是拒绝传统 AI 的特定表征方案。最后进入学习四分类和 Q-learning 判词,看 Brooks 如何为强化学习时代埋下伏笔。
**[第四篇:Bar-Hillel 批评的当代回响——三条伏线与 LLM 的三重对质](https://www.paddysun.top/archives/5039)** 将三条反叛伏线拉到当代,与 LLM 展开三重对质。心智社会的”多样性涌现”对应 LLM 的多头注意力,subsumption 的”感知-行动耦合”对应 LLM 的 tool-use,无表征智能的”隐式模型”对应 LLM 的参数化统计分布。重点理解一个核心命题:LLM 不是三条伏线的延续,而是三条伏线揭示的问题结构在统计时代的重现。幻觉从哪里来?智能错觉为什么持续存在?规则爆炸为什么变成了参数爆炸?这些问题都能在三条伏线中找到原型。
---
## 导航结语:为什么要重返 1986
三十多年后的今天,当我们谈论 LLM Agent、谈论多智能体系统、谈论具身智能时,很少有人意识到这些热门话题的核心论争,早在 1986 年就已经以更清晰的形态发生过一次。Minsky 和 Brooks 提出的问题——智能是单体的还是社会的?需要世界模型还是不需要?表征是基础还是障碍?——至今没有标准答案。
重返三条反叛伏线,不是为了发思古之幽情,而是为了获得审视当下的坐标系。当我们说 LLM 是”无中央表征”的统计系统时,我们是否真的理解了 Brooks 的”无表征”意味着什么?当我们说多智能体是未来方向时,我们是否真的思考过 Minsky 提出的协调难题?当我们惊叹于 Agent 的工具调用能力时,我们是否意识到那不过是 subsumption 的语言版本?
三条伏线的真正价值,不在于它们给出了什么答案,而在于它们划定了什么边界。知道什么问题在三十年前就已经被问过、被争过、被部分回答过,我们才能在今天的喧嚣中保持清醒。这就是为什么我们要花四篇文章的篇幅,重返 1986 年那个范式崩塌的关键时刻。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] 符号单体时代:第一组织形式的确立与反叛(阶段二导航)
https://www.paddysun.top/archives/4942 · 2026-08-23
**系列名称**:[\[Agent 考古\] AI 组织形式的七次重分配](https://www.paddysun.top/?p=4915)
**篇号**:第 2 篇 / 共 13 篇 **主题分类**:总领导航 **前置阅读**:[Agent 概念沿革](https://www.paddysun.top/?p=4915) **阅读时间**:约 8 分钟
## 1956-1976,AI 的第一个范式是怎么建立又怎么暴露边界的
1956 年的达特茅斯会议上,[Logic Theorist](https://www.paddysun.top/?p=4947)用 52 条定理证明宣告了符号主义 AI 的诞生。两年后,McCarthy 的 [Advice Taker](https://www.paddysun.top/?p=4958) 构想描绘了”用陈述句告知机器常识,让它自行演绎并服从指令”的美好蓝图。这两个奠基性工作共同确立了 AI 的**第一组织形式**——目标驱动的符号单体:一个拥有显式世界模型、通过逻辑推理达成目标的单体系统。
从 1956 到 1976 年的二十年间,这一组织形式从雏形走向成熟,又在成熟中暴露了自身的根本边界。STRIPS 将状态空间搜索工程化为可操作的规划系统,ELIZA 用最简的模板匹配确立了”智能”的下界,MYCIN 则把规则范式推向顶峰的同时遭遇了规则爆炸的天花板。这三个系统分别从成熟态、最小基线和规则边界三个维度,共同勾勒出第一组织形式的完整轮廓。
本阶段的三篇核心文章,将带你重走这二十年的关键节点。我们不只是复述历史,而是要回答一个根本问题:当 AI 的第一个范式走到尽头时,它留下了哪些遗产,又埋下了哪些反叛的种子?理解这段历史,才能真正看懂今天 LLM Agent 的架构选择究竟从何而来,又将走向何方。
## 阶段二讲什么,为什么重要
阶段二聚焦于 AI 第一组织形式的**确立与显形**。如果说阶段一([Logic Theorist](https://www.paddysun.top/?p=4947) 与 [Advice Taker](https://www.paddysun.top/?p=4958))回答了”符号主义 AI 如何诞生”,那么阶段二要回答的是:当这种组织形式真正落地为工程系统时,它长什么样、能走多远、又在哪里碰壁。
这一阶段的重要性在于,它是符号主义 AI 从”思想实验”走向”工程现实”的关键一跃。[STRIPS](https://www.paddysun.top/archives/4968) 在 Shakey 机器人上实现了感知-规划-执行的完整闭环,这是后世所有 Agent 架构的直接原型。ELIZA 用最简陋的机制制造了最惊人的”智能错觉”,迫使我们重新思考”智能”究竟意味着什么。MYCIN 将专家知识编码为数百条规则,在医学诊断领域达到了与人类专家相当的水平,却也暴露了知识获取瓶颈的本质困难。
更重要的是,这三个系统共同暴露了第一组织形式的三条根本边界:框架问题、智能错觉和规则爆炸。这些边界不是工程上可以通过”更多计算力”或”更多数据”解决的问题,而是内在于符号主义范式的本质局限。理解这些边界,是理解后续所有 AI 范式转向——从连接主义的崛起到深度学习的革命——的关键钥匙。
## 三个核心问题,三个路标系统
阶段二的三篇文章分别回答一个核心问题,每个问题对应一个经典系统。三者共同构成了理解第一组织形式的完整坐标系。
### 成熟态长什么样:STRIPS 与行动规划的工程化
STRIPS(斯坦福研究所问题求解器)是第一组织形式的**成熟形态**。它诞生于 1971 年,是 Shakey 机器人项目的核心大脑。Fikes 和 Nilsson 将 Logic Theorist 的状态空间搜索与 GPS 的手段-目的分析结合起来,创造了第一个真正可运行的自动规划系统。
STRIPS 的核心创新是**操作符三元组**:每个行动由前提条件、添加表和删除表定义。执行一个行动时,系统自动应用添加表和删除表来更新世界模型,无需重新推导整个世界的状态。这一设计既是对 McCarthy & Hayes 1969 年提出的框架问题的工程回应,也埋下了封闭世界假设的隐患——在积木世界里完美运行的机制,放到开放世界中就会遭遇框架公理爆炸。
理解 STRIPS,就是理解现代 Agent 的 tool call、state management、plan-then-execute 模式从何而来。今天 ReAct 循环中的每一次工具调用,本质上都是 STRIPS 操作符在 LLM 时代的转世。
### 最小基线在哪里:ELIZA 与智能错觉的底线
ELIZA 是第一组织形式的**退化形态**,也是衡量”智能”的最小基线。1966 年,Weizenbaum 用一套关键词匹配加模板替换的机制,创造了一个能与人进行自然语言对话的程序。它没有知识库、没有推理引擎、没有世界模型,甚至不记忆对话历史——但用户却纷纷相信”它理解我”。
ELIZA 的意义不在于它有多智能,而在于它揭示了人类认知中的一个深刻倾向:我们倾向于将模式匹配解读为理解,将行为相似性等同于内部机制。Weizenbaum 本人对这种”ELIZA 效应”深感震惊,并在十年后写下《计算机能力与人类理性》进行深刻的自我批评。
将 ELIZA 作为基线的价值在于,它迫使我们追问:当我们说一个系统”有智能”时,我们究竟在说什么?是行为上的相似,还是机制上的等价?这个问题在 LLM 时代变得更加尖锐——如果 ELIZA 用零知识创造了智能错觉,那么拥有千亿参数的 LLM,它的”理解”又有多少是真正的理解,多少是更精致的模式匹配?
### 规则范式的顶峰和边界:[MYCIN](https://www.paddysun.top/archives/4987) 与确定性因子的工程
MYCIN 是第一组织形式的**顶峰形态**。1976 年,斯坦福大学的 Shortliffe 开发了这个感染性疾病诊断专家系统,用约 600 条 IF-THEN 规则加确定性因子(CF),在菌血症诊断领域达到了与人类专家相当的水平。
MYCIN 的技术贡献在于它对不确定性的工程处理。确定性因子不是概率,而是对”专家信念强度”的量化——它不满足概率论公理,却能很好地模拟医生在不确定情况下的推理方式。反向链推理从假设出发追溯证据,结构上与 Logic Theorist 的分离法同构。
MYCIN 的真正意义在于它暴露了规则范式的根本边界。600 条规则只覆盖了菌血症一个子领域,规则之间的交互不可预测,每条规则都需要专家手动编码——这就是著名的知识获取瓶颈。MYCIN 的成功证明了符号主义在封闭领域的强大,它的失败则预言了整个专家系统运动的式微。
## 从 Logic Theorist 到 STRIPS:继承与跃迁
阶段二的三个系统不是凭空出现的,它们都是阶段一两条思想线索的继承与发展。理解这种谱系关系,才能看清 AI 发展的内在逻辑。
[Logic Theorist 的状态空间搜索和手段-目的分析](https://www.paddysun.top/?p=4947),在 STRIPS 中被工程化为可操作的规划系统。LT 从定理逆向搜索公理,STRIPS 从初始状态前向搜索目标状态——方向相反,但底层的启发式搜索机制一脉相承。不同的是,LT 的推理对象是逻辑命题,而 STRIPS 的操作对象是物理世界的行动。从”定理证明”到”行动规划”的转向,标志着符号主义从纯粹的逻辑研究走向了真实世界的工程实践。
[McCarthy 的 Advice Taker 构想](https://www.paddysun.top/?p=4958)则有两条不同的继承路径。在 STRIPS 中,”陈述句告知”演变为操作符模板的定义——工程师用一阶逻辑描述行动的前提和效果,系统自行规划执行顺序。在 MYCIN 中,”陈述句告知”被推向极致:600 条医学规则就是 600 条陈述句,反向链推理就是 McCarthy “演绎例程”的医学版本。两条路径最终都遭遇了同一种困难:前提选择的复杂性,这正是 Bar-Hillel 在 1958 年对 Advice Taker 批评的回声。
## 阶段二时间线
从 1956 到 1976 年的二十年,是符号主义 AI 从诞生到成熟、再到暴露边界的完整周期。Logic Theorist 奠定了搜索与推理的基础,McCarthy 描绘了”常识推理”的蓝图,ELIZA 从反面划定了智能的底线,STRIPS 将规划系统工程化,MYCIN 则把规则范式推到了它的极限。
## 三篇文章的关系三角
STRIPS、ELIZA 和 MYCIN 构成了一个互相映照的三角关系。STRIPS 和 MYCIN 都是”显式编码”的典范——STRIPS 编码行动,MYCIN 编码知识——但它们分别遭遇了框架问题和规则爆炸,这两种困境本质上是同一个困难在不同领域的表现。ELIZA 则从反面衬托两者:它的正则模板是规则的退化形态,它的零推理反衬出推理的价值,但三者共享着同一个范式底色——智能都被固化在程序或规则里,而非从数据中学习。
理解这个三角关系,你就能把握阶段二的整体图景:三个系统从不同角度定义了第一组织形式的轮廓,也从不同方向暴露了它的边界。
## 阶段二阅读顺序建议
阶段二的三篇文章各有侧重,但存在内在的递进关系。建议按照以下顺序阅读,以获得最佳的理解路径。
**第一步:[从 STRIPS 开始,建立成熟态的坐标](https://www.paddysun.top/archives/4968)。** STRIPS 是第一组织形式最完整、最系统的体现,理解了 STRIPS 的操作符三元组、状态空间搜索和框架问题,你就有了衡量其他系统的参照系。STRIPS 文章会带你从 Shakey 机器人的工程背景出发,深入操作符的设计哲学,再到框架问题的深层含义,最后连接到当代 Agent 的 state management 困境。
**第二步:[读 ELIZA,从底线反观”智能”的定义](https://www.paddysun.top/archives/4980)。** 有了 STRIPS 作为”成熟智能体”的参照,再看 ELIZA 的”零知识、零推理”,你才能真正体会到”智能错觉”的震撼。ELIZA 文章会拆解 DOCTOR 脚本的匹配机制,分析 ELIZA 效应的认知根源,并追问一个至今没有答案的问题:行为判据究竟能不能衡量智能?
**第三步:[读 MYCIN,看规则范式的顶峰与崩塌](https://www.paddysun.top/archives/4987)。** 最后读 MYCIN,你会看到”陈述句告知”的规模化尝试如何走到了它的尽头。600 条规则的工程壮举、确定性因子的精巧设计、反向链推理的优雅结构——以及知识获取瓶颈的根本困境。MYCIN 是符号主义的巅峰之作,也是它的黄昏。
**贯穿三篇的暗线:[Bar-Hillel 批评的回声](https://www.paddysun.top/archives/5039)。** 在阅读过程中,你会反复遇到同一个主题的变奏:前提选择的困难。它在 STRIPS 中表现为框架问题,在 ELIZA 中表现为模板的局限性,在 MYCIN 中表现为规则爆炸。这条暗线将三篇文章串联起来,也为后续阶段的”三条反叛伏线”埋下了伏笔。
## 准备好进入符号主义的黄金时代了吗
阶段二是符号主义 AI 的黄金时代,也是它自我审视的时代。三个经典系统,三种不同的命运,共同指向同一个结论:目标驱动的符号单体作为 AI 的第一组织形式,在封闭世界里无比强大,在开放世界中则举步维艰。
接下来的三篇文章,将逐一深入这些系统的历史背景、技术细节和当代回响。它们不只是对过去的考古,更是对当下的启示——因为今天的 LLM Agent,依然在与五十年前同样的问题搏斗,只是换了一套技术语言。
准备好了吗?让我们从 STRIPS 开始,走进 AI 第一组织形式的成熟时刻。
---
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
====
# [Agent 考古] AI 组织形式的七次重分配(总领导航)
https://www.paddysun.top/archives/4915 · 2026-08-22
**系列名称**:Agent 考古——AI 组织形式的七次重分配
**篇号**:第 1 篇 / 共 ?篇 **主题分类**:总领导航 **前置阅读**:无 **阅读时间**:约 12 分钟
---
## 七十年,Agent 的概念变了多少次?
如果你在 1956 年的达特茅斯会议上问”什么是 Agent”,答案可能是”一个能搜索定理证明路径的程序”。如果你在 1995 年问 Wooldridge 和 Jennings,他们会给你一份包含自主性、社会性、反应性、主动性的四性质定义1。如果你在 2023 年打开 GitHub,你会看到 AutoGPT 的 README 把它描述成”GPT-4 完全自主运行的实验”。而到了 2025 年,这个问题的答案可能同时指向 MCP 协议上的可寻址工具节点,和 o1 模型内部那条不对外完全可见的长思维链。
七十年间,”Agent”这个词的含义至少经历了七次实质性的变迁。每一次变迁都不只是术语的翻新,而是**控制流所有权的一次重新分配**——谁有权决定机器下一步做什么、谁能编辑那份”承诺执行的行动计划”,答案在人和机器之间、在单体和网络之间、在代码和权重之间,不断地转移。
理解这七次变迁,对今天的 Agent 开发者和研究者至关重要。因为当你用 LangGraph 画状态图、用 Function Calling 定义工具契约、用 ReAct 提示模板驱动循环时,你实际上是在与七十年间沉淀下来的多层组织形式同时对话——每一层都有它的来历、它的问题、它的未竟之业。不了解这些层积,你就无法分辨哪些是真跃迁、哪些只是旧瓶装新酒的工程封装。
本系列文章以 AI 历史上的**第一组织形式——目标驱动的符号单体**为锚点,从 1950 年代的图灵测试与 Logic Theorist 出发,穿越 McCarthy、Minsky、Brooks 三条反叛伏线,最终回到当下,试图回答一个问题:七十年的演化究竟留下了什么?这篇总领文将先带你鸟瞰七阶段全景,再聚焦阶段二的核心命题,最后给出本系列 13 篇文章的阅读路线。
---
## 一条主线:控制流所有权的七次重分配
> 七十年演化可压缩为一条主线——**控制流所有权的七次重分配**:
>
> 哲学悬置(Ⅰ)→ 人写规则的符号单体(Ⅱ)→ 承诺与协议的社会节点(Ⅲ)→ 经验习得的闭环(Ⅳ)→ 语言接口 + 自驱循环(Ⅴ)→ 契约化与图编排的拉锯(Ⅵ)→ 协议外化与推理内化的双向运动(Ⅶ)
>
> 每次范式跃迁都发生在控制流所有权发生转移的时刻;其余大量新词,只是所有权未变时的工程封装。
这条主线还有一个等价读法:**意图编辑权的迁移**。以经典 BDI(信念-愿望-意图)为坐标——信念是对世界状态的持有,愿望是任务的来源,而**意图(承诺执行的行动计划)在工程上如何被生成、编辑与控制**,恰是每种组织形式的试金石。控制流所有权落到工程细节上,就是”谁有权书写与修改这份行动计划”。
为什么选择 BDI 作为贯穿七十年的分析坐标?因为 BDI 不是某一阶段的特定架构,而是对”一个能自主行动的系统需要具备哪些基本心智成分”这一问题的形式化抽象——任何 Agent,无论它用的是符号规则、神经网络还是协议网络,都必须回答:它相信什么、想要什么、打算做什么。用 BDI 的透镜去看每一代组织形式,你会发现变化的不是三心态本身,而是它们各自的载体、来源与编辑方式。
两条缠绕的副线贯穿始终:决策机制的来源从人写规则迁移到环境反馈习得再到模型内部推理;组织边界从符号单体漂移到协议社会、可学习单体、通用内核、自驱循环、网络节点,直至沉入权重内部。每次范式跃迁都发生在某条主线发生”所有权转移”的时刻,而其余大量新词,只是两条主线未变时的工程封装——本报告附录中的概念鉴别清单,正是用这条标准对热区名词做了系统的鉴别与降级。
---
## 七阶段时间轴:从哲学悬置到双向运动

---
## 七阶段卡片:组织形式的七次跃迁
### 阶段一:哲学悬置——问题先于计算
维度内容**年代**古代 – 1950**核心组织形式**无工程实现,三个千年问题悬置**代表性工作**亚里士多德《论灵魂》、狄德罗《达朗贝尔的梦》、老庄主客之辩**BDI 坐标**人即原生 Agent,意图编辑权完全属于内部心智
这一阶段的凝练物不是组织形式,而是**三个千年悬置的问题**:何为自主、智能如何被外部判定、主体与环境的边界何在。亚里士多德的实践三段论已把 BDI 的协作结构写出——大前提承载欲求(愿望),小前提承载知觉(信念),结论不是命题而是**行动**。此后每个阶段的组织形式,都是对这三个问题的一次计算化回答——问题先于计算存在了两千年。
### 阶段二:目标驱动的符号单体——第一组织形式的确立
维度内容**年代**1950s – 1980s**核心组织形式**显式目标 + 状态空间搜索的符号单体**代表性工作**图灵测试、Logic Theorist、STRIPS、MYCIN、心智社会、Brooks 包容架构**BDI 坐标**三心态全部由人预制,意图编辑权 100% 在工程师手中
这是本系列的核心阶段,也是 AI 历史上**第一组织形式**的确立时刻。知识与推理同居于一个封闭单体内,目标树是这个时代唯一的”组织结构”,感知与行动被预设为符号的输入输出。Turing 1950 以自然语言对话为智能判据确立了操作化定义2,Logic Theorist 1956 以手段-目的分析将问题递归归约为目标-子目标树3,STRIPS 1971 以前提+效果的算子形式化了规划4,MYCIN 1976 以数百条规则将专家系统推向顶峰5。
这个范式有三个核心基石:接口方式上人通过编写代码(祈使句指令)来规定机器的行为,组织结构上是一个集中式的”单体大脑”(知识和推理同居于一个封闭系统内),运作机制上依赖”中央世界模型”进行自上而下的感知-规划-执行流水线。Newell 与 Simon 在 1976 年提出的物理符号系统假设,为这一范式提供了认识论基石——一个物理符号系统具备了进行通用智能行为的必要且充分手段。
但该阶段更重要的凝练是:范式在自身内部埋下了**三条否定自己的伏线**——
**第一条伏线:McCarthy 的 Advice Taker。** 1958 年 McCarthy 提出,不应再用祈使句指挥机器,而应**用陈述句告知机器世界的事实与规则**,让机器自己通过逻辑演绎推导出该做什么动作6。这直接否定了”人必须写死每一步操作指令”的工程范式,把机器从”指令执行器”变成了”基于知识的推理器”。这种”以自然语言陈述句装配能力”的构想,正是阶段五中 LLM 通过上下文进行推理与行动的最早种子——意图生成的内移之路,由此开启。
**第二条伏线:Minsky 的心智社会。** 1986 年 Minsky 提出,复杂的智能不可能由一个完美统筹的中央逻辑单体完成,智能是由无数个”本身没有智能的微小 Agent”通过相互协作、竞争涌现出来的7。他用循环论证检验、小人无限回归批判、单动因谬误命名三重论证,彻底否定了”单体集中式结构”这一组织边界。这埋下了分布式与多智能体系统的思想先声,直接预示了阶段三(协议社会节点)和阶段六(多 Agent 角色协作框架)的繁荣。
**第三条伏线:Brooks 的反叛。** 1986 年起,Brooks 指出中央世界模型是障碍,真实世界太复杂无法完美符号化,主张去掉中央模型和规划器,让”感知”直接耦合”行动”8。他随后在 1990–1991 年的系列论文中将这一工程论证推向正面假设对垒——”世界自身即是它最好的模型””显式表征与世界模型纯粹碍事””表征是错误的抽象单元”91011。这直接否定了符号主义的认识论基石——物理符号系统假设,埋下了阶段四(强化学习、端到端感知-行动闭环)和现代具身智能的种子。
**范式最深刻的否定者,恰恰在范式内部孕育。** 这三条伏线分别精准击碎了符号单体的三块基石——McCarthy 击碎”祈使句接口”,Minsky 击碎”单体集中式结构”,Brooks 击碎”中央符号表示与自上而下规划”。
总结来看,这三条走向实质上是回答了同一个工程核心问题:”Agent 接下来该做什么(意图)”是如何被决定的?内移走向回答”由模型自己想出来”,分散走向回答”由多个节点商量出来”,消解走向回答”由环境反馈逼出来”。三条伏线在阶段二内部发芽,最终在阶段四、五、六、七长成了现代 Agent 工程的参天大树。而本系列之所以从阶段二开始、用十三篇的体量来展开,正是因为理解了符号单体的确立与它内部的三条反叛种子,才能看懂后来一切演化的基因。
各篇主题简介如下,可从感兴趣的主题直接切入:
## 系列文章
[**Agent 考古**](https://www.paddysun.top/?p=4915) 符号单体时代 系列文章关键词**导读:**[符号单体时代:第一组织形式的确立与反叛](https://www.paddysun.top/?p=4942)—[Logic Theorist:符号搜索的第一台证明机器](https://www.paddysun.top/?p=4947)手段-目的分析、状态空间搜索、定理证明[McCarthy Advice Taker:陈述句革命的最早蓝图](https://www.paddysun.top/?p=4958)陈述句告知、推理-行动闭环、属性表装配[STRIPS:状态空间规划的成熟与框架问题](https://www.paddysun.top/archives/4968)算子三元组、世界模型增量、帧问题解法[ELIZA:最小智能体的基线与错觉](https://www.paddysun.top/archives/4980)正则模式匹配、聊天机器人、智能判定陷阱[MYCIN:规则范式的顶峰与边界](https://www.paddysun.top/archives/4987)置信度推理、专家系统、规则脆性**导读:**[三条反叛伏线汇论:语言接口·社会涌现·具身学习](https://www.paddysun.top/archives/4998)—[Minsky 心智社会:单体结构的内部否定](https://www.paddysun.top/archives/4997)单动因谬误、机构协作、K 线记忆、审查器[Brooks 包容架构:感知-行动耦合的工程反叛](https://www.paddysun.top/archives/5013)分层包容、抑制/禁止仲裁、无中央模型[Brooks 无表征智能:物理接地假设的哲学宣言](https://www.paddysun.top/archives/5030)无表征智能、四关键概念、学习四分类**回顾:**[Bar-Hillel 式批评:意义、翻译与框架问题](https://www.paddysun.top/archives/5039)翻译全自动悖论、意义消解、框架问题跨代回响**终章:**[自知、自觉、自止——终章定论](https://www.paddysun.top/archives/5049)**历史辩证法、组织演化层积观、回到当下**
### 阶段三:承诺与协议的社会节点——自主性的第一个可计算答案
维度内容**年代**1980s – 2000s**核心组织形式**经通信协议耦合的节点网络**代表性工作**Bratman 意图理论、Shoham AOP、BDI 架构、FIPA-ACL、AIMA**BDI 坐标**计划库由人预设,栈调度归 Agent,意图编辑权首次分担
两个概念在此阶段诞生:一是**意图 = 对行动的持续性承诺**——决策从单步规则触发升级为带承诺结构的慎思过程,哲学阶段的”自主”问题获得第一个可计算实现;二是**智能体社会**——任务成为可招标资源,协调成为显式协议行为,Agent 上升为语言级编程构造。BDI 三心态首次各获自己的数据结构与更新机制,三种承诺策略(盲目/单一心智/开放心智)本质上是**意图编辑粒度的旋钮**——人类第一次给机器写下”意图自决权”的授权范围。1990 年代已把 2020 年代多智能体叙事的全部概念部件造齐,唯一缺的是一颗可用的通用认知内核。
> **系列导航** · 意图即承诺,智能体即社会——自主性的第一个可计算答案
[**Agent 考古**](https://www.paddysun.top/archives/4915) 意图即承诺,智能体即社会 系列文章关键词**导读:**[总览与阅读路线](https://www.paddysun.top/?p=5114)四条线时间线 · 阶段二衔接 · 阅读路线[意图即带承诺的选择](https://www.paddysun.top/?p=5118)C&L 1990 · PGOAL · 持续承诺[BDI 从理论到工程](https://www.paddysun.top/?p=5122)PRS · AgentSpeak · dMARS · 承诺策略[何为 Agent](https://www.paddysun.top/?p=5128)W&J 弱/强概念 · AOP[合同网](https://www.paddysun.top/?p=5132)Smith 1980 · 任务招标 · 囚徒困境[三种仲裁](https://www.paddysun.top/?p=5136)Z&R · PERSUADER · D&M[联合意图部署](https://www.paddysun.top/?p=5140)STEAM · ARCHON · EV(通信)[智能体如何找到彼此](https://www.paddysun.top/?p=5153)KQML · FIPA · JADE · MCP/A2A[反应与慎思的和解](https://www.paddysun.top/?p=5160)TouringMachines · INTERRaP · 门控[意图编辑权](https://www.paddysun.top/?p=5160)三时空同构 · 编辑权拉锯 · 自止焊接[自组织的实证与治理悖论](https://www.paddysun.top/?p=5167)Dochkina 2026 · BCG 治理悖论[当 LLM 住进 BDI](https://www.paddysun.top/?p=5172)Ciatto 2025 · GenAI+BDI · 计划生成
### 阶段四:经验生长的策略——决策机制所有权从人写到习得
维度内容**年代**2000s – 2020s**核心组织形式**感知-决策-行动闭环整体成为优化对象**代表性工作**DQN、AlphaGo、AlphaFold、AlexNet**BDI 坐标**三心态整体变形,意图被压进策略网络的概率分布
**决策机制所有权第一次转移**——从人编写规则到从交互经验习得。奖励/数据取代规则成为唯一的组织信号。BDI 三心态在此整体变形:信念变成网络权重,愿望被压缩为标量奖励信号,**意图不再是显式的符号计划**,而被压进从状态到动作的映射。BDI 意义上的承诺结构在此整体缺席——这正是”决策机制所有权转移”在心智结构上的对应物。意图编辑权并未消失,而是**间接化**:工程师不再逐条改写计划,转而设计产生意图的信号与数据。
### 阶段五:通用认知内核 + 语言接口 + 循环基元——Advice Taker 的迟到兑现
维度内容**年代**2017 – 2022.10**核心组织形式**think-act-observe 循环成为最小组织单元**代表性工作**Transformer、GPT-3、InstructGPT、CoT、ReAct、WebGPT**BDI 坐标**意图获得软编辑界面,编辑权呈分层共享状态
三件事同时落地:**指令即程序**——任务接口从代码与规则变为自然语言;**上下文即工作记忆**——不更新参数的即时能力装配;**循环即智能体**——think-act-observe 成为最小组织单元。最具张力的凝练是:McCarthy 1958 年的 Advice Taker 设想在此兑现,但兑现方式完全出乎逻辑主义预料——不靠公理推演,靠统计学习 + 上下文装配。意图编辑权在此呈**分层共享**:预训练决定意图生成的先验,提示模板由工程方划定边界,轨迹内每一步的意图书写由模型自决。
### 阶段六:循环的标准化与接口的契约化——一场”爆发”实为两个方向相反的事件
维度内容**年代**2023 – 2024**核心组织形式**自驱动循环 + 结构化契约 + 图编排矫正**代表性工作**AutoGPT、Function Calling、LangGraph、Voyager、Toolformer**BDI 坐标**意图编辑权的拉锯战——大幅让渡与分层回拉同时发生
清单标为”爆发”,按组织形式拆解实为**两个方向相反的事件同窗并行**。事件 A 是控制流所有权的拉锯:AutoGPT 完成控制流从人到系统的移交,但高失败率证明”形式先于能力”;LangGraph 随即以显式图骨架回拉控制流——图编排恰是对自驱循环失控的矫正反应。事件 B 是工具接口的契约化:Function Calling 使工具调用从隐式自然语言解析跃迁为结构化一等公民。本阶段的遗产不是爆发,而是循环的标准化与接口的契约化。
### 阶段七:协议外化与推理内化——同一时刻的离心与向心运动
维度内容**年代**2024 – 至今**核心组织形式**系统层网络化膨胀 + 模型层推理内化,双向边界谈判**代表性工作**o1/R1、MCP、A2A、Computer Use、SWE-agent**BDI 坐标**信念获取网络化、愿望下发协议化、意图生成沉入权重
按组织形式凝练,这是**两条方向相反的主线同时展开**。外化线(离心)完成”单体+工具 → 网络化寻址”的跃迁:接口语法(Function Calling)→ 行动空间设计(SWE-agent)→ 寻址总线(MCP)→ 互操作发现(A2A)。内化线(向心)则把阶段五赖以运行的外部脚手架(提示激发的 CoT、反思循环、搜索树)吸收回权重,”想得更久”成为独立于”搭得更多”的扩展轴。两线交汇处即是当前时刻的张力:能力向协议外化(系统层膨胀)与推理向权重内化(模型层膨胀)正在重新划分系统层与模型层的边界。七十年前完全属于人、阶段三起开始与人分担的那个”承诺执行的行动计划”,其编辑界面第一次同时向上(协议)与向下(权重)两个方向移出了人的直接书写范围——这正是”控制流所有权双向往返”在心智结构上的投影。
---
## 演化不是替代而是层积
走完七阶段全景,有一个关键认知必须先建立:演进不是替代,而是层积。每一代的组织形式都仍在运行——今天你在 LangGraph 里画的状态图,本质上是阶段三”计划库 + 慎思调度”在 LLM 基座上的复现;你用 Function Calling 定义的工具契约,是阶段六”接口契约化”的遗产;而模型内部那条长思维链,则是阶段七”推理内化”的产物。LLM 之所以成为工程可行性的核心催化剂,源于它首次使 Agent 同时握住”感知-规划-行动-反思”闭环的四支箭——而此前每一代范式只触及其中一支。
七十年演化的每一步,做的都是同一件事——重新分配控制权的归属。而 2024 年之后的新变化是,这场分配第一次同时向两个相反方向进行。理解了这条主线,你再看今天 Agent 领域的热闹喧嚣,就能分辨出哪些是真正的范式跃迁、哪些只是既有组织形式的重新包装。
---
## 参考文献
[**1**] Wooldridge, M. & Jennings, N.R. (1995). “Intelligent Agents: Theory and Practice.” *Knowledge Engineering Review*, 10(2), 115-152.
[**2**] Turing, A.M. (1950). “Computing Machinery and Intelligence.” *Mind*, 49, 433-460.
[**3**] Newell, A. & Simon, H.A. (1956). “The Logic Theory Machine.” 达特茅斯会议论文。
[**4**] Fikes, R.E. & Nilsson, N.J. (1971). “STRIPS: A New Approach to the Application of Theorem Proving to Problem Solving.” *Artificial Intelligence*, 2(3-4), 189-208.
[**5**] Shortliffe, E.H. & Buchanan, B.G. (1976). *Rule-Based Expert Systems: The MYCIN Experiments of the Stanford Heuristic Programming Project*. MIT Press.
[**6**] McCarthy, J. (1958). “Programs with Common Sense.” *Mechanisation of Thought Processes*.
[**7**] Minsky, M. (1986). *The Society of Mind*. Simon & Schuster.
[**8**] Brooks, R.A. (1986). “A Robust Layered Control System for a Mobile Robot.” *IEEE Journal of Robotics and Automation*.
[**9**] Brooks, R.A. (1990). “Elephants Don’t Play Chess.” *Robotics and Autonomous Systems*, 6, 3-15.
[**10**] Brooks, R.A. (1991). “Intelligence without Representation.” *Artificial Intelligence*, 47, 139-159.
[**11**] Brooks, R.A. (1991). “Intelligence without Reason.” *IJCAI-91* 会议论文。
====
# 将 626 个访客 IP 全查了一遍,其中 190 个是全球通缉的惯犯
https://www.paddysun.top/archives/4872 · 2026-08-16
四层防护日志全量分析 · 626 个拦截 IP · AbuseIPDB 交叉回查 · 数据窗口 2026-07-17 ~ 2026-08-16
> 我的站近半年没有更新过一篇内容,却在这 30 天里接待了 626 个”访客”——全部被防护拦截。我把四层日志导出来做了一次全量交叉分析,并把这 626 个 IP 在 AbuseIPDB 上批量举报后回查了全球置信分。这篇文章只呈现数据和从中得到的客观结论,不作任何布道。
626
30 天内被四层防护拦截的去重 IP。其中 **190 个** AbuseIPDB 置信分满分(全球公认恶意),**81 个**是官方白名单(合法爬虫与共享代理出口),另有 **58 个**是我的站发起的全球首次举报。
拦截 IP 总数626剔除本人与内网段后
WAF 攻击拦截390次 / 78 个 IP
黑名单拦截1,176次 / 310 个 IP
登录爆破拦截744次 / 100 个 IP
CDN 边缘挑战106次 / 73 个 IP
## 一、攻击类型:64% 是 SQL 注入,且漏洞平均”年龄”超过十年
WAF 层 30 天拦截 390 次攻击,类型分布高度集中。SQL 注入 252 次里,绝大多数打在 `/`、`/index.php`、`/blog/` 这类通用路径上,而非任何具体业务接口——这是无差别扫描的典型特征,不是对站点做过功课的定向攻击。
WAF 拦截的攻击类型分布
30 天 · 主机 WAF 层 · 共 390 次 · 悬停查看数值
表格视图
两个可量化的”低技术含量”证据:其一,代码执行类攻击的 payload 是 ThinkPHP `invokefunction` 远程调用——一个 2018 年的老漏洞,而目标根本不是 PHP 框架站;其二,代码注入类全部是 PHP-CGI 参数注入(`%ADd` 前缀,CVE-2012-1823 变体),甚至还在请求 `php-cgi.exe` 这个 Windows 路径。**攻击载荷与站点实际技术栈完全脱节**,扫描器不在乎你是什么站,它只是把十几年攒下的漏洞清单对每个 IP 撒一遍。
## 二、目标路径:WordPress 暴露面的精确画像
黑名单层 1,176 次拦截的目标路径,几乎就是 WordPress 站点暴露面的一份清单。前八名中五个是 WordPress 原生或插件接口:
被拦截请求的目标路径 Top 8
30 天 · 黑名单情报层 · 1,176 次拦截
表格视图
逐项客观解读:`/xmlrpc.php`(59 次)同时具备爆破与 pingback 放大两种攻击价值;`/wp-json/wp/v2/users` 系列(约 60 次)是登录名枚举——REST API 未鉴权时会把作者登录名直接返回给请求方;`/robots.txt`(66 次)是扫描前的踩点动作,正常浏览器极少直接请求它;而 `/wp-json/wp/v2/users/me` 那 83 次里,有 84 次其实来自我本人(下一节详述)。信息泄露类攻击(WAF 层 64 次)的目标高度一致:`/.git/config`、`/.env`、`/proc/self/environ`、云厂商凭证路径——攻击者要的是源码仓库和密钥,不是内容。
## 三、时间结构:攻击以”波次”而非”背景噪音”到来
按天聚合后能看到清晰的波次结构。8 月 6 日黑名单拦截单日 502 次,是平日的 10-30 倍,由多个 IP 在数小时内协同完成——典型的分布式集中扫描。此外 7 月 30-31 日、8 月 10 日各有一波 WAF 攻击高峰。
每日拦截量
蓝:WAF 攻击拦截 · 橙:黑名单拦截 · 悬停查看当日双数值
WAF 攻击拦截
黑名单拦截
表格视图
一个值得注意的细节:两类拦截的波峰并不同步。WAF 高峰日(7/30、8/10)黑名单拦截量平平,黑名单高峰日(8/6)WAF 拦截为零——**两波是不同来源、不同工具的独立行动**,而非同一批攻击者换手法。
## 四、全量回查:626 个 IP 的全球”信用档案”
把 626 个 IP 提交 AbuseIPDB 后批量回查,每个 IP 拿到三项关键数据:置信分(0-100)、历史总举报数、举报者数量。分布如下:
626 个 IP 的全球置信分分布
颜色越深 = 社区确认恶意程度越高 · 数据来源:AbuseIPDB 批量回查(2026-08-16)
表格视图
三个层面的客观结论:
- **本地拦截与全球判断高度一致**:217 个 IP(34.7%)置信分 80+,190 个满分。我的四层规则拦下的东西,全球几百个站点也拦下了同样的东西。
- **头部惯犯的”作案广度”惊人**:27 个 IP 全球总举报数 ≥ 500,其中 13 个被 ≥ 300 个不同站点举报过,最高的一个(荷兰某主机商)被 559 个站点举报 2,292 次。这些 IP 长期、稳定、大规模地扫描整个互联网。
- **举报者数量的中位数只有 10**:一半以上的 IP 只有零星记录——大量扫描节点是”新面孔”,单靠黑名单情报无法覆盖,这也是为什么它们能穿透到我的第三、四层才被拦。
头部惯犯的全球举报广度
每个点 = 一个 IP · 横轴:全球举报它的站点数 · 纵轴:总举报次数 · 颜色:置信分
表格视图
## 五、81 个白名单:一次数据质量事故的完整解剖
回查发现了本次分析最重要的一件事:81 个我当作”恶意 IP”上报的地址,是 AbuseIPDB **官方白名单**。构成如下:
81 个白名单 IP 构成
44 个 CDN 共享代理出口 + 37 个搜索引擎/SEO 官方爬虫
表格视图
其中 44 个 CDN 代理出口 IP 值得完整还原:我的应用层防火墙统计曾显示”德国、瑞典是攻击来源前几名”——回查后确认这些 IP 属于某 CDN 的共享出口段。也就是说,**攻击者把自己的域名套上免费 CDN 反代再回源,我的日志记录的只是 CDN 边缘节点**。这 44 个 IP 在应用层被拦截了 300+ 次,看起来像 44 个不同攻击者,实际背后是若干个借道者,而且我永远无法从日志里得知它们的真实地址。
> 客观事实是:站点挂在 CDN/代理后面时,若防护层取的是 TCP 连接 IP 而非
>
> X-Forwarded-For
>
> 透传的真实客户端 IP,则日志、统计、封禁列表记录的都是代理影子。我在不知情的情况下,把 44 个影子当攻击者封了、上报了。剩余 37 个(SEO 爬虫与搜索引擎 bot)则是被应用层规则当攻击拦截的合法抓取——个人博客的高频爬虫流量本身属于正常互联网行为。
## 六、来源结构:数据中心占六成,大陆流量平均分仅 14.5
626 个 IP 的基础设施属性与地域分布,呈现出明确的二元结构:
IP 的基础设施类型
回查字段 usageType · 626 个 IP
表格视图
中国大陆 IP vs 境外 IP
数量 vs 平均置信分 · 大陆 204 个 / 境外 422 个
表格视图
- **380 个 IP(61%)来自数据中心/主机托管**,229 个(37%)来自固定宽带——攻击主体是租来的服务器,而非个人电脑。固定宽带里则集中了几个被植入扫描脚本的家宽网段。
- **大陆 IP 与境外 IP 性质截然不同**:204 个大陆 IP 平均置信分 14.5,其中 123 个为 0-4 分(基本无恶意记录);422 个境外 IP 平均 62.8 分。大陆拦截量高主要来自 CDN 边缘挑战层(106 次全部为大陆 IP),而穿透到 WAF 层的攻击 97% 来自境外。
- 满分 IP 的国家分布:美国 51、德国 24、新加坡 17、法国 13、荷兰 12——与全球数据中心分布基本重合。
## 七、网段聚类:攻击基础设施高度集中
按网段聚类后发现,626 个 IP 并非均匀散布,而是集中在少数几个来源。最大单一集群 62 个 IP 来自同一海外云服务商网段,平均置信分 97;第二集群 58 个 IP 来自华东某省运营商家宽段——**这 58 个 IP 此前全球零举报,我的上报是首报**,是一个新启用的扫描集群。
主要攻击网段聚类
气泡大小 = IP 数量 · 颜色 = 平均置信分(越深越危险) · 网段已模糊化
表格视图
附带的独立事实:确认 6 个 Tor 出口节点(5 个置信分满分,单节点最高被举报 226 次);一家印尼大学的服务器(549 次举报/274 个举报站点)出现在扫描源里;多家对滥用投诉不作为的低价主机商合计贡献了约三分之一的惯犯 IP。
## 八、流量侧画像:”访客”的构成
CDN 层的 30 天流量统计(按流量字节)可以和拦截数据互为印证。这个近半年无更新的站,流量构成如下:
客户端操作系统构成(按流量)
CDN 层统计 · 30 天 · Bot 类占 14.2%,另有 25.7% 无法识别
表格视图
User-Agent 维度:流量第一的”Chrome 142 / Windows”占 8.1%——一个最新主版本号出现在无更新站点的流量榜首,且无对应的人类访问理由;空 UA(`-`,纯脚本直连)占 4.1%;声明为 `curl` 的占 1.7%;两家中文博客聚合爬虫合计约 8%。应用层防火墙拦截的 100 个”顶级 IP”里,回查确认 44 个是 CDN 共享出口、约 37 个是合法爬虫——**应用层眼中的”攻击榜”与真实攻击者的重合度,比表面数字低得多**。
## 九、数据汇总
四层防护拦截量对比
拦截次数与涉及 IP 数 · 各层职责不同,量级递减
表格视图
指标数值
拦截 IP 总数(去重、剔除本地)626
其中 AbuseIPDB 置信分 80+217(34.7%)
其中满分 100190(30.4%)
其中官方白名单(误报)81(12.9%)
其中全球首报 IP58(华东家宽集群)
数据中心来源占比61%
大陆 IP 平均置信分 / 境外14.5 / 62.8
全球总举报 ≥500 次的惯犯27 个
Tor 出口节点6 个(5 个满分)
单波最高单日拦截502 次(8 月 6 日)
## 写在最后
把 30 天的数据摊开,得到的最核心的客观事实有三个。**第一,攻击的绝对量与站点价值无关**:一个半年无更新的个人站,30 天被 626 个 IP 光顾,其中三分之一是全球确认的惯犯——互联网上的扫描是全天候、无差别、按漏洞库存货循环的背景活动。**第二,攻击质量与攻击数量严重不匹配**:没有发现任何针对站点实际技术栈的攻击,全部是对着错误目标撒网的老漏洞。**第三,观测数据本身会说谎**:626 个”恶意 IP”里,81 个是白名单,44 个是代理影子——在修正取数方式之前,我的日志、统计与封禁决策都在与幻影作战。
数据与方法:四层防护(CDN 边缘 / 主机 WAF / 黑名单情报 / 应用防火墙)日志导出 · IP 去重并剔除本地与内网段 · AbuseIPDB 批量举报与回查交叉验证 · 网段与厂商名称已模糊化 · 图表数据内嵌本页,无外部请求 · 所有数字可由表格视图复核
====
# 我怀疑我吃错了东西
https://www.paddysun.top/archives/4840 · 2025-12-13
最近我发觉,当老师这事越来越邪门了。不是说它变难了——正相反,它容易起来了,容易得让人心里发毛。就像你明知道吃的是屎,可嚼起来却是巧克力的味儿。
一方面,**时间突然多出来了。**
以前备课得熬通宵,现在全靠吃老本。教过一轮的好处就在这儿——你不用再当拓荒的,每节课都从零开始刨地。这本该让人高兴,可这轻松劲儿让我浑身不自在——轻松的事轮得到我来干?
另一方面,**学生居然会笑了**,上课不再是唱独角戏了。
我老师当年急得跳脚时说过:“吵架还得有个来回呢,你们上课也得出点声,让我知道教室里还有活人。”以前觉得让学生开口比登天还难,他们不吭声,我一个人唱独角戏,累得跟孙子似的。有个老教师,疫情期间上网课,一来年纪大玩不转电子设备,二来看不见学生,没互动——不习惯这套。疫情结束得了抑郁,课也讲不了了。演员也一样,台下要是有动静,台上就来劲。
现在我算明白了,学生不吭声,多半是走神了——这很正常,数学这东西本来就容易让人神游,逻辑一环扣一环,稍微一走神就跟不上了,就只有接着神游。**他们不是不想学(大都知道该学,毕竟150呢),是讨厌“上课”这副阵仗。**
我从戏剧和脱口秀那儿偷了点招,试着换着嗓门说话——有时候像太监宣旨,有时候像付航一样“猴子叫”。偶尔拿自己开涮,说点不三不四的俏皮话。嘿,还真管用。
这让我想起那些“网红老师”。他们在讲台上手舞足蹈,说些幼稚的话——“学霸题,数正方体”“在小小的花园里挖呀挖呀挖”。我当时觉得太尴尬了,暗自发誓:我是正经人,绝不变成那副德行。可现在呢?我正一步步变成自己讨厌的样子,而且居然还挺享受。
学了点心理学才明白,人说话这档子事,效率低得可怜,每秒就[39个比特](https://immarcus.com/blog/thirty-nine-bps/),专注力顶多撑五分钟——本来就得哄着🧠学习。用滑稽的、顺口溜、甚至演点戏,就是用这些“不正经”的手段,**哄着那个又懒又好奇的大脑去理解这个复杂的世界**。
第三件邪门事是:**学生做题慢了,我反而不急了。**
以前看见学生一小时磨一道题,心里跟火烧似的。现在才明白,那火是自己点的——总想着“这么简单你怎么就不懂”,从没想过“我讲的人话在他听来可能是外星语”。同一道题,我试着用三种姿势、五种语调、七种比喻来讲。这倒逼着我把藏在直觉里的东西,无法言说的感觉思路,从暗处揪到亮处来。
这大概就是“输出倒逼输入”。逼着自己把脑子里那团浆糊摊在阳光下,晾晒、解剖给学生看。我说这是自己给自己动手术——不打麻药,还得举着镜子看。**不是我聪明,就是这么笨拙又诚恳地就行。**
---
可所有这些好事堆在一起,反而让我警惕起来。就像你明知道盘子里是屎,尝起来却是巧克力味儿。这里头肯定有鬼。
要么是我已经滑下去了,滑成了那种腰带上挂钥匙、端着保温杯时不时嘬一口的老教师——搞什么“翻转课堂”,学生学不好就说“练得少”“生源差”,把自己的油滑当幽默,把懒惰包装成教学智慧。
要么是**我在真正应该用功的地方偷懒了**。
战术上我是勤快了——课堂热闹了,讲题花样多了。可战略上呢?我那个搞物理的哥们儿前些天问我:“你到底怎么看教学这回事?”问得我当场卡壳。
是啊,**在AI都能写诗的年头,你把那点公式定理翻来覆去地讲,有个什么意思?**一个学生在你课堂里坐的那几百个钟头,不过是他生命的几千分之一。在这几千分之一的时间里,你非要往他脑子里塞什么解题技巧——这跟在沙漠里倒一杯水有什么区别?
教学的真正价值,恐怕根本不在于“传达知识”。知识现在满大街都是,你跟AI扯半小时就能摸清个陌生领域,便宜得像秋天的落叶。真正的价值,是让学生看见知识背后那团火。
让他知道数学不是试卷上的酷刑,而是撬动世界的杠杆;**让他觉得那些符号和图形,或许能帮他抵达想去的地方**。哪怕只是种下一颗“这东西可能有点用”的种子,也比强迫他吞下十公五三强。
可这部分活儿,我现在干得最少。因为它没法写进教案——你没法标注“此处应引发梦想共鸣”。它只能见缝插针地长出来,像石头缝里的野草。
**最让我脊背发凉的,是那种悄无声息的“单向性”。**
上文是我一个人的反思,一个人的结论,这对嘛?我越来越熟练地“输出”,却越来越难收到真实、带刺儿的“反馈”。学生不敢说真话,同事间尽是客套。要不是在网上看到那些匿名的、扎心的吐槽——比如有个博友吐槽[家长会像坐牢、骂老师教学生作弊、骂课间不让说笑](https://www.suiyan.cc/blog/20251123135354)——我可能还做着“课堂效果不错”的春秋大梦。
那家长的博客像面照妖镜,照出了教育现场另一种真相:**根本没有真正的双向对话**。家长会成了单方面的训话和表演,**课堂成了教师自嗨的舞台**,学生和家长的真实感受,全被沉默和客套捂住了嘴。这让我想起我高中时那个年轻的数学老师,他每学期末跟每个学生合影,讲错了会老老实实道歉。他那么用心,绩效却“不好看”,最后也离开了教育行业。
是不是因为,**真诚的互动、平等的对话、对好奇心的呵护,这些真正要紧的东西,在追求效率和绩效的系统里,最先被当成垃圾扔掉了?**
用物理的话说,这么干最省力。沿着惯性往下滑,重复老路,总是轻松的。而心里那点珍视的东西——创造性、平等对话、好奇心——得额外费力气去护着,也正被“绩效”这玩意儿慢慢啃食。
我爸问过我:“你想这么多,学生/家长知道吗?”
可能知道,也可能不知道。但那个老师的离开始终提醒我:**教育要是没了双向的、敢说真话的反馈,就成了场精致的独角戏。**就算台下有笑声,就算流程顺溜,就算你觉得自己在努力“哄着”大脑学习——可要是没有真实声音的回流,这一切都是沙上筑塔。
---
所以我打算继续“堕落”,但得换个方向堕落。
太监嗓的俏皮话还得说,一道题讲出十八般花样还得干——因为这些毕竟管用。但更要在那些公式的缝儿里,塞点别的东西:塞进数学怎么就成了“自由的艺术”,塞进它怎么又冷酷又浪漫,塞进它怎么让一些看着不可能的事,变成可能。
同时,我得主动捅破那层“安全却沉默”的窗户纸。**把真实的声音放进来,哪怕它扎人。** 告诉学生:“要是我讲得像外星语,你起来骂我都行。”在家长会留出真说话的时间,别光展览成功经验。跟同事别光聊分数,也聊聊那些让我们憋屈、困惑却真实的瞬间。
这很难,难就难在它没法计划,很难成文。你只能备好一片土,等着不知哪颗种子发芽。而这片土的肥料,就是**勇气和信任**——**我有勇气接骂,他们才敢信这个地儿能说人话。**
也许哪天,会有个学生因为我某句“跑题的话”,突然觉得那些曲里拐弯的线和冷冰冰的数,跟他想要的未来有关。也许哪天,会有个家长会后留下,不是问怎么提分,而是说:“孩子最近对数学感兴趣了。”
到那时候,我才能梗着子说:巧克力就算包得像屎,可里头终归是巧克力。这就够了。
====
# 【曙光大陆】005 新朋友与新阶层
https://www.paddysun.top/archives/4784 · 2025-12-12
[【曙光大陆】全书目录](https://www.paddysun.top/?p=4516)(连载中)
> 试试第一人称
宴会结束后,我像一只终于找到洞的老鼠,每逢休假日就往那条巷子钻。那身借来的魔法礼袍被我叠叠好,挑了个秃头皇子不在的时候,放到了“魔导工学”那屋里,换上了洗得发白的衬衫。
酒馆老板,那个独眼的壮汉,第一次见我穿成这样进来,独眼里的光闪了闪,像是在说:哟,学乖了。
“又来了?”他的声音还是那么糙,像砂纸磨铁皮,“少爷,这儿酒可不好喝。”
“叫我艾伦。”我摸出几个铜币,“老样子。”
他收了钱,从柜台下摸出陶罐倒酒。杯子还是那个豁口杯,只是豁口换了个方向。我后来想,这大概是他表达善意的方式。
“艾伦。”他重复了一遍,像是在嘴里嚼了嚼才咽下去,“学院的学生?”
“新生。”
“新生就敢往这种地方钻。”他用那块破得能当情趣内衣的抹布擦柜台,动作慢得像在给古董抛光,“胆子不小。”
我嘟囔了一句:“这儿比隔壁好玩。”,心里想的是原来世界里的苍蝇馆子。
他的手顿了顿,独眼瞥了我一下,没接话。但我看见他嘴角动了动,像是在笑,又像是在嘲讽什么。
那天下午我坐在酒馆里,听周围的人说话。那些话糙得很,像没打磨过的石头,硌得耳朵疼。但硌着硌着,反倒听出些滋味来——工钱被扣了三个铜板,井水有股怪味,工厂里又断了手指头。这些事在宴会厅里是听不见的,那儿的人只说吃喝玩乐,女人和权力。
我听着,脑子里自动把这些话翻译成另一种语言:熔炉热效率低下,地下水受工业污染,安全生产条例是摆设。你看,这就是受过教育的人的毛病——总想把活生生的事塞进概念的框子里,好像框进去了,事情就解决了似的。
第二次去,老板在我喝完第一杯后,又给我续了半杯,没收钱。
第三次,他坐在我旁边抽起了烟斗。烟雾缭绕中,他问:“学院都教些什么?”
“魔法基础,帝国史,军事训练。”
“魔法啊……”他吐出一口烟,独眼望着天花板上的蛛网,“好东西。可惜不是给我们用的。”
“为啥?”
他笑了,笑容里的皱纹像干裂的土地:“为什么?少爷,您是真不知道还是装不知道?魔法要天赋,要血脉,要钱——请老师、买材料、进学院,哪样不是钱?我们这种人,连魔法灯都用不起,只能用这破油灯。”
他拿烟斗指了指墙上那盏灯。灯芯烧得噼啪响,光晕昏黄,照得他的脸一半明一半暗,像个褪了色的雕塑。
我沉默了。我想起维克多领口那只金鹰,在宴会厅的灯光下亮得刺眼。是的,魔法或者说教育在这个世界,就是特权的体现,就像有本网络小说的名字《没钱你修什么仙》。
第四次去,老板正在后门和一个瘦高男人说话。没一会儿高瘦男人就走了,连碰倒了椅子都没回头。
“那是老约翰。”他主动说,“矿上塌方,他儿子没了。矿主赔了二十个银币。”
二十个银币。我想起宴会上那杯星光酒,五个金币,合五百个银币。
“够嘛。”我弱弱的说。
“当然不够。”他的声音平静得像在说今天的天气,“一条命,二十个银币。这就是我们这些人的价钱。”这可能才是真正的反差吧。
那天我离开时,他叫住我,递过来一个小布包:“拿着。你总喝那种劣酒,胃会受不了。这是我自己泡的药茶,就是吃了屎会变黑就是了。”
布包里是几块黑褐色的根茎,闻着有股土腥味。我接过,感觉手里沉甸甸的。
“谢谢。”
“别谢我。”他转身继续擦杯子,“我只是不想看一个学院的学生死在我的酒馆里,麻烦。”
但我知道,这不是全部原因。嘿嘿。
---
学院生活还在继续。军事训练像一场永无止境的噩梦,教官看我的眼神,像是在看一块需要反复捶打的铁胚。我渐渐学会了应付——在公开场合,我老老实实按“标准流程”施法,虽然效果总是不尽如人意;在私下里,我继续用自己的方式理解魔法,进步快得让我自己都害怕。
理论课上,我还是会困。那些“神恩浩荡”、“血脉呼唤”的废话,像催眠曲一样有效。我更多的时间花在了图书馆,用我那“啥字儿都认得”的本事,翻阅那些积满灰尘的旧书。我在寻找这个世界的“底层逻辑”,就像程序员找代码的bug。
实践课上,我故意表现得时好时坏。有时候“火焰箭”能烧穿靶心,有时候却只能冒点青烟。教官看我的眼神越来越复杂。
而维克多,那个头发梳得能滑倒苍蝇的贵族小子,又出现了。
那是一个周三的下午,我刚从训练场回来,浑身汗臭得像条咸鱼。维克多在走廊拦住了我。
“史密斯。”他的声音得体得像量过尺寸的礼服,但他后退半步的动作是认真的。“有时间吗?我想和你谈谈。”
我眼神发指,用毛巾擦脸上的汗,下意识的回道:“谈啥?”(派大星嗓音)
“关于你的施法方式。”他斟酌着用词,“很独特。虽然不规范,但效果有时候出乎意料。”
“教官说那是野路子。”我说。
“教官有教官的看法。”他笑了笑,那笑容里有种居高临下的宽容,“但我觉得,创新不应该被完全否定。帝国需要新思维。”
我等着他的下文。
“我父亲赞助了一个学术沙龙。”他继续说,“成员都是有想法的年轻人。我们讨论魔法技术的革新,社会改良的可能性……我想,你可能会感兴趣。”
嗯?我的耳朵竖了起来。可能是原主的本能反应。
“什么时候?”我问。
“这周五晚上。地点在城西的‘银橡树俱乐部’。”
“我去。”这可以确定是间谍原主的本能反应了。
维克多似乎有些意外,但很快恢复了笑容:“很好。我会把地址给你。着装……不必太正式,但也不要太随意。”他的目光在我洗得发白的学院服上扫过,虽然掩饰得很好,但我还是捕捉到了那一闪而过的鄙夷。
就像看一块掉进汤里的苍蝇。
周五晚上,我找到了“银橡树俱乐部”。那是一座三层石砌建筑,朴素得像个修道院。大厅里铺着深色地毯,墙上挂着地图和工程图纸。人已经来了十几个,大多是年轻人,衣着体面但不浮夸。
维克多正在和一个戴眼镜的瘦高男人说话,看见我进来,他招了招手。
“各位,这位是艾伦·史密斯,学院的新生。”他介绍道,“他在魔法实践上有些独特的见解。”
几道目光落在我身上,有好奇,有审视,也有不以为然。我点点头,算是打招呼。
那晚讨论的主题是“魔法工业化与平民教育”。一个商人模样的中年男人正在发言:
“……关键在于降低魔法器具的使用门槛。现在的魔法灯为什么普及不了?不是因为技术做不到,而是因为旧贵族垄断了核心符文……”
“然后呢?”一个年轻学者打断他,“公开了符文,平民就买得起了?制作成本还是摆在那里。”
“所以需要规模化生产!”另一个声音加入,“用蒸汽动力驱动魔法刻印机,批量生产标准化的符文板……”
“但那样会挤垮传统的手工作坊。”
“进步总是有代价的……”
我听着,心里渐渐明白过来。这些人谈论的“魔法民主化”,核心是**让魔法技术变得更便宜、更普及**,从而让新兴的商业阶层能够进入市场,打破旧贵族的垄断。他们关心效率,关心利润,关心如何“重新分配蛋糕”。
但他们很少提到,那些在魔法工厂里操作危险机械的工人;很少提到,魔法工业产生的污染;很少提到,规模化生产背后,是更严酷的剥削。
就像在讨论怎么把蛋糕切得更漂亮,却没人问做蛋糕的人手疼不疼。
讨论间歇,维克多走到我身边,递给我一杯酒,确实比酒馆的劣酒好得多诶。
“感觉如何?”他问。
“很有意思。”我说,“大家都很务实。”
维克多笑了:“务实是美德。帝国需要务实的人,而不是整天念叨‘古老传统’的老古董。”他压低声音,“我父亲常说,这个国家就像一台老旧的魔法机车,零件锈蚀,却还在勉强行驶。我们需要的是工程师,不是祭司。”
我喝了一口酒,没接话。
“对了,”他像是忽然想起什么,“下次聚会,我们想换个地方。你有什么建议嘛。”
“我对这地儿可不熟。来到帝都之后都没出过几次校门”
“是吗?你常去的那家酒馆——‘铁砧与酒杯’,怎么样。”维克多脸上露出了3分轻蔑的笑——你的行踪我可一清二楚。
“铁砧与酒杯’,老板人挺好的。”我的脑子里突然复现了老约翰,哪个儿子在矿难里死了的父亲。要是这帮子富二代去包个场什么的,也算帮了把汉斯吧。
“我和几个成员商量了一下,觉得总在俱乐部聚会,有点脱离实际。”维克多的笑容里有一丝得意,“既然要讨论平民教育、工业化,不如直接去平民区看看。而且那家酒馆位置不错,空间也够。我已经和老板谈好了,每周租用一次场地,费用按市价付。”
我愣住了。我没想到维克多动作这么快。
“你……和汉斯谈过了?”我问。
“昨天去的。”维克多说,“老板一开始不太愿意,但钱总能说服人,不是吗?”他拍了拍我的肩膀,“这还得感谢你。要不是你带我去过那儿,我都不知道下民区还有这么个有特色的地方。”
“什么时候?”我有点期待汉斯感激涕零的表情了。
“下周五。”维克多说,“你会来的,对吧?毕竟,那是你的‘地盘’。”
“我会来。”
---
接下来的几天,我照常上课、训练、去图书馆。但我心里总惦记着酒馆的事。汉斯怎么感激我,会不会把他那个视若珍宝的烟斗借我抽两口。
转眼间也就到了周五晚上,我提前来到了“铁砧与酒杯”。酒馆里已经收拾过了——桌子擦得比平时干净,地上的污渍也清理了,但那股混合着劣酒、汗味和烟味的气息,是擦不掉的。
汉斯正在吧台后整理酒杯,看见我进来,他点了点头,独眼里没什么表情。
“老板,”我走过去,“维克多他们……”
“我知道。”他打断我,“今晚酒馆不对外营业,只接待他们。”他顿了顿,“十个金币。够我卖一个年的的酒了。”
“如果你不愿意,可以拒绝。”我挤眉弄眼的说。
汉斯看了我一眼,忽然笑了:“拒绝?少爷,您说得轻巧。我女儿病了,需要钱买药。五十个银币,我就能请个好牧师,还能剩下钱买点肉给她补补身子。您说我该拒绝吗?”
“而且。。。”他后面的话我没听清。但这话就不太好接了。
陆陆续续地,沙龙成员来了。大约十几个人。他们走进酒馆时,表情各异——有人好奇地东张西望,有人皱着眉头用手帕捂住鼻子,有人则努力做出“自然”的样子。
维克多是最后一个到的。他今天穿了一件深蓝色的便服,料子很好,但款式简单。他一进门就看到了我,笑着走过来。
“怎么样?这地方不错吧?”他环顾四周,“很有烟火气。”
生活气息。我想起汉斯女儿的病,想起老约翰死去的儿子。是的,这地方充满了“生活气息”。
讨论开始了。今晚的主题是“魔法农业与粮食安全”。一个年轻学者在发言,讲述如何用改良的土系魔法提高作物产量。
汉斯靠在吧台后,静静地听着,独眼盯着发言的人,脸上没什么表情。
我坐在角落,也静静地听着。我听到那些关于效率、成本、产量的讨论,听到那些雄心勃勃的计划。
但没有人提到,那些在田里劳作了一辈子的老农,会不会用这些新玩意儿;没有人提到,魔法农业会不会产生新的污染;没有人提到,粮食产量提高了,农民的收入会不会反而减少。
中场休息时,维克多走到吧台,要了一杯葡萄酒。汉斯默默地倒了一杯推过去。
“老板,”维克多抿了一口酒,皱了皱眉,“你觉得刚才的讨论怎么样?魔法农业,有没有前途?”
汉斯擦着杯子,头也不抬:“我不懂魔法,老爷。”
“但你是生意人。”维克多笑着说,“生意人应该懂成本、懂市场。如果魔法能让粮食产量翻倍,粮价下降,更多的人能吃饱饭——这不是好事吗?”
“是好事。”汉斯说,“但粮价下降了,种粮的人怎么办?”
维克多愣了一下。
“这个……总会有办法的。”他含糊地说,“技术进步总会带来阵痛,但长远来看……”
“长远来看,我们都死了。”汉斯打断他。
维克多的笑容僵了一下。他看了汉斯一眼,眼神里闪过一丝不悦,但很快又恢复了那副宽容的姿态:“你说得对。所以我们需要更周全的计划。”
讨论继续进行。后来有人提到了平民区的卫生问题。
“需要建立公共魔法净水系统。”一个商人说,“用标准化的水净化符文,配合蒸汽动力,成本可以压得很低……”
“但平民付得起使用费吗?”
“付不起的可以申请补贴……”
“谁来补贴?市政府?那钱还不是从税收里出?”
争论又开始了。我听着,忽然觉得有些疲惫。这些讨论就像在精致的棋盘上推演棋局,但棋盘外的真实世界,那些在泥泞中挣扎的人,似乎永远只是棋子。
沙龙结束时,已经快半夜了。成员们陆续离开,维克多最后一个走。他随意的在吧台上排出五个金币,硬币落在吧台上,发出清脆的响声。看来他是不打算再来体验生活了。
汉斯收起钱,点了点头。
维克多走到门口,又回头看了我一眼:“一起走吗?”
“我再坐会儿。”我说。
酒馆里安静下来。汉斯开始收拾桌子,把那些几乎没动过的点心和酒水收起来。
“他们没怎么吃啊,浪费粮食。”我装作义愤填膺的逗汉斯。
“正常。”汉斯头也不抬,“这些东西,他们看不上。”
我走到吧台前,看着汉斯把剩下的食物仔细包好,放进一个篮子里。
“给你女儿?”我问。
汉斯的手顿了顿:“嗯。她喜欢甜食。”
两人沉默了一会儿。
“你觉得他们怎么样?”我又尝试委婉的邀功。
汉斯直起身,独眼看向我:“聪明人。有学问,有想法,也有钱。”他顿了顿,“但他们看不见我们。”
我无言以对。因为我知道他说得对。就连我自己,在来到这个世界之初,不也是抱着一种“观察者”的心态吗?
“但至少他们在想办法。”我说,声音有些干涩。
“是啊,在想办法。”汉斯笑了笑,那笑容里有一种深深的疲惫,“想办法让我们活得更有效率,更符合他们的规划。就像修理一台机器,让零件运转得更顺畅,但不会问零件疼不疼。”
他拿起篮子,走向后门:“我要回去了。女儿还在家等我。”
“我帮你关门。”我说。
汉斯点点头,推门出去了。我留在酒馆里,慢慢收拾剩下的东西。做这些的时候,我脑子里回响着今晚听到的那些讨论,那些宏大的计划,那些关于“进步”和“未来”的憧憬。
然后我想起了汉斯的话:我们对他们来说,只是问题。
---
又过了几天,我再次来到酒馆。这次是周日下午,酒馆里人不多。
汉斯看见我,点了点头,照例给我倒了一杯酒。但今天,老板的表情有些不对劲——眉头紧锁,独眼里满是焦虑。
“怎么了?”我问。
汉斯张了张嘴,似乎想说什么,但又咽了回去。他摇摇头:“没事。”
我没再追问,但心里留了个意。我坐在老位置,慢慢喝着酒,观察着。一切都和往常一样,但又有哪里不同——汉斯擦杯子的动作比平时急躁,时不时看向后门。
大约过了一个小时,后门忽然被推开了。一个女孩冲了进来——大约十四五岁,瘦瘦小小的,穿着一件洗得发白的旧裙子,棕色的头发乱糟糟的。她脸上挂着泪痕,眼睛红肿,一进门就扑向吧台。
“爸爸!”女孩的声音带着哭腔。
汉斯立刻放下手里的杯子,绕过吧台抱住女儿:“莉莉?怎么了?”
女孩在他怀里抽泣着,话都说不清楚。汉斯拍着她的背,独眼里的焦虑变成了心疼,还有一丝……愤怒?
酒馆昏黄的灯光照在父女俩身上,把他们的影子拉得很长,投在斑驳的墙上,像一幅褪了色的旧画。
[上一章](https://www.paddysun.top/archives/4808) 下一章
[【曙光大陆】全书目录](https://www.paddysun.top/archives/4516)
====
# 个人博客“安全运维”:实用指北
https://www.paddysun.top/archives/4831 · 2025-12-10
> 因为前几天Next.js漏洞闹的人心惶惶。我看到热新群友发出提醒的时候,就很想知道这关我的事情嘛?白激动了一场。
> 顺便整理了自己的日常“安全运维”过程。 主要包括:如何判断新漏洞尝试关我的事情嘛?我如何处理WAF和腾讯主机安全的告警?
## 一、梳理资产清单
首先需要将自己的资产,框架,细细梳理。整理有哪些,是什么版本,与官方发布页面。我知道这很无聊(嘛?很有趣好吧)目的在于:
- 检查**是否在官方维护周期内**,维护周期到什么时候。如果不在评估风险并计划升级。
- 是否需要更新。
- 便于之后收到云主机安全和WAF等告警,和群友发出来的热门漏洞陷阱时候快速**确定新漏洞和我有没有关系**。
- 确定之要主动关注那些安全情报
其中的建议的思路是这样的。
1. **核心组件**(操作系统、核心服务、数据库、Web服务器,WAF):检查版本支持周期。
2. **插件与主题**:尽量选择商业化有完善维护的,开启自动更新就好了,但也记录一下,万一呢是吧。
### 资产清单(示例)
**1. 底层与基础设施**
组件类别组件名称版本/状态**是否在维护期/风险**建议检查地址**系统**UbuntuXXX**是**。XXX 支持至 **X年X月**。定期 `apt update && apt upgrade`。[Ubuntu 安全通告](https://ubuntu.com/security/notices) [版本生命周期](https://ubuntu.com/about/release-cycle)**WAF**长亭 SafelineXXX**是**。保持更新就好了**核心防线**,务必保持更新。关注管理后台的升级提示。[官方文档与公告](https://help.waf-ce.chaitin.cn/)
---
**2. 核心应用与中间件**
业务核心部分,必须严格跟进官方情报。
组件类别组件名称版本/镜像**是否在维护期/风险**建议检查地址**核心应用**WordPresswordpress:XXX**是**。WordPress XXX系列仍在积极维护和安全更新。开启核心**自动安全更新**。关注大版本发布。[WordPress 官方安全公告](https://wordpress.org/news/category/security/) [核心开发博客](https://make.wordpress.org/core/)**数据库**XXXXXX**是**。XXX 是当前稳定系列 (GA),提供安全更新。定期更新镜像,注意备份后再操作。[MariaDB 安全公告 (CVE)](https://mariadb.com/docs/security/cve/) [版本支持政策](https://mariadb.com/kb/en/mariadb-server-release-dates/)
**3. WordPress 插件与主题**
插件
插件名称版本**是否在维护中?** (判断依据)备注与建议检查地址**WP Mail SMTP**4.7.1**是** (超500万安装,商业公司维护)**关键插件**。配置涉及邮箱凭证,必须保持最新。[插件主页](https://wordpress.org/plugins/wp-mail-smtp/)
---
**主题列表**
主题名称版本/状态**是否在维护中?**备注与建议**二〇二三**未启用**是** (WordPress官方默认主题)备用主题,安全。
---
## 二、情报收集
在梳理完资产清单后,接下来就是搭建“情报网络”。目标是:**在漏洞被大规模利用、甚至被“广而告之”之前,就收到风声**。而不是在吹水群里或着刷短视频时才后知后觉,这不是显得你很菜嘛。
除了上文我们介绍的操作系统啊什么的发的官方安全通报。
我希望有一个**免费的、可设置关键词的平台**(比如输入“WordPress”、“WooCommerce”、“Redis”),一旦**有相关漏洞披露,就能自动推送给我**。但很遗憾,并没有找到。以下是我尝试过的:
- [OPENcve](https://app.opencve.io/):免费版不能设置关键词(默认关键词为linux,windows好吧也行)
- [安恒情报](https://www.dbappsecurity.com.cn/):我怎么都绑定不了邮箱,气死我了。
- [长亭漏洞情报库](https://rivers.chaitin.cn/vuldb):扫描微信订阅的二维码,扫了就关注了个“应急响应中心”的公众号,更新频率很低。长亭雷池是好用,但这些社区功能像是做了一半没做完一样(盆友说是降本增效)
- 或许可行的方案:还没来得及尝试:[CVE Push Service | 高危漏洞实时情报自动化推送工具](https://blog.csdn.net/weixin_44309905/article/details/151070345)
没有免费的订阅/推送服务,难道要我时不时打开情报网站,一个一个搜索关键词?
没有枪,没有炮,敌人给我们造!我选择**放弃“大海捞针”,转为“让攻击者告诉我,哪里最危险”** —— 也就是充分利用WAF、云主机安全甚至是蜜罐系统的**告警功能/拦截日志**。
> 我之前随便布设了一个 Hfish 蜜罐,每日收集的攻击接近千条。我根本处理不过来。工作流程就是从蜜罐系统中将攻击记录导出然后写了个脚本加入ipset黑名单,然后报告给 AbusedIPDB。 最近攻击量猛增,用的轻量化数据库根本受不了,证书也没设置对,就下掉了。
## 三、告警处理
当告警真的来了(比如手机弹出“腾讯云主机安全-网络攻击告警”)。我是这样处理的。
**告警通常长这样:**
目标IP端口攻击来源IP来源地漏洞名称你的服务器IP80[208.87.xxx.xxx](https://208.87.xxx.xxx/)美国**React Server Components 远程代码执行漏洞(CVE-2025-55182)**你的服务器IP80[156.251.xxx.xxx](https://156.251.xxx.xxx/)中国香港**Apache HTTP Server路径穿越漏洞 (CVE-2021-41773)**
看到这个,我的处理方法是(流程图太长了,你感兴趣可以下下来):
[我的安全告警处置流程图](https://www.paddysun.top/wp-content/uploads/2025/12/%E5%AE%89%E5%85%A8%E5%91%8A%E8%AD%A6%E5%A4%84%E7%BD%AE%E6%B5%81%E7%A8%8B%E5%9B%BE-301x1024.png)[下](https://www.paddysun.top/wp-content/uploads/2025/12/%E5%AE%89%E5%85%A8%E5%91%8A%E8%AD%A6%E5%A4%84%E7%BD%AE%E6%B5%81%E7%A8%8B%E5%9B%BE-301x1024.png)
**第一步:先看结果——“打中了吗?”**
- **看告警状态**:是 **“已拦截”** 还是 **“攻击成功”**?
**第二步:再看详情——“关我事吗?”**
1. **提取关键信息**:从“漏洞名称”里找到 **CVE编号**(如 CVE-2021-41773)或准确的漏洞名称。
2. **快速查询**:把CVE编号丢进你的**漏洞情报库**(下面有推荐),查看详情。
3. **对照资产清单**:重点看这个漏洞影响**哪个服务、哪个版本范围**。然后立刻翻回你的**资产清单表**,核对你的对应服务版本是否在受影响范围内。
**我常用的漏洞情报库:**
- [**腾讯漏洞情报\[付费\]**](https://console.cloud.tencent.com/cwp/defend):需要配合腾讯主机安全使用(10元/月,但告警分析和处置建议很详细)。还支持列表导出。
- **[长亭漏洞情报中心\[免费\]](https://rivers.chaitin.cn/vuldb)**:可以单独使用,或者配合雷池“查看攻击详情”,对漏洞描述和分析比较详细。
- **[CNNVD\[免费\]\[备用\]](https://www.cnnvd.org.cn/)**:国家漏洞库,权威,描述简单,没有分析。但附有多个国内外信息源。称之为漏洞导航站。
**第三步:咋搞啊——“人若犯我……我拿它也没办法”**
我发现大部分情况都是其利用的漏洞与我的版本不匹配。或者就是被WAF拦截了。可能这就是最常见的状态——**攻击者只是在“广撒网”**,对我们没有构成实质威胁。
但我的原则是:**“来都来了,不给你留下点纪念品说不过去吧?”** 既然你主动扫描我、攻击我,那我也不能让你白跑一趟。
所以我会:
1. **封禁IP**:使用 `ipset_manager.sh` 拉黑一段时间。
2. **上报情报**:报告至 AbuseIPDB,要让这个IP的“恶行”被更多人知道。
> 不是这个专业的,但感觉玩的很开心,还请大佬不吝赐教
> 本文采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en)
====
# 我与垃圾评论
https://www.paddysun.top/archives/4826 · 2025-12-09
作为刚建站两个月时,我小心翼翼开放评论第二天就经历了所有WordPress用户共同的噩梦:违规垃圾评论。
在尝试了Akismet(对中文内容拦截效果很差)、全部人工审核(感觉让别人等着审核通过不太好。。。)。
终于发现了两个插件[@obaby](https://oba.by/2025/09/21609)的**[baby-wp-comment-filter](https://github.com/obaby/baby-wp-comment-filter)**和[@沈唁志](https://qq52o.me/2720.html)的[**wp-baidu-textcensor**](https://github.com/sy-records/wp-baidu-textcensor)。
但很快发现了新问题:
1. 广告开始出现在**用户名**字段,**成功绕过所有检查**
2. 复杂的纯中文的软文广告形态绕过黑名单匹配
3. 手动维护黑名单的成本极高(试过导入[一个很长很长的中文敏感词库](https://github.com/dablelv/dirty-cnwords)导致页面崩溃)
4. wp-baidu-textcensor对百度审核API的调用没有充分保护,只有频率限制。被有心人用个IP池什么的刷完了咋办。
## 技术选型:混合防御策略的诞生
经过两周的测试,我发现一个**分层验证模型**(以baby-wp-comment-filter为基础,后置百度文本内容审核)效果最佳。
```
通过拒绝通过拒绝安全可疑违规用户提交评论WAF人机验证与频率限制Baby WP基础检查即时拒绝百度AI内容审核自动发布人工审核自动拦截
```

实施方面我是没有那个能力去从零写,就只有东拼西凑了。
防御层处理速度识别能力资源消耗[雷池 Bot防护](https://waf-ce.chaitin.cn/)2s左右人及防护,但出现了正常评论丢失的问题大约1g内存[Baby WP本地规则](https://github.com/obaby/baby-wp-comment-filter)毫秒级英文/基础格式可忽略[百度AI审核](https://github.com/obaby/baby-wp-comment-filter)毫秒级中文语义/变体广告API配额
目前在Baby WP的框架下加入了论百度AI审核的能力,后台插件太多看着难受。我爱大而美\^o^/。
分支地址:[https://github.com/PaddySun/baby-wp-comment-filter/tree/feat/baidu-textcensor](https://github.com/PaddySun/baby-wp-comment-filter/tree/feat/baidu-textcensor)
还在测试阶段,之后也会继续维护开发分支!(立flag
## 致谢与Roadmap
特别感谢原插件作者[@obaby](https://oba.by/2025/09/21609)的基础框架,和[@沈唁志](https://qq52o.me/2720.html)的百度审核部分代码。我爱开源社区。
- 近期:完整测试后PR到**baby-wp-comment-filter**
- 中期:加入评论用户名长度限制自定义
- 长期:可能会研究下NLP和效率优化技术、垃圾评论特征分析等等
## 需要你的帮助
谢谢你看到这里,那我就在厚脸皮一下。
1. **测试用例征集** 如果你遇到过特殊形态的垃圾评论,欢迎在[Issue](https://github.com/PaddySun/baby-wp-comment-filter/issues)提交样本,在本站留言会被拦截(希望如此
2. **误报/漏报/反馈**如果你在本站留言被错误拦截,我大概率能受到提醒与你的评论原文。但方便的话请[留言邮件或任何方式](https://www.paddysun.top/contact-us)通知我。
无论最终PR是否被@obaby通过,这个分支都会持续维护。折腾永不停止,与人斗其乐无穷。
====
# 是人也看不清的动态验证码生成与破解
https://www.paddysun.top/archives/4815 · 2025-12-08
> 真的很抽象很抽象,想到我曾经想拿这个去申请专利我就想笑(21年已经有人注册了类似方法技术[1])。
> 建议桌面端浏览,建议看看长什么样就行了。
> 还有有什么很好的wordpress Latex方案嘛。现在使用md转HTML加入,加载又慢,效果又差。
生成方法的数学模型 仅文章
生成方法的数学模型(1) 均匀噪声背景Ibase(x,y,t)∼U(0,1)其中 (x,y)(x,y) 是像素坐标,U\mathcal{U} 为均匀分布。(2) 字符蒙版**静态字符蒙版**:
对每个字符 cc,定义其像素矩阵 C∈{0,1}Hc×WcC \in \{0,1\}^{H_c \times W_c},其中:实心部分透明部分C(y,x)={1实心部分0透明部分**字符蒙版随机化**:Cr(x,y,t)=C(y,x)⊙Ibase(x,y,0) 蒙版随时间,以给定速度(vx(t),vy(t))(v_x(t),v_y(t))运动,运动的蒙版为。Mglobal(x,y,t)=Cr(x−∫0tvx(t)dt⋅t,y−∫0tvy(t)dt)2. 图像合成公式**最终图像** 在时间 tt 的合成:字符蒙版初始随机噪声背景保留背景噪声Iresult(x,y,t)=Mglobal(x,y,t)⏟字符蒙版⊙Ibase(x,y,0)⏟初始随机噪声+(1−Mglobal(x,y,t))⏟背景保留⊙Ibase(x,y,t)⏟背景噪声其中 ⊙\odot 是逐元素乘法。直线匀速运动下的破解方法1. 引言动态验证码作为一种增强安全性的技术手段,通过在时间维度引入变化来抵抗自动化攻击。然而,其设计原理可能引入新的安全漏洞。本文研究一类特殊的动态验证码,其生成过程可表述为:Iresult(x,y,t)=Mglobal(x,y,t)⊙Ibase(x,y,0)+(1−Mglobal(x,y,t))⊙Ibase(x,y,t)其中 Mglobal(x,y,t)M_{\text{global}}(x,y,t) 为字符蒙版,Ibase(x,y,t)I_{\text{base}}(x,y,t) 为背景图像。本文旨在从观测图像序列 {Iresult(x,y,ti)}i=1N\{I_{\text{result}}(x,y,t_i)\}_{i=1}^N 中恢复任意时刻 tt 的字符蒙版 Mglobal(x,y,t)M_{\text{global}}(x,y,t)。2. 问题建模与特性分析2.1 动态验证码生成模型考虑动态验证码图像序列 {Iresult(x,y,ti)}i=1N\{I_{\text{result}}(x,y,t_i)\}_{i=1}^N,其中每个时刻的图像由字符区域和背景区域组合而成:**字符区域**(Mglobal(x,y,t)=1M_{\text{global}}(x,y,t)=1):像素值保持初始时刻不变,即 Ibase(x,y,0)I_{\text{base}}(x,y,0)**背景区域**(Mglobal(x,y,t)=0M_{\text{global}}(x,y,t)=0):像素值随时间独立随机变化,服从均匀分布 U(0,1)\mathcal{U}(0,1)2.2 时空特性分析字符蒙版做匀速直线运动:Mglobal(x,y,t+Δt)=Mglobal(x−vxΔt,y−vyΔt,t)同一字符点在相邻帧间满足:字符点同一字符点Iresult(x,y,t)字符点=Iresult(x+vx,y+vy,t+1)同一字符点3. 逆问题求解算法3.1 运动速度估计对于正确速度 (vx,vy)(v_x, v_y),字符区域(平移后对齐)的差值为0,背景区域差值较大(因为独立随机)。定义互相关(Cross-Correlation)如下。R(u,v)=∑t=1N−1∑x,yIresult(x,y,t)⋅Iresult(x+u,y+v,t+1)因此,正确的 (vx,vy)(v_x, v_y) 会使 R(u,v)R(u,v)最小。(vx,vy)=argmaxu,vR(u,v)3.2 参考坐标系对齐将所有帧变换到 t=0t=0 时刻的坐标系:J(x,y,ti)=Iresult(x+vxti,y+vyti,ti)其中 J(x,y,ti)J(x,y,t_i) 表示在参考坐标系 (x,y)(x,y) 处、时刻 tit_i 的像素值。3.3 字符区域识别基于时间序列方差分析区分字符区域和背景区域。对于每个参考系位置 (x,y)(x,y):Var(x,y)=1N−1∑i=1N[J(x,y,ti)−J¯(x,y)]2其中 J¯(x,y)=1N∑i=1NJ(x,y,ti)\bar{J}(x,y) = \frac{1}{N} \sum_{i=1}^N J(x,y,t_i) 为时间序列均值。通过阈值分割生成参考系蒙版:Mglobal(x,y,0)={1if Var(x,y)<τ0otherwise阈值 τ\tau 选择理论值 α12\frac{\alpha}{12}(均匀分布方差为 112\frac{1}{12})或经验值 0.01∼0.050.01 \sim 0.05。3.4 任意时刻蒙版重建从参考系蒙版 Mglobal(x,y,0)M_{\text{global}}(x,y,0) 重建任意时刻 tt 的蒙版:Mglobal(x,y,t)=Mglobal(x−vxt,y−vyt,0)4. 算法流程本文提出的逆问题求解算法流程如下:**输入**:图像序列 {Iresult(x,y,ti)}i=1N\{I_{\text{result}}(x,y,t_i)\}_{i=1}^N**速度估计**:通过帧间配准估计 (vx,vy)(v_x, v_y)**坐标对齐**:生成参考系图像序列 {J(x,y,ti)}i=1N\{J(x,y,t_i)\}_{i=1}^N**方差计算**:计算每个位置的时间序列方差 Var(x,y)\text{Var}(x,y)**阈值分割**:生成参考系蒙版 Mglobal(x,y,0)M_{\text{global}}(x,y,0)**运动补偿**:重建任意时刻蒙版 Mglobal(x,y,t)M_{\text{global}}(x,y,t)5. 实验分析与讨论5.1 实验结果xxxxxxxxxx从GIF中提取了 100 帧 (索引 0:100:1)提取了 100 帧, 尺寸: (100, 250)正在估计运动速度...估计的运动速度: vx=-3, vy=0正在对齐帧到参考坐标系...正在识别字符区域...方差统计信息: 最小值: 1892.23 最大值: 16256.25 平均值: 14582.21 中位数: 15319.89使用的方差阈值: 11515.00字符区域占比: 0.077针对本次测试的验证码文本为"ZAdx"动态验证码。从GIF动画中成功提取了100帧图像(索引范围0:100,步长为1),帧尺寸为250×100像素。经过运动估计算法处理,准确识别出字符蒙版的运动速度为水平方向vx=-3像素/帧,垂直方向vy=0像素/帧,表明字符蒙版沿水平向左匀速运动。在坐标系对齐和方差分析阶段,算法获得了以下关键统计信息:时间序列方差的最小值为1892.23,最大值为16256.25,平均值为14582.21,中位数为15319.89。基于这些统计特征,选择了11515.00作为方差阈值,成功识别出占总面积7.7%的字符区域。由于字符蒙版从图像边界外开始运动,恢复效果呈现明显的时序特征:先进入视野的字符"ZA"因观察到了较长的运动周期,蒙版恢复较为清晰完整;而后出现的字符"d"和"x"因在观测时间窗口中在图像区域内时间较短,导致恢复的蒙版较为残破不全。这一现象符合运动蒙版的物理特性,也证明了运动估计的准确性。

## 参考文献
1. 基于混沌干扰与动态视觉暂留的抗再训练视频验证码生成方法及系统 雷扬
2. 高效的验证码识别技术与验证码分类思想 文晓阳
3. 基于PHP的中文GIF动态验证码生成器的设计与实现 唐乾林
4. 视觉注意力检测综述 王文冠
> 本文采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en)
====
# 【曙光大陆】004 上流与下流
https://www.paddysun.top/archives/4808 · 2025-12-07
与其做一个窝窝囊囊的人,何如做一头人见人爱的驴?
这念头在艾伦脑子里转了好几天,尤其是在军事基础训练的时候。那教官,脸色一如既往差的像是秦陵里的干尸,自打见识了艾伦那套“野路子”火球术后,也不知道为什么就盯上他了。一起挥挥魔杖就好(集体施出的威力大些,也有限),他反而得去跑圈;别人跑圈,他还是得跑圈;休息睡了,他被单拎出来,继续特训那套“帝国标准魔力引导手势”,一遍又一遍,直到胳膊酸得抬不起来,汗水流进眼睛里,辣得生疼。
那些细皮嫩肉的贵族少爷们,起初多少有点担心,后来发现教官的火力全集中在艾伦身上,便也松快下来。现在没人会来和艾伦搭话了,原本也没有,看艾伦的眼神里没有可怜,就是单纯的看那头拉磨拉得特别卖力、却总挨鞭子的倔驴的感觉。
时间过得快极了,也慢极了。快的是训练日程,慢的是每一分每一秒的肌肉酸痛和精神折磨。艾伦觉得自己就像一块被反复捶打的铁胚,教官就是那铁匠,抡着“规矩”的大锤,非要把他身上那些“不合时宜的棱角”砸平了,砸进那个统一的、方正的模子里去。他脑子里嗡嗡的,塞满了教官的吼声、皮靴砸地的声音、还有自己粗重的喘息。有时候累极了,他真觉得自己不如变成头驴,至少驴挨鞭子是因为拉磨,拉完了还能歇歇,吃口草料。他现在这算啥?拉的是看不见的磨,挨的是“为你好的鞭子”。
训练总算结束了,艾伦的脑子还是懵的,像被灌了一瓢刚搅和开的糨糊。胳膊腿儿仿佛不是自己的,走路都打着飘。回到宿舍,一头栽倒在硬板床上,盯着天花板上那几道陈年水渍,觉得那纹路比任何魔法阵都深奥难懂。
就在他觉得自己快要像块晒透的土坯一样裂开时,一张请柬,带着股薰衣草掺和魔法墨水的怪味儿,塞到了他手里。递请柬的是秃头,“魔导工学”那屋的管理员。递过这张颇具分量的请柬的时候随意的像问吃了吗,“斯特林伯爵,学院的金主。他儿子和你同班,就那个头发梳得能滑倒苍蝇、坐得比教堂长凳还直的维克多。去露个脸,穿体面点。”
艾伦捏着那烫金边的羊皮纸,感觉比训练时的沙袋还沉。魔法礼服?他只有两件洗得发白、腋下快透光的学院袍。正装?他上辈子的西装倒是挺括,可惜没跟着灵魂一起穿越过来。
秃头像是看穿了他的窘迫,叹了口气,从他那散发着旧书和古怪药剂味的衣柜深处,刨出一套深蓝色的礼服。“借你的,小心点穿别揉别洗,有恒温的符文,所以才叫魔法礼服。”艾伦接过,料子沉甸甸的,触手微凉,袖口那些银线绣的符文,在昏暗的光线下像一群睡着了的小萤火虫。
周五晚上,艾伦就穿着这套借来的“皮”,站在了斯特林伯爵府邸的大门前。好家伙,这哪是府邸,分明是把一座小山掏空了,又用宝石和亮晶晶的魔法糊了一遍。黑丝绒似的夜空,成了盛放珠宝的衬垫,窗户里流光溢彩,活像巨兽睁开了无数只镶金嵌银的眼。门口杵着俩守卫,盔甲不是铁打的,像是某种会变色的水晶,灯光一照,赤橙黄绿青蓝紫,轮流在他们身上跑马,看得艾伦眼晕,心想这要是搁生产队晚上站岗,不用带灯,自个儿就能当信号塔使。
珍珠白的大门不是打开的,是像块受热的猪油膏,慢慢化开,变得透明,露出里面更加晃眼的世界。艾伦迈步进去,感觉自己不是走进了一个厅堂,而是掉进了一个正在缓慢旋转的、光怪陆离的万花筒。
穹顶高得能飞鸽子,上面的壁画不是画的,是像流沙一样缓缓地流动着,金色的云,紫色的霞,蓝色的不知名星图,慢悠悠地飘荡、融合、分离,看得人脖子发酸。墙上挂着的祖宗画像,大部分眼珠子会跟着人骨碌碌转,有点则在哪冲瞌睡——谁家没几个躺平的呢是吧。
艾伦试着往左挪两步,画里那个戴着夸张假发、面色红润的老爵爷,眼珠就跟着滑到左边;往右挪,眼珠又骨碌回来。这感觉,比被教官盯着做俯卧撑还让人毛骨悚然,仿佛在扒拉着你,掂量着你身上的礼服是租是借,掂量着你骨头里几两重,琢磨着怎么榨干你身上的全部油水。
大厅中央是个喷泉,喷的不是水,是发光的、粘稠的、像融化的琉璃似的东西。它忽而扭成螺旋,忽而炸开成雪花,忽而又聚拢成一个个模糊的、仿佛有生命的人形,旋即又散开。围着喷泉的长桌上,食物堆得像小山。烤得焦黄、滋滋冒油的禽兽,艾伦认得;那些蠕动着的蓝色胶冻、冒着七彩气泡的饮料、长得像微型森林的甜点,他就敬谢不敏了。尤其是一种放在银盘里、还在微微搏动的、暗红色的肉块,旁边插着花体的小标签:“烈焰犀牛心”,艾伦胃里一阵翻腾。
人声嗡嗡,像夏天池塘里成群的蛤蟆。男人们穿着和艾伦类似的魔法礼服,只是料子更挺,符文更亮,有些人的领口、袖扣甚至鞋尖,都嵌着真正会发光的魔法石。女人们则是移动的星河,露着白花花的肩膀和后背,裙摆迤逦,上面绣着的魔法纹路随着步伐摇曳着明明灭灭,洒下细碎的光尘。
拿着小扇子一档小嘴儿,就开始笑话艾伦这个乡巴佬了——至少艾伦是这样觉得的。
空气里混杂着昂贵的香水味、食物的油腻香气,还有一种无处不在的、细微的魔法波动,像无数只小虫子在皮肤上爬。
艾伦把自己缩进一个靠近巨型盆栽的角落,手里端着一杯不知名的、冒着珍珠般气泡的银色饮料,不敢喝。他观察着人群,很快看出了门道。
最核心的一圈,众星捧月般围着个穿金色礼服、头发梳得一丝不苟的中年男人,想必就是斯特林伯爵。他说话声音不高,每说一句,周围便适时地响起一阵压低的笑声或赞同的颔首,节奏精准得像交响乐。旁边是年轻贵族们的圈子,维克多就在其中,如鱼得水,笑容标准得可以用尺子量,领口的金鹰家徽比在学校里戴着的好像又大了一圈,光芒刺眼。
还有一些人,散落在边缘,衣着各式各样,体面但不出挑,神情带着点谨慎的恭敬,大概是教授、官员或富商。艾伦属于这里,又不完全属于——他连这身“皮”都是借的。
果然,维克多像艘装饰华丽的巡洋舰,缓缓驶到了艾伦好不容易找到的“浅水区”,但又因为吃水太深开不进来。远远的打了声招呼,“史密斯,”他开口,笑容无懈可击,“真令人意外。”目光在艾伦袖口那处不易察觉的、用魔法勉强修补过的磨损处停留了半秒。
“秃头 让我来见识见识。”艾伦实话实说。
维克多点点头,仿佛这个答案印证了他的某种判断。“见识见识?很有自知之明。”他语气轻飘飘的,像在点评一道不够甜的餐后点心,“毕竟,合适的场合需要合适的装束,就像合适的土壤才能长出合适的作物,不是吗?”他点了点头,动作不大不重,却带着一种毋庸置疑的、划分界限的意味,然后转身回到了他那光芒四射的圈子。隐约有压低的笑声传来,像蚊子哼。
艾伦不想琢磨他说的是啥意思。继续啃着一块看起来相对正常的蜂蜜糕点,甜得发齁。他感觉自己像混进天鹅群里的土鸭子,毛色不对,叫声不对,连划水的姿势都透着笨拙。但起码吃饱了再说。
宴会的高潮是一只鸟。伯爵命人推上来一个罩着黑绒布的笼子,掀开布,里面是只漂亮得近乎邪异的生物——火羽鸟,据说来自火山群岛。它被放出来,在大厅上空盘旋,拖曳着长长的、火星四溅的尾羽,像一把在空中挥舞的、燃烧的拂尘。宾客们仰头赞叹,为那些精准避开他们头顶、化为光屑消失的火星而鼓掌。
先是盘旋再是俯冲,最后引导着众人的视线,飞向了那扇变得透明的宴会厅大门。大门外,不知何时已停了一辆由四匹纯白独角兽牵引的、通体镶嵌月光石的华贵马车。车门无声滑开,一只穿着银线刺绣软靴的脚迈了出来。
然后,艾伦看见了那张脸。
那张脸他太熟悉了——每天在“魔导工学”资料室里,一天到晚研究者那些“小玩意”、抬起头用那双总在提醒你眠不足的眼睛、得能数清有几根头发的那张脸。
秃头。
但现在,这张脸上方顶着繁复得能当鸟巢的银白色假发,假发上还别着几枚小小的、不断变换色彩的魔法星钻。他身上穿着银白与深紫交织的宫廷礼服,领口别着的不是家徽,而是一枚小小的、散发着柔和日晖般光芒的徽记——晨曦皇室的象征。他脸上那种惯常的、对什么都提不起劲的懒散神情消失了,取而代之的是一种恰到好处的、温和而疏离的威严。嘴角挂着浅浅的、标准的弧度,眼神平静地扫过大厅,像阳光掠过水面,温暖却不深入。
大厅中的众人,包括斯特林伯爵,纷纷脱帽俯身,动作整齐得像排练过无数次。小姐们则微微屈膝,裙摆如花朵般绽开。
“皇长子艾德里安·晨曦殿下,”斯特林伯爵迎上前,声音里带着恰到好处的恭敬与熟稔,“欢迎驾临寒舍,真是蓬荜生辉。”
“斯特林叔叔太客气了。”艾德里安——或者说,秃头——的声音响起,还是那个音色,但语调、节奏、轻重,全都变了。不再是资料室里那种含糊的、带着鼻音的嘟囔,而是清晰、平稳、每个字都落在该落的地方,像精心调试过的琴键。“父亲有点想念您了,特命我前来一看看,顺便代看望下他送您的火烈鸟了。”
“陛下厚爱啊。”斯特林伯爵侧身引路,“殿下请。”
接下来的半小时,艾伦就站在那个角落里,看着那个他以为除了捣鼓发明和打瞌睡之外什么都不会的“秃头”,自如地周旋在宾客之间。他和老贵族们谈论今年的魔法作物收成,语气熟稔得像在聊自家后院;他和几个将军模样的男人低声交谈了几句,对方立刻露出受宠若惊的表情;他甚至走到那群年轻贵族中间,拍了拍维克多的肩膀,说了句什么,维克多那张永远完美的笑脸竟然出现了片刻真实的、受鼓舞的红光。
更让艾伦目瞪口呆的是,艾德里安居然还和几位小姐跳了舞。他的舞步标准而流畅,引领着女伴在光滑的地面上旋转,银白色的假发在灯光下闪着柔和的光,那身华丽的礼服穿在他身上,竟然不显突兀,反而有种奇异的和谐——仿佛他生来就该穿成这样,站在这里。
艾伦看着,脑子里一片混乱。那个在资料室角落啃干面包、袍子上沾着墨水渍、抱怨“这帮小兔崽子又把卷宗顺序搞乱了”的秃头,和眼前这个谈笑风生、举止优雅、被众人簇拥的皇长子,真的是同一个人吗?
他想起少林寺的扫地僧人了。不带这么反差的呀。
也许,人本来就有很多张脸。在资料室是一张,在宴会厅是另一张。在泥地里是一张。就像驴,拉磨的时候是一副样子,卸了套、在田野里撒欢的时候,又是另一副样子。
艾伦正胡思乱想,忽然感觉一道目光落在他身上。他抬起头,正好对上艾德里安看过来的眼睛。隔着半个大厅,隔着晃动的人影和闪烁的灯光,那双眼睛平静无波,看不出任何情绪。但艾伦确定,他看见自己了。
艾德里安的目光只停留了一瞬,便自然地移开,继续和身旁的一位老贵族交谈,仿佛刚才那一眼只是无意中的扫视。
憋闷。那种训练时被训斥的不行、透不过气的憋闷感又回来了,还混杂了甜腻的香气和虚假的笑声。艾伦借口透气,溜出了大厅。
走廊长得仿佛没有尽头,厚地毯吸走了所有脚步声。他漫无目的地走,推开一扇不起眼的侧门,来到了一个露天阳台。夜风一吹,脑子清醒了些。下面是个魔法花园,植物们发着幽光,蓝的、绿的、紫的,像一片沉静而诡异的海底。更远处,是城市密密麻麻的灯火,那些魔法塔尖的光芒,从这里看,冰冷而遥远。
他摸出根烟——本地特产,烟叶里掺了宁神草,点着了,有一股清凉的薄荷味冲进肺里。烟雾缭绕中,他仿佛又回到了前世夏夜的路边摊,啤酒、烤串、汗味和肆无忌惮的吹牛声。但那画面很快被另一种声音覆盖。
是歌声。跑调的、粗野的、混杂着喧哗和碰杯声的歌声,从伯爵府高墙的另一边,隐约传来。
鬼使神差地,艾伦掐灭烟,顺着阳台一侧狭窄的、装饰性的铁梯爬了下去,穿过寂静的、发着微光的花园,找到一扇隐藏在藤蔓后的、生锈的小铁门。门没锁,轻轻一推,“吱呀”一声,另一个世界的声音和气味,汹涌地扑了进来。
门后是条巷子,地上是黑乎乎的泥浆,混杂着可疑的垃圾。空气的味道复杂极了:劣质酒精的酸馊、汗液的咸腥、食物腐败的馊味,还有一股……类似烧焦塑料混合着硫磺的、刺鼻的化学气味。巷子尽头有光,昏黄、摇曳,是从一扇破窗户里透出来的油灯光。
艾伦走过去,那是一家酒馆。招牌歪斜,油漆剥落,画着的酒杯图案模糊不清。喧闹声正是从这里炸开的。
他推门进去。
烟雾更浓,是劣质烟草和某种廉价魔法燃料混合的产物,辛辣呛人。灯光昏暗,勉强照亮几张油腻的破木桌和长凳。挤在这里的人,与宴会厅里的仿佛是两种不同的生物。男人大多穿着看不出本色的工装或粗布衣,脸上刻着疲惫和风霜;女人很少,且大多面色憔悴。几乎每个人身上都带着某种“痕迹”:缺了手指的手,不太灵便的腿,脸上、脖子上奇怪的色素沉积或疤痕。艾伦认出其中一些是“魔法灼伤”或“低度污染症”——长期接触未经妥善处理的魔法废料或廉价魔法器具的后果。
吧台后的老板是个秃顶壮汉,正用一块黑乎乎的抹布擦着同样黑乎乎的杯子。看见艾伦进来,他独眼里闪过一丝诧异,像在粪堆里看见了一朵绢花。
“少爷,走岔道了吧?”老板声音沙哑,像砂纸磨过木头。
艾伦没说话,走到吧台前,掏出几个磨得发亮的铜币——他省下的。“酒,”他说,“最烈的。”
老板盯着铜币,又盯着艾伦身上与这里格格不入的礼服下摆(尽管沾了灰),半晌,收起钱,从柜台下摸出个陶罐,倒了满满一杯浑浊的、泛着泡沫的液体推过来。杯子边沿有个豁口。
酒很辣,像一道火线从喉咙烧到胃里。艾伦端着杯子,找了个墙角的空位坐下。周围的人起初还打量他,但很快就被各自的忧愁和酒精拉回了自己的世界。
声音嘈杂地涌进他的耳朵:
“……三个铜板!说好五个,那狗日的工头抹了两个!说是魔法熔炉效率低了,扣我们的钱!”
“……咳嗽,咳了半个月了,东区那水……不能喝了,一股子怪味,可有什么法子?”
“……听说了吗?南巷老约翰家的闺女,在纺纱厂,手被魔法纺锤卷进去,没了……赔了十个银币,顶个屁用!”
“……活不下去了,真活不下去了……北边矿上又塌了,埋了十几个,尸首都挖不全……”
“……小声点……我听说,有些地方,有人在‘串’了……”
“……串?拿啥串?拿你挖矿的镐头,去串那些老爷的魔法盔甲?醒醒吧!”
这些声音,粗糙,真实,带着汗味、酒气和绝望。它们像一把生锈的锉刀,嘎吱嘎吱地,锉掉了艾伦脑子里那些宴会厅的华美光影,露出了下面冰冷、坚硬、布满裂痕的现实基底。这个魔法光辉照耀的帝国,它的蒸汽魔法机车跑得再快,它的浮空城堡建得再高,也是用这些人的血汗、健康甚至生命,一点点垫起来的。那些宴会厅里光鲜亮丽的人们,他们的恒温礼服、自动料理、魔法娱乐,其代价就流淌在这条肮脏巷子的空气里,凝固在这些残破的身体上。
艾伦又喝了一杯。劣酒烧灼着他的胃,也烧灼着他的思绪。他想起了教官的“规矩”,想起了维克多那轻飘飘的“合适”,想起了那只在笼中盘旋的火羽鸟。上流与下流,原来不过是一墙之隔。墙内的人,在精致的笼子里,享受着被规训好的“自由”和“美好”;墙外的人,在露天的泥泞里,挣扎着最原始的生存。而他自己,这个穿越而来的灵魂,这个背负着间谍任务的替身,此刻正可笑地骑在墙头上,一只脚沾着宴会厅的香水味,一只脚浸在贫民窟的泥浆里。
他在酒馆里坐了很久,直到身上的礼服沾满了烟味和酒气,直到那些痛苦的倾诉和麻木的叹息几乎要把他淹没。离开时,老板在他身后含糊地说了句:“少爷,这地方……下次别来了吧,被盯上可不妙咯。”
艾伦没回头。被盯上?我啥时候没被盯着整了。
他沿着原路返回,像一道幽灵溜回依旧灯火通明的宴会厅。音乐悠扬,笑声晏晏,仿佛那堵高墙真的能隔绝一切。维克多看到他,又走了过来,笑容完美:“哦,史密斯,刚才去哪儿了?错过了伯爵珍藏的星光酒。”
艾伦看着他领口那只金光闪闪的、抓着闪电的鹰,忽然觉得那鹰爪不是抓着闪电,而是抓着无数看不见的、来自墙外的镐头、纺锤和病痛。
“去透了透气,”艾伦说,声音平静,“外面的风……很凉快。”
维克多似乎觉得这个回答无趣又合理,点了点头,翩然离去。
宴会终于散场。艾伦脱下那身借来的礼服,小心叠好,仿佛上面沾着的不仅仅是灰尘和烟酒气。他换上自己粗糙的学院袍,躺在硬板床上。黑暗中,酒馆里那些面孔、那些声音,却更加清晰起来。
他想起了莫言笔下那片土地上人们的坚韧与苦难。原身来到这里,本是为了执行任务,观察,汇报,或许还要破坏。他看到的,是一个内部正在溃烂的巨物。破坏它?它自身的重量就快把它压垮了。拯救它?他一个异乡人,一个替身,凭什么?又怎么救?
可是,那些酒馆里的眼睛,那些在魔法工业齿轮下被碾轧的生命……仅仅做一个“观察者”?就像你看见有人陷在泥潭里,慢慢下沉,你可以记录他下沉的速度和姿势,写一份漂亮的报告;也可以,试着扔一根绳子过去,哪怕只是一根草绳。
艾伦在黑暗中睁着眼。他知道自己力量微薄,身份尴尬,前路迷茫。但有些东西,看见了,就再也无法假装没看见。有些声音,听到了,就再也无法从脑子里赶出去。
[上一章](https://www.paddysun.top/archives/4770) [下一章](https://www.paddysun.top/archives/4784)
[【曙光大陆】全书目录](https://www.paddysun.top/archives/4516)
> 本文采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en)
====
# 【曙光大陆】003 上课睡觉就是香
https://www.paddysun.top/archives/4770 · 2025-12-06
[【曙光大陆】全书目录](https://www.paddysun.top/?p=4516)(连载中)
艾视线越过帝国魔法与军事学院的大门(这玩意到哪都一样)。在艾伦眼里——哥特式的尖顶和飞扶壁,硬邦邦地戳向灰蒙蒙的天,可屋顶上偏又装着几架铁皮风轮,被风吹得吱呀呀乱转。屋檐下盘着黑黢黢的蒸汽管道,烟囱里喷出的白烟略略带着股呛人的硫磺味儿,混着旧石头上的青苔气,钻进鼻孔里,成了种说不清道不明的混沌。这感觉,活像在太和殿的龙椅下头砌了个烧煤的锅炉,热是热了,可那祖宗传下来的阴凉气儿,全给搅和成了黏糊糊的雾。
因为在旅馆里躲了几天没敢出来,艾伦没赶上大批新生报道的热闹。现在只有他一个人站在这校门口。
门卫是个独眼老兵,脸上横着一道蜈蚣似的疤,直钻进那只空瘪的眼窝里去。他胸前挂着一枚鸡蛋大的勋章,磨得锃亮,艾伦自然认不出是哪个年月的功绩。他用剩下那只浑浊的眼珠子,上上下下把艾伦剐了三遍,喉咙里滚出一声黏痰般的闷响:“进去吧,小子。别惹事。”
艾伦心里嘀咕,我倒是想惹点事儿,可眼下连这地方的茅坑朝南朝北都摸不清,能惹个屁的事。他想到能够往坑里扔钠块儿的传奇学长了。
---
头几天的课,说是要把大家拉到一条起跑线上,教“魔法基础”。
学院发的《魔法的微笑》,纸是糙黄的,金属的封面上印着些弯弯绕绕的花纹,说是魔法分三大类:元素、炼金、召唤。艾伦用他那“啥字儿都认得”的古怪本事一琢磨,心里就透亮了。
元素魔法——火、水、风、土。说得玄乎,不就是把这儿的热挪到那儿,把水捏成冰,把风拧成刀子?跟空调、冰箱、风扇一个理儿,无非是这里不使电,嘴里念念有词,手上比比划划,就获得了驱动的能量罢了。他习惯性的把最关键的部分略去了。
炼金术——更直白了,就是把分子原子什么的重新组合一下。用他们这套东西把铅变金子?理论上还真行,可你得往里填进去多少力气?好比你想把一筐烂地瓜变成白面馍,光对着锅台念咒顶屁用。想到那些炼金术士,守着咕嘟冒泡的坩埚和亮晶晶的玻璃管子,脸上挂着敬神似的庄重,抽卡一样的希望发现一个化学反应的式子。在艾伦看来,就像是用猜来解微积,汗流浃背,累得吐白沫,也是白费功夫。
召唤术——最是云山雾罩。按书上说,是和“别处”的东西搭上线,借它的劲儿。艾伦躺在硬板床上想了一宿,这宿舍倒是单间,要不是想召唤个魅魔什么的他也不会想这么久。结果呢是觉得这大概跟做梦差不多,梦里你见着个披头散发的美女,要么吓得尿炕要么就抱回屋里。那怪物未必就在你被窝里,可那泡尿却是实实在在的。
上午是理论,下午是实操。
理论课的老教授,胡子白得像隆冬的雪,说话倒快得紧。讲“魔力导流七准则”,唾沫星子能喷到最后一排;讲魔法生物,什么龙啊之类的,反而没什么激情,也不站着了,就拿手指在空中划着圈,仿佛真能牵出根看不见的线。底下的人,脑袋一点一点,像秋风中蔫了的高粱穗子。艾伦也困,可他困得清醒——他发现那些弯弯绕绕的咒语和手势,被他心里那套从另一个世界带来的“数理把戏”一框,全成了直溜溜的公式。教授在黑板上画了个鬼画符似的魔法阵,艾伦在草纸上画了坐标系,列了函数,结果竟对上了。他咧了咧嘴,觉得这世上的道理,扒了皮,拆了骨,原来都差不多。
实践课就更有乐子了。教官是个板着脸的汉子,深蓝军服扣到下巴,肩章上的银线都磨毛了边。他在训练场上踱步,皮靴砸在石板上的声音,又硬又冷,像在敲一副老棺材板。“咒语,手势,精神,三位一体!”他的声音像砂轮磨铁,“我们伟大的帝国在七百年验证过的路径,自然是最为妥帖和实用的。任何试图另辟蹊径的举动,恕我直言,都堪称对新辉和传统的严重亵渎。”
学生们对着草扎的假人,憋足了劲儿放“火焰箭”🔥。艾伦旁边那个细皮嫩肉的贵族小子,脸憋成了猪肝色,咒语念了五遍,魔杖尖儿才“噗”地冒了股青烟,还不如灶膛里爆个火星子亮堂。
轮到艾伦,他没念书上的咒。他想着:火嘛,就是热乎气儿聚成一团,给它个往前窜的劲儿,再给他个对抗地球吸引力的气儿。别让它半道散了架。这跟往灶膛里吹风、让火烧旺点有啥区别?他就在心里头,把这“热乎气儿”当成个有鼻子有眼的玩意儿,给它分派方向:往前去多少,往上顶多少,怎么让它不歪……魔杖随手一挥——
“嗖!”
一道橘红的光,又直又狠,凿在假人胸口,烧出个黑窟窿,边缘还滋滋冒着烟。
教官的脚步停了。他慢慢转过身,眯着眼看艾伦,那眼神像在估量一头牲口的牙口。“阁下,”他喉结动了动,“念的是什么咒语?”
艾伦老实巴交地说:“没念,就……想了想。”
教官没再说话,只是那高昂的下巴,抬得更高了些。
下课了,人都走光了,艾伦被留了下来。
教官的办公室在塔楼顶,大,却空得能跑马。一张厚实的橡木桌子,一把高背椅,墙上挂着一张颜色褪得发白的帝国地图,边角都卷了起来。没有书,没有茶壶,连点人味儿都没有,像个临时搭起来的戏台子。
“坐。”教官自己先陷进高背椅里,手指头“嗒、嗒、嗒”地敲着桌面。西晒的光从高窗斜劈进来,把他那张脸切成两半,一半在明晃晃的光里,硬得像铁;一半埋在浓墨似的影子里,看不清虚实。
“阁下的方法好像甚是奇妙”他开口,“可否再演示一次。”
艾伦照做了。这次他有意放慢了心里头那套“力的合成与分解”的把戏,让那道橘红色初时还是和烈烈的雷一样快和锰,但教官嘴唇动了动,就变得慢悠悠,直到悬在半空,才看得起是个火球,然后就消散掉了。
那张坚毅的脸盯着光散开后空中那点微微扭曲的波纹,看了很久。屋里只剩下他用羽毛笔敲桌子的声音,一声,又一声,敲得人心头发紧。
老半天才出声,“阁下……确实有点意思。”他终于说,可脸上没半点“有意思”的表情,“然而我必须提醒阁下,训练场域所要求的并非‘趣味性’。这里需要的是规范,是整齐划一,是即便在梦里,那种失去了意识的状态下,也能完美复现的,精确的,标准流程。我希望你能充分清晰的理解这一点。”
“懂,教官。”
“当晨光再度镀亮塔尖,在众人视线所及之处,我期望阁下能遵循既定的传统的典仪。”教官站起身,走到窗边,背对着艾伦,影子拖得老长,“但在‘双弦月低语之夜’与‘银星倒悬之刻’,待熄灯钟鸣后第一根香烛燃尽时,你需来此。进行……私人研习。”(就算在魔法的世界里,也没正常人会这么文绉绉的说周三和周五)
他侧过半边脸,那阴影里的半张脸,显得格外幽深:“我须以最审慎的目光检视,你这套……非正统的技法,是否潜藏着不应有的‘扰动’。既为你的安危计,亦为整个社群的秩序计。此乃谕令。”
艾伦听出来了,他说的是“监视”,不是“检视”。
---
日子一天天过,艾伦渐渐咂摸出这世界的味儿来。魔法和那些铁疙瘩、齿轮、蒸汽管子搅和在一起,生出种怪胎似的热闹。教室里,煤气灯“噗噗”响,灯罩上却刻着的定时“开关”的鬼画符;训练场上,稻草靶子已经被打的草屑纷飞,管这玩意儿立起来还是躺倒的玩意儿的却是个咕噜转的水晶球,藏在了教官的军服里;图书馆倒是大的不行,指调高高,取个高点儿的书得坐那升降的笼子,靠齿轮链条拽着上下,关键地方却嵌着几块亮晶晶的魔石,说是能防着掉下来。最开眼的是“魔导工学”那屋,里头摆的物件,能让人以为进了阎王殿的刑房——有靠鬼画符代替算盘珠子的“铁算盘”,有用水晶嗡嗡响传信的“话匣子”,还有台半拉子“魔导车”,前头是黑乎乎的蒸汽锅炉,邪乎的魔法让他变小了好几号,也不知道热效率能不能超过50%(狗头),刻在车梁上金闪闪的法阵图,说是能让车跑起来不颠屁股。
管这屋的是个秃头壮汉,眼镜片厚得像酒瓶底。他倒是不怎么爱说话,架不住艾伦看着这车架子熟悉啊,时不时就过来瞅两眼,搭把手。一来二去秃头也就渐渐放开了聊了些东西。
艾伦心想,这话熟,跟他老家墙上刷的“科学种田,亩产万斤”的大横幅,一个调调。他拿起一块刻满符文的铁板看了看,那些曲里拐弯的“上古神文”,在他眼里就是些走了岔道的电路图。要是换成印刷的法子,快得很。可他没吭声。他现在是个“有点灵气但得走正道”的新生,不是来砸人饭碗的。
他那“穿越带来的便宜”越来越藏不住。教科书上那些“神恩浩荡”“血脉呼唤”“心诚则灵”的屁话,他一个字也咽不下去。可一把这些玩意儿套上“能量守恒”“流体力学”“量子纠缠”的壳子,立刻就顺溜了。
“元素亲和测试”那天,学生们轮流摸几个颜色各异的玻璃球。轮到艾伦,他先摸红的(火),心里想着烧炕的热乎劲儿,那玻璃球“嗡”一下,亮得像个烧红的烙铁;摸蓝的(水),想着河里冰茬子化开的样子,球便泛起柔柔的蓝光;摸青的(风),想着屋檐下穿堂风的呜咽,球自个儿转了起来;摸黄的(土),想着夯土墙的结实,球面上竟浮出龟背似的纹路。
记录官的手直哆嗦:“全……全元素……强度还……这不合乎法理……”
艾伦低下头,盯着自己那双沾了灰的鞋面:“许是……玻璃球晒久了,有点上火?”
他心里明镜似的:这不是“亲和”,是“明白”。就像你会使唤驴拉磨,不是你和驴亲,是你懂驴脾气。
---
明白归明白,课上该睡还得睡。这天的“帝国史”,讲课的是个干瘦老太太,声音像风吹破窗户纸。她讲“晨曦皇室的神圣血脉”,讲得嘴角冒白沫,仿佛那血脉真能淌出金子来;讲“灰袍法师团的黄昏”,枯瘦的手臂在空中挥舞,像在指挥一场无声的葬礼。底下的人,睡得口水直流。
艾伦也撑不住了。昨晚他偷摸着研究从床板暗格里翻出来的旧笔记,用他那本事读着原主那人留下的、蚂蚁爬似的密文,熬到后半夜。现在眼皮上像压了两扇磨盘。
他强睁着眼,盯着老太太一开一合的嘴,脑子里却自个儿转了起来:
“皇室被供在神龛里”——泥菩萨需要金身,金身需要香火。
“灰袍子们捏着高阶法术”——手艺成了门槛,门槛成了高墙。
“魔法血脉论”——龙生龙,凤生凤,老鼠的儿子会打洞,换了个说法罢了。
他脑袋开始一点一点,眼前的景象糊成了一片。老太太变成了两个,黑板上的字像蛆一样扭动。他梦见回到了高中课堂,数学老师一只手扶着腰,一只手拍着桌子吼:“孙仁!上来讲讲!”
他一个激灵,醒了。发现满屋子人都瞅着他。历史教授站在讲台上,细长的教鞭悬在半空,正指着他鼻尖:“这位同学,你来说说,兽人的作战特点是什么?”
艾伦站起来,魂儿像按了冲水键的马桶里的纸。他哪儿知道什么兽人打仗。
可就在这当口,他忽然想起昨晚在笔记密文里破译出的一段话,像是关于“混成小队”的记载。他咽了口唾沫,试探着说:
“呃……采用小股精锐部队,结合魔法掩护和利用四条腿的优势机动突袭,针对敌方后勤线和指挥节点进行打击?”
教室里静得能听见灰尘落地的声音。
老太太推了推眼镜,慢慢点了下头:“回答基本正确。“
艾伦坐下,后背的冷汗把粗布衣服都洇湿了。他娘的,这身子的前主,到底在脑子里埋了多少要命的玩意儿?
下课铃像救命的唢呐一样响了。艾伦抱着砖头厚的课本往回走,路过布告栏,看见新贴了一张黄纸,墨迹还没干透:
磨磨唧唧半天,就底下一行蚂蚁似的小子有用:“全体新生,即日起开展军事基础训练。理论课程暂停。”
艾伦盯着那行字,忽然“嘿”地笑出了声。
原来甭管在哪个旮旯,甭管学的是念咒还是算数,该挨的捶,一顿也躲不掉。这个慢火炖肉的过程,早些年你觉得自个儿是块硬骨头,炖着炖着,也就酥了,烂了,没形了。
年轻人总觉得山都能搬走,后来才明白,山不动,是人被锤扁了,你说动就是动的。
艾伦挺想去学院外头瞅瞅,看看是不是真有尖耳朵的精灵姑娘。可奇怪的是,他心里并不特别憋闷。
也许是因为,在这光怪陆离的地界,他好歹摸到了一点门道,当了一回“好学生”——哪怕这门道,是用向量解咒语,用种地看天时的眼光看历史,用烧火棍捅灶膛的劲儿使魔法。
他抬起头。学院的钟楼“当当”地敲响了,声音闷闷的,混在齿轮转动的嘎吱声里,像这个世界的底色,混沌,嘈杂,却又自成一套歪理。
艾伦深深吸了口气。那空气里,煤烟子味、雨后臭氧的腥味、还有旧羊皮纸的霉味,一股脑涌进来,呛得他有点想咳嗽,却又觉得莫名踏实。
得,他想,来都来了,倒要看看这出荒诞戏,还能唱出什么更邪性的桥段。
眼下最要紧的,是先在那劳什子军事训练里,把胳膊腿儿全须全尾地保住。还有,床板底下那本要命的笔记,里头到底还埋着多少前主留下的、能炸死人的秘密?
他转过身,朝着宿舍那排低矮的砖房走去。脚步踩在碎石路上,沙沙地响,比来时,似乎轻快了一丁点儿。
[上一章](https://www.paddysun.top/archives/4522) [下一章](https://www.paddysun.top/archives/4808)
[【曙光大陆】全书目录](https://www.paddysun.top/archives/4516)
====
# 写给墙外的人:失恋,是另一种“服刑”
https://www.paddysun.top/archives/4755 · 2025-12-05
这几天,[我定制了一批明信片](https://www.paddysun.top/archives/4658)。熟悉我的人都知道我这人性子急,纸才打印出来,热乎劲儿还没过去,没想好寄给谁,就开始盘算着怎么寄出去了。
以前我在英国、海南都曾寄明信片给国内的朋友,但好像一张也没能抵达对方手里。那种石沉大海的感觉,让我开始好奇:一封信,究竟如何才能真正抵达?
于是我去网上搜了搜“寄信”。出乎意料地,我闯入了一个特殊群体的世界——**监狱服刑人员的家属**。对他们而言,与墙内挚爱的唯一联系,似乎只剩下寄信和聘请律师这两条狭窄的通道。
我读着那些“写信注意事项”:如何在信封上写下对管教警官的感谢,如何在字里行间既倾诉思念,又需要让检查信件的人感到被尊重与愉悦,从而让你的信更快、更顺利地抵达。
这种感觉很难形容。直到我猛然想起最近[一位失恋的朋友](https://www.paddysun.top/archives/4709)。
那位朋友许久没有联系了,深夜发来消息,说遇到了“无法解决的人生问题”。我苦笑着回:“我也遇到了,因为附近共享充电宝都还满了。”
但听完Ta的故事。我忽然发现,**失恋的人,与高墙外等待的家属,共享着同一种“服刑”的状态。**
---
家属等待的,是经过审查、可能被退回、或杳无音讯的回信。每一个寄出的字,都像投入深海的漂流瓶,不知能否激起回响。
失恋的人等待的,是一封来自过去的“解释”,一个来自对方的“回心转意”,或哪怕只是一句诚恳的“对不起”。你编辑了无数条微信,又逐字删除,因为你清楚,那个收信的人,已经单方面关闭了收件箱。**我们都在“等待一封信”,而那封信可能永远无法抵达**。**我们都被困在“单方面通讯”的孤岛里。**
家属们学习在信里写:“里面管理很文明,管教很好,我很好,你放心。”——这些话,是写给检查者看的,也是为了保护墙内的人,更是为了骗过自己,维系那根脆弱的线。
失恋的人也在学习新话术。对朋友说:“我没事,我很好。”对家人说:“早就过去了。”在深夜的社交媒体上,发一首语焉不明的歌,几张看似明媚的风景照——这些,都是经过精心“审查”后,才允许发布的“安全内容”。真正的崩溃,只敢留给凌晨三点的天花板。
**我们都在用公开的“我很好”,来寄送私密的“救救我”。**
家属的思念,需要经过警官的检查与传递。你的爱和牵挂,被置于一个系统的、冷漠的流程之中。
而失恋者的思念呢?它需要依赖曾经美好的回忆来传递——那家一起吃饭的餐厅、那首一起听过的歌、甚至同一款洗衣液的味道。这些没有生命的“第三方”,成了刺向你内心的信使,每一次投递,都带来一阵熟悉的绞痛。所以**我们的思念,都依赖一个“第三方”来传递。**
但是**我们最私密的情感,都失去了直接投递的资格。**
正如那些指南里说的:“人在最低谷时,心理感受会特别敏感。雪中送炭,远胜于锦上添花。” 对墙内的人,一封信,每个月墙外的定时汇款,都在传递着这个世界上还有人关心你的信息。
对失恋中的人,同样如此。你不需要朋友滔滔不绝地分析利弊,不需要朋友积极地介绍新对象。Ta可能只需要你安静地陪在身边,像递上一个无声的“馒头”:一句“我在这里”,一张纸巾,或一次允许Ta崩溃的包容。**我们最需要的,其实都不是“锦上添花”**。而是稳定且坚定的陪伴,帮助我们战胜孤单。
---
我看到了那些家属在信封上写下的、给管教警官的话:
**“辛苦管教帮检查信件,祝您工作愉快。”**
**“谢谢你们,让我的思念,有处安放。”**
读到这里,我很难说出是什么滋味。
我想对我的朋友,以及所有正在情感中“服刑”的人说:
也许,我们也该学会在生活的信封上,写下这样一句话——不是写给那个已经离场的人,而是写给我们自己,写给时间,写给命运这个严苛的“管教”:
**“辛苦你了,帮我检查这段过往。祝我自己,早日‘出狱’,找到自己的那片海。”**
**“谢谢时间,让我的思念,终于有处安放。”**
然后,像一位最忠诚的邮差,把这份经过泪水的审查、被成长盖章的信,稳稳地,投递给未来的自己。
**刑期或有长短,但爱过本身,不是罪过。而等待信来的每一天,都是我们在为自己的心,争取减刑。**
> 本文采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en)
====
# 失恋的人——不可机洗,忌熨烫
https://www.paddysun.top/archives/4709 · 2025-12-03
三年前,分手那阵子,我在飞机上读完《让我独自一人》。三万英尺高空,窗外云层翻滚如棉絮,机舱里人人裹着毯子昏睡,只有我捏着这本薄薄的小册子,心里翻腾着另一种风暴。那时我想:玛塞勒·索瓦若这女人真够可以的——躺在肺结核疗养院里,咳着血,被男人一封信通知分手,居然没哭天喊地,反而提起笔,写了四封不打算寄出的信。她管这叫“评注”,像解剖一只死去的蝴蝶那样,一片片拆解爱情腐烂的翅膀。我一边读一边嫉妒她那所谓的“前夫哥”:能被这样的灵魂爱过,哪怕最后遭她冷眼审视,也是种幸运吧?转念又笑自己荒唐,果然,男的大多不是什么好东西——这话可能偏激,但,宁可外耗别人也别内耗自己。
三年后,朋友的故事让我又翻出这本书。纸页已经泛黄(想象,读的是电子书),扉页上还留着当时随手划的线:“**让我独自一人**——不是赌气的宣言,是重新学会呼吸的姿势。”如今再读,忽然觉得索瓦若最狠的地方不在决绝,而在那种近乎残酷的诚实:她不允许爱情沦为一场自我感动的话剧。疼痛是真的,但不必演给谁看。
——是为记,也为你我,为所有在爱里摔碎又默默把自己拼起来的人。
---
我朋友的故事,很像索瓦若那本书里漏掉的一章。不过索瓦若写的是“让我独自一人”,她写的倒像是“让我独自一人,但先容我再哭两场”。这没什么不好,人有时候就得把心里那点东西抖落干净了,像抖一件穿久了的毛衣,总有些看不见的线头要掉出来。
她说失恋后睡不着,心脏在夜里跳得像打鼓。我想到索瓦若在疗养院咳嗽,听着自己的呼吸,知道有些东西正从身体里流走。不过她更年轻些,是在XX的夜里数心跳,数着数着就哭了。她说那种痛不重,但硌人,像毛衣领子里的商标。这比喻真不赖,王小波大概会喜欢——痛感成了件有商标的衣物,提醒你这东西哪儿产的,什么材质,洗标上写着“不可机洗,宜手洗,忌熨烫”。爱情可不就是这样么,穿的时候舒服,脱下来才发现扎人。
她喝酒,喝到烂醉,却没去找“前夫哥”。她说这是进步。我想起索瓦若那句:“如果您爱我,我将痊愈。”但这里反过来——因为我不再求您爱我,所以我得自己痊愈,哪怕痊愈的过程像在伤口上撒盐,撒的还是粗盐粒。她半夜注册新号去诉说,像在空房间里给自己写信,信纸是黑的,字是透明的,只有她知道写了什么。
最有趣的是朋友想象的”前夫哥“的视角:他收到好友申请,知道是她,却不想通过。他觉得她“做事一套一套的,老把自己包装成受害者的样子”。这让我想起索瓦若书里另一段:“他爱这个女人,是因为她勇敢、独立、见解独到;但如果他想娶她……就会将勇气看作叛逆,将独立看作高傲和坏脾气。”我当时就是因为接受不了”前夫姐“比我优秀和上进而选择的分手。
但在朋友在这里反了过来:”前夫哥“爱这个女人,因为他可爱,依靠他;但当时间一长就变成了幼稚,烦人和厌倦了。诶,男人没一个好东西。
你看,同一个人的特质,在爱里是宝石,不爱了就成砂砾。男生觉得她“幼稚”“虚伪”,可这虚伪里有多少是他当初说“可爱”的部分呢?人就是这么回事,自己泼出去的水,回头嫌地上湿。
她说昆明太小,走两步都是回忆。这倒像某种物理学现象——城市在失恋后会发生空间坍缩,所有街道都弯向同一个点。她在那个点上站了很久,站成个路标,上面写着“此处曾有人爱过,现在只剩风”。
她最后写:“如果可以,我想让你再好好了解我,而不是义无反顾地放弃我。”这话说得恳切,近乎哀求。但索瓦若早就看明白了——当一个人决定放弃你时,他放弃的不仅仅是“你”,还有“了解你”这桩事本身。了解需要时间,而他已经没那个耐心了,就像读一本书读到一半,发现不是自己喜欢的类型,就合上了,连书签都懒得留。
她问我该怎么办。我的经历告诉我:“这就像走在一条漆黑的巷子里,你不知道前面有没有出口,只能摸着墙走。墙是湿的,有青苔,你可能会滑倒,但你不能停,因为停下就更黑了。”但我没这样回复她。索瓦若的回答更适合她吧:“让我独自一人。”不是赌气,是说:好吧,既然只剩我一人,那我就一人走下去,走到哪天算哪天。
朋友还在哭,哭完了发消息说“我怎么又哭”。这让我想起索瓦若那句:“您似乎是想杀死您心目中的我……看到自己就这样被毁灭,我只能哭泣。”但有趣的是,她一边哭,一边记得“我进步了”。进步是什么呢?大概是今天比昨天少想他五分钟,或者忍住了一次手贱没点发送键。这种进步微小得像灰尘,但积多了,也能在阳光下看见漂浮的轨迹。
最后她说:“如果爱靠嘴说,哑巴该怎么办。”这话漂亮很漂亮。索瓦若整本书都在做这件事——用文字说那些说不出的话,给哑巴的爱情找条出路。我朋友也在找她的出路,在昆明的夜里,在酒后的眩晕里,在一次次点开又关掉的对话框里。这条路不好走,但她在走,这就够了。
毕竟,如索瓦若所写:“人类终将孤独的结论并不妨碍我们用尽一切气力找寻不孤独的可能,哪怕只是暂时的。”她还在找,这就是全部的故事了。
> 本文采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en)
====
# 数据驱动选题:个博如何快速增长浏览量
https://www.paddysun.top/archives/4702 · 2025-12-03
## 先说结论:两周内,我的博客从零到日访近百,方法是做对五件事
如果你只想看速成指南,以下是核心要点:
1. **加入所有博客聚合平台**:特别是榜单类的博客,保持自己出现在头部。才有充分的曝光。这是[列表](https://www.boyouquan.com/similar-sites),顺着加去吧。
2. **保持社群活跃**:多水群,多出现,才方便你在群里发链接。
3. **面向读者选题:**访客多半是隔壁站长,你的选题要思考他们想看什么。主题配置页面美化?还是心灵鸡汤回忆杀?
4. **主动分享**:在社区里和其他内容平台附上(例如知乎)你的链接。一定有人想要点一点。
5. **流量驱动创作:**设置基础数据追踪,教程写了自取。分析从哪来,为什么会来,喜欢看什么,调整创作方向。
好了你可以退出了,博流量很简单,写个UC震惊标题就好(大概吧)。**真正难的是克制自己不去“造屎”**。
## 不要造屎,不要造屎,不要造屎
### 一、开篇:数字会说话,但说的人话不多
我这人有个毛病,看见数字就手痒。教授说“数据不会说谎”,我信了;后来发现,数据确实不说谎,但说出来的话能把人绕进迷宫里。如今自己搞了个博客,挂上几个聚合站,便忍不住要看看那些数字背后藏着什么名堂。
咱知道,这世上最诚实的东西有两样:一是镜子,二是数字。镜子告诉你丑不丑,数字告诉你文章有没有人看**(但不是文章好不好)**。两者都没法让人清醒,但后者更仁慈些——至少没人说你考得不好。
### 二、初来乍到:四个站点与零的博弈
十一月底,我把博客像撒种子似的扔进四个聚合站。Plogfinder像个图书馆,把RSS马上排排站好;开往是个随性的旅人,带着访客在各站间跳来跳去;BlogsClub丰富而克制,排行榜、精选文章一应俱全。
头几天,数据面板上躺着几个零。零是个奇妙的数字,它既代表“什么都没有”,又暗示“可能有什么”。就像冬天光秃秃的树枝,你知道春天要来,但不知道哪天来。
Bing最先给了面子,收录了。点击率15.38%——这数字挺体面,体面得像相亲时对方说“你人挺好”。至于Google和百度,它们大概觉得我这小站还需要再观察观察。
### 三、第一波浪花:来自陌生人的善意
不到一天,自己统计的数据出来了。**8.9%的访客点了“关于我”**——这些人真有意思,来看文章,却先想知道写文章的是个什么人。我忽然想起王小波说的:“人活在世上,就是为了忍受摧残,一直到死。”但访客们不摧残你(但愿不会吧),他们只是好奇,行为我的照骗能骗到人嘿嘿。
**[bf.zzxworld.com](https://bf.zzxworld.com/)带来的访客最多**。这就像你在街上卖唱,第一个往帽子里扔硬币的总是陌生人。陌生人的善意最纯粹,他们不欠你什么,给钱只是因为想给。
BlogsClub的数据更有趣:207个独立访客,100个回访。一半的人来了又走,一半的人走了又来。这比例让我想起爱情——总有人是过客,总有人会回头。
### 四、排行榜上的秘密:时间、社群与选题
之后我每天时不时刷一下BlogsClub的博阅榜,像相面似的。前二十名里,运行时间从两百多天到九千多天都有。时间这东西很公平,它给每个博客同样的二十四小时。
**在Q群里活跃的站长,他们的数据往往好看。**“龙王吐水”的博主们,他们的访问量也像水一样哗哗流。这道理简单:你在人群里说话,总有人会对你感兴趣。
再看内容。科技类文章占了七成江山。大概国内生态如此。但细看下去:
- 工具教程最吃香,比如“MAA配置进阶”浏览量两万三——人人都想省力,这是人性;
- 个人观点也能火,《查理九世》的童年共鸣——人人都需要被理解,这也是人性;
**大众化内容易破圈,小众内容聚铁粉**——就像菜市场卖白菜的比卖松露的多,但买松露的回头客多。
### 五、我的实验:写了两篇“博流量”的文章:
1. **[工具推荐文](https://www.paddysun.top/archives/4680)**,没主动分享,浏览量38。对标的是那些**“所有站长都用得上”**的教程。数据说:实用内容有长尾,但需要时间发酵。
2. **[合规话题文](https://www.paddysun.top/archives/4612)**,分享到Q群,浏览量23。对标的是**“站长关心但非技术”**的内容。数据说:社群分享能启动,但话题得戳中痛点。
又写了两篇“非流量驱动”的:
1. **[影评](https://www.paddysun.top/archives/4562)**,分享给知己好友,浏览量15。对标**大众娱乐内容**。数据说:即使不推广,好内容也能自己走路。
2. **[算法](https://www.paddysun.top/archives/4387)**,分享给知己好友,浏览量7。纯粹**是我喜欢的内容**。“硬核”(自认为)的是真没什么人看啊。
但说实话,用自己的网站发文章给朋友看是真的感觉自己又装到了。
### 六、矛盾的真相:既要数字,又要脸面
我坦白,我看重流量。写作的人谁不希望被看见?但我也怕太功利,有人看又没钱赚,纯纯满足自己可笑的虚荣心。
- **[ElysiumStack](https://www.elysium-stack.cn/)**运行不到一年,月UV七千三。它做对了三件事:技术教程扎实、情感生活坦诚、社群互动积极。这是**平衡的艺术**——既给干货,也给真人。
- **[哈喽!林墨白](https://blog.lmb.blue/)**运行一千二百天,内容杂而有趣。这是**时间的礼物**——你持续做一件事,时间会替你积累信誉。
- **[彬红茶日记](https://note.redcha.cn/)**运行九千天,友链九十四条。这是**连接的价值**——博客不是孤岛,是群岛中的一座。
### 七、最后说点人话
我以内心的阴暗揣摩他人:写博客的人多少都有点暴露癖——把想法摊开来给人看,还暗戳戳希望有人说“写得真好”。我觉得这没什么不好意思的,就像你怎么知道我最近被学生家长表扬了呀?嘿嘿,都是七情六欲的事。
但可能,最好的状态是:**认真统计流量,但不当流量的奴隶;渴望被人看见,但不只为了被看见而写。**
数字告诉我,工具文流量高;但心里告诉我,有些话不吐不快。在这两者之间,我选择——都写。今天写怎么搭服务器,明天写怎么看待生活。云上的服务器搭好了,地上的生活还要继续过嘛。
数据驱动选题,但不驱动灵魂。这就是我的结论,也是我的坚持。**如果你那天发现我在造屎,欢迎来线下真实我,我请你吃饭。**
“一个人只拥有此生此世是不够的,他还应该拥有诗意的世界。”有数据就分析数据,希望有人认可就求求来评论吧,有干活就抖落出来,有别人想看的,也有我自己想说的(只是可能得等等了哈哈)。
## 流量头部站点分析完整数据

> 数据来源:
> 主要访问量和内容比例数据:2025年11月30日统计的 [博阅榜](https://www.blogsclub.org/rank.html) 11月访问排行榜
> 友情链接数:林林杂语 [针对博客网站友链的随机网络研究](https://www.xiaozonglin.cn/blog-friendlink-network-research/)
> QQ群活跃度:来自我对QQ群聊的内容查找
>
> 本文最早发布于 [https://www.paddysun.top/](https://www.paddysun.top/archives/category/worlds-of-if/light-shadow),采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。
====
# 个人站长必备的5类免费流量/浏览量分析工具推荐
https://www.paddysun.top/archives/4680 · 2025-12-02
建站满月那天,无意义的刷着自己的网站,像不知道孩子考试分数的家长。
每天最关心三件事:今天有人来看吗?他们从哪来?看完后是拂袖而去还是多待了会儿?这感觉就像在黑暗里吹口哨——你听见回声,却不知声音撞上了哪面墙。
下面这五类从流量入口到出口,都是我试过后留下的。它们不会让你变成算命先生,但至少能告诉你,黑暗里那堵墙,大概在什么位置。
### 一,搜索引擎健康度监控——搜索引擎可见性检查

**问题**:我的网站在搜索引擎眼里,算是个正经地方吗?
搜索引擎是根据根据爬虫结果来决定是否和如何在搜索结果中展示你的网页。也就是要主动去问一问,看一看其爬没爬到,爬到了什么。但是要等他们反馈问题大改要等待约一周的时间。耐心一点。
**工具**:
1. **[Bing Webmaster Tools](https://www.bing.com/webmasters/about)**:这位门房和气些。我的小站提交第四天,它就收录了,大概十天后发现了问题:没有高质量的入站链接。
2. **[Google Search Console](https://search.google.com/search-console/performance/)**:目前没有收录,在我优化SEO,更改sitemap.xml的3天后其就发现了问题并给我发来了邮件指出存在:字段“id”中的网址无效(在“itemListElement.item”中)的问题。
3. **[百度站长平台](https://ziyuan.baidu.com/)**:他没给我任何收录和反馈,现在看我的眼神还像看空气。但因为其在国内的地位还是放上来了。
或者可以通过搜索引擎使用如下关键词搜索,从普通用户的角度来看看收录情况。
```
site:paddysun.top #替换为你的域名
```
### 第二类:全局流量概览与来源分析——来源与偏好分析
**问题**:那些稀稀拉拉的访客,究竟是顺着哪条小路摸来的?这就像在雨夜里听脚步声——你得分辨出哪些是路过,哪些是专程来访。
**工具**:
1. **[WP Statistics](https://wp-statistics.com/)**:它界面干净,免费版就能够统计引荐源、入站\出站链接、单页面浏览量、浏览时间等。你可以读出你的读者来自哪里,喜欢哪些内容,那些平台上的推广是有用的。是Wordpress插件,一键安装,我也不知道其他架构能不能用。
2. **[Cloudflare Web Analytics](https://www.cloudflare.com/vi-vn/web-analytics/)**:更轻的备选。它连JavaScript都不用,像在门缝里塞纸条计数,原始但有效。如果你的域名是托管在 Cloudflare 上的且开启了小黄云,那集成 Web Analytics 十分简单。(虽然我没用过)
PS:WP-statistics:后台赫然显示:`[bf.zzxworld.com](https://bf.zzxworld.com/)` 是我最大的推荐来源。数据第一次说了句我能听懂的话:“寻找并发掘这些优质内容的独立个人博客正是 BlogFinder 的价值所在。”
### 第三类:社区与同行参照分析——找到并学习优秀的大佬
**问题**:在这片博客森林里,我站在哪棵树下?
独自写作久了,会患上两种病:要么觉得举世皆醉我独醒,要么觉得满世界就我最无聊。得找个参照物。
**工具**:
1. [**BlogsClub**博阅榜](https://www.blogsclub.org/rank.html):这东西妙极了。它把几百个独立博客排成队列,每天更新UV/RV值。我的小站像条沙丁鱼,挤在榜单中段。看久了发现规律:工具类文章是硬通货,情感随笔是软黄金——前者招来过客,后者留住知音。
2. **[Plogfinder 更新榜单](https://bf.zzxworld.com/s/diligent_list)**:我常在这里看看谁和我一样话痨,吃饱了没事天天发文章。看看别人的更新评论,那感觉自己还算好的了。
ps:本篇文章和 [《 疯狂动物城2 》观后感:一个躺不平者的自洽宣言](https://www.paddysun.top/archives/4562) 都是根据其中高浏览量内容进行的浏量导向形创作。如果想看我分析啥内容更受欢迎请评论区留言,嘿嘿。
### 第四类:单篇文章深度分析

**问题**:读者真的读完了吗?还是在第一段就打着哈欠关掉了?
这是最残忍也最迷人的部分——你要亲眼看看,那些珍贵的访客是如何在你精心布置的文字/页面里转悠的,也通过他们的行为分析你的页面设计合不合理。
**工具**:[**Microsoft Clarity**](https://clarity.microsoft.com/):我强烈推荐这个免费工具。它能录下访客的浏览过程视频,生成页面点击量热力图。第一次看回放时,我像个偷窥狂般紧张。
**ps**,我的首页热力图显示:个人简洁,小说和互联网内容合规内容更受搭建欢迎我盯着屏幕苦笑。原来大家在宗教大法官的诘问前都挺住了,却在我辛辛苦苦写的技术文章面前落荒而逃。
### 第五类:自动化监控与警报——检查运行是否稳定

**问题**:我的网站还活着吗?你肯定不希望你睡觉的时候服务器也去睡觉了。
这事关乎尊严。可以写得内容不好,但不能让人连门都敲不开,就感觉自己好像损失了几个亿。
**工具**:
1. [长亭百川网站监测](https://rivers.chaitin.cn/product/cpv9gt10lne7evnpajs0):免费的第三方SaaS运行状态检测,可以从4国内1新加坡的探针中选一个,只是免费版不支持网站无法访问的提醒,需要登录才能查看。
2. [Uptimerobot](https://uptimerobot.com):也是SaaS的。只是他无法选探针位置(默认国外),但支持邮箱发送警告通知。
**教训**:之前兴冲冲上了CDN,但配置错误,我本地解析到原IP根本没发现,朋友提醒才发现的。感觉在互联网上,沉默超过五秒,就会被判死刑。
### 后记
仅以此文章,纪念本站收到的第一条评论,感谢喜欢。
> 本文最早发布于 [https://www.paddysun.top/](https://www.paddysun.top/archives/category/worlds-of-if/light-shadow),文字部分采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。
====
# 期待彗星来到的日子
https://www.paddysun.top/archives/4658 · 2025-12-01
我这人性子急,一开始教书那阵,看学生一个钟头憋不出三道题,急得想学猴子叫。后来读到一篇怪文章,说人讲话这档子事,效率低得可怜,统共就每秒[39个比特](https://immarcus.com/blog/thirty-nine-bps/)——本站3M🤌宽带的服务器大概是其的8万倍。
> Marcus-《39 bps》
> 高效的沟通,对于社会一定会是利大于弊吗?
> 我们想了解和体验各种不同的人生,但我们真的想变成别人吗?
> 我们想去同理他人的痛苦,但我们会想要复刻他人的痛苦吗?
这就没事了。合着不是学生笨,是咱们人类这套沟通的家伙什儿,本就是老天爷设的限。这让我想起建博客的时候,遇到问题去论坛上问,要等个两三天才有回复。ICP备案审核也是,要等1个来月,我也是急的抓耳挠腮。
我开始逛个人网站以后,时间真的慢了下来。在军爸的文章里看到,[明信片能悠悠走个十年](https://me.xu19.com/received-postcard-10-years-later/),走到收信人都忘了这茬。既然快不起来,那干脆就慢着过。我开始逛那些个人弄的小网站,像举着望远镜在银河里找星星。
你得慢,得耐心,每个个人网站都是一个独立的星球,UI设计是它的躯壳,字里行间是它的灵魂。这感觉真好,窥私癖得到了极大的满足。
看他们怎么用代码写诗,拿镜头腌日子,把生活过成一部舍不得完结的连载小说。我还在[BlogsClub](https://www.blogsclub.org/)上认了一帮“星尘同好”,有个叫[核桃](https://www.htaoo.com/)的天天在群里整活,还有个[ttio](https://ttio.cc/)的绝对是个大闷骚,还有个大暖男[熊大](https://whitebear.im/)。。。。
说到浪漫,我得再提提[“军爸”的明信片](https://me.xu19.com/received-postcard-10-years-later/)。这年头还有人玩这个,就像是有计算器但还是要坚持手算一样。真是一生只够爱一个人的。这话让我心里一紧,我,舔着脸说自己大概也算是适合活在那句话里的人。
我成不了古人,所以也想在自个儿的一亩三分地里,搞点“不合时宜”的仪式。就去定做了套明信片(当甲方也并不快乐,和设计师沟通起来多少有些痛苦)。
设计的灵感来源于昨夜读到[NASA的旧文](https://www.nasa.gov/history/955-years-ago-halleys-comet-and-the-battle-of-hastings/),讲哈雷彗星。这玩意儿每隔七十六年才来人间打个照面,在人类头上撒了满脑子的浪漫与迷信。1066年它来看人打仗,被绣进了挂毯;马克·吐温跟着它来,又跟着它走;1986年,人类派出个探测器,飞过亿万里去瞅它一眼。这种“理性算准了轨道,感性却在上头写满神秘”的劲儿,妙不可言。

左图:11世纪《巴约挂毯》中描绘的黑斯廷斯战役场景,天空中出现一颗彗星。右图:《巴约挂毯》中彗星的特写镜头。图片来源:***Anglo-Saxon Archaeology***。
所以我的明信片,右边要开一扇透明的窗,蚀刻上彗星来的路。你收到后,对着天光一举——瞧,那颗跋涉了千万年的石头,正穿过这张薄薄的纸,朝你飞过来。那一刻,我们的目光就在光年里碰上了。这大概是我这笨脑子,能想出的最浪漫的接头暗号。
然后还做了个现实能查查哈雷彗星飞到了哪的页面。
[Halley 哈雷彗星实时位置与轨迹](https://www.paddysun.top/halley)
那一刻,你和七百六十年前看它的人,和一百年后将要看它的人,用的是同一双眼睛。
我总觉得,所有人的脑子里都有一座无与伦比的宫殿,里头塞满了私密的体验、古怪的念头和发光的记忆。可惜门太窄,每次只能挤出一小缕烟。这大概也是种保护,免得谁的痛苦像瘟疫般传染,或者一句混账标语就让我们集体中邪。沟通的低效,恰是每个灵魂能自个儿蹲在墙角,琢磨点儿与众不同东西的前提。
等到2061年哈雷彗星再来的时候,我该是个老头了。也许眼花,也许背驼,但我想我还会站在阳台上,举起那张早已发黄的明信片,对准夜空。
所以,别着急。有些事快不起来,也不必快。就像等一张迟到的明信片,等一颗彗星的归来,等一个念头慢悠悠地穿过生活的窄门,落地生根。在所有人都拼命把岁月加速成比特流的时候,咱们偏要当几个把日子过成诗的“落后分子”。
这没什么不好。毕竟,按照科学的说法,咱们的时间,还多得很。
> 本文最早发布于 [https://www.paddysun.top/](https://www.paddysun.top/archives/category/worlds-of-if/light-shadow),文字部分采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。
## Paddy的明信片(抄袭 军爸 QaQ)
如果你也希望收到我的明信片,请填写下面的问卷,**然后在本页面留言**(光填问卷我不会收到提醒)。明信片定制还挺贵的没定几张,送完/付不出邮费即止。
====
# 如果生活是泥潭,那就自己做那只飞鸟
https://www.paddysun.top/archives/4621 · 2025-11-30
> 本文回忆了我曾经的至暗时刻
非阅读不可!我最近在重读的《不能承受的生命之轻》,非如此不可。其中“轻重”的隐喻直击我的心灵。
上了大学之后,我便失去了唯一的目标——考上好大学。我逐渐变得,无所适从。
我上大学的目标是什么呢?考上好的研究生?满绩?从第一次旷课,到第一次挂科。没有父母的责备,老师的催促。成绩好像也没什么意义。
或许我应该交一个漂亮的女朋友?但为了恋爱而去恋爱,真的很痛苦。恋爱好像也没什么意义。
在周而复始一天天里,睁眼,上课,打游戏,睡觉。“一切都以我们经历过的的方式再现”,像是陷入了无法逃脱的泥潭。这份周而复始的重复和确定,压得我喘不过气来。
我开始打破这份“确定”,不回寝室,打一整天的游戏;不顾一切,说走就走的旅行。

完全受动物性支配去行动的日子是快乐的。不做计划,不考虑未来,“在虚幻中逃避,摆脱那种毫无快乐可言的生活”,尽情的去感受那种生命中的偶然,那份不确定。毕竟“凡是必然发生的事,凡是期盼得到、每日重复的事,都悄无声息。唯有偶然的巧合才会言说。”
如果说生命之重是周而复始的重复和确定。那么生命之轻,就是“偶然”;是蓦然回首;是多年前埋下的种子,今天恰好我能让我乘凉;是“小鸟儿一齐飞落在阿西西的圣方济各的肩头。”

非如此不可吗?非如此不可。因为我想这么做;人生不就是把“偶然的事件(贝多芬的一首乐曲、车站的一次死亡)变成一个主题,然后记录在生命的乐章中。犹如作曲家谱写奏鸣曲的主旋律,人生的主题也在反复出现、重演、修正、延展。”
我希望读书也是这样的。偶然邂逅一本好书,一段文字。恰好合我口味哦,给我启发,便读下去。非如此不可。
我希望分享也是这样的。不带有什么目的,不必期待他人的回复。仅仅是因为我想说,我便说了。非如此不可。
然而,生命之轻是我们无法承受的。如同我失去了我的爱情;如同我要为我为我之前“自由”的生活方式“买单”。
或许,我们可以尽量的去平衡“轻重”。
“轻”与“重”,“美”与“丑”等等,“就像所有的二元论一样,任何成双成对的东西……他们中的一个总要吃掉另一个,或者两个双双淹没在彼此的毁灭之中。”
本书的主人公,托马斯在对于婚姻的恐惧和女人的渴望中达成了某种妥协——所谓的“性友谊”(王小波的“伟大友谊”)。
我们在面对,生命之轻和生命之重时;不得不去完成的学业和生性渴望的“玩乐”时,又该达成怎样的妥协,或者说应该如何平衡呢?
我的答案是:“白日不到处,青春恰自来。苔花如米小,也学牡丹开。 ”“但知行好事,莫要问前程。”这才是真正的非如此不可。

本文最早发布于 多年前我的读书群,现在已经没人说话了,采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。
====
# 互联网信息服务的合规之路
https://www.paddysun.top/archives/4612 · 2025-11-29
> 和 [blogsclub](https://www.blogsclub.org/) 群友聊起APP备案上架什么的,想起之前整理过相关信息。就刨出来了,又水了一篇文章真好。
> 注意:非专业人士,纯当长长见识,不构成任何建议。
## 境外数据访问
访问GitHub等外网资源时是否使用了合法的信道?
> 《中华人民共和国计算机信息网络国际联网管理暂行规定》 **第六条**:计算机信息网络直接进行国际联网,必须使用邮电部国家公用电信网提供的国际出入口信道。任何单位和个人不得自行建立或者使用其他信道进行国际联网。
>
> **第十四条** 违反本规定第六条、第八条和第十条的规定的,由公安机关责令停止联网,给予警告,可以并处15000元以下的罚款;有违法所得的,没收违法所得。
## 网站备案及许可证取得
面向中国公民可访问的网站必须要完成ICP备案+公安备案,营利性的需要取得ICP许可等其他许可。
非经营性互联网信息服务需要进行ICP备案+公安备案
> **非经营性互联网信息服务备案管理办法**
>
> **第五条**:在中华人民共和国境内提供非经营性互联网信息服务,应当依法履行备案手续。未经备案,不得在中华人民共和国境内从事非经营性互联网信息服务。本办法所称在中华人民共和国境内提供非经营性互联网信息服务,是指在中华人民共和国境内的组织或个人利用通过互联网域名访问的网站或者利用仅能通过互联网IP地址访问的网站,提供非经营性互联网信息服务。
> **计算机信息网络国际联网安全保护管理办法**
>
> **第十二条** 互联单位、接入单位、使用计算机信息网络国际联网的法人和其他组织(包括跨省、自治区、直辖市联网的单位和所属的分支机构),应当自网络正式联通之日起30日内,到所在地的省、自治区、直辖市人民政府公安机关指定的受理机关办理备案手续。
经营性互联网信息服务需要完成公安备案及得到经营许可
> **互联网信息服务管理办法**
>
> 第十九条,未取得经营许可证,擅自从事经营性互联网信息服务,或者超出许可的项目提供服务的,由省、自治区、直辖市电信管理机构责令限期改正,有违法所得的,没收违法所得,处违法所得3 倍以上5 倍以下的罚款;没有违法所得或者违法所得不足5 万元的,处10 万元以上100 万元以下的罚款;情节严重的,责令关闭网站。
> **经营性网站备案登记管理暂行办法**
>
> 取得《ICP许可证》后,向工商行政管理机关申请增加“互联网信息服务” 或“因特网信息服务”的经营范围。
## APP备案
APP也需要完成备案。但APP并非网站,不需要进行网站备案(也叫ICP备案)。
国内服务器供应商、应用商店和提供云服务的手机厂商(比如通知推送服务),不能给没有备案的 APP 提供服务。
此前已经开展业务的app需要在2024年4月前完成备案
未开展业务的app需要先备案后开展业务。
> [光明网](https://baijiahao.baidu.com/s?id=1773811240364275540&wfr=spider&for=pc)
>
> 通知明确,在中华人民共和国境内从事互联网信息服务的APP主办者,应当依照《中华人民共和国反电信网络诈骗法》《互联网信息服务管理办法》(国务院令第292号)等规定履行备案手续,未履行备案手续的,不得从事APP互联网信息服务。
>
> 通知要求,网络接入服务提供者、分发平台、智能终端生产企业不得为未履行备案手续的APP提供网络接入、分发、预置等服务。
>
> 通知提出,网络接入服务提供者、分发平台应对拟从事APP互联网信息服务组织或个人的用户真实身份、网络资源等信息进行查验,不得在明知或应知信息不准确情况下,为其代为履行备案手续。
### 备案流程
需要完成以下两个备案
**移动应用程序信息服务登记**:这是指在工业和信息化部指定的服务机构进行app基本信息和主体信息登记的过程。移动应用程序信息服务登记适用于所有提供互联网信息服务的app。
**移动应用程序内容审查**:这是指在国家新闻出版署指定的服务机构进行app内容分类和分级审查的过程。移动应用程序内容审查适用于提供新闻、出版、教育、医疗等内容服务的app。
**一、app怎么进行移动应用程序信息服务登记?**
移动应用程序信息服务登记是所有app必须进行的第一步备案。那么,如何进行移动应用程序信息服务登记呢?以下是详细的步骤:
**1. 准备材料**
移动应用程序信息服务登记需要准备以下材料:
```
主体资质证明:如果你是个人开发者或者运营者,你需要提供个人身份证复印件;如果你是企业开发者或者运营者,你需要提供企业营业执照复印件。
应用基本信息:包括应用名称、图标、简介、截图、版本号、大小、分类等。
应用功能说明:包括应用主要功能、特色功能、用户群体等。
应用安全保障措施:包括应用是否有安全检测报告、是否有用户协议和隐私政策等。
其他相关材料:根据不同类型的应用,可能还需要提供其他相关材料,例如:提供金融、医疗、教育等服务的应用,需要提供相应的行业许可证或资质证明;提供地图、导航等服务的应用,需要提供地理信息服务许可证或备案证明;提供音乐、视频、游戏等服务的应用,需要提供版权授权或许可证明等。
```
**2. 提交材料**
准备好材料后,你需要在工业和信息化部指定的服务机构提交材料。目前,工业和信息化部指定了以下三家服务机构:
```
中国移动互联网应用安全检测:网址为http://www.msa-alliance.cn/。
中国互联网协会移动互联网应用程序自律公约:网址为http://www.cnnic.cn/。
中国通信标准化协会移动互联网应用程序信息服务登记平台:网址为http://www.ccsa.org.cn/。
```
你可以根据自己的喜好和方便,选择任意一家服务机构进行提交。提交的方式有两种:
**在线提交**:你可以在服务机构的网站上注册账号,填写并上传相关材料,完成在线提交。
**邮寄提交**:你可以将相关材料打印出来,按照服务机构的要求,邮寄到指定的地址,完成邮寄提交。
**3. 等待审核**
提交材料后,你需要等待服务机构的审核。审核的时间根据不同的服务机构和不同的情况而定,一般在5-15个工作日内完成。如果审核通过,你会收到服务机构发出的移动应用程序信息服务登记编号和证书。如果审核不通过,你会收到服务机构发出的退回或补正通知,你需要根据通知要求,重新提交或修改材料。
**4. 完成登记**
收到移动应用程序信息服务登记编号和证书后,你就完成了移动应用程序信息服务登记。你需要将登记编号和证书保存好,并在app中显著位置展示登记编号。这样,你的app就可以正常上架、推广、下载、使用了。
**二、app怎么进行移动应用程序内容审查?**
移动应用程序内容审查是部分app必须进行的第二步备案。那么,如何进行移动应用程序内容审查呢?以下是详细的步骤:
**1. 判断是否需要内容审查**
首先,你要判断你的app是否需要进行内容审查。根据《移动互联网应用程序信息服务管理规定》,以下类型的app需要进行内容审查:
```
新闻类:指提供时政新闻、社会新闻、经济新闻等内容服务的app。
出版类:指提供图书、报刊、音像制品等内容服务的app。
教育类:指提供学前教育、基础教育、高等教育、职业教育、继续教育等内容服务的app。
医疗类:指提供医疗保健、健康管理、疾病预防等内容服务的app。
其他类:指国家新闻出版署认为需要进行内容审查的其他类型的app。
```
如果你的app属于以上类型之一,那么你就需要进行内容审查。如果你不确定你的app是否需要进行内容审查,你可以咨询国家新闻出版署或其指定的服务机构。
## 信息记录
需要保存提供与用户信息60天备查
> 292号令规定,互联网信息服务提供者和互联网接入服务提供者应当记录。互联网信息服务提供者应当记录提供的信息内容及其发布时间、互联网地址或者域名;互联网接入服务提供者应当记录上网用户的上网时间、用户账号、互联网地址或者域名、主叫电话号码等信息。记录应当保存60天。
## **登载违禁内容**
只要从事互联网信息服务,在信息内容上都不得有下列这九种情况:
> (一)反对宪法所确定的基本原则的; (二)危害国家安全,泄露国家秘密,颠覆国家政权,破坏国家统一的; (三)损害国家荣誉和利益的; (四)煽动民族仇恨、民族歧视,破坏民族团结的; (五)破坏国家宗教政策,宣扬邪教和封建迷信的; (六)散布谣言,扰乱社会秩序,破坏社会稳定的; (七)散布淫秽、色情、赌博、暴力、凶杀、恐怖或者教唆犯罪的; (八)侮辱或者诽谤他人,侵害他人合法权益的; (九)含有法律、行政法规禁止的其他内容的。
## 数据出境
数据跨境传输如符合条件需要完成**《数据出境安全评估》**
[详细信息](https://www.163.com/dy/article/HC0P2TQ70519PQRV.html)

## AIGC相关问题
使用境外数据/模型需要注意以上法律问题。
并且算法需要通过算法备案与深度合成安全评估
> **《互联网信息服务算法推荐管理规定》**[算法备案](https://mp.weixin.qq.com/s?__biz=MzU3MzA5ODU0MA==&mid=2247485279&idx=4&sn=5ae30ea02c6e34b097f01fee2257308d&scene=21#wechat_redirect)
>
> 第24条规定,需要备案的主体是”具有舆论属性或者社会动员能力的算法推荐服务提供者”,备案义务主体限定在算法服务提供者,排除了算法研发者、设计者和算法最终使用者(用户) 。其次,备案义务主体须具有舆论属性或者社会动员能力。
>
> 
>
> 还可能涉及《算法推荐管理规定》《深度合成管理规定》中的备案的要求和安全评估的要求。
[更多信息](https://it.sohu.com/a/705037529_121123759)
## 部分行业需要资质
例如教育、金融、新闻、文化娱乐等?是否取得了相应的行业资质?没的话,一样违法。
====
# docker + WordPress 加固部署方案(雷池 WAF)
https://www.paddysun.top/archives/4570 · 2025-11-29
> 虽然WordPress部署教程有很多,本篇部署方案的重点在于在单个服务器上,docker 部署,使用**长亭Safeline 雷池 Web应用防火墙**( WAF )进行代替常用的Nginx 保证 WordPress 安全。适合使用单服务器的个人博客网站,建议配置至少2h4g。
入手了自己的云服务器,总不能闲着不用叭,用其来部署一个个人博客站,记录成长、分享生活是一个好的选择。博客框架有很多,我想更多的专注于内容创作(主要是菜,所以选择了老牌成熟的 **WordPress** 。
然而,WordPress的巨大市场份额也使其成为黑客与自动化攻击脚本的重点关注对象。因此,**如何为其筑起坚固的防线保证 WordPress 安全?**(其实是我喜欢瞎折腾啦
通过Docker容器化技术,我们将构建一个由Safeline WAF作为安全网关,内部集成MariaDB数据库与Redis缓存的高效、安全的WordPress站点。
实际部署成果:[https://www.paddysun.top/](https://www.paddysun.top/) 欢迎来我的个人博客玩呀
## **核心组件简介**
1. **WordPress**
1. **是什么**:一款全球最流行的开源内容管理系统(CMS),以其强大的功能、灵活的可扩展性(海量主题与插件)和友好的用户体验而闻名。无论是个人博客、企业官网还是电商平台,它都能胜任。
2. **在本文中的角色**:我们网站的核心应用,提供内容创作和管理的所有功能。
2. **长亭 Safeline WAF**
1. **是什么**:一款业界领先的、开箱即用的Web应用防火墙产品。它像一位忠诚的卫士,守候在网站的最前沿,对所有外来访问请求进行检测和过滤,能有效防御SQL注入、跨站脚本(XSS)、恶意爬虫等常见的Web攻击。
2. **在本文中的角色**:我们的“安全网关”。所有公网流量都必须先经过它的审查,确认安全无害后,才会被转发给内网的WordPress容器。WordPress本身则不直接暴露在公网上,提升了安全性。
实现 **“既享受WordPress的便捷与强大,又拥有可靠的安全防护”**
## 本部署方案关键优势
1. **单服务器**:虽然长亭官方不建议单服务器部署,奈何钱包空空。成本低
2. **安全防护**:所有流量经过 Safeline WAF 防护
3. **网络隔离**:WordPress 不直接暴露在公网
4. 详细得不行(大概叭:我折腾了1个月,稳定运行1个月的实际部署方案
**这种架构既保证了安全性,又保持了完整功能。**
# 具体部署方案 (个人博客实战检验稳定运行)
### 购买并登云服务器(建议配置至少2h4g)
- 选择 Linux 系统镜像
- 确保云和系统安全组开放端口:80, 443
- 通过 SSH 登录服务器:`ssh ubuntu@your-server-ip`
### 0.服务器准备&docker安装
```
# 更新系统
sudo apt update && sudo apt upgrade -y
# 安装 Docker
sudo apt install docker.io -y
# 安装 Docker Compose
sudo apt install docker-compose-plugin -y
# 验证安装
docker --version
docker compose version
# 确保云防火墙和服务器系统放行80和443端口
```
### 1.safeline docker安装
safeline docker安装教程摘录自官方文档 [长亭官方安装教程](https://help.waf-ce.chaitin.cn/node/01973fc6-e12f-789f-a8ff-e81d383c80bc)
#### 1.1.创建雷池目录
```
mkdir -p "/data/safeline"
```
该命令会创建 `/data/safeline` 目录作为雷池的安装目录(你可以根据你的实际情况选择安装目录)
请确保该目录至少有 5GB 的存储空间(如果日常流量较大,请保证充足的磁盘容量)
#### 1.2.下载 compose 编排脚本
使用下方的命令进入雷池安装目录,并下载 docker compose 编排脚本
```
cd "/data/safeline"
wget "https://waf-ce.chaitin.cn/release/latest/compose.yaml"
```
#### 1.3.配置 compose 环境变量
使用下方的命令进入雷池安装目录,并创建 `.env` 配置文件
```
cd "/data/safeline"
touch ".env"
```
使用文本编辑器打开 `.env` 文件,写入下方的内容,POSTGRES的密码需自定义
具体参数请参考官方文档 [长亭官方安装教程](https://help.waf-ce.chaitin.cn/node/01973fc6-e12f-789f-a8ff-e81d383c80bc)
```
SAFELINE_DIR=/data/safeline
IMAGE_TAG=latest
MGT_PORT=9443
POSTGRES_PASSWORD=yourpassword #(自定义密码使用数字+英文大小写组合,勿使用特殊字符)
SUBNET_PREFIX=172.22.222
IMAGE_PREFIX=swr.cn-east-3.myhuaweicloud.com/chaitin-safeline
ARCH_SUFFIX=
RELEASE=
REGION=
MGT_PROXY=0
```
#### 1.4.启动雷池
现在万事具备,使用以下命令启动雷池服务
```
cd "/data/safeline"
docker compose up -d
```
### 2.Wordpress 安装
> WordPress部署方案参考 [Docker部署Wordpress (Nginx+Mariadb+redis+Wordpress)](https://blog.csdn.net/qq_21876073/article/details/145785504?fromshare=blogdetail&sharetype=blogdetail&sharerId=145785504&sharerefer=PC&sharesource=C_c8S&sharefrom=from_link)
选择合适的目录,创建项目结构
```
# 创建项目目录
mkdir wordpress && cd wordpress
# 创建必要的目录结构
mkdir -p data/mariadb/{conf,logs}
mkdir -p data/redis/{conf,log,data}
mkdir -p data/wordpress/{html,php}
# 设置目录权限
sudo chmod -R 755 data/
```
### 3. 创建配置文件
#### 3.1 修改后的 docker-compose.yml(关键修改)
```
# docker-compose.yml
services:
mariadb:
image: mariadb:10
container_name: mariadb
restart: always
volumes:
- ./data/mariadb/conf:/etc/mysql/conf.d
- ./data/mariadb/logs:/logs
- wordpress-db-data:/var/lib/mysql
environment:
MARIADB_DATABASE: wordpress
MARIADB_USER: ${DB_USER:-wordpress_user}
MARIADB_PASSWORD: ${DB_PASSWORD:-secure_password_123}
MARIADB_ROOT_PASSWORD: ${DB_ROOT_PASSWORD:-very_secure_root_password_123}
TZ: Asia/Shanghai
networks:
- wordpress_network
redis:
image: redis:alpine
container_name: redis
restart: always
volumes:
- ./data/redis/log/redis.log:/etc/redis.log
- ./data/redis/conf/redis.conf:/etc/redis/redis.conf
- ./data/redis/data:/data
networks:
- wordpress_network
wordpress:
depends_on:
- mariadb
- redis
image: wordpress:latest
container_name: wordpress
restart: always
volumes:
- ./data/wordpress/html:/var/www/html
- ./data/wordpress/php/upload.ini:/usr/local/etc/php/conf.d/upload.ini
environment:
WORDPRESS_DB_HOST: mariadb
WORDPRESS_DB_USER: ${DB_USER:-wordpress_user}
WORDPRESS_DB_PASSWORD: ${DB_PASSWORD:-secure_password_123}
WORDPRESS_DB_NAME: wordpress
TZ: Asia/Shanghai
# 重要!:不可以设置 WordPress 站点 URL 和主页地址 要不然之后无法修改
# WORDPRESS_CONFIG_EXTRA: |
# define('WP_HOME', 'https://${DOMAIN}');
# define('WP_SITEURL', 'https://${DOMAIN}');
networks:
- wordpress_network
# 重要:不直接暴露端口到宿主机,只在Docker内网访问
expose:
- "80"
networks:
wordpress_network:
volumes:
wordpress-db-data:
```
#### 3.2 创建环境变量文件
```
# 创建 .env 文件存储敏感信息
cat > .env << EOF
# 数据库配置
DB_USER= #(你的数据库用户名称)
DB_PASSWORD= #(你的安全密码)
DB_ROOT_PASSWORD= #(你的安全密码)
# 域名配置
DOMAIN= #你的域名
SERVER_IP= #你的IP
# WordPress 容器配置
WORDPRESS_PORT=80
WORDPRESS_CONTAINER_NAME=wordpress
EOF
# 保护环境文件权限,若要以非root启动,则暂时不必配置权限
chmod 600 .env
```
#### 3.3 创建 Redis 配置
```
# 下载 Redis 配置文件
wget -O ./data/redis/conf/redis.conf http://download.redis.io/redis-stable/redis.conf
# 修改 Redis 配置
sed -i 's/^bind 127.0.0.1/bind 0.0.0.0/' ./data/redis/conf/redis.conf
sed -i 's/^protected-mode yes/protected-mode no/' ./data/redis/conf/redis.conf
sed -i 's/^daemonize yes/daemonize no/' ./data/redis/conf/redis.conf
echo 'logfile "/etc/redis.log"' >> ./data/redis/conf/redis.conf
echo 'maxmemory 1gb' >> ./data/redis/conf/redis.conf
echo 'maxmemory-policy allkeys-lru' >> ./data/redis/conf/redis.conf
# 创建日志文件
touch ./data/redis/log/redis.log
chmod 666 ./data/redis/log/redis.log
```
#### 3.4 创建 PHP 上传配置
```
# 创建 PHP 配置目录
mkdir -p ./data/wordpress/php/
# 创建 upload.ini 文件
cat > ./data/wordpress/php/upload.ini << EOF
file_uploads = On
memory_limit = 256M
upload_max_filesize = 100M
post_max_size = 100M
max_execution_time = 300
EOF
```
### 4. 启动 WordPress 服务
```
# 启动所有服务
docker compose --env-file .env up -d
# 查看服务状态
docker compose ps
# 查看 WordPress 日志
docker compose logs -f wordpress
```
### 5. 配置 Safeline 反向代理
因为WordPress和safeline处于不同的docker和网络, 现在需要在 Safeline 管理界面添加 WordPress 站点, 这样safeline才能与WordPres通讯.
#### 5.1 获取 WordPress 容器网络IP
```
# 将 WordPress 相关容器连接到 Safeline 网络
sudo docker network connect safeline-ce wordpress
# 查看 safeline-ce 网络中 wordpress 容器的 IP 地址
sudo docker inspect safeline-ce
# 将"Name": "wordpress"块的IP地址记录下来
```
#### 5.2 在 Safeline 中添加站点
1. **登录 Safeline 管理界面**:`https://您的服务器IP:9443`
**添加防护站点**
1. 站点名称:`wordpress或者你喜欢的名称`
2. 上游服务器:WordPress 容器的实际 IP地址
3. 访问域名:`your-domain.com` (没有域名一定要填写 * 才能使用IP访问(建议在开启CDN之后去除 * 避免IP扫描发现原站IP与匹配的站点)
4. 协议:HTTP(如果配置了 HTTPS 证书则选择 HTTPS)
5.
**配置监听端口**:
1. 监听端口:80 和 443(若要开启HTTPS则必须监听443端口)
2. 确保 Safeline 监听的端口在防火墙中开放
#### 5.3 配置 DNS 解析
将您的域名 `your-domain.com` 解析到服务器 IP: `您的服务器IP地址`
### 6. 完成 WordPress 安装
1. 通过 Safeline 访问您的网站:`https://your-domain.com或者公网IP`
2. 按照 WordPress 安装向导完成安装
3. 选择语言、设置站点标题、管理员账号等信息
### 7. WordPress 安全加固
#### 7.1 修改默认设置
```
# WordPress 初始化完成后操作
# 进入2.中选择的Wordpress对应根目录下
cd /你的/目录/地址
# 修改默认数据库表前缀
if [ -f "./data/wordpress/html/wp-config.php" ]; then
sed -i "s/\$table_prefix = 'wp_';/\$table_prefix = 'wp_$(openssl rand -hex 3)_';/" ./data/wordpress/html/wp-config.php
echo "数据库表前缀已修改"
fi
```
#### 7.2 设置文件权限
```
# 设置正确的文件权限
sudo chown -R www-data:www-data ./data/wordpress/html/
sudo find ./data/wordpress/html/ -type d -exec chmod 755 {} \;
sudo find ./data/wordpress/html/ -type f -exec chmod 644 {} \;
```
### 8. 验证配置
#### 8.1 检查 Safeline 防护
访问您的网站,确认:
- 网站正常访问
- Safeline 的防护功能正常工作
- 如果需要强制重定向到HTTPS 重定向正常(如果配置了 SSL),可以在wordpress后台配置站点名URL
```
# 进入WordPress /wp-admin/ 后台-设置-常规命令页面 进行配置
# https://你的网址/wp-admin/options-general.php
WordPress 地址(URL) https://www.paddysun.top/
站点地址(URL) https://www.paddysun.top/
```
#### 8.2 测试 WordPress 功能
测试以下功能确保正常工作:
- 文章发布
- 图片上传
- 插件安装
- 主题切换
### 9. 管理命令
```
# 停止服务
docker compose down
# 重启服务
docker compose restart
# 查看服务状态
docker compose ps
# 查看日志
docker compose logs wordpress
# 备份数据库
docker compose exec mariadb mysqldump -u root -p wordpress > backup.sql
```
### 10.建议(经验之谈
- 对于个人博客不建议开启safeline Bot防护,开启bot防护也记得将RSS等路径排除。否则博客聚合站点和友站bot机器人无法抓取你的最新文章,别人也无法通过RSS订阅你的文章。
- 建议开启CC防护这个没影响。
- 记得定期维护,更新系统、WordPress 核心、主题和插件等。
- 建议部署完成后创建系统镜像。定期备份。
> 本文最早发布于 [https://www.paddysun.top/](https://www.paddysun.top/archives/category/server-ops),采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。投稿至[长亭内容创作者计划](https://help.waf-ce.chaitin.cn/node/01973fc6-e069-73a3-b921-287761946055),希望能够获得雷池专业版授权体验一下 QaQ。
====
# 在线 RSS 订阅器 folo.is 推荐
https://www.paddysun.top/archives/4581 · 2025-11-28
最近看到了很多优秀的个人博客(大佬们收下我的膝盖吧),其大部分都开起了RSS订阅
(本站RSS地址在此[https://www.paddysun.top/feed](https://www.paddysun.top/feed))。
为了不错过大佬们的更新,并且防止自己浏览其收藏夹变得像老奶奶的裹脚布一样长的臭不可闻,所以我选择了[folo.is](https://app.folo.is/)作为我的RSS订阅在线阅读器。其实也没有很认真的选。但他的页面真的很好看,不用下载客户端万岁。
并且可以认领自己站点和看到有哪些人看了你的文章(又要开始卷了嘛)
其认领自己站点的方式是 选择自己的站点-右键-认证订阅源,其中有 发布内容 / 插入描述 / RSS标签 三种认证方式。
以下是其需要发布的内容,我也就乘此机会水一篇文章啦。
```
This message is used to verify that this feed (feedId:216471337671194624) belongs to me (userId:216471154551610368). Join me in enjoying the next generation information browser https://folo.is.
```
====
# 《 疯狂动物城2 》观后感:一个躺不平者的自洽宣言
https://www.paddysun.top/archives/4562 · 2025-11-28
昨晚看了《疯狂动物城2》引发了一场关于自我身份、责任与逃避的深度思考。坐在影厅里,我发现自己既像朱迪又像尼克——一个想躺平却始终躺不平的人。当屏幕上充满生命力的动物世界展开时,我却不得不离开影厅,回复学生家长的消息:“老师,这几题不会”。
这句话像一道无形的墙,瞬间将我拉出那个色彩斑斓的动物城,回到成人的世界,回到我的责任中。我像朱迪一样只是回望了一眼狐尼克,望了望花花绿绿的影屏,就走出了影厅。
**逃避与面对**
曾经有段时间,我整日完全凭借着兴趣行事,逃避责任。感情失利不过是个方便的借口,更深层的原因是我恐惧于那宏大的“媚俗”,那种人人都在追逐,并声称其有意义的叙事。
正如特蕾莎的梦:她被迫与一群裸体女人围着游泳池行走,她们一起唱着歌,但歌词里没有意义。这些爬行动物,就是那些歌词没有意义的女人。他们尽管在拼命的追逐与合群,但在这个过程中,痛苦被忽略,个性被否定。他们承受着生命最卑微的“重”,却在集体的记忆中,轻如尘埃。
然而,选择“躺平“,远离这个年纪应该做的事情,在泳池边看着的代价是什么呢。这势必会慢慢的陷入“湿地市场”。对于狐尼克这样见多识广的老江湖,那里都是一个未知的领域。这意味着,成为边缘群体,和曾经的同学朋友逐渐断了联系。这种“被遗忘”,是比歧视更深的暴力。
为什么说我有朱迪的部分?可能因为多年的教育在我心中埋下了难以根除的功利主义和学生思维——只有利益交换和事事争先才能赢,要做一个“有意义的人”。
我曾经坚定地对朋友说:“要是我老得不能为社会做贡献了,我就去死。”多么天真又可怕的宣言。它将生命的价值完全置于外部评判体系,让灵魂彻底屈服于功利的重压。这是我像朱迪的部分,但这也是我痛苦的根源——让我想躺平却始终躺不平。
**生存的悖论**
《疯狂动物城2》最伟大的隐喻,可能是“气候墙”,它精准地控制着温度与湿度,让不同习性的动物都能能够毗邻而居。这堵墙,是多样性的基石,是动物城的“Es muss sein!”。
然而,这堵墙太重要了,他重要到让我们很难意识到:象征着一切让差异共存成为可能的社会契约、制度设计与环境工程,我们现代社会和《动物城1》中都把这当和空气一般的理所当然。
我们之所以能享受和谐而衣食无忧的生活,正是因为我们依赖于一个庞大、精密且无时无刻不在运作的系统。
那个打断我观影的家长信息——“老师,这几题不会”——就是我生活中的“气候墙”。它是一道命令,一个“非如此不可!”的责任召唤。它将我从电影幻梦的“轻”中,强行拉回现实生活的“重”。这道责任的墙,与电影中的气候墙,形成了奇妙的互文:它们都代表着一种结构性的力量,它既支撑着我的生活,也界定着我的边界。
所以,朱迪和尼克这样两种价值观的角色能够互补,能够有一个中间地带存在吗?
**找到中间的出路**
真的很幸运,我找到了教学这条中间的道路。这里没有太多的蝇营狗苟,小朋友心思单纯,与他们的交流让我感到踏实。虽然代沟逐渐加大,提起他们对数学的兴趣越来越难,但教学这件事本身恰好满足了我内心那无法完全抛弃的优绩主义思维。
在完全躺平和全身心投入社会大机器之间,教学成了我的中间道路。它让我在扛起责任的同时,仍能保有一丝纯粹。
它是我在“完全躺平”的轻,与“投身宏大机器”的重之间,为自己谈判得来的一个平衡。
托马斯与特蕾莎,一个渴望女人之“轻”,一个却是他生命不可承受之“重”‘;朱迪(责任、正义之重),尼克(狡黠、疏离之轻)的结合体中;还有我自己摆烂和卷的两面之间的永恒挣扎。
**两种看电影的方式**
回到《疯狂动物城2》,我注意到自己看电影的方式也发生了变化。找彩蛋、单纯享受童话故事的乐趣,好像没有分析电影背后的政治隐喻、阶级对立、身份认同和政治正确来得“重要”。
我想吐槽这是阅读理解做多了的后遗症,但转念一想,这其实也不错。我们总是带着自己的全部经历和思考方式去理解世界,无论是通过教育者的眼光,还是通过纯观众的心态。
**生活的另一种真实**
从动物城回到现实世界,我不再是那个要么全盘接受、要么彻底逃避的极端者。在躺平与站起之间,我找到了自己的节奏——承担责任,但不被完全吞噬;保持纯真,但不脱离现实。
那条来自学生家长的消息打断了我的观影体验,但这并非一个错误。它只是生活的另一种真实,是我选择的道路上一个自然的节点。
也许,成长就是在责任与纯真之间找到属于自己的平衡点,并接受这种平衡会随着生命阶段不断调整的事实。就像朱迪和尼克,看似对立,实则互补,没有谁比谁高尚。多样的我们共同构成了一个更完整的视角,来看待这个复杂又美丽的世界。
请允许我选择走进我的“湿地市场”,去看见那些被我的世界所忽略的“爬行动物”——或许是学生的困惑,或许是自己的局限。并在那堵无处不在的“气候墙”下,背负着它的重量,做一个清醒的、负责的建造者与修补者。
> 参考: [\[豆瓣\]从种族偏见到集体性遗忘:《疯狂动物城2》的暗线,你可能没看到](https://movie.douban.com/review/17226018/)
>
> 本文最早发布于 [https://www.paddysun.top/](https://www.paddysun.top/archives/category/worlds-of-if/light-shadow),采用 [共享-署名-非商用-相同方式共享 4.0 国际许可协议](https://creativecommons.org/licenses/by-nc-sa/4.0/deed.en) 进行许可。
====
# 我们为何服从法律,我们需要怎样的法律?
https://www.paddysun.top/archives/4546 · 2025-11-27
> 转载自自己的知乎高赞文章(其实并不高,QaQ
*张三这几天因为嫖娼,被罗警官抓了,进警局的时候张三大喊着“你凭什么抓我,我有什么义务来服从法律!”*
*罗警官决定好好教育教育张三,于是罗警官缓缓道来:*
在很久很久以前的原始部落里,人们生活在“孤独,贫穷,肮脏,野蛮且短寿的”状态里,强壮的胖虎拎过瘦弱的大雄一阵胖揍,大雄很委屈说:“为什么?”
胖虎说:“这是爸爸对你的爱呀!”
我们可以想见,在原始社会里,这是很自然的状态,强壮者有很大的机会去打劫与掠夺,人们生活在“一切人反对一切人的战争状态”,然而,强壮者并不会一直强势,他们一旦睡着了也容易受到攻击。
于是这天深夜,大雄和哆啦A 梦拿着骨刀,走进了胖虎的帐篷。

于是,**无论是强壮还是瘦弱的人,都有自发的倾向去达成一个协议,一个契约,这个契约让你放弃攻击他人的权力,并服从保护他人的规则。**当然你需要放弃的可能不止不攻击他人这一项权力,可能还有不偷窃等等,也需要服从其他许多的规则。
自然而然地,为了保证这项规则的有效运行,我们都需要寻求一个酋长,长老,一个[统治者](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E7%BB%9F%E6%B2%BB%E8%80%85&zhida_source=entity),或者是官府,政府,来确保这个契约的运行和有效。
可能因为我们所申诉的权益很多;也可能因为就算是一个强者,也不能保证自己的方方面面都不受损;更可能因为签订契约的人太多,官府,政府很可能成为一个什么都管的,庞大的组织,成为一个巨无霸,成为一个“利维坦” 。
**从自身利益的角度出发,我们确实需要并且渴望法律,法律或者说政府有权利限制我们的权力。**在经典的《[社会契约论](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E7%A4%BE%E4%BC%9A%E5%A5%91%E7%BA%A6%E8%AE%BA&zhida_source=entity)》“创始人”霍布斯看来,没有强力统治者来震慑众人,人们会千方百计地实现自己的利益,不惜使用野蛮手段,以致社会陷入彻底的混乱。很可能由于霍布斯经历过英国内战的恐怖,所以在[霍布斯](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=3&q=%E9%9C%8D%E5%B8%83%E6%96%AF&zhida_source=entity)看来,“即使一个很坏的政府也比野蛮危险的自然状态要好”,如果政府保护你的生命,那么这就是你所能期望的所有权力了。[1]
并且,我们有古话说:“刑不可知,威不可测,则民众畏上也。”如果[刑法](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E5%88%91%E6%B3%95&zhida_source=entity)的使命仅仅只是打击犯罪,保护人们的生命,那么其实没有必要有成文的法律。并且没有成文法律的话,只要是我们认为不正确的,想打击的都是犯罪,这会使得打击犯罪更加灵活,有效,及时和便利。[2]
---
*但张三似乎意识到了其中的不妥和扭曲,他大声抗辩到:“我们虽然需要被限制,被约束,但我们不是宠物,我们人人生而平等,我们若干不可剥夺的权利中不仅有生命权、还有自由权和追求幸福的权利!”*
> “我们认为下面这些真理是不言而喻的:人人生而平等,造物者赋予他们若干不可剥夺的权利,其中包括生命权、[自由权](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=2&q=%E8%87%AA%E7%94%B1%E6%9D%83&zhida_source=entity)和追求幸福的权利。为了保障这些权利,人类才在他们之间建立政府,而政府之正当权力,是经被治理者的同意而产生的。当任何形式的政府对这些目标具破坏作用时,人民便有权力改变或废除它,以建立一个新的政府;其赖以奠基的原则,其组织权力的方式,务使人民认为唯有这样才最可能获得他们的安全和幸福。”——《[独立宣言](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E7%8B%AC%E7%AB%8B%E5%AE%A3%E8%A8%80&zhida_source=entity)》
*罗警官笑了,喝了口水后说到:“是的,完全正确……”*
无疑,**法律必须要保护我们的生命权力,但它同时也必须保障和促进人们的自由,提升我们对于幸福的追求。**
而且自然环境,或者是原始社会似乎也没有想象中那么坏,胖虎有时也会帮助大雄。
我们或许可以认同这样一个观点。从出生起,我们心底都存在着一些普遍的善良的观念,可能是合作的观念,可能是平等的观念。在这些普遍的、基本的美德之上,我们似乎可以构造一个“公意(general will )”,一个普遍认可的社会道德和价值观。
这样的价值观不可能是由人主观设计的,可以说是客观存在的,因此我们会对其心存敬畏[2]。并且这样的“[公意](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=2&q=%E5%85%AC%E6%84%8F&zhida_source=entity)”会受到被统治和统治者的一致认同和敬畏。
而且若没有成文的法律,权力不加以限制,人民会活在恐惧和猜疑之中,所以为了让人们更好地追求幸福,尊重和保障人们自由的权力,被统治者也需要受到这样的契约或者说法律的约束。
并且**法治的基本要义可能就在于用公开的权力去约束权力,让民众有合理的欲求,免于惶惶不可终日的恐惧。**[2]
> “自从有刑法存在,国家代替受害人施行报复时开始,国家就承担双重责任正如国家在采取任何行为时,不仅要为社会利益反对犯罪者,也要保护犯罪人不受被害人的报复。现在刑法同样不只反对犯罪人,也保护犯罪人,它的目的不仅在于设立国家刑罚权力,同时也要限制这一权力,它不只是可罚性的缘由也是它的界限,因此表现出悖论性:刑法不仅要面对犯罪人以保护国家,也要面对国家保护犯罪人,不单面对犯罪人,也要面对[检察官](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E6%A3%80%E5%AF%9F%E5%AE%98&zhida_source=entity)保护市民,成为公民反对司法专横和错误的大宪章。”——《[法学导论](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E6%B3%95%E5%AD%A6%E5%AF%BC%E8%AE%BA&zhida_source=entity)》

由此,可以说,我们有义务去服从在此基础上建立的法律。
这样的**法律以保护我们的生命权力,增进人们的自由,提升我们对于幸福的追求为基本目的。**
这样的法治虽然不能完美无暇,但朝着正义前行,一如客观存在的“圆”是法治永远的追求,虽不能至,心向往之。
对于这样的法律,我们有服从的义务,我们应该**“严格服从,自由批判”**。[2]
---
*张三陷入了沉思,他敏锐地意识到“幸福”这个词语本身就是模糊的,法律应该支持人们追求幸福,但每个人对于幸福的定义千差万别,法律是否有权利去指导人们追求幸福呢,甚至是去限制一些人呢?*
*于是张三继续抗辩道:“我认可为了正义,或者个人的利益,我可能有义务要去服从法律。但如果这个法律和我追求的幸福相冲突了呢?”*
*张三补充道“比如说我嫖娼,我们都是自愿的,符合市场经济规律的,我很寂寞,我需要人陪,我付钱得到了快乐,妓女缺钱,需要钱,妓女付出劳动得到了金钱,我们没有影响到他人,而且我们得到了幸福呀”*
*罗警官笑得更开心了,再喝了口水,问道“幸福有高下之分吗?”*

你可能认为“幸福没有高下之分,口腹之欲和心智之养没有区别”。我们或许可以这样说:听一场音乐会和玩一次过山车是没有什么区别的。甚至如果因为动物有感觉将动物也算入内的话,一个为人生思辨的哲学家也许还不如一头满足的猪幸福。
> “快乐不分多少,图钉跟诗一样好”—— 边沁
然而,任何人都不会否定,某些快乐和幸福是独特的,比如帮助他人的快乐,探索未知的快乐。这些快乐与口腹之欲等单纯的观感带来的快乐是不同的。这些的特别的快乐能使人运用他们的高级官能,带给人们一种骄傲,一种专属于人的尊严感。**这种幸福在给个体带来满足的同时也能带来[社会福祉](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E7%A4%BE%E4%BC%9A%E7%A6%8F%E7%A5%89&zhida_source=entity)的增加。**
> “理智的快乐,感情和想象的快乐以及道德情感的快乐所具有的价值要远高于单纯感官的快乐。”—— 穆勒
我们可能会赞同这样的观点:一只满足的猪比我们更满意于自己的命运。但谁也不愿意真的变成一只猪。也许“**做一个不满足的人胜于做一只满足的猪;做不满足的[苏格拉底](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E8%8B%8F%E6%A0%BC%E6%8B%89%E5%BA%95&zhida_source=entity)胜于做一个满足的傻瓜。**”
> “极少有人会因为可以尽量地享受的快乐而同意变成低等的动物;凡聪明人都不会同意变成傻瓜,凡受过教育的人都不愿意成为无知的人,凡有良心和感情的人,即使相信傻瓜、白痴和流氓比他们更满意于自己的命运,也不愿意变得自私卑鄙。”—— 穆勒
所以,**法律也有权力去指导人们去追求一些高级的幸福**,有权利让你负有赡养父母的责任,减轻你见义勇为的顾虑。有权力限制一些不好的幸福,比如说嫖娼就是一种违背道德,有伤社会风化的行为,虽然可能带来一时的快乐,但会给个人和社会带来许多问题。所以嫖娼是法律所不允许,需要限制的。
更何况,面对一些更大的威胁时,我们个人的幸福和自由显然需要放一放。譬如疫情,譬如外敌入侵。
于是,可以说,法律有权力去指导人们追求幸福,甚至限制和牺牲一些自由。
最后我们总结道,**我们需要的法律以保护我们的生命权力,增进人们的自由,提升我们对于幸福的追求为基本目的,指导、促进我们追求能够体现人的尊严的,能带来社会福祉的增加的幸福。这样的法律是我们需要的,我们也会发自内心的尊崇。**
参考资料:
[1] Bruce N. Waller. Consider Philosophy [M]
[2] 罗翔.圆圈正义[M]
[3] 楚留香.浅析穆勒对[边沁功利主义](https://zhida.zhihu.com/search?content_id=204552988&content_type=Article&match_order=1&q=%E8%BE%B9%E6%B2%81%E5%8A%9F%E5%88%A9%E4%B8%BB%E4%B9%89&zhida_source=entity)的发展[EB/OL].[http://zhuanlan.zhihu.com/p/35244606](http://zhuanlan.zhihu.com/p/35244606)
ps:这更多是我的一些思考,可以说是一篇学习笔记。思考并不深入,存在诸多谬误,请批评指正!
====
# 【曙光大陆】002 这照片上是你吗?
https://www.paddysun.top/archives/4522 · 2025-11-26
[【曙光大陆】全书目录](https://www.paddysun.top/archives/4516)
孙仁同志——现在该叫他艾伦,或者凯因,或者随便什么史密斯了——觉得这世上的规则,就像他大学时那辆破车的链条,你永远不知道它会在哪个节骨眼上“嘎嘣”一声断开,把你撂在半路。不同的是,大学的链条断了顶多让你迟到,这里的链条断了,怕是连脖子都要一并交代了。
他凑到那扇镶着铅条的玻璃窗边,像只偷油的耗子般往外窥探。果然,楼下街对面那家“瘸腿驮马”旅店,此刻热闹得像一锅煮沸的饺子。几个穿着锃亮胸甲、头盔上插着可笑羽毛的卫兵,像模像样地端着长戟,把旅店门口堵得严严实实。他们的样子,让艾伦想起学校保安队那些戴红袖章的老头,架势十足,但真遇上翻墙的老油条,多半也只能干瞪眼。
不过,卫兵旁边还站着两位。这两位就有点不好玩了。他们穿着深蓝色的、仿佛能把光线都吸进去的长袍,袍子上用银线绣着些纠缠不清的纹路,看着就让人眼晕。手里也没拿刀剑,就杵着根比他们个子还高的木杖,杖头顶着个不明材质的水晶球。那做派,那气场,活脱脱就是他高等数学课上那位永远板着脸的教授——你或许能蒙混过保安,但绝骗不过教授那双能看穿你灵魂是否挂科的眼睛。
“好家伙,”艾伦心里嘀咕,“这他妈是教务处的和保卫科的联合执法啊。”
他看见一个卫兵头目,拿着张羊皮纸,对着旅店老板指手画脚。老板是个胖得像尊佛的中年男人,此刻正把脑袋摇得像拨浪鼓,脸上的肥肉跟着一颤一颤。艾伦几乎能猜到对话内容:
“有没有个名叫约翰·史密斯的在你们店里?”
“长官,真没有啊!我们这儿来往的都是老实巴交的客商……”
“他登记住在这!看,白纸黑字!(把羊皮纸拍老板脸上)”
“哎哟,那肯定是假的!这年头,连卖耗子药的都敢说自己祖上是伯爵哩!”
。。。。。。
艾伦瞧着卫兵拉着了一个不知情况的住客,其大条的神经忽然不知道搭错了哪根弦,照着对面人的嘴型就开始配音“这照片上的是你吗?”,“不是!”。。。。。。
那两位法师倒是一直没动静,像两尊门神。但他们杵在那里,本身就是一种无声的威胁。艾伦琢磨,那水晶球会不会像个生物特征识别器,或者更玄乎点,直接就是个灵魂扫描仪?自己这个鸠占鹊巢的冒牌货,不知道原主的“生物信息”备份了没有?这要是一扫描,发现内核是个被高等数学折磨得死去活来的二十一世纪灵魂,乐子可就大了。好比你在故宫里安装了液晶电视,技术上是进步了,但放在那环境里,就是最大的不和谐。
他看着卫兵们咋咋呼呼地开始搜查旅店的马厩和堆放草料的后院,动作粗鲁,惊得几只母鸡咯咯乱飞。法师依旧不动,仿佛在说:让这些粗坯去折腾吧,真正的猎手,只需要等待。
艾伦缩回脑袋,背靠着冰冷的墙壁。桌上那三张身份证明,像三张嘲讽的鬼牌。翠鸟已经暴露,猎犬已经出动。他现在就是那个被推上前台的、手忙脚乱的替补演员,剧本没看,台词不会,台下还坐着一群等着挑刺的评委。
他拿起那本《基础元素引导与安全规范》,掂量了一下。这玩意儿比砖头还沉,指望它立刻学会闪现术,怕是比期末前一周自学完《数学物理方程》全本还要渺茫。他又瞥见那本被原主藏在暗格里的《异世界风流骑士》,封面上画着个盔甲闪亮、左拥右抱的猛男。艾伦苦笑,这他妈的,原来间谍的消遣也这么接地气啊。
楼下的喧闹声似乎更近了。艾伦想象着,也许下一秒,他的房门就会被“砰”地一声撞开,卫兵和法师涌进来,水晶球发出刺眼的光芒,一个冰冷的声音宣布:“灵魂验证失败,非本机用户,予以清除。”
生活就是个缓慢受槌的过程,人一天天老下去,奢望也一天天消失,最后变得像挨了槌的牛一样。可现在,艾伦觉得这槌落得有点太快、太急了,他这头牛还没开始吃草,就要被拉去宰了。
他深吸一口气,那混合着霉味和薰衣草香的古怪空气涌入肺叶。妈的,既然逃课能触发流放,穿越能变成替身,那谁说不能在这规则荒诞的夹缝里,再扑腾几下呢?
他决定,至少得试试看,能不能把这出荒诞剧,演成一场黑色幽默。
于是他又开始捣鼓起暗格里翻出来的玩意儿。
正琢磨着一个铜制烟斗塞有没有啥特殊功能,门外就响起了敲门声。那声音不紧不慢,活像他大学时那位总爱在考试前溜达来溜达去的系主任。
他当时就想,这世上的权威人物敲门都一个德行,明明能一脚踹开,偏要敲出个温文尔雅的节奏来,让你自己把脖子伸进绳套。
他拉开门,门外站着那位深蓝袍子的法师。法师身后,旅店经理搓着手,脸上堆着笑,像颗快要融化的太妃糖。
趁对方迟迟未开腔,艾伦耐不住好奇,将他从头到尾细细大量了一遍。
袍子颜色深得像是把整个夜空的墨水都吸了进去,细看有些银色纹路扭来扭去,看得人眼晕。法师的脸藏在阴影里,只有扶着木杖的手指显得特别白,像几截泡福尔马林里太久的标本。
“例行检查,阁下。”法师的声音平平的,没什么起伏,硬生生挤出来了个难看的微笑。“最近有些……不太安分的老鼠。”
艾伦侧身让他进来,心里琢磨,自己现在算不算一只不太安分的老鼠?而且还是从别的粮仓流窜过来的。
房间不大,法师那双藏在阴影里的眼睛,像探照灯似的扫了一圈,最后停在桌上。桌上摊着几样零碎:一个看起来能当开瓶器用的金属片,几根一头烧焦的小木棍,还有一本摊开的、画满了奇怪符号的笔记本——正是原主同志来不及销毁的小玩意儿。艾伦的冷汗差点就要像他当年查期末成绩时那样喷涌而出了。这些东西,好比在宿舍里被查寝老师翻出了热得快和一整套《金瓶梅》,属于跳进黄河也洗不清的范畴。
法师的视线在那堆破烂上停留的时间,长得让艾伦觉得仿佛过了一个世纪。他能感觉到空气像块慢慢凝固的猪油。他甚至开始思考,用魔法来刑讯逼供会玩出什么新花样。
就在他几乎要听见命运链条“嘎嘣”一声脆响时,法师的目光移开了,落到了床边那本砖头厚的《基础元素引导与安全规范》上,旁边还压着一份崭新的、印着烫金文字的羊皮纸文件。
“帝国魔法与军事学院?”法师那平淡的声线里,似乎掺进了一丁点儿别的东西,不知道是看到猎物的兴奋还是遇到“同类”的喜悦。他伸出那截白得过分的手指,虚点了点那份录取通知书。
孙福灵心至,赶紧把那份卷轴拿起来,双手递过去,动作恭敬得像是在递交入党申请书。“是,刚收到的。正准备去报到。”
法师并没有接,只是隔着那层阴影似乎又看了一眼。然后,他发出一种介于理解和无趣之间的、短促的气音。“嗯。”
他重新转向桌上那堆间谍道具,这次眼神就完全不同了。那是一种带着些许了然、些许容忍,甚至还有一丝“你们这些搞学术的真是莫名其妙”的眼神。就像他当年的导师,看到他试图用食堂的微波炉测量光速时露出的表情。
“学校的教授,”法师像是自言自语,又像是对艾伦解释,“总有些……奇思妙想。搞出些稀奇古怪的玩意儿也不足为奇。” 他顿了顿,补充了一句,语气近乎宽容,“毕竟,探索真理的道路,总是布满荆棘和……嗯,这些零碎。”
说完,他微微颔首,那身深蓝袍子像夜色一样无声地滑出门外,还顺手替艾伦带上了门。轻飘飘的,没留下一点要追究的意思。
艾伦缓慢的转过身,慢慢的将身体的重量靠到了门板上。凝固的空气这才慢慢化开了。鲁迅曾经写过,生活就是个缓慢受槌的过程。刚才那一下,槌子已经举到头顶了,结果却轻轻落下,只在他脑门上弹了个脑瓜崩。
他颤抖着手,挪到了桌前,看着那堆差点让他完蛋的“奇思妙想”,又看了看那份救了他小命的录取通知书。这感觉荒谬极了,好比你在考场作弊被逮个正着,监考老师却因为你是他学院的,要是通报上去,学院也要跟着你倒霉。
虽然原本的砍头刀挥了个空,但这一分钟他的心思活泛不起来。
但我们这些看着了解了,在这个世界,帝国魔法与军事学院学生的身份,就像他原来那个世界的985学生证,在某些时候,总能获得些优待。
再凭借着原主贵族家里的零花钱和间谍经费,领着双份工资。直接逆袭成为高学历的高富帅。精灵姐姐,兽耳妹妹,嘿嘿嘿!
然而事情怎可能让他一帆风顺?
法师眼如深潭水,照破皮相观骨髓。
忽闻学院钟声响,方得一线续命机。
替身演罢开场戏,大幕未落戏已续。
终有一日锣鼓歇,看你如何藏故衣。
====
# 【曙光大陆】001 古希腊掌管签到的神
https://www.paddysun.top/archives/4517 · 2025-11-26
[全书目录](https://www.paddysun.top/?p=4516)(连载中)
孙仁后来总想,那个世界一定是个结构精妙的骗局。
故事开始于数学物理方程课前五分钟。他骑着那辆除了铃不响哪都响的破车,像枚精确制导的导弹,射向教学楼。透过门缝,他撇见了那个4个神圣的数字——签到码。在教务系统的宇宙里,孙仁这个名字暂时不会变成“缺勤”的悲惨状态。
冲出教学楼,大跨上车,他调转车头,感觉自己像个刚炸完桥的游击队员,成功撤退。春天的阳光,此刻不再是电磁波,而是上帝慷慨赠送的、不要钱的蜂蜜,浇在身上。吹得人心痒痒的。日头把背心晒得发烫,凉风顺着袖管子、领口往里钻,浑身三万六千个毛孔,都张着小嘴哼哼。
路右边那大草坪,可是热闹得紧。上百个社团在那摆开阵势,花花绿绿,呜嗷喊叫,活似一锅滚开的杂碎汤。那草皮子,叫前几日的雨水浇得狠了,一股脑地往外钻,绿得淌油。动漫社那些女学生,上身倒是五花八门,但下身统一露着白花花的腿;街舞社的几个愣头青,把个破录音机开得震天响,在草地上拧麻花,脖子上的链子甩起来,能晃瞎人眼;远处还有耍笔杆子的、唱戏的、放风筝的,把那风筝放得比教学楼还高,真不知道会不坏把飞机钓下来。
孙仁眯缝着眼,两腿机械地蹬着车轱辘。这热火朝天的景象,在他眼里,隔着一层看不见的毛玻璃。那喧闹是他们的,像隔着河岸看对岸的灯火,暖烘烘,亮堂堂,却烫不着他的皮肉。
赶着回去打游戏,哪有这闲心停下。
他倒是贪恋眼下这一刻——日头把背心晒得发烫,凉风顺着袖管子、领口往里钻,浑身三万六千个毛孔,都张着小嘴哼哼。这份独个儿的舒坦,不与人言说的小自在,像偷喝了一盅温吞的米酒,从喉咙眼一路暖到肚脐眼。
他正美着呢,忽然间,天色就变了。
不是寻常那种乌云翻墨,而是头顶上好大一块蓝天,像是被一口吸干,“刺啦”一声就裂开一道惨白的大口子。没等他醒过神,一个炸雷,不是从天上来,倒像是从他脑瓜仁里爆开,喀嚓!震得他三魂七魄都错了位。
紧接着,他就觉着身子一轻,不是腾云驾雾的轻快,而是像被人从烂泥塘里往外拔萝卜似的,一股子蛮不讲理的劲儿,攥着他的领子往上提。屁股底下的破车、眼前的绿草地、喧闹的人声、暖烘烘的日头……全都像退潮似的,“呼啦”一下从他感知里抽走了。最后钻进他耳朵眼的,是一个又干又硬,像是庙里泥胎塑像开口的声音,一字一顿:
“孙仁,签到……早退。流放异界,即刻执行。”
阳光的暖意还没散尽,刺骨的寒风就裹了上来。他像颗被弹弓射出去的泥丸,一头栽进了无边的、冰冷的、色彩混乱的虚空里。只留下那辆破铁驴,在四月天的日头底下,或许“哐当”一声,歪倒在路边,惊起几只正在草根下扒食的肥麻雀。
孙仁最后的意识是:妈的,原来掌管签到的,真他妈是个神。
他就这样被带走了,像被风吹走的一粒尘埃。只留下那辆破车,歪在春草青青的路边,见证着一个关于签到、自由与雷霆之怒的,传说中的大二学生。
孙仁醒来时,首先闻到的是股子怪味儿——半是发霉的稻草,半是某种薰衣草香精,混在一起活像老太太的梳妆台被打翻在了马厩里。他睁眼瞧见天花板上吊着个锡蜡烛台,烛火跳得正欢实,把个木头房梁照得影影绰绰。
“操他娘的,”他心想,“这梦做得还挺立体。”
---
他醒来后一个鲤鱼打挺——结果落在硬木床板上,疼得直抽凉气。这下他彻底醒了,光着脚丫子踩,活像只刚被阉了的猫满屋子转悠。雕花木椅、鎏金马桶、墙上还挂着手织挂毯,织着个胖天使在吹喇叭。看到这儿,孙仁乐得后槽牙都晒着了——穿越了!还是豪华单间!
短暂的震惊过后,一股狂喜像嗝一样顶了上来。穿越了!他,孙仁,一个在二十一世纪被高等数学逼得屁滚尿流的大学生,居然成了异世界的主角!这意味着什么?意味着精灵妹妹那尖耳朵会害羞地抖动,兽娘妹妹毛茸茸的尾巴会蹭你的手心,还有巨龙宝藏、上古魔法……去他妈的数学物理方程,去他妈的早退流放,这里是老子的新手村!
他兴奋地跳下床,感觉自己像个刚充了值的VIP玩家。当务之急是搞清楚“角色设定”。他在房间里翻箱倒柜,动作轻快得像只偷到了油的耗子。在皮质的行李箱里,净翻出了些乱七八糟的东西:几本厚重的大部头,书名诸如《基础元素引导与安全规范》,等等《异世界风流骑士》?好东西一会儿看;还有一套叠得整整齐齐的、面料不错的黑色军装;还有一份用看起来就很牛逼的羊皮纸文件——“帝国魔法与军事学校入学通知书”
“稳了!”孙仁打了个响指,看来原主是个学霸型选手,正好方便他打入……呃,是融入这个世界内部,开展丰富多彩的业余生活。
他丝毫没有注意到,他能读懂这些异世界蚯蚓文,甚至加密的蚯蚓文,就是他最大也是唯一的“穿越福利”。
突然想起看过的那些网文套路,他当即对着空气比划:“系统老哥?在不在?给个新手大礼包呗?”只有烛火噼啪作响。他不死心,又念叨:“精灵妹妹兽娘姐姐,我这儿货到付款,速来签收啊!”
正美着呢,眼角瞥见行李箱底有个小缝。这厮前世在宿舍偷藏泡面的灵光涌了上来,三抠两撬,暗格“咔嗒”弹开,哗啦啦掉出一堆物什。
最上头是几张身份证明之类的东西。第一张,照片上是他现在这张略显苍白的脸,表情略带傲慢的年轻人照片——毫无疑问,就是他现在这张脸,名字是“艾伦·弗罗斯特”,籍贯是某个听都没听过的边境小镇。可以,还是个贵族。
第二张,照片还是他,照片同样是“凯因”,但眼神锐利,嘴角带着一丝冷酷,背景是某种抽象的暗色花纹名字变成了“卡尔·里德尔”,身份是“皇家炼金师协会见习会员”。嗯?有点意思,莫非原主还是个斜杠青年?
当他翻到第三张卡片时,脸上的笑容像被冻住的狗屎一样僵住了。
照片里的人穿着朴素的商人服装,笑容憨厚得像食堂里的打饭阿姨,名字却变成了“约翰·史密斯”。这名字敷衍得就像在路边摊买的假证。
孙仁把三张卡片并排放在桌上,看着那三个名字、三种身份,却共享着同一张脸——他现在的脸。他想起某部特工电影,主角就有这么一沓不同身份的证件。
看着看着,鬼使神差的,他拆开了桌角的一只纸折的千纸鹤。果不其然,其上用暗红墨水写着几行字:“翠鸟暴露,猎犬已出动。永别了,同志。”
孙仁一屁股坐回那张软床上,感觉屁股底下的不是天鹅绒,而是针毡。
此刻烛火“噗”地爆了个灯花,把孙仁惊得一哆嗦。他忽然觉得这间精致的客房,像个精心布置的捕兽夹。窗外传来马蹄声。
孙仁后来总想,那个世界一定是个结构精妙的骗局。从大学的签到系统,到这个见鬼的异世界间谍身份,一切都他妈的充满了荒诞的、硬邦邦的、不容置疑的规则。你以为你逃课是为了自由,结果触发了流放;你以为穿越是龙傲天的开始,结果发现自己脖子上套着随时会收紧的绞索。
他想起那个把他扔到这儿的签到之神,觉得那位爷简直是个荒诞派艺术家。看看魔法教材,桌上的三张假身份证,和手上这张死亡通知书。这情形好比你去菜市场买二斤猪肉,摊主递给你一把上了膛的左轮。
盔甲的碰撞声由远及近,好像在楼下停住了。
孙仁把暗格推回去,忽然笑出声来。这他妈哪是异界冒险,分明是赶鸭子上架当特务。他掂量着那本魔法教材,寻思着要不要先学个闪现术——毕竟前世骑破车练就的逃课技巧,在这地方可能不太够用。
[下一章](https://www.paddysun.top/archives/4522)
[【曙光大陆】全书目录](https://www.paddysun.top/?p=4516)
====
# 【曙光大陆】目录 – 周末更新
https://www.paddysun.top/archives/4516 · 2025-11-26
> 发心:
>
> 这是我计划在本站上连载的原创故事《曙光大陆》。我很喜欢剑与魔法的世界,感觉比起仙侠世界要科学那么一丢丢(狗头,其实主要是感觉中文的,能听懂的咒语啊招式名什么的太尴尬了)。并且我这人闷骚的很。万幸互联网上的大佬搞出了京剧版的哈利波特,这个味太合我的胃口了。所以打算落笔写下自己的第一篇故事。把莫言的那股子乡土味道,王小波的那种痞味什么的狠狠的摸到巫师长袍上去,哈哈哈哈,狂笑。
>
> ps:其实我语文啊文笔什么的超级差,第一次写故事纯属吃太饱没事干,哈哈哈哈哈哈哈哈。
**小说简介**:大学生逃课被流放至魔法异界,意外获得多重身份与间谍任务,在规则与荒诞交织的世界中,努力把被现实逼疯的人生,演成一场黑色幽默的冒险。
## 目录
[001 古希腊掌管签到的神](https://www.paddysun.top/?p=4517)
[002 这照片上是你吗?](https://www.paddysun.top/archives/4522)
[003 上课睡觉就是香](https://www.paddysun.top/archives/4770)
[004 上流与下流](https://www.paddysun.top/archives/4808)
005 新朋友与新阶层
006 平民的友谊
007 如果上天再给我一个机会,我选择做个好人
====
# 【方法论】机器学习先做特征选择还是参数寻优?
https://www.paddysun.top/archives/4510 · 2025-11-26
> 知乎上有人提问:
> 特征选择若使用包裹式或嵌入式都得基于预测模型,那么这时候是先用模型的默认超参数做特征选择吗?然后再用新特征集进行超参数寻优?
>
> 那这样会不会出现一个问题,就是使用默认参数时并没有充分发挥所有特征的信息,导致一些有用的特征被筛掉了,导致整体性能变差,再怎么优化超参数也没用了。
>
> 本篇是对其问题的回答,也是对于此前[【监督学习】:说话人特征提取算法比较 – Under the Sun with Paddy](https://www.paddysun.top/archives/4430)实验的回顾和总结。
是的,使用默认参数时**很容易没有充分发挥所有特征的信息。**解决方法是:**应该将特征选择本身视为模型训练一个需要优化的“[超参数](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=%E8%B6%85%E5%8F%82%E6%95%B0&zhida_source=entity)”。**
**建议**
1. **理解模型的“偏好”**:首先通过文献和经验,定性分析你的模型擅长处理何种信息(空间、时间、频率…),再据此设计或选择特征。
2. **将特征子集作为超参数**:在计算资源允许时,最严谨的方法是将“使用哪组特征”本身作为一个超参数,与模型参数一同进行优化。
3. **优先使用嵌入式选择**:使用[L1正则化](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=L1%E6%AD%A3%E5%88%99%E5%8C%96&zhida_source=entity)、[树模型](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=%E6%A0%91%E6%A8%A1%E5%9E%8B&zhida_source=entity)等内置特征重要性评估的方法,让特征选择与模型训练同步进行。
4. **谨慎进行特征扩展**:任何新的特征扩展(如我的动态特征)都应以**控制变量**的方式进行严格评估,警惕“维度堆砌”的陷阱。
## 具体的分析和结论
> 在我之前的实验中,我比较了[MFCC](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=MFCC&zhida_source=entity)、[Fbank](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=Fbank&zhida_source=entity)和[LPCC](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=LPCC&zhida_source=entity)三种音频特征在说话人识别任务中的表现。实验设计类似于一种“特征选择”场景:我固定了[CNN模型](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=CNN%E6%A8%A1%E5%9E%8B&zhida_source=entity)的架构,比较MFCC、Fbank和LPCC三种音频特集性能。
### 实验发现:
**1,特征集本身对性能有决定性影响。**对于相同模型的多次实验中,MFCC在低噪声下准求率就底的降无可将。没有好的食材,厨艺在精湛也没用,再参数调优也提高不了鲁棒性。
**2,不同特征集在不同模型下性能差异显著**。
我使用CNN模型结果是:LPCC ≈ Fbank > MFCC;使用[LSTM模型](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=LSTM%E6%A8%A1%E5%9E%8B&zhida_source=entity)的文献结果是:Fbank > MFCC > LPCC,这说明了特征和使用什么模型超参数是紧密耦合的。如果先用默认超参数做特征选择,可能会过早地丢弃一些有用特征(如LPCC,其在文献中普遍不被看好),因为默认参数无法充分发挥这些特征的潜力,从而导致整体性能上限降低。
**3,不合时宜的特征会破坏模型原有的学习能力。**
预实验时,我‘自作聪明’地将FBank与其一阶、二阶差分动态特征拼接在一起,结果FBank特征的准确率急剧下降。特征工程的关键在于‘适配’而非‘堆砌’。为LSTM提供丰富的时序动态特征是‘投其所好’,而为CNN提供同样的特征则是‘强人所难’。在机器学习中,理解你的模型‘喜欢吃什么’,比一味地提供‘昂贵的食材’要重要得多。”
### 结论和启示
**1,“特征-模型协同设计“**
传统的机器学习流程常将特征工程与模型训练视为两个独立的阶段,但我的实验表明这存在严重局限。更有效的做法是建立协同设计的思维:
在前向设计时:根据任务特性先预设可能的有效特征,同时考虑匹配的模型架构。比如处理时序依赖强的任务,优先考虑LSTM/Transformer与动态特征的组合;处理局部模式明显的任务,则考虑CNN与静态特征的搭配。
在反向验证时:当模型表现不佳时,不仅要调整超参数,更要反思特征集与模型的匹配度。我的FBank+动态特征实验就是典型案例——性能下降时首先应该质疑的是“这些特征吗真的适合这个模型嘛”,而不是盲目继续调参。
**2. 采用分阶段-迭代式的特征评估策略**
针对“默认参数做特征选择可能误删有用特征”的困境,我建议:
第一阶段:广度探索
使用简单模型(如SVM、浅层CNN)和默认参数快速测试各个特征集的潜力上限,重点关注不同特征集带来的性能差异趋势,而不是绝对数值。此时的目标是识别出有前途的特征方向,而不是做出最终选择。
第二阶段:深度优化
对潜力特征集,进行特征子集+模型超参数的联合优化。例如使用[贝叶斯优化](https://zhida.zhihu.com/search?content_id=758210072&content_type=Answer&match_order=1&q=%E8%B4%9D%E5%8F%B6%E6%96%AF%E4%BC%98%E5%8C%96&zhida_source=entity)同时搜索特征组合和关键超参数。这一阶段的计算成本虽高,但能避免因前期草率特征选择导致的性能天花板。
第三阶段:交叉验证
最有说服力的做法是在多个不同架构的模型上验证特征集的有效性。如果一个特征集在CNN、LSTM、Transformer等多种模型下都表现良好,那它很可能确实包含了任务的本质信息。
**3. 理解不同模型的“特征偏好”先验**
从我的实验和阅读论文,可以提炼出一些模型偏好的经验法则:
> CNN类模型:偏好局部相关性强的特征,如图像中的相邻像素、音频中的相邻频带。特征应该尽可能保留空间结构信息。
> LSTM/RNN类模型:偏好具有清晰时间演变的特征,对特征的平滑性和动态范围相对不敏感。
这些先验知识可以在实验初期为我们提供有价值的指导。
====
# 【监督学习】:说话人特征提取算法比较
https://www.paddysun.top/archives/4430 · 2025-11-24
# 引言:从无监督到监督
在之前我们[实验了无监督的聚类方法(kmeans,DBSCAN,层次聚类)](https://paddysun.top/archives/4417),表现最好方案 mfcc特征提取+tSNE降维+kmeans聚类,效果很差。
> mfcc特征提取+tSNE降维+kmeans聚:
>
> 具体来说,虽然其整体分离度(Separation Ratio)能够达到0.97,这表明聚类结果的簇内距离相对较小,簇间距离相对较大,聚类质量很高,解释了一些声音的结构特征;但其调整兰德指数(ARI)也仅为0.2384,意味着聚类结果与真实标签之间的匹配程度较低。
为了更好的完成说话人识别任务我进行了粗浅的论文阅读,通过阅读论文(随便看了几篇,大部分是近代而非现代的啦),总结说话人分类技术发展历程如下。
发展阶段时间范围特征提取技术分类算法主要特点**传统方法阶段**20世纪80-90年代• LPCC(线性预测倒谱系数) • MFCC(梅尔频率倒谱系数) • 反射系数 • 面积函数 • 对数面积比• 矢量量化(VQ) • 模板匹配法 • 最小距离分类器 • 高斯混合模型(GMM)• 基于声道模型和听觉特性 • 手工设计特征参数 • 识别率相对较低**统计模型发展阶段**2000-2010年• 差分倒谱参数 • 特征加权 • 瓶颈特征(BN) • 说话人编码• GMM-UBM框架 • 隐马尔可夫模型(HMM) • 支持向量机(SVM) • 因子分析(JFA)• 引入通用背景模型 • 统计建模方法成熟 • 文本无关识别成为主流**深度学习革命阶段**2010年• FBank特征 • X-vector • d-vector • 深度特征 • 端到端特征• 深度神经网络(DNN)• 卷积神经网络(CNN) • 循环神经网络(RNN/LSTM) • 注意力机制 • 生成对抗网络(GAN) • 端到端模型(CTC)• 自动学习特征表示 • 端到端建模 • 性能大幅提升 • 处理复杂场景能力强
看完论文,我决定试试炼丹(采用基于深度学习的端到端方法),这是亲爱的Deep Seek给我的理由:
- **理论依据**:深度学习使用多层的非线性结构将低层特征变换成更加抽象的高层特征,相比传统浅层模型拥有更强的表达和建模能力。语音信号作为一种非平稳的随机信号,其形成和感知过程本身就是一种复杂信号的处理过程,深层模型在一定程度上能够模拟人类语音信息的结构化提取过程[1]。
- **性能优势**:自2009年深度学习首次应用于语音识别任务以来,相比传统的高斯混合模型-隐马尔科夫模型(GMM-HMM)语音识别系统获得了超过20%的相对性能提升[1]。深度学习方法在复杂信号处理上展现出明显优势。
- **技术成熟度**:近年来,基于深度学习的说话人识别技术取得了突破性进展,如X-vector、d-vector等深度特征提取方法,以及端到端建模技术,都显著提升了识别性能[3]。
机器学习什么的太复杂了(我太菜了),我们还是先比较三种主流音频特征提取算法(MFCC、LPCC、深度特征)在说话人识别任务中的表现,系统评估其在准确性、鲁棒性等方面的性能差异。
## 三大音频特征的”武功秘籍”
### MFCC:语音识别的”老将”
**MFCC(梅尔频率倒谱系数)** 可以说是语音处理领域的”常青树”,从零几到近些年的论文中其都频繁出现,在我们先前无监督的学习中也表现出色。它的设计灵感来源于人类听觉系统——我们耳朵对不同频率声音的敏感度是不同的。
**工作原理简析**:
1. **模拟人耳**:通过梅尔尺度模拟人耳的非线性频率感知
2. **倒谱分析**:分离声源特征和声道特征
3. **动态特征**:捕捉语音的时序变化
### LPCC:基于物理模型的”理论派”
**LPCC(线性预测倒谱系数)** 走的是另一条技术路线。它基于语音产生的物理模型,试图通过数学方法描述我们的发声器官。查阅到的多篇论文中其表现都逊于MFCC,但还是请出来试试身手。
**理论基础**:
- **线性预测**:用过去的语音样本预测未来的样本
- **声道建模**:模拟口腔、鼻腔等共振腔的滤波特性
- **参数精简**:用少量参数描述复杂的语音信号
### Fbank:深度学习的”新宠”
**Fbank(滤波器组能量)** 可以看作是MFCC的”前身”。它保留了梅尔滤波器组的能量信息,但没有进行最后的倒谱变换。但在我们先前无监督的学习中也表现较差(MFCC 处理的平均 ARI 得分为 **0.1459**,Fbank 处理的平均 ARI 得分为 **0.0317**)。
**独特优势**:
- **信息保留更完整**:避免了倒谱变换可能的信息损失
- **更适合深度学习**:让神经网络自己学习有用的特征组合
- **计算更简单**:少了一步DCT变换
## 实验设计:公平的竞技场
参考崔琳等人对于特征提取效果研究的实验设计[5],设计了”严谨”的实验方案。并且预实验时发现CNN的表现有着很高的随机性(可能这就是被称为炼丹的原因),研究的是特征处理,所以不固定随机数种子,训练重复十次。
### 数据准备
因为电脑空间有限,装不下20多G的完整VoxCeleb1训练集,加上需要克服CNN训练中的随机性,进行重复实验大量数据对于训练时间变得很长很长,所以只下载了VoxCeleb1测试集部分。
音频时长统计数据集时长标准差: 7.56 秒**说话人数量**:40人最短时长: 4.00 秒训练集:668个样本最长时间: 24.16 秒验证集:143个样本平均时长: 7.13 秒测试集:144个样本
数据预处理时,统一设置如下参数:
```
- 采样率:16kHz
- 帧长:25ms
- 帧移:10ms
- FFT大小:1024
```
### CNN模型架构
采用统一的经典卷积神经网络架构。模型包含多个卷积层、批归一化、Dropout等现代深度学习组件。
### 特征提取设计
主要参考崔琳等人的研究成功,选择各自特征提取方法的最佳参数。
**特征提取流程步骤**
步骤操作说明1音频加载与分割使用librosa加载,按3秒分割2预加重处理仅LPCC使用,系数0.973分帧加窗汉明窗,25ms帧长,10ms帧移4特征提取分别计算MFCC/Fbank/LPCC5动态特征计算MFCC和LPCC添加一阶、二阶差分6特征标准化均值方差归一化7特征堆叠时间帧×特征维度
**特征提取参数设置**
特征类型参数名称参数值计算方法/说明设置的原因**通用参数**采样率16000 Hz音频重采样率帧长25 ms`FRAME_LENGTH`语音信号的短时平稳特性,通常选择20-30ms以保证信号在帧内平稳[7]帧移10 ms`FRAME_SHIFT`保证相邻帧之间有足够的重叠,避免帧间变化过大,通常为帧长的1/2-1/3[7]FFT点数512`N_FFT`在16kHz采样率下,512点FFT提供足够的频率分辨率,同时计算效率较高[6]音频片段长度3.0 s`segment_length`基于数据集的统计信息**MFCC特征**MFCC系数13维`n_mfcc=13`低阶倒谱系数能够反映声道的脉冲响应特征,13维是说话人识别的常用维度[5]梅尔滤波器数40个`n_mels=40`Mel滤波器组在低频区域分布密集,能够更好地模拟人耳听觉特性[4]动态特征一阶、二阶差分共39维特征(13+13+13)反映语音的动态特性,人耳对动态特性更为敏感,能显著提高识别率[5]标准化均值方差归一化`(x-μ)/σ`**Fbank特征**梅尔滤波器数40个`n_mels=40`测试时发现对Fbank也组合上1,2阶差分其效果明显下降,古没有组合同台特征特征维度40维对数梅尔频谱能量动态特征无仅使用静态特征标准化均值方差归一化`(x-μ)/σ`**LPCC特征**LPC阶数12阶`order=12`对于语音信号,12阶LPC能够较好地模拟声道特性,是常用选择[5]LPCC系数12维`n_ceps=12`预加重系数0.97高频增强补偿语音信号被抑制的高频部分,消除声带和嘴唇效应,提升高频信号[9]动态特征一阶、二阶差分共36维特征(12+12+12)反映语音的动态特性,人耳对动态特性更为敏感,能显著提高识别率[5]标准化均值方差归一化`(x-μ)/σ`
我个人猜测于认为:
1. **Fbank可能在深度学习框架下略胜一筹**
2. **MFCC作为基准应该会有稳定表现**
3. **LPCC可能表现最差**
## 结果分析
在完成十次重复实验后,我们得到了三种特征提取方法在说话人识别任务中的综合表现数据。本部分将从整体性能比较和具体性能评估两个维度进行分析,并结合特征本身的特性对结果进行推测性解释。
### 比较分析:三种特征的”华山论剑”
从整体识别性能来看,三种特征提取方法在说话人的准确率相差不大,MFCC表现略逊一筹。
**准确率与F1分数表现**:
> 在40说话人数据集上,LPCC表现出最高的准确率(76.11%准确率,75.31%F1),Fbank次之(75.07%准确率,73.59% F1),MFCC相对较低(71.53%准确率,69.95% F1)
>
> 在20说话人简化数据集上,Fbank实现最佳性能(78.42%准确率,77.94% F1),LPCC紧随其后(76.71%准确率,75.73% F1),MFCC仍居末位(74.74%准确率,73.51% F1)
这一结果部分颠覆了我最初的预期——LPCC这个”理论派”在实际表现中并不逊色,甚至在复杂场景下略胜一筹。而Fbank在数据量减少时展现出更好的适应性,MFCC则始终保持着稳定但非最优的表现。
**性能稳定性分析**: 通过十次重复实验的标准差来看,Fbank在40说话人数据集上展现出最佳的稳定性(准确率标准差5.55%),LPCC在20说话人数据集上最为稳定(准确率标准差5.13%)。MFCC在两个数据集上都表现出较大的波动性(标准差分别达12.15%和8.94%),说明其性能受训练随机性影响较大。
从CNN训练的收敛速度来看LPCC在20说话人数据集上训练时间标准差最小(41.35秒),表明其收敛过程相对稳定;而MFCC在40说话人数据集上训练时间标准差较大(138.88秒),说明收敛过程存在较大波动印证了其性能受训练随机性影响较大。
### 鲁棒表现
在噪声环境下的测试结果中,LPCC与Fbank特征的鲁棒性同样相差不大。
> LPCC在噪声条件下表现最佳,在40说话人数据集上噪声下准确率达21.79%,在20说话人数据集上达24.82%
>
> Fbank噪声鲁棒性次之,相应准确率为16.68%和29.32%
>
> MFCC对噪声最为敏感,噪声下准确率仅4.44%和9.89%
噪声下性能保持率(SNR=0dB时的性能占SNR=20dB的比例)进一步证实了这一趋势:MFCC在40说话人数据集上保持率最高(38.79%),但在实际准确率绝对值上仍远低于其他两种特征。
### 结果推测:为什么”理论派”逆袭了?
基于以上结果,亲爱的Deepseek对三种特征的表现差异进行如下推测:
1. **LPCC的意外优势**:
- **物理模型的基础**:LPCC基于语音产生的物理模型,可能更好地捕捉了说话人生理特征(如声道形状),这些特征在噪声环境下相对稳定
- **参数精简效应**:12维LPCC系数相比其他特征的更高维度,可能减少了过拟合风险,特别是在数据量有限的情况下
- **预加重处理**:LPCC特有的预加重步骤增强了高频信息,可能在噪声环境中提供了更多鲁棒性特征
2. **Fbank的深度学习适配性**:
- **信息保留完整**:Fbank避免了MFCC的DCT变换信息损失,为CNN提供了更丰富的原始特征,让网络自行学习最佳表示
- **维度适中**:40维特征在表达能力和计算复杂度间取得良好平衡
- **数据量依赖性**:在20说话人简化数据集上Fbank表现最佳,说明其在数据量减少时仍能保持较好性能
3. **MFCC的相对劣势**:
- **倒谱变换的副作用**:MFCC的倒谱分析在分离声源和声道特征时,可能丢失了对说话人识别有用的混合信息
- **噪声敏感性**:基于人耳听觉特性的Mel尺度在噪声环境下可能放大失真效应
- **动态特征的局限性**:虽然添加了一阶二阶差分,但在深度学习框架下,这些手工设计的动态特征可能不如网络自行学习有效
### 思考与启示
本次实验给我最大的启示是:在深度学习时代,传统特征提取方法仍然有其价值。LPCC这个基于上世纪七八十年代理论的方法,在特定场景下竟然能与现代方法一较高下,这提醒我们不应盲目追求”最新最好”,而应基于具体任务和数据特性选择合适的技术。
值得一提的是,特征提取时间虽在实验环境中差异明显,但在实际应用中,LPCC的0.1秒提取时间相对于数分钟的训练时间而言,差异并不显著。因此在追求最终性能的场景下,计算代价较高的特征仍值得考虑。
数据集合特征类型准确率均值F1均值F1标准差训练时间均值(秒)噪声下准确率平均训练时间占总时间比值40说话人MFCC0.7152780.6995120.140234377.69370.04440.24685640说话人Fbank0.7506940.735920.053953402.89980.16680.26333140说话人LPCC0.7611110.7530950.079191389.60110.21790.25463920说话人MFCC0.7473680.7350790.094648117.60050.09890.07686220说话人Fbank0.7842110.7794420.080627128.77250.29320.08416420说话人LPCC0.7671050.7573270.056198113.44740.24820.074148
## 参考文献
1. 戴礼荣,张仕良,黄智颖.基于深度学习的语音识别技术现状与展望[J].数据采集与处理,2017,32(02):221-231.DOI:10.16337/j.1004-9037.2017.02.002.
2. 张高峰,刘天,解晓敏,等.基于条件Wasserstein生成对抗网络的说话人辨认研究[J].计算机应用与软件,2025,42(08):213-218+241.
3. 郑立通,洪峰,郑婉,等.基于迁移学习和多尺度损失的短语音说话人识别方法[J].声学技术,2025,44(04):565-574.DOI:10.16300/j.cnki.1000-3630.24011601.
4. 崔琳,王芷悦. 基于LFBank与FBank混合特征的声纹识别研究[J]. 计算机科学,2022,49(z2):609-613. DOI:10.11896/jsjkx.211000194.
5. 余建潮,张瑞林. 基于MFCC和LPCC的说话人识别[J]. 计算机工程与设计,2009,30(5):1189-1191.
6. 蔡莲红, 黄德智, 蔡锐. 现代语音技术基础与应用[M]. 北京: 清华大学出版社, 2003.
7. 韩纪庆, 张磊, 郑轶然. 语音信号处理[M]. 北京: 清华大学出版社, 2004.
8. 宫晓梅,王怀阳. 噪声环境下MFCC特征提取[J]. 微计算机信息,2007,23(22):247-249. DOI:10.3969/j.issn.1008-0570.2007.22.102.
9. 丁爱明. 作为说话人识别特征参量的MFCC的提取过程[J]. 电子工程师,2006,32(1):51-53. DOI:10.3969/j.issn.1674-4888.2006.01.017.
====
# 【聚类分析】降维聚类判断是谁在说话
https://www.paddysun.top/archives/4417 · 2025-11-20
在上一篇文章 [【降维分析】 声音的可视化探索:从鸟叫到声纹识别](https://paddysun.top/archives/4387) 中我们进行了声音可视化分析的初步探索,提出了能否用这种特性来进行语音识别的假设。下面我们就将完整走完整个语音聚类分析过程、操作方法与结果分析。
在研究材料上,我们不再麻烦亲友录制了,而是使用大型开源语言数据集。在全球大型语音语料库中,**[VoxCeleb1](https://mm.kaist.ac.kr/datasets/voxceleb/)** 是一个具有代表性的语音数据集,包含了来自全球范围的语音样本集。每个说话人身份信息标记得非常完整和清晰,为语音聚类分析提供了良好的基础。
---
## 一、语音数据聚类是什么?
语音数据聚类是一种**无监督学习问题**,其目标是通过语音特征,将语音数据视为“样本”,依据相似性将它们自动划分为若干簇(Cluster)。这些簇可能代表**同一个说话人的声音分布**。
在语音识别与语音数据研究领域,聚类技术可用于**推测语音的来源**,尤其是在没有明确标签信息的情况下,是一项非常实用的数据挖掘技术。我们选取 VoxCeleb1 数据集的一部分,尝试通过聚类分析找出**说话人身份的分布边界**,并探索声音是否具有“声音指纹”的特性。
---
## 二、语音特征提取:MFCC 与 Fbank

为了提出录音设备差异背景噪音干扰,更好地表征语音数据,我们使用了两种常用的音频特征:**MFCC**(梅尔频率倒谱系数)和 **Fbank**。
### 1. **MFCC(梅尔频率倒谱系数)**
- MFCC 是一种广泛用于语音分析的特征,通过计算语音的频谱能量分布并将其映射到梅尔频率尺度(近似人类听觉感知特性)。
- 每个 MFCC 特征向量包括 20 个主频段 + 两个差分(delta 和 delta2),总共形成 **60 维**的语音表征。
- 能够捕捉时间上的动态变化,是语音识别中常用的特征。
### 2. **Fbank**
- 与 MFCC 类似,但采用对数梅尔能量(Log-Mel Spectrogram)来表示语音的频谱特征。
- 更关注频段能量分布,包含了更多信息,对发音时间变化的捕捉不如 MFCC 灵敏。
**针对说话人聚类任务结果:**
- MFCC 处理的平均 ARI 得分为 **0.1459**
- Fbank 处理的平均 ARI 得分为 **0.0317**
这表明:**MFCC 更适合用于说话人聚类**,推测它能更准确地表达语音的个性化特征。
---
## 三、降维方法:PCA 和 t-SNE
为了将高维语音特征(60 维)映射为可视化的 2D 结构,我们采用了两种经典的降维技术:**PCA(主成分分析)** 和 **t-SNE(t-分布随机邻域嵌入)**。
### 1. **PCA(主成分分析)**
- 是一种线性降维方法,通过最大化数据的方差来提取主要成分。
- 优点是运行速度快、可解释性好;缺点是**可能丢失非线性结构信息**,对复杂空间关系表达有限。
### 2. **t-SNE(t-分布随机邻域嵌入)**
- 是一种非线性降维方法,**擅长保留高维数据的局部关系**,适合**可视化数据分布**。
- 结果更贴近人类感知,对于不同说话人在高维空间中的分布关系更能体现出来。
**针对说话人聚类任务结果:**
- t-SNE 处理的平均 ARI 得分为 **0.1034**
- PCA 处理的平均 ARI 得分为 **0.0742**
虽然结果表明:**t-SNE 在保留语音特征分布细节方面表现更为出色**,因而 ARI 和轮廓系数都更好。但从下图可以看出,其都没能呈现出明显的聚类,各类都混杂在了一起,只能期待其通过聚类算法能够有较好的表现。
---
## 四、聚类方法:KMeans、DBSCAN、层次聚类
为了评估语音数据的聚类效果,代码中运行了三种主流的聚类方法:**KMeans**、**DBSCAN**(密度聚类)和**层次聚类**。
### 1. **KMeans 聚类**
- 一种基于均值的聚类方法,将数据划分为若干个**中心明确的簇**。
- 在该实验中,我们选择了 **10 个聚类簇**,并基于真实标签评估了聚类效果。
**关键结果:**
- 在 **MFCC + t-SNE** 空间下表现最佳,获得 ARI 得分 **0.2384**
- 聚类数 10,轮廓系数 **0.4266**
### 2. **DBSCAN(密度聚类)**
- DBSCAN 假设数据为**不同密度的区域**,自动识别噪声点。
- 举个例子就像在沙滩上寻找人群和孤立的个体,非常适合复杂、异构的数据集。
**关键结果:**
- 在 **MFCC + t-SNE** 下“拟合”出 8 个簇(ARI = 0.0445)
- 噪声占比高达 **76.61%**,说明语音数据存在较大的异质性和噪声干扰。
### 3. **层次聚类(Hierarchical Clustering)**
- 通过构建树状结构(Dendrogram),揭示语音样本之间的**层次关系**,理解不同说话人、不同语音之间的关联。
**关键结果:**
- 在所有方法中表现不如下克莱斯的 KMeans
- 但轮廓系数良好(MFCC PCA 下为 0.432)
---
## 五、结果分析:为何 KMeans 在 MFCC t-SNE 下表现最佳?
从代码运行结果来看,**MFCC + t-SNE 的组合下,KMeans 在语音聚类中表现最佳**,其 ARI 得分高达 **0.2384**,意味着该方法在识别说话人之间聚类结构上具有一定的能力。
### 假设一:**MFCC 更能捕捉声音的语义信息**
- MFCC 更注重语音的**频谱和时间动态变化**,捕捉声学特征时比 Fbank 更贴近人对声音的感知机制。
- 因此,**MFCC 更具代表性**,能够更清晰地划分说话人边界。
### 假设二:**t-SNE 在 MFCC 空间表现出更强的聚类分离能力**
- t-SNE 通过非线性映射保留了**不同说话人之间的分布关系**,使得 KMeans 在 t-SNE 空间中的聚类边界更清晰、更优雅。
- 这也解释了为何 ARI 和轮廓系数在 t-SNE 空间下更高。
### 假设三:**KMeans 在聚类中更稳健**
- KMeans 能适配相对清晰的语音分布,尤其在 MFCC + t-SNE 的交织下能准确识别说话人身份。
- DBSCAN 在 t-SNE 空间下噪点占比较高(76.61%),说明语音数据**混杂度较高**,很多样本无法准确归类到某个说话人。
---
## 六、每个说话人的表现差异:纯度、同质性、完整性
以 **KMeans + MFCC + t-SNE** 为例,我们对每一位说话人的聚类效果进行了评估。
**分析:**
- 其**纯度(Purity)** 从中低(<0.3)到中高(>0.7)差异明显,反映**不同说话人的语音差异程度不一**,部分说话人更容易被识别。
- 除此之外,所有说话人分类结果的**同质性(Homogeneity)**均为 1,说明**每个说话人的样本都被分到一个簇中**,无跨说话人混淆。
- 除此之外,所有说话人分类结果的**完整性(Completeness)** 全为 0,表明**未能完全划分所有说话人的语音**,说明数据分布可能存在不均衡,或部分语音被错误地归到其他说话人下。
---
## 七、结果解读:语音聚类的问题与意义
### 1. 语音聚类效果非绝对,存在个体差异
- 语音聚类不是完全一针见血的识别任务。每个人的声音都独一无二,但**某些人语音风格更显著**,更容易在孟弗特空间中被分离。
- 聚类结果可能会受到发音习惯、语境、情绪等多种因素影响,导致某些说话人的语音分布较为模糊。
### 2. DBSCAN 擅长处理噪声,但也带来了“模糊”的问题
- DBSCAN 具有处理**噪声点**的能力,适合对语音数据进行初步筛查或重点关注真实样本。
- 然而,在本实验中,**76% 的样本被判定为噪声**,说明语音数据的**一致性不足**,配音、背景混音等情况可能导致聚类效果受损。
### 3. ARI 和 Silhouette 系数反映聚类能力的现状
- 尽管 **KMeans 在 MFCC + t-SNE 空间中达成的最佳 ARI 得分为 0.2384**,说明这个方法**基本识别出某些说话人的聚类结构**。
- 但由于语音样本之间的差异并非完全可区分,且数据可能包含**混淆样本**,因此聚类质量仍有提升空间。
---
## 八、语音可视化:图像蕴含的声音边界
从代码跑出的可视化图表我们不难发现,**即便采用 MFCC + t-SNE 技术,语音数据中的不同说话人仍然存在较大重叠区域**,说明:
项目说明**最佳聚类配置**mfcc_tsne_kmeans(0.2384 ARI)**语音特征**MFCC 更具代表性,能准确捕捉说话人音色特征**降维方式**t-SNE 优于 PCA,保留了更好的簇间关系**聚类算法**KMeans 是最稳健的选择,层次聚类和 DBSCAN 存在噪声干扰**噪声比例**一些方法(如 DBSCAN)发现超过 70% 的样本为噪声**整体分离度(Separation Ratio)**仅 0.97,分离度良好但仍有提升空间
---
## 九、未来优化方向
- **使用深度学习特征**:如 CNN、DNN 或预训练语音模型(如 VGGish)提取的嵌入特征,可能更接近人类听觉的感知方式。
- **优化降维参数**:t-SNE 的参数选择对结果影响显著,可以通过调优保留更多的结构信息。
- **增加样本量**:每位说话人仅使用了少量语音片段,数据稀疏可能影响聚类效果。
- **调整算法超参数**:如 KMeans 的簇数、DBSCAN 的 `eps` 和 `min_samples` 等参数,需要根据实际数据分布进行优化。
====
# AbuseIPDB黑名单实战测评:在中国网络环境下的效果与局限
https://www.paddysun.top/archives/4409 · 2025-11-20
> 基于真实蜜罐数据的深度分析,揭示全球威胁情报平台在中国网络环境中的表现
在服务器安全防护中,黑名单拒绝访问是第一道防线。作为全球知名的威胁情报平台,AbuseIPDB提供了大量免费的恶意IP数据。但这款国际化的安全工具在中国网络环境中表现如何?本文将基于本地蜜罐数据,进行深入解析。
## 测试环境与方法
为了客观评估AbuseIPDB的实用效果,我们搭建了HFish蜜罐系统,在1周的时间内捕获了3,369个攻击IP。通过与AbuseIPDB的下载的1万条免费黑名单数据进行对比分析,得出以下结论。
## 核心发现:AbuseIPDB的总体表现
**数据对比结果令人惊讶:**
- 蜜罐捕获恶意IP命中AbuseIPDB免费黑名单比例**仅15.3%**(515个)
- 估计完整AbuseIPDB黑名单检测率为29.24%(515/1,761,匹配IP数 / 蜜罐捕获IP中AbuseIPDB高置信度个数)
这意味着,如果我们完全依赖AbuseIPDB的免费黑名单,只能阻挡不到三分之一的已知威胁。
## 中国网络环境的特殊挑战
### 地域性数据偏差明显
分析蜜罐捕获攻击ip地理位置分析来看,攻击来源分布:
- 中国IP:**1,277个**(37.9%),平均AbuseIPDB威胁评分仅38.9分
- 美国IP:692个(20.5%),平均AbuseIPDB威胁评分75.7分
- 英国IP:258个(7.7%),平均AbuseIPDB威胁评分高达92.9分
**关键发现:** 中国IP的平均威胁评分显著低于其他国家,但这并不意味着威胁程度真的更低。
### 高攻击频率IP的漏报问题
我们发现了**42个高风险IP**(占总数1.24%),它们具有以下特征:
- 攻击次数超过10次
- AbuseIPDB置信度却低于50%
- 其中包括一个对SSH进行**超过1万次暴力破解**的IP
更令人担忧的是,还有**17个IP**(0.50%)在AbuseIPDB中完全没有记录。这些”隐身杀手”如果仅依赖外部威胁情报,将完全无法识别。
### 中国安徽网段IP的评分异常
在1,277个中国IP中,**692个**来自中国某通信公司安徽网络,但这些IP的平均威胁评分仅为16.0分。这一异常低的评分与其实际的攻击行为严重不符,表明AbuseIPDB对中国某些运营商网络的覆盖存在明显盲区。
## 免费用户的现实困境
### 功能限制的影响
AbuseIPDB对免费用户设置了以下限制:
- 每日API查询限额:1,000-5,000次
- 黑名单下载限制:10,000条(仅占总量的10%)
对于低流量的网站(比如本站日均请求量大于1千)绰绰有余。但对于中等流量的网站,这些限制在实际运维中显得捉襟见肘,每日5,000次的查询额度可能连基本的日志分析都无法满足。
### 威胁标签粒度不足
虽然AbuseIPDB提供了威胁分类标签,但对于特定业务场景(如博客站点的恶意爬虫防护)来说,标签粒度仍然不够细致,无法实现精准的针对性防护。
在实际为蜜罐捕获的攻击行为打标签时,我常常面临选择困境。AbuseIPDB提供的分类看似丰富,但在具体场景下却显得“高不成低不就”。这并非平台之过,而是通用型威胁情报在面对个性化防御需求时必然出现的鸿沟。
为了更清晰地展示这个问题,我将AbuseIPDB的官方分类整理成了下表:
**AbuseIPDB 威胁分类标签(中文版)**
ID威胁类型说明与局限性1**DNS劫持**篡改DNS记录导致错误重定向。2**DNS投毒**伪造域名服务器缓存。3**欺诈订单**虚假订单,主要针对电商。4**DDoS攻击**参与分布式拒绝服务攻击(通常是僵尸网络的一部分)。5**FTP暴力破解**针对性很强,但与其他暴力破解分开。6**死亡之Ping**发送超规IP数据包。**过于陈旧的攻击方式**。7**网络钓鱼**钓鱼网站和/或邮件。8**VoIP欺诈**9**开放代理**开放代理、中继或Tor出口节点。**许多爬虫、扫描器会使用,但本身不直接等于攻击**。10**网站垃圾**评论/论坛垃圾、HTTP来源垃圾等。11**垃圾邮件**垃圾邮件内容、病毒附件、钓鱼邮件。12**博客垃圾**CMS博客评论垃圾。**与“网站垃圾”标签存在重叠**。13**VPN IP**关联类别。**VPN IP本身是中性工具,难以直接判定善恶**。14**端口扫描**扫描开放端口和脆弱服务。**是攻击的前奏,但本身破坏性低**。15**黑客攻击****过于笼统,等于没有分类**。16**SQL注入**尝试SQL注入攻击。17**欺骗**邮件发件人欺骗。18**暴力破解**对网页登录、SSH、FTP、RDP等服务进行凭证破解。**覆盖范围广,但无法区分具体攻击的服务**。19**恶意网络机器人**网页抓取、不遵守爬虫协议的爬虫。**这是最接近“恶意爬虫”的标签,但粒度依然很粗**。20**被利用的主机**主机可能已感染恶意软件。**通常与其他类别结合使用,本身不描述攻击行为**。21**Web应用攻击**尝试探测或利用已安装的Web应用程序(如CMS、电商平台)。**覆盖范围极广,从扫描到漏洞利用都包含在内**。22**SSH**SSH滥用。**必须与其他类别结合使用,单独使用意义不明**。23**物联网定向攻击**针对“物联网”设备的滥用。
通过上表,我们可以清晰地看到标签系统存在的几个核心问题:
1. **粒度不均,部分标签过于陈旧或宽泛**:像`黑客攻击`这样的标签几乎无法提供任何有效信息;而`死亡之Ping`在现代网络环境中已很少见。
2. 关键标签缺失,无法满足精细化防护:以博客站最关心的恶意爬虫为例,我们并不能单独下载**恶意网络机器人**黑名单。
3. **标签存在重叠和模糊地带**:`网站垃圾 (10)`和`博客垃圾 (12)`如何精确区分?`暴力破解 (18)`与`FTP暴力破解 (5)`、`SSH (22)`又该如何组合使用?观察其他AbuseIPDB用户上报的内容,其标签可谓千奇百怪。
4. **中性行为与恶意行为混杂**:`开放代理`和`VPN IP`本身是技术中性的,大量正常用户也会使用。将它们直接标记为威胁,可能导致误封,这对于面向广大网民的服务而言需要非常谨慎。
## 完善方案:构建混合防护体系
- **本地蜜罐数据优先**:应优先将本地蜜罐捕获的IP地址作为黑名单的来源。这些IP已被确认具有恶意行为,针对性强且误报率低,响应及时,无需等待外部平台更新。
- **多层情报融合**:建议采用分层的防护策略。 第一层:本地蜜捕获IP(立即封锁) 第二层:AbuseIPDB高置信度IP(≥90%) 第三层:其他威胁情报源数据 第四层:行为分析规则(应对零日攻击)
- **自动化运维流程**:应建立黑名单自动更新机制。流程包括:蜜罐捕获新IP → 自动查询威胁情报 → 高风险IP自动加入防火墙。这样可以提升响应速度与系统安全性。
## 结论
AbuseIPDB作为全球化的威胁情报平台,在国际网络威胁检测方面表现出色,但在中国网络环境中存在明显的区域性偏差。免费用户获得的黑名单有限,防护能力一般。
**最佳实践是采用”内外结合”的策略**:以本地蜜罐数据为核心,以AbuseIPDB等外部情报为补充,构建符合自身业务特点的多层防护体系。
在网络安全领域,没有银弹。真正的安全来自于持续监控、及时响应和深度防御。黑名单只是安全体系中的一环,结合其他安全措施才能构建真正可靠的防护网络。
---
*本文数据基于2025年11月13日至11月20日Hfishi蜜罐系统、11月20日AbuseIPDB数据,分析结果仅供参考。具体防护策略请根据实际业务需求进行调整。*
====
# 【降维分析】 声音的可视化探索:从鸟叫到声纹识别
https://www.paddysun.top/archives/4387 · 2025-11-19
最近我看到了一个有趣的视频[【鸟叫声的三维体现】](https://www.bilibili.com/video/BV1aixAz1EZg/?share_source=copy_web&vd_source=3982ec416caf3ff4e458d45d8f81ec12) ,通过某种算法将鸟叫声绘制在了三维坐标中。这让我产生了强烈的好奇心:这样的可视化有什么意义?它能用来做什么?
## 初探声音的”三维世界”
声音本质上是一种振动,传统上我们使用波形图或频谱图来表示它。
> 想象你要记录一个连续变化的波浪。如果你只用文字描述这个波浪,可能会很困难。但如果你沿着波浪每隔一段固定距离就测量一次高度,然后把所有这些高度值连起来,就能近似地还原出波浪的形状。
>
> **数字照片是空间的高维结构**:每个像素有RGB三个值,所有像素组成的矩阵就是照片的高维表示。相邻像素间的空间关系构成了图像内容。
>
> **数字音频是时间的高维结构**:每个采样点单个像素,看似只是振幅数字。但连续采样点间的时间关系(波形变化)构成了声音的“图像”。就像像素组合成边缘、纹理,采样点组合成音调、音色等听觉特征。
然而波形图或频谱图,并不能反应人的音色,语言的句式结构等复杂信息。但将声音映射到三维空间,让我们能够从全新的角度观察声音的特征和结构。
我首先尝试使用主成分分析(PCA)技术,将两首不同风格歌曲的音频数据进行降维处理。每段音频都被分割成许多小片段,每个片段有60多个特征维度,我使用PCA将这些高维数据压缩到我们能够直观理解的三维空间。
> **简单解释一下PCA**:想象你有一堆在多个维度上分布的数据点,我们没办法视觉观察高纬结构的特征。所以PCA的目标就算找到一个最佳的观察角度,让你能在三维空间中看到这些高纬数据点之间最明显的差异。
分析结果很有趣:
- 两首歌的中心点明显分离,距离达到4.3个单位
- 它们的分布范围也不同,表明音频特征有显著差异
- 在三维空间中,两首歌的音频片段确实分布在不同的区域
```
=== 统计分析结果 ===
歌曲1中心点: [-2.09450279 -0.37006448 -0.31934641]
歌曲2中心点: [2.09450279 0.37006448 0.31934641]
两首歌中心点距离: 4.3016
歌曲1分布范围(标准差): [1.91407585 2.50499429 1.57101622]
歌曲2分布范围(标准差): [0.96306112 1.66113684 1.84670616]
两首歌音频特征相似度: 差异较大
```
## 从音乐到人声:声纹识别的可能性
这个发现让我产生猜想:既然不同歌曲在声音空间中位置不同,那么不同人的说话声音是否也会有独特的”空间签名”?代表着人的口音,嗓音粗细等信息。这可能是声纹识别的一种新思路。
验证思路就算对比人声在空间中的分布,看看会不会不同?
于是我邀请了一位朋友(男性,带有闽南语口音)与我(男性,普通话略好一丢丢,QaQ)一起朗读同一段文字,使用相同的录音设备。结果印证了猜想。
#### PCA结果:
```
人声朗读对比
PCA
=== 统计分析结果 ===
A中心点: [0.23291338 1.0100605 0.32674812]
B中心点: [-0.23291338 -1.0100605 -0.32674812]
两人声朗读中心点距离: 2.1737
A分布范围(标准差): [2.19198087 1.53562504 1.61154289]
B分布范围(标准差): [2.5012327 1.57993654 1.35136674]
两人声朗读特征相似度: 差异较大
```
诶确实,可以发现。两个人的声音在这个二维空间中被分开了。而且从PCA的结果可以看出高能量的采样点都集中于维度1的正方向上,且二人采样点分离较开,产生假设一:高能量声音更能区分每个人的说话特征。
**PCA分析结果**:
- 两个人的声音中心点距离为2.17个单位
- 分布范围相似但位置明显分离
- 高能量的声音片段(音量较大的部分)更集中在特定方向
#### TSNE结果:
> **简单解释t-SNE**:与PCA不同,t-SNE更注重保留数据点之间的局部关系,特别擅长展现数据中的聚类结构。
```
=== 统计分析结果 ===
TSNE
A中心点: [-0.73746437 5.762217 4.046767 ]
B中心点: [ 0.27417228 -5.641561 -3.668627 ]
两人声朗读中心点距离: 13.8057
A分布范围(标准差): [11.39428 9.830946 10.227653]
B分布范围(标准差): [14.40624 9.117463 10.810812]
两人声朗读特征相似度: 差异较大
```
并且TSNE的结果中,各自的部分采样点连了一起,呈现出一定的线性结构,这与TSNE的原理有关,且也符合发同一音时的变化是连续的特征,产生假设二:能否用这种特性来进行语音识别?也就是比如每个人发“啊”音时,其在空间中的点列形状是相似的,只是位置不同(位置代表了各人发声特点)
## 扩大实验规模:四人朗读分析
为了验证这一发现的普适性,我又邀请了3位朋友,连上自己一共4人,使用不同的录音设备朗读同一段文字。
#### PCA结果:


可以发现,在PCA的结果中,整体上看各人的采样点范围重合,部分混杂在了一起,没有清晰的边界,但依然有着各自不同的分布范围。并且我们可以发现高能量(深色)的采样点都集中于维度1的正方向上,有维度1值越大,各人采样点越分散的趋势。
#### TSNE结果


可以看出TSNE的边界,比PCA结果更加清晰。保留了明显的线性结构,这可能对应着发音时的连续变化过程。
#### 时间维度上的发现
最有趣的是,当我观察声音点在三维空间中随时间变化的动画时,发现那些连成线的结构确实对应着时间上连续的声音片段:
*声音点在t-SNE空间中的时间演化,可见连续发音形成线性结构*
这提示了一个有趣的可能性:每个人发同一个音时,其在空间中的轨迹形状可能是相似的,只是位置不同——位置反映了个人发声特点,而轨迹形状可能反映了发音内容。
## 实际应用与展望
这种声音可视化技术有多个潜在应用方向:
1. **声纹识别**:每个人的声音在特征空间中有独特分布,可用于身份验证
- [【聚类分析】降维聚类判断是谁在说话](https://paddysun.top/archives/4417)
2. **语音识别**:相似的发音可能在空间中形成相似的轨迹模式
3. **医学诊断**:某些嗓音疾病可能导致声音在特征空间中的分布异常
4. **语音教学**:可视化母语者与学习者的发音差异,提供直观反馈
这项探索表明,将声音映射到可视空间不仅能帮助我们理解声音的本质,还可能为声音相关的技术应用提供新的思路。虽然目前的实验还比较简单,但已展现出令人兴奋的可能性。
声音不再只是听觉的体验,通过数据可视化,我们能够”看见”声音的独特指纹,探索每个人声音的独特性。这或许就是那部将鸟叫声可视化的视频背后的深层意义——让我们从新的维度理解和欣赏声音世界的丰富性与多样性。
====
# 【数学建模】000 从问题到解决方案
https://www.paddysun.top/archives/4342 · 2025-11-05
## 数学建模核心算法与方法论:从问题到解决方案
### 1. 数学建模流程全解析
#### 1.1 典型建模流程
数学建模本质上是从现实问题出发,通过数学模型来描述问题的过程。一个典型的建模过程可以分为以下几个步骤:
- **问题分析与抽象**:明确问题的核心,从复杂现象中提炼关键因素,定义模型假设条件。
- **模型选择**:根据问题类型和数据特征选择合适的建模方法。
- **算法实现**:实现选择的模型,并通过编程语言(如Python)编码。
- **结果验证**:对模型结果进行验证,确保结果的准确性和合理性。
- **模型优化**:根据验证结果调整模型参数或改进模型,直到满足需求。
**案例:** 基于电商商品销售数据的交叉销售预测
1. 明确目标:预测哪种商品是顾客最有可能再次购买的商品。
2. [数据预处理](https://paddysun.top/archives/4340):清洗数据,补充缺失值,特征选择。
3. 建立模型:如[逻辑回归](https://paddysun.top/archives/4344)。
4. 训练与验证模型。
5. 结果:对模型结果进行调整与优化,如增加样本量或改进特征。
#### 1.2 模型选择方法论
**代码框架示例:**
```
def model_selection_guide(problem_type, data_size, feature_type):
if problem_type == "classification":
if data_size < 1000:
return "SVM或决策树"
else:
return "随机森林或XGBoost"
elif problem_type == "regression":
return "线性回归、多项式回归或Lasso回归"
else:
return "未定义"
```
### 2. 基础数学模型详解
#### 2.1 优化模型
- **线性规划**:使用单纯形法和内点法求解最优解。
- **整数规划**:分支定界法和割平面法解决含有整数变量的问题。
- **非线性规划**:利用梯度下降法和牛顿法优化模型。
#### 2.2 概率统计模型
- **[回归分析](https://paddysun.top/archives/4344)**:线性、逻辑、多项式等不同类型的回归。
- **[时间序列分析](https://paddysun.top/archives/4350)**:如ARIMA模型或状态空间模型。
- **[蒙特卡洛模拟](https://paddysun.top/archives/4356)**:随机抽样用于模拟复杂系统的行为。
### 3. 机器学习核心算法
#### 3.1 监督学习
```
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from xgboost import XGBClassifier
models = {
"随机森林": RandomForestClassifier(),
"支持向量机": SVC(),
"XGBoost": XGBClassifier()
}
```
#### 3.2 无监督学习
- **[聚类分析](https://paddysun.top/archives/4417)**:包括K-means、DBSCAN、层次聚类等方法。
- **[降维技术](https://paddysun.top/archives/4387)**:如PCA、t-SNE和UMAP。
- **关联规则**:如Apriori算法。
### 4. 现代智能优化算法
#### 4.1 元启发式算法
- **遗传算法**:基于自然选择的原理。
- **粒子群优化**:通过模拟鸟群的飞行行为进行搜索。
- **模拟退火**:模拟降温过程寻找全局最优。
#### 4.2 深度学习模型
- **神经网络基础**:前向传播和反向传播算法。
- **卷积神经网络(CNN)**:用于图像处理。
- **循环神经网络(RNN)**:处理序列数据。
- **Transformer架构**:用于自然语言处理。
- **自编码器**:学习数据的底层表示。
- **生成对抗网络(GAN)**:生成新的数据实例。
### 5. 评价指标与验证方法
#### 5.1 模型评估指标
- **分类问题**:准确率、精确率、召回率、F1-score、AUC-ROC。
- **回归问题**:MSE、MAE、R²、调整R²。
- **聚类问题**:轮廓系数、Calinski-Harabasz指数。
- **时间序列预测**:MAE(平均绝对误差)、MAPE(平均绝对百分比误差)等。
- **异常检测:**FPR(假阳性率)、TPR(真正性率)等。
#### 5.2 验证策略
- **交叉验证**:k折交叉验证、分层k折交叉验证。
- **自助法(Bootstrap)**:通过重复抽样进行模型评估。
- **统计显著性检验**:使用t-test、ANOVA等方法验证模型效果的显著性。
### 6. 实际建模案例解析
#### 6.1 预测类问题
- **股票价格预测**:使用时间序列模型(如ARIMA)结合LSTM。
- **用户流失预测**:通过分类模型(如LR或XGBoost)进行预测。
#### 6.2 优化类问题
- **物流路径优化**:使用遗传算法结合TSP(旅行商问题)。
- **资源分配优化**:线性规划或整数规划方法解决问题。
#### 6.3 分类聚类问题
- **客户细分**:应用K-means结合RFM(Recency、Frequency、Monetary)模型。
- **异常检测**:使用孤立森林或自编码器模型。
### 7. 模型优化与调参技术
#### 7.1 超参数优化
```
from sklearn.model_selection import GridSearchCV
param_grid = {
'n_estimators': [100, 200, 300],
'max_depth': [3, 5, 7]
}
grid_search = GridSearchCV(RandomForestClassifier(), param_grid, cv=5)
grid_search.fit(X_train, y_train)
```
#### 7.2 集成学习方法
- **袋装法(Bagging)**:使用随机森林。
- **增强法(Boosting)**:包括AdaBoost、GBDT和XGBoost。
- **堆叠法(Stacking)**:使用多层模型融合技术。
### 8. 建模工具与实战技巧
#### 8.1 常用工具对比
- **Python生态**:scikit-learn、TensorFlow、PyTorch。
- **R语言**:caret包、ggplot2可视化。
- **专业软件**:MATLAB、LINGO。
#### 8.2 实战经验分享
- **特征工程中的陷阱与解决方案**:特征选择、数据变换。
- **过拟合的识别与预防**:交叉验证、正则化。
- **模型部署与监控的最佳实践**:云平台部署、实时监控与维护。
---
通过这些章节的详细说明,希望能为读者提供一个全面而实用的数学建模学习指南。无论是学术研究还是实际应用,这些知识都极具参考价值。
====
# 【数学建模】004 蒙特卡罗模拟数学原理
https://www.paddysun.top/archives/4356 · 2025-11-05
蒙特卡罗方法 Monte Carlo methods,或称蒙特卡罗实验 Monte Carlo experiments,一大类计算算法的集合,依靠重复的随机抽样来获得数值结果。基本概念是利用随机性来解决理论上可能是确定性的问题。蒙特卡洛模拟是十分常用,使用广泛(计算机模拟,最优化,数值积分,依据概率分布生成图像等等)的方法。其他例子包括:对输入中具有重大不确定性的现象进行建模,如商业中的风险计算,以及在数学中对具有复杂边界条件的多维定积分进行评估。在系统工程问题(空间、石油勘探、飞机设计等)的应用中,基于蒙特卡罗的故障预测、成本超支和进度超支通常比人类的直觉或其他的“软性”方法更有效。
在物理学相关问题中,蒙特卡罗方法可用于模拟具有多个耦合自由度的系统,如流体、无序材料、强耦合固体和细胞结构(参见细胞波茨模型 Cellular Potts Model、相互作用粒子系统 Interacting Particle Systems、麦肯-弗拉索夫过程 McKean-Vlasov Processes、气体动力学模型 Kinetic Models of Gases)。
中国科学院高能物理研究所蒙特卡罗模拟数学原理什么是蒙特卡罗模拟 中国科学院高能物理研究所
[https://mp.weixin.qq.com/s/Fid3BY5ArhHx7dxHnU1PMg](https://mp.weixin.qq.com/s/Fid3BY5ArhHx7dxHnU1PMg)实例:估计π值ximport randomimport matplotlib.pyplot as pltimport numpy as np
def estimate_pi(num_samples): """ 使用蒙特卡罗方法估计π值,并返回估计结果列表。 参数: num_samples (int): 随机样本的数量。 返回: list: 包含每次迭代后π的估计值。 """ circle_points = 0 pi_estimates = [] for i in range(1, num_samples + 1): # 生成一个随机点(x, y),位于[-1, 1] x [-1, 1]内 x = random.uniform(-1, 1) y = random.uniform(-1, 1) # 计算点到原点的距离 distance = x**2 + y**2 # 如果点在单位圆内,则增加circle_points计数 if distance <= 1: circle_points += 1 # 计算π的估计值 pi_estimate = 4 * circle_points / i pi_estimates.append(pi_estimate) return pi_estimates
# 设置随机样本数量num_samples = 100000
# 调用函数估计πpi_estimates = estimate_pi(num_samples)
# 定义y轴刻度标签的格式化函数def format_yaxis(value, tick_number): # 找到π的倍数 N = int(np.round(value / np.pi)) if N == 0: return "0" elif N == 1: return r"\pi" else: return rf"{N}\pi"
# 绘制π估计值随样本量增加的变化曲线plt.figure(figsize=(10, 6))plt.plot(range(1, num_samples + 1), pi_estimates, label='Estimated π')plt.axhline(y=np.pi, color='r', linestyle='--', label='Actual π')
# 设置y轴的刻度标签plt.gca().yaxis.set_major_locator(plt.MultipleLocator(np.pi))plt.gca().yaxis.set_major_formatter(plt.FuncFormatter(format_yaxis))
# 设置其他图表元素plt.xlabel('Number of Samples')plt.ylabel('Estimate of π')plt.title('Estimation of π Using Monte Carlo Method')plt.legend()plt.grid(True)plt.show()实例:测试保险产品的风险测试**年龄分布生成**我们先创建了0到100岁范围的年龄段,并使用了**Dirichlet分布**随机生成不同年龄段的概率,这样可以模拟真实的人口年龄结构。使用`numpy.random.choice`函数,根据年龄分布的概率随机生成了10,000个客户的年龄。**寿命模拟**假设寿命服从**正态分布**,均值为75岁,标准差为10岁,生成了每个客户的预期寿命。为了保证合理性,将寿命限制在0到120岁之间。**年金支付模拟**每个客户领取年金的年数是他们的寿命减去当前年龄,如果寿命大于当前年龄则计算年金支付年数,否则不支付年金。假设年金每年支付1000元,计算每个客户的年金总支付额。**蒙特卡洛模拟**通过对10,000个客户的随机年龄和寿命模拟,程序多次重复此过程,最终通过大量随机试验近似计算整个客户群体的年金保险总支付金额。蒙特卡洛模拟通过大量随机样本反复计算,得出年金支付的平均、最大、最小等统计结果,帮助分析风险。此方法有效地模拟了年金保险的风险和不确定性,并通过模拟结果帮助决策者评估风险敞口。xxxxxxxxxximport numpy as npimport matplotlib.pyplot as plt
# 假设你有不同年龄段的年龄分布,比如0-100岁ages = np.arange(0, 101)# 设定一个假设的概率分布,真实情况下应根据普查数据获得probabilities = np.random.dirichlet(np.ones(len(ages)), size=1)[0]
# 蒙特卡洛模拟生成客户群体N = 10000 # 假设生成1万个客户simulated_ages = np.random.choice(ages, size=N, p=probabilities)
# 假设寿命服从正态分布,均值为75岁,标准差为10lifetimes = np.random.normal(loc=75, scale=10, size=N)# 过滤掉不合理的寿命,比如负数或超过某个最大寿命的值lifetimes = np.clip(lifetimes, a_min=0, a_max=120)
# 模拟年金保险支付情况,假设每年支付1000元年金annual_annuity_payment = 1000
# 计算每个客户的领取年金年数annuity_years = np.maximum(lifetimes - simulated_ages, 0)
# 计算年金总支付额total_annuity_payments = annuity_years * annual_annuity_payment
# 显示模拟的人群年龄分布和寿命分布fig, axs = plt.subplots(2, 1, figsize=(8, 10))
# 人群年龄分布axs[0].hist(simulated_ages, bins=30, color='skyblue', edgecolor='black')axs[0].set_title("Age Distribution of Simulated Clients")axs[0].set_xlabel("Age")axs[0].set_ylabel("Number of Clients")
# 寿命分布axs[1].hist(lifetimes, bins=30, color='lightgreen', edgecolor='black')axs[1].set_title("Lifetime Distribution")axs[1].set_xlabel("Age at Death")axs[1].set_ylabel("Number of Clients")
plt.tight_layout()plt.show()
# 显示总年金支付额的描述性统计total_annuity_summary = { "Mean Total Annuity Payments": np.mean(total_annuity_payments), "Median Total Annuity Payments": np.median(total_annuity_payments), "Max Total Annuity Payments": np.max(total_annuity_payments), "Min Total Annuity Payments": np.min(total_annuity_payments), "Total Payments (Sum)": np.sum(total_annuity_payments)}
import pandas as pdsummary_df = pd.DataFrame(total_annuity_summary, index=["Values"])蒙特卡洛树搜索**MCTS**蒙特卡洛模拟在棋类游戏和博弈论模型中的应用,主要体现在**蒙特卡洛树搜索(Monte Carlo Tree Search, MCTS)**,这是一种强大的搜索算法,常用于决策问题中的策略优化。以下是一些经典的实例:1. **围棋中的蒙特卡洛树搜索(AlphaGo)****背景**:围棋是一个极为复杂的棋类游戏,棋盘上存在极其庞大的可能性空间,传统的穷举搜索方法几乎无法有效应用于围棋。**AlphaGo**:谷歌的AlphaGo在围棋中使用了蒙特卡洛树搜索与深度学习结合的技术来选择最优策略。MCTS在每个节点上进行随机模拟(又称为**Playout**),通过模拟随机对局来评估当前节点的潜在获胜概率。经过大量模拟之后,MCTS可以选择那些获胜概率更高的决策路径。**MCTS流程**:**选择(Selection)**:根据已知信息(如获胜概率)从根节点到子节点,逐步选择未完全扩展的节点。**扩展(Expansion)**:如果当前节点未终结游戏,扩展一个新的子节点。**模拟(Simulation)**:从新扩展的节点开始进行一次随机的完全对局模拟,直到游戏结束。**反向传播(Backpropagation)**:根据模拟的结果,更新从当前节点到根节点之间所有节点的获胜概率。AlphaGo 通过结合MCTS和神经网络评估函数,使其在围棋领域实现了突破,成功击败了人类顶级选手。2. **国际象棋中的MCTS(Leela Chess Zero)****背景**:国际象棋也是一种具有巨大决策空间的棋类游戏,虽然比围棋复杂度稍低,但仍然不容易通过传统穷举法找到最优策略。**Leela Chess Zero**:类似于AlphaGo的围棋算法,Leela Chess Zero也结合了蒙特卡洛树搜索和神经网络评估函数。在棋局的每个状态下,MCTS通过模拟一系列随机的对局过程来评估某个动作的有效性。Leela Chess Zero通过大量模拟和训练,逐步提升其对棋局的理解和决策能力。**具体过程**:系统通过模拟大量可能的棋局走法,在棋盘上扩展不同的分支,反复评估各个分支的结果,从而选择获胜概率最大的策略。3. **博弈论模型中的蒙特卡洛模拟(扑克与其他对抗性游戏)****背景**:扑克等对抗性博弈游戏中,玩家的策略选择需要考虑对手的反应和未来可能的牌局变化,博弈空间非常庞大且存在信息不完全的问题。**DeepStack与Libratus(扑克AI)**:这些扑克AI使用了MCTS与博弈论中的**纳什均衡**相结合的技术,通过蒙特卡洛模拟评估不同对局的可能结果。特别是在不完全信息的场景下(如对手牌未知),AI通过大量随机模拟可能的牌局走向和对手反应,来选择最有利的策略。**MCTS在扑克中的应用**:**信息集处理**:在扑克中,部分信息对玩家不可见(如对手的手牌),MCTS可以通过模拟对手可能持有的手牌集合,推测最优策略。**模拟对局**:通过随机模拟未来可能的发牌和下注过程,预测对手的策略反应,从而调整自己的策略选择。4. **博弈树搜索中的MCTS(一般博弈论问题)****背景**:在博弈论模型中,双方的策略会相互影响,双方都试图通过预测对手的行为来做出最佳决策。**应用实例**:在简单的博弈论问题中,比如经典的**囚徒困境**或**市场竞争模型**,玩家可以通过MCTS进行模拟,预测在对方采取某种策略的情况下自己的最佳回应。MCTS通过大量的策略模拟,逐步找到一种接近纳什均衡的解,从而选择最优的博弈策略。5. **Hex棋中的MCTS****背景**:Hex棋是一种棋类游戏,其目标是在棋盘上连接两个对边。Hex棋的复杂性较高,传统搜索算法难以处理。**应用实例**:MCTS在Hex棋中非常有效,通过模拟大量对局,随机生成不同的棋步组合,并通过模拟的结果判断每个棋步的胜算几率。MCTS逐步扩展每个节点的搜索树,并更新获胜概率,从而帮助玩家做出更优的策略选择。实例:井字棋**MCTS**决策xxxxxxxxxximport randomimport mathfrom copy import deepcopy
# 定义井字棋游戏class TicTacToe: def __init__(self): self.board = [[' ' for _ in range(3)] for _ in range(3)] self.current_player = 'X'
def make_move(self, row, col): if self.board[row][col] == ' ': self.board[row][col] = self.current_player self.current_player = 'O' if self.current_player == 'X' else 'X' return True return False
def get_winner(self): # 检查行、列、对角线是否有赢家 for i in range(3): if self.board[i][0] == self.board[i][1] == self.board[i][2] != ' ': return self.board[i][0] if self.board[0][i] == self.board[1][i] == self.board[2][i] != ' ': return self.board[0][i] if self.board[0][0] == self.board[1][1] == self.board[2][2] != ' ': return self.board[0][0] if self.board[0][2] == self.board[1][1] == self.board[2][0] != ' ': return self.board[0][2] return None
def is_full(self): return all(self.board[i][j] != ' ' for i in range(3) for j in range(3))
def get_available_moves(self): return [(i, j) for i in range(3) for j in range(3) if self.board[i][j] == ' ']
def clone(self): return deepcopy(self)
# 定义MCTS节点class Node: def __init__(self, state, parent=None): self.state = state self.parent = parent self.children = [] self.visits = 0 self.wins = 0 self.untried_moves = state.get_available_moves()
def is_fully_expanded(self): return len(self.untried_moves) == 0
def best_child(self, c_param=1.4): choices_weights = [ (child.wins / child.visits) + c_param * math.sqrt((2 * math.log(self.visits) / child.visits)) for child in self.children ] return self.children[choices_weights.index(max(choices_weights))]
def expand(self): move = self.untried_moves.pop() new_state = self.state.clone() new_state.make_move(*move) child_node = Node(new_state, parent=self) self.children.append(child_node) return child_node
def update(self, result): self.visits += 1 if result == 'X': self.wins += 1
# MCTS主函数def mcts(root_state, iterations=1000): root_node = Node(root_state)
for _ in range(iterations): node = root_node state = root_state.clone()
# 选择阶段:找到未完全扩展的节点 while not node.is_fully_expanded() and node.children: node = node.best_child()
# 扩展阶段:如果节点没有完全扩展,扩展一个子节点 if node.untried_moves: node = node.expand()
# 模拟阶段:随机模拟一局游戏直到结束 while not state.is_full() and state.get_winner() is None: available_moves = state.get_available_moves() move = random.choice(available_moves) state.make_move(*move)
# 反向传播阶段:根据模拟结果更新节点 winner = state.get_winner() while node is not None: node.update(winner) node = node.parent
return root_node.best_child(c_param=0).state
# 游戏测试def print_board(state): for row in state.board: print(' | '.join(row)) print('-' * 5)
if __name__ == "__main__": game = TicTacToe()
while game.get_winner() is None and not game.is_full(): print("Current board:") print_board(game)
if game.current_player == 'X': print("MCTS is thinking...") game = mcts(game, iterations=1000) else: move = input("Enter your move (row, col): ").split(',') game.make_move(int(move[0]), int(move[1]))
print("Game Over") print_board(game) winner = game.get_winner() if winner: print(f"The winner is {winner}!") else: print("It's a draw!") 物理模拟计算机对于物理的模拟是非连续的,我们只能按照一定时间间隔(Tick)去计算全局物理量。最经典的例子为FPS游戏中的弹道模拟、命中判定。FPS中的计算机模拟费力不讨好的FPS核心逻辑:命中判定,什么是延迟补偿,服务器tick,以及为什么会吞子弹
[https://www.bilibili.com/video/BV1Ne411D7HB/?spm_id_from=333.1007.top_right_bar_window_history.content.click&vd_source=d482d60c82056fef722a6116dbfed026](https://www.bilibili.com/video/BV1Ne411D7HB/?spm_id_from=333.1007.top_right_bar_window_history.content.click&vd_source=d482d60c82056fef722a6116dbfed026)
[1]梁白鸥.实时网络游戏中关键技术的研究与实现[D].电子科技大学,2007.
[实时网络游戏中关键技术的研究与实现_梁白鸥.pdf](https://uploader.shimo.im/f/HfztgEQ2Q98YhUak.pdf)
在第一人称射击(FPS)场景中,诸如击杀、受伤等事件通常是瞬间发生的。然而,计算机需要一定的时间来进行判定计算,例如确定这些事件是否发生、玩家如何移动等。这使得计算机只能每隔一段时间间隔tTickt_{Tick}(最短小于一次判定计算花费的时间)。具体来说,计算机需要利用texcutet_{excute}时间点的信息(玩家位置,状态),来进行判定计算。以texcute−tTickt_{excute}-t_{Tick}时刻的玩家状态,texcute−tTickt_{excute}-t_{Tick}时刻至texcutet_{excute}时刻之间的玩家操作,依照游戏规则来给出下一个时间点texcute+tTickt_{excute}+t_{Tick}时刻玩家的状态。这一过程不断重复,从而完成了整个游戏的模拟。此过程中需要通过不同数学算法来进行计算。弹道轨迹模拟算法基于射击参数,使用抛物线方程(也可以之间)来计算子弹的飞行路径(x,y位置)。这个过程可以通过调整子弹初速度来考虑不同枪械种类的影响。y=−12gt2+v0sin(θ)t+y0x=v0cos(θ)t+x0\begin{aligned}&y=-\frac{1}{2}gt^{2}+v_{0}\sin(\theta)t+y_{0}\\&x=v_0\cos(\theta)t+x_0\end{aligned}g 是重力加速度(大约为 9.8 m/s²)。t 是时间。v0 是子弹的初速度。θ 是发射角度。y0和x0分别是子弹发射时的初始高度和水平位置。若不考虑子弹下坠,即高速短距离射击,或者是激光枪。则可以使用直线方程如下。y−y0=tanθ(x−x0)y-y_0=\tan \theta (x-x_0)概率的射击算法**射击圆形物体**其中r是目标的半径。σx\sigma_x是方向子弹离圆心的偏差。由于射击是依概率的因此当计算点不在射击目标范围内的时候由于其它因素如武器的质量、使用者的稳定性和技术、各种不同弹道发射器的机械结构以及风速风向情况使得也可能打中目标因此可取2r为一个界限,来判定是否有可能射中目标。因此在2R范围内的射击都是有效范围。Px={1σx=01−e−(r2/2σx2)0<σx≤2r0σx>2rP_x=\begin{cases}1&\sigma_x=0\\1-e^{-(r^2/2\sigma_x^2)}&0<\sigma_x\leq2\text{r}\\0&\sigma_x>2\text{r}\end{cases}
**弹片的影响**导弹一般很少直接命中飞机。导弹一般会到达一个“最接近点” 然后在飞机附近引爆。之后导弹的碎片从爆炸点呈环或球状散开飞机被弹片命中继而被摧毁。这个算法可以用于爆炸性投射武器、火球来瞄准飞机等敌人计算弹片影 响的概率公式如下。
x=nAν2πr2(cosϕ1−cosϕ2)Px=1−e−x\begin{aligned}&x=\frac{nA_{\nu}}{2\pi r^{2}(\cos\phi_{1}-\cos\phi_{2})}\\&P_{x}=1-e^{-x}\end{aligned}
其中n是导弹头的碎片数目; AνA_{\nu}是目标相对于导弹的攻击面,以平方米为单位;r是从爆炸点到目标的距离,以米为单位;ϕ1\phi_{1}是从导弹弹道到最近目标攻击范围边缘的角度;ϕ2\phi_{2}是从导弹弹道到最远目标攻击范围边缘的角度。射击的延迟补偿网络游戏的模拟一般在服务器进行。所有的玩家操作都需要上传到服务器。数据到达服务器之前服务器仍然在不停的模拟整个游戏世界,同时,玩家在此期间也在进行新的操作。例如:一个玩家在时刻10.50秒的时候向一个目标射击 射击的信息被打包发送到服务器上,10.60秒的时候,该射击数据到达服务器。而射击对象的网络延迟较低,其新的位置信息已经在10.55秒到达了服务器,服务器在10.60秒时按照玩家射击数据进行判断时,射击对象已经不在10.50秒的位置,由此服务器判断未打中。因此可能给玩家呈现一个不真实的现象本来在客户端上已经打到目标但是实际上有服务器仲裁的结果却并没有打到。**基于历史信息的延迟补偿**由此,可以在服务器和客户端上都保存玩家的各个时刻的历史状态信息。假设当前的网络延迟为LnetworkL_{network}、 同步延迟为LsynL_{syn}当前的服务器的时间为tservert_{server}。 服务器预测的命令执行时间为texcutet_{excute}那么预测的命令执行时间的计算公式为texcute=tserver−Lnetwork−Lsynt_{excute}=t_{server}-L_{network}-L_{syn}
即服务器会根据所保存的历史信息。使用texcutet_{excute}时刻的玩家信息进行判断。然和不同玩家之间的网络延迟为LnetworkL_{network}和同步延迟LsynL_{syn}均不同。若使用射击方玩家的网络延迟LnetworkL_{network}和同步延迟LsynL_{syn}。则对于射击对象来说,可能会产生在客户端已经躲开,但仍然被射中的,延迟中弹的,情况。
====
# ARMA模型识别与选择
https://www.paddysun.top/archives/4352 · 2025-11-05
ARMA模型识别与选择
ARMA模型识别与选择**自相关与偏自相关:ARMA模型的“指纹识别器”**要为一个平稳的非白噪声序列选择合适的ARMA模型,我们需要工具来识别其内在结构。**自相关函数(ACF)** 和**偏自相关函数(PACF)** 就是这样的工具,它们的作用类似于“指纹”,不同的模型会留下独特的ACF和PACF模式。**1. 自相关函数 (ACF – Autocorrelation Function)****核心思想**:衡量时间序列 Xt{X_t} 与自身过去值 Xt−k{X_{t-k}} 之间的**总体**线性相关性。**定义**:对于一个平稳时间序列 Xt{X_t},间隔 kk 期(滞后 kk)的自相关系数 ρkρ_k 定义为:
ρk=Corr(Xt,Xt−k)ρ_k = Corr(X_t, X_{t-k})
这表示 XtX_t 和 Xt−kX_{t-k} 之间的简单相关系数。**计算**:ρk=Cov(Xt,Xt−k)/Var(Xt)ρ_k = Cov(X_t, X_{t-k}) / Var(X_t) (由于序列平稳,方差恒定)**样本ACF**:在实践中,我们使用样本数据来估计 ρkρ_k:
rk=[Σt=k+1T(Xt−X̄)(Xt−k−X̄)]/[Σt=1T(Xt−X̄)2]r_k = [ Σ_{t=k+1}^T (X_t - X̄)(X_{t-k} - X̄) ] / [ Σ_{t=1}^T (X_t - X̄)^2 ]
其中 TT 是样本总量。**关键点**:ACF衡量的是 XtX_t 与 Xt−kX_{t-k} 之间**所有路径**的相关性,包括通过中间变量 Xt−1,Xt−2,...,Xt−k+1X_{t-1}, X_{t-2}, ..., X_{t-k+1} 的间接影响。**必须用于平稳序列**。非平稳序列的ACF会衰减得非常慢,没有参考意义。对于**白噪声序列**,理论上所有 ρkρ_k (k≥1) 都等于0。**2. 偏自相关函数 (PACF – Partial Autocorrelation Function)****核心思想**:在控制了中间变量 Xt−1,Xt−2,...,Xt−k+1X_{t-1}, X_{t-2}, ..., X_{t-k+1} 的影响后,衡量 XtX_t 与 Xt−kX_{t-k} 之间的**纯粹**线性相关性。**定义**:偏自相关系数 φkkφ_kk 是 XtX_t 对 Xt−1,...,Xt−kX_{t-1}, ..., X_{t-k} 进行回归时,Xt−kX_{t-k} 的回归系数。它度量了在排除中间滞后影响后,XtX_t 与 Xt−kX_{t-k} 的额外关联。**解释**:可以理解为,φkkφ_kk 是 XtX_t 和 Xt−kX_{t-k} 在剔除了 Xt−1X_{t-1} 到 Xt−k+1X_{t-k+1} 的线性影响之后的相关性。**关键点**:PACF切断了 XtX_t 与 Xt−kX_{t-k} 之间通过所有更短滞后的联系,只衡量它们俩的“直接”关系。同样**必须用于平稳序列**。**二、 ARMA模型的识别:ACF与PACF的模式**下表总结了不同模型下ACF和PACF的典型理论模式,这是模型识别的基石。模型ACF (自相关图)PACF (偏自相关图)直观理解**AR(p)**
*(自回归模型)***拖尾**
呈指数衰减、正弦波动或两者混合。衰减速度由模型参数决定。**p阶后截尾**
在滞后 pp 期之后突然急剧地降至接近零。**ACF拖尾**:一个AR过程的影响会持续到未来,导致自相关关系缓慢消失。
**PACF截尾**:在控制了前 pp 期的影响后,更早的滞后项对当前值没有**直接**解释力。**MA(q)**
*(移动平均模型)***q阶后截尾**
在滞后 qq 期之后突然急剧地降至接近零。**拖尾**
呈指数衰减或振荡衰减。**ACF截尾**:一个MA过程只有 qq 期的记忆性,超过 qq 期后,过去的冲击与当前值不再相关。
**PACF拖尾**:由于MA模型可转换为无穷阶的AR模型,所以偏自相关关系是逐渐衰减的。**ARMA(p, q)**
*(混合模型)***拖尾**
在 qq 期后开始呈指数或振荡衰减。**拖尾**
在 pp 期后开始呈指数或振荡衰减。ACF和PACF都表现出**拖尾**特性,因为模型同时包含了AR和MA的成分。这使得单纯看图识别 pp 和 qq 变得困难。**重要提示**:**“截尾”**:指系数在某一阶后**理论上严格为0**。在样本图中,表现为超出该阶数后,系数几乎全部落入置信区间内(通常为95%的蓝色虚线带)。**“拖尾”**:指系数随着滞后阶数增加**逐渐衰减至0**(指数型或振荡型),不会突然切断。在实际的样本图中,由于随机性,模式可能没有理论那么完美,需要结合统计检验和模型选择准则。**三、 模型选择:AIC与BIC准则**当通过ACF/PACF初步确定模型范围后,或者面对多个备选模型时,我们需要一个客观的统计标准来选择“最佳”模型。这就是**AIC(赤池信息准则)** 和**BIC(贝叶斯信息准则)**。**核心问题**:如何在模型的**拟合优度**和**复杂度**之间取得平衡?更复杂的模型(参数更多)拟合效果更好,但可能过拟合。**AIC (Akaike Information Criterion)**
AIC=2k−2ln(L)AIC = 2k - 2ln(L)kk:模型中参数的个数(AR阶数p + MA阶数q + 常数项等)。LL:模型的极大似然函数值,代表了模型对数据的拟合程度(LL越大,拟合越好)。**BIC (Bayesian Information Criterion) / SBC (Schwarz Bayesian Criterion)**
BIC=ln(T)∗k−2ln(L)BIC = ln(T) * k - 2ln(L)TT:样本观测值的总数。**使用规则**:**选小原则**:在多个候选模型中,选择**AIC或BIC值最小**的模型。**AIC vs. BIC**:BIC的惩罚项 ln(T)∗kln(T)*k 比 AIC的 2k2k 更大(当 T≥8T ≥ 8 时,ln(T)>2ln(T) > 2)。因此,**BIC对模型复杂度的惩罚更重,倾向于选择更简洁(参数更少)的模型**,理论上更具一致性。AIC倾向于选择拟合更好的模型,但可能在样本量较大时选择稍复杂的模型。**实践建议**:通常同时计算AIC和BIC,如果两者选出的模型一致,则结果非常稳健。如果不一致,需结合业务背景、模型简洁性和预测效果综合判断,但BIC通常是更保守可靠的选择。**总结:完善的ARMA建模流程****平稳化**:确保时间序列是平稳的(通过差分等方法)。这是所有后续分析的基础。**白噪声检验**:如果是白噪声,则停止分析。**模型识别**:绘制平稳序列的**ACF和PACF图**。根据图表模式(见上表)初步判断模型类型(AR, MA, ARMA)和可能的阶数 (p,q)(p, q)。**参数估计**:使用**极大似然估计(MLE)** 等算法(由软件完成)对候选模型的参数进行估计。**模型诊断**:**残差检验**:检查模型残差是否为白噪声(如Ljung-Box检验)。如果残差是白噪声,说明模型已充分提取信息;否则,需要回到第3步重新调整模型。**离群值检查**:观察是否有异常参数估计。**模型选择**:在通过诊断的模型中,比较**AIC和BIC**,选择信息准则值最小的作为最终模型。**预测**:使用最终模型进行预测。通过这一套完整的流程,我们就能系统性地、科学地建立并选择一个优秀的时间序列模型。
====
# 【数学建模】003 时间序列分析:从基础理论到实战建模
https://www.paddysun.top/archives/4350 · 2025-11-05
[数学建模] 003 时间序列分析:从基础理论到实战建模 好的,这是一篇根据您提供的笔记整理而成的博客文章。时间序列分析:从基础理论到实战建模一、 时间序列分析概述核心目标:描述过去 -> 分析…
====
# 【数学建模】002 回归建模:从数据预处理到结果解释
https://www.paddysun.top/archives/4344 · 2025-11-05
[数学建模] 002 回归建模:从数据预处理到结果解释
回归建模:从数据预处理到结果解释1. 什么是回归建模回归建模是通过数学模型来解释变量之间关系的技术,常用的方法包括线性回归、广义线性模型、时间序列分析等。本篇文章将详细讲述如何进行数据预处理、模型回归分析、结果解释和实际应用。类别方法核心思想数学公式优点适用情况**线性回归**简单线性回归建立因变量与一个自变量之间的线性关系y=a+bx y=a+bx 简单直观,计算效率高两个变量之间的线性关系 多元线性回归建立因变量与多个自变量之间的线性关系y=a+bx1+cx2…… y=a+bx_1+cx_2…… 可以同时考虑多个影响因素多个自变量与因变量的线性关系**非线性回归**多项式回归用多项式函数拟合数据y=a+bx+cx2…… y=a+bx+cx^2…… 可以拟合曲线关系非线性但光滑的数据关系 简单非线性用指数、对数等基本非线性函数拟合y=aebx y=ae^{bx}
y=axb y=ax^{b}
y=a+blogax y=a+b log_{a}{x} 形式简单,参数解释明确特定的非线性模式(指数增长、幂律等) 逻辑模型描述S型增长过程y=K1+e−rx y=\frac{K}{1+e^{-r x}} 描述饱和增长过程增长率逐渐降低至稳定状态 Gompertz模型描述不对称的S型增长y(t)=Aexp(−exp(λ(B−t))) y(t)=A \exp (-\exp (\lambda(B-t))) 描述不对称增长模式早期增长较慢,在后期增长较快 Gauss模型用高斯函数描述峰值型数据y=aexp(−(x−b)22c2) y=a \exp \left(-\frac{(x-b)^2}{2 c^2}\right) 描述对称的峰值分布描述峰值型数据 Weibull分布描述寿命与可靠性数据F(x)={1−e−(xλ)kx≥00x<0 \mathrm{F}(\mathrm{x})=\left\{\begin{array}{cl}1-\mathrm{e}^{-\left(\frac{\mathrm{x}}{\lambda}\right)^{\mathrm{k}}} & \mathrm{x} \geq 0 \\0 & \mathrm{x}<0\end{array}\right. 灵活的寿命分布模型描述寿命与生存性数据**正则化回归**岭回归加入L2正则化的线性回归-减少模型方差,防止过拟合多重共线性数据,线性拟合 Lasso回归加入L1正则化的线性回归-特征选择,稀疏解高维数据,特征选择,线性拟合**树基回归**决策树回归基于树结构递归划分特征空间-处理缺失值,无需插值,解释性强分类变量,也可改进为连续但效果一般 随机森林回归多棵决策树的集成学习-稳定性高,不受离群点影响不需要关注离群值,用于估计特征重要性 梯度提升回归树逐步修正残差的集成方法-预测精度高处理复杂的非线性关系和交互作用,但容易过拟合**其他回归**支持向量回归寻找最优超平面进行预测-对异常值相对不敏感有噪声或异常值的数据 神经网络回归使用神经网络拟合复杂关系-自动特征工程,拟合能力强特征丰富的复杂非线性关系2. 数据预处理2.1. 数据预处理的基本步骤**数据收集**:从各类数据源中获取数据,包括UCI机器学习库、Kaggle、中国统计信息网等。**数据清洗**:处理缺失值、异常值和重复记录。**数据转换**:对数据进行标准化或对数转换,以满足模型假设。**特征选择**:确定哪些变量与目标变量相关,并处理定性变量。3. 回归分析3.1. 线性回归的基本原理线性回归假设自变量和因变量之间存在线性关系。其数学表达式为:Y=β0+β1X1+β2X2+…+βpXp+ϵ Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \ldots + \beta_p X_p + \epsilon 其中,ϵ\epsilon 是误差项,通常假设其满足正态分布且方差相等(同方差假设)。3.2. 数据对数转换当数据存在偏斜分布时,可以通过取对数来处理:Y′=ln(Y) Y' = \ln(Y)
X′=ln(X) X' = \ln(X) 通过取对数转换,可以减轻数据的偏斜性,提高模型的拟合效果。4. 回归模型的分类与应用4.1. 横截面数据与时间序列数据**横截面数据**:在一个时点上收集的不同对象的数据,适合多元线性回归,如消费行为研究。**时间序列数据**:对同一对象在不同时间点连续观察的数据,适合AR、MA、ARMA、ARIMA模型。**面板数据**:横截面数据与时间序列数据的结合,适合固定效应、随机效应等模型。4.2. 数据来源**UCI机器学习数据库**:[https://archive.ics.uci.edu/ml/datasets.php](https://archive.ics.uci.edu/ml/datasets.php)**多类别数据集**:[http://www.uco.es/kdis/mllresources/](http://www.uco.es/kdis/mllresources/)**Kaggle**:[https://www.kaggle.com/datasets](https://www.kaggle.com/datasets)**百度数据开放平台**:[https://open.baidu.com/open/#/open](https://open.baidu.com/open/#/open)**亚马逊数据集**:Registry of Open Data on AWS**谷歌数据集搜索引擎**:[https://datasetsearch.research.google.com/](https://datasetsearch.research.google.com/)5. 回归模型的实现与分析5.1. 模型回归系数的解释不同类型的模型回归系数的解释具有一定的差异:**多元线性回归**:回归系数表示当其他变量保持不变时,自变量对因变量的平均影响。例如,增加1个单位的自变量X,因变量Y平均增加β1\beta_1个单位。**时间序列回归**:自回归(AR)模型项表示该变量过去值对当前值的影响。例如,Yt=α+βYt−1+ϵt5.2. 如果有定性变量定性变量需要通过虚拟变量进处理:**引入虚拟变量**:将分类变量编码为0-1,例如:**虚拟变量编码**:如果分类变量有3个类别,使用2个虚拟变量,例如:类别A: V1 = 0, V2 = 0类别B: V1 = 1, V2 = 0类别C: V1 = 0, V2 = 1**多分类虚拟变量的设置**:通常引入的虚拟变量个数为分类数减1,以避免多重共线性。5.3. 交互效应交互效应是指自变量之间的交互关系对因变量的影响:Y=β0+β1X1+β2X2+β3(X1×X2)+ϵ Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \beta_3 (X_1 \times X_2) + \epsilon 例如,产品的销售量不仅与价格有关,还与广告投入有关,可以通过引入交互项:X1×X2 X_1 \times X_2 来研究其影响。6. 实测与结果解释6.1. 拟合优度R方较低怎么办**解释型回归**:主要关心系数的经济意义和理论依据,R方不作为主要指标。**预测型回归**:更关注模型的实际预测能力,建议使用调整后的R方。6.2. 极端情况下的处理**R方极低**:考虑引入新的变量或调整模型结构,避免导入大量无关变量。**拟合值为负数**:检查数据尺度和比例,可能需要重新缩放。7. 回归模型的假设检验与问题解决7.1. R方的适当解释**调整后的R方**:当添加变量后拟合优度没有显著提升时,调整后的 R¯2\bar{R}^2 可能会降低,反映了模型的整体预测能力。7.2. 异方差检验与处理**异方差检验**:**怀特检验**(White Test):通过残差图和统计量进行检验。**处理异方差**:**稳健标准误**:使用一般的线性回归加稳健标准误,不显著影响回归系数的估计。**广义最小二乘法**(GLS):重新加权估计。7.3. 多重共线性的检验与处理**多重共线性检验**:**方差膨胀因子**(VIF):计算每个自变量的VIF值,VIF > 10 表示存在多重共线性。**处理多重共线性**:**增加样本量**:提高样本容量。**剔除变量**:谨慎删除可能导致内生性问题的变量。**模型结构调整**:重新设定模型,减少共线性的影响。8. 逐步回归8.1. 逐步回归方法**向前逐步回归**:逐步加入变量,每个变量加入后重新评估模型。**向后逐步回归**(推荐):逐步删除变量,每个变量删除后重新评估模型。9. 实际案例分析9.1. 案例分析:股票价格预测**数据来源**:历史股票价格数据。**模型选择**:ARIMA结合LSTM。**模型解释**:输出结果的经济意义和显著性。9.2. 案例分析:用户流失预测**数据来源**:用户行为数据。**模型选择**:分类模型(如随机森林、XGBoost)结合特征工程。**模型解释**:预测结果的人工智能决策路径分析。10. 结论与建议**回归模型的实际应用**:选择合适的模型和方法,结合数据和业务背景进行建模。**持续学习**:不断学习新的统计方法和技术,提高模型的预测能力和解释性。
====
# 【数学建模】001 数据预处理
https://www.paddysun.top/archives/4340 · 2025-11-05
数据预处理是数学建模中至关重要的一步,它直接影响模型的性能和可靠性。本文将系统介绍数据预处理的各个方面,并结合实际案例展示如何在数学建模中应用这些技术。
数据预处理方法
数据预处理(Data Preprocessing)是指在进行实际数据分析或机器学习建模之前,对原始数据进行的一系列处理步骤。目的是为了提高数据质量,使得后续的数据分析或模型训练更加有效。通常包括但不限于以下几个方面:数据清洗(Data Cleaning):处理缺失值:通过删除、填充平均值、中位数或其他预测方法来处理缺失数据。异常值检测:识别并处理异常值,这些值可能是因为数据录入错误或是测量错误造成的。一致性检查:确保所有数据记录遵循相同的格式和单位。数据集成(Data Integration):结合来自不同来源的数据,这可能涉及到解决数据冗余和数据冲突的问题。数据转换(Data Transformation):规范化/标准化:将数据转换到相同的尺度上,比如将所有数值特征缩放到0到1之间或转换为标准正态分布。聚集:汇总数据,例如计算平均值、总和等。数据离散化:将连续数据转换为分类型数据。创建派生属性:基于现有数据创建新的特征。数据约简(Data Reduction):降低数据维度,比如通过主成分分析(PCA)减少特征数量。采样:减少数据集的大小,例如通过随机抽样获取数据子集。数据划分(Data Partitioning):将数据集划分为训练集、验证集和测试集,用于模型的训练、调优和最终评估。 数据清洗综述[数据清洗研究综述_廖书妍.pdf](https://uploader.shimo.im/f/zCqsoJeJ1Hk4XFkT.pdf)
[结构化数据清洗技术综述_郝爽.pdf](https://uploader.shimo.im/f/p6tmFXTXbQuDU91R.pdf)[1]郝爽,李国良,冯建华,等.结构化数据清洗技术综述[J].清华大学学报(自然科学版),2018,58(12):1037-1050.DOI:10.16511/j.cnki.qhdxxb.2018.22.053.
[1]廖书妍.数据清洗研究综述[J].电脑知识与技术,2020,16(20):44-47.DOI:10.14004/j.cnki.ckt.2020.2361.
数据清洗的过程可以描述为:给定具有模式R 的数据库实例I以及数据质量需求;数据清洗是指找到数据库实例I′,它可以满足所有的数据质量需求,同时清洗代价最小。清洗质量的评价指标常用的评价指标有准确率、召回率和F值。考虑一个二分类问题,即实例被分为正类和负类,那么:准确率定义为被分类器判断为正类的实例中正确分类的比例;召回率定义为分类器将正类判断为正类的比例;而F值是准确率和召回率的调和平均值。准确率召回率准确率召回率F=2×准确率×召回率准确率+召回率F=2\times\frac{\text{准确率}\times\text{召回率}}{\text{准确率}+\text{召回率}}
为了衡量数据 清洗算法的性能,研究人员往往会在干净的数据库实例Ic中手动注入数据噪声,得到包含脏数据的 数据库实例I,通过数据清洗算法获得I′后,利用Ic 和I′计算相应的准确率、召回率和F值。数据噪声的类型与检测数据缺失直接检测是否为空数据冗余其问题在于,重复元组(行)数据的所有特征并不一定相同,甚至都要相同,但其确实指的是同一个元组。例如:相同员工数据元组,级别 特征不同,其他特征相同;可以直接对比关键特征(姓名)相同的元组,但此例中如何区分同名者和数据冗余也是个问题。名称特征分别为iPad 2nd和iPad Two的两个元组,所有特征都不相同。可以先聚类(相当于分类问题,方法有:相似度函数,规则判断,机器学习等),缩小搜索空间。基于字段的检测算法。可以采用**LevenshteinDistance**算法、**余弦相似度函数**算法进行字段的相似度检测,以识别冗余的数据。Levenshtein Distance算法易于实现。余弦相似度算法更多地用于检测文本的相似度。通过该算法获得的相似性度量的值越小,说明个体间越相似。基于记录的检测算法。有**N-Grams算法**、**聚类算法**、**SNM算法**、**MPN算法**等。N-Grams算法生成一个哈希表,然后根据哈希表来判断记录之间的相似性;聚类算法通过计算将相似的数据归为一类;SNM算法实现较为容易,但在很大程度上取决于关键字,依赖性较强;MPN算法的优点是它可以更为全面地收集重复的数据,但使用起来较为烦琐。数据冲突通过完整性约束可以检测数据冲突,而完整性约束可以从干净的数据集中学得。不同的完整性约束有不同的学习方法,但许多完整性约束都是基于函数依赖设计的。函数依赖的学习算法分为自上而下和自下而上两类**自上而下**:假设所有属性都相互依赖开始,然后逐步地去除那些实际上不存在的依赖关系。TANE、FD_Mine、FUN等**自下而上**:从单个属性开始,逐步构建起更大范围的依赖关系等。FastFDs、Dep-Miner等。数据错误指数据库实例中某些不为 空的属性值是错误的,例如属性域错误、拼写错 误、格式错误等。数据错误有时会引发数据冲突, 但是不冲突的数据不一定是正确数据。基于**完整性约束的错误检测**。完整性约束可以用来检测数据冲突,但是约束本身无法指出冲突的发生是由哪个属性值引发的。基于**规则的错误检测**。在关系表和主数据之间建立匹配关系,若关系表中的属性值和与其匹配到的主数据中的属性值不相等,就可以判断关系表中的数据存在错误。基于**统计和机器学习的错误检测**。基于统计和机器学习的错误检测算法多是基于统计分析的:通过概率模型或关系依赖模型获得输入数据集的定量统计信息,比如属性值的共现信息, 然后通过真值推理来检查原始数据值是否在期望范 围内,或者查找不符合输入数据整体分布的属性值,这些属性值就是错误的属性值。面向**离群点检测的方法**。主要包括基于统计模型的算法、基于接近度的算法、基于密度的算法以及基于聚类的算法等。数据转换与添加标准化(Standardization,Z-score 标准化)这种方法将数据转换成标准正态分布的形式,即均值为0,标准差为1。计算特征x均值μ=1n∑i=1nxi\mu=\frac1n\sum_{i=1}^nx_i \\
计算特征x标准差σ=1n∑i=1n(xi−μ)2\sigma=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(x_{i}-\mu)^{2}} \\
标准化x_izi=xi−μσz_{i}=\frac{x_{i}-\mu}{\sigma}优点使不同特征具有相同的尺度。数据的距离信息得以保留。不太受异常值的影响。缺点非正态分布的数据标准化后其分布显著改变。大数据集运算时间长。适用场景对特征尺度敏感的算法(SVM,线性回归/逻辑回归),依赖于距离的算法(K均值聚类)x
from sklearn.datasets import fetch_california_housingfrom sklearn.preprocessing import StandardScalerimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as sns
# 加载数据集california = fetch_california_housing()data = pd.DataFrame(california.data, columns=california.feature_names)
# 原始数据统计信息print("原始数据统计信息:\n", data.describe())
# 标准化scaler = StandardScaler()data_scaled = scaler.fit_transform(data)
# 将标准化后的数据转为DataFramedata_scaled = pd.DataFrame(data_scaled, columns=california.feature_names)
# 标准化后数据统计信息print("标准化后数据统计信息:\n", data_scaled.describe())
# 可视化前后数据分布plt.figure(figsize=(16, 6))
# 标准化前的分布plt.subplot(1, 2, 1)sns.histplot(data['MedInc'], kde=True, color='blue')plt.title('Distribution of Median Income before Standardization')
# 标准化后的分布plt.subplot(1, 2, 2)sns.histplot(data_scaled['MedInc'], kde=True, color='red')plt.title('Distribution of Median Income after Standardization')
plt.show()归一化(Normalization,Min-Max标准化)这种方法将每个特征的值重新映射到[0, 1]区间内xmin=min(X) xmax=max(X)x_{\min}=\min(X)\ \ \ x_{\max}=\max(X)
进行归一化xi′=xi−xminxmax−xminx_{i}^{\prime}=\frac{x_{i}-x_{\mathrm{min}}}{x_{\mathrm{max}}-x_{\mathrm{min}}}优点使不同特征具有相同的尺度,数据的整体分布形状得以保留。缺点包含明显离群值的数据,标准化可能会受到影响,导致结果不理想。适用场景神经网络:神经网络中的权重更新可能受益于数据的规范化;主成分分析:依赖于特征之间的协方差矩阵**当特征的尺度不一致时,即某些特征的取值范围远大于其他特征,这会导致协方差矩阵的某些元素远大于其他元素。在这种情况下,PCA 的结果可能会偏向于那些尺度较大的特征,因为这些特征在协方差矩阵中占据主导地位。例如,如果一个特征的取值范围是 0-1000,而另一个特征的取值范围是 0-1,那么前者对协方差矩阵的贡献将远远超过后者,即使后者在数据中可能同样重要。xfrom sklearn.datasets import load_irisfrom sklearn.preprocessing import MinMaxScalerimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as sns
# 加载数据集iris = load_iris()data = pd.DataFrame(iris.data, columns=iris.feature_names)
# 原始数据统计信息print("原始数据统计信息:\n", data.describe())
# 归一化scaler = MinMaxScaler()data_normalized = scaler.fit_transform(data)
# 将归一化后的数据转为DataFramedata_normalized = pd.DataFrame(data_normalized, columns=iris.feature_names)
# 归一化数据统计信息print("归一化后数据统计信息:\n", data_normalized.describe())
# 可视化前后数据分布plt.figure(figsize=(16, 6))
# 归一化前的分布plt.subplot(1, 2, 1)sns.histplot(data['sepal length (cm)'], kde=True, color='green')plt.title('Distribution of Sepal Length before Normalization')
# 归一化后的分布plt.subplot(1, 2, 2)sns.histplot(data_normalized['sepal length (cm)'], kde=True, color='orange')plt.title('Distribution of Sepal Length after Normalization')
plt.show()归一化到单位长度(Normalization to Unit Length)这种方法计算每个向量相对于其自身的长度(或范数),通常使用L2范数。Xunit=X∥X∥X_{\mathrm{unit}}=\frac{X}{\|X\|}
∥X∥\|X\|为L2范数(也称为欧几里得范数)是向量空间中的一种范数,它是向量各元素平方和的开方。∥x∥2=x12+x22+...+xn2=∑i=1nxi2\|\mathbf{x}\|_2=\sqrt{x_1^2+x_2^2+...+x_n^2}=\sqrt{\sum_{i=1}^nx_i^2}
*正则化技术中作为惩罚项,比如在岭回归(Ridge Regression)中,L2范数被添加到损失函数中,以防止模型过拟合。最大值归一化(Max Normalization)将所有数据除以最大的绝对值。Xmax=Xmax(|X|)X_{\max}=\frac{X}{\max(|X|)}时间序列频率转换[1]张春华,高铁梅,陈飞.经济时间序列频率转换方法的研究与应用[J].统计研究,2017,34(02):92-100.DOI:10.19343/j.cnki.11-1302/c.2017.02.009.
[经济时间序列频率转换方法的研究与应用_张春华.pdf](https://uploader.shimo.im/f/eXBeishAjRkciar2.pdf)
由于所获得指标的数据频率有时可能不同(如年度、季度或月度) ,而计量经济模型又要求变量的样本频率必须相同,因而无法一起使用,需要将其中的某些指标进行频率转换,以达到数据频率的统一,例如衡量经济总量的国内生产总值(GDP)是观测实体经济状况最为全面有效的指标,但是公布的GDP指标只有季度和年度数据,当计量经济模型需要使用月度频率的GDP数据时,就需要进行频率转换。传统频率转换方法线性插值:这是一种简单的数值插值方法,通过直线连接两个已知数据点来估算未知数据点的值。二次插值:类似于线性插值,但使用二次曲线来连接数据点,提供更平滑的插值。拉格朗日插值:一种多项式插值方法,可以根据已知点构造一个多项式函数来近似中间值。三次样条函数插值:这种方法使用分段的三次多项式来平滑地连接数据点,提供比线性和二次插值更精确的结果。前沿频率转换方法Denton 方法原理:Denton 方法最初由 Denton 在 1971 年提出,旨在通过数值平滑并使用优化方法来保持低频数据的变化趋势。该方法后来经过多次修正和完善。特点:Denton 方法是一种全局插值方法,即修改低频数据序列中的任何一个点或增加数据点都会影响到整个高频插值序列。Chow-Lin 方法原理:Chow-Lin 方法由 Chow 和 Lin 在 1971 年提出,基于稳态多变量回归分析来插值高频数据。该方法假设高频数据序列中的随机扰动项服从一阶自回归 AR(1) 过程。特点:通过建立一个包含多个高频数据解释变量的回归模型来估计高频序列,这种方法同样是全局插值方法。Litterman 方法原理:Litterman 方法与 Chow-Lin 方法类似,区别在于 Litterman 方法假定方程中的随机扰动项服从随机游走过程。特点:该方法也是全局插值方法,任何低频数据点的变化都会影响高频插值序列。混频数据模型(Mixed Data Sampling, MIDAS)原理:混频数据模型允许直接将不同频率的变量纳入同一个模型中,通过考虑高频数据变量样本数据的特征来估计模型参数。特点:该方法可以处理指数变量和存量变量,但通常不适合直接处理流量变量。此外,混频数据模型需要采用特定的模型形式,缺乏一定的灵活性。独热编码(One-Hot Encoding)为每个类别创建一个二进制特征,每个特征表示一个类别是否存在。每个类别C_i被表示为一个长度为m的二进制向量,其中第i位为1,其余为0。eg. ’red’→[1,0,0],’green’→[0,1,0],’blue’→[0,0,1]eg.\ \text{'red'}\to[1,0,0]\text{,'green'}\to[0,1,0]\text{,'blue'}\to[0,0,1]
这样做是为了消除类别之间的顺序关系,避免模型引入虚假的顺序信息。提高模型对类别变量的处理能力,适合无序类别。但当类别较多时,会显著增加数据的维度,导致“维度灾难”。可以使用sklearn.preprocessing.OneHotEncoder实现xxxxxxxxxx#来自https://mp.weixin.qq.com/s/qOe-jdj1jqqko9vLzgS67Qimport pandas as pdfrom sklearn.preprocessing import OneHotEncoderimport matplotlib.pyplot as pltimport seaborn as sns
# 创建示例数据data = pd.DataFrame({ 'Gender': ['Male', 'Female', 'Female', 'Male', 'Female', 'Male', 'Male', 'Female']})
# 独热编码onehot_encoder = OneHotEncoder(sparse=False)gender_encoded = onehot_encoder.fit_transform(data[['Gender']])
# 将独热编码后的数据转为DataFramegender_encoded_df = pd.DataFrame(gender_encoded, columns=onehot_encoder.categories_[0])
# 可视化独热编码结果plt.figure(figsize=(8, 6))sns.heatmap(gender_encoded_df, annot=True, cbar=False, cmap='coolwarm')plt.title('One-Hot Encoded Gender')plt.xlabel('Gender')plt.ylabel('Sample Index')plt.show()
print("独热编码结果:\n", gender_encoded_df)过采样(Over-sampling)过采样的目标是通过复制少数类样本来平衡类别分布,主要方法包括简单复制和SMOTE(合成少数类过采样技术)。SMOTE的核心步骤如下选择样本: 从少数类样本中随机选择一个样本xx。在少数类样本中找到一个最近邻样本xneighborx_{\mathrm{neighbor}} 。生成新样本: 在原样本和一个最近邻样本之间生成一个新样本 ,其计算公式为:xnew=x+λ×(xneighbor−x)x_{\mathrm{new}}=x+\lambda\times(x_{\mathrm{neighbor}}-x)
其中λ\lambda是一个0到1之间的随机数。可以通过imblearn.over_sampling.SMOTE来实现xxxxxxxxxx#来自https://mp.weixin.qq.com/s/qOe-jdj1jqqko9vLzgS67Qfrom sklearn.datasets import make_classificationfrom imblearn.over_sampling import SMOTEimport matplotlib.pyplot as pltimport seaborn as sns
# 创建不平衡数据集X, y = make_classification(n_samples=1000, n_features=2, n_informative=2, n_redundant=0, n_clusters_per_class=1, weights=[0.9, 0.1], random_state=42)
# 使用SMOTE进行过采样smote = SMOTE(random_state=42)X_resampled, y_resampled = smote.fit_resample(X, y)
# 可视化过采样前后的数据分布plt.figure(figsize=(16, 6))
# 过采样前plt.subplot(1, 2, 1)sns.scatterplot(X[:, 0], X[:, 1], hue=y, palette='coolwarm')plt.title('Before SMOTE')
# 过采样后plt.subplot(1, 2, 2)sns.scatterplot(X_resampled[:, 0], X_resampled[:, 1], hue=y_resampled, palette='coolwarm')plt.title('After SMOTE')
plt.show()降采样(Under-sampling)降采样的目标是通过减少多数类样本来平衡类别分布。最简单的方法是随机采样,即从多数类中随机选择与少数类同等数量的样本。可以采用imblearn.under_sampling.RandomUnderSampler来实现xxxxxxxxxx#来自https://mp.weixin.qq.com/s/qOe-jdj1jqqko9vLzgS67Qfrom sklearn.datasets import make_classificationfrom imblearn.under_sampling import RandomUnderSamplerimport matplotlib.pyplot as pltimport seaborn as sns
# 创建不平衡数据集X, y = make_classification(n_samples=1000, n_features=2, n_informative=2, n_redundant=0, n_clusters_per_class=1, weights=[0.9, 0.1], random_state=42)
# 使用随机降采样undersampler = RandomUnderSampler(random_state=42)X_resampled, y_resampled = undersampler.fit_resample(X, y)
# 可视化降采样前后的数据分布plt.figure(figsize=(16, 6))
# 降采样前plt.subplot(1, 2, 1)sns.scatterplot(X[:, 0], X[:, 1], hue=y, palette='coolwarm')plt.title('Before Under-sampling')
# 降采样后plt.subplot(1, 2, 2)sns.scatterplot(X_resampled[:, 0], X_resampled[:, 1], hue=y_resampled, palette='coolwarm')plt.title('After Under-sampling')
plt.show() 数据约简约简算法分类思想过滤式方法是独立于后续机器学习算法的,它通过一些统计度量来评估特征的重要性,例如卡方检验、互信息、相关系数等。包裹式方法依赖于特定的学习算法,通过选择特征子集来训练模型,并根据模型的表现来评估特征的重要性。 **Name****随机森林重要性排序****Boruta算法****mRMR算法****HOML算法**核心思想利用特征在树中的使用频率或者特征在分割节点上的减少不纯度来衡量特征的重要性。基于随机森林的特征选择方法,通过引入随机化的“阴影特征”来判断现有特征是否优于随机特征。基于最大相关性最小冗余的原则来选择特征,旨在选择那些与目标变量高度相关同时与其他特征低度相关的特征。利用模拟退火来跳出局部最优解,遗传算法来探索全局解空间,以及贪婪算法来加速搜索过程。这种混合方法使得算法能够在复杂问题中寻找到较好的解决方案。优点可以有效地处理高维数据,并且可以自动处理缺失值。可以处理特征间复杂的相互作用,并且能区分重要特征和冗余特征。减少特征间的冗余。适用于多标签分类问题,这类问题通常比单标签分类更加复杂,因为一个样本可能属于多个类别。缺点可能对噪音数据敏感。计算复杂度较高,尤其是在创建阴影特征样本时。计算时间长,特别是在特征数量较大的时候。可解释性差;需要对算法参数进行适当的调整适用范围适用于具有大量特征的数据集。适用于需要严格区分重要特征和冗余特征的场景。适用于特征之间存在冗余的情况。计算复杂度最高## Boruta算法[1]陈逸杰,唐加山.改进Boruta算法在特征选择中的应用[J].软件导刊,2019,18(04):69-73.[改进Boruta算法在特征选择中的应用_陈逸杰.pdf](https://uploader.shimo.im/f/bGgTs8kwZIl5WGvM.pdf)
Boruta算法是一种用于特征选择的包装方法,它主要围绕随机森林分类器构建。这个算法的特点在于它引入了“阴影特征”(Shadow Features)的概念,这些阴影特征是通过打乱原始特征的值来创建的,目的是为了评估每个特征相对于随机噪声的重要性。Boruta算法的基本步骤包括:复制样本:将原始数据集复制一份。创建阴影特征:对复制的数据集中的每列数据进行随机排列,从而创建阴影特征。合并样本:将原始特征与阴影特征合并,形成一个新的数据集。运行随机森林分类器:在这个新的数据集上运行随机森林算法,并计算每个特征的重要性。特征标记:如果某个特征的重要性低于阴影特征的平均重要性,则该特征被标记为“不重要”;如果特征的重要性高于最好的阴影特征的重要性,则被标记为“重要”。重复过程:删除阴影特征,并重复上述过程,直到所有特征都被标记为“重要”或“不重要”。使用 URL 乳腺癌威斯康星(诊断)数据集 进行传统Bourta复现[Boruta算法对于URL 乳腺癌威斯康星(诊断)数据集的应用.txt](https://uploader.shimo.im/f/ecATJ4iSEycWhzYD.txt)xxxxxxxxxximport pandas as pdfrom sklearn.model_selection import train_test_splitfrom boruta import BorutaPyfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.metrics import accuracy_scoreimport matplotlib.pyplot as pltimport seaborn as snsimport numpy as np# # 加载数据 红酒# url = "http://archive.ics.uci.edu/ml/machine-learning-databases/wine/wine.data"# columns = ['Class', 'Alcohol', 'Malic acid', 'Ash', 'Alcalinity of ash', 'Magnesium', 'Total phenols',# 'Flavanoids', 'Nonflavanoid phenols', 'Proanthocyanins', 'Color intensity', 'Hue',# 'OD280/OD315 of diluted wines', 'Proline']# wine_data = pd.read_csv(url, header=None, names=columns) # X = wine_data.drop('Class', axis=1)# y = wine_data['Class']
# 准备数据 乳腺癌威斯康星(诊断)数据集# 第一列为 ID(标识符)。# 第二列为 Diagnosis(诊断结果,M表示恶性,B表示良性)。# 其余列是特征数据。# 数据集URLurl = "https://archive.ics.uci.edu/ml/machine-learning-databases/breast-cancer-wisconsin/wdbc.data"
# 定义列名column_names = ['ID', 'Diagnosis'] + [f'Feature_{i}' for i in range(1, 31)]
# 读取数据cancer_data = pd.read_csv(url, header=None, names=column_names)
# 删除ID列cancer_data.drop('ID', axis=1, inplace=True)
# 将诊断结果转换为数字cancer_data['Diagnosis'] = cancer_data['Diagnosis'].map({'M': 1, 'B': 0})
# 准备数据X = cancer_data.drop('Diagnosis', axis=1)y = cancer_data['Diagnosis']
# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y)
# 初始化随机森林模型rf = RandomForestClassifier(n_jobs=-1, class_weight='balanced', max_depth=5)
# 初始化Boruta特征选择器boruta_selector = BorutaPy(rf, n_estimators='auto', verbose=2, random_state=42)
# 对训练数据进行特征选择boruta_selector.fit(X_train.values, y_train.values)
# 检查选中的特征selected_features = X_train.columns[boruta_selector.support_].tolist()print("Selected Features: ", selected_features)
# 打印被剔除的特征rejected_features = X_train.columns[~boruta_selector.support_].tolist()print("Rejected Features: ", rejected_features)
# 打印有待定性的特征tentative_features = X_train.columns[boruta_selector.support_weak_].tolist()print("Tentative Features: ", tentative_features)
# 获取特征排名feature_ranks = boruta_selector.ranking_
# 将特征名称和排名结合成一个DataFramefeature_importance_df = pd.DataFrame({ 'Feature': X_train.columns, 'Rank': feature_ranks})print(feature_importance_df)
# 初始化存储特征排名的 DataFrameranking_df = pd.DataFrame(index=range(1, 21), columns=X_train.columns)
# 运行 Boruta 20 次for i in range(20): print(f"Iteration {i+1}") # 初始化Boruta特征选择器 boruta_selector = BorutaPy(rf, n_estimators='auto', verbose=2, random_state=i, max_iter=50) # 对训练数据进行特征选择 boruta_selector.fit(X_train.values, y_train.values) # 获取特征排名 feature_ranks = boruta_selector.ranking_ # 将特征排名保存到 DataFrame 中 ranking_df.loc[i+1] = feature_ranks
# 确保数据集中只有数值列numeric_ranking_df = ranking_df.apply(pd.to_numeric, errors='coerce')
# 计算每个特征的中位数median_values = numeric_ranking_df.median()
# 根据中位数对列进行排序sorted_columns = median_values.sort_values().index
# 设置绘图风格plt.figure(figsize=(15, 8))sns.set(style="whitegrid")
# 绘制箱线图sns.boxplot(data=numeric_ranking_df[sorted_columns], palette="Greens")plt.xticks(rotation=90)plt.title("Sorted Feature Ranking Distribution by Boruta", fontsize=16)plt.xlabel("Attributes", fontsize=14)plt.ylabel("Importance", fontsize=14)plt.tight_layout()plt.show()mRMR算法[1]李扬,顾雪平.基于改进最大相关最小冗余判据的暂态稳定评估特征选择[J].中国电机工程学报,2013,33(34):179-186+27.DOI:1 0.13334/j.0258-8013.pcsee.2013.34.024.
[基于改进最大相关最小冗余判据的暂态稳定评估特征选择_李扬.pdf](https://uploader.shimo.im/f/VfFOoJpQRYb7rjJS.pdf)
其核心思想是从给 定的特征集合中寻找与目标类别有最大相关性且 相互之间具有最少冗余性的特征子集。给定两个随机变量x和y,其概率密度为p(x) 和p(y),联合概率密度为p(x,y),则x和y之间的互信息定义为 I(x;y)=∬p(x,y)logp(x,y)p(x)p(y)dxdyI(x;y)=\iint p(x,y)\log\frac{p(x,y)}{p(x) p(y)}\mathrm{d}x\mathrm{d}y
最大相关和最小冗余的测度指标分别定义为 maxD(S,c),D=1|S|∑xi∈SI(xi;c)\max D(S,c),D=\frac{1}{\left|S\right|}\sum_{x_{i}\in S}I\left(x_{i};c\right)
minR(S),R=1|S|2∑xi,xj∈SI(xi;xj){min}R(S), R=\frac{1}{\left|S\right|^{2}}\sum_{x_{i},x_{j}\in S}I\left(x_{i};x_{j}\right)使用 URL 乳腺癌威斯康星(诊断)数据集 进行传统mRMR复现mrmr库的按照需要采用如下命令xxxxxxxxxxpip install mrmr_selectionxxxxxxxxxximport pandas as pdfrom mrmr import mrmr_classifimport matplotlib.pyplot as pltimport seaborn as snsimport numpy as np
# 数据集URLurl = "https://archive.ics.uci.edu/ml/machine-learning-databases/breast-cancer-wisconsin/wdbc.data"
# 定义列名column_names = ['ID', 'Diagnosis'] + [f'Feature_{i}' for i in range(1, 31)]
# 读取数据cancer_data = pd.read_csv(url, header=None, names=column_names)
# 删除ID列cancer_data.drop('ID', axis=1, inplace=True)
# 将诊断结果转换为数字cancer_data['Diagnosis'] = cancer_data['Diagnosis'].map({'M': 1, 'B': 0})
# 准备数据X = cancer_data.drop('Diagnosis', axis=1)y = cancer_data['Diagnosis']
# 可视化相关性矩阵correlation_matrix = X.corr()plt.figure(figsize=(12, 10))sns.heatmap(correlation_matrix, annot=True, fmt=".2f", cmap='coolwarm')plt.title("Correlation Matrix of Features")plt.show()
# 应用mrmr库进行RMR算法选择特征#selected_features = mrmr_classif(X=X, y=y, K=10) # 选择前10个特征
#print("Selected features:", selected_features)
# 计算每个特征与目标变量的相关性correlation_with_target = X.corrwith(y).sort_values(ascending=False)
# 计算互信息def estimate_joint_probability(data): """估计联合概率分布""" values, counts = np.unique(data, return_counts=True) joint_prob = counts / float(data.size) return values, joint_prob
def marginal_probability(data): """计算边缘概率分布""" values, counts = np.unique(data, return_counts=True) marginal_prob = counts / float(data.size) return marginal_prob
def mutual_information(x, y, bins=10): """计算两个变量之间的互信息""" c_xy, _, _ = np.histogram2d(x, y, bins=bins) c_xy = c_xy / np.sum(c_xy) px = marginal_probability(x) py = marginal_probability(y) mi = 0 for i in range(bins): for j in range(bins): if c_xy[i, j] > 0: mi += c_xy[i, j] * np.log2(c_xy[i, j] / (px[i] * py[j])) return mi
# 最大化相关性和最小化冗余selected_features = []num_features_to_select = 10while len(selected_features) < num_features_to_select: max_gain = -np.inf best_feature = None for feature in X.columns: if feature not in selected_features: gain = correlation_with_target[feature] - sum([mutual_information(X[feature], X[f]) for f in selected_features]) if gain > max_gain: max_gain = gain best_feature = feature selected_features.append(best_feature)
# 可视化特征选择过程fig, ax = plt.subplots(figsize=(10, 6))ax.barh(range(len(selected_features)), [correlation_with_target[f] for f in selected_features], color='skyblue')ax.set_yticks(range(len(selected_features)))ax.set_yticklabels(selected_features)ax.set_xlabel('Correlation with Target')ax.set_title('Selected Features by mRMR')plt.show()
# 可视化特征之间的相关性selected_X = X[selected_features]correlation_matrix_selected = selected_X.corr()plt.figure(figsize=(10, 8))sns.heatmap(correlation_matrix_selected, annot=True, fmt=".2f", cmap='coolwarm')plt.title("Correlation Matrix of Selected Features")plt.show()补充完整性约束在数据库管理和数据清理的过程中,“完整性约束”(Integrity Constraints)指的是用来保证数据库中数据准确性和一致性的规则集合。这些约束条件确保了数据符合预期的结构和逻辑关系,从而防止错误或不一致的数据进入数据库系统。以下是几种常见的完整性约束:实体完整性(Entity Integrity):每个表必须有一个主键(Primary Key),该主键唯一标识表中的每一条记录,并且不允许为空(NULL)。参照完整性(Referential Integrity):这是关于外键(Foreign Key)的规则,当一个表引用另一个表的主键时,被引用的主键必须存在于目标表中。如果删除了一个主键记录,则需要更新或删除所有依赖于该主键的外键记录,以保持数据一致性。域完整性(Domain Integrity):定义了字段的有效输入范围或类型。例如,年龄字段只能包含非负整数,或者电子邮件地址字段必须符合电子邮件地址的标准格式。用户定义的完整性(User-defined Integrity):用户可以根据业务需求定义额外的约束,如检查约束(CHECK约束),它可以是一个布尔表达式,用于限制列中的值或多个列之间的关系。数据一致性(Data Consistency):维护数据的一致性意味着确保事务在执行前后数据保持一致状态。例如,转账操作应该确保从一个账户转出的金额等于另一个账户转入的金额。在数据清洗过程中,完整性约束可以帮助识别和纠正数据中的错误,例如无效值、重复记录、违反参照完整性的记录等。通过应用这些约束,可以确保数据库中的数据始终保持准确、可靠和可用的状态。这对于任何依赖于高质量数据的应用程序都是至关重要的。滑动窗口(Sliding Window)滑动窗口(Sliding Window)是一种处理时间序列数据和其他序列数据的技术,常用于生成固定长度的输入序列,用于训练模型。这种方法特别适用于时间序列预测、图像处理等序列数据处理领域。滑动窗口的具体步骤可以概括为以下几个步骤:定义窗口大小:确定窗口的长度(窗口大小),即每个片段包含多少个数据点。这个长度可以根据问题的具体需求来选择。定义步长:确定窗口移动的步长(步幅),即每次移动多少个数据点。步长可以等于窗口大小(即不重叠),也可以小于窗口大小(即有重叠)。生成窗口序列:从原始时间序列数据中,按照定义的窗口大小和步长,生成一系列的窗口序列。构造输入输出对:对于每个窗口序列,将其作为模型的输入(特征),并根据业务需求定义对应的输出(目标)。例如,预测下一个时间点的值时,可以将窗口序列作为输入,将下一个时间点的值作为输出。xxxxxxxxxximport numpy as np
def sliding_window(data, window_size, step_size=1): """ 生成滑动窗口序列。 :param data: 输入的时间序列数据 :param window_size: 窗口大小 :param step_size: 步长,默认为1 :return: 生成的窗口序列 """ # 确保数据是numpy数组 data = np.array(data) # 计算可以生成的窗口数量 num_windows = ((len(data) - window_size) // step_size) + 1 # 初始化输出数组 windows = np.zeros((num_windows, window_size)) # 生成窗口序列 for i in range(num_windows): start = i * step_size end = start + window_size windows[i] = data[start:end] return windows
# 示例数据data = np.random.rand(10) # 生成一个长度为10的随机序列window_size = 3 # 窗口大小为3step_size = 1 # 步长为1
# 生成滑动窗口序列windows = sliding_window(data, window_size, step_size)
print("Original data:", data)print("Generated windows:")for window in windows: print(window)**参考内容**
Python实现数据预处理:常见缺失值处理方法解析
[https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ](https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ)
特征选择:基于随机森林的Boruta算法应用
[https://mp.weixin.qq.com/s/wX1B_2wxp3kUVjQKQE5XLw](https://mp.weixin.qq.com/s/wX1B_2wxp3kUVjQKQE5XLw
通透!十大数据预处理方法%20最强总结!
https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ)
[](https://mp.weixin.qq.com/s/wX1B_2wxp3kUVjQKQE5XLw
通透!十大数据预处理方法%20最强总结!
https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ)通透!十大数据预处理方法 最强总结!
[https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ](https://mp.weixin.qq.com/s/wX1B_2wxp3kUVjQKQE5XLw
通透!十大数据预处理方法%20最强总结!
https://mp.weixin.qq.com/s/qNpeQ9hoPGVyjmxxs3bYEQ)**数据处理实例**
Doping:使用精心设计的合成数据测试和评估异常检测器的技术
[https://mp.weixin.qq.com/s/-Fd2xqacThNyhYuPw5fv4g](https://mp.weixin.qq.com/s/-Fd2xqacThNyhYuPw5fv4g)
基于距离度量学习的异常检测:一种通过相关距离度量的异常检测方法
[https://mp.weixin.qq.com/s/JfJo-UQjU1vz9ct5YEw37Q](https://mp.weixin.qq.com/s/JfJo-UQjU1vz9ct5YEw37Q
多变量异常检测:工业数据分析中的异常检测技术
https://mp.weixin.qq.com/s/3HdLeusKtFA-2gPyZ4sG-A)
多变量异常检测:工业数据分析中的异常检测技术
[https://mp.weixin.qq.com/s/3HdLeusKtFA-2gPyZ4sG-A](https://mp.weixin.qq.com/s/JfJo-UQjU1vz9ct5YEw37Q
多变量异常检测:工业数据分析中的异常检测技术
https://mp.weixin.qq.com/s/3HdLeusKtFA-2gPyZ4sG-A)
====
# 孩子兴趣探索 vs 深耕?一个科学决策模型
https://www.paddysun.top/archives/4303 · 2025-11-04
近期在与长辈交流时,我常常会被问到一个的问题:如何在有限的时间内帮助孩子发现真正有兴趣的事物,并投入其中?特别是当学业竞争日益激烈时,孩子的时间变得尤其宝贵,因此,如何平衡兴趣探索与深耕的决策显得尤为重要。本文将介绍一个多臂老虎机算法模型,帮助家长们在这个过程中找到科学的决策路径。
## 解决方案:来自多臂老虎机的启发
为了解决这个问题,我构建了一个特定的决策模型([Multi-Armed Bandit](https://www.bilibili.com/video/BV11a411T7qN/?share_source=copy_web&vd_source=3982ec416caf3ff4e458d45d8f81ec12)),这不仅仅是一个数学工具,更是一个经过精心设计的决策模型,它模拟了在100小时内探索10种常见爱好的过程。该模型的构建基础源自**PERMA模型**(长期幸福感)、**心流理论**(技能发展理论)以及**成长心态研究**的综合应用。
> [【计算模型】基于多臂老虎机模型的爱好选择策略优化研究:探索与开发的权衡分析](https://www.paddysun.top/archives/4305)
## 六种策略及其实际应用
为帮助家长们更好地理解这个模型的应用,本文将详细介绍六种不同的策略,并提供具体的操作指南。
### 1. ε-first策略(探索优先策略)
**原理**:前40%时间均匀探索所有爱好,剩余时间专注最佳爱好。
**操作指南**:
- **探索阶段**(如前3个月):每周轮流尝试2-3个不同爱好,每个活动投入固定时间(如每周2小时),记录孩子的兴趣反馈。
- **开发阶段**(后续时间):根据探索结果,将更多时间投入到最感兴趣且最具潜力的爱好中。
**适合场景**:适用于那些兴趣不明确或者需要进行广泛尝试的孩子们。
### 2. ε-greedy策略(贪心探索策略)★ **最优策略**
**原理**:每次决策时有10%的概率随机探索新爱好,否则选择当前最佳爱好。
**操作指南**:
- **主要时间**(约90%)用于当前最感兴趣的爱好。
- **探索机会**(如每月一次):安排小范围的新爱好体验日,看看能否从中发现新的潜能。
**适合场景**:最适合那些有初步兴趣,但仍然保持开放心态以便探索新可能性的孩子。
### 3. UCB策略(上界置信区间策略)
**原理**:优先选择“平均收益高”且“尝试次数少”的爱好。
**操作指南**:
- **记录系统**:建立一个爱好探索表,记录每个爱好投入时间及评价反馈。
- **计算UCB值**:定期基于公式`UCB = 平均收益 + 2 × √(ln总时间/尝试次数)`排名选择某个爱好。
**适合场景**:与家长偏好高度科学数据统计的家庭。
### 4. Thompson采样策略(贝叶斯采样策略)
**原理**:基于概率分布选择,成功率高的爱好被选中的概率高。
**操作指南**:
- **主观评估**:根据历史表现,进行主观估计每个爱好“成功率”。
- **比选机制**:用类似“抽签”的随机系统来决定重点培养对象。
**适合场景**:适用于那些愿意依据直觉指导的选择方法的家庭。
### 5. Softmax策略(概率分布策略)
**原理**:按当前兴趣程度分配时间,高信念爱好获得多数时间但保留探索空间。
**操作指南**:
- **时间分配**:将孩子当前兴趣所及爱好的时间按偏好程度分配。
- **定期复检**:每个季度重新评估兴趣分布以决定以后如何做调整。
**适合场景**:适用于兴趣广泛而不容易过度专精的孩子群。
### 6. 随机策略(基线参考)
**原理**:完全随机选择,无明确指导。
**建议**:除非在探索初期,否则不推荐使用。
## 实验结果:什么策略最有效?
经过1000次模拟实验,我们获取了各策略下的平均收获评分。
策略平均收获评价ε-greedy**82.015****最优**Thompson采样80.599次优UCB71.754中等Softmax71.935中等随机策略56.711基线ε-first24.507最差
**关键发现**:**ε-greedy策略**(90%深耕+10%探索)是最优选择,因为它能在保证主要时间投入在价值最大化活动的同时,也能通过适度探索发现潜在的优质爱好。
## 现实应用:学习编程的启示
在我们设定的模型中,**编程开发**(平均收益高,但初期回报低)不仅反映了技能积累过程中的延迟回报,还突显了成长心态的重要性。这种策略强调即便面临初期困难,也要保持积极态度,因为一些最值得投入的爱好往往需要一定的学习曲线才能凸显真正的价值。
## 给家长的具体建议
1. **采用“主次结合”模式**:确保主要时间(约90%)用于已知高价值爱好,同时保留少量时间(约10%)用于系统性尝试新项目。
2. **建立探索机制**:每月设定“探索日”,在系统中全面体验新活动,并记录孩子的反馈和表现。
3. **注重长期价值**:即便遇到初期的挑战也不要轻易放弃,因为有些潜在的高回报爱好可能需要更长的时间才能显现。
4. **个性化调整**:根据孩子的个性喜好灵活选择策略,对于数据驱动型孩子可以采用UCB策略,而对于依感觉行事的孩子则可以选择Thompson采样。
5. **定期回顾**:每个季度重新评估孩子对不同爱好的兴趣变化,依据季节和个人成长需求及时调整策略方向。
## 结语
养育孩子,并不只是找到“唯一正确”的爱好发展路径,更是在于建立一个可持续优化决策系统的模型。通过科学地平衡探索与深耕,家长们不仅能帮助孩子发现真正的热爱,还能在有限的时间内取得最大的成长收益。这不仅仅是方法论的总结,更重要的是一种思维方式的转变——即要在不断变化的培养过程中保持灵活与适应。
====
# 【计算模型】基于多臂老虎机模型的爱好选择策略优化研究:探索与开发的权衡分析
https://www.paddysun.top/archives/4305 · 2025-11-04
本研究通过构建一个计算模型(HobbyDecisionModel),模拟个体在有限时间预算下对有限爱好的选择过程,旨在优化探索(尝试新爱好)与开发(专注现有爱好)的权衡。模型参数基于心理学实证研究(如PERMA模型和心流理论),并比较了六种策略(ε-first、ε-greedy、UCB、Thompson采样、Softmax和随机策略)的性能。实验基于1000次模拟运行,结果显示,ε-greedy策略平均收益最高(82.015单位幸福感),显著优于其他策略(如UCB的71.754和随机策略的56.711)。这表明在爱好选择中,适度探索(ε=0.1)能有效平衡短期收益与长期价值。本研究为个人时间管理和幸福感优化提供了理论支持和实践启示。
**关键词**:多臂老虎机;探索-开发权衡;爱好选择;幸福感;计算模型;策略优化
---
### 1. 引言
爱好选择是个人发展的重要组成部分,涉及时间分配和收益最大化问题。传统研究多基于心理学理论(如Seligman的PERMA模型强调长期幸福感,Csikszentmihalyi的心流理论描述技能发展),但缺乏量化模型。多臂老虎机模型(Multi-Armed Bandit, MAB)为这类问题提供了框架,通过探索(获取新信息)与开发(利用已知信息)的权衡优化决策(Lattimore & Szepesvári, 2020)。本研究构建一个基于真实数据的爱好决策模型,比较多种MAB策略,以指导个人在有限时间内最大化爱好收益。模型参数源自实证研究,模拟结果揭示了最优策略的实用价值。
### 2. 方法
#### 2.1 模型设计
我们开发了HobbyDecisionModel类,模拟个体在总时间预算(100小时)下对10种常见爱好的选择过程。模型参数基于心理学实证研究:
- **爱好列表及参数**:如表1所示,爱好的长期价值(gamma)参考PERMA模型(Seligman, 2011),初期收益(alpha)和中期收益(beta)基于成长心态研究(Dweck, 2006)。编程开发被设定为“真正的最爱”(标记为★),因其高技能积累和职业相关性(长期价值0.95),但初期收益较低(0.15),反映学习曲线陡峭。
- **收益函数**:
- 探索阶段收益:初期线性增长,后转为对数增长,反映学习曲线(Ericsson, 1993)。
- 开发阶段收益:采用S型函数,模拟专业技能的非线性积累,并加入心流体验加成(Csikszentmihalyi, 1990)。
- **信念更新**:基于贝叶斯学习理论,根据观察收益更新个体对爱好价值的信念。
- **交叉收益矩阵**:反映技能迁移性,参考跨学科学习研究(如技能迁移理论)。
*表1: 爱好真实参数(基于心理学研究和实证数据)*
爱好名称长期价值 (gamma)初期收益 (alpha)中期收益 (beta)音乐演奏0.850.250.55绘画创作0.820.300.52编程开发 ★0.950.150.65健身训练0.780.350.48阅读学习0.880.400.58烹饪烘焙0.720.450.45园艺种植0.680.380.40摄影摄像0.750.320.50写作创作0.900.280.60手工制作0.700.420.47
#### 2.2 策略实现
通过StrategyEvaluator类比较六种策略:
- **ε-first策略**:前40%时间均匀探索所有爱好,剩余时间开发信念最高的爱好。
- **ε-greedy策略**:每次决策以10%概率随机探索,否则选择当前最佳爱好。
- **UCB策略**:使用上界置信区间平衡探索与开发,参数c=2(Auer et al., 2002)。
- **Thompson采样**:基于Beta分布的后验采样,实现贝叶斯优化。
- **Softmax策略**:按当前信念的概率分布选择,温度参数为0.1。
- **随机策略**:作为基线,完全随机分配时间。
##### 2.2.1. **ε-first策略(探索优先策略)**
**策略原理**:
- 在总时间的前ε比例(默认40%)进行系统探索,均匀尝试所有爱好;剩余时间专注于信念最高的爱好进行深度开发。
- 优点:确保全面探索,避免错过潜在优质爱好;缺点:探索阶段可能浪费时间在低价值爱好上。
**家长操作方式**:
- 探索阶段(例如前3个月)
- 安排孩子每周轮流尝试2-3个不同爱好(如音乐、绘画、编程),每个爱好投入固定时间(如每周2小时)。
- 记录孩子的兴趣反馈和初步成就感(如“喜欢程度评分1-10”)。
- 开发阶段(后续时间)
- 基于探索结果,选择孩子最感兴趣且收益最高的爱好(如编程),增加投入时间(如每周5小时)。
- 例如:暑假广泛尝试,开学后专注1-2个核心爱好。
- **关键提示**:适合兴趣不明确的初期阶段,避免过早专精。
---
##### 2.2.2. **ε-greedy策略(贪心探索策略)**
**策略原理**:
- 每次决策时,以ε概率(默认10%)随机探索新爱好,否则选择当前最佳爱好。
- 优点:持续探索,适应兴趣变化;缺点:可能过度探索低概率爱好。
**家长操作方式**:
- 日常安排
- 主要时间(90%)用于孩子当前最喜欢的爱好(如阅读)。
- 每月安排1-2次“新奇体验日”,随机尝试新活动(如园艺、手工)。
- 调整机制
- 如果孩子对某个新爱好表现出强烈兴趣,适当增加其时间比例。
- 例如:平时每天练琴1小时,每月一次家庭烘焙活动。
- **关键提示**:适合兴趣相对稳定但需保持开放性的场景。
---
##### 2.2.3. **UCB策略(上界置信区间策略)**
**策略原理**:
- 通过数学公式平衡探索和开发:优先选择“平均收益高”且“尝试次数少”的爱好。
- 优点:数据驱动,高效利用信息;缺点:需持续记录数据。
**家长操作方式**:
- 数据记录
- 制作“爱好探索表”,记录每个爱好的投入时间、孩子收益评分(如快乐度、技能进步)。
- 例如:表格包含“爱好名称|累计时间|平均收益|最近尝试日期”。
- 决策规则
- 定期(如每周末)计算每个爱好的UCB值: `UCB = 平均收益 + 2 × √(ln总时间/尝试次数)`
- 选择UCB最高的爱好安排下周时间。
- **实例**:如果编程收益高但尝试少,优先安排;绘画收益平稳则维持。
- **关键提示**:适合注重科学决策的家庭,需家长耐心记录。
---
##### 2.2.4. **Thompson Sampling策略(贝叶斯采样策略)**
**策略原理**:
- 基于贝叶斯概率:从每个爱好的成功率分布中采样,选择采样值最高的爱好。
- 优点:灵活处理不确定性;缺点:需要概率思维。
**家长操作方式**:
- 主观评估
- 家长根据孩子历史表现,主观估计每个爱好的“成功率”(如编程成功率70%,绘画50%)。
- 例如:孩子过去学乐器快,则音乐成功率评级高。
- 随机选择
- 每月初,用抽签方式决定重点爱好(成功率高的爱好中签概率高)。
- 例如:写10张纸条(7张“编程”,3张“绘画”),抽中哪个就侧重培养。
- **关键提示**:适合直觉型家长,能结合孩子特质灵活调整。
---
##### 2.2.5. **Softmax策略(概率分布策略)**
**策略原理**:
- 根据当前信念的概率分布选择爱好:高信念爱好被选中的概率高,但保留探索机会。
- 优点:平滑过渡探索与开发;缺点:温度参数需调试。
**家长操作方式**:
- 时间分配比例
- 按孩子当前兴趣程度分配时间(如最喜欢的三项爱好占80%时间,其余20%尝试新活动)。
- 例如:孩子60%喜欢编程,20%喜欢阅读,20%其他——每周按此比例安排时间。
- 动态调整
- 每季度重新评估兴趣分布,根据学校活动、季节变化调整(如暑假增加户外爱好权重)。
- **关键提示**:适合兴趣多元但需避免过度分散的孩子。
---
### 6. **随机策略**
**策略原理**:
- 完全随机选择爱好,无目标性。
- 优点:简单易行;缺点:效率最低,易迷失方向。
**家长操作方式**:
- 避免使用
- 除非在极度自由探索阶段(如幼童游戏),否则不推荐。
- 若需随机元素,可结合其他策略(如每月一次“幸运抽奖”选择新活动)。
- **关键提示**:仅作为基线参考,实际应用应优先其他策略。
### 3. 实验设置
模拟运行1000次,总时间预算为100小时,探索阶段占比40%。评估指标为平均累积收益(单位:幸福感),基于模型中的收益函数计算。实验环境使用Python编程实现,确保了结果的可重复性。
### 4. 结果
策略性能比较基于1000次实验的平均奖励,如表2所示。ε-greedy策略获得最高平均收益(82.015单位幸福感),Thompson采样次之(80.599),而ε-first策略收益最低(24.507),随机策略作为基线收益为56.711。
*表2: 策略性能比较(基于1000次实验的平均奖励)*

策略名称平均奖励(单位:幸福感)ε-first24.507ε-greedy82.015UCB71.754Thompson80.599Softmax71.935随机策略56.711**最优策略****ε-greedy**
### 5. 讨论
#### 5.1 策略性能分析
ε-greedy策略的表现最优(平均奖励82.015),归因于其对于单一爱好的长期探索:10%的探索概率允许持续尝试新爱好,避免过早收敛于次优选择,同时90%的开发概率确保时间集中于高价值爱好(如阅读)。这与多臂老虎机理论一致,即适度探索能减少遗憾(Lattimore & Szepesvári, 2020)。相比之下,ε-first策略收益最低(24.507),因为其固定探索阶段(40%时间)过长,导致开发不足,无法充分利用高长期价值爱好;UCB和Softmax策略收益中等(约71-72),可能因参数设置未完全适应爱好收益的非线性特征。
#### 5.2 模型与实际应用的关联
模型参数基于真实心理学数据,例如:编程开发作为“真正的最爱”但初期收益低,反映了技能积累的延迟回报(Ericsson, 1993);而烹饪烘焙初期收益高(0.45)但长期价值较低(0.72),符合短期满足与长期收益的权衡。信念更新机制模拟了人类学习过程,个体通过贝叶斯学习逐步识别高价值爱好,这与心流理论中“技能-挑战平衡”相契合(Csikszentmihalyi, 1990)。实践上,本模型建议个人在爱好选择中采用ε-greedy类策略:定期尝试新活动(如每月探索一个新爱好),同时主要时间投入于已识别的高价值爱好,以最大化长期幸福感。
#### 5.3 局限性与未来工作
本研究假设爱好收益静态独立,而实际中可能存在动态交互和外部因素(如社交影响);未来工作可引入多目标优化(如同时考虑幸福感和技能提升)或强化学习扩展。此外,模型参数基于通用数据,个体差异未纳入;未来可个性化参数校准。
### 6. 结论
本研究通过多臂老虎机模型优化了爱好选择策略,实证表明ε-greedy策略在平衡探索与开发方面最具优势。模型基于心理学理论,为行为决策研究提供了计算框架。实践上,个体可借鉴此模型分配时间,以最大化长期幸福感。未来方向包括扩展至动态环境和真实世界验证。
====
# 从失乐园到复乐园
https://www.paddysun.top/archives/4298 · 2025-11-04
读完《失乐园》与《欲乐园》两本书之后本来没什么好说的,但忍不住诱惑看了看书评,那些飘忽的情感好似凝结了起来。变得不吐不快。
## 切开,子宫与“野”医生
《生命之轻》中描述切开病人身体时:医生“就体会到一阵强烈但短暂的亵渎神灵的感觉。吸引着他的肯定是这东西!”这是一种诗画的描述,是昆德拉的想象。
而真正做过外科医生的渡边纯一描写的手术场面与这截然相反,有着琐碎的问题,需要繁琐的操作,面对着腹腔中“鲜血犹如从地底下冒出,卷着漩涡,汹涌而来”场面的小医生,只会祈求神明的保佑。
```
前面有个颜色发黄的膀胱,子宫就在它后面。子宫两侧有两条绳子一样的东西伸出来,很好找。把手伸进去拿出胎盘。鲜红的、滑不出溜的,只要把它摘掉,出血自然就停了
```
《欲乐园》中对于手术等医生场景描写是极其成功的。读者能够一窥无影灯下的场景,充分感受到主角成长的不易——一个没学过医的,有着极高天赋的普通人,机缘巧合之下从手术助手找阑尾开始一步步成长为受人敬仰的医生。这个过程是极其艰辛的,特别是在一个学历之上的社会当中,勿论医生这个凭执照上岗的特殊职业。
在书中的世界里,有没有医师执照似乎将人划分为了两个不同的物种。一个天上一个底下。这种心理是能够理解的。我在健身房锻炼的时候就在想:我这么努力,受了这么多酷,什么样的女朋友能配上我啊。设想背了数不清的书,考了数不清的考试,本科也比别人多一年的医学生来说也就不难理解了。
这种学历社会下,以证书或者学历来评判人的情况,正是《欲乐园》的核心矛盾,然而我认为其表现的不够,主要体现在《欲乐园》对于人物塑造上的乏力。
## 乏力的人物,专一的视角
书中有个重要配角,明子护士,是渡边年轻时经历的两段恋情的女主角构成的。渡边从札幌医学院整形外科调到东京工作后,就与分隔两地的女友智子护士分了手。在银座酒吧认识了酒吧女招待铜子,很快坠入爱河,但渐渐地发现她太较真,太规矩,感觉很有压力,最终分了手。(欲望乐园归去来兮,竺家荣)
然而本书似乎不关心,除了男主角之外其他人的想法,几乎没有其他角色的内心独白。这就让男主角三郎与明子护士的恋情,三郎与富家千金亚希子的恋情,显得较为突兀和苍白。不禁让我感到疑惑,为什么她会喜欢上她。
这种天降似的爱情,说好听点叫自然而然,说难听点叫莫名其妙。这样显得明子与亚希子这个女主显得十分的标签化与单薄。同样的情况也发生在亚希子父亲,这个本可以塑造为看不起低学历之人的反派角色。通过对其的塑造,明明可以进一步加深本书的核心矛盾,突出社会造成的人的异化,控诉社会的不公。
但本书并没有这么做,这样专一的视角恰恰又是最真实的。我们能听到的只有主角自己的心声。我们能看到只有他人的外表,永远不可能看到他人的内心。
毕竟“人心隔肚皮”。这种独特的专一视角,也定是作者有意为之。
## 乐园到底在哪?
有人评价:在《失乐园》中看到的是都市人的迷失,在性虚背后的绝望感,无法脱离社会规范,无法救赎,也无法解脱。
确实《失乐园》中的男女主二人在事业上并不“成功”,不是“社会所需要”的人。他们似乎沉醉在低级的欲望当中无法自拔。
然而《欲乐园》中,男主三郎有着高超的医术,为社会所所需,被同事所敬仰,有能力过上社会精英的生活,却忍受不了内心的煎熬选择了逃离。他似乎也迷失了。
然而我们不仅要问:若没有社会规范的约束,沉醉在低级的欲望又有何妨?若没有医生执照这回事,三郎能否凭借高超的医术出人头地?
幸福有高下之分吗?我曾经的文章中毫不犹豫写下了:“做一个不满足的人胜于做一只满足的猪;做不满足的苏格拉底胜于做一个满足的傻瓜。”
窃以为渡边淳一想要表达的与这截然相反。正如边沁所说:幸福没有高下之分,口腹之欲和心智之养没有区别。《失乐园》中久木祥一郎、松原凛子抛却了一切现实,在私欲的释放中到达了极乐。而《欲乐园》中的三郎一直为社会规则所困,只能靠逃避来解决问题。
这两本书带给我们最宝贵的,正是关于:在当今社会中,人应该怎样生活,才算是真的生存过的思考。
我们的乐园在哪里呢?
我“现在对自己所做的事情以及未来的道路还是很茫然的。”
“当我们徘徊在权威与反权威的两大阵营的夹缝间时,如何寻找值得相信的真相?如何思考存在的意义?如何实现自己的价值?如何看待大师的作品?这是一个值得思考的问题。”
====
# 【杂】小说写作的变迁
https://www.paddysun.top/archives/4290 · 2025-11-04
载体本身无所谓,我最近观察到的一个现象就是年轻人的思想表达,以前跻身在V家的曲子中,现在则是二创填词的什么电棍顶针抽象视频,猫meme,番的mad(如mygo),甚至是一些直白的杂谈视频。 如何看待从blog到发帖,再到发视频,信息的高速路在不断加速。
我认为思想需要通过媒体(media,传播信息的媒介)而传播。新媒的出现与发展,必然导致思想以不同的形式出现。
### 小说写作的变迁
分析小说这一文学体裁,思维的表达方式,的发展变化。我们可以看出其不仅仅受社会环境的影响,也随着媒体的发展而发展,也因为新媒体的挑战而改变。
最早的小说可能以口头故事的形式存在,以手抄本的形式传播。如中世纪的骑士传奇和东方的志怪小说。是吟游诗人口中奥德修斯在海上的历险;是说书先生口中的九尾狐。和我们今天在联网上吃的瓜也没什么区别,也登不得大雅之堂。
随着印刷工艺的发展(活字印刷于公元10世纪发明),小说的印刷和传播变得更为广泛。随着受众的扩大,其易读性也显著提升。18世纪末期,在蒸汽机的轰鸣中,伦敦的灰雾中,受到工业革命冲击的人们寻求浪漫主义文学的慰藉。并于19世纪上半叶,达到浪漫主义的高峰,涌现了拜伦、雪莱等一大批作家。
```
《呼啸山庄》
我若祈祷,我们便着来实唯一,启动我双唇的祷文只有:“请便着来实扰乱我的心,小任变我我自由。”是的,短暂的生命已近终点,这是我唯一的祈求——后之将小起论生死,起一求心灵后之将小起拘,一觉有勇生风接受。
```

而在19世纪中叶,资本主义确立,以法国七月革命和英国光荣革命为标志。促使人们以客观理性的角度观察世界,将物质利益成为衡量事物的重要标准。此时的作家仔细临摹现实,纤毫毕现的呈现呈现现实生活。“除细节的真实外,还要真实地再现典型环境中的典型人物”,提供足够的背景,为人物的每一个行为提供都足够动机。
```
《安娜·卡列宁娜》
“到时候再看吧。”斯捷潘·阿尔卡季奇自语道,站起身来,穿上浅蓝丝绸衬里的灰色睡衣,甩起穗带打了个结,向自己宽阔的胸腔里充分吸进一口气,习惯性地迈出精神充沛的步子,向外撇着两脚,那样轻松地撑着他肥满的身体,走到窗边,拉起窗帘,响亮地打了打铃。应着铃声马上走进来他的老朋友、贴身男仆马特维,拿着他的外衣、一双靴子和电报。跟着马特维走进来的是带着刮脸用具的理发师。
```
当时人们感受他人生活,主要靠的就是小说。文字里纤毫毕现的现实,便是他们的照片他们的电影。而当摄影技术真正发展起来时,作家们感受到了危机。

约1826年,世界上第一张照片《窗外的风景》诞生 。1851年,阿彻发明了成本更低,表现力更强的湿板摄影。这促进了摄影技术的普及化进程。随着科技进步和工业革命的浪潮,尤其是19世纪中叶社会经济的快速发展、中产阶级的兴起以及人们对新奇科技的渴望,逐渐走进了普通人的生活。
20世纪的作家们意识到,再怎样去描摹现实都不如一张照片来的真实。很多作家开始探索写作的可能性。卡夫卡,乔伊斯,博尔赫斯,西亚·马尔克斯,米兰昆德拉等人形成了他们自己的答案。
其中,米兰昆德拉认为,小说的使命是去拷问和探究存在。“存在,就是‘在世界之中’。世界构成人的一部分,它是人的维度。存在,并非已发生之事,存在是人类可能性的场域,一切人可能成为的,一切他能够做到的。”
具体来说,其又是如何拷问这种存在的呢?现实主义的作家会淋漓尽致的描线现实的场面,而昆德拉会让主角驻足与面包和油条之间,纠结——吃面包就不能吃油条。通过展示主人公一点点做出最终选择的过程,昭示人的存在是一种充满了可能性的场域。
就像是薛定谔的猫,在不被观察时处于生与死的叠加状态,这就是其的存在,一种可能性的场域。但一旦观察,其就变为了现实,不在是存在。
这种可能性的场域用相机是难以表达的,因为图像就是显示状态的定格,影片也不过是多张照片的排列。并且是适合用文字表达的,毕竟从黑白的文字到读者脑中的想象就是一种不确定性——“一万个读者有一万个哈姆雷特”。

有人认为,这段时期中的作品,如《变形记》《城堡》《尤利西斯》《百年孤独》等,很难被影视化,其中包含了唯有小说才能表达的观点。同样,我们也可以说影视中也有文字难以表达,可以借鉴之处。
摄影技术也同样使得小说中的现实主义的进一步深化——推动了纪实文学、非虚构小说的发展;也推动了小说中叙事方式的革新——例如詹姆斯·乔伊斯的《尤利西斯》。
《尤利西斯》借鉴了电影的剪辑技巧来构建小说结构。书中一天内的事件被扩展为详尽的心理分析和感官体验,而某些时刻则被极度压缩,这种对时间的操控与电影剪辑中加速、减速、定格等手段异曲同工,能够增强情感表达或突出特定主题。
在这个过程中,文字与影像各自发挥所长,互为镜照,共同拓展了人类叙事与思维表达的边界,证明了不间媒体之间既竞争又共生的动态平衡,以及它们在不同历史时期中持续激发创意、深化人类自我理解的力量。
====
# 【观察与猜测】为何我们关上了沟通的门?——从“闭锁心理”谈起
https://www.paddysun.top/archives/4286 · 2025-11-04
观察开始
前些日子的一次深圳之行,让我有幸见证了一对母女之间充满阳光的互动:小女孩活泼开朗,乐于向客人展示新学的歌曲和知识,脸上洋溢着被看见、被认可的自信光芒。
这个画面,与我日常教学中接触到的另一个案例形成了鲜明对比。那个孩子长期拖欠作业陷入恶性循环,面对不擅长的学科时,甚至会身体不适(如皮肤瘙痒)。更令人心痛的是,他会下意识地躲避老师,拒绝沟通交流(甚至拒绝回答你今天有什么作业这样的问题),仿佛每一次交流都是一次需要逃避的审判。
这两种截然不同的状态,引发了我对自己教学实践乃至我亲子关系的深度反思。我发现,无论是成年人还是孩子,当沟通的渠道变得狭窄,当表达的热情逐渐熄灭时,背后往往隐藏着一种复杂而普遍的心理机制——我将它称为**“闭锁心理”**。
今天,我想结合心理学视角,与大家一同探讨这种心理状态的成因、表现以及可能的出路。
---
### **一、 “闭锁”背后:我们为何会关上心门?**
“闭锁心理”的形成,并非一朝一夕,而是源于我们内心深处一些根深蒂固的假设和机制的失衡。
#### **1. 内心的渴望与恐惧:一场永恒的拉锯战**
从根本上说,人是社会性动物,我们天生就渴望与他人建立连接,渴望被理解、被认可(这被称为“归属需求”)。但同时,我们对社交中的潜在风险——比如被拒绝、被否定——也有着天生的回避本能。这两种力量在我们心中不断拉扯。
当“被否定”的恐惧压倒了“被连接”的渴望时,我们便会启动防御机制,选择退回到自己的世界里。
#### **2. “预期”的决定性作用**
我们的行为,很大程度上取决于我们对未来的“预期”。这个“预期”并非凭空而来,而是由过去的经验塑造的。
- **积极的反馈循环**:一次成功的分享(比如小女孩唱歌得到了大家的掌声),会强化“表达是被欢迎的”这一认知,让她更愿意下一次再次尝试。
- **消极的固化循环**:而如果过去的尝试总是换来冷漠、敷衍甚至否定(比如孩子分享想法后被说“这有什么好说的”或“别来烦我”),大脑就会形成一个消极的自动化思维:“我的想法没价值”、“说出来也没用,还会被嘲笑”。为了保护自己免受预期的伤害,个体会选择沉默、回避,而这种回避行为,恰恰又因为没有新的积极反馈来修正认知,从而让这个消极循环愈发坚固。
#### **3. 心理上的“成本效益分析”**
我们的大脑在无形中会进行一场“成本效益”的计算。这里的“成本”是主观放大的:它可能被认为是**“情绪消耗”**(解释清楚一件事太累了)、**“风险成本”**(需要暴露自己的脆弱,可能会被攻击)、或**“背景成本”**(我的经历你们不了解,解释起来太麻烦)。
而“效益”——获得认同、建立连接——却被主观低估了,甚至被“无意义”化。当计算结果是“投入远大于产出”时,大脑自然会选择那个最“划算”的选项:不做,即保持沉默。
---
### **二、 “闭锁”的日常表现?**
“闭锁心理”像一个无形的屏障,在日常行为中会有多种具体表现,值得我们留意。 这是我的总结:
1. **行为上的“逃离”与“替代”**
- **沉迷虚拟世界**:长时间刷手机、玩游戏、看网络小说,这些低互动、高反馈的虚拟活动,成了逃避现实社交的“避难所”。在这里,你可以不用解释,也无需担心被评判。
- **物理与心理上的回避**:回避眼神接触,减少对话,在有人靠近时下意识后退或转移话题。对于需要表达的任务,能躲则躲。
2. **认知上的“屏蔽”与“僵化”**
- **选择性“失聪”**:当别人与他沟通时,仿佛听不见,不做任何回应。这并非生理问题,而是心理上的自我保护,通过切断信息输入来避免潜在的负面刺激。
- **思维的“自我设限”**:陷入“反正他们也不会懂”、“我的想法太幼稚了”、“说了也白说”的僵化思维中,拒绝接收任何新观点,也否定了自己的思考价值。
3. **自我表达上的“压抑”与“沉默”**
- **隐藏“光”**:有创意的想法、学习的成果、内心的喜悦,都选择不展示。这背后是深深的“我不够好”的羞耻感,以及对“展现后被否定”的恐惧。
- **用“疲惫”合理化**:当被鼓励分享时,常用“累了”、“没意思”、“懒得说”等借口来搪塞,这其实是一种防御性的沉默,是对“暴露自己”的合理化回避。
---
### **三、 走出“闭锁”:如何重建连接的桥梁?**
“闭锁心理”是认知、情绪和环境共同作用的结果,打破它需要耐心和智慧,从个体和环境两方面入手。
#### **(1)个体层面:成为自己思维的“破壁人”**
1. **识别并挑战自动化思维** 当“我说的没人听”这个念头出现时,学着像旁观者一样审视它:“这是100%的事实,还是我的一个消极猜测?有没有任何证据证明相反的可能性?” 通过这种认知行为疗法(CBT)中的技术,松动根深蒂固的负面信念。
2. **进行“微尝试”,重获掌控感** 不必追求一步到位的完美表达。可以从最低风险的“微互动”开始,比如在群里发一个与主题相关的表情,或在私下给朋友点个赞,简单附一句“这个很有趣”。每一次微小的成功,都是在为自信账户“储蓄”。
3. **练习自我关怀** 理解并接纳自己的恐惧和回避行为。告诉自己:“不想说话是正常的,这并不意味着我有什么问题。” 用温暖的态度对待自己,而不是苛责,是改变的起点。
#### **(2)环境层面:营造一个“安全”的表达空间**
1. **提供“无评判”的倾听** 作为家人、朋友或师长,最重要的任务是创造一个绝对安全的氛围。当对方愿意开口时,请放下手机,给予全然的关注,用“嗯”、“后来呢?”等简短回应表示你在听,而非急于评判、给建议或转移话题。
2. **从“评价”转向“好奇”** 与其说“你画得真棒”(这是一种评价),不如问“你画这幅画的时候,脑海里在想什么呀?”(这是表达好奇, “同一阵线”)。后者将焦点从“作品的好坏”转移到了“人的感受和思考”上,让对方感到自己的内在世界被珍视。
3. **庆祝微小的进步** 当那个回避的孩子,哪怕只是抬起头看了你一眼,或者简短地回应了一个词,都请给予真诚(从细节出发,情真意切的)的肯定。这种“正向强化”是打破消极循环最有效的燃料,它能帮助对方重新建立“我的尝试是被欢迎的”这一积极认知。
**写在最后**
无论是活泼自信的小女孩,还是陷入“闭锁”困境的孩子,其差异不在于天生的性格优劣,而在于后天互动中积累的无数微小的经验。那些被看见、被回应、被珍视的时刻,如涓涓细流,汇成自信的江河;而那些被忽视、被否定、被冷落的瞬间,则可能筑起一堵沉默的高墙。
需要指出,和时刻提醒我自己的是:并非“外向”就是好的,“内向”就是坏的。若能够从独处中汲取能量,在安静的内省中恢复精力,**“内向”就只不过是一种健康且稳定的性格特质**。社交对他们而言是“可选项”,独处是舒适的“充电模式”。**“闭锁”**者则可能在内心深处渴望连接,但恐惧和预期的痛苦让他们无力行动。这种内心的挣扎和回避本身,就是一种巨大的**能量消耗**,会让他们感到疲惫和耗竭。
理解“闭锁心理”,是为了更深刻地理解我们自己,以及我们身边那些暂时“关上心门”的人。这需要我们付出更多的耐心、智慧和善意,去拆掉那堵墙,而不是在墙外指责它的冰冷。因为,在墙的另一端,同样渴望着一个能安全表达的世界。
---
*本文仅为笔者个人学习笔记与教育反思,其中所有案例均经过深度脱敏与复合化处理,尽可能去除了任何真实可识别的个人隐私。*
*文中所提及的观点仅为个人见解,不能替代专业的心理咨询或医疗诊断。若您或您身边的人有严重的心理困扰,请务必寻求合格的心理健康专业人士的帮助。*
====
# RSA加密算法数学原理
https://www.paddysun.top/archives/4254 · 2025-11-04
RSA加密
RSA加密符号说明MOD此符号有两个含义 由于网上资料对此符号的混用,故特此说明同余符号 给定正整数m,如果两个整数a和b满足a-b能被m整除,即m|(a-b),那么就称整数a与b对模m同余,记作a≡b(mod m)取余符号 a mod b = c 表示整数a除以整数b所得余数为cgcd()与的最大公因数gcd(a,b)=a与b的最大公因数 RSA加解密方法欲加密明文m选择两个大质数p和q 计算n=p*q,安全要求n至少为1024位长计算φ(n)=(p-1)(q-1)选择公钥e,满足1≤e<φ(n),gcd(e,φ(n))=1 (gcd最大公约数)选择私钥d,满足于e*d≡1(mod φ(n) )加密 传递e、n给对方 ,加密明文m为c方法如下c=memodn解密 已知d、n时 ,将密文c解密为明文方法如下m=cdmodn数学原理欧拉函数 φ(n)的计算定义:φ(n) 表示在小于等于 n 的正整数之中,与 n 构成互质关系的数的个数。如果 n = p * q,p 与 q 均为质数,则φ(n)=φ(pq)=φ(p−1)φ(q−1)=(p−1)(q−1)明白了对于任意数n的φ(n)的计算方法即可得出上述结论对于任意数n的φ(n)的计算再说一遍:φ(n) 表示在小于等于 n 的正整数之中,与 n 构成互质关系的数的个数。1~N共有N个数,去掉其中N的因数,剩下的就是与 n 构成互质关系的数。由此即可求出φ(n) 。先对N进行质因数分解:N=p1c1p2c2p3c3⋯pmcm1~N中,任一质数p的倍数的个数为[N/p]取整,另一质数q的倍数的个数为[N/q]取整。1~N中除去p与q的倍数。剩下的,与 n 构成互质关系的数的,个数为N−Np−Nq+Npq=N⋅(1−1p)(1−1q) PS: 因为pq的倍数被多去了一次,所以要加上[N/pq]取整。使用了容斥原理。由质因数分解的定义可得,N的全部因数为p1p2p3⋯pm有φ(N)=N−∑i=1mNpi+∑1≤i 1: res //= n res *= (n - 1) return respython按欧拉函数定义计算任意数的欧拉函数xxxxxxxxxximport fractions
def phi(n): amount = 0 for k in range(1, n + 1): if fractions.gcd(n, k) == 1: amount += 1 return amount公钥私钥的生成公钥的选择条件 gcd(e,φ(n))=1 保证了私钥d的存在,既e的逆元存在模φ(n)为什么呢,需要理解 模的逆元 这个概念模的逆元定义:模m意义下,e与m互质时,存在k, 有de=km+1既de≡1(mod m ),则称d为e的逆元逆元存在的充要条件模m意义下,e的逆元存的冲要条件就是,gcd(e,m)=1证明则需要使用 辗转相除法 的知识,见下文辗转相除法也叫欧几里得算法,对于e、φ(n)有s、d,有下式gcd(Φ(n),e)=s⋅Φ(n)+d⋅e当 gcd(e,φ(n))=1时,上式为1=s⋅Φ(n)+d⋅e可写成下式,后文的证明需要使用此式d⋅e=1+s⋅Φ(n)证明解密是加密的逆过程当我们知道d、n可对密文c进行如下操作得到明文m。
证明解密是加密的逆过程即证明下式成立m=cdmodn证:考虑到c=mdmodn=(cdmodn)emodn对于c可进行如下代换c=(me+k1n)将上式带入后有右式右式=cdmodn=(md+k1n)dmodn右式右式=(∑i+j=dmie(k1n)j)modn=(med)modn 对于ed有下式d⋅e=1+s⋅Φ(n)带入右式有右式右式=(med)modn=mms⋅Φ(n)modn其中,由快速幂取模(后文有解释)有ms⋅Φ(n)modn=∏i=1..s(mΦ(n)modn)modn欧拉定理(后文有解释)得出mφ(n)modn=1带入后右式有右式右式=m⋅1modn=mmodn由于0≤m