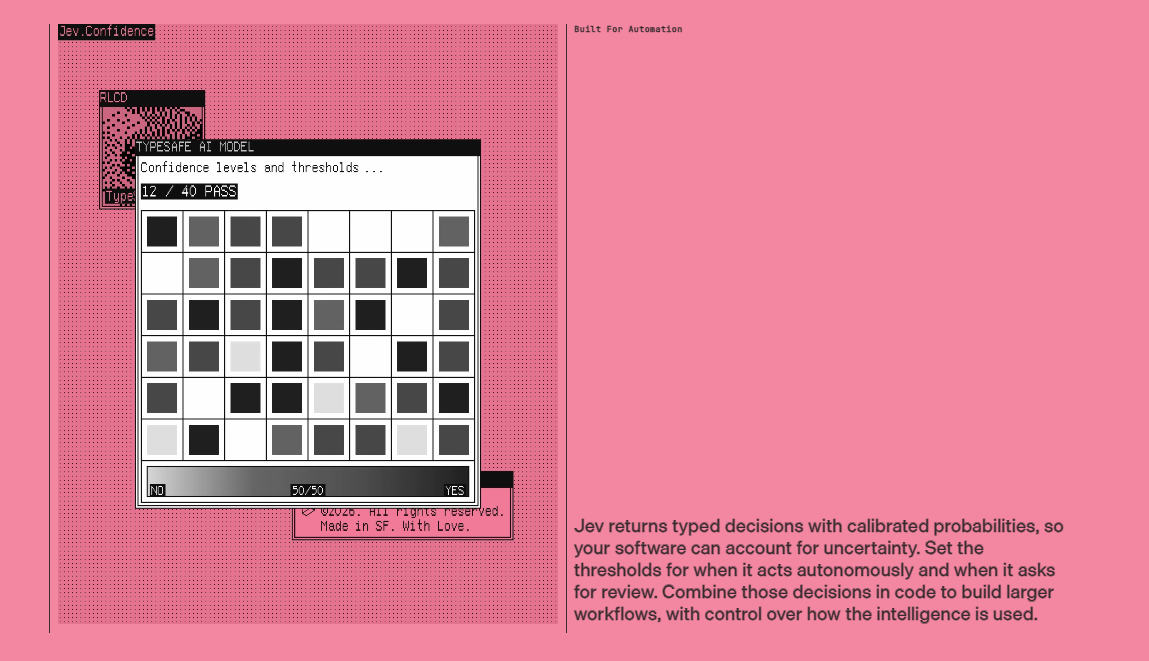
9 月 15 日,旧金山公司 TypeSafe AI 发布了 Jev。
这个模型不聊天,不写代码,不生成任何文本。给它一段状态和一组候选选项,它返回一个选择、一个分数或一个概率。
随后一周,它在 X、GitHub 和 Agent 开发者社区刷屏,发布视频播放量 3600 万 1,Hacker News 的讨论帖攒到 1972 分、512 层楼(截至 9 月 23 日)2,中文媒体跟着发了《刷屏了》《为啥突然全网爆火》。
刷屏的同一周,至少三个互不隶属的开源项目宣布复现了它。
「Jev 是谁带火的」,这个问题没有单一答案。可查证的事实分四段:
第一段,产品。Jev 是 TypeSafe AI 的第一个公开模型,官方称之为 System One Model,定价每十亿输入 token 42 美元,输出不收费。
第二段,官方口径与第三方实测之间有实质差距。速度优势在公平对比下从「40200 倍」缩水到 1.216 倍;「零幻觉」的宣传撞上 16% 真实标签零概率的实测记录。
第三段,复现生态。Laya、APUS-OpenJev、zefan-cai Open-Jev、六个两天内出现的克隆–「OpenJev」已经不是一个项目的名字,是一类项目的统称。
第四段,实测。本文在两台设备上跑了开源复现 Laya 的三个 checkpoint:准确率 80%93%,单次决策 33270 毫秒;又从第三台设备经局域网远程复测、用 4B 生成式模型同题对照(86.7%),并把 Laya 拉进一个真实生产任务(中文商品类目分类)量了底细–69.2%,输给同题的全部生成式对手,包括一个 0.8B。
下面分段展开,每段附出处。
一、Jev 是什么:看看其背后的公司
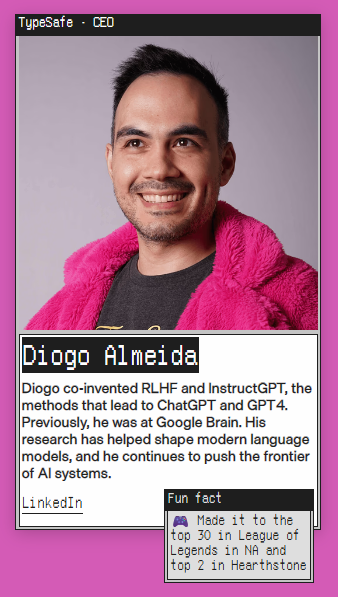
TypeSafe AI,旧金山公司,
创始人兼 CEO Diogo Almeida。
官网团队页的介绍原话:「Diogo co-invented RLHF and InstructGPT, the methods that lead to ChatGPT and GPT4. Previously, he was at Google Brain.」3
注意官方措辞是「共同发明了 RLHF 和 InstructGPT 这两个方法」,不是「发明了 ChatGPT」。顺带解释两个缩写:RLHF(Reinforcement Learning from Human Feedback)是基于人类反馈的强化学习,把 ChatGPT「调教」出来的那套训练方法;InstructGPT 是 ChatGPT 的前身模型。中文媒体怎么转述的,见第八节。
公司以 stealth 状态(隐身运营,不公开宣传)运作约两年,发布时带着约 4000 万美元种子轮(此数字见于第三方转述,原始出处未核实)4。
2026 年 9 月 15 日,Jev 公开发布。四个独立的第三方信源给出的日期一致 5。9 月 21 日取消候补、全面开放 6。
官方文档的定义原话:「Jev evaluates typed questions against a state and returns structured results directly. No text generation, no parsing.」7
官方文档把这三种基础判断能力称作「AI 原语」(primitive,编程术语,指可直接调用、可组合的最小功能构件,类似标准库函数)7:
| 原语 | 问题类型 | 返回 |
|---|---|---|
| Choice | 从候选中选一项 | choice、各选项概率、置信度 |
| Score | 按评分规则打分 | score、概率分布、置信度 |
| Noul | 陈述是否为真 | 0~1 概率 |
三种问题可以混在一次调用里。官方原话:「Every question is evaluated in parallel and in isolation against the same state in one go. Adding questions barely changes the response time.」7
官方还给了一条使用原则:每个问题只问一件小事,问的是「the kind of judgment a highly knowledgeable person could make in a few seconds given the right context」–一个懂行的人看一眼上下文几秒钟内能下的判断 7。
定价是传播最广的点。token(词元)是模型的计费单位,大约一个单词或半个常用词。官方首页原话:「$42 Per Billion input tokens」,输出 token 不收费 3。
换算成常见口径是每百万输入 token 0.042 美元。凤凰科技的转述把两说讲清楚了:「输入每十亿 token 为42 美元,换成常见口径,就是每百万 token 0.042 美元;输出不收费。」12
所以「输出永久免费」和「$0.042/1M tokens」不矛盾,是同一个数字的不同分母。
但官方 FAQ 里自己列了「Are these prices temporary or subsidized?」的问题–价格能否持续,官方留了口子 3。
二、名字的来历
System 1 / System 2 出自心理学。丹尼尔·卡尼曼 2011 年的《思考,快与慢》让这对术语大众化 14。
AI 界用这套框架也早于 Jev。LeCun 2022 年的《A Path Towards Autonomous Machine Intelligence》已经用 System 2 论述机器智能 15;2025 年的综述《From System 1 to System 2: A Survey of Reasoning Large Language Models》被引已超过 400 次 16。
TypeSafe 做的事,是把「System One Models」注册成一个产品类别名。官方博客《Introducing System One Models and Jev》(9 月 15 日)解释了两个名字的来历:「We were inspired by Daniel Kahneman, Thinking, Fast and Slow. We named Jev after William Stanley Jevons.」6
William Stanley Jevons,十九世纪英国经济学家,「杰文斯悖论」以他命名:效率提升,消耗反而增加。一个把判断成本砍低几个数量级的模型以他命名,这层联想顺理成章–需要说明,官方没有明说这层用意,这是合理推断 6。
创始人在 latent.space 播客里的态度倒是不纠结:「we need a new class of models. We’re not attached to naming that class of models.」19
那 Jev 到底是不是「System 1」?从接口形态看,像:不给中间推理过程,单次前向(one forward pass,一次网络计算即出结果,不逐字生成)出结果,延迟稳定且几乎不随问题数增长。从行为看,要打折扣:后文有两个第三方实测——选项顺序一换就改 13% 的答案,该说「不知道」时嘴硬一半。比较公允的说法是:它把「快直觉」做成了产品,直觉的准头还需要证据。
两种调用形态的差别,一张图说清:
flowchart LR
    subgraph SG1["生成式模型:System 2 路线(ChatGPT 一类)"]
        A["输入:状态 + 指令"] --> B["逐字生成回答文本"] --> C["应用代码解析文本取答案"]
    end
    subgraph SG2["决策模型:System 1 路线(Jev / Laya)"]
        D["输入:状态 + 带类型的问题"] --> E["单次前向,一次算完"] --> F["直接返回:选项 + 概率分布 + 置信度"]
    end
图 1:同一次判断,两种调用形态。生成式模型要把答案「写」出来再解析;决策模型把答案「算」出来直接用。
三、官方口径 vs 第三方实测
官方首页最显眼的位置挂着两组大字:「193.6x Faster, 444.6x Cheaper」–比前沿大模型快 193.6 倍、便宜 444.6 倍,口径见下文 3。
传播中取整成「200x faster, 400x cheaper」;另有「40 to 200 times faster」的区间口径在多家第三方转载中出现 21。Tom’s Hardware 的措辞是「claims to be 193x faster and 445x cheaper」–一个 claims,不带背书 22。
两个独立的第三方基准测了实账。
基准一:AbdelStark 的 jev-benchmarks 23。
它测的是「零样本文本分类」:给模型一段文本和一组候选标签,不提供任何训练示例,看它能不能选对、给出的概率靠不靠谱。三个数据集:AG News(把新闻标题归入 4 个栏目)、Banking77(把用户发给银行客服的一句话归入 77 种意图之一,本基准用 72 选项版)、DAIR Emotion(把一条评论归入 6 种情绪)。
规程是预注册的——开跑之前先公开锁死题目、模型版本(jev-1.13.0)和判分规则,共 300 个保留样本,防止事后挑题凑数。对比对象是本地 CPU 上的开源分类模型 GLiNER2.5(零样本,即不做针对性训练直接上手)。
准确率:AG News(4 选项)Jev 0.910 对 0.700;Banking77(72 选项)Jev 0.870 对 0.610;DAIR Emotion(6 选项)0.480 对 0.440,统计上不能区分。
延迟:托管调用的 Jev p50(中位数延迟,一半请求快于此值)为 236~256 毫秒;本地 CPU 上的 GLiNER 约 44 毫秒。
基准二:nibzard 的 decision-model-benchmark 24。
所谓冻结协议,指题目、模型版本、判分规则全程固定,结果可复核。三类对手:Jev、八个约束模式下的 LLM(关闭自由生成,只许按格式作答)、三个确定性基线(关键词规则一类的傻瓜基线)。原始日志全部公开,总花费 28.34 美元,声明无厂商赞助。
结论逐条:
- 质量:「No class wins on quality.」Jev 在银行意图分类(Banking77,见基准一)上 76.3%,排中游;最好的 gpt-oss-120b 是 81.3%。
- 速度:「Fastest measured – not 40-200x.」Jev 的 p50 是 264
276 毫秒;对上跑在 Cerebras 推理硬件上的 gpt-oss-120b 只有 1.2 倍;对 thinking 模式的 LLM 是 1016 倍。报告原话补刀:「The vendor’s speedup claim holds only against LLMs left in their slowest default mode.」 - 成本:「Cheapest by ten times.」每千次决策 0.07 美元,最便宜的 LLM 是 0.19 美元。方向属实,幅度是十倍,不是四百倍–口径差异:官方按 token 对比,基准按每次决策对比。
- 一个官方写明的边界:选项基数最多 255,官方博文原话是 cardinality up to 255 6;nibzard 实测证实 256 个选项直接报错「400 Too many choices」,而所有 LLM 都能处理 512。
- 一个官方没提的边界:选项顺序打乱后,Jev 会改变 13% 的选择。
- 校准:最扎心的一条。在强制「我不知道」的测试项上,所有 LLM 在 97%~100% 的项目上承认无知,Jev 只有 49.7%,校准误差(ECE,衡量「模型声称的把握」与「实际正确率」的偏差,越低越好)0.246,全场最差。报告的小标题是「Only jev bluffs」。
三组数字放在一起:官方说 193.6 倍,第三方在公平条件下测出 1.2~16 倍;官方宣传校准可靠,第三方测出「唯一嘴硬的选手」。
这不等于 Jev 没有价值。每千次决策 0.07 美元的成本、260 毫秒上下稳定的端到端延迟,是真实且有用的。差距在宣传的分母:对比对象选了「默认慢速模式的 LLM」,而不是「同等智力下最快的推理方案」。
官方也不是没有交代。博文写明对比基准是 GPT-6 Astra 与 Fable 5.1 的均值,评测由自家团队制作、承认存在偏差,首页那组 193.6x/444.6x 官方自称是「上端估计」;关于定价,官方的原话是「We can’t prove it isn’t subsidized」–无法证明不是补贴价 6。
四、复现潮:不是一家,是一批
把一周的时间线排开:9 月 15 日发布,当天 HN 破千分;9 月 16 日首批开源平替出现;9 月 17 日两个独立基准上线,发布视频播放量 3600 万 1;9 月 18 日 Laya 首发 28;9 月 19 日克隆盘点与中文引爆;9 月 20 日中文圈刷屏;9 月 21 日 APUS 模型族上线、Jev 取消候补全面开放 6;9 月 23 日,传统媒体开始定调 2231。
flowchart LR
    A["9/15<br/>发布"] --> B["9/16<br/>首批开源平替"] --> C["9/17<br/>两个独立基准上线"]
    C --> D["9/18<br/>Laya 首发"] --> E["9/19<br/>克隆盘点、中文引爆"] --> F["9/20<br/>中文圈刷屏"]
    F --> G["9/21<br/>APUS 模型族上线<br/>Jev 全面开放"] --> H["9/23<br/>传统媒体定调"]
图 2:发布后一周的时间线。产品的火和生态的火是同一天点着的。
Jev 发布两天内,latent.space 的标题是《Here are 6 Clones of Jev in 2 days》32。
一周内可确认的独立复现:
| 项目 | 主体 | 架构 | 许可 | 链接 |
|---|---|---|---|---|
| Laya | Convai Innovations | ModernBERT-large 421M + mmBERT 322M | Apache-2.0 | github.com/NandhaKishorM/laya |
| APUS-OpenJev-v1 | APUS(麒麟合盛)AI 实验室 | 4B / 9B / 35B-A3B,Qwen 底座 | 代码 MIT | huggingface.co/apus-ailab/APUS-OpenJev-v1 |
| Open-Jev | zefan-cai | Qwen3.5 LoRA + 决策头,2B/9B/27B | – | zefan-cai.github.io/open-jev |
| openjev | AlexWortega | Qwen3.5 cross-encoder | – | huggingface.co/AlexWortega/openjev |
| Bespoke Nimble 等 | 社区 | LoRA 配方 | – | 见 latent.space 盘点 32 |
表格里的行话:B=十亿参数(4B 即 40 亿);底座=拿现成开源模型当起点继续训练;LoRA=一种只训练少量附加参数的低成本微调技术;cross-encoder(交叉编码器)=把两段文本一起喂进模型做判断的模型结构。
HuggingFace 上有个聚合工具,原名 Jev Reproductions Tracker,现名 Jev Decision Index:收录 31 个复现模型,累计 13.2 万次评测请求 34。周边项目也来了:superagents-lab 的 jev-search(9 月 17 日,github.com/superagents-lab/jev-search)基于 Jev API 做搜索排序–不是模型复现,是生态位 35。
三点需要区分。
第一,「OpenJev」是统称,不是一家。zefan-cai 的 Open-Jev(2B/9B/27B)和 APUS 的 OpenJev-v1(4B/9B/35B)是不同项目,社区文章常混用 36。
第二,zefan-cai 在项目页写明了边界:「Independent implementation inspired by Jev; no claim to reproduce its proprietary method or speedups.」37
第三,时间线里有比 Jev 更早的。Laya 作者在 dev.to 的自述标题是「I built non-autoregressive decision models a year ago, then a frontier lab called it a …」38–非自回归决策模型(即不逐字生成的决策模型)一年前就做了,然后一家前沿实验室给它起了个品类名。复现潮里混着跟随者和先行的撞名者,这是考证「谁带火谁」时最容易搞错的部分。
还有个考证级细节:TypeSafe 说自己的训练方法是 RLCD(Reinforcement Learning for Calibrated Decisions)6,Laya 也说自己是 RLCD。同名,双方都没解释关系 28。
APUS 的版本补一句:9 月 19 日先放出了 fast-browser-use,9 月 21 日模型族 APUS-OpenJev-v1 上线,MIT 协议,宣称跨三大桌面系统且无 GPU 可跑 4142,新华网当日跟进报道 42。其模型卡给出 80 题冻结面板(题目先公开锁死再评测)的成绩:35B-A3B(总参数 350 亿、每步只激活约 30 亿的稀疏架构)88.75%、9B 85.0%、4B 82.5%,对照 Jev API 82.5% 44–9B 打平 Jev API,这是复现项目目前最硬的一条成绩。
五、实测:Laya 的三个 checkpoint
测试集:15 道封闭选择题,五个任务族(浏览器操作、是非判断、蕴含关系、情绪判断、指令遵循)加一组工单路由,任务族结构对齐 APUS 评测面板。跑批用自建的轻量测试框架,每题独立调用,记录延迟与完整输出。
被测模型:Laya 的三个 checkpoint(checkpoint 即「检查点」,训练完成后存下来的模型快照,可理解为一个成品版本)。参与设备三台:
- 设备 A:AMD Ryzen 7 5800H(8 核 16 线程)/ 32GB 内存,纯 CPU 推理
- 设备 B:Apple Silicon(10 核)/ 16GB 内存,纯 CPU 推理
- 设备 C:不做本机推理,经局域网 HTTP 远程调用部署在设备 B 上的 laya-server
| Checkpoint | 设备 | 准确率 | 单决策平均延迟 | 加载后常驻内存 |
|---|---|---|---|---|
| laya 英文原版 421M | A | 14/15(93%) | 270ms | 2.0GB |
| laya-typed-decisions 421M | A | 14/15(93%) | 265ms | 约 2.0GB |
| laya-multilingual 322M | A | 12/15(80%) | 81ms | 1.64GB |
| laya-multilingual 322M | B | 12/15(80%) | 33.5~43.2ms | 1.87GB |
| laya-multilingual 322M | C→B(远程) | 12/15(80%) | 38.4ms(服务端口径)/约50ms(含局域网往返) | 1.87GB(驻留在设备 B) |
七个观察。
一,延迟量级。本地 CPU 的单决策 33270 毫秒,落在第三方实测 Jev API 的同一区间(236312 毫秒 232437)。这类模型的卖点不是「更快的大模型」,是另一类调用。
二,跨设备一致性。同一 checkpoint 同一测试集,M 芯比 5800H 快约 2 倍,准确率完全相同。322M 的 checkpoint 常驻内存 1.6GB,加载一次 22~28 秒–近五年的任何笔记本都能常驻。
三,概率是真概率。每次决策返回完整的候选概率分布,代码可以直接按阈值分支,不需要解析文本。
四,失分模式。三个 checkpoint 唯一共同失分是一道边界题(指令要求「只回一个词」,正确答案「Paris.」被判违规);multilingual 额外错两道(一道中文指令的浏览器操作题、一道报价咨询的路由题)。后一点印证 Laya 自曝的限制:英文 checkpoint 对非拉丁文字会崩,官方举的例子是高棉语 0.000 准确率配 0.952 置信度 28。
五,APUS-OpenJev 未实测。4B 权重 8GB 可以 CPU 慢跑,9B 需要 18GB 磁盘,本机条件不足,此行留空。
六,确定性与远程调用。同一 checkpoint 连续两轮跑批,15 题的选择、概率分布、置信度全部逐位一致(output_tokens 恒为 0)——判别式打分对采样温度不敏感,请求里的 temperature 参数形同虚设;这对「按置信度阈值做分支」的工程用法是硬保障,也让跑批结果天然可复现。第三台设备经自研评测器(eval_harness 的 laya 传输层)复测,判分与自建框架逐题一致;局域网 HTTP 端到端约 50 毫秒,网络往返代价约 17 毫秒,远程化部署可忽略。
七,与生成式小模型同题对照。同一批 15 题,Qwen3-4B-Instruct-2507(4B,生成式,GPU)拿到 13/15(86.7%),比 laya-multilingual 高 6.7 个百分点,代价是延迟约 220 毫秒与需要文本解析。两类模型的失分不重叠:laya 错浏览器操作与路由题,Qwen3 错的两题恰好是 compliant/violation 反向互换(该族金标——即人工标注的标准答案——本身存疑)。「决策模型更快」成立;「决策模型更准」在这批题上不成立。
六、延伸实测:生产类目分类上的底细(2026-09-23)
jev 的 15 题测的是「泛决策」,题面干净、选项互斥。真实生产任务是另一种样子:中文商品名,五个类目(衣服/鞋子/裤子/裙子/其他),类目之间有从属关系——裤子与裙子都穿在身上,但不是「衣服」。用同一种子集(13 题,题目来自真实业务数据人工构造;因涉及公司生产项目,样本与业务细节不公开)横向量了一圈 49:
| 模型 | 类目精确匹配 |
|---|---|
| Qwen3-8B / Qwen3-4B(生成式) | 13/13 |
| Qwen3.5-0.8B 官方基座(生成式,全场最小) | 13/13 |
| 电商微调 0.8B(Q8 量化,权重压成 8 比特整数的省内存版) | 13/13 |
| 电商微调 0.8B(Q4 量化,压得更狠,精度损失更大) | 12/13 |
| laya-multilingual 322M | 9/13(69.2%) |
| DeepSeek 生产脚本(修参数前,输出截断 bug) | 8/13(可解析样本 8/8) |
laya 的 4 道失分全部同型:裤子、裙子被判成「衣服」,且是高置信错误(「衣服」的概率 0.61~0.99)。把类目边界定义写进指令(「裤子=裤装…裙子=裙装…衣服=上装与外套…」)重测:修复 2 题、回退 2 题,净收益为零——训练分布层面的盲区,提示词救不回来。
flowchart TB
    IN["中文商品名(13 题,真实业务数据人工构造)"] --> ENG["laya-multilingual 判类"]
    ENG -->|"正确 9/13"| OK["落类正确"]
    ENG -->|"误判 4/13(高置信)"| BAD["「裤子」「裙子」被判成「衣服」<br/>「衣服」概率 0.61~0.99"]
    BAD --> PW["把类目边界定义写进提示词重测"]
    PW --> NET["修复 2 题、回退 2 题:净收益为零"]
图 3:生产类目任务上的误判路径。
这一条给观察四补了个更实的注脚:多语言 checkpoint 的「100+ 语言」是理解层的能力(9 道做对的题同样是中文输入),细粒度类别判别是另一回事。落地建议随之明确:33 毫秒的判别引擎适合粗路由与二分兜底(意图路由、合规判定、是否类问题);细粒度多类目分类,今天就该交给生成式模型——哪怕后者只有 0.8B。
七、中文报道的转述质量
把中文圈的传播链对照官方口径过了一遍。
没转错的:发布日期 9 月 15 日,未见一处写错;定价两说(「输出 token 永久免费」与「$0.042/1M」)都能调和,凤凰科技明确写出换算关系 12;三原语 Choice/Score/Noul 的转述与官方文档一致 51。
轻度放大的:创始人身份。官方措辞是「co-invented RLHF and InstructGPT, the methods that lead to ChatGPT」,有中文媒体写成「参与了 ChatGPT 的研发工作」52–方向一致,表述更宽。
明确错误的:电子工程专辑《为啥Jev突然就全网爆火了?》把 Diogo Almeida 称为「OpenAI 的联合创始人」–他是前研究员,不是 OpenAI 联创 31。
疑似混淆的:OSCHINA 相关文章的列表摘要出现了「TypeSafe 最近开源了…」的字样–截至 9 月 23 日,Jev 本体没有开源,开源的是复现项目和 TypeSafe 自己的评测外围 54。
选择性引用的:「70 毫秒出判断」这类标题,取的是官方 70~500ms 端到端区间的下限 55。
没查到原文的:OSCHINA 那篇(仅列表页摘要可见,摘要本身疑似有误)与 36氪两篇的完整正文,均只有列表页或转载快照 52。
总体判断:这一轮中文传播没有硬伤,放大集中在人物故事上,数字层面比英文圈克制。
八、冷静的部分
汇总第三方实测暴露的问题,四条。
一,校准是卖点也是软肋。Banking77 上 Jev 校准占优,对依赖置信度做分支的系统这是硬通货;但 DAIR Emotion 上 16% 的样本给真实标签的概率是零 23,强制不确定场景全场最嘴硬(ECE 0.246)24。「不可能幻觉」在类型安全意义上成立–它不会输出选项之外的值;但在概率校准意义上不成立。两个命题经常被混着用 24。
二,255 个选项是官方博文写明的上限(cardinality up to 255 6),nibzard 实测证实 256 直接报错「400 Too many choices」,而所有 LLM 都能处理 512 24。高基数场景其实是 Jev 的强项面(72 选项 0.870)–前提是别越线。
三,位置偏差:选项顺序换一下,13% 的答案会变。官方评测没有覆盖这一项 24。
四,速度宣传条件性成立。对上同等智力下最快的推理方案,优势是 1.2 倍 24。
五,架构保密。TechCrunch 报道,外部观察者怀疑 Jev 基于开源权重模型改造,官方未确认;FastAPI 作者 Ronacher 的评价是「幻觉问题部分转嫁给了用户」64。
六,可用性:有报道称服务尚未向中国大陆地区开放 41。
官方 FAQ 自己列了「Can Jev still get things wrong?」和「Are these prices temporary or subsidized?」两个问题 3–答案原文未能抓取,但问题本身的存在说明官方知道边界在哪。
最后
两条实际的提醒。
- 判断某类调用(路由、分类、审核、审批这类封闭决策)值不值得换 System One 模型,用三个数验算:单次决策延迟、每千次决策成本、校准误差。前两个 Jev 和复现们有硬优势;第三个必须用自己的数据测,不要拿宣传页的数字当真–Laya 的 README 把自己的失败案例一条条列了出来,这种诚实比「零幻觉」三个字值钱 28。
- 「谁带火谁」是双向的。Jev 的发布让 Laya 这种更早的非自回归决策模型一夜之间有了参照系;开源复现的对照表(9B 85% 对 Jev API 82.5%、33ms 对 260ms)也在替这个品类做教育。产品的火和生态的火是同一周烧起来的,分不出先后。
未能核实的事项
- 官方 API 上下文长度上限(仅 OpenRouter 页面的 32K 转述;官方文档未直接给出)
- 官方语言支持清单(只有复现项目反向信息:Laya 100+ 语言、APUS 标注 en|zh)
- TypeSafe 投资方与融资金额(官方仅称 top-tier investors,$40M 一说未找到原始出处)
- Diogo Almeida 在 OpenAI 的具体职位、任职年限,及 InstructGPT 论文作者名单中的位置
- 「Noul」一词的命名解释
- Latent Space 两篇 AINews 与播客的完整正文(付费墙,仅标题/摘要)
- dev.classmethod.jp 文章正文(列表页可见,slug 当前 404)
- OSCHINA 文章正文(仅列表页摘要,摘要疑似有误)
- 新华网文章的完整 URL 与正文全文(引文来自搜索快照与第三方转述)
- 知乎《输出token永久免费!》原帖 URL(仅得新浪转载)
- 36氪两篇 Jev 文章的完整正文
- 「Vercel 24 小时内近 13% 付费团队采用、14 万人排队」的原始出处(疑似官方口径经媒体转述)
- 发布视频 36M views 的平台口径与统计截止点
- Jev 发布前是否有其他公司用「System One Model」作产品名(检索未发现,但属消极主张)
来源与引用
- Latent Space AINews.《Jev: a “System One Model”…》. 2026-09-16(36M views 佐证).(快照转引,正文付费墙未读) ↩︎
- Hacker News 讨论帖(2026-09-15T19:25:03Z 提交;截至 2026-09-23 为 1972 分、512 评论;早前快照为 1821 分、480 评论).(快照转引) ↩︎
- TypeSafe AI 官网首页(193.6x/444.6x 宣传、$42/1B input tokens、238x 对比 Claude Fable 5.1、RLCD、团队介绍、FAQ 题目). https://typesafe.ai/ 抓取于 2026-09-23 ↩︎
- chatmaxima.com. “TypeSafe Jev System One Model”(stealth 约两年、$40M seed、2026-09-15 发布). https://chatmaxima.com/blog/typesafe-jev-system-one-model (第三方转述,原始出处未核实) ↩︎
- 发布日期互证:datacamp.com《System One Models: Jev》、you.com《What is Jev》、requesty.ai《TypeSafe Jev explained》、explainx.ai. 均访问于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- TypeSafe 官方文档. https://docs.typesafe.ai/ (三原语定义、并行隔离求值、atomic questions 原则)抓取于 2026-09-23 ↩︎
- TypeSafe 官方文档. https://docs.typesafe.ai/ (三原语定义、并行隔离求值、atomic questions 原则)抓取于 2026-09-23 ↩︎
- TypeSafe 官方文档. https://docs.typesafe.ai/ (三原语定义、并行隔离求值、atomic questions 原则)抓取于 2026-09-23 ↩︎
- TypeSafe 官方文档. https://docs.typesafe.ai/ (三原语定义、并行隔离求值、atomic questions 原则)抓取于 2026-09-23 ↩︎
- TypeSafe AI 官网首页(193.6x/444.6x 宣传、$42/1B input tokens、238x 对比 Claude Fable 5.1、RLCD、团队介绍、FAQ 题目). https://typesafe.ai/ 抓取于 2026-09-23 ↩︎
- 凤凰科技.《爆火模型Jev全面开放,所有用户送1.2亿token》. https://tech.ifeng.com/ 约 2026-09-21(快照转引,原文 URL 未核) ↩︎
- TypeSafe AI 官网首页(193.6x/444.6x 宣传、$42/1B input tokens、238x 对比 Claude Fable 5.1、RLCD、团队介绍、FAQ 题目). https://typesafe.ai/ 抓取于 2026-09-23 ↩︎
- Daniel Kahneman. Thinking, Fast and Slow. Farrar, Straus and Giroux, 2011. ↩︎
- Yann LeCun.《A Path Towards Autonomous Machine Intelligence》. OpenReview, 2022. ↩︎
- 《From System 1 to System 2: A Survey of Reasoning Large Language Models》. arXiv, 2025.(编号未能核实;快照显示被引 441) ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- latent.space 播客.《Jev: System One models for Prod, not God – with Diogo Almeida》. 约 2026-09-21.(快照转引,完整 URL 未核) ↩︎
- TypeSafe AI 官网首页(193.6x/444.6x 宣传、$42/1B input tokens、238x 对比 Claude Fable 5.1、RLCD、团队介绍、FAQ 题目). https://typesafe.ai/ 抓取于 2026-09-23 ↩︎
- 「40 to 200 times faster」口径转述:beam.ai《Jev: TypeSafe AI for agents》、yourstory.com、outcomeschool.com. 均访问于 2026-09-23 ↩︎
- Tom’s Hardware(“claims to be 193x faster and 445x cheaper”). 约 2026-09-21.(快照转引) ↩︎
- AbdelStark. jev-benchmarks. GitHub. https://github.com/AbdelStark/jev-benchmarks (预注册协议、jev-1.13.0、AG News/Banking77/DAIR Emotion 结果、16% 真标签零概率、延迟 236-256/246ms)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- Latent Space AINews.《Jev: a “System One Model”…》. 2026-09-16(36M views 佐证).(快照转引,正文付费墙未读) ↩︎
- Laya GitHub README(2026-09-18 首发,GitHub/HF API 元数据;三 checkpoint 架构、33ms T4 自测、对 Jev 对照表、Honest limits、Banking77 0.425 自曝、Khmer 0.000@0.952、RLCD、impossibl 免费托管端点). https://github.com/NandhaKishorM/laya 访问于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- Tom’s Hardware(“claims to be 193x faster and 445x cheaper”). 约 2026-09-21.(快照转引) ↩︎
- 电子工程专辑.《为啥Jev突然就全网爆火了?》(摘要将 Diogo Almeida 称为「OpenAI 的联合创始人」,系媒体错误). eet-china.com.(快照转引) ↩︎
- latent.space.《[AINews] Here are 6 Clones of Jev in 2 days》. 约 2026-09-19.(快照转引) ↩︎
- latent.space.《[AINews] Here are 6 Clones of Jev in 2 days》. 约 2026-09-19.(快照转引) ↩︎
- HuggingFace Space「Jev Decision Index」(原名 Jev Reproductions Tracker,multimodalart 维护,2026-09-17 创建;收录 31 个复现模型、132,422 次评测请求). 访问于 2026-09-23 ↩︎
- superagents-lab. jev-search. GitHub. 2026-09-17(基于 Jev API 的搜索项目,非模型复现) ↩︎
- 「OpenJev」多项目混用:zefan-cai Open-Jev(2B/9B/27B)与 APUS-OpenJev-v1(4B/9B/35B-A3B)为不同项目;dev.classmethod.jp 有同口径文章(原文 URL 未核) ↩︎
- zefan-cai. Open-Jev 项目页. https://zefan-cai.github.io/open-jev/ (独立实现声明、JevBench 231 题结果、官方 70-500ms 转引、Jev API 延迟实测 286.0-312.8ms)访问于 2026-09-23 ↩︎
- Laya 作者 dev.to 自述.《I built non-autoregressive decision models a year ago, then a frontier lab called it a …》. https://dev.to/ (完整 slug 未核,标题经搜索快照确认) ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- Laya GitHub README(2026-09-18 首发,GitHub/HF API 元数据;三 checkpoint 架构、33ms T4 自测、对 Jev 对照表、Honest limits、Banking77 0.425 自曝、Khmer 0.000@0.952、RLCD、impossibl 免费托管端点). https://github.com/NandhaKishorM/laya 访问于 2026-09-23 ↩︎
- 搜狐(APUS 9 月 19 日开源 fast-browser-use、「全球最早一批针对 Jev 的独立开源复现」、跨平台无 GPU 可跑、服务尚未向中国大陆地区开放). https://m.sohu.com/ 约 2026-09-20.(快照转引) ↩︎
- 新华网.《APUS开源Jev跨平台复现:国产模型实现秒级决策》. 2026-09-21.(快照转引,完整 URL 未核) ↩︎
- 新华网.《APUS开源Jev跨平台复现:国产模型实现秒级决策》. 2026-09-21.(快照转引,完整 URL 未核) ↩︎
- APUS-OpenJev-v1 模型卡(80 题冻结面板:35B-A3B 88.75%、9B 85.0%、4B 82.5%,对照 Jev API 三轮均值 82.92%;准确率用 9B-3000、延迟用 9B-5949 两个不同 checkpoint;优化后 9B 决策服务 p50 25.58ms @ RTX PRO 6000 96GB;模型卡自认「不构成统计显著优越」). https://huggingface.co/apus-ailab/APUS-OpenJev-v1 访问于 2026-09-23 ↩︎
- AbdelStark. jev-benchmarks. GitHub. https://github.com/AbdelStark/jev-benchmarks (预注册协议、jev-1.13.0、AG News/Banking77/DAIR Emotion 结果、16% 真标签零概率、延迟 236-256/246ms)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- zefan-cai. Open-Jev 项目页. https://zefan-cai.github.io/open-jev/ (独立实现声明、JevBench 231 题结果、官方 70-500ms 转引、Jev API 延迟实测 286.0-312.8ms)访问于 2026-09-23 ↩︎
- Laya GitHub README(2026-09-18 首发,GitHub/HF API 元数据;三 checkpoint 架构、33ms T4 自测、对 Jev 对照表、Honest limits、Banking77 0.425 自曝、Khmer 0.000@0.952、RLCD、impossibl 免费托管端点). https://github.com/NandhaKishorM/laya 访问于 2026-09-23 ↩︎
- 本项目 benchmark 实测(2026-09-23):jev-local-16 经 eval_harness laya 传输层复测(判分与原生跑批逐题对齐)、Qwen3-4B-Instruct-2507 同题对照(13/15)、T1 商品分类种子 13 题横向(laya 经远程 suite t1-cat-13 跑批 9/13;prompt 边界定义重测修 2 回退 2)。明细见 ru-ecom-listing-research 仓库
results/bench/T6_*、results/jev/与《T6-jev决策基准-laya实测报告》. ↩︎ - 凤凰科技.《爆火模型Jev全面开放,所有用户送1.2亿token》. https://tech.ifeng.com/ 约 2026-09-21(快照转引,原文 URL 未核) ↩︎
- 三原语的中文转述互证:机器之心《刷屏了,前OpenAI研究员做的Jev,大家为啥抢着用?》(2026-09-19,36氪/新浪/知乎多平台转载);smzdm《Jev 爆火这一周》.(快照转引) ↩︎
- 36氪.《刷屏全球的AI新顶流Jev,一句话都不说,到底怎么玩?》(创始人表述)与《刚刚,Jev全网解禁,1.2亿Token限时免费用》(console.typesafe.ai). 约 2026-09-20.(快照转引,原文 URL 未核) ↩︎
- 电子工程专辑.《为啥Jev突然就全网爆火了?》(摘要将 Diogo Almeida 称为「OpenAI 的联合创始人」,系媒体错误). eet-china.com.(快照转引) ↩︎
- OSCHINA 列表页快照(正文未抓取;摘要出现「TypeSafe 最近开源了…」表述存疑) ↩︎
- smzdm.《前OpenAI研究员的Jev刷屏:不写一个字、70毫秒出判断》(取官方区间下限). 约 2026-09-22.(快照转引) ↩︎
- 36氪.《刷屏全球的AI新顶流Jev,一句话都不说,到底怎么玩?》(创始人表述)与《刚刚,Jev全网解禁,1.2亿Token限时免费用》(console.typesafe.ai). 约 2026-09-20.(快照转引,原文 URL 未核) ↩︎
- AbdelStark. jev-benchmarks. GitHub. https://github.com/AbdelStark/jev-benchmarks (预注册协议、jev-1.13.0、AG News/Banking77/DAIR Emotion 结果、16% 真标签零概率、延迟 236-256/246ms)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- TypeSafe AI Blog.《Introducing System One Models and Jev》. 2026-09-15. https://typesafe.ai/blog/introducing-system-one-models-and-jev (40x–200x 口径、70–500ms 端到端、Kahneman/Jevons 命名、cardinality up to 255、对比基准 GPT-6 Astra 与 Fable 5.1 均值、We can’t prove it isn’t subsidized、评测自建承认偏差)抓取于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- nibzard. decision-model-benchmark. GitHub. https://github.com/nibzard/decision-model-benchmark (冻结协议、p50 264-276ms、76.3% 中游、1.2x/10-16x、255 选项上限、ECE 0.246、位置偏差 13%、$0.07/1k 决策)访问于 2026-09-23 ↩︎
- TechCrunch 报道(Ronacher 引语「幻觉问题部分转嫁给了用户」、外部怀疑 Jev 基于开源权重、Vercel 用户实测 5–18x 提速、创始人履历独立佐证). 访问于 2026-09-23 ↩︎
- 搜狐(APUS 9 月 19 日开源 fast-browser-use、「全球最早一批针对 Jev 的独立开源复现」、跨平台无 GPU 可跑、服务尚未向中国大陆地区开放). https://m.sohu.com/ 约 2026-09-20.(快照转引) ↩︎
- TypeSafe AI 官网首页(193.6x/444.6x 宣传、$42/1B input tokens、238x 对比 Claude Fable 5.1、RLCD、团队介绍、FAQ 题目). https://typesafe.ai/ 抓取于 2026-09-23 ↩︎
- Laya GitHub README(2026-09-18 首发,GitHub/HF API 元数据;三 checkpoint 架构、33ms T4 自测、对 Jev 对照表、Honest limits、Banking77 0.425 自曝、Khmer 0.000@0.952、RLCD、impossibl 免费托管端点). https://github.com/NandhaKishorM/laya 访问于 2026-09-23 ↩︎
发表回复